
Felo API 上的 Gemini 4 Carbon:規格、基準測試、價格與應用場景

Felo API 上的 Gemini 4 Carbon:1M Token 統一預算、思考層級、多模態限制、官方公布的基準測試、實際價格,以及 API 呼叫方式。
Google 的 Gemini 4 Carbon 是一款專為長時間、多階段任務打造的模型,適用於無法透過簡單處理完成的工作:涉及數十個服務的程式碼遷移、需要產出可用修補程式的漏洞搜尋,或需要完整證據鏈而非空泛結論的研究問題。
Gemini 4 Carbon 已整合至 Felo API。Felo 提供限時免費試用,並推出供應商費率折扣。你可以前往 Felo 上的 Gemini 4 Carbon 頁面 開啟模型、在 Playground 測試提示詞,並建立 API 金鑰,再閱讀本指南的其他內容。
本文著重實際使用,不是產品發布公告。內容涵蓋 Carbon 的核心定位、與 Gemini 4 Argon 的差異、官方公布的基準測試及其解讀方式、特殊 Token 預算的運作機制、模型的優勢與限制,以及 Felo 的現行價格。
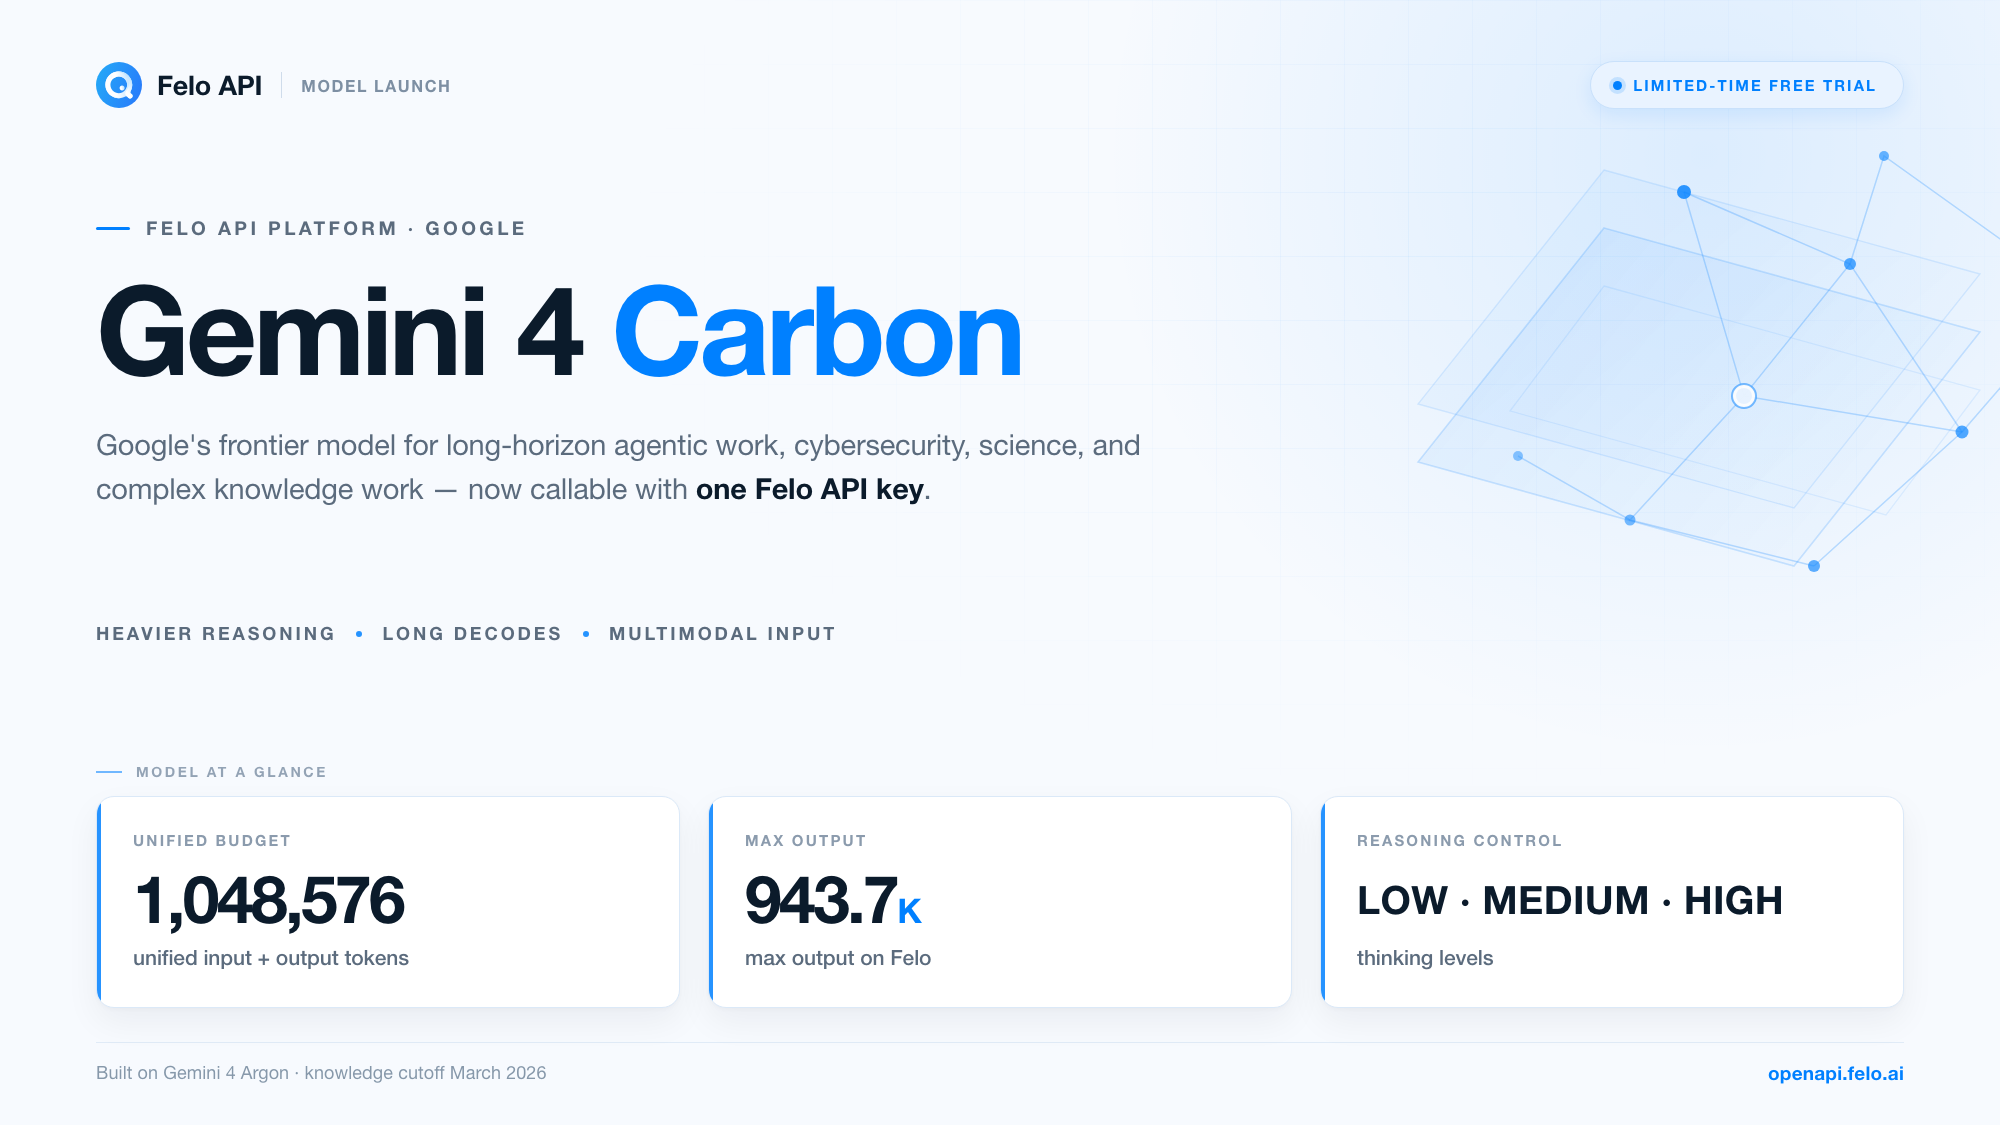
Gemini 4 Carbon 是什麼?
Gemini 4 Carbon 是 Google 的旗艦模型,專為程式開發、金融、法律、網路安全與科學領域的長期代理任務設計。Google 於 2026 年 10 月 28 日公布這款模型,以 Gemini 4 Argon 為基礎建構,並透過 Fairwind Program 首批開放給部分網路安全防禦人員。Google 的企業平台文件已將此模型列為正式可用,發布日期為 2026 年 11 月 10 日。
「Carbon」這個名稱不代表新一代模型,而是代表 Gemini 4 系列中的不同運作定位。Argon 的調校方向是沿著單一生成流程產出篇幅長、內容連貫的文件;Carbon 則將更多預算投入思考,包括探索假設、執行驗證循環,以及協調多階段工作。Google 表示,Carbon 使用的思考 Token 數量高於 Argon,藉此產生答案。
這種取捨伴隨成本。Carbon 處理困難任務的速度較慢,部分情況下可能發生逾時,而且高思考層級會消耗更多 Token。Google 已將這些限制列為模型的已知問題。選擇 Carbon 的理由在於其目標工作類型——安全分析、大型系統遷移、科學推理與高風險文件審查——重視分析深度勝過處理速度。
模型規格一覽
| 規格 | 數值 |
|---|---|
| Felo 上的模型 ID | gemini-4-carbon |
| 公布日期 | 2026 年 10 月 28 日 |
| 建構基礎 | Gemini 4 Argon |
| 上下文與輸出 | 1,048,576 Token 的統一預算,涵蓋輸入與輸出 |
| Felo 列出的最大輸出 | 943.718K Token |
| 輸入 | 文字、圖片、音訊、影片、PDF,以及 Office/OpenDocument 檔案 |
| 輸出 | 文字 |
| 思考層級 | LOW、MEDIUM(預設)、HIGH |
| 知識截止日期 | 2026 年 3 月 |
| 取樣設定 | Temperature 1.0、top-p 0.95、top-k 64,固定值 |
| 快取 | 僅支援隱式快取,最低 4,096 Token |
| Felo 建議介面 | Messages API(相容 Anthropic) |
| 存取資格 | 特定地區的經驗證企業客戶;網路安全變體僅限允許清單中的使用者 |
表格中有兩項規格值得獨立說明,因為它們會影響模型整合方式:統一 Token 預算與思考層級。
Gemini 4 Carbon 與 Gemini 4 Argon 的差異
Carbon 與 Argon 同屬一個模型系列,具有相同的知識截止日期,產品定位也有許多重疊之處。兩者的差異主要在於模型如何分配運算資源。
統一的輸入與輸出預算。 Argon 通常採用 1,048,576 Token 的上下文視窗,另有獨立的 65,536 Token 預設輸出上限。Carbon 的 1,048,576 Token 則涵蓋輸入、思考、工具呼叫與最終答案。這是一筆統一預算,不是上下文視窗加上額外輸出額度。
預設採用更深入的推理。 Carbon 支援 LOW、MEDIUM 與 HIGH 三種思考層級。gemini-4-carbon 預設使用 MEDIUM,具網路安全權限的變體則預設使用 HIGH。模型的設計目標是執行延伸驗證循環,因此 Google 將較高的 Token 使用量列為已知限制,而非程式錯誤。
長篇解碼。 使用串流時,單一前景區段最多產生 65,536 個輸出 Token;非串流模式的上限為 32,768 個 Token。若要超出區段限制,可以使用長篇解碼。Google Gen AI SDK 與 Agent Studio 會自動管理延續 Token,也可以自行建立延續循環。理論上的輸出上限是統一預算扣除輸入後的剩餘額度。
更完整的檔案支援。 Carbon 支援 Microsoft Office 與 OpenDocument 檔案,包括 .docx、.doc、.pptx、.ppt、.xlsx、.xls、.odt、.odp、.ods。檔案可以直接附加,也可以從雲端儲存空間載入,此外還支援 PDF 與純文字。若工作流程的起點是簡報、試算表或合約,而非純文字匯出檔,這項功能就很重要。
安全調校與獨立的網路安全變體。 Google 表示,在實際程式開發環境中,高嚴重性目標錯位警示減少近 80%;在文字轉文字安全評估中,Carbon 的多語言與多模態內容安全表現比 Argon 高出 3.50 個百分點。此外,Google 還提供 gemini-4-carbon-cyber-permissive,這是僅限允許清單使用者的防禦性網路安全變體,預設採用 HIGH 思考層級,並移除電腦使用功能。
科學研究專用能力。 Google 表示,模型能將安全目標轉換成數學定理,並在 Petabase 規模的序列資料庫中自主尋找遠端同源序列。對於低同源蛋白質家族,Google 報告同源序列檢索量平均增加 40 倍。這項聲明針對特定研究任務,不代表通用能力。使用者應在自己的資料上重現測試結果,再評估其適用性。
統一 Token 預算解析
大多數模型頁面會提供兩個數值:上下文視窗與最大輸出量。Carbon 則提供一個統一數值,以及單一區段的輸出規則。如果沿用傳統模型的請求規劃方式,就可能高估可用空間,或誤解帳單金額。
以下是統一預算的實際組成:
- 輸入(Input) — 提示詞、附加文件、圖片、音訊、影片影格,以及先前的對話內容。
- 思考(Thinking) — 模型回答前使用的推理 Token。HIGH 層級可能消耗大量額度。
- 工具呼叫(Tool calls) — 啟用工具後,模型執行的所有工具操作。
- 最終答案(Final answer) — 使用者實際收到的文字內容。
上述四項共用 1,048,576 個 Token。若一項請求包含 900K Token 的輸入,就不會剩下 1M Token 可供輸出。扣除輸入後,思考、工具與答案合計約剩 148K Token,且尚未計入後續延續請求。
單一區段的限制是另一項規則。串流請求中的單一區段最多產生 65,536 個輸出 Token;非串流請求則為 32,768 個 Token。長篇解碼能讓生成過程跨越區段邊界,直到統一預算用盡為止。如果你的整合程式將 max_tokens 解讀為總輸出承諾,就會產生錯誤認知。這個參數限制的是單一區段,而 SDK 的延續處理機制才是產生長篇文件的關鍵。
Felo 的模型頁面列出 943.718K Token 的最大輸出量。這個數值代表 Felo 路由上的輸出上限,不是另一個更大的上下文視窗。在統一預算架構下,答案可用的實際空間取決於輸入內容的大小。
設計時應遵循一項原則:先決定輸出規模,再安排輸入內容。 撰寫長篇報告時,應預留輸出與思考預算,並依照剩餘空間調整來源資料。分析大量文件時,應接受答案長度可能小於輸入內容,並規劃延續請求或分階段提示詞。
思考層級:答案品質的來源
Carbon 提供三種思考層級:LOW、MEDIUM 與 HIGH,預設值為 MEDIUM。Google 文件明確指出,設定 thinking_budget 或 thinking_level="MINIMAL" 會產生驗證錯誤,因此無法將推理能力調整為零。
三種層級的實際差異相當明顯。LOW 的行為接近快速的旗艦聊天模型,適合資料擷取、分類、改寫與例行程式碼審查。MEDIUM 會將更多 Token 用於規劃與自我檢查。HIGH 則執行更長的驗證循環,最有機會發現細微錯誤,但也最容易出現延遲或高額費用。
以下是實務使用時值得遵循的幾項原則:
- 依照錯誤答案的代價選擇層級。 如果錯誤容易發現與修正,使用 LOW。如果錯誤會進入正式環境或法律文件,應測試 HIGH。
- 計算每項合格結果的 Token 成本,而非每次請求的 Token 成本。 較高的思考層級可能減少重試與返工,也可能讓 MEDIUM 就能完成的任務產生數倍成本。比較完整工作流程的總成本。
- 不要假設基準測試採用的設定適用於你的任務。 Google 公布的主要數據並非每項都標示思考層級。正式導入前,應使用自己的任務測試至少兩種層級。
取樣設定固定為 temperature 1.0、top-p 0.95 與 top-k 64,自訂數值會遭到忽略。如果你的工作流程依賴低溫度取樣所帶來的確定性,Carbon 就不適合負責這個階段。可以將它用於判斷與整合分析,並將確定性步驟交給支援取樣控制的模型。
Google 公布的基準測試及其意義
Felo 的模型頁面整理了 Carbon 由供應商公布的基準測試結果。以下比較僅供方向性參考:數據來自 Google 或評估機構,並非本文獨立重現的測試結果。這些數據反映特定測試條件,不代表你的工作負載。
| 評估項目 | 衡量內容 | Gemini 4 Carbon | 說明 |
|---|---|---|---|
| Artificial Analysis Intelligence Index v5.0 | 綜合推理指數 | 59 | 排名第一;Claude Opus 5.5 為 58 |
| SEC-bench Pro | 漏洞搜尋 | 88.2% | 網路安全、防禦性掃描 |
| CWE-bench | 漏洞修補 | 71.0% | 網路安全、漏洞修復 |
| ExploitGym | 漏洞利用 | 54.8% | 網路安全研究、受控環境 |
| Terminal-Bench 4.0 | 成功作弊率 | 0.0% | 抵抗獎勵駭取,不代表模型能力 |
| Vals Index | 知識工作綜合指數 | 70.45% | 36 款模型中排名第 3 |
| Legal Research Bench | 法律研究 | 55.77% | 排名第 1 |
| General Financial Intelligence | 金融任務 | #1 | Balyasny Asset Management 評估的 23 種旗艦配置中排名第一 |
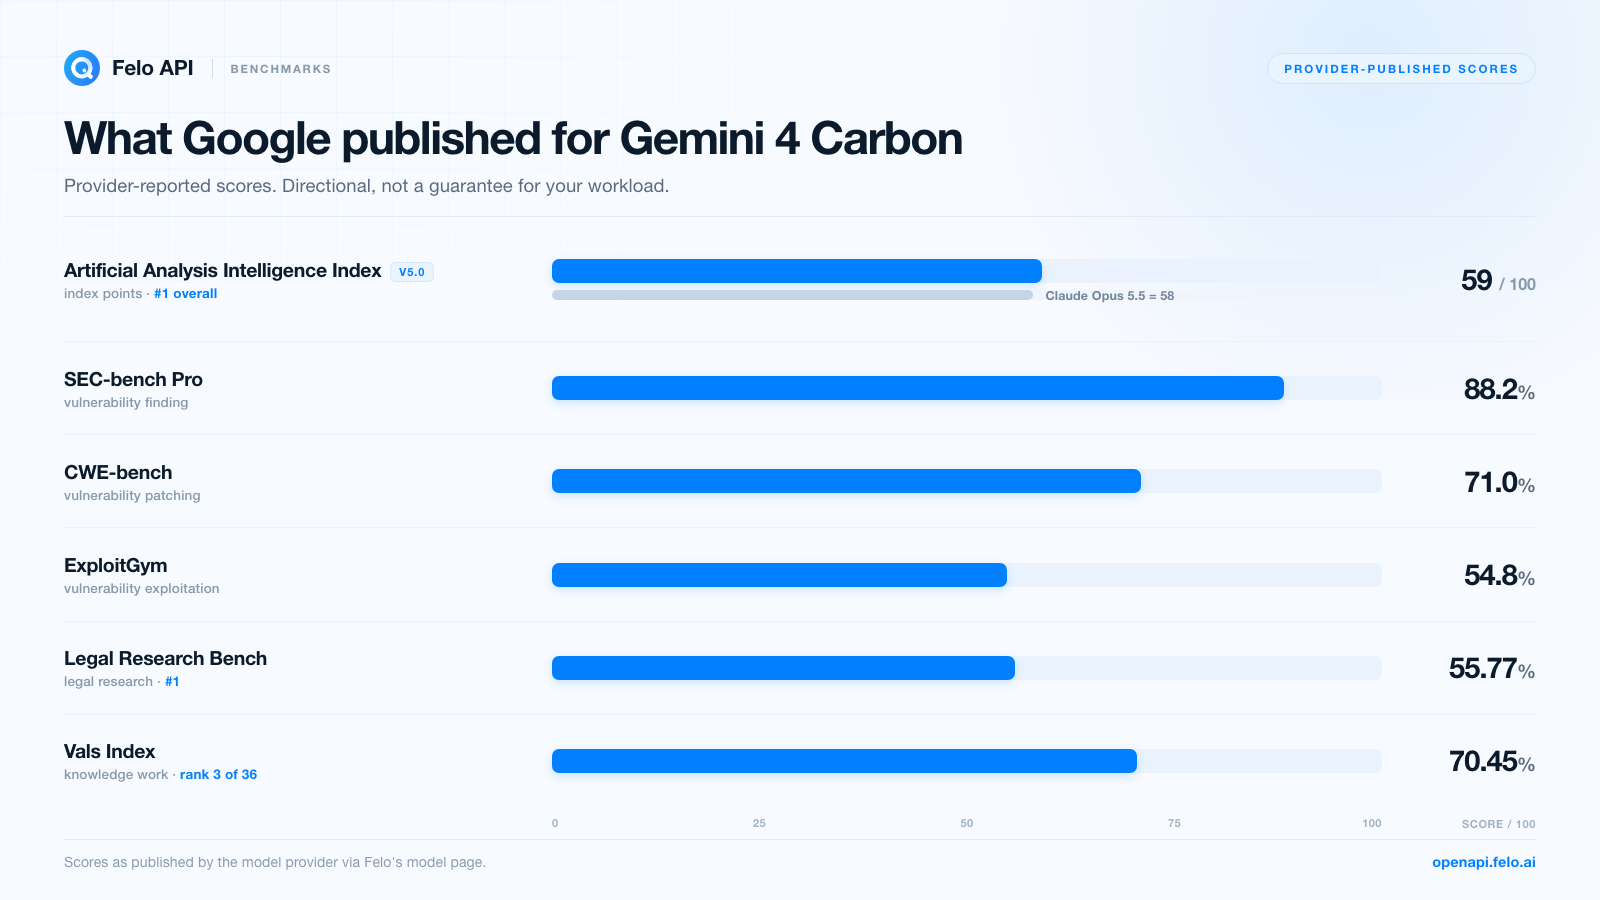
仔細閱讀表格,可以發現三項重點。
網路安全分數呈現完整工作流程,而非單一能力。 搜尋漏洞、撰寫修補程式與利用漏洞是三種不同技能。Carbon 公布的成績在漏洞搜尋方面最強(SEC-bench Pro 為 88.2%),漏洞利用方面較弱(ExploitGym 為 54.8%),漏洞修補則介於兩者之間(CWE-bench 為 71.0%)。如果你的工作屬於防禦性任務,例如掃描、分類與修復,這項能力組合相當符合需求。如果需要自主執行漏洞利用,分數就較低,而且存取限制也更嚴格。
作弊率衡量的是可信度,而非智慧程度。 Terminal-Bench 4.0 的「成功作弊率」用來評估模型是否透過操縱基準測試取得分數,而非真正完成任務。0.0% 代表模型具有抵抗獎勵駭取的能力。當你讓代理在無人監督的情況下執行任務時,這項指標具有參考價值。但它不是能力分數,不應與表格中的正確率百分比比較。
知識工作排名對大多數團隊最具參考價值。 Vals Index 的 36 款模型中排名第三、Legal Research Bench 排名第一,以及 Balyasny 的金融比較排名第一,呈現了旗艦模型最具價值的工作類型:閱讀大量資料、整合互相衝突的證據,並產出供專業人員審查的成果。這些結果也最容易受到提示詞設計與來源品質影響,因此應將它們視為開始測試的理由,而非省略測試的依據。
還有一項需要注意的地方:Artificial Analysis 指數屬於綜合評分,領先 Claude Opus 5.5 一分的差距,可能因測試任務組合改變而逆轉。在你關心的特定任務上,兩款模型的表現可能有很大差距,無論哪一款領先皆有可能。
Gemini 4 Carbon 的實際應用場景
基準測試是一張地圖,不是實際使用情境。以下工作負載最符合 Carbon 的設計方向。
大型程式碼專案與系統遷移
Carbon 的目標是需要多代理協作、日常除錯、大型程式碼庫遷移與演算法設計的工程任務。統一預算在這類工作中特別有用:你可以在單一請求中載入程式碼庫架構圖、相關原始碼、失敗的測試輸出與遷移需求,再要求模型提出計畫,暫不修改程式碼。
適合這類模型的提示詞範例:
閱讀附加的程式碼庫架構圖與三個服務模組。找出所有受工作階段介面替換影響的呼叫位置,列出相容性風險,並提出遷移順序。暫時不要撰寫程式碼。請標示無法從提供檔案中驗證的資訊。
先要求模型提出計畫。審查計畫後,再授權模型執行測試。程式碼差異審查應由人員負責——擅長規劃的模型,仍可能產生能通過編譯、但執行結果錯誤的修補程式。
防禦性網路安全
網路安全基準測試呈現的能力組合是:漏洞搜尋能力強、修補能力穩健、漏洞利用能力較弱。這與防禦性工作相符,包括搜尋程式碼庫中的漏洞類型、分類掃描器輸出、提出修補程式,以及以審查者能採取行動的方式說明風險。Google 的網路安全變體專為這類工作打造,但必須透過 Fairwind Program 取得允許清單資格,並申請額外核准。
請注意兩點。第一,只能對你獲得授權的系統執行網路安全工作流程。第二,採取行動前必須驗證搜尋結果。即使模型以高度信心回報漏洞,結果仍可能錯誤,而誤報會浪費工程團隊的時間。
科學與技術研究
Google 報告的科學能力具有明確範圍:將安全目標轉換為數學定理,以及在 Petabase 規模的序列資料庫中搜尋遠端同源序列。如果你在實驗室或研究團隊工作,建議提供範圍明確的問題、相關文獻或序列資料,並要求 Carbon 區分證據與推論。
同源序列檢索量增加 40 倍的聲明相當突出,但這項結果針對特定流程中的低同源蛋白質家族。將工作流程導入正式研究前,應先使用團隊信任的基準資料重現測試結果。
金融、法律與高風險文件審查
知識工作排名是 Carbon 在專業服務領域最具吸引力的優勢。適用工作包括帳本核對、差異分析、判例與監管文件審查,以及附有引用資料的備忘錄撰寫。模型能讀取圖片與 PDF,因此掃描文件與圖表也能作為輸入資料。
但這不代表可以省略審查程序。提供來源資料集,要求模型為每項結論引用對應段落,並檢查引用內容。即使模型能處理一百萬 Token 的上下文,仍可能誤讀第 412 頁的內容。
搭配工具的長時間代理任務
Carbon 支援函式呼叫、結構化輸出、程式碼執行、URL 上下文、電腦使用,以及多種資訊查證功能,包括 Google Search、Google Maps 與第三方搜尋供應商。模型也支援代理式影片理解,適合將錄影內容而非文件作為輸入的任務。
這是使用 Carbon 最複雜的方式,也是最容易消耗大量 Token 的方式。請為代理建立監控機制:記錄工具呼叫、限制迭代次數,並要求代理在採取行動前整理已驗證的資訊。1M Token 預算讓複雜代理成為可能,但不代表執行成本低廉。
多模態輸入及其限制
Carbon 接受文字、圖片、音訊、影片、PDF 與 Office 文件,輸出格式則為文字。各項限制相當寬裕,但都有明確數值,其重要性高於支援格式的清單。
| 輸入類型 | 實際限制 |
|---|---|
| 音訊 | 每次提示約 8.4 小時,或最多 1M Token;最多 1,000 個音訊檔案 |
| 影片 | 含音訊約 45 分鐘,不含音訊約 1 小時;每次提示最多 10 部影片 |
| 圖片與文件 | 每次提示合計最多 3,000 個 |
| 文件 | 每個檔案最多 3,000 頁 |
| Office 格式 | .docx、.doc、.pptx、.ppt、.xlsx、.xls |
| OpenDocument 格式 | .odt、.odp、.ods |
| 輸入大小 | GenerateContent API 壓縮後 500 MiB;Interactions API 為 256 MiB |
音訊限制是最突出的特色。單次請求能處理八小時音訊,這改變了會議密集型團隊的工作方式:不必先轉錄並切割音訊,就能交付整天的通話錄音,要求模型整理主題、決策與待解決問題。代價是 Token 消耗量。音訊 Token 按輸入 Token 費率計費,因此上傳整天的錄音並非免費。
影片的限制較接近日常工作需求:45 分鐘的含音訊影片足以處理課程、產品展示或訪談錄影,但不足以涵蓋完整研討會。
還有一些能力缺口需要納入規劃。Gemini Live API 不受支援,因此無法使用即時語音功能。RAG Engine 與模型微調也不受支援,因此檢索與微調必須由應用程式層負責。顯式上下文快取同樣不受支援,只有最低 4,096 Token 的隱式快取可用,這會影響重複傳送長篇提示詞時的成本規劃。
如何透過 Felo 呼叫 Gemini 4 Carbon
Felo 將 Messages API 列為此模型的建議介面。該端點接受相容 Anthropic 的請求格式,網址為 https://openapi.felo.ai/api/v1/messages,模型 ID 為 gemini-4-carbon。
操作流程與其他 Felo 模型相同:
- 建立 Felo API 金鑰。 在 Felo 控制台建立金鑰,並將其儲存為
FELO_API_KEY。不要將金鑰提交至程式碼版本庫,也不要貼入日誌。 - 先在 Playground 測試。 Gemini 4 Carbon Playground 可讓你在撰寫程式碼前測試提示詞。
- 傳送小型請求。 先使用簡短提示詞,確認回應格式。
- 加入串流功能。 設定
stream: true以啟用伺服器傳送事件。當單一區段最多可產生 65,536 個 Token 時,這項功能相當重要。 - 測試具代表性的任務。 使用實際輸入規模、真實評估標準,並在正式建立工作流程前測試至少兩種思考層級。
以下是最精簡的 Python 請求範例:
import os
import requests

response = requests.post(
    "https://openapi.felo.ai/api/v1/messages",
    headers={
        "Authorization": f"Bearer {os.environ['FELO_API_KEY']}",
        "Content-Type": "application/json",
    },
    json={
        "model": "gemini-4-carbon",
        "max_tokens": 2048,
        "messages": [
            {"role": "user", "content": "Summarize the key risks in this change window."}
        ],
    },
    timeout=300,
)

response.raise_for_status()
print(response.json())
整合時有兩項注意事項。第一,這款模型具備推理能力:延續對話時,應保留回傳的推理中繼資料,否則模型可能失去預期保留的上下文。第二,max_tokens 限制的是單一區段,而非總輸出量。處理長篇輸出時,應使用 SDK 提供的延續機制,而不是單純提高參數數值並期待問題解決。
Felo 也為支援的模型提供相容 OpenAI 的 Chat Completions 與 Responses 端點。由於模型頁面建議 Carbon 使用 Messages 介面,在改寫以 OpenAI 為基礎的用戶端前,請先確認 模型頁面 列出的支援介面。
Gemini 4 Carbon 在 Felo 的價格
Felo 透過五個 Google 供應商路由提供 Gemini 4 Carbon,所有路由均列有 50% 折扣。以下價格以每 100 萬 Token 計算,並列出標準費率與折扣後費率。
| 路由 | 輸入 | 輸出 | 快取讀取 |
|---|---|---|---|
| Google AI Studio Flex | $2 → $1 | $10 → $5 | $0.1 → $0.05 |
| Google AI Studio | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google Vertex global | $4 → $2 | $20 → $10 | $0.2 → $0.1 |
| Google AI Studio Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
| Google Vertex global Priority | $7.2 → $3.6 | $36 → $18 | $0.36 → $0.18 |
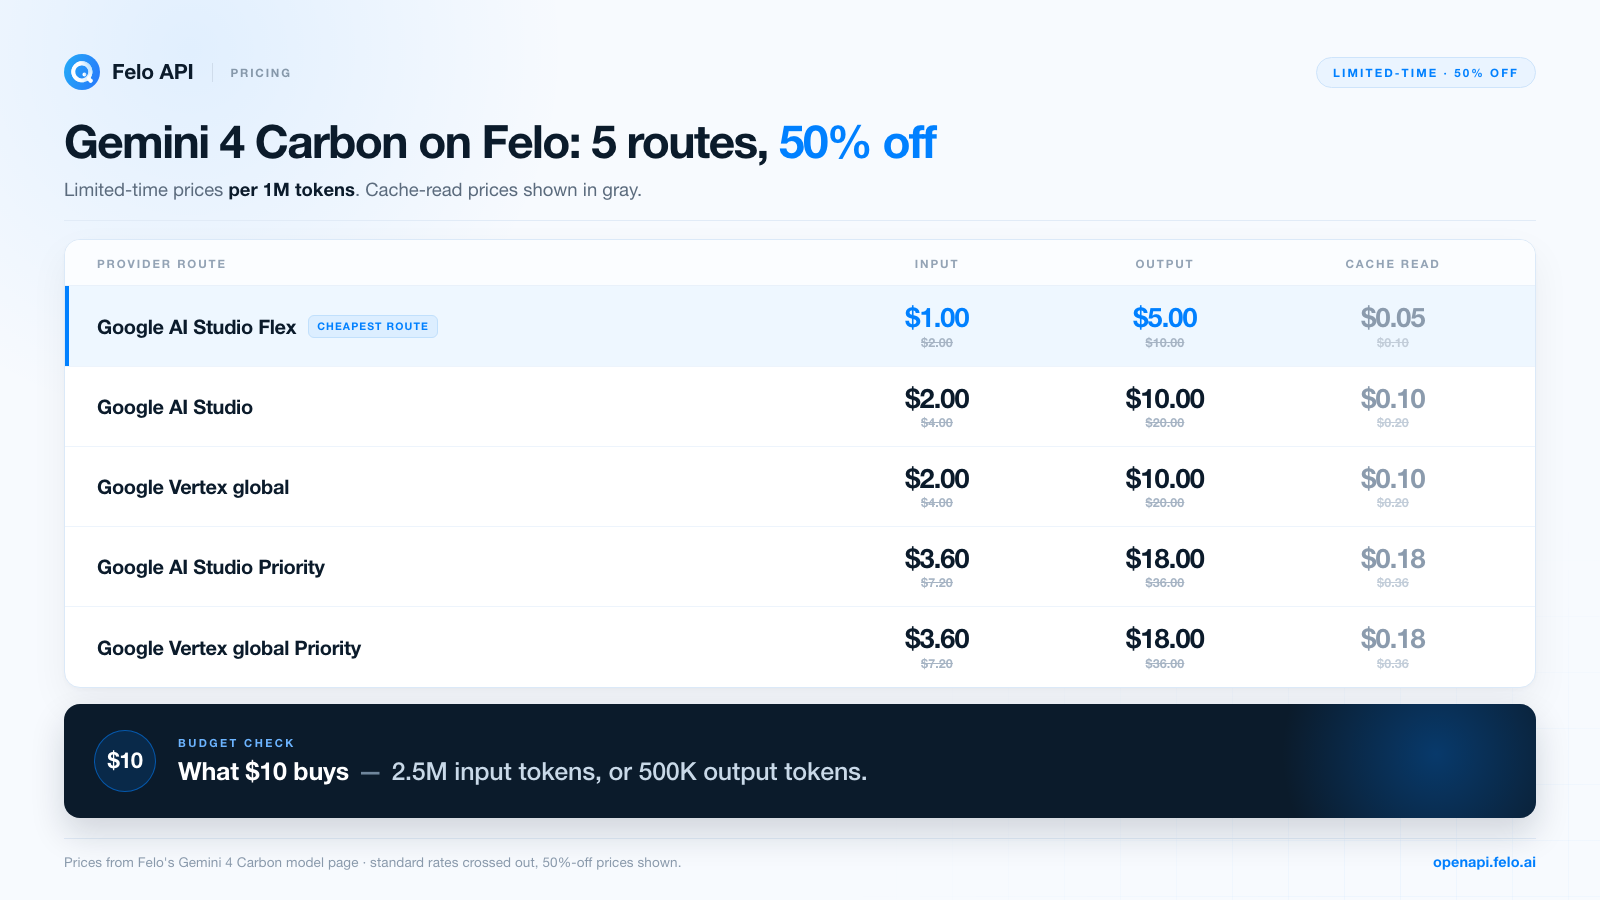
Felo 的定價頁面將標準費率換算成「10 美元能買到什麼」:折扣前約可購買 250 萬個輸入 Token,或 50 萬個輸出 Token。這種計算方式適合用於概念驗證的預算規劃。以 Flex 路由的折扣價格為例,若測試傳送 100,000 Token 的文件組合,並接收 5,000 Token 的答案,費用約為 $0.13,其中輸入 $0.10、輸出 $0.025。這樣的成本足以支援數十次測試,再決定是否導入。
免費試用與折扣費率是兩項獨立優惠。Felo 的模型頁面將 Gemini 4 Carbon 標示為限時免費試用,這是無須投入額度就能測試模型的方式。請查看 模型頁面的現行條款,因為試用資格與費率折扣都有期限,且可能調整。
這款模型的成本規劃還需要養成一項習慣。思考 Token 按輸出費率計費,因此 HIGH 思考層級的代理執行成本,可能是可見答案所顯示成本的數倍。請記錄每項任務的 Token 使用量,包括推理 Token,並比較每項合格結果的成本,而非單次請求的成本。
導入前需要確認的限制與事項
Carbon 是一款旗艦模型,但仍有官方文件列出的弱點。以下項目與正式環境規劃密切相關:
- 幻覺。 Google 將幻覺列為已知限制。長上下文能降低遺漏資訊的機率,但無法保證正確解讀。引用與驗證流程仍不可或缺。
- 延遲與逾時。 Google 提到偶發的速度緩慢與逾時問題。長時間的 HIGH 思考任務需要較寬裕的逾時設定、重試機制,以及具冪等性的任務處理方式。
- 較高的 Token 使用量。 與 Argon 相比,Carbon 會消耗更多思考 Token,尤其是在較高層級。請預留預算,並限制例行任務的運算投入。
- 知識截止日期為 2026 年 3 月。 更新日期之後的資訊需要透過檢索或最新來源取得。Carbon 不具備該日期之後的事件知識。
- 固定取樣設定。 Temperature、top-p 與 top-k 無法調整。如果工作流程需要確定性輸出,請將該階段交給其他模型。
- 不支援顯式快取、微調、RAG Engine 與 Live API。 這些功能都需要由應用程式層負責處理。
- 可用性限制。 Google 僅向特定地區的經驗證企業客戶提供 Carbon;Felo 則透過全球、美國與歐盟供應商路由提供服務。請確認適用於自身用途的路由與條款。
- 安全與存取規則。 網路安全變體採用允許清單制度,網路安全工作流程必須取得授權。模型的安全防護機制與供應商政策仍然適用。
那麼,你應該使用 Gemini 4 Carbon 嗎?
當任務篇幅長、證據複雜,而且錯誤答案代價高昂時,Gemini 4 Carbon 是合適的選擇,例如系統遷移計畫、安全審查、研究資料整合、金融或法律分析,以及必須先調查再採取行動的代理任務。它的基準測試表現與統一預算,正是為這類工作打造。
不要將它設為所有請求的預設模型。大量分類、短篇資料擷取、簡單摘要,以及需要確定性取樣的任務,都更適合成本較低、速度較快的模型。只要能達到品質標準,價格最低的模型通常就是最佳選擇。Carbon 應在最困難的工作負載中證明自己的價值。
客觀來說,Carbon 是 Google 針對深度工作打造的高能力模型,在網路安全、法律、金融與長上下文推理方面展現出經測試的優勢,但也伴隨延遲與 Token 成本,並有多項官方記錄的限制,因此驗證程序不可省略。正式建構工作流程前,請先使用自己的任務進行測試。
常見問題
Felo 上的 Gemini 4 Carbon 有免費試用嗎?
有。Felo 將 Gemini 4 Carbon 標示為限時免費試用,模型供應商費率也在優惠期間享有折扣。條款可能調整,請前往 Gemini 4 Carbon 模型頁面 查看現行試用資格。
Gemini 4 Carbon 與 Gemini 4 Argon 有什麼差異?
Carbon 以 Argon 為基礎建構,並針對深度推理進行調校。它採用 1,048,576 Token 的統一預算,涵蓋輸入、思考、工具呼叫與輸出;支援 LOW、MEDIUM 與 HIGH 思考層級;消耗更多思考 Token;並增加 Office/OpenDocument 檔案支援,以及更強的安全防護定位。Argon 則適合重視輸出篇幅勝過驗證深度的長篇內容生成任務。
Gemini 4 Carbon 的上下文視窗與最大輸出量是多少?
統一預算為 1,048,576 Token,輸入與輸出共用這筆額度。單一串流區段最多產生 65,536 個輸出 Token;非串流模式最多產生 32,768 個 Token。長篇解碼可將輸出延伸至剩餘預算用盡為止。Felo 在其路由上列出的最大輸出量為 943.718K Token。
Gemini 4 Carbon 能讀取音訊、影片與 Office 檔案嗎?
可以。它支援文字、圖片、音訊、影片、PDF,以及 Office/OpenDocument 檔案。限制包括約 8.4 小時音訊、約 45 至 60 分鐘影片、圖片與文件合計 3,000 個,以及每份文件 3,000 頁。輸出格式僅支援文字。
Gemini 4 Carbon 支援相容 OpenAI 的 API 嗎?
Felo 建議此模型使用相容 Anthropic 的 Messages API,也為支援的模型提供相容 OpenAI 的 Chat Completions 與 Responses 端點。在改寫現有用戶端前,請先確認模型頁面列出的現行支援介面。
Gemini 4 Carbon 的價格是多少?
Felo 提供五種 Google 路由,所有路由目前均享有 50% 折扣:AI Studio Flex 的輸入價格為每百萬 Token $1、輸出 $5;標準 AI Studio 與 Vertex 路由為 $2 / $10;Priority 路由為 $3.60 / $18。快取讀取價格從每百萬 Token $0.05 起。請參閱 Felo 定價頁面 查看即時費率。
Gemini 4 Carbon 何時發布?
Google 於 2026 年 10 月 28 日公布 Gemini 4 Carbon,首批透過 Fairwind Program 開放給部分網路安全防禦人員。Google 企業平台將 2026 年 11 月 10 日列為正式可用日期。Felo 已透過五個 Google 供應商提供此模型的路由服務。
在 Felo 上試用 Gemini 4 Carbon
評估 Carbon 最有效的方式,是交給它一項你已經知道答案的任務。開啟 Gemini 4 Carbon Playground,貼上真實文件或程式碼範例,並使用相同提示詞比較 LOW 與 HIGH 思考層級。如果結果符合預期,就建立 API 金鑰,將測試整合至自己的工作流程。
從 Gemini 4 Carbon 模型頁面 開始,查看現行試用條款、供應商路由與使用限制,再針對手上最困難的任務建立最小規模的測試流程。
本文也提供以下語言版本:English、简体中文、日本語、한국어、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。