
Felo 上的 GPT Image 2.6:將 GIF 轉換成影片鏡頭

Felo 上的 GPT Image 2.6:製作循環 GIF,透過 API 建立動作影格,再使用 Kling 將影格製作成動畫。包含程式碼與使用限制。
當你要求影片模型生成「一名揮劍的騎士」時,得到的揮劍動作往往只是勉強符合描述。劍刃會變得模糊,人物身體比例會在不同影格之間改變,攝影機也會自行加入沒有人要求的運鏡。
導演透過場面調度解決這個問題:角色站在哪裡、哪個動作先發生,以及動作在哪裡結束。Felo 上的 GPT Image 2.6 可以在瀏覽器中將這套動作規劃製作成 1.8 秒的循環 GIF,也可以透過影像 API 建立 3 × 3 影格表。這兩種方式的成本都比先支付影片模型的燈光、構圖與配樂生成費用,再決定動作來得低。
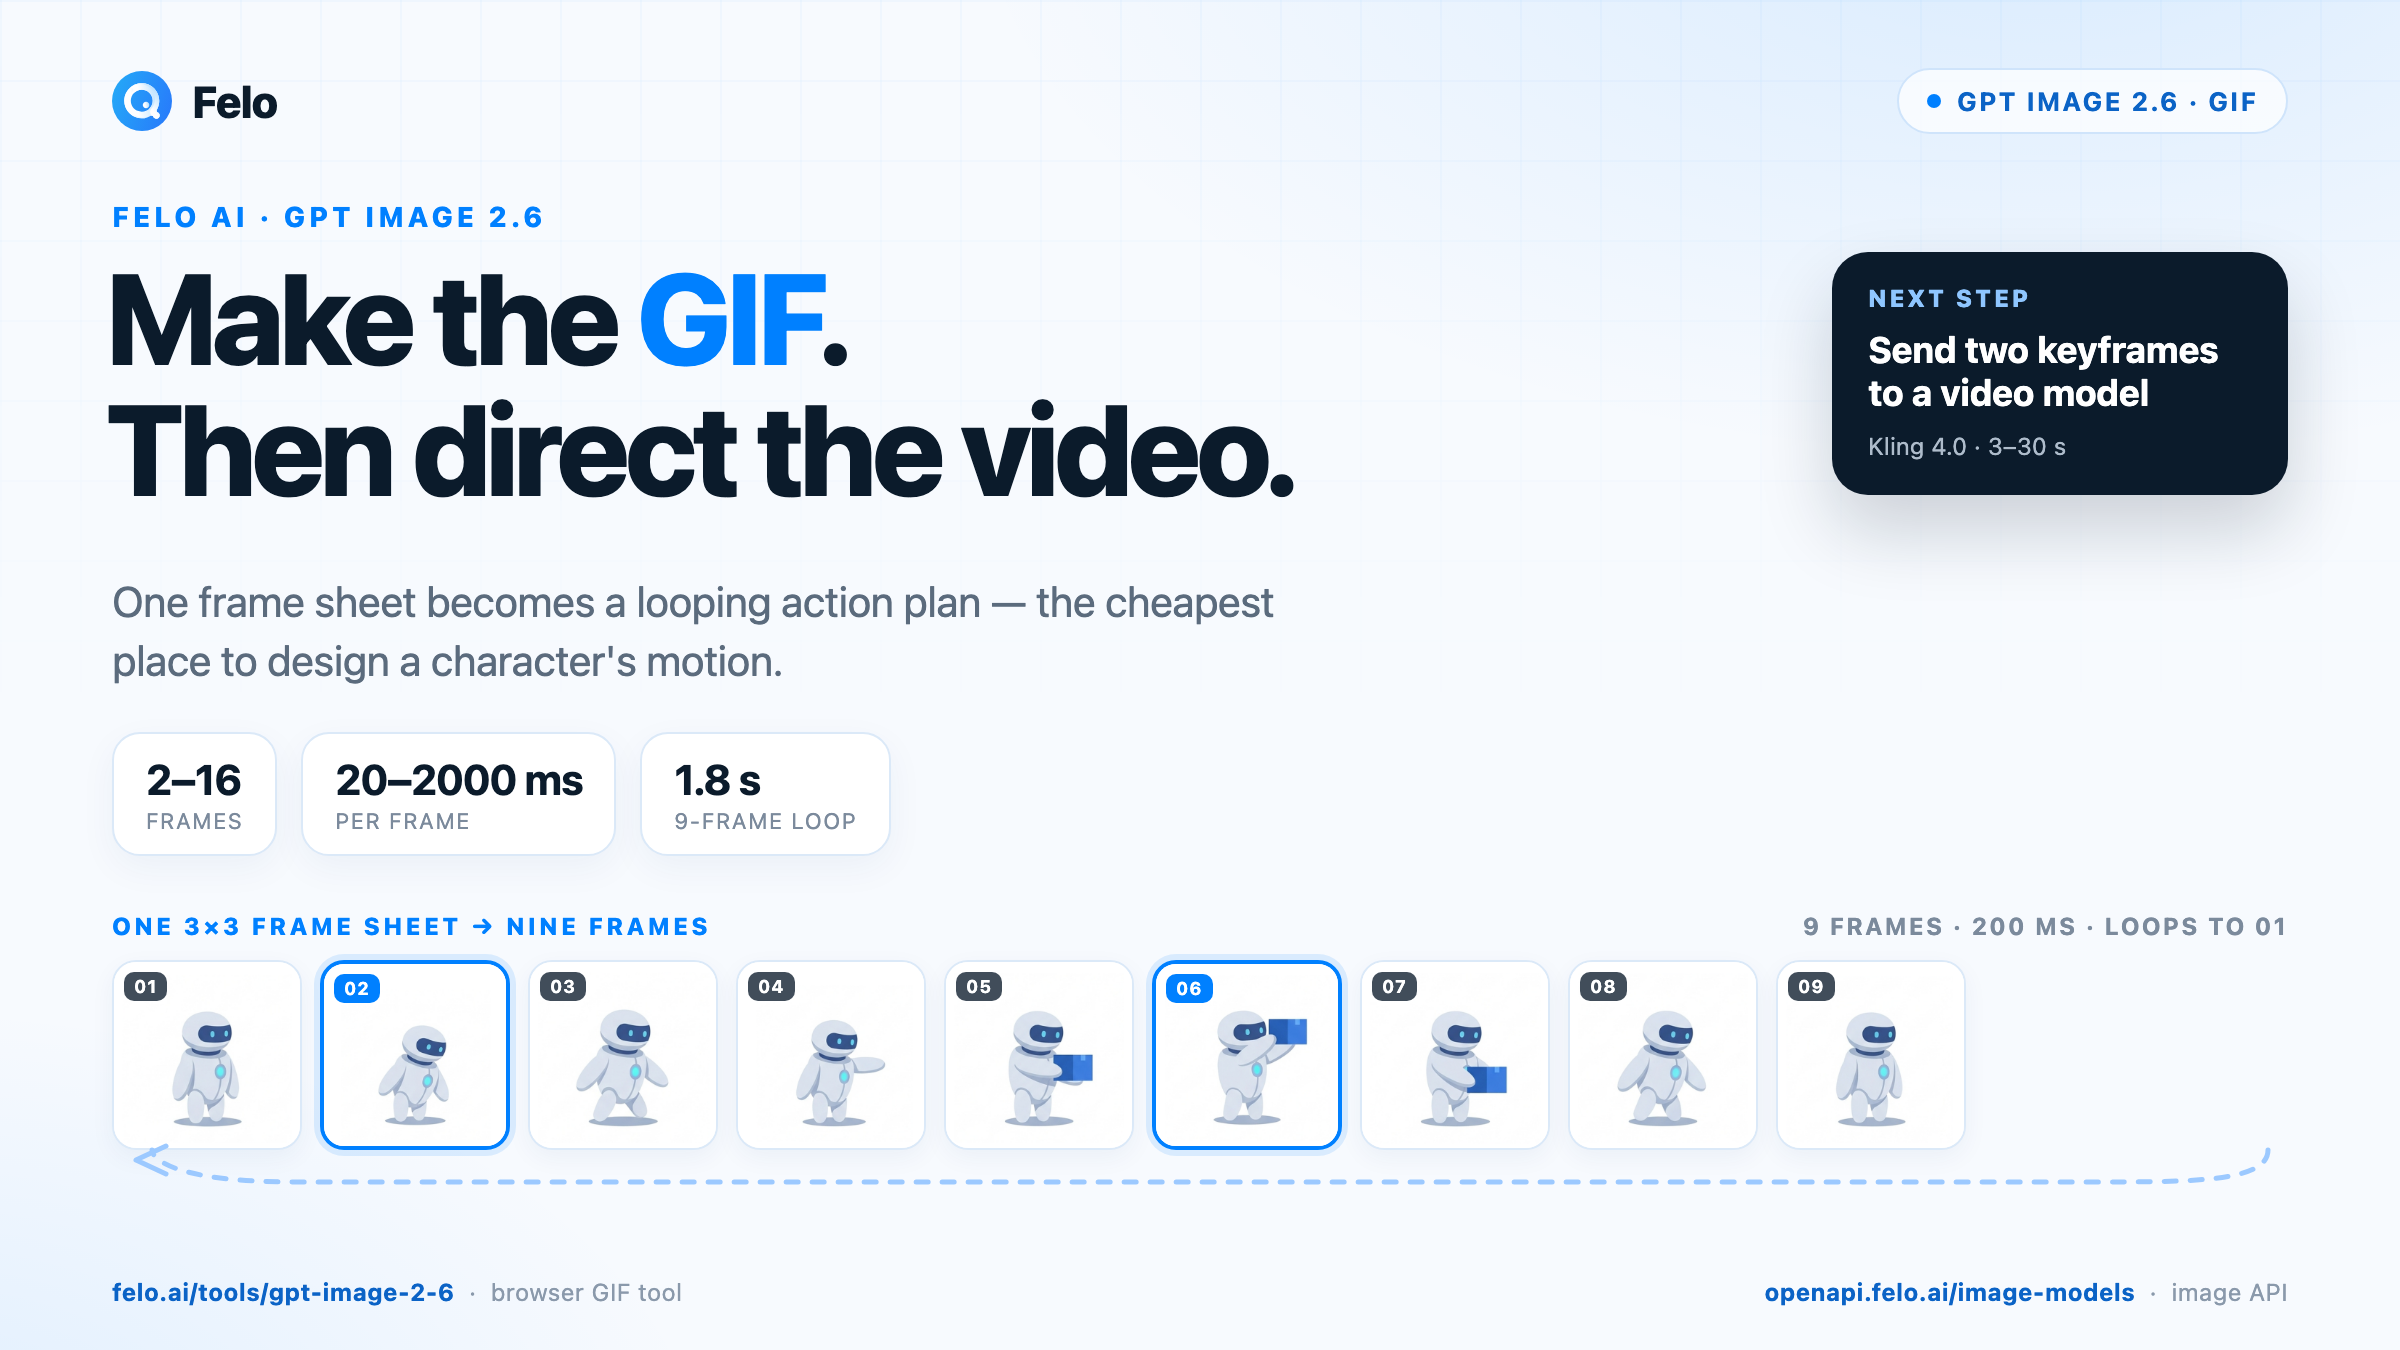
在 Felo 上使用 GPT Image 2.6 的兩種方式
在瀏覽器中使用:AI GIF 產生器
開啟 felo.ai/tools/gpt-image-2-6,描述你想生成的影像,並選擇模型。輸入框的預設模型為 GPT Image 2.6 Flare,輸出格式為 PNG。若要製作動畫,請開啟設定並選擇 GIF。只在提示詞中寫入「GIF」,不會改變輸出格式。
GIF 控制選項採用精簡設計:2 至 16 個影格、每個影格 20 至 2000 毫秒,起始影格尺寸為 512 × 512。Felo 的預設設定為 9 個影格,每個影格 200 毫秒,產生 1.8 秒的循環動畫。這個時間很短,確實如此,但足以判斷一個手勢是否清楚易懂。
你可以上傳參考影像、要求修改,或使用草圖控制項標記區域。第一次測試動作時,請使用單一主體、純色背景和一個動作。
輸出示意圖:由 9 個影格組成、每格 200 毫秒的循環動畫。瀏覽器工具會直接產生 GIF;下方的代理程式工作流程則會使用一張 3 × 3 影格表建立相同的影格。
透過 API 使用:適用於代理程式與應用程式
相同的兩款模型也收錄在 Felo 的影像模型目錄中,模型 ID 分別為 gpt-image-2.6-flare 和 gpt-image-2.6-sunburst。一組 API 金鑰涵蓋來自 8 家供應商的 18 款影像模型,因此代理程式可以比較或切換模型,不必開啟不同供應商的帳戶。
| GPT Image 2.6 Flare | GPT Image 2.6 Sunburst | |
|---|---|---|
| 設計用途 | 快速草稿與頻繁修改 | 細節豐富的影像與精準編輯 |
| 模型 ID | gpt-image-2.6-flare | gpt-image-2.6-sunburst |
| 輸入/輸出 | 文字、影像 → 影像 | 文字、影像 → 影像 |
| 適用情境 | 快速探索動作構想 | 維持不同分鏡中的角色一致性 |
| 標示價格 | 每 1M 輸入 tokens $5,每 1M 輸出 tokens $30 | 每 1M 輸入 tokens $5,每 1M 輸出 tokens $30 |
計價單位是 token,而非影像,因此解析度與參考影像數量都會影響費用。兩款模型的頁面都顯示限時免費試用標章;規劃正式製作前,請確認目前的條款與費率。
瀏覽器會輸出 GIF;影像 API 則會回傳靜態影像。這些模型的 output_format 列舉值為 png、jpeg 或 webp,因此代理程式需要使用生成的影格組合 GIF。下方的 API 章節會展示相關做法。
為什麼 GIF 比影片提示詞更適合作為初稿
影片模型是插值引擎。它們擅長填補兩個狀態之間的畫面,卻不擅長判斷哪些狀態才重要。文字提示詞只提供一句話供模型解讀;九格 GIF 則提供九個明確決策,涵蓋姿勢、輪廓與時間節奏。
九格影格預算也會迫使你做出選擇。每格 200 毫秒的設定,沒有空間容納模糊的「動態動作場景」。你必須明確指定:準備姿勢、蓄力、出擊、後續動作、回到起始姿勢。影片提示詞效果不佳,往往是因為從未明確決定動作內容。
循環效果帶來第二項限制。能夠順暢循環的 GIF 必須回到起始姿勢,而這也是鏡頭容易剪輯的原因。如果角色手臂在結尾停留於不同位置,下一個鏡頭的角色身體姿勢就會發生變化。
你也能在幾秒內檢查整段動畫。確認人物輪廓、雙手、道具,以及最後一格與第一格之間的銜接。代理程式可以比較影格,或要求視覺模型描述畫面變化,所有這些工作都能在支付影片生成費用前完成。
Felo 的工具頁面明確說明:「GIF 是無聲循環動畫。需要聲音、長場景或多個鏡頭時,請使用影片工具。」這句話正是這套工作流程的起點,而不是終點。
在瀏覽器中建立動作
以下是一套實用的循環設計流程,可在角色動作成為影片鏡頭前完成規劃。
1. 先固定角色外觀
不要從動畫開始。先生成角色的靜態參考影像,採用正面視角、中性姿勢與純色背景。製作動畫時,提示詞中的所有細節都必須保持一致:髮型、服裝顏色、配件、武器與身體比例。不同次生成之間容易出現一致性偏移,因此描述越具體,模型在影格之間需要自行補充的內容就越少。
2. 將動作寫成循環,而不是場景
實用的動作提示詞包含四個部分:
- 設定場景。畫面中有哪些物件、物件位於何處,以及外觀特徵。
- 指定一個動作。哪些部位移動,以及動作發生的順序。
- 固定不變的元素。攝影機、雙腳、標誌與雙手。
- 要求回到起點。結尾必須回到起始姿勢。
例如:
一名穿著芥末黃色外套的快遞員站在淺色石板街道上,側面視角,全身入鏡,固定攝影機。角色轉移身體重心,伸手進入郵差包,取出一個藍色小包裹,並將包裹舉向前方。保持外套、郵差包與攝影機不動。接著放下包裹,回到起始姿勢。讓動作形成流暢循環。簡單背景,沒有文字。
這個提示詞刻意保持簡單。這裡的簡單反而是優點:單一明確動作搭配九個影格,在 512 × 512 的尺寸下就能清楚呈現。人群、雨景與攝影機運鏡可以留給影片模型處理。
3. 在設定中選擇 GIF,從小規模開始
設定 512 × 512、9 個影格,以及每格 200 毫秒。接著生成。在基本動作清楚呈現前,不要增加影格數量。
循環效果出現問題時,請依照以下順序修正:先減少影格並簡化動作,再延長每格時間,最後才增加需要保持一致的細節。
4. 檢查銜接處,而不只是中間影格
觀看循環動畫兩次。最後一格與第一格之間的銜接,是大多數問題出現的位置:肩膀突然跳動、道具換手,或背景發生位移。
接著一次只修改一個變數。新的姿勢構想代表新的提示詞;時間調整則代表修改影格數量或每格時間。兩者混在一起修改,就無法判斷哪項調整產生了效果。
從 GIF 到影片:兩種交接方式
Felo 的影片 API 不支援動畫 GIF 輸入。它接受靜態影像或影片,因此交接前需要一個轉換步驟。以下兩種方式都很實用,另外還有第三種方式可以保留 GIF 作為最終成果。
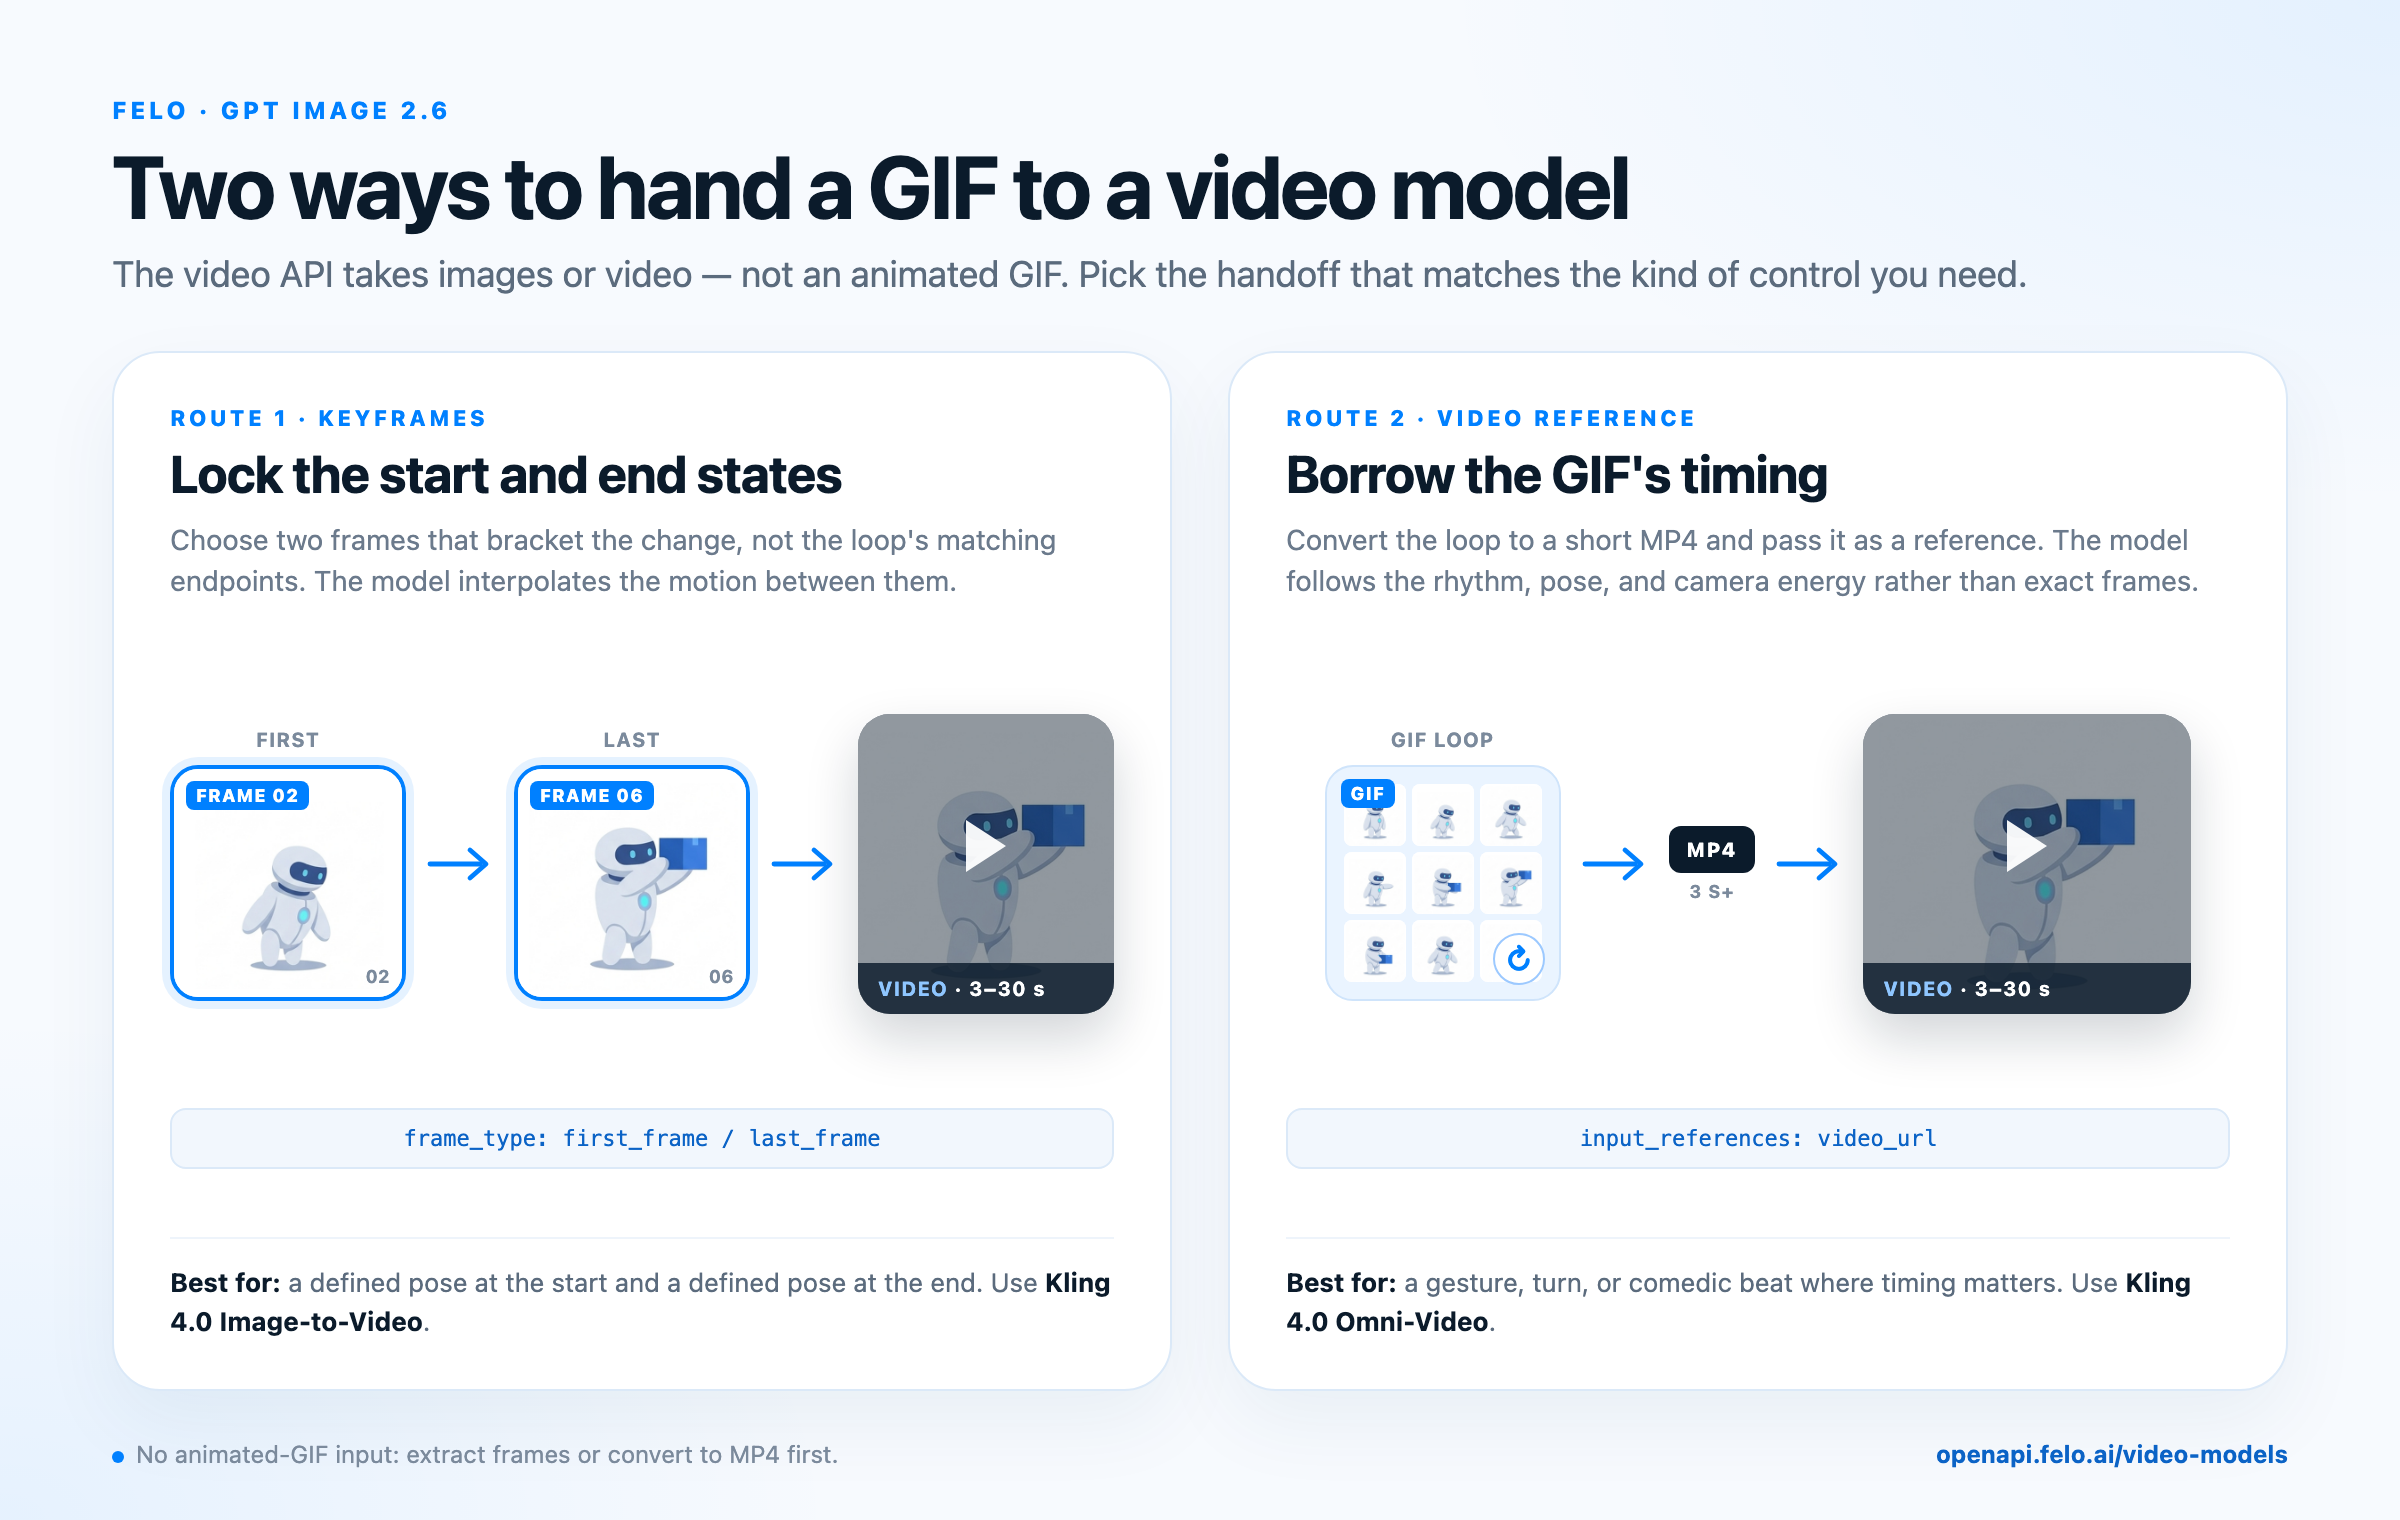
關鍵影格固定起始與結束狀態;影片參考則沿用 GIF 的時間節奏。
方式 1:關鍵影格,適用於明確的起始與結束狀態
選擇能夠界定目標動作變化的兩個影格。以快遞員為例,應選擇第 2 格(轉移重心)與第 6 格(向前舉起包裹),而不是循環動畫中刻意設計成相同的第一格與最後一格。將兩張影像作為 frame_images 傳送,並將 frame_type 設定為 first_frame 或 last_frame。
這樣就能固定你選定的起始與結束狀態。提示詞只需要描述兩張影像無法呈現的內容:攝影機移動、燈光與節奏。
Kling 4.0 Image-to-Video 很適合這種用途。模型頁面將 frame_images 列為支援參數,並說明可生成 3 至 30 秒、具有立體聲音訊的影片片段。輸入選定的兩個姿勢後,模型會在兩者之間插補動作。
關鍵影格方式的簡短提示詞:
同一名穿著相同芥末黃色外套的快遞員,站在相同的石板街道上,伸手進入郵差包並舉起一個藍色包裹。攝影機緩慢推近,柔和的午後陽光,淺景深。保持角色的臉部、服裝與包裹不變。自然的街道環境音。
影片模型會填補兩個姿勢之間的動作。相較於要求模型根據一句話自行設計整套動作,這種方式需要模型發揮的創意空間更小。
方式 2:影片參考,適用於沿用原有節奏
如果你希望影片遵循 GIF 的節奏,可以將循環動畫轉換成短 MP4,再將它作為影片參考傳入。在影片 API 中,input_references 除了接受 image_url 參考影像,也接受 video_url 項目。
ffmpeg -stream_loop 1 -i action.gif -t 3 -movflags +faststart -pix_fmt yuv420p action.mp4
Kling 4.0 Omni-Video 是以參考素材為導向的選項。其頁面列出最多 5 段影片片段,每段長度為 3 至 30 秒,總長度不得超過 30 秒,並支援最多 10 張參考影像。你可以在同一個請求中傳送動作草圖與角色影像。
當時間節奏是重點時,請使用這種方式:例如三拍手勢、轉身或喜劇停頓。Omni-Video 支援 3–30 秒的影片參考,因此匯出前請將 GIF 延長至至少三秒;設定 12 個影格、每格 250 毫秒也能達到這個時間。
影片模型會遵循參考素材的大致節奏與姿勢,不會逐格重現原始動畫。如果你需要指定的起始與結束狀態,請使用關鍵影格。
或者保留 GIF
有些情況下,GIF 本身就是最終成果。循環貼圖、UI 狀態、社群貼文或遊戲精靈圖,都不需要影片模型或配樂。Felo 的 GPT Image 2.6 模型案例包括像素風水劍循環動畫、人物轉身眨眼,以及日文活動橫幅;這三種作品都以簡短且容易辨識的動作為核心。
這種格式也有實際限制:每格最多 256 色、沒有音訊,而且檔案大小會隨著尺寸與影格數量增加。純色與簡單背景能降低色彩限制帶來的影響。漸層與膚色則可能出現色帶。
GPT Image 2.6 API:提交、輪詢、取得結果
人類可以在瀏覽器中等待 GIF 生成完成。代理程式則需要清楚的任務規格才能完成這項工作。Felo 的 API 提供這套流程:提交、輪詢、取得結果。
影像端點為 POST https://openapi.felo.ai/api/v1/images/generations,並使用 bearer 金鑰進行驗證。端點會回傳 202 和 task_id。接著輪詢 GET /api/v1/images/generations/{task_id},直到 status 變成 succeeded,再從 outputs 讀取簽署的媒體 URL。
請求主體接受模型 ID、提示詞、quality、aspect_ratio、output_format,以及用於參考影像的 input_references。如果需要本機參考影像,請先透過 POST /api/v1/files 上傳。該端點接受 PNG、JPEG、GIF、WebP、MP4 及其他常見格式,檔案上限為 100 MiB,並會回傳檔案記錄。將回傳的 id 作為 input_references 中的 file_id 傳入。
對於需要 GIF 的代理程式,最精簡的方式是在一次影像呼叫中要求生成完整動作的分鏡表,再將影格切割出來。單一請求生成九個姿勢;切割流程具有確定性;GIF 則透過本機組合完成。這些影格也是影片步驟所需的素材,因此不必重複生成。
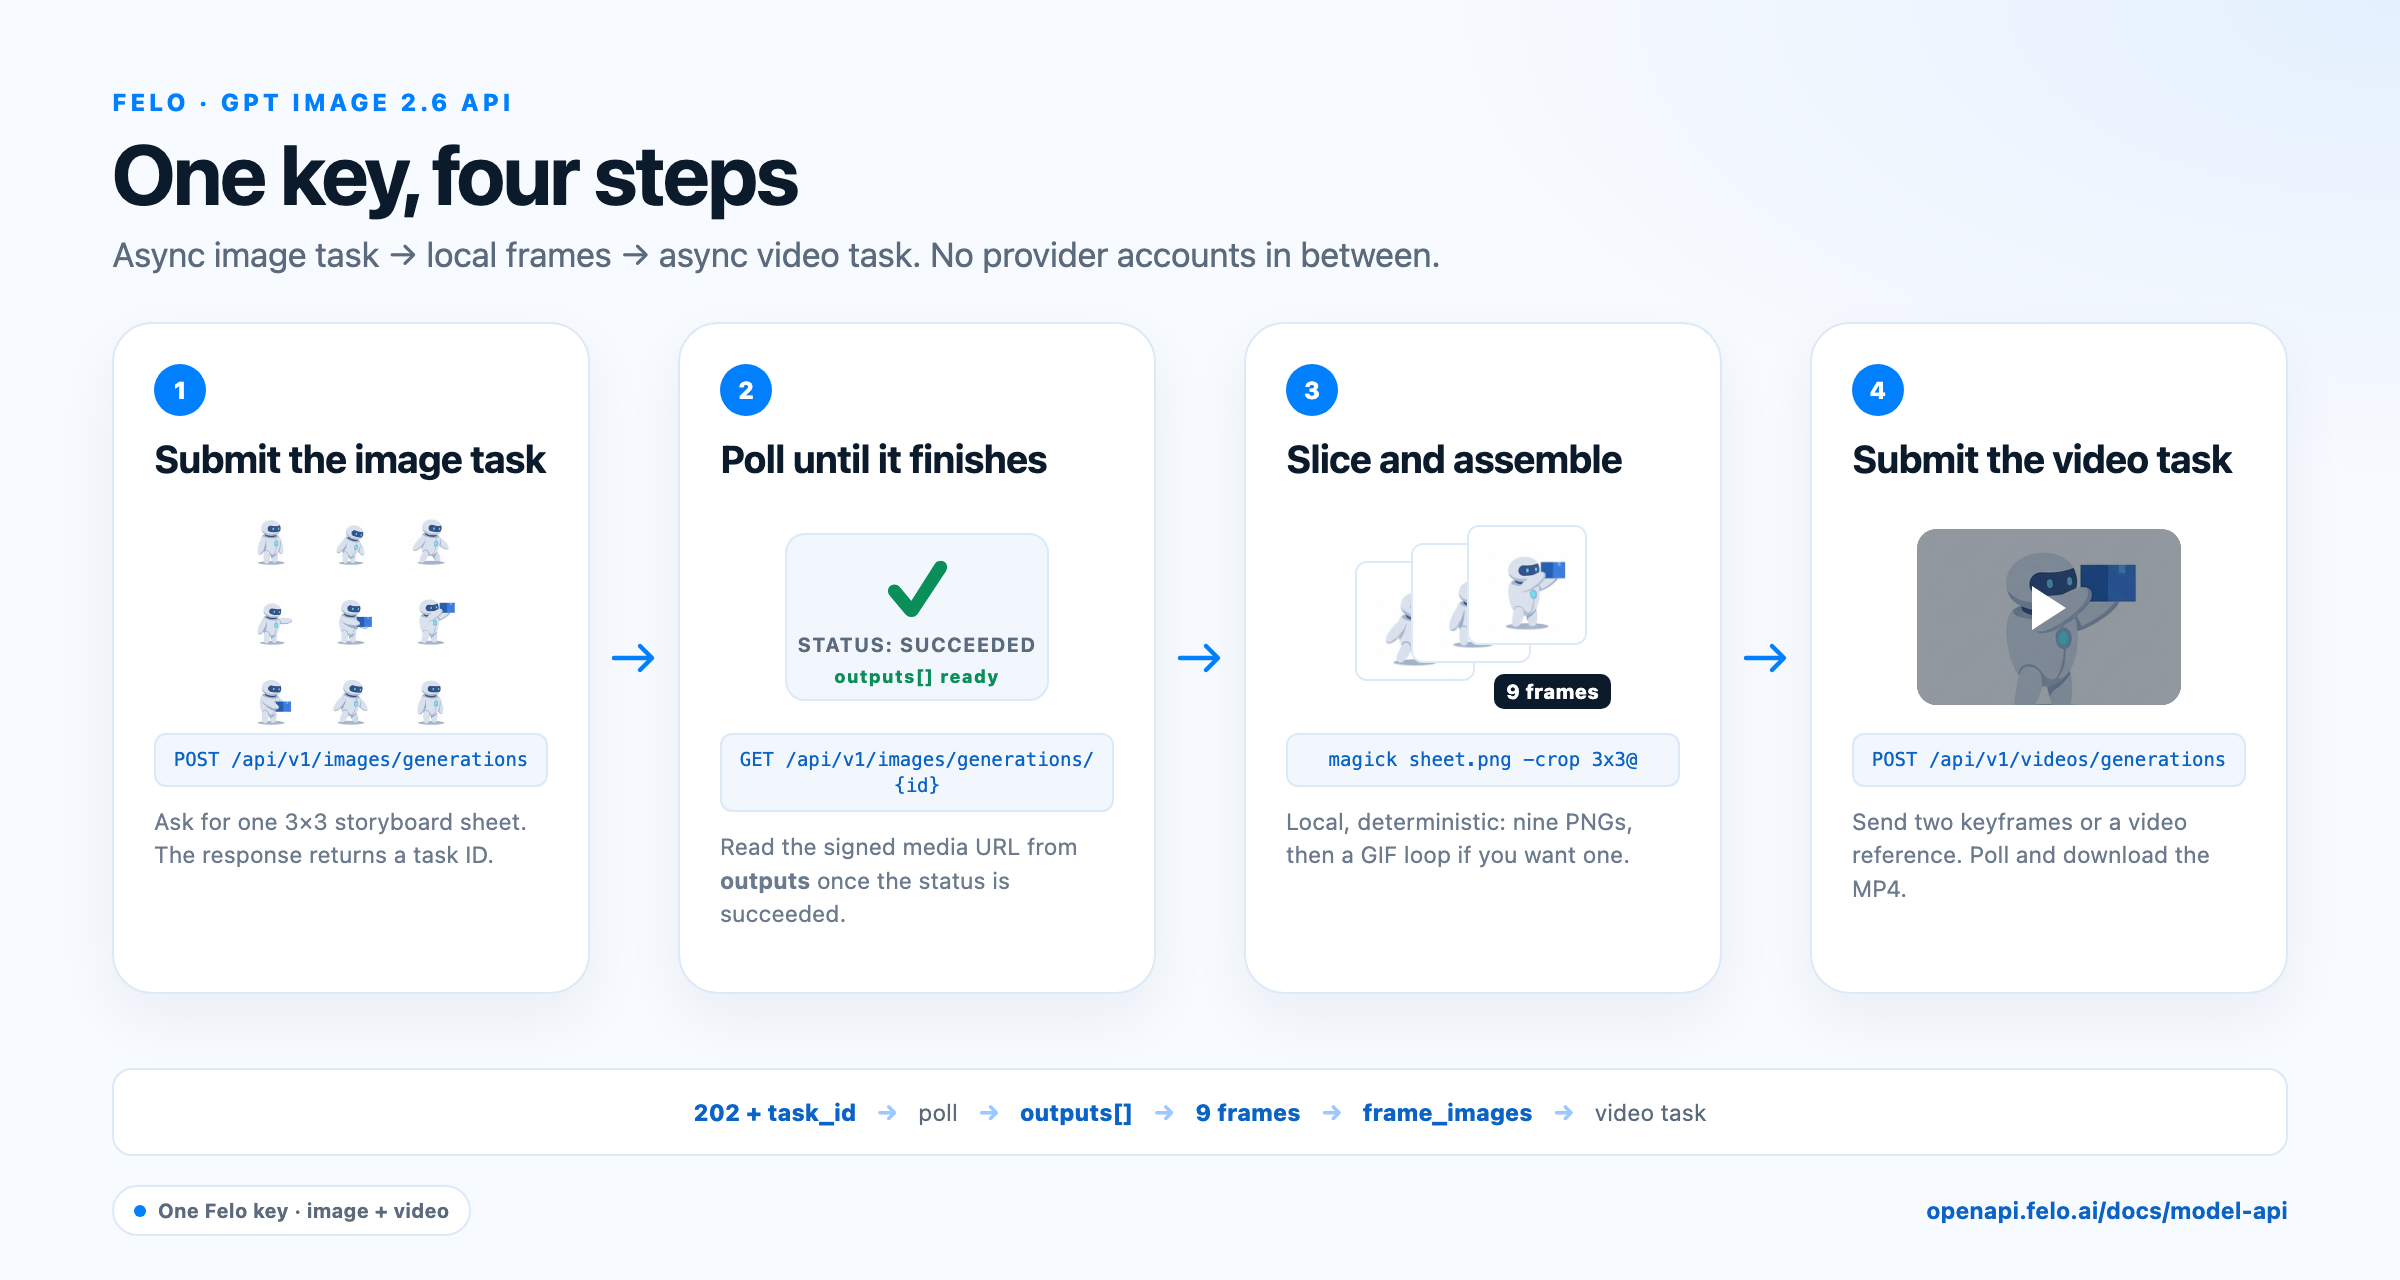
任務流程:提交影像任務、輪詢生成結果、在本機切割影格表,接著使用這些影格提交影片任務。
一次要求生成九個姿勢
這項請求可以使用以下分鏡提示詞:
一張 3 × 3 分鏡表,純白背景,九個大小相同的正方形面板緊密排列,面板之間沒有間隙。每個面板都出現同一名穿著芥末黃色外套的快遞員:側面視角、全身入鏡、身體比例、顏色與郵差包完全一致。第 1 格站立;第 2 格轉移重心;第 3 格伸手進入郵差包;第 4 格打開郵差包;第 5 格取出藍色包裹;第 6 格向前舉起包裹;第 7 格放下包裹;第 8 格將手放回身體側邊;第 9 格與第 1 格姿勢相同。平面光線、比例一致、沒有文字、沒有說明文字、沒有面板編號。
1K 影格表裁切後,每個區塊約為 340 像素,比瀏覽器工具的 512 像素影格更模糊;如果你的使用管道支援更大尺寸,請要求生成更大的正方形影像。切割前請檢查影格表:如果面板大小不一致或角色外觀發生變化,請使用更簡單的版面指示重新生成,而不是等裁切後再修正。
提交、切割、組合
import os
import time
import requests

BASE = "https://openapi.felo.ai/api/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['FELO_API_KEY']}"}

def poll(path, timeout=900, interval=5):
    deadline = time.time() + timeout
    while time.time() < deadline:
        response = requests.get(f"{BASE}{path}", headers=HEADERS, timeout=30)
        response.raise_for_status()
        task = response.json()
        if task["status"] in {"succeeded", "failed", "interrupted"}:
            if task["status"] != "succeeded":
                raise RuntimeError(task.get("error", task["status"]))
            return task
        time.sleep(interval)
    raise TimeoutError(path)

STORYBOARD_PROMPT = (
    "A 3x3 storyboard sheet on plain white, nine equal square panels edge to edge, "
    "the same courier in a mustard jacket in every panel, side view, full body, "
    "identical proportions and colors: standing, shifting weight, reaching into a "
    "satchel, opening it, pulling out a blue parcel, holding it forward, lowering it, "
    "hand at side, standing again. Flat lighting, consistent scale, no text, no gutters."
)

response = requests.post(
    f"{BASE}/images/generations",
    headers=HEADERS,
    json={
        "model": "gpt-image-2.6-sunburst",
        "prompt": STORYBOARD_PROMPT,
        "aspect_ratio": "1:1",
        "quality": "medium",
    },
    timeout=60,
)
response.raise_for_status()

result = poll(f"/images/generations/{response.json()['task_id']}")
output = result["outputs"][0]
sheet_url = output["url"] if isinstance(output, dict) else output
with open("sheet.png", "wb") as file:
    file.write(requests.get(sheet_url, timeout=60).content)
接著在本機切割影格表並組合循環動畫:
magick sheet.png -crop 3x3@ +repage -resize 512x512! frame-%02d.png
magick -delay 20 -loop 0 frame-*.png action.gif   # 20/100 s = 200 ms per frame
ImageMagick 6 使用者可以將 magick 替換成 convert。提示詞要求面板之間沒有間隙,因此裁切結果會保持均勻。
將兩個關鍵影格傳送至影片模型
def upload(path):
    with open(path, "rb") as file:
        response = requests.post(
            f"{BASE}/files", headers=HEADERS, files={"file": file}, timeout=60
        )
    response.raise_for_status()
    return response.json()["id"]

VIDEO_PROMPT = (
    "The same courier on the same stone street reaches into the satchel and holds "
    "out a blue parcel. Slow push-in, soft late-afternoon light, shallow depth of "
    "field. Keep the face, clothing, and parcel unchanged."
)

# Panels 2 and 6 bracket the change; the loop's matching endpoints do not.
first_id = upload("frame-01.png")
last_id = upload("frame-05.png")

video = requests.post(
    f"{BASE}/videos/generations",
    headers=HEADERS,
    json={
        "model": "kling-4.0/image-to-video",
        "prompt": VIDEO_PROMPT,
        "duration": 5,
        "resolution": "720p",
        "frame_images": [
            {"type": "image_url", "frame_type": "first_frame",
             "image_url": {"file_id": first_id}},
            {"type": "image_url", "frame_type": "last_frame",
             "image_url": {"file_id": last_id}},
        ],
    },
    timeout=60,
)
video.raise_for_status()
video_task = video.json()["task_id"]
使用相同方式輪詢影片任務,並下載簽署的輸出 URL。端點為 POST https://openapi.felo.ai/api/v1/videos/generations;任務包含與影像任務相同的 status 和 outputs。完整的影片端點目錄請參閱影片模型頁面。
將工作流程整合至代理程式
代理程式可以用相當於數張影像的成本生成多張動作分鏡表、比較結果,再決定是否投入影片生成費用。它也能記錄每個提示詞對應的影格表,這是人類透過 UI 點擊操作時難以做到的事。
由於同一組金鑰涵蓋聊天、影像與影片模型,整套流程可以在單一代理程式中完成:規劃模型撰寫動作節拍,影像呼叫生成影格表,視覺模型檢查一致性,最後由影片呼叫完成鏡頭。Felo 提供相容於 OpenAI 與 Anthropic 的 base URL,以及 Codex、Claude Code、DeepSeek Harness、OpenClaw 和其他代理程式用戶端的設定指南,因此現有代理程式不必重新建置,就能連接這個平台。
這套流程無法解決的問題
GIF 優先的方法可以減少動作設計中的模糊空間,但無法讓影片模型達到逐格精準的程度。
- 動作仍會產生偏移。影片模型會進行插值;兩個關鍵影格之間的手部位置或衣物皺褶可能發生變化。參考影像有助於維持一致性,但仍需檢查結果。
- 短片就是短片。2 至 16 個影格只能呈現手勢,無法構成完整場景。你可以使用多個手勢建立場景,並讓影片模型處理轉場。
- 影格中的文字很脆弱。不同影格之間的字體可能出現晃動。標題應在設計工具中加入,而不是放進動畫。
- 模型清單會變動。試用條款與支援參數屬於即時資料,因此將模型 ID 整合至正式環境前,請確認模型頁面或 Playground 的資訊。
常見問題
GPT Image 2.6 可以在 Felo 上生成動畫 GIF 嗎?
可以,使用瀏覽器工具即可。選擇 GPT Image 2.6,開啟設定並選擇 GIF。面板支援 2 至 16 個影格、每格 20 至 2000 毫秒,起始尺寸為 512 × 512;9 個影格、每格 200 毫秒可生成 1.8 秒的循環動畫。
我可以透過 API 呼叫 GPT Image 2.6 嗎?
可以。在 Felo API Platform 上使用模型 ID gpt-image-2.6-flare 或 gpt-image-2.6-sunburst,搭配 POST /api/v1/images/generations 即可。一組 Felo 金鑰就能完成呼叫;你不需要 OpenAI、Google 或快手帳戶。這項呼叫採用非同步方式:提交任務、輪詢任務狀態,再下載輸出結果。
影像 API 會回傳 GIF 檔案嗎?
目前不會。公開影像 API 為這些模型列出的格式為 png、jpeg 和 webp。代理程式仍能透過生成影格表或一系列靜態影像,再使用 ImageMagick 或 ffmpeg 在本機組合,製作 GIF。這種產物往往更實用,因為影片步驟也需要個別影格。
如何在 Felo 上將 GIF 轉換成影片?
將 GIF 作為動作規劃,再透過以下兩種方式之一交給影像轉影片 API:擷取兩個界定動作變化的關鍵影格,並以 frame_images 傳送;或將循環動畫轉換成 MP4,並作為 video_url 參考傳入。Felo 的影片 API 不接受動畫 GIF 直接輸入。
GPT Image 2.6 GIF 的費用是多少?
兩款模型都採用 token 計價:每 1M 輸入 tokens $5,每 1M 輸出 tokens $30,因此更高的解析度或更多參考影像會增加費用。瀏覽器工具與 API 都會使用你的 Felo 額度;請查看模型頁面,確認目前的費率與試用條款。
從循環動畫開始
改善 AI 影片的可靠方法,是停止一開始就要求生成影片。先將動作縮小到足以檢查的程度,製作循環動畫、修正銜接處,接著再將影格交給能夠添加燈光、攝影機運鏡與聲音的模型。
前往 Felo 上的 GPT Image 2.6,在瀏覽器中製作你的第一個循環動畫。準備好將這套工作流程整合至代理程式時,請瀏覽影像模型 API、建立金鑰,並傳送第一個請求。GIF 是動作規劃,影片則是最終演出。
本文也提供以下語言版本:English、简体中文、日本語、한국어、हिन्दी、Français、العربية、Русский、اردو、Bahasa Indonesia、Deutsch、Tiếng Việt、Türkçe、Italiano、ไทย、Español、বাংলা、Português。