01
Menampung seluruh konteks
Tetingkap konteks 1 juta token dan pengetahuan sehingga Jun 2026. Perbualan panjang, satu repositori penuh atau satu set dokumen kekal dalam satu tugasan.
Anthropic mengeluarkan Opus 5.5 pada 22 September 2026
Model pertama dalam keluarga Claude 5.5. Keupayaannya menyamai Claude Fable 5.1 pada kebanyakan kerja, kos operasinya 40% lebih rendah daripada Opus 5, dan outputnya lebih 30% pantas.
Kini dalam Felo Search
Claude Opus 5.5 tersedia dalam Felo Search untuk kerja dengan input panjang: memadankan angka antara fail, menjejaki dakwaan sehingga ke sumbernya, dan menghasilkan jawapan yang boleh anda sampaikan kepada orang lain.
01
Tetingkap konteks 1 juta token dan pengetahuan sehingga Jun 2026. Perbualan panjang, satu repositori penuh atau satu set dokumen kekal dalam satu tugasan.
02
Dalam ujian dalaman Anthropic, 16 daripada 18 laporan melepasi paras kualiti. Satu angka atau petikan yang direka sudah cukup untuk menggagalkan tugasan itu.
03
Anthropic merombak cara model berkomunikasi: maklumat terpenting didahulukan, dan laporannya menyatakan dengan jelas apa yang selesai, apa yang ditemui dan apa yang masih terbuka.
Panduan pantas
Claude Opus 5.5 muncul dalam pemilih model bersama model terkemuka lain dalam akaun anda.
Perbezaan Opus 5.5
Anthropic menekankan kecekapan, bukan skor penanda aras yang lebih tinggi: lebih sedikit token setiap tugasan, harga setiap token lebih rendah dan kos 40% lebih rendah pada beban kerja biasa. Inilah yang menjadikan kerja agen berjam-jam mampu dimiliki.
01
Anthropic melaporkan seorang penguji awal mengaudit dan membaiki pangkalan kod 200,000 baris dalam kurang tiga jam, sedangkan Opus 5 mengambil lebih 20 jam dan menggunakan 2.5 kali lebih banyak token.
02
Deloitte melaporkan bahawa pada tahap effort paling rendah pun Opus 5.5 menemui 72% pepijat yang diketahui dalam semakan kod, berbanding 56% pada Opus 5 di high, dengan lebih sedikit amaran palsu.
03
Tulisannya lebih pendek dan lebih tersusun. Box melaporkan jawapan 40% kurang berjela tanpa kehilangan ketepatan, dengan satu pertiga token yang digunakan Opus 5.
Pemilihan model
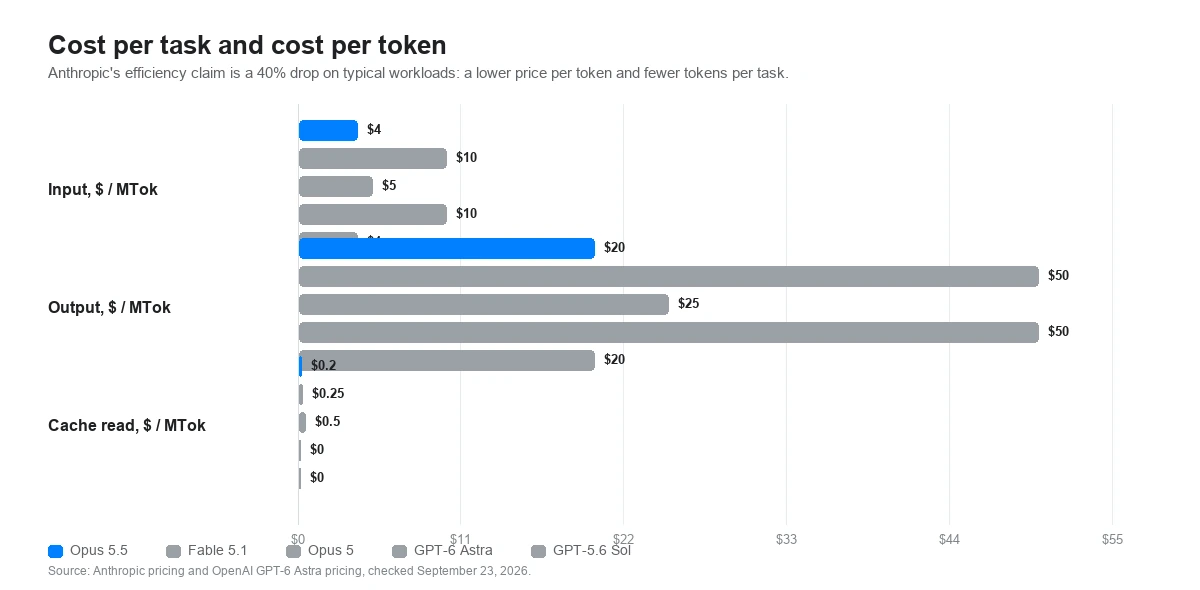
Harga di bawah ialah kadar API awam rasmi setiap juta token, bukan harga langganan atau penggunaan Felo. Baris effort sama pentingnya dengan baris harga: prompt yang sama boleh berbeza kosnya bergantung dari mana setiap model bermula.
Kadar API awam dan nilai lalai disemak pada 23 September 2026 terhadap pengumuman Claude Opus 5.5 oleh Anthropic, halaman model Claude Platform dan halaman GPT-6 Astra oleh OpenAI. Harga setiap token hanyalah sebahagian daripada jumlah kos tugasan. Dakwaan kecekapan Anthropic ialah penurunan kos 40% pada beban kerja biasa, yang menggabungkan harga setiap token lebih rendah dengan lebih sedikit token setiap tugasan.
Keputusan yang diterbitkan Anthropic
Anthropic menerbitkan angkanya sendiri bersebelahan Fable 5.1, Opus 5, GPT-6 Astra dan GPT-5.6 Sol. Dua daripada empat carta di bawah menunjukkan ketepatan berbanding kos setiap tugasan dan bukan ketepatan semata-mata, kerana itulah perbandingan yang dibuat Anthropic.
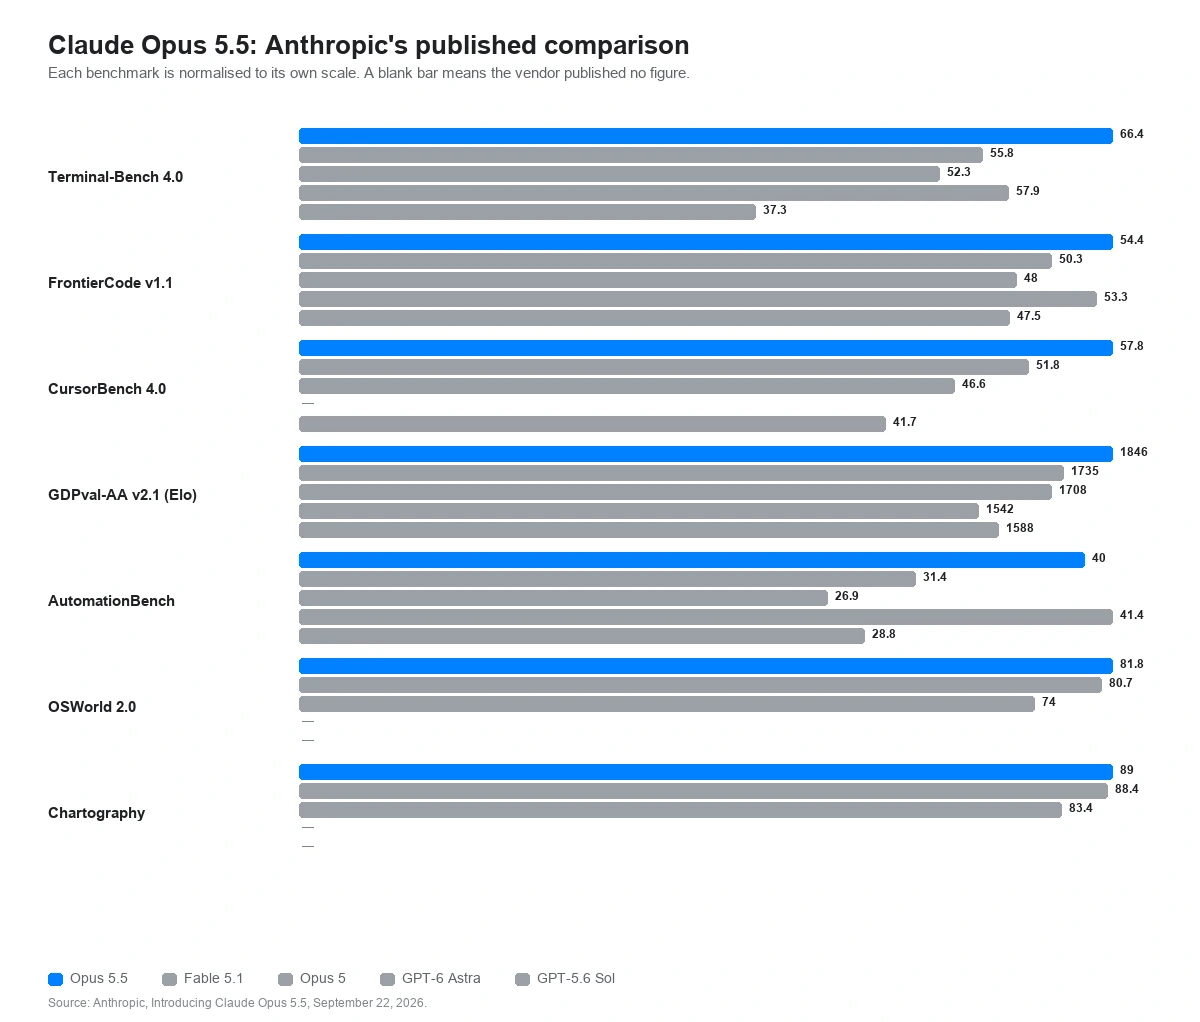
Perbandingan penuh yang diterbitkan
Pengekodan agen, kerja pengetahuan, aliran kerja perniagaan, penaakulan merentas disiplin, penyelidikan saintifik, penggunaan komputer dan pembacaan carta pada kelima-lima model yang diukur.
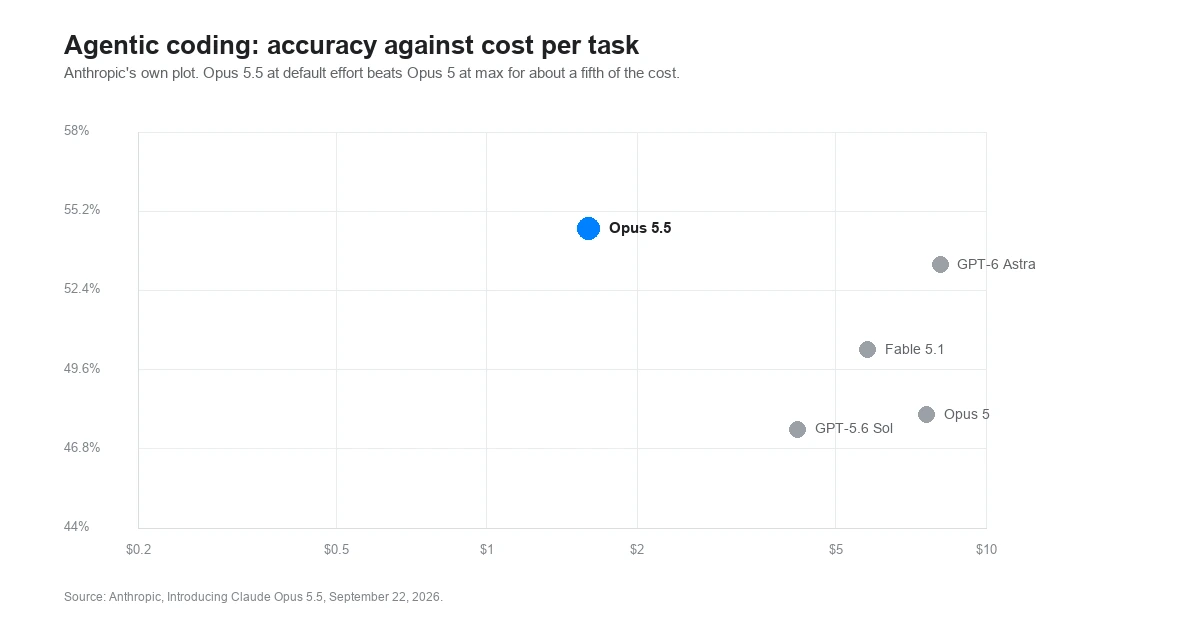
Pengekodan agen
Terminal-Bench 4.0, FrontierCode v1.1 dan CursorBench 4.0, diplot sebagai ketepatan berbanding kos setiap tugasan.
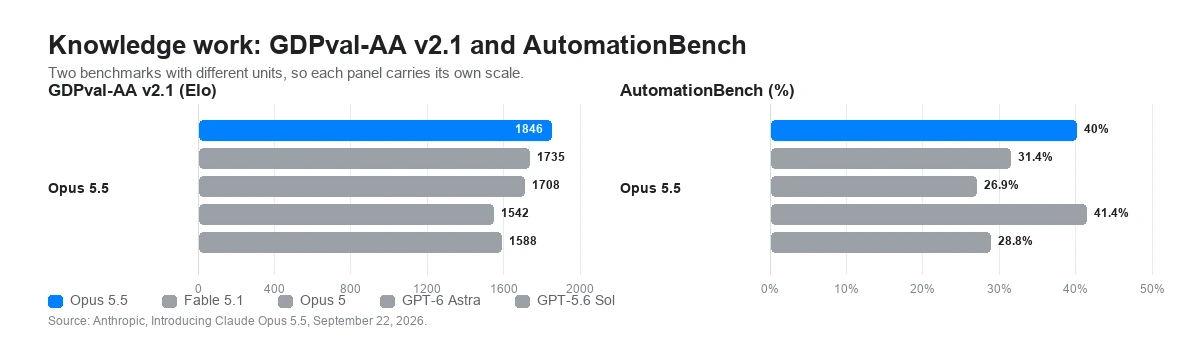
Kerja pengetahuan
GDPval-AA v2.1 merentas 44 pekerjaan, AutomationBench dan WANDR, penanda aras pengumpulan data Perplexity.
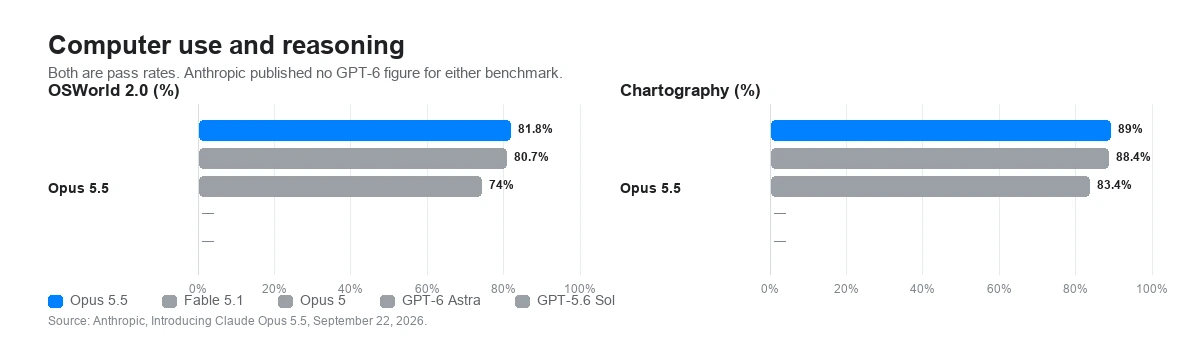
Penggunaan komputer dan penaakulan
OSWorld 2.0, Humanity's Last Exam dan Chartography, yang terakhir mengukur ketepatan membaca nilai daripada carta.
Ketepatan berbanding kos setiap tugasan
Tesis utama Anthropic bukan skor lebih tinggi pada sebarang kos, tetapi skor yang sama atau lebih baik dengan sebahagian kecil kos setiap percubaan.
Angka terbitan vendor. Kecuali dinyatakan sebaliknya, Anthropic menjalankan Opus 5.5 dengan penaakulan adaptif pada max effort dan menilainya dengan pengadang pengeluaran diaktifkan. Apabila pengadang itu masuk campur, tugasan keselamatan siber diselesaikan oleh Opus 4.8 dan tugasan biologi oleh Opus 5, yang mungkin merendahkan angka Opus 5.5 yang diterbitkan pada penanda aras tersebut. Angka GPT-6 Astra dan GPT-5.6 Sol ialah seperti yang dilaporkan OpenAI. Jurang penanda aras antara vendor ialah petunjuk lemah tentang perbezaan sebenar, seperti yang Anthropic sendiri katakan tentang angka-angka ini.
Jika anda sudah menjalankan Opus 5
Anthropic menyenaraikan empat perubahan yang tidak serasi untuk integrasi yang sudah berjalan pada Claude Opus 5, ditambah satu lagi yang mengubah bentuk respons tanpa menggagalkan permintaan. Elok dibaca sebelum menukar ID model, kerana tiga daripadanya memulangkan ralat 400 dan bukan merosot secara senyap.
01
Pada Opus 5, penaakulan boleh dimatikan pada high dan ke bawah. Pada Opus 5.5 ia sentiasa aktif, dan kedua-dua penyahtindasan serta belanjawan token manual memulangkan ralat 400. Effort menjadi satu-satunya kawalan, dan nilai lalainya berubah daripada high kepada medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice yang ditetapkan kepada "any" atau kepada nama alat tertentu memulangkan ralat 400, termasuk pada titik akhir pengiraan token. Gunakan auto bersama penggunaan alat yang ketat atau output berstruktur, dan nyatakan dalam prompt bila alat itu terpakai.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Setiap blok penaakulan merekodkan model yang menghasilkannya. Opus 5.5 membaca blok daripada Opus 5 dan model Opus, Sonnet serta Haiku yang lebih awal, tetapi tidak daripada Fable atau Mythos. Jika penghala memindahkan perbualan ke model lain, pusingan seterusnya berjalan tanpa penaakulan sebelumnya.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 mengekalkan penaakulan; model lain membuangnya
04
Dalam Claude API dan Google Cloud, alat computer_20251124 memulangkan ralat 400. Isytiharkan toolset computer_toolset_20260801, buang pengepala beta dan sesuaikan gelung agen untuk blok member tool_use. Pada Amazon Bedrock alat lama masih berfungsi.
computer_20251124 -> computer_toolset_20260801
Kerana penaakulan tidak boleh dimatikan, yang dilaraskan ialah effort. Opus 5.5 menyokong kelima-lima tahap dan bermula pada medium, satu tahap di bawah Opus 5. Nasihat Anthropic ialah mengulang sapuan pada penilaian anda sendiri dan bukan membawa tetapan lama, serta menetapkan max_tokens yang longgar pada tahap tinggi, kerana token penaakulan dikira pada had itu walaupun teks penaakulannya tidak dipulangkan.
Effort ialah isyarat tingkah laku, bukan belanjawan token yang ketat: pada tahap rendah model tetap berfikir untuk masalah yang benar-benar sukar, cuma kurang daripada tahap tinggi. Anthropic juga menyatakan bahawa pada tahap yang sama Opus 5.5 cenderung berfikir lebih banyak setiap pusingan daripada Opus 5, terutamanya pada xhigh dan max, jadi tetapan yang dibawa daripada Opus 5 akan menghasilkan pusingan yang lebih panjang dan lebih mahal.
Di mana ia sesuai
Opus 5.5 berbaloi apabila sesuatu tugasan berjalan berjam-jam, merangkumi lebih banyak fail daripada yang mampu dipegang seorang, atau menghasilkan sesuatu yang perlu disemak orang lain. Ini kes yang digambarkan Anthropic dan penguji awalnya, bukan prompt sembang biasa.
Membawa perubahan menembusi repositori besar sehingga ujiannya lulus, bukan berhenti pada tampalan pertama yang kelihatan munasabah. Anthropic melaporkan migrasi 680,000 baris selesai dalam kurang sehari oleh seorang penguji.
Column, penguji yang dipetik Anthropic, melaporkan menemui pepijat dengan menyemak dokumentasi luaran bagi integrasi pihak ketiga yang dimodelkan secara salah beberapa commit lebih awal.
Bina modelnya dahulu, kemudian ringkasan satu halaman, dengan peringatannya tetap utuh. Anthropic melaporkan analisis penggabungan selesai dalam 63 minit berbanding 93 minit pada Opus 5, dengan separuh kos.
Model mewakilkan kepada subagen dan menyesuaikan tempo dengan belanjawan masa. Nasihat Anthropic ialah memberi seni bina berbilang agen isyarat masa berlalu supaya ia selari dan bukan bersiri.
01
Sertakan repositori, dokumen dan keperluan yang perlu diambil kira oleh jawapan yang berguna. Tetingkap 1 juta token ada untuk ini.
02
Katakan apa yang mesti benar sebelum kerja dianggap siap. Nasihat Anthropic untuk sesi tanpa pengawasan ialah menyimpan bahagian tugasan dalam senarai semak yang dikemas kini oleh model.
03
Jalankan tugasan yang sama pada Opus 5.5, Opus 5 dan Fable 5.1 dalam Felo. Bandingkan bukan sahaja jawapannya, tetapi juga ujian, peringatan dan penggunaan token.
Pilih Claude Opus 5.5 sebaik sahaja ia muncul dalam pemilih model akaun anda.
Cuba Opus 5.5 di FeloClaude Opus 5.5 ialah model Anthropic untuk pengekodan agen jangka panjang dan kerja pengetahuan, dikeluarkan pada 22 September 2026 sebagai model pertama keluarga Claude 5.5. Menurut Anthropic, keupayaannya menyamai Claude Fable 5.1 pada kebanyakan kerja dengan kos operasi 40% lebih rendah daripada Claude Opus 5.
Letakkan Claude Opus 5.5 bersebelahan model terkemuka lain dalam Felo, kemudian ujinya pada kerja yang anda tangguhkan kerana ia mengambil masa berjam-jam.
Cuba Opus 5.5 di FeloMulakan dari Felo AI Search dan pilih modelnya di tempat ia tersedia.