Diumumkan 30 September 2026 · Dilancarkan secara berperingkat

Gemini 4 Argonpenyelidikan panjang, ditulis penuh sampai habis

Model frontier pertama Google sejak Gemini 3, dibina untuk penaakulan mendalam dalam kerja panjang berbilang langkah. Siling outputnya naik daripada 64K token kepada 1M, dan angka terbitan Google lebih menonjol dalam kerja pengetahuan berbanding pengekodan.

Felo API masih dalam peringkat beta tertutup — akses kepada Gemini 4 Argon akan dibuka tidak lama lagi.
Seni utama Gemini 4 Argon: nama model di sisi angka 4 yang besar atas latar kecerunan biru
Seni pengumuman Google. Argon dilancarkan di bawah skema penamaan baharu, bukan sebagai kemas kini barisan Gemini 4.0, sebab itulah namanya tidak membawa nombor versi.
1M
Token output maksimum
Naik daripada 64K — satu laporan penuh dihasilkan dalam satu laluan.
2 $ / 10 $
Harga API pengenalan
Setiap juta token input dan output. Input cache diskaun 95%.
77.9%
DeepSWE v1.1
Skor yang dilaporkan Google, mendahului Claude Opus 5.5 dan GPT-6 Astra.
15%
Kadar halusinasi
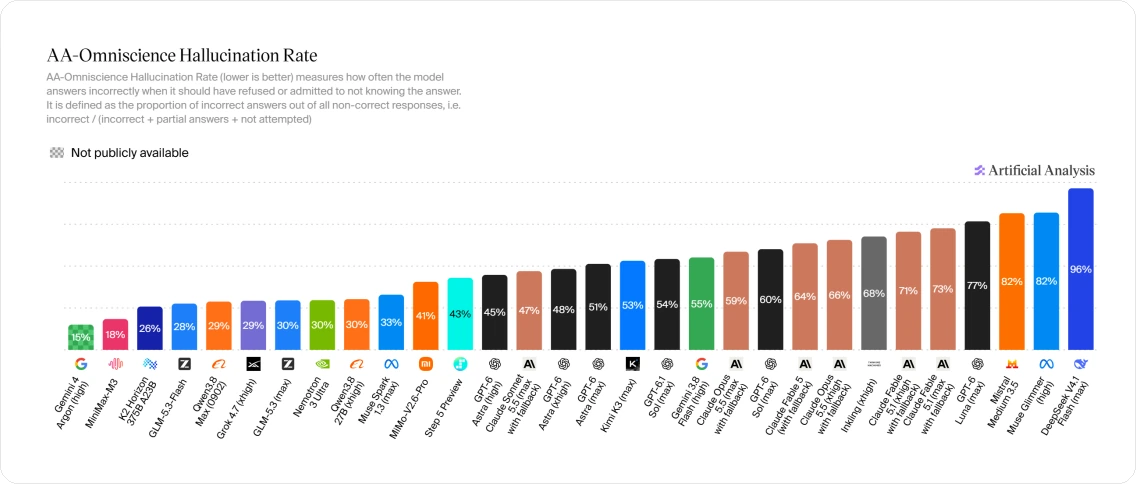
Kadar terendah yang diukur Artificial Analysis dalam kalangan model frontier.

Rajah dan carta di halaman ini datang daripada organisasi yang menerbitkannya, iaitu Google, Arena.ai dan Artificial Analysis; semuanya dipaparkan tanpa sebarang perubahan.

Status pelancaran

Argon belum tersedia secara umum. Inilah urutan kemunculannya.

Google mengeluarkan Argon secara berperingkat, dan peringkat pertama bukan untuk umum. Akses dalam Felo sedang disediakan seiring pelancaran ini.

Sudah tersedia

Pasukan pertahanan siber terpilih

Rakan terpilih dalam Fairwind Program Google menerima Argon dahulu, dan menerimanya tanpa pengadang siber.

Diumumkan seterusnya

Pelanggan API berbayar dan Google AI Ultra

Google berkata akses lebih luas bermula di sini. Tiada tarikh diberikan, dan langganan semata-mata tidak memberikannya hari ini.

Belum dijadualkan

Pembangun, perusahaan dan pengguna

Menyusul selepas peringkat berbayar. Google belum menetapkan garis masa untuk ketersediaan umum.

Akses Argon dalam Felo Search masih dalam proses. Halaman ini akan dikemas kini apabila ia dibuka.

Apa yang dikuasainya

Model yang dibina untuk menghabiskan kerja panjang, bukan menjawab pantas

Kekuatan Argon yang diterbitkan berkisar pada membaca, menaakul dan menulis panjang. Bentuknya berbeza daripada model frontier yang mengutamakan pengekodan dan sering dibandingkan dengannya.

Penaakulan yang bertahan sepanjang tugasan panjang

Google meletakkan Argon untuk kerja berbilang langkah yang berjalan berjam-jam, tempat model terdahulu melencong atau berhenti terlalu awal.

1M token output dalam satu laluan

Sebab yang dinyatakan Google: model yang ada ruang untuk berfikir panjang boleh menyelesaikan masalah sukar dalam satu laluan, bukan melalui banyak ulang-alik.

Kerja pengetahuan mendahului, bukan pengekodan

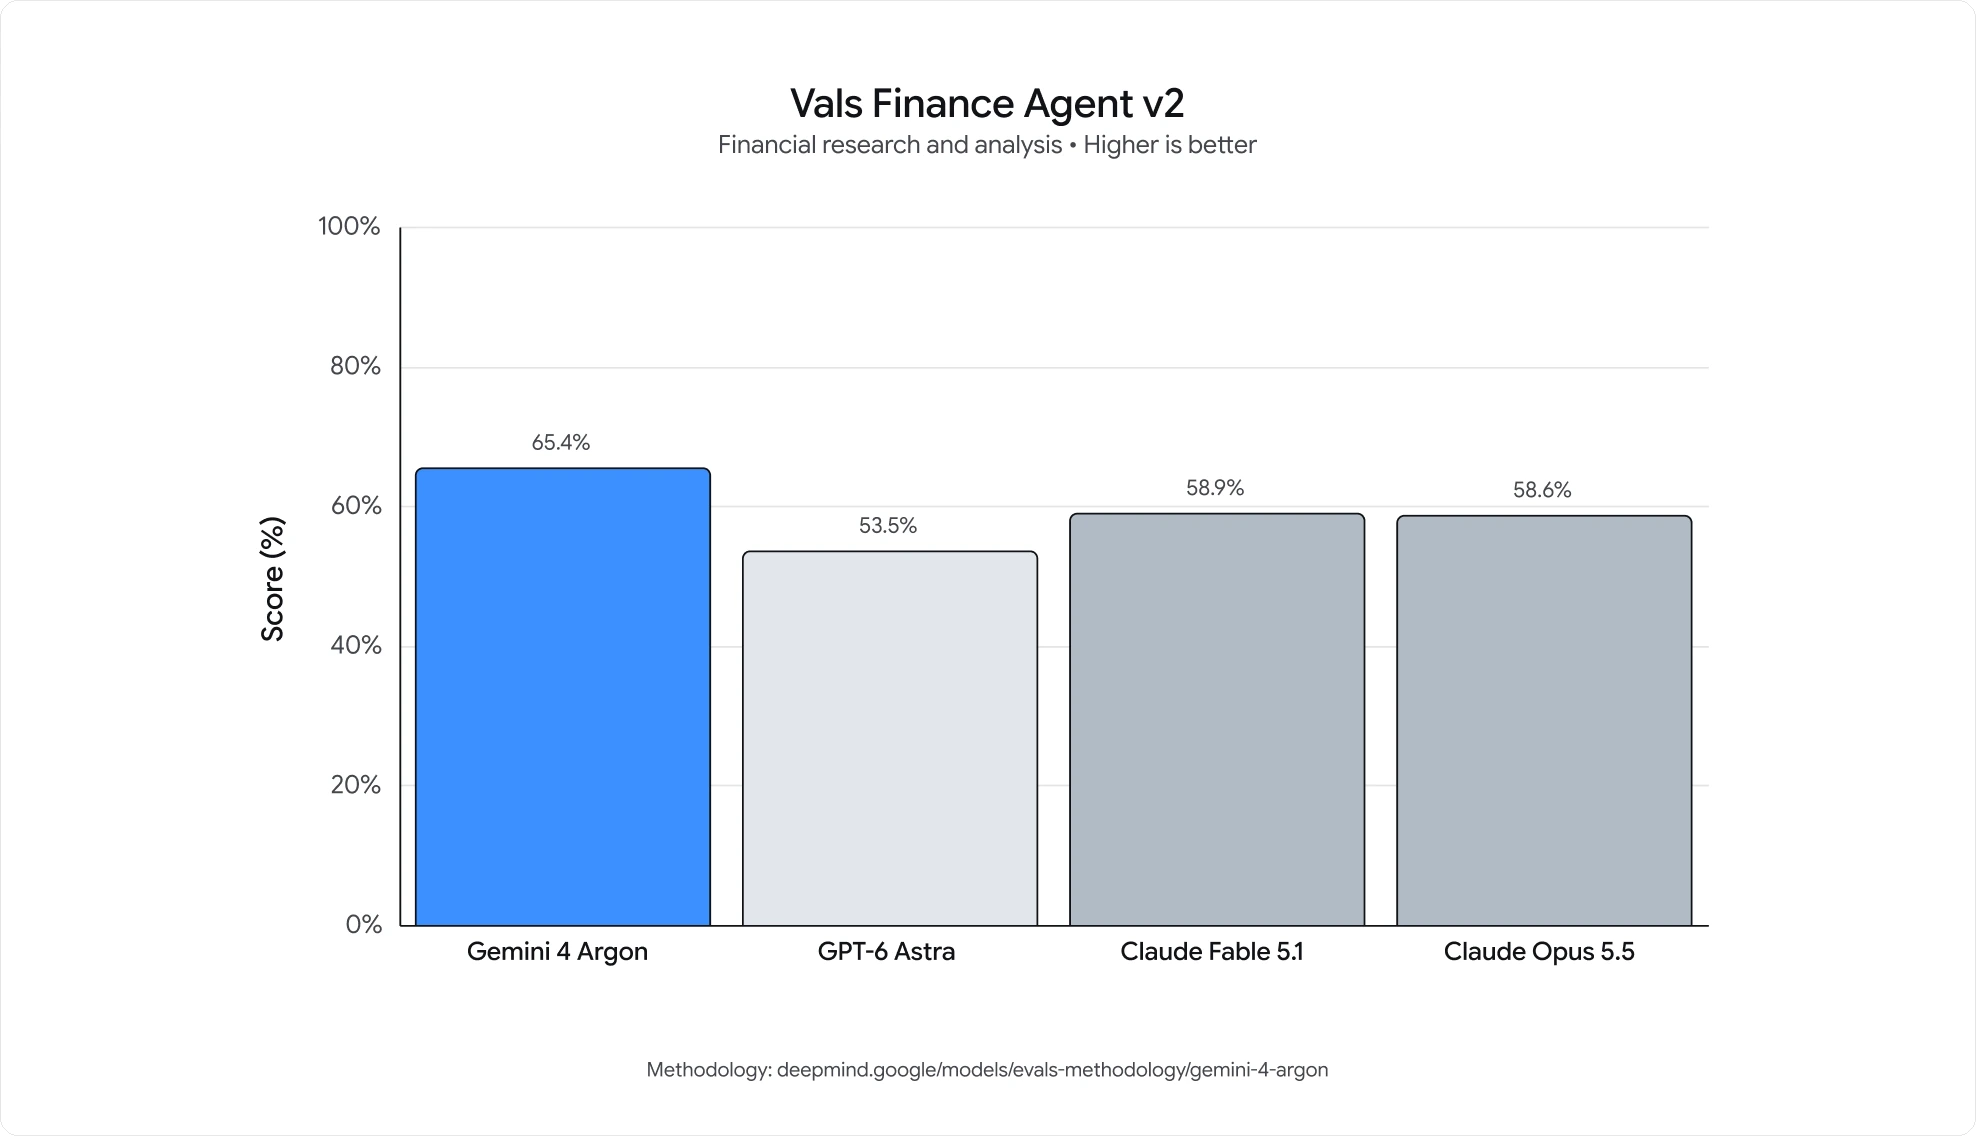
Jurang terlebar yang dilaporkan ialah pada Harvey's Legal Agent Benchmark dan Vals Finance Agent v2 — analisis undang-undang dan kewangan sebenar, bukan tugasan sintetik.

Pengambilan konteks panjang yang kekal tepat

Pada GraphWalks, yang menguji sama ada model benar-benar boleh menggunakan konteks 256K hingga 1M, Google melaporkan keunggulan lebih sepuluh mata berbanding model perdana lain.

Pemahaman video panjang

LVBench, yang mengukur pemahaman video panjang, dilaporkan pada 91.7% — skor tertinggi yang Google senaraikan untuk Argon.
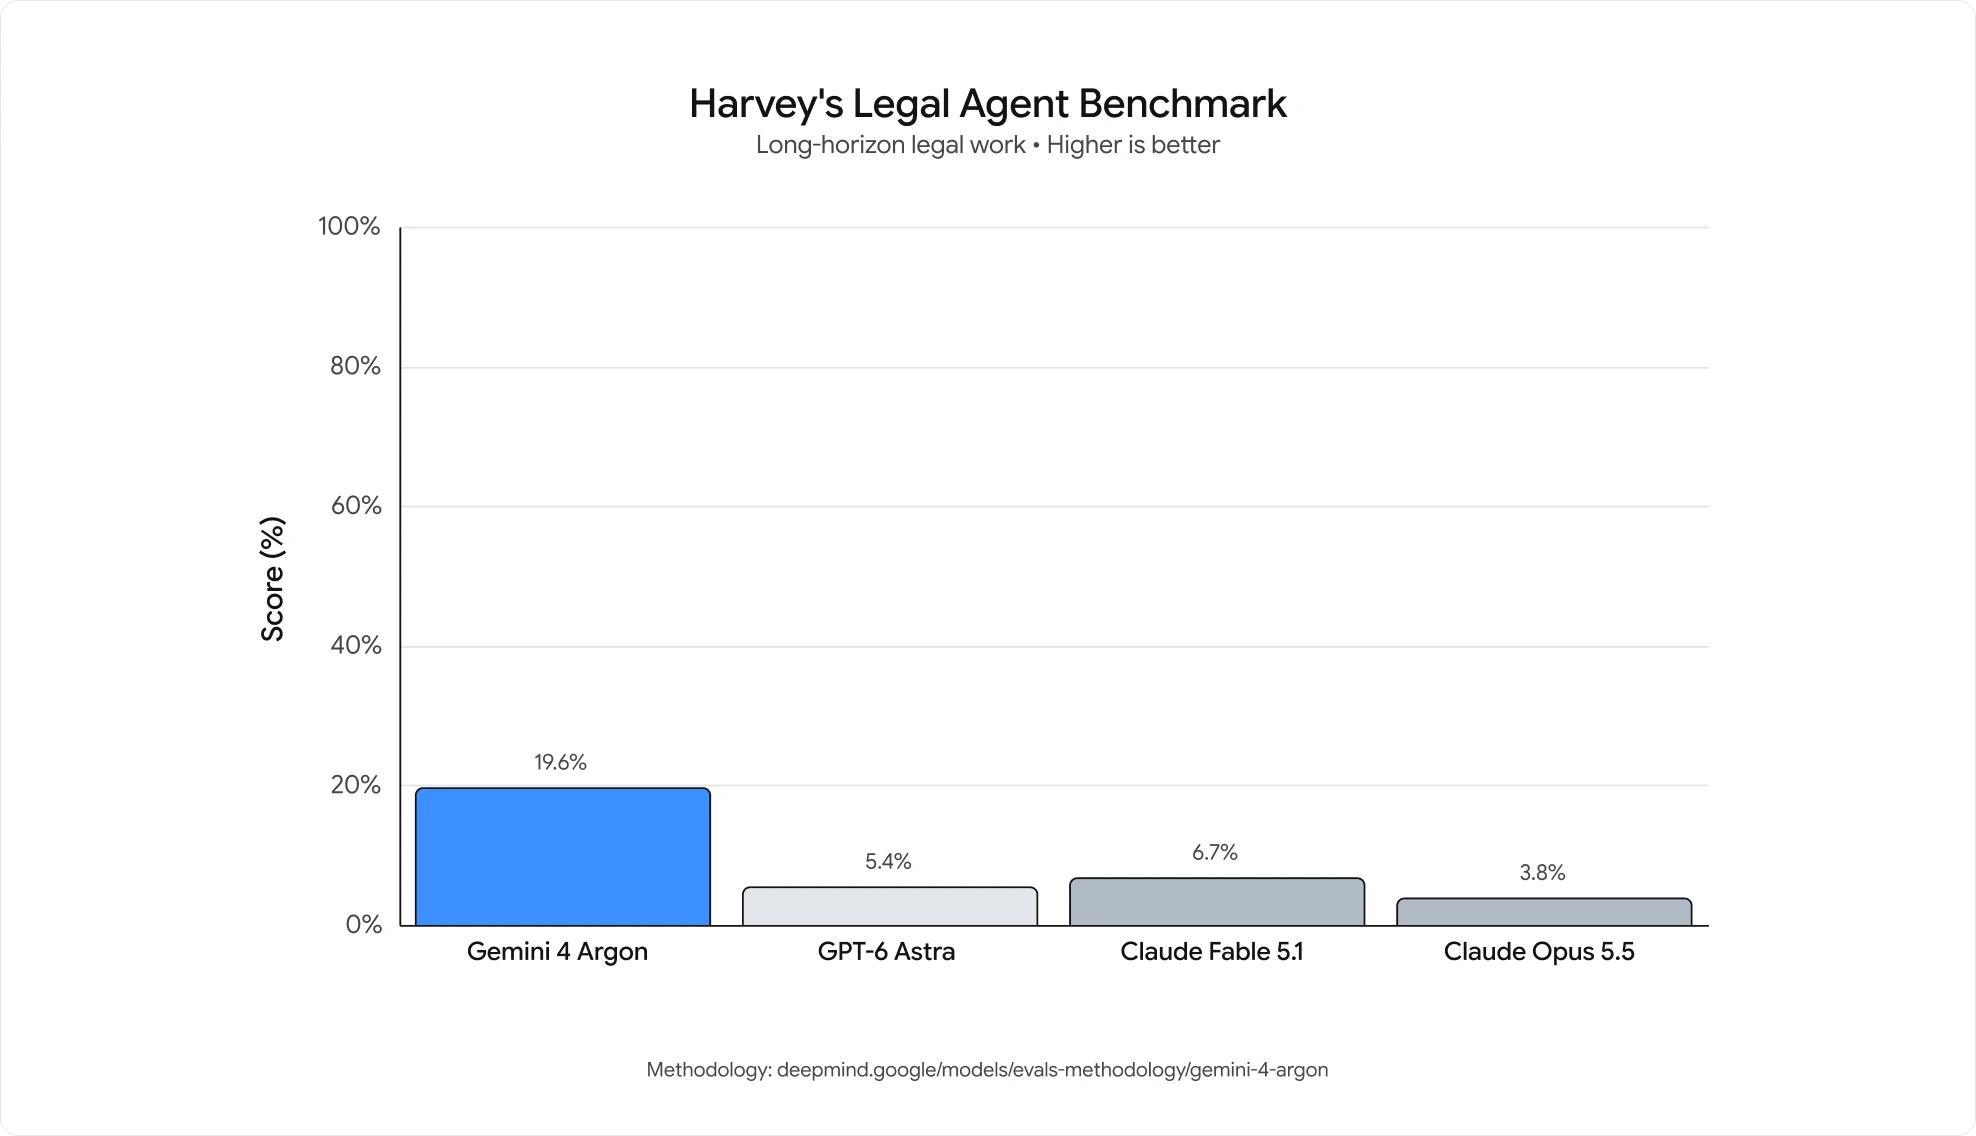
Carta palang Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Kerja guaman jangka panjang. Angka 19.6% Argon kira-kira tiga kali ganda model seterusnya, dan inilah jurang terlebar dalam set terbitan Google.
Carta palang Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Penyelidikan dan analisis kewangan, pada 65.4% berbanding kelompok 53.5–58.9%. Jurangnya lebih kecil daripada kerja guaman, tetapi susunannya sama.

Angka yang diterbitkan

Kedudukan Argon pada penanda aras Google sendiri

Ini keputusan yang dilaporkan vendor. Google belum mengeluarkan tetapan thinking atau effort untuk skor utamanya, dan belum ada makmal bebas yang mengulanginya.

Penanda aras
Apa yang diukur
Argon
Perbandingan terdekat
DeepSWE v1.1
Kejuruteraan perisian jangka panjang
77.9%
Opus 5.5 pada 74.2%, GPT-6 Astra pada 74.1%
CWE-bench v1
Mencari dan menampal kerentanan
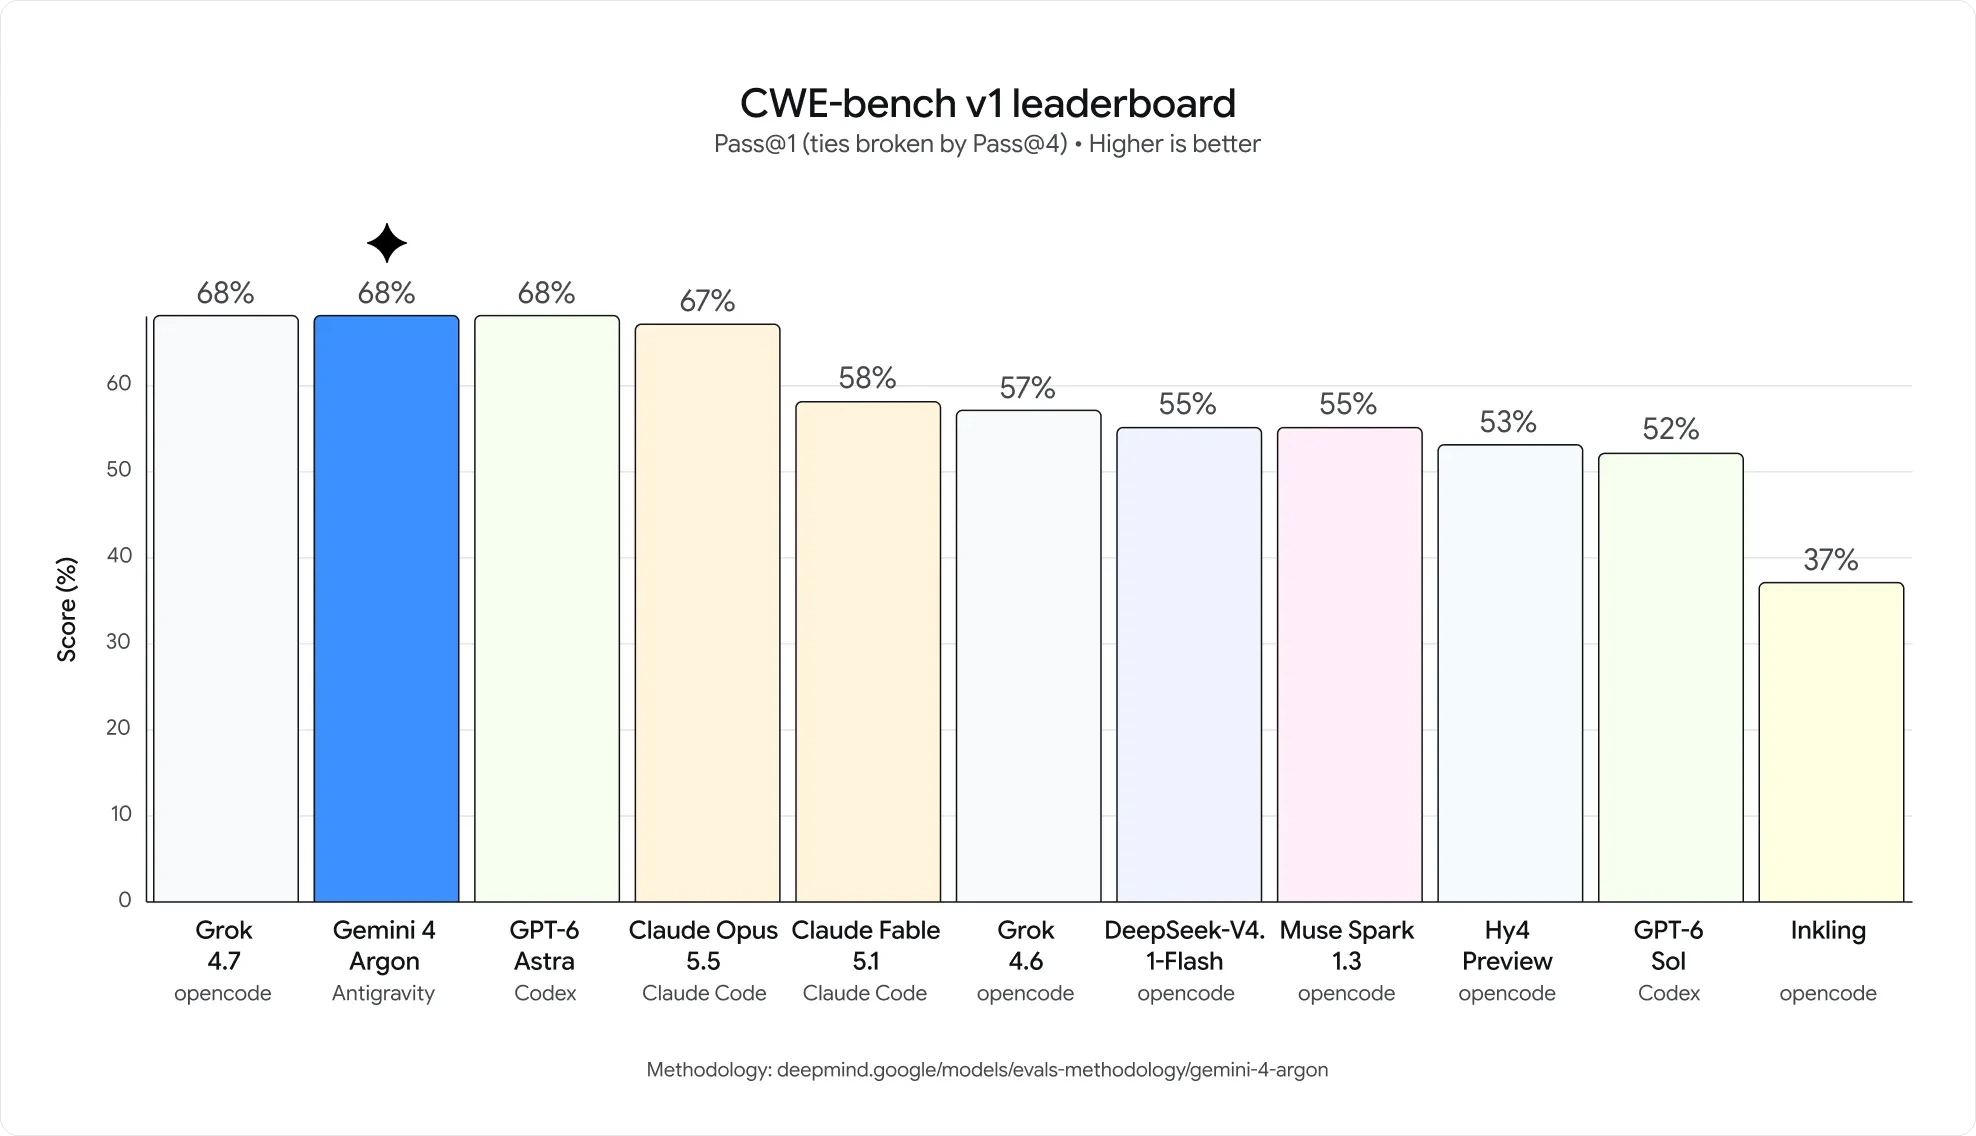
68%
Seri di tempat pertama
AutomationBench
Tugasan perniagaan hujung ke hujung, daripada Zapier
51.3%
Menduduki tempat pertama
LVBench
Memahami video panjang
91.7%
Skor tertinggi yang Google laporkan untuk Argon

Anggap ini sebagai petunjuk kasar. Penanda aras vendor jarang kekal sama apabila digunakan pada beban kerja produksi, dan Bloomberg melaporkan sebahagian pekerja Google sendiri ragu keunggulan penanda aras itu terbawa ke kerja sebenar.
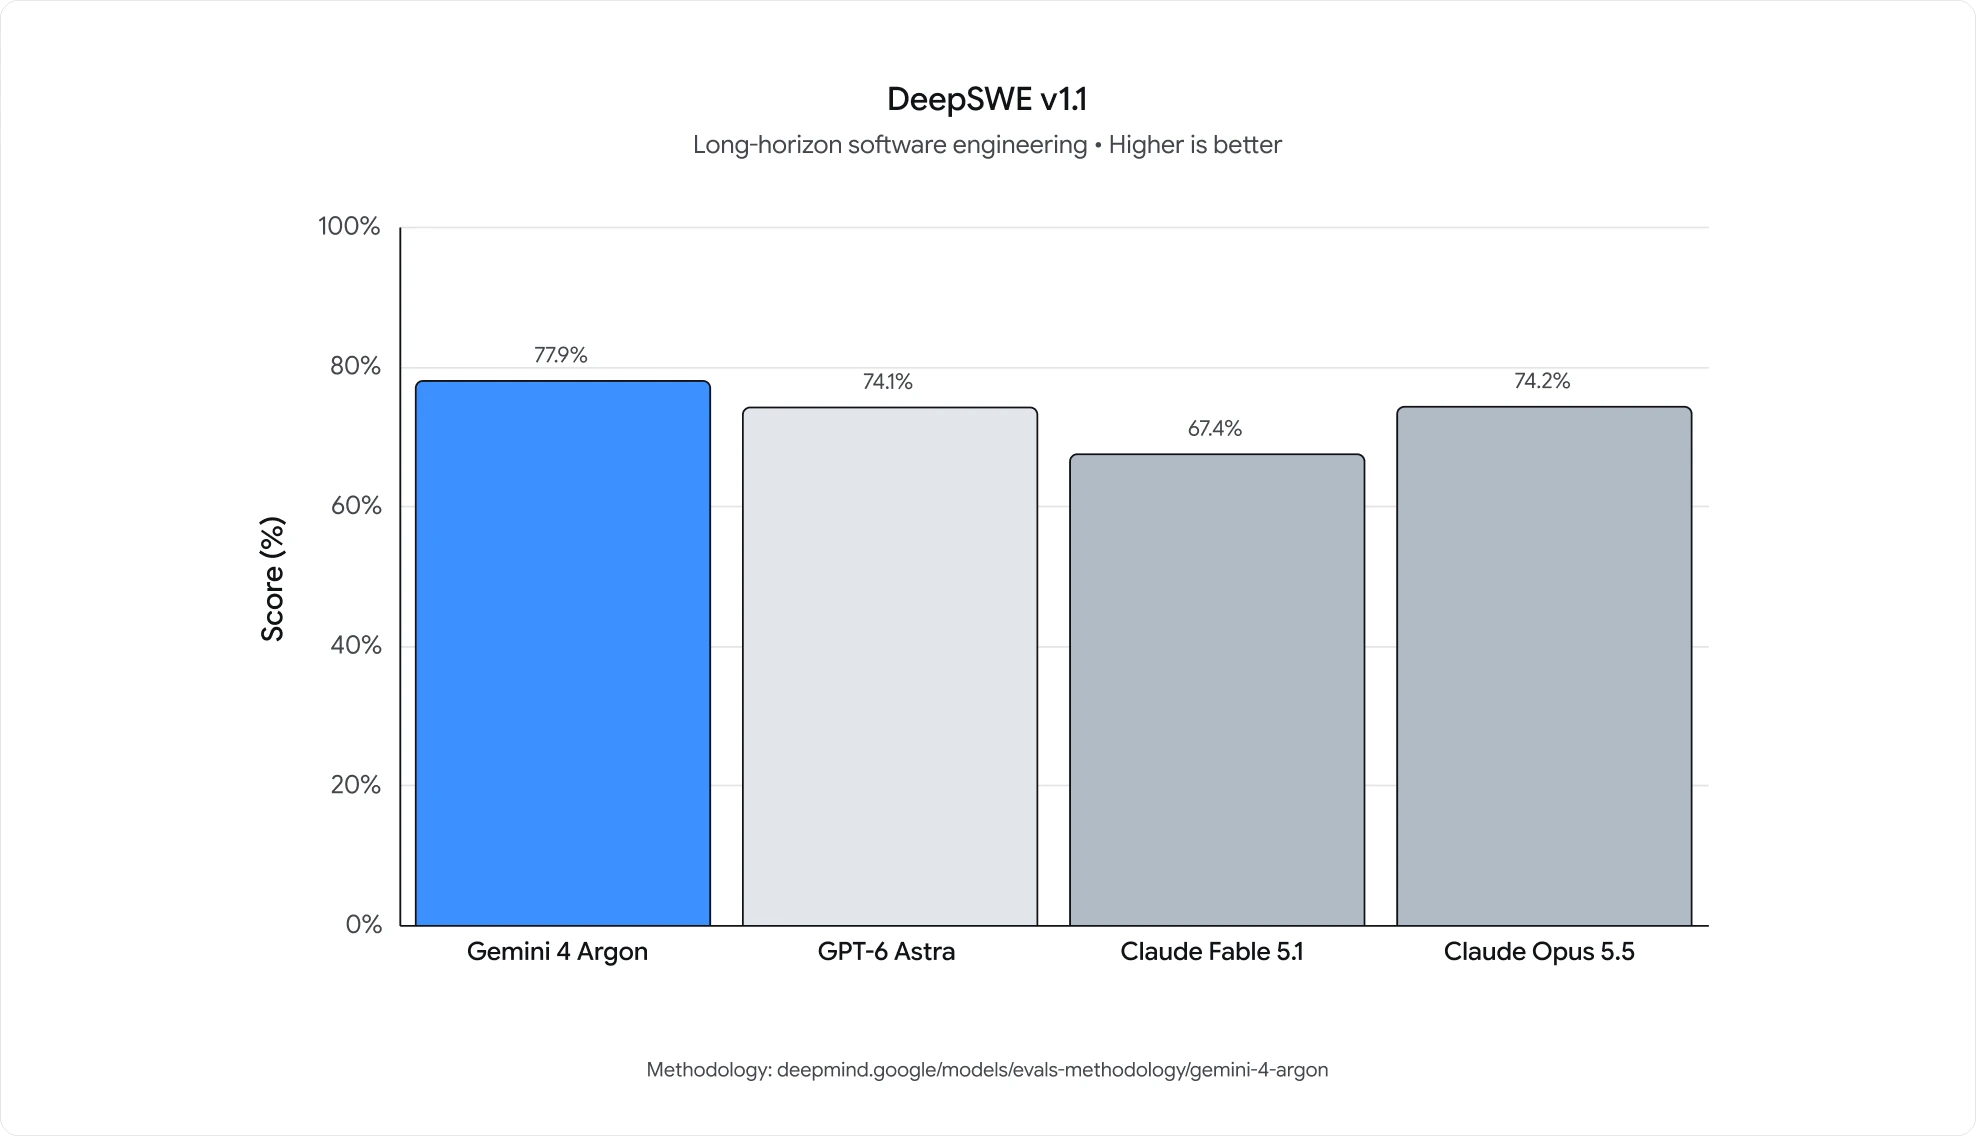
Carta palang DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Kejuruteraan perisian jangka panjang. Angka utama 77.9%, dengan kedua-dua pesaing terdekat dalam lingkungan empat mata.
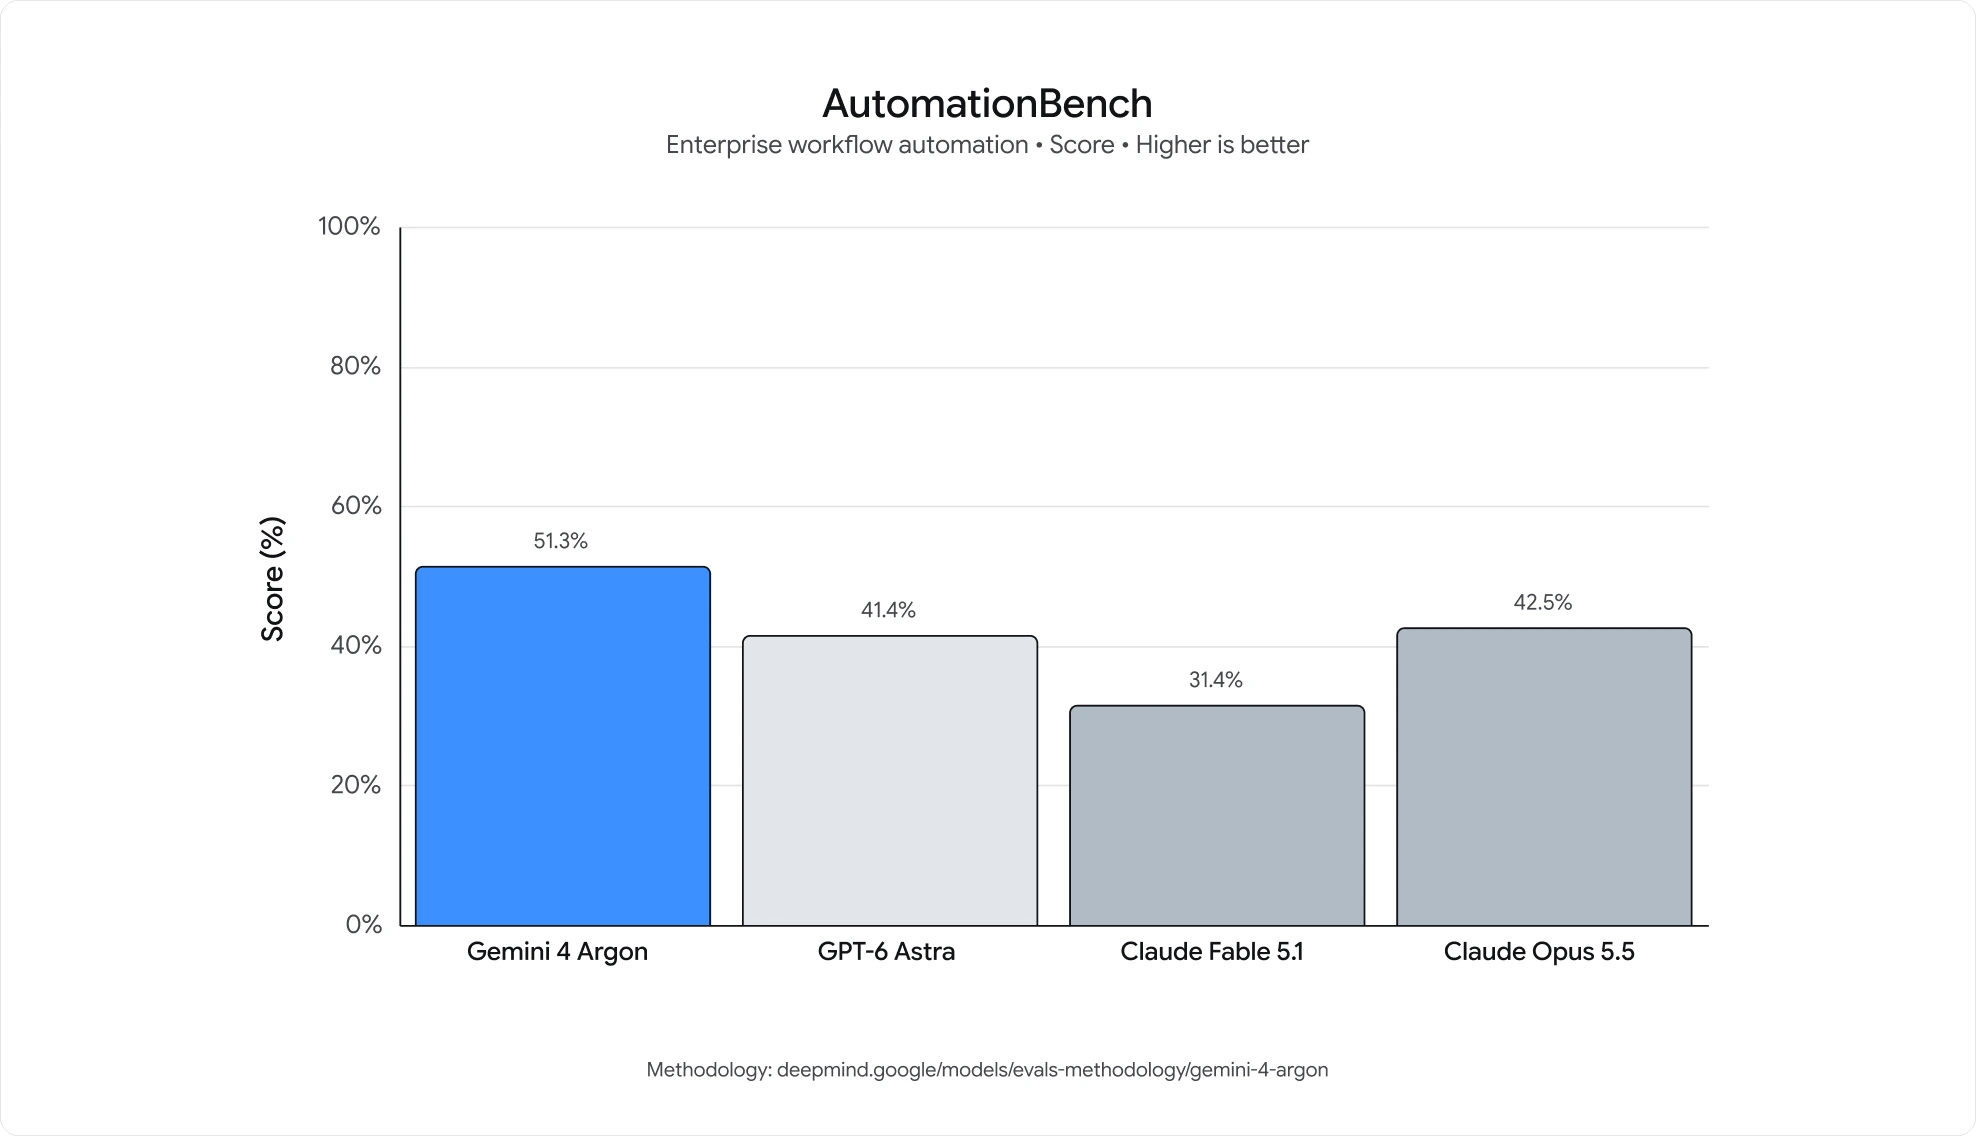
Carta palang AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Tugasan perniagaan hujung ke hujung yang dibina Zapier. Argon melepasi 50%, manakala setiap model lain dalam perbandingan berada dalam lingkungan tiga puluhan atau awal empat puluhan.
Papan pendahulu CWE-bench v1: Gemini 4 Argon, Grok dan GPT-6 Astra seri pada 68%, Claude Opus 5.5 pada 67%, menurun sehingga Inkling pada 37%
Penemuan kerentanan pada Pass@1. Argon seri di puncak papan yang padat, bukan membuka jurang, sebab itulah jadual di atas menyebutnya seri di tempat pertama.
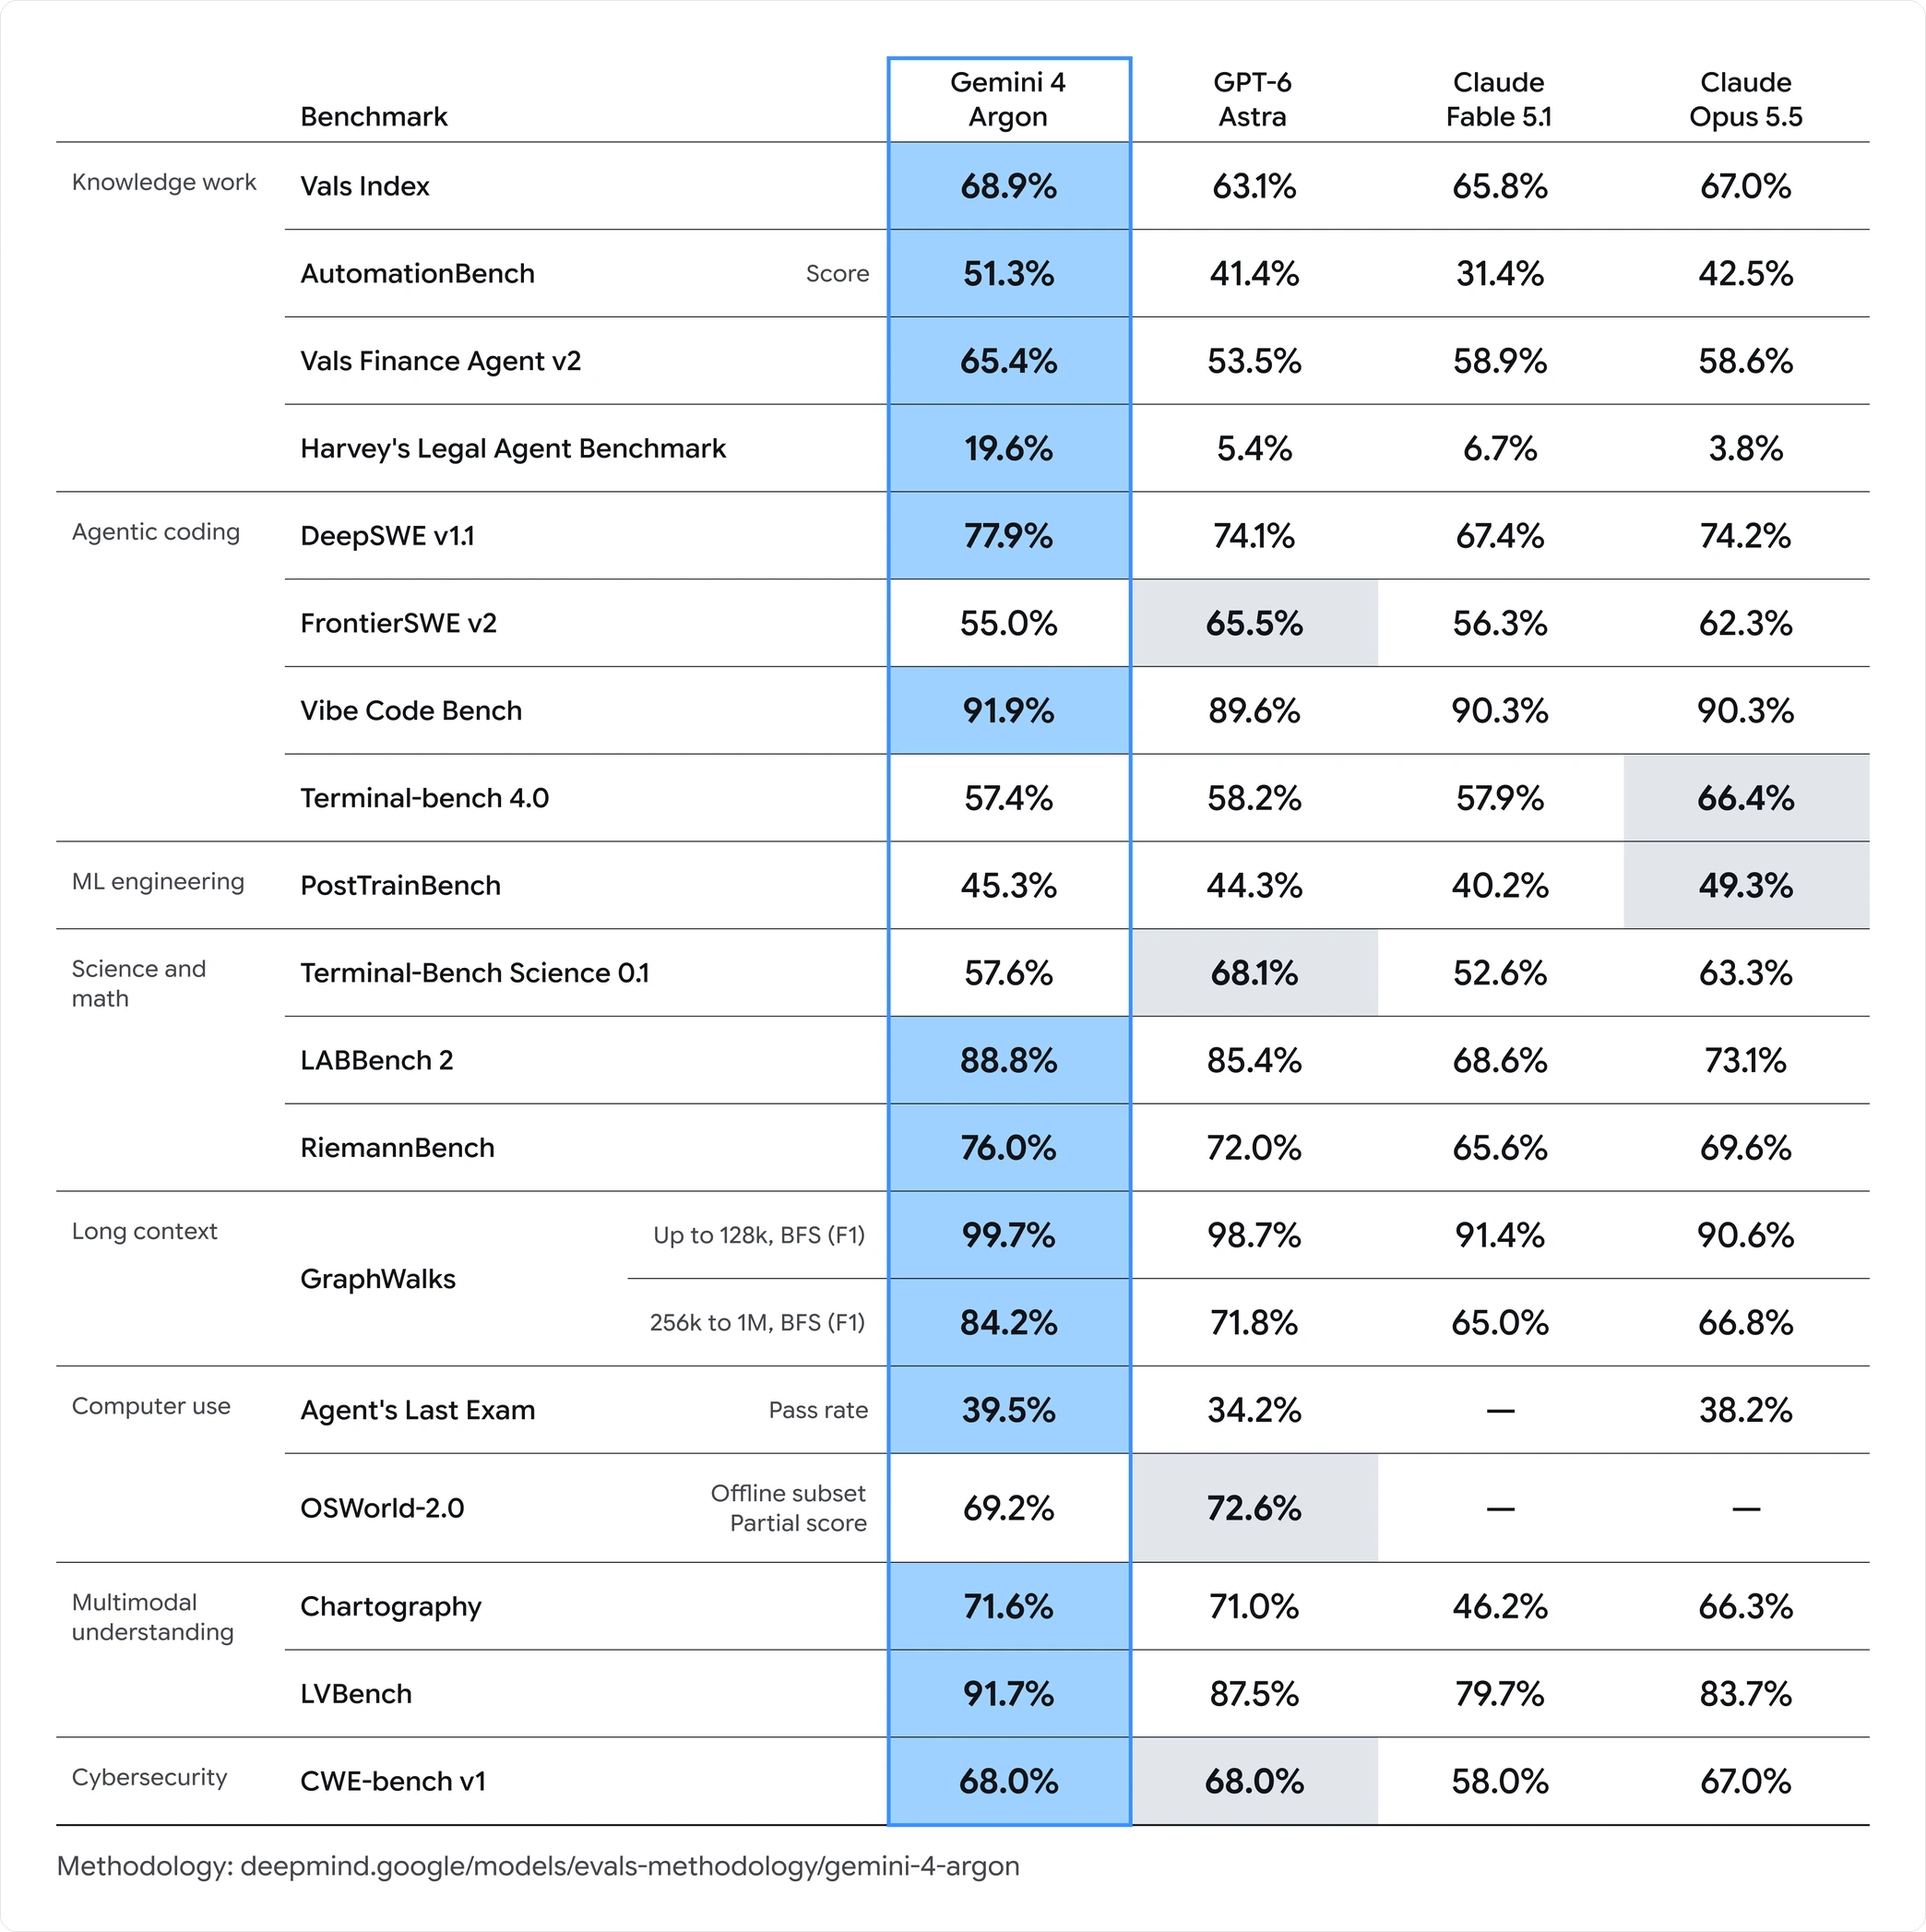
Jadual keputusan penuh Gemini 4 Argon daripada Google merentas 16 penanda aras, dikelompokkan kepada kerja pengetahuan, pengekodan agen, kejuruteraan ML, sains dan matematik, konteks panjang, penggunaan komputer, pemahaman multimodal dan keselamatan siber
Jadual lengkap daripada pengumuman, dengan sel kemenangan Argon berwarna biru dan sel tempat pesaing mendahului berwarna kelabu. Baris yang Argon tidak mendahului ialah FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 dan OSWorld-2.0.
Carta palang kadar halusinasi AA-Omniscience daripada Artificial Analysis bagi 36 model, disusun dari yang terendah: Gemini 4 Argon (High) pada 15%, kemudian MiniMax-M3 pada 18%, Kimi K2.5 pada 26%, dan meningkat hingga DeepSeek-V4 Flash pada 96%
Ukuran bebas daripada Artificial Analysis, dan satu-satunya angka di halaman ini yang tidak dibekalkan oleh mana-mana vendor: kekerapan setiap model menjawab dengan salah dan bukannya memilih untuk tidak menjawab. 15% Argon adalah yang terendah antara 36 model yang ada dalam carta; skalanya memanjang hingga 96%.
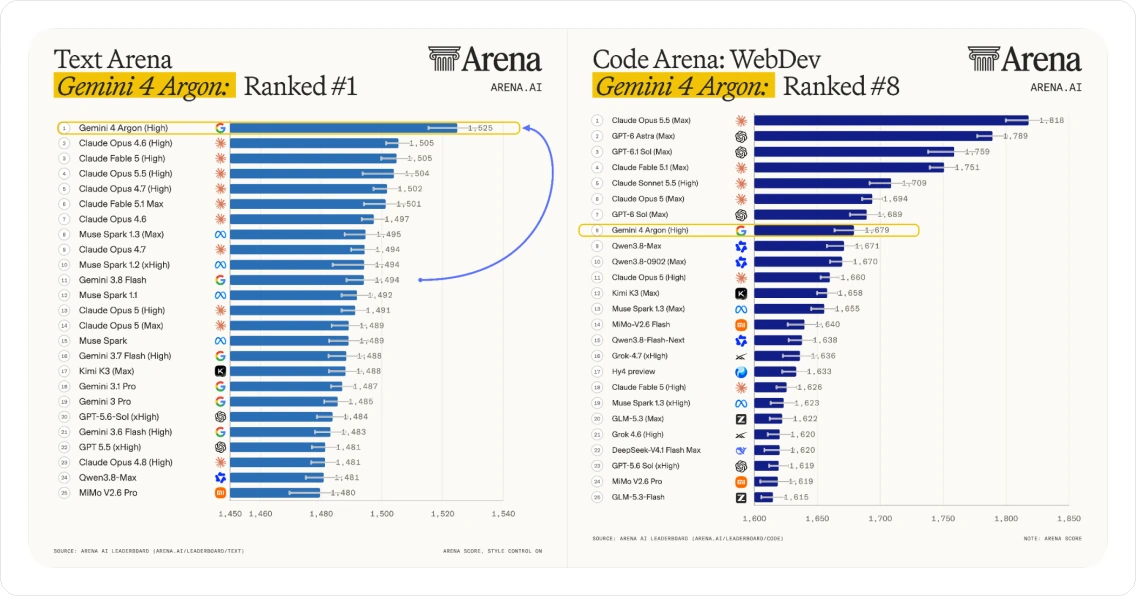
Papan pendahulu Text Arena dan Code Arena: WebDev daripada Arena.ai bersebelahan: Gemini 4 Argon di kedudukan 1 dalam Text Arena dengan 1,625, dan ke-8 dalam Code Arena: WebDev dengan 1,679
Dua kedudukan yang menjadi asas perenggan di atas, daripada papan pendahulu Arena.ai yang diundi orang ramai. Argon mendahului 25 model yang tersenarai dalam Text Arena; dalam Code Arena: WebDev ia kelapan, di belakang empat model Claude dan tiga daripada barisan GPT-6 OpenAI.

Di Felo

Bentuk aliran kerja penyelidikan dengan penulis 1M token

Felo menggabungkan carian dengan pemahaman dokumen, jadi model beroutput panjang mengubah apa yang boleh dihasilkan dalam satu sesi.

Penyelidikan yang berakhir dengan dokumen

Kumpulkan sumber, kemudian minta model menulis sintesisnya dalam satu laluan, bukan menyusunnya bahagian demi bahagian melalui banyak prompt.

Seluruh set dokumen dalam satu tugasan

Pengambilan konteks panjang ialah keupayaan terkuat Argon, dan itulah yang menjadikan set kontrak, pemfailan dan laporan panjang mampu diuruskan.

Menulis draf apabila nada penting

Profil Argon yang dilaporkan — teks kuat, pengekodan sederhana — sesuai untuk pasukan yang mahu tulisan yang terbaca seperti ditulis, bukan dicantum.

Kos

Berapa kos Argon, dan apa yang berubah kemudian

Google menerbitkan kadar pengenalan dan kadar senarai yang lebih tinggi, tanpa menyatakan bila peralihan berlaku. Rancang belanjawan anda dengan angka yang lebih tinggi.

Jenis token
Pengenalan
Kemudian
Input
2.00 $ / M
4.00 $ / M
Input cache
diskaun 95%
diskaun 95%
Output
10.00 $ / M
20.00 $ / M

Sebagai perbandingan, kadar pengenalan ini lebih kurang setanding GPT-6.1 Sol dan Sonnet 5.5, dan kira-kira satu per lima GPT-6 Astra. Ini harga senarai, bukan kos terukur setiap tugasan — Argon menjawab soalan yang lebih sukar, jadi satu laluan tetap boleh menelan kos lebih tinggi.

Cara bekerja dengan Argon di Felo

01

Bawa seluruh soalannya

Berikan Felo keseluruhan set dokumen atau urutan panjang itu, bukan ringkasannya. Kelebihan Argon bermula apabila konteks sudah tidak muat dalam satu prompt.

02

Minta hasil akhirnya

Dengan siling output 1M token, anda boleh meminta laporan penuh atau draf lengkap dalam satu arahan, bukan bahagian demi bahagian.

03

Semak dengan sumbernya

Felo mengekalkan petikan pada jawapan, dan itulah yang menjadikan dokumen panjang hasil model boleh disemak.

Akses Argon dalam Felo Search masih dalam proses. Sehingga ia dibuka, setiap model lain dalam barisan Felo boleh digunakan sekarang.

Buka Felo AI Search

Gemini 4 Argon: soalan lazim

Belum untuk umum. Google mengeluarkan Argon dahulu kepada rakan terpilih dalam Fairwind Program, dan berkata akses lebih luas akan bermula dengan pelanggan API berbayar serta pelanggan Google AI Ultra. Tiada tarikh diumumkan untuk peringkat itu, dan langganan berbayar tidak memberi akses hari ini.

Cuba model frontier Google di Felo

Cari, baca dan tulis dengan model yang sesuai untuk tugasan itu. Argon menyertai barisan apabila pelancarannya sampai ke Felo.

Buka Felo AI Search

Tiada kad kredit diperlukan untuk menggunakan Felo AI Search.