הוכרז ב-30 בספטמבר 2026 · מושק בשלבים

Gemini 4 Argonמחקר ארוך, כתוב במלואו

המודל הדגל הראשון של Google מאז Gemini 3, שנבנה להיסק עמוק בעבודות ארוכות ורבות-שלבים. הוא מעלה את תקרת הפלט מ-64K טוקנים ל-1M, ובמספרים ש-Google פרסמה הוא מוביל בעבודת ידע ולא בכתיבת קוד.

‏Felo API נמצא בבטא סגורה — והגישה ל-Gemini 4 Argon תגיע בקרוב.
תמונת המפתח של Gemini 4 Argon: שם המודל לצד הספרה 4 גדולה על רקע גרדיאנט כחול
תמונת ההודעה של Google. Argon יוצא לאור תחת שיטת שמות חדשה ולא כעדכון לקו Gemini 4.0, ולכן השם אינו נושא מספר גרסה.
1M
פלט מרבי בטוקנים
עלייה מ-64K — דוח שלם שנוצר במסלול אחד.
2 $ / 10 $
מחיר API היכרותי
לכל מיליון טוקני קלט ופלט. קלט מהמטמון בהנחה של 95%.
77.9%
DeepSWE v1.1
הציון ש-Google דיווחה, לפני Claude Opus 5.5 ו-GPT-6 Astra.
15%
שיעור הזיות
הנמוך ביותר שנמדד בין מודלי הדגל על ידי Artificial Analysis.

הנתונים והגרפים בעמוד הזה לקוחים מהגופים שפרסמו אותם — Google, Arena.ai ו-Artificial Analysis — והם מובאים ללא שינוי.

מצב ההשקה

‏Argon עדיין לא זמין לכולם. זה סדר ההגעה שלו.

‏Google משחררת את Argon בשלבים, והשלב הראשון אינו הפומבי. הגישה בתוך Felo נבנית במקביל להשקה הזו.

זמין כעת

מגני סייבר מהימנים

שותפים נבחרים בתוכנית Fairwind של Google מקבלים את Argon ראשונים, ומקבלים אותו בלי אמצעי הגנה סייבריים.

השלב הבא שהוכרז

לקוחות API בתשלום ו-Google AI Ultra

‏Google אומרת שהגישה הרחבה מתחילה כאן. לא נמסר תאריך, ומנוי לבדו לא מקנה גישה היום.

אין תאריך עדיין

מפתחים, ארגונים וצרכנים

מגיע אחרי המסלולים בתשלום. Google לא התחייבה ללוח זמנים לזמינות כללית.

הגישה ל-Argon בתוך החיפוש של Felo נמצאת בתהליך. העמוד הזה יתעדכן כשהיא תיפתח.

במה זה טוב

מודל שנבנה לסיים עבודה ארוכה, לא לענות מהר

החוזקות שפורסמו ל-Argon מתקבצות סביב קריאה, היסק וכתיבה ארוכה. זה פרופיל שונה ממודלי הדגל שממוקדים בכתיבת קוד ואיתם משווים אותו.

היסק שמחזיק מעמד במשימה ארוכה

‏Google ממקמת את Argon לעבודות רבות-שלבים שנמשכות שעות, שבהן מודלים קודמים נודדים מהנושא או עוצרים מוקדם.

‏1M טוקנים של פלט במעבר אחד

הסיבה ש-Google מציינת לעלייה: מודל שיש לו מקום לחשוב באריכות יכול לפתור בעיה קשה במסלול אחד במקום בהרבה סבבים.

עבודת ידע מובילה, לא כתיבת קוד

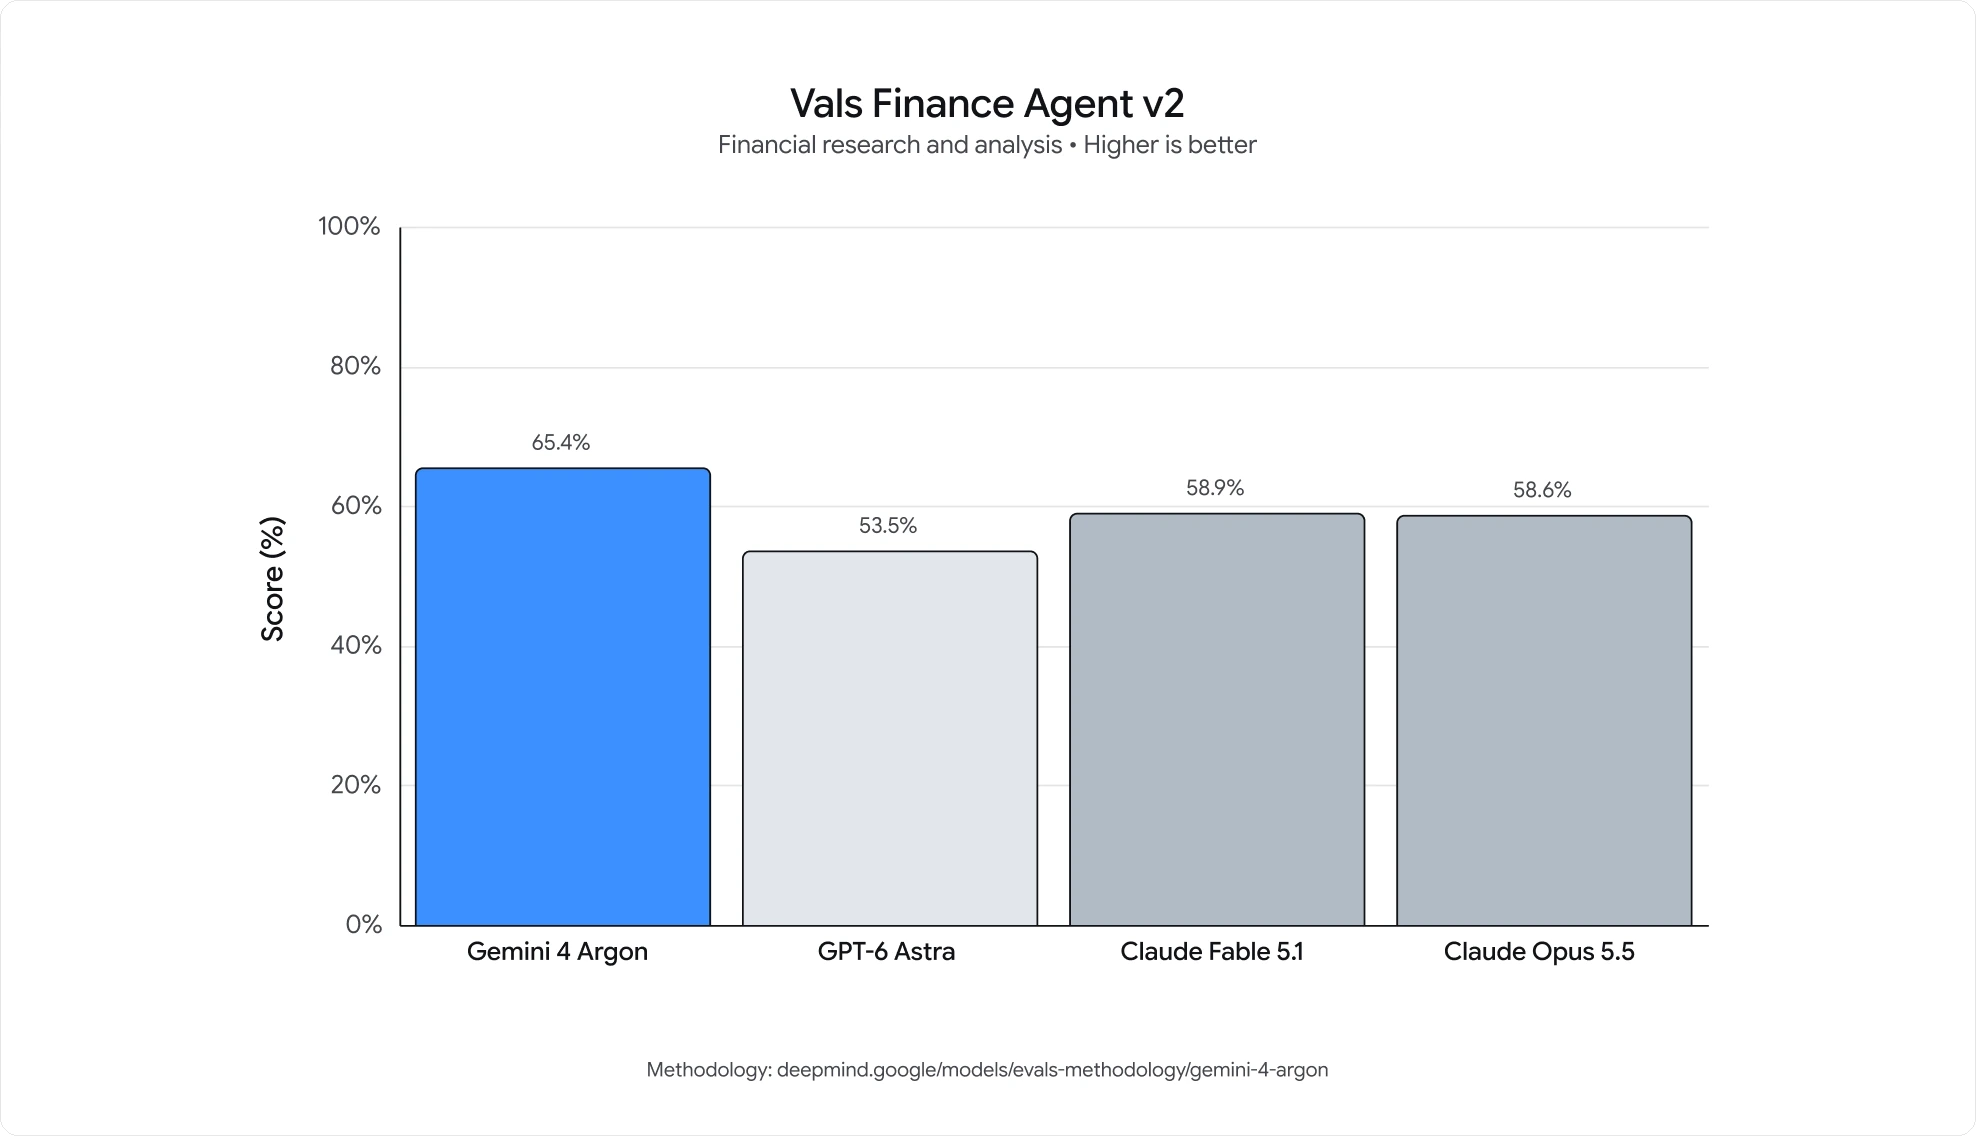
הפערים הרחבים ביותר מדווחים ב-Harvey's Legal Agent Benchmark וב-Vals Finance Agent v2 — ניתוח משפטי ופיננסי אמיתי, לא משימות סינתטיות.

שליפה מהקשר ארוך שמחזיקה מעמד

ב-GraphWalks, שבוחן אם המודל באמת מצליח להשתמש בהקשר של 256K עד 1M, Google מדווחת על יתרון של יותר מעשר נקודות על פני שאר מודלי הדגל.

הבנת וידאו ארוך

‏LVBench, שמודד הבנה בסרטוני וידאו ארוכים, מדווח ב-91.7% — הציון הגבוה ביותר ש-Google מפרטת ל-Argon.
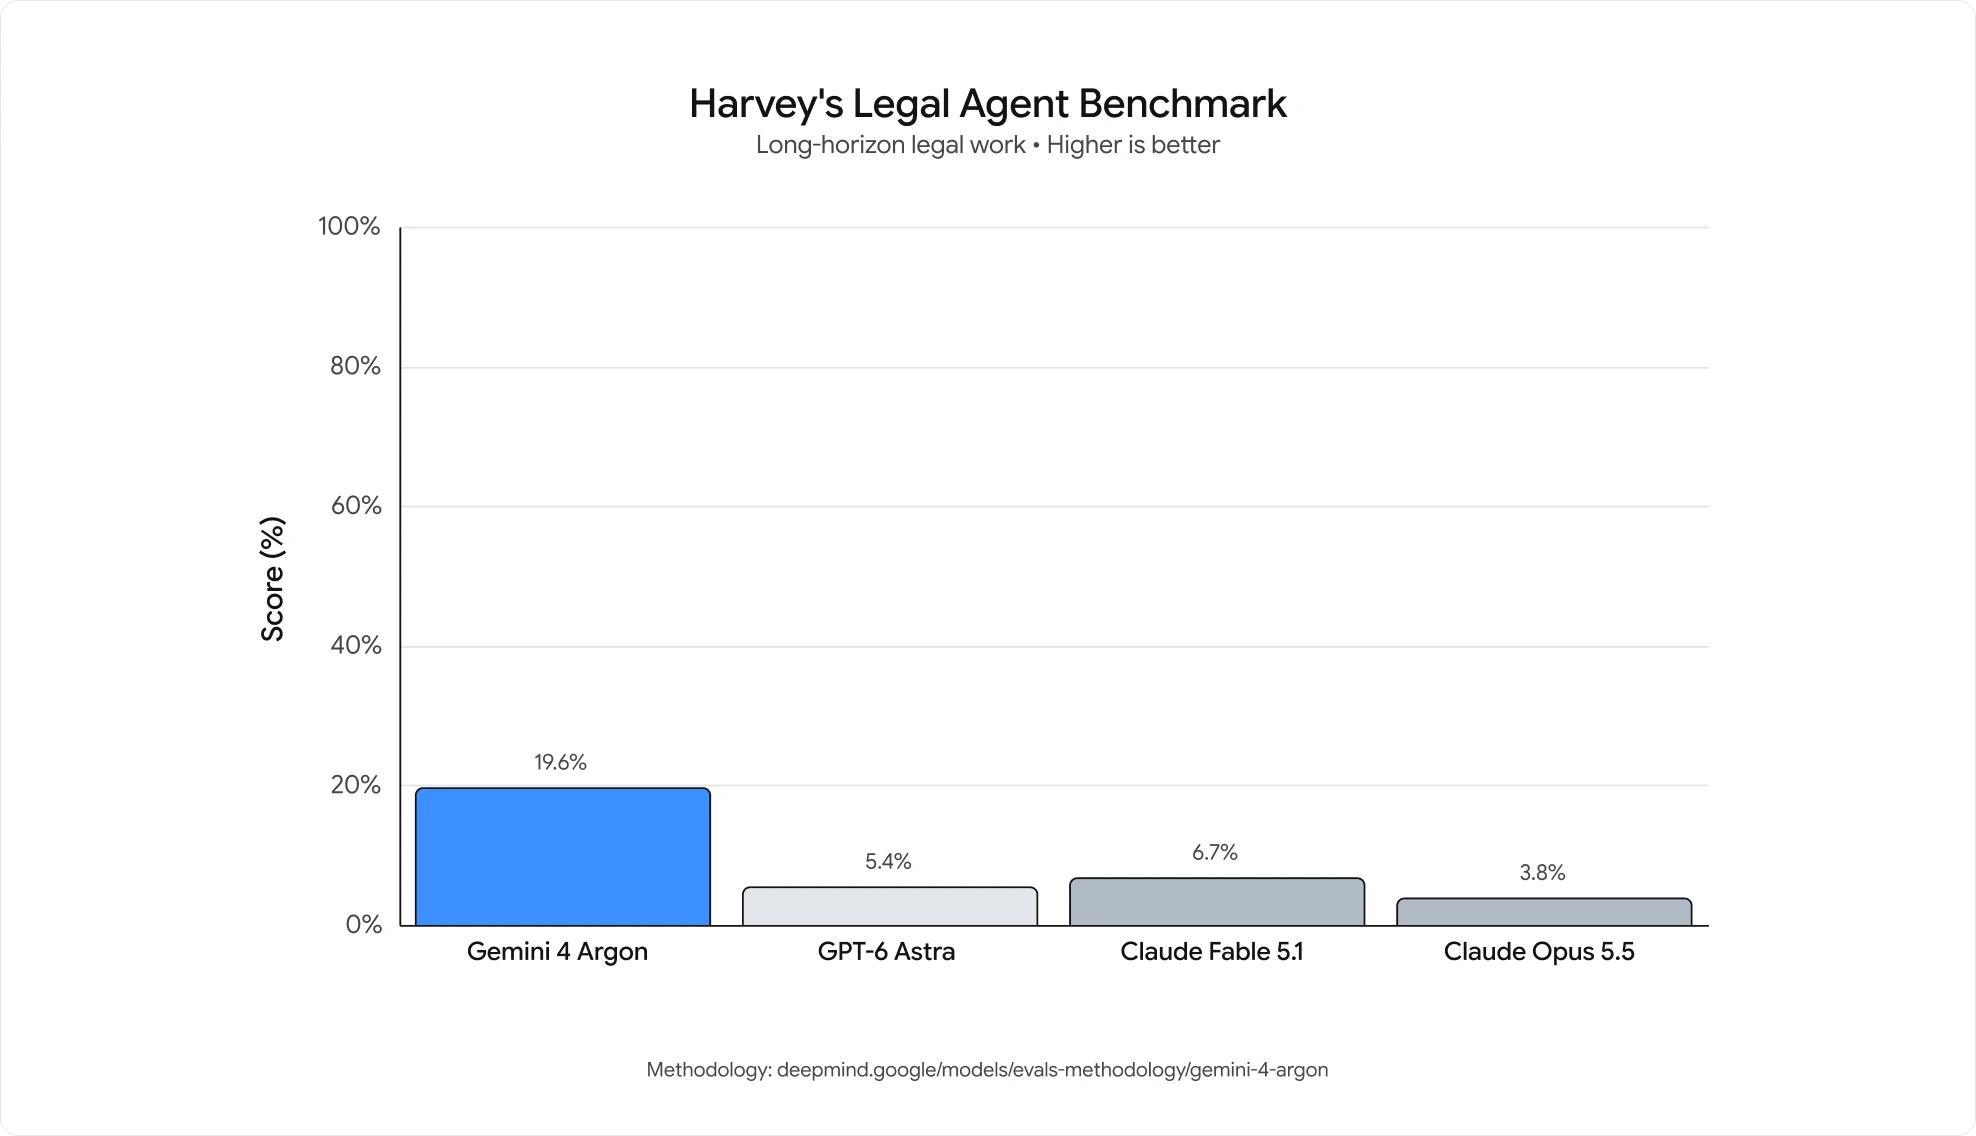
תרשים עמודות של Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
עבודה משפטית בטווח ארוך. 19.6% של Argon הם בערך פי שלושה מהציון של המודל הבא, וזה הפער הרחב ביותר בקבוצה ש-Google פרסמה.
תרשים עמודות של Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
מחקר וניתוח פיננסיים, עם 65.4% מול קבוצה של 53.5%–58.9%. פער צר יותר מאשר בעבודה המשפטית, אבל אותו סדר.

המספרים שפורסמו

היכן Argon עומד בבנצ׳מרקים של Google עצמה

אלה תוצאות שדווחו על ידי הספק. Google לא פרסמה הגדרת thinking או effort לציונים המובילים, ואף מעבדה עצמאית לא שחזרה אותם עדיין.

בנצ׳מרק
מה הוא מודד
Argon
ההשוואה הקרובה
DeepSWE v1.1
הנדסת תוכנה לטווח ארוך
77.9%
‏Opus 5.5 ב-74.2%, GPT-6 Astra ב-74.1%
CWE-bench v1
איתור ותיקון פרצות
68%
חולק את המקום הראשון
AutomationBench
משימות עסקיות מקצה לקצה, מבית Zapier
51.3%
במקום הראשון
LVBench
הבנת וידאו ארוך
91.7%
הציון הגבוה ביותר ש-Google מדווחת ל-Argon

התייחסו אליהם ככיוון בלבד. בנצ׳מרקים של ספקים כמעט לא שורדים מפגש עם עומסי עבודה בייצור בלי שינוי, ו-Bloomberg דיווחה שחלק מעובדי Google עצמם מטילים ספק בכך שיתרון הבנצ׳מרק עובר לעבודה אמיתית.
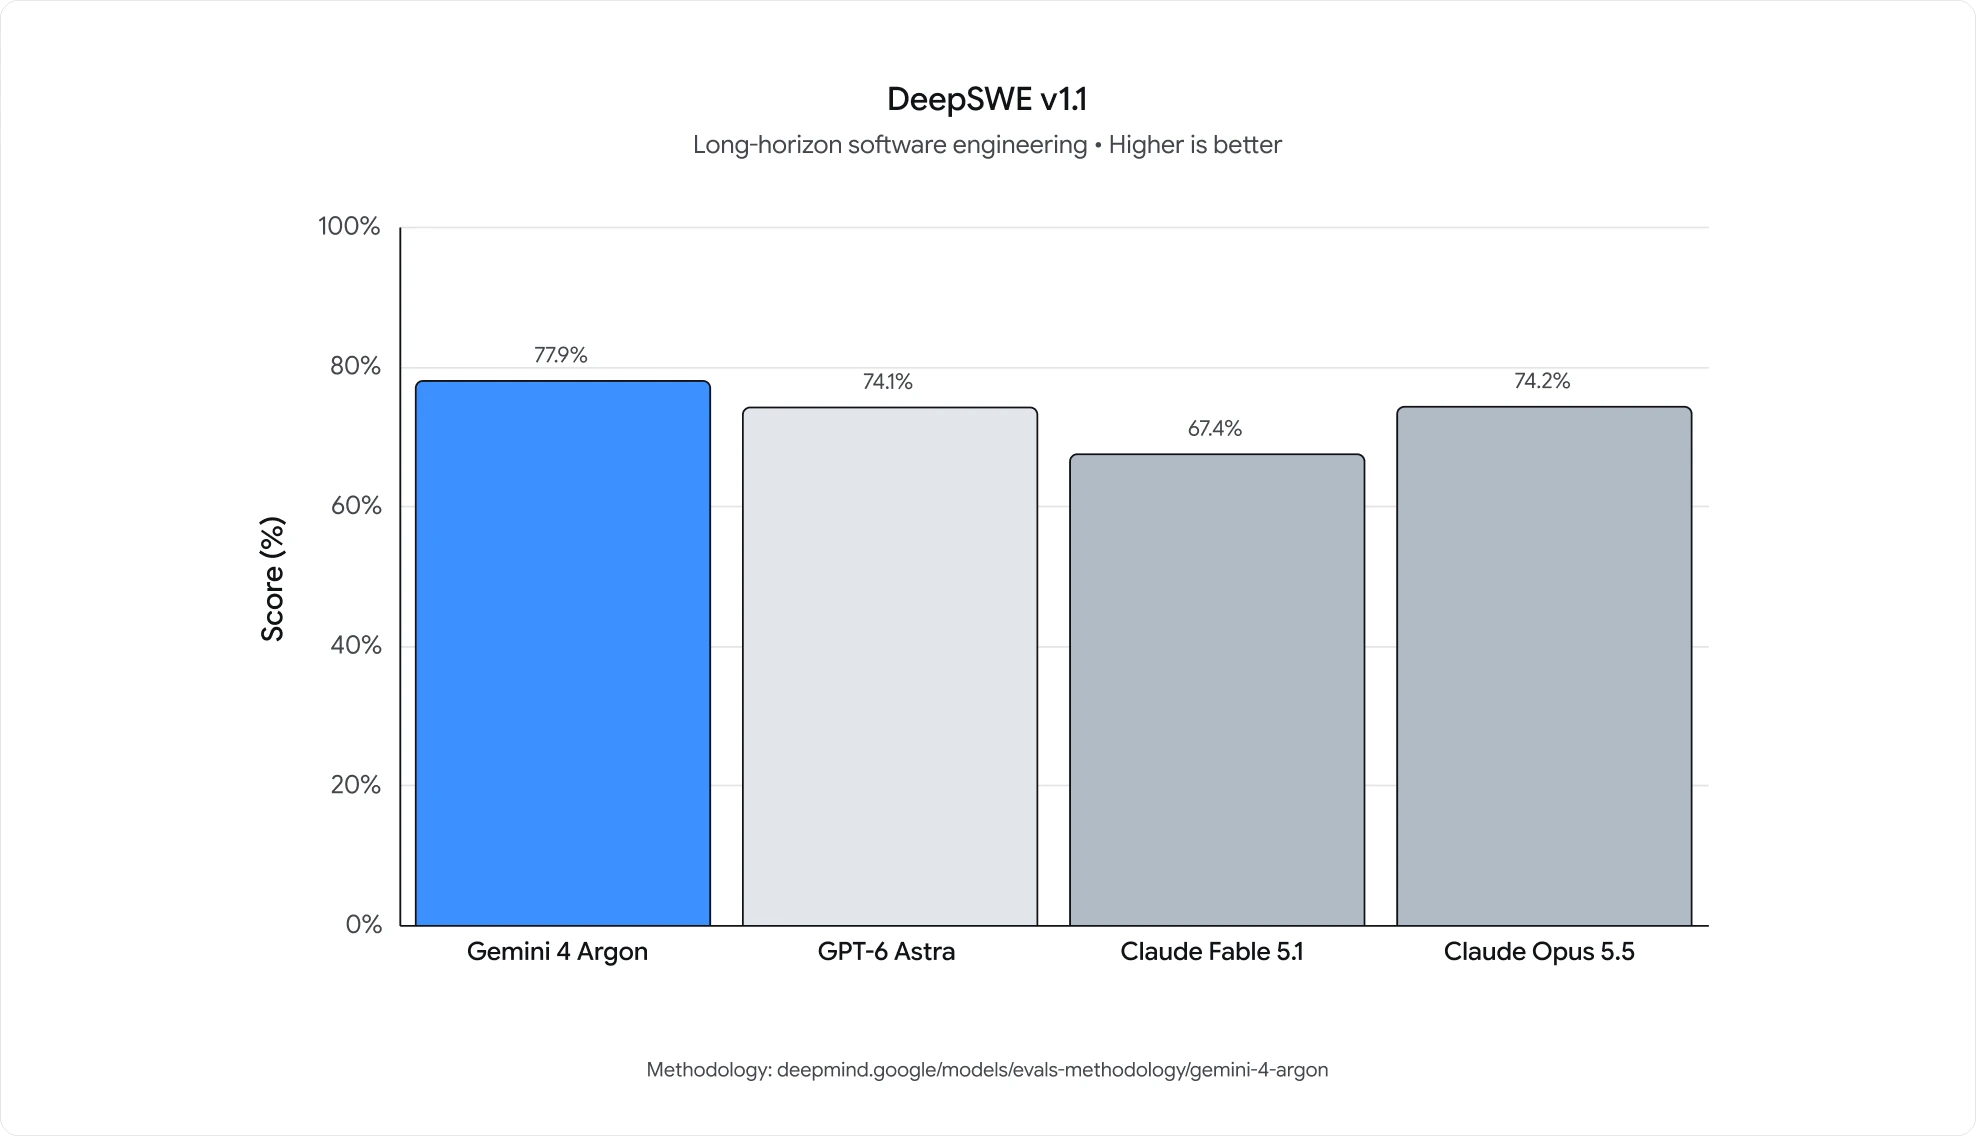
תרשים עמודות של DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
הנדסת תוכנה לטווח ארוך. הציון המוביל 77.9%, כששני המתחרים הקרובים נמצאים בטווח של ארבע נקודות ממנו.
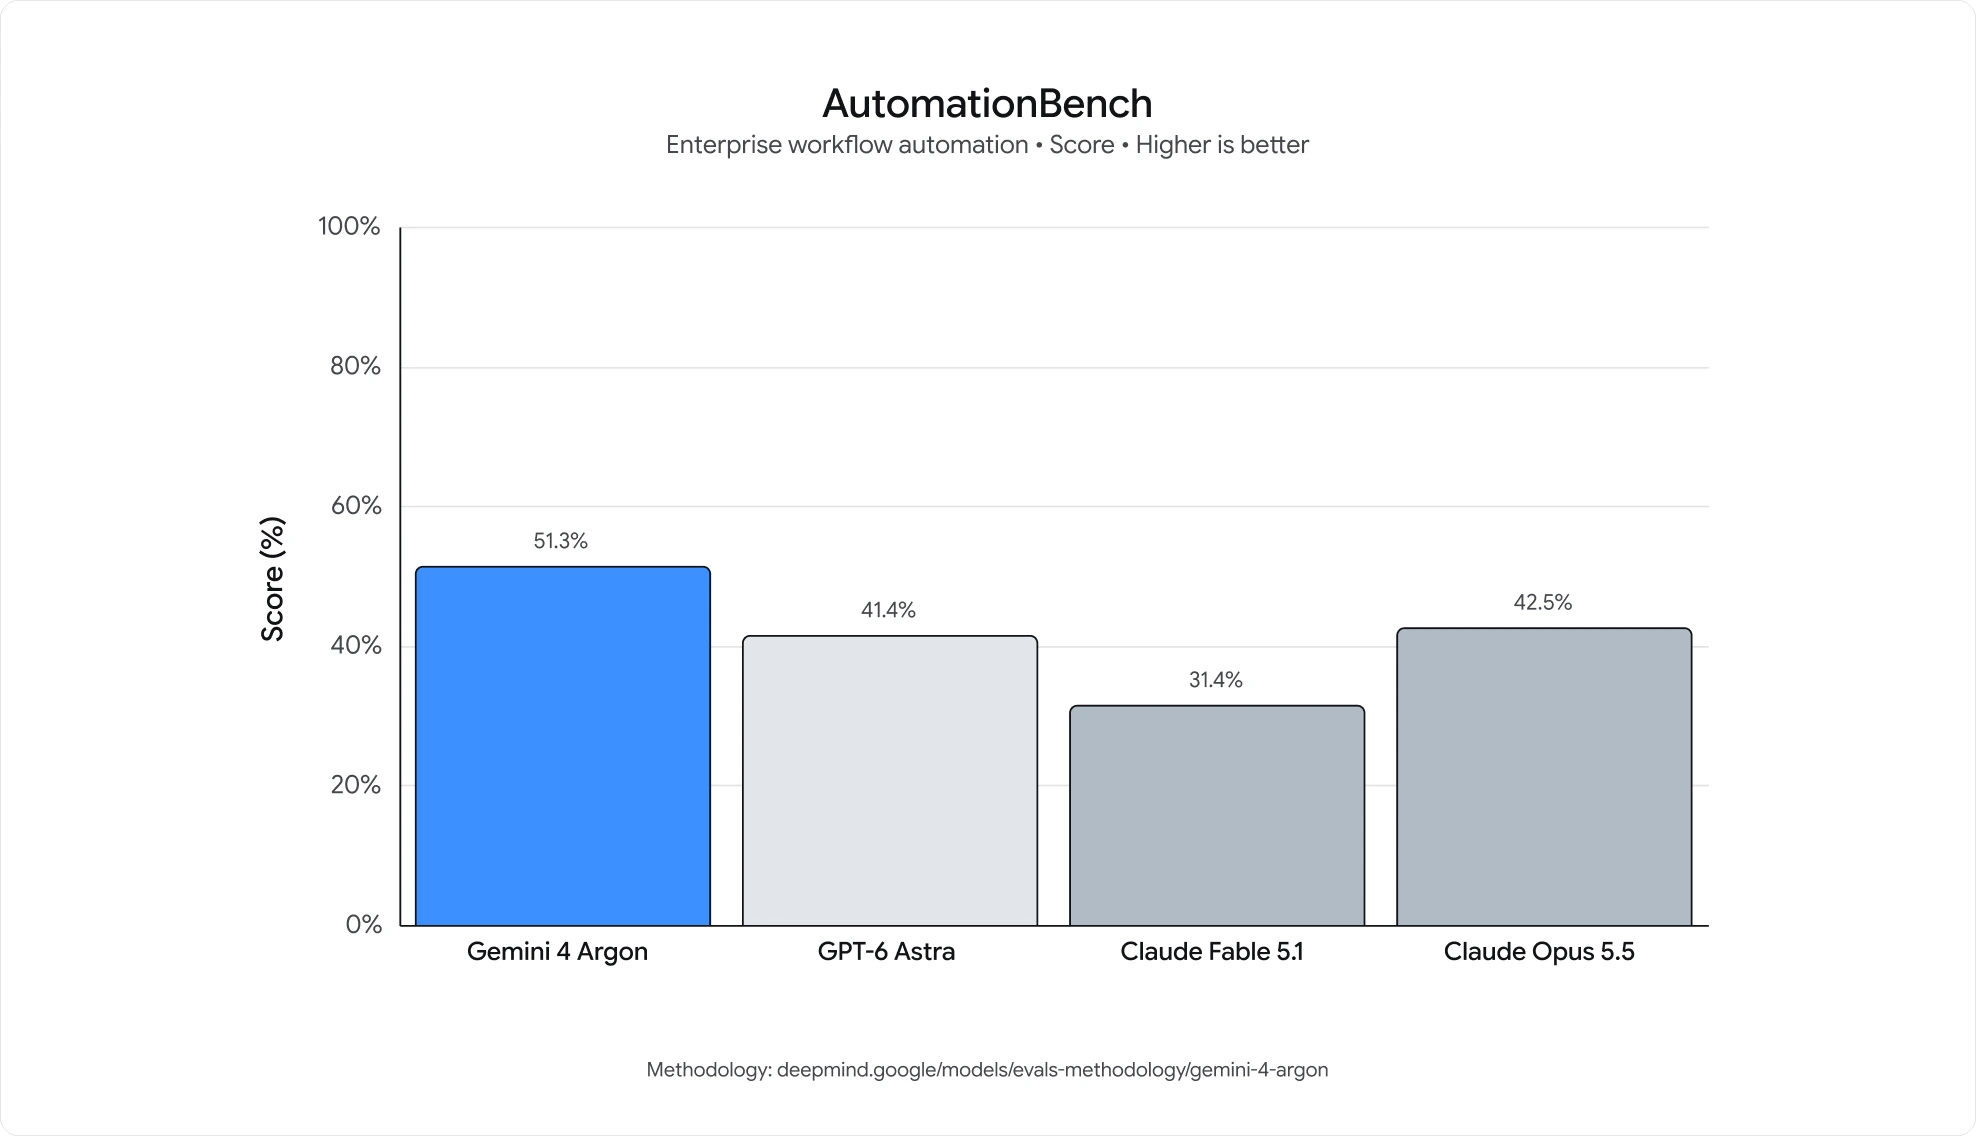
תרשים עמודות של AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
משימות עסקיות מקצה לקצה, מבית Zapier. Argon עובר את רף 50% בעוד כל שאר המודלים בהשוואה נמצאים בשנות השלושים או בתחילת שנות הארבעים.
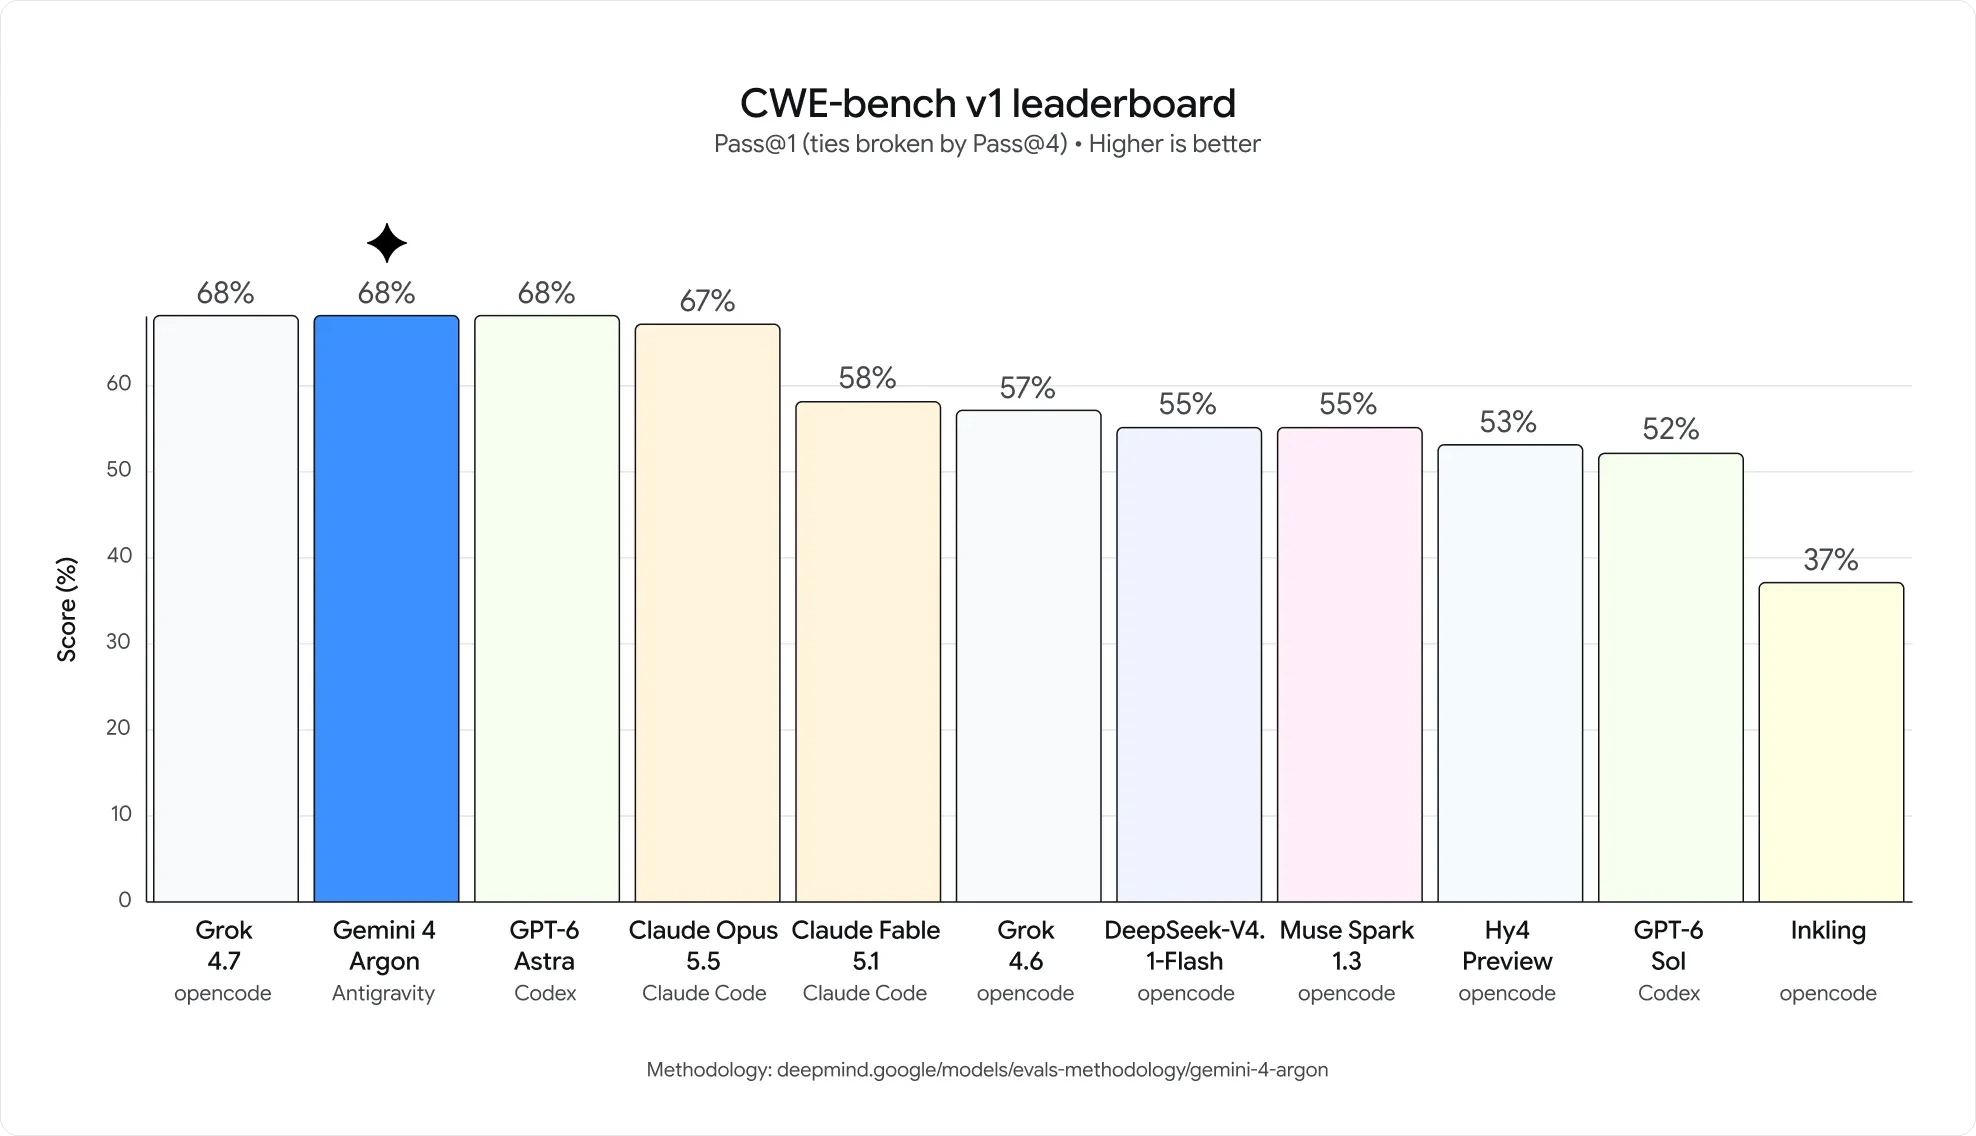
טבלת המובילים של CWE-bench v1: Gemini 4 Argon, Grok ו-GPT-6 Astra בשוויון ב-68%, Claude Opus 5.5 ב-67%, ומשם הולך ופוחת עד Inkling ב-37%
איתור פרצות ב-Pass@1. Argon חולק את ראש הטבלה הצפופה במקום לפתוח פער, ולכן הטבלה למעלה מכנה זאת שוויון במקום הראשון.
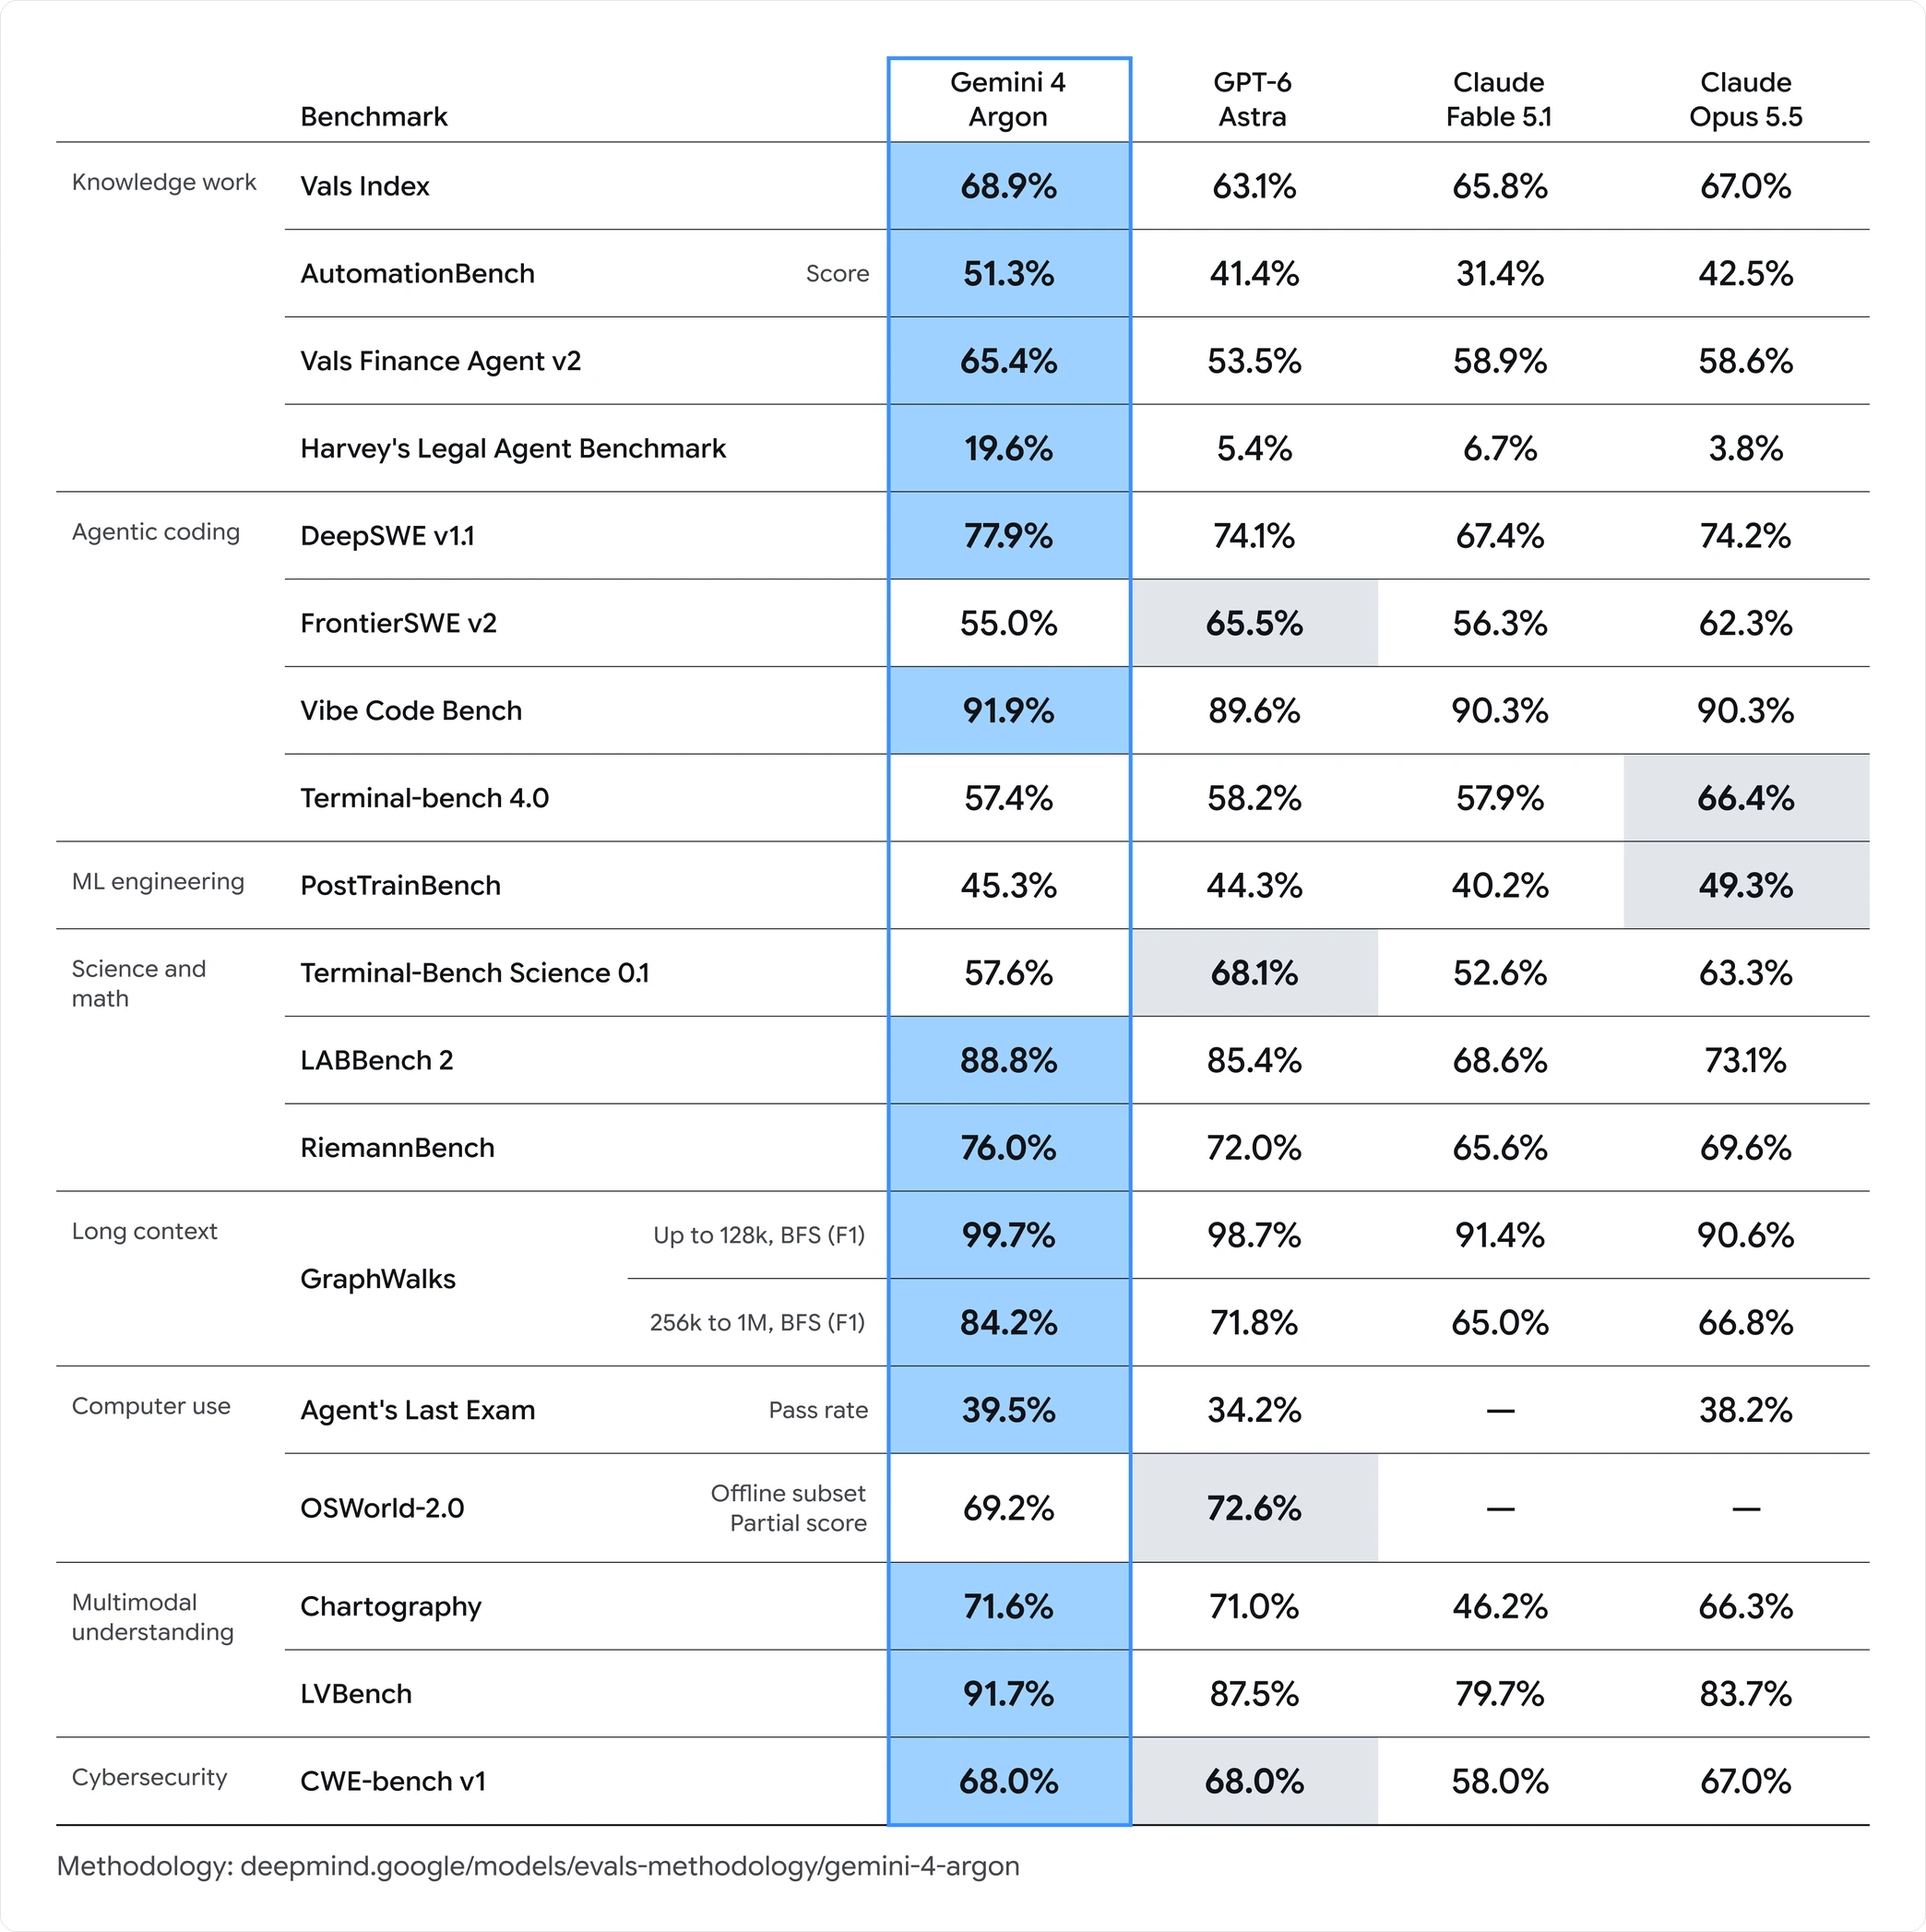
טבלת התוצאות המלאה של Google ל-Gemini 4 Argon על פני 16 בנצ׳מרקים, בקבוצות: עבודת ידע, כתיבת קוד סוכנית, הנדסת ML, מדע ומתמטיקה, הקשר ארוך, שימוש במחשב, הבנה רב-מודאלית ואבטחת סייבר
הטבלה המלאה מההודעה, עם הניצחונות של Argon בכחול והתאים שבהם מתחרה מוביל באפור. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench ו-Terminal-Bench Science 0.1 ו-OSWorld-2.0 הם השורות שבהן Argon אינו מוביל.
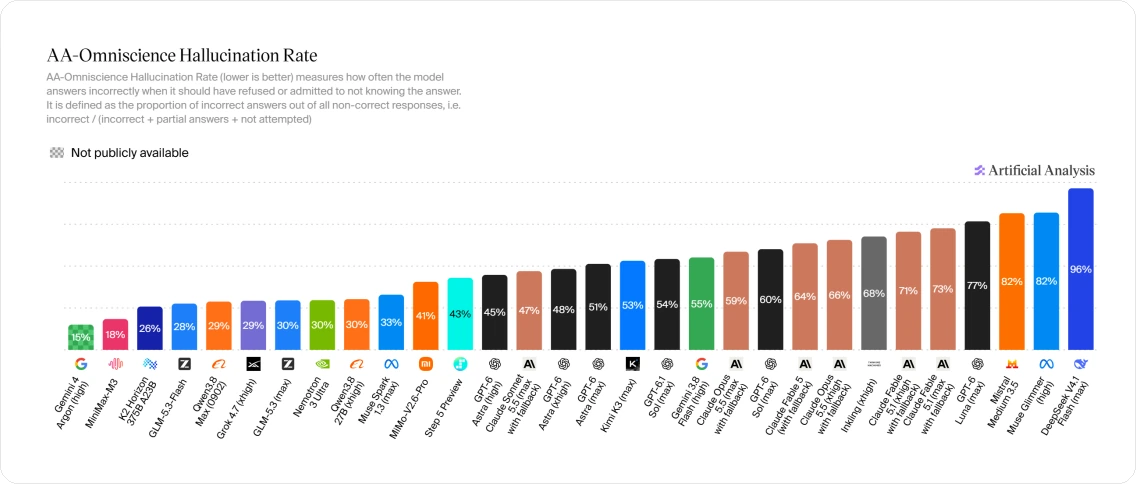
תרשים עמודות של שיעור ההזיות ב-AA-Omniscience של Artificial Analysis על פני 36 מודלים, מסודרים מהנמוך לגבוה: Gemini 4 Argon (High) ב-15%, אחר כך MiniMax-M3 ב-18%, Kimi K2.5 ב-26%, ועד DeepSeek-V4 Flash ב-96%
מדידה עצמאית של Artificial Analysis, והנתון היחיד בעמוד הזה שאף ספק לא סיפק: באיזו תדירות כל מודל עונה תשובה שגויה במקום להימנע מלענות. 15% של Argon הם הנמוכים מבין 36 המודלים בתרשים; הסקאלה מגיעה עד 96%.
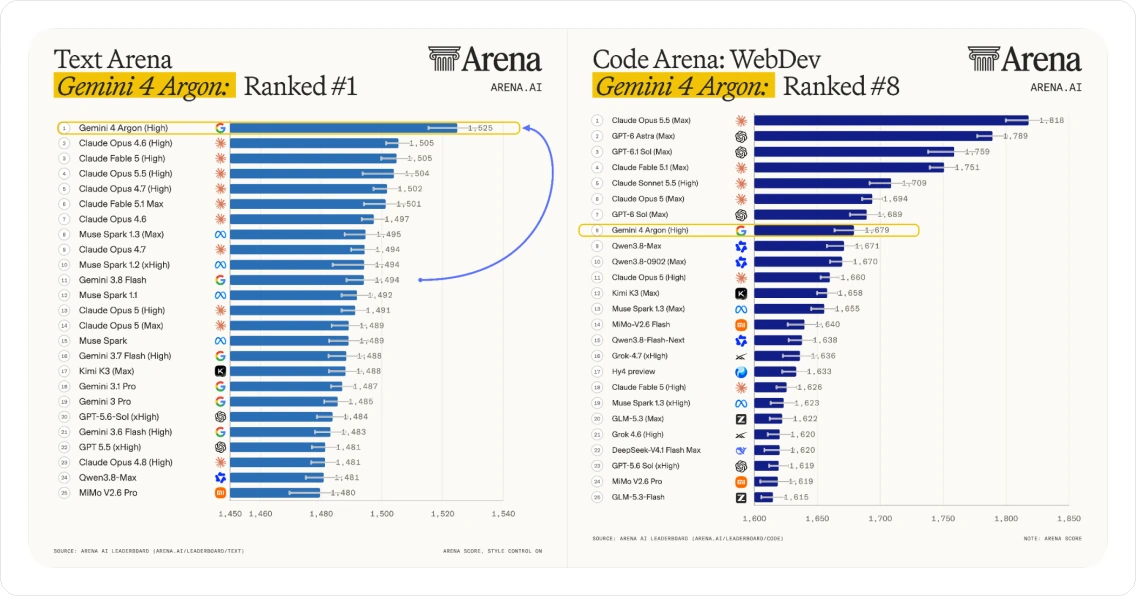
טבלאות הדירוג של Arena.ai — Text Arena ו-Code Arena: WebDev — זו לצד זו: Gemini 4 Argon במקום הראשון ב-Text Arena עם 1,625, ובמקום השמיני ב-Code Arena: WebDev עם 1,679
שני הדירוגים שהפסקה שלמעלה נשענת עליהם, מהטבלאות של Arena.ai שנקבעות בהצבעות קהל. Argon מוביל את 25 המודלים ברשימת Text Arena; ב-Code Arena: WebDev הוא שמיני, אחרי ארבעה מודלים של Claude ושלושה מסדרת GPT-6 של OpenAI.

ב-Felo

איך נראה תהליך מחקר עם כותב של 1M טוקנים

‏Felo מחברת חיפוש להבנת מסמכים, ולכן מודל עם פלט ארוך משנה את מה שסשן אחד יכול להפיק.

מחקר שמסתיים במסמך

אספו מקורות, ואז תנו למודל לכתוב את הסינתזה במעבר אחד במקום להרכיב אותה סעיף-סעיף דרך פרומפטים רבים.

ערכות מסמכים שלמות במשימה אחת

שליפה מהקשר ארוך היא היכולת החזקה ביותר של Argon, והיא מה שהופך ערכות חוזים, דיווחים ודוחות ארוכים לעבודה ישימה.

כתיבה שבה הטון חשוב

הפרופיל המדווח של Argon — טקסט חזק, כתיבת קוד בינונית — מתאים לצוותים שצריכים טקסט שנקרא ככתוב, ולא כזה שמורכב מחלקים.

עלות

כמה עולה Argon, ומה ישתנה בהמשך

‏Google פרסמה תעריף היכרות ותעריף מחירון גבוה יותר, בלי לומר מתי מתרחש המעבר. תכננו את התקציב לפי המספר הגבוה.

סוג הטוקן
היכרות
בהמשך
קלט
2.00 $ / M
4.00 $ / M
קלט מהמטמון
הנחה של 95%
הנחה של 95%
פלט
10.00 $ / M
20.00 $ / M

לשם השוואה, תעריף ההיכרות עומד בערך באותה רמה כמו GPT-6.1 Sol ו-Sonnet 5.5, וכחמישית מ-GPT-6 Astra. אלה מחירי מחירון, לא עלות מדודה לכל משימה — Argon עונה על שאלות קשות יותר, כך שהרצה אחת עדיין יכולה לעלות יותר.

איך לעבוד עם Argon ב-Felo

01

הביאו את כל השאלה

תנו ל-Felo את ערכת המסמכים או את השרשור הארוך עצמו, לא תקציר שלהם. היתרון של Argon מתחיל במקום שבו ההקשר מפסיק להיכנס לפרומפט.

02

בקשו את התוצר המוגמר

עם תקרת פלט של 1M טוקנים אפשר לבקש את הדוח המלא או את הטיוטה השלמה בהוראה אחת במקום בחלקים.

03

בדקו אותו מול המקורות

‏Felo משאירה את הציטוטים צמודים לתשובה, וזה מה שהופך מסמך ארוך שנוצר על ידי מודל לבר-בדיקה.

הגישה ל-Argon בתוך החיפוש של Felo נמצאת בתהליך. עד שתיפתח, כל שאר המודלים בקו של Felo זמינים כעת.

פתחו את החיפוש של Felo AI

Gemini 4 Argon: שאלות נפוצות

לא באופן כללי. Google שחררה את Argon קודם לשותפים נבחרים בתוכנית Fairwind שלה, ואומרת שהגישה הרחבה תתחיל בלקוחות API בתשלום ובמנויי Google AI Ultra. לא הוכרז תאריך לשלב הזה, ומנוי בתשלום לא מקנה גישה היום.

נסו את מודלי הדגל של Google ב-Felo

חפשו, קראו וכתבו עם המודל שמתאים למשימה. Argon יצטרף לקו כשההשקה שלו תגיע ל-Felo.

פתחו את החיפוש של Felo AI

אין צורך בכרטיס אשראי כדי להשתמש בחיפוש של Felo AI.