01
להחזיק את כל ההקשר
חלון הקשר של מיליון טוקנים וידע עד יוני 2026. שרשור ארוך, מאגר קוד שלם או ערכת מסמכים נשארים במשימה אחת.
Anthropic השיקה את Opus 5.5 ב-22 בספטמבר 2026
המודל הראשון במשפחת Claude 5.5. הוא מגיע לרמה של Claude Fable 5.1 ברוב העבודות, עולה ב-40% פחות להרצה מ-Opus 5, ומייצר פלט מהיר ביותר מ-30%.
זמין כעת בחיפוש של Felo
Claude Opus 5.5 זמין בחיפוש של Felo למשימות עם קלט ארוך: הצלבת מספרים בין קבצים, מעקב אחר טענה עד למקור, והחזרת תשובה שאפשר להעביר הלאה כמו שהיא.
01
חלון הקשר של מיליון טוקנים וידע עד יוני 2026. שרשור ארוך, מאגר קוד שלם או ערכת מסמכים נשארים במשימה אחת.
02
בבדיקה פנימית של Anthropic, 16 מתוך 18 דוחות עברו את רף האיכות. מספר אחד או ציטוט אחד שהומצאו היו מכשילים את כל הבדיקה.
03
Anthropic עיצבה מחדש את אופן התקשורת של המודל: המידע החשוב ביותר מגיע ראשון, והדוח אומר בפירוש מה הושלם, מה נמצא ומה עוד פתוח.
מדריך קצר
Claude Opus 5.5 מופיע בבורר המודלים לצד שאר המודלים המובילים בחשבון שלכם.
מה שונה ב-Opus 5.5
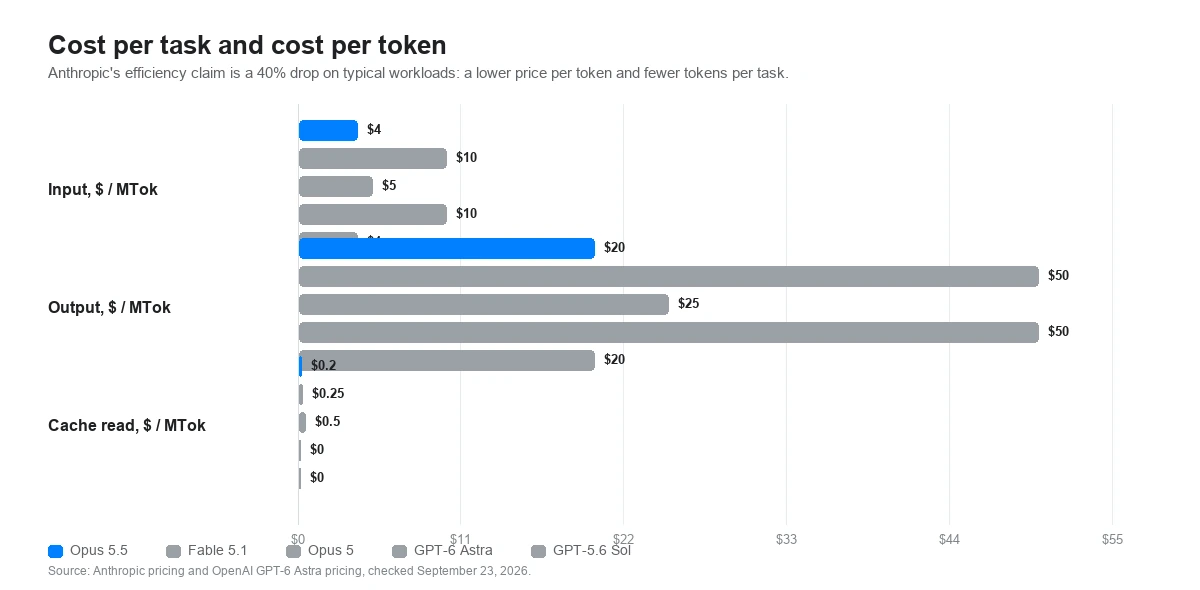
Anthropic שמה את הדגש על יעילות ולא על ציון בנצ׳מרק גבוה יותר: פחות טוקנים לכל משימה, מחיר נמוך יותר לטוקן, ועלות נמוכה ב-40% בעומסי עבודה אופייניים. זה מה שהופך עבודת סוכן ארוכה למשתלמת.
01
Anthropic מדווחת שבודק מוקדם בחן ותיקן בסיס קוד של 200,000 שורות בפחות משלוש שעות, בעוד Opus 5 נדרש ליותר מ-20 שעות והשתמש בפי 2.5 טוקנים.
02
Deloitte דיווחה שגם בדרגת effort הנמוכה ביותר Opus 5.5 תפס 72% מהבאגים הידועים בסקירת קוד, לעומת 56% ב-Opus 5 ב-high, ועם פחות התראות שווא.
03
הטקסטים קצרים יותר ומאורגנים טוב יותר. Box דיווחה שתשובות היו פחות מלל ב-40% בלי לאבד דיוק, ובשליש מהטוקנים של Opus 5.
בחירת מודל
המחירים שלמטה הם תעריפי API ציבוריים רשמיים לכל מיליון טוקנים, ולא מחירי מנוי או שימוש של Felo. שורת ה-effort חשובה כמו שורת המחיר: אותו פרומפט יכול לעלות אחרת לגמרי לפי נקודת הפתיחה של כל מודל.
תעריפי ה-API הציבוריים וברירות המחדל נבדקו ב-23 בספטמבר 2026 מול הודעת Claude Opus 5.5 של Anthropic, עמודי המודלים ב-Claude Platform והעמוד של GPT-6 Astra ב-OpenAI. מחיר הטוקן הוא רק חלק מהעלות הכוללת של משימה. הצהרת היעילות של Anthropic היא ירידה של 40% בעומסים אופייניים, והיא משלבת מחיר נמוך יותר לטוקן עם פחות טוקנים לכל משימה.
התוצאות שפרסמה Anthropic
Anthropic פרסמה את המספרים שלה לצד Fable 5.1, Opus 5, GPT-6 Astra ו-GPT-5.6 Sol. שניים מארבעת הגרפים שלמטה מציגים דיוק מול עלות לכל משימה ולא דיוק בלבד, כי זו בדיוק ההשוואה ש-Anthropic עורכת.
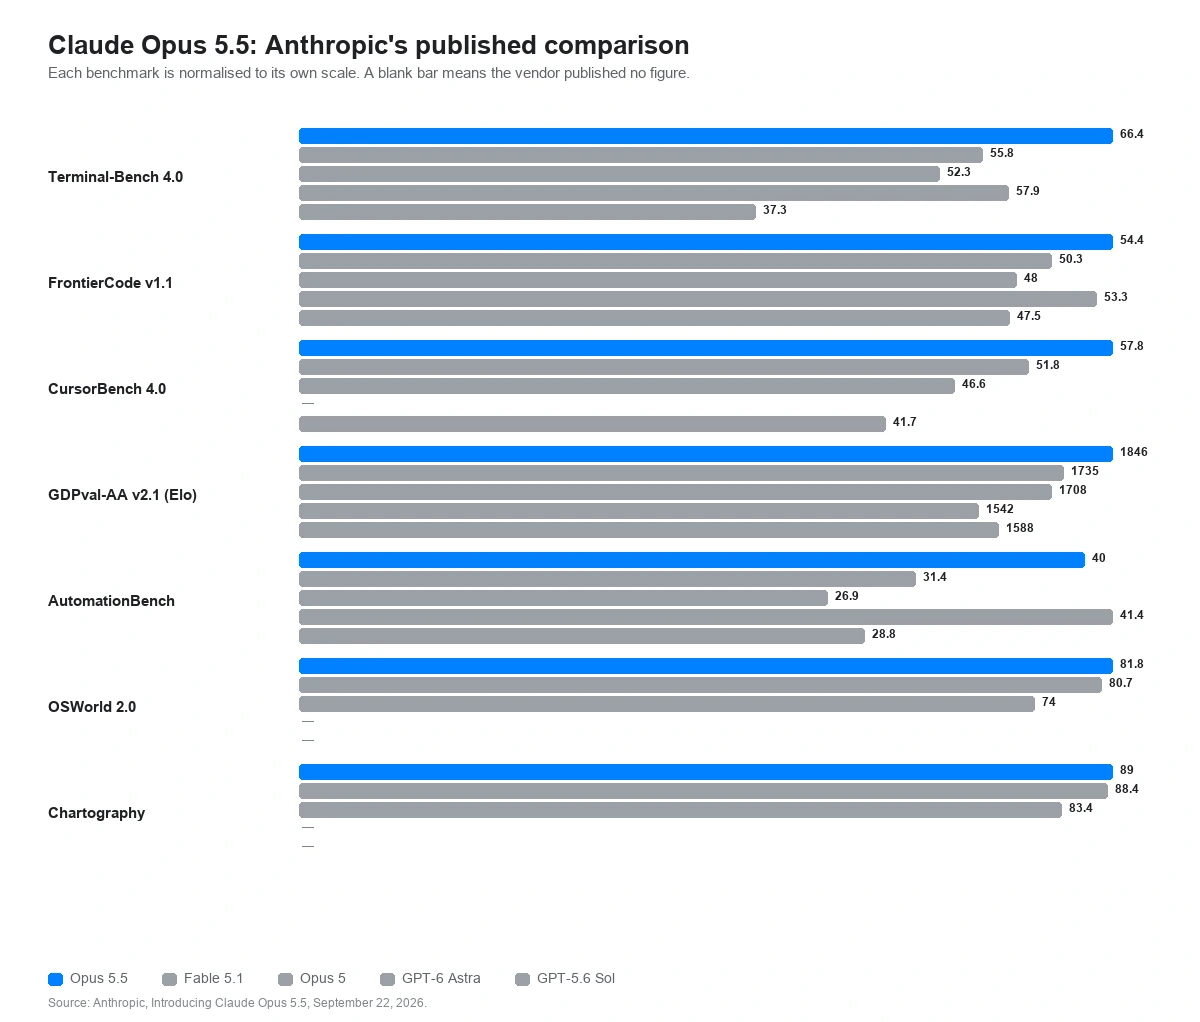
ההשוואה המלאה שפורסמה
כתיבת קוד סוכנית, עבודת ידע, תהליכים עסקיים, היסק בין-תחומי, מחקר מדעי, שימוש במחשב וקריאת גרפים, בכל חמשת המודלים שנמדדו.
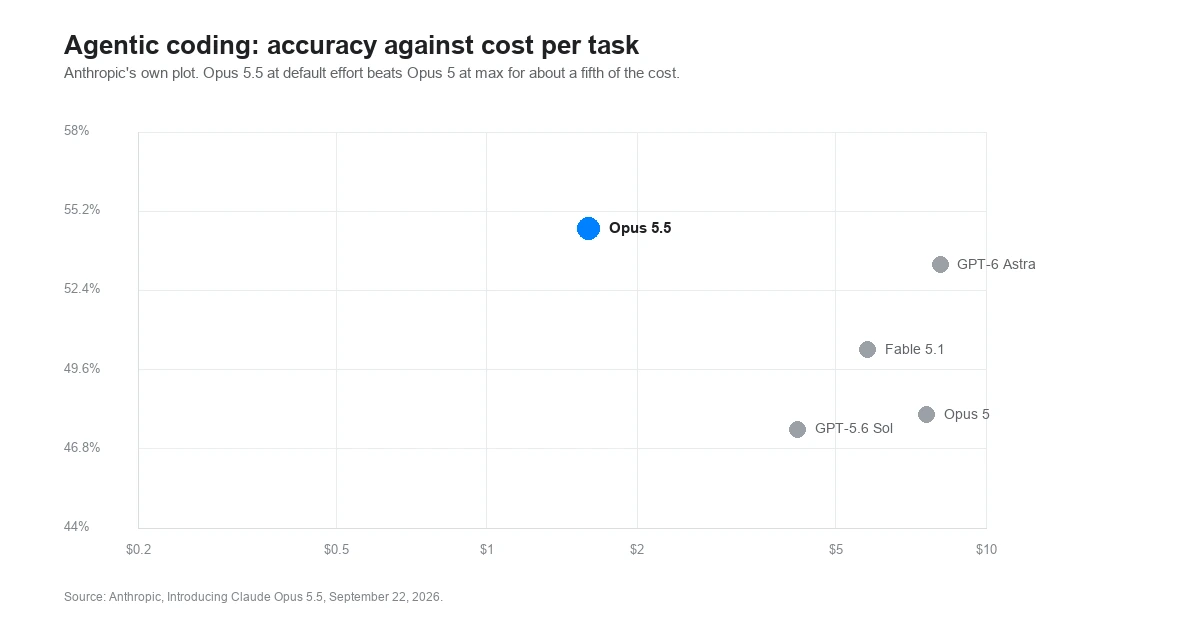
כתיבת קוד סוכנית
Terminal-Bench 4.0, FrontierCode v1.1 ו-CursorBench 4.0, כשברקע עלות לכל משימה.
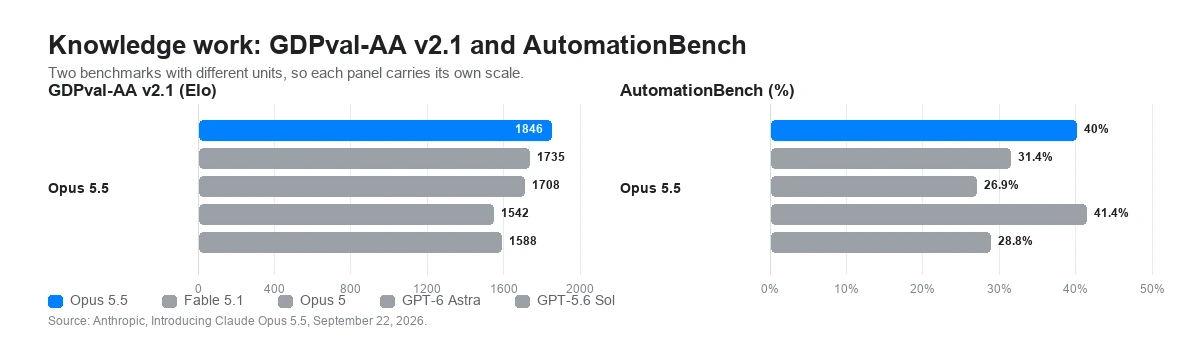
עבודת ידע
GDPval-AA v2.1 על פני 44 מקצועות, AutomationBench, ובנצ׳מרק איסוף הנתונים WANDR של Perplexity.
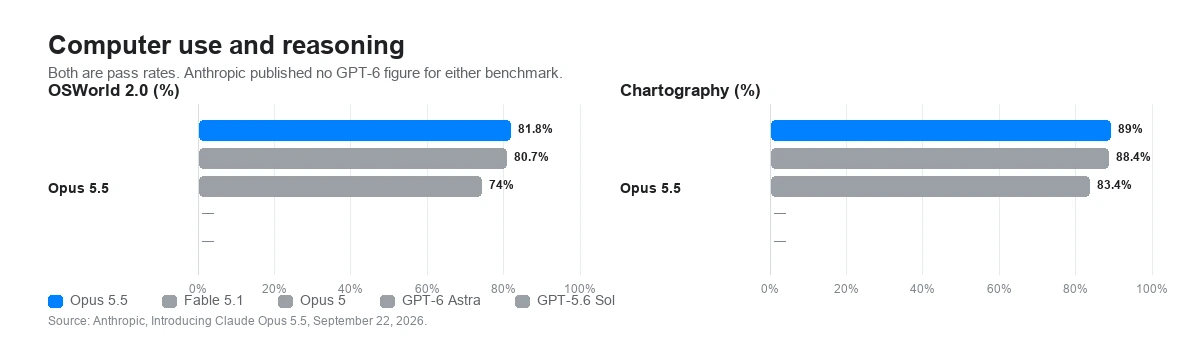
שימוש במחשב והיסק
OSWorld 2.0, Humanity's Last Exam ו-Chartography, כשהאחרון מודד את הדיוק בקריאת ערכים מגרף.
דיוק מול עלות לכל משימה
הטענה המרכזית של Anthropic אינה ציון גבוה יותר בכל מחיר, אלא אותו ציון או טוב יותר בשבריר מהעלות לכל ניסיון.
מספרים שפורסמו על ידי הספק. אלא אם צוין אחרת, Anthropic הריצה את Opus 5.5 עם חשיבה אדפטיבית ב-max effort והעריכה אותו כשאמצעי ההגנה לייצור פעילים. כשאמצעים אלה התערבו, משימות סייבר הושלמו על ידי Opus 4.8 ומשימות ביולוגיה על ידי Opus 5, מה שככל הנראה מפחית את המספרים שפורסמו ל-Opus 5.5 בבנצ׳מרקים האלה. המספרים של GPT-6 Astra ו-GPT-5.6 Sol הם כפי ש-OpenAI דיווחה. פערי בנצ׳מרק בין ספקים הם אינדיקציה חלשה להבדלים אמיתיים, וכך Anthropic עצמה אומרת על המספרים האלה.
אם אתם כבר מריצים Opus 5
Anthropic מפרטת ארבעה שינויים לא תואמים לאינטגרציות שכבר פועלות על Claude Opus 5, ובנוסף שינוי חמישי שמשנה את מבנה התשובה בלי להכשיל בקשות. כדאי לקרוא אותם לפני החלפת מזהה המודל, כי שלושה מהם מחזירים שגיאת 400 במקום להידרדר בשקט.
01
ב-Opus 5 אפשר היה לכבות חשיבה ב-high ומטה. ב-Opus 5.5 היא תמיד פעילה, וגם צורת הכיבוי וגם תקציב טוקנים ידני מחזירים שגיאת 400. effort הוא כעת הבקרה היחידה, וברירת המחדל עברה מ-high ל-medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
הגדרת tool_choice ל-"any" או לכלי בשם מפורש מחזירה שגיאת 400, כולל בנקודת ספירת הטוקנים. השתמשו ב-auto יחד עם שימוש קפדני בכלים או פלט מובנה, וציינו בפרומפט מתי הכלי רלוונטי.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
כל בלוק חשיבה מתעד איזה מודל יצר אותו. Opus 5.5 קורא בלוקים מ-Opus 5 וממודלים קודמים של Opus, Sonnet ו-Haiku, אבל לא מ-Fable או Mythos. אם נתב מעביר את השיחה למודל אחר, הסבבים הבאים רצים בלי ההיסק הקודם.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 שומרים על החשיבה; מודלים אחרים מפילים אותה
04
ב-Claude API וב-Google Cloud הכלי computer_20251124 מחזיר שגיאת 400. הצהירו במקומו על ערכת computer_toolset_20260801, הסירו את כותרת ה-beta, והתאימו את לולאת הסוכן לבלוקי member tool_use. ב-Amazon Bedrock הכלי הישן עדיין עובד.
computer_20251124 -> computer_toolset_20260801
מאחר שאי אפשר לכבות חשיבה, מה שמכווננים הוא effort. Opus 5.5 תומך בכל חמש הדרגות ומתחיל ב-medium, דרגה אחת מתחת ל-Opus 5. ההמלצה של Anthropic היא להריץ סריקה מחודשת על ההערכות שלכם ולא להעביר הגדרה קיימת, ולהקצות max_tokens נדיב בדרגות הגבוהות, כי טוקני חשיבה נספרים במכסה הזו גם כשטקסט החשיבה לא מוחזר.
effort הוא אות התנהגותי ולא תקציב טוקנים נוקשה: בדרגה נמוכה המודל עדיין חושב על בעיות קשות באמת, רק פחות מאשר בדרגה גבוהה. Anthropic מציינת גם שב-Opus 5.5 יש נטייה לחשוב יותר בכל סבב מאשר ב-Opus 5 באותה דרגה, בעיקר ב-xhigh וב-max, כך שהגדרה שהועברה מ-Opus 5 תייצר סבבים ארוכים ויקרים יותר.
היכן זה מתאים
Opus 5.5 משתלם כשמשימה נמשכת שעות, משתרעת על יותר קבצים ממה שאדם אחד יכול להחזיק, או מפיקה משהו שמישהו אחר צריך לבדוק. אלה המקרים ש-Anthropic והבודקים המוקדמים שלה מתארים, לא פרומפטים כלליים של צ׳אט.
להעביר שינוי דרך מאגר גדול עד שהבדיקות עוברות, במקום לעצור בתיקון הראשון שנראה סביר. Anthropic מדווחת על מיגרציה של 680,000 שורות שהושלמה בפחות מיום על ידי בודק אחד.
Column, אחת הבודקות ש-Anthropic מצטטת, דיווחה שמצאה באג בכך שבדקה תיעוד חיצוני לאינטגרציה של צד שלישי שתוכננה לא נכון כמה קומיטים קודם.
לבנות את המודל ואז את הסיכום של עמוד אחד, תוך שמירה על ההסתייגויות. Anthropic מדווחת על ניתוח מיזוג שהושלם ב-63 דקות לעומת 93 ב-Opus 5, בחצי מהעלות.
המודל מאציל לסוכנים משניים ומתאים את הקצב לתקציב זמן. ההמלצה של Anthropic היא לספק לארכיטקטורה מרובת סוכנים אות של זמן שחלף, כדי שתעבוד במקביל ולא בטור.
01
הוסיפו את המאגר, המסמכים והדרישות שתשובה שימושית חייבת להתחשב בהם. חלון מיליון הטוקנים קיים בדיוק בשביל זה.
02
אמרו מה צריך להיות נכון כדי שהעבודה תיחשב גמורה. ההמלצה של Anthropic להרצות ללא השגחה היא להחזיק את חלקי המשימה ברשימה שהמודל מעדכן.
03
הריצו את אותה משימה על Opus 5.5, Opus 5 ו-Fable 5.1 ב-Felo. השוו גם בדיקות, הסתייגויות וצריכת טוקנים, לא רק את התשובה.
בחרו ב-Claude Opus 5.5 כשהוא יופיע בבורר המודלים בחשבון שלכם.
נסו את Opus 5.5 ב-FeloClaude Opus 5.5 הוא המודל של Anthropic לכתיבת קוד סוכנית ארוכה ולעבודת ידע, שיצא ב-22 בספטמבר 2026 כמודל הראשון במשפחת Claude 5.5. לפי Anthropic הוא מגיע לרמה של Claude Fable 5.1 ברוב העבודות, בעוד עלות ההרצה נמוכה ב-40% מזו של Claude Opus 5.
הציבו את Claude Opus 5.5 לצד שאר המודלים המובילים ב-Felo, ואז נסו אותו על העבודה שאתם דוחים כי היא נמשכת שעות.
נסו את Opus 5.5 ב-Feloהתחילו בחיפוש של Felo AI ובחרו את המודל במקום שבו הוא זמין.