Diumumkan 30 September 2026 · Dirilis bertahap

Gemini 4 Argonriset panjang, ditulis utuh sampai tuntas

Model frontier pertama Google sejak Gemini 3, dibangun untuk penalaran mendalam pada pekerjaan panjang yang berlapis. Batas outputnya naik dari 64K token menjadi 1M, dan angka yang dipublikasikan Google lebih menonjol di pekerjaan pengetahuan ketimbang coding.

Felo API masih dalam tahap beta tertutup — akses ke Gemini 4 Argon akan segera hadir.
Gambar utama Gemini 4 Argon: nama model di samping angka 4 besar di atas gradasi biru
Gambar dari pengumuman Google. Argon hadir dengan skema penamaan baru, bukan sebagai pembaruan lini Gemini 4.0, sehingga namanya tidak memuat nomor versi.
1M
Token output maksimum
Naik dari 64K — satu laporan utuh dihasilkan dalam satu lintasan.
2 $ / 10 $
Harga API perkenalan
Per juta token input dan output. Input cache dapat diskon 95%.
77.9%
DeepSWE v1.1
Skor yang dilaporkan Google, di atas Claude Opus 5.5 dan GPT-6 Astra.
15%
Tingkat halusinasi
Tingkat terendah yang diukur Artificial Analysis di antara model frontier.

Gambar dan bagan di halaman ini berasal dari organisasi yang menerbitkannya, yakni Google, Arena.ai, dan Artificial Analysis; semuanya ditampilkan tanpa perubahan apa pun.

Status peluncuran

Argon belum tersedia untuk umum. Ini urutan kehadirannya.

Google merilis Argon secara bertahap, dan tahap pertama bukan untuk publik. Akses di dalam Felo sedang disiapkan bersamaan dengan peluncuran ini.

Sudah tersedia

Tim pertahanan siber tepercaya

Mitra terpilih dalam Fairwind Program Google menerima Argon lebih dulu, dan menerimanya tanpa pengaman siber.

Diumumkan berikutnya

Pelanggan API berbayar dan Google AI Ultra

Google menyebut akses yang lebih luas dimulai dari sini. Belum ada tanggalnya, dan berlangganan saja tidak memberi akses hari ini.

Belum dijadwalkan

Pengembang, perusahaan, dan konsumen

Menyusul setelah tingkat berbayar. Google belum menetapkan tenggat untuk ketersediaan umum.

Akses Argon di dalam Felo Search masih dalam proses. Halaman ini akan diperbarui begitu dibuka.

Kelebihannya

Model yang dibangun untuk menuntaskan pekerjaan panjang, bukan menjawab cepat

Kekuatan Argon yang dipublikasikan berpusat pada membaca, menalar, dan menulis panjang. Bentuknya berbeda dari model frontier yang mengutamakan coding dan sering dibandingkan dengannya.

Penalaran yang bertahan di tugas panjang

Google memosisikan Argon untuk pekerjaan berlapis yang berjalan berjam-jam, tempat model sebelumnya melenceng atau berhenti terlalu awal.

1M token output dalam satu kali jalan

Alasan yang disebut Google: model yang punya ruang untuk berpikir panjang bisa menyelesaikan masalah sulit dalam satu lintasan, bukan lewat banyak bolak-balik.

Pekerjaan pengetahuan yang menonjol, bukan coding

Selisih terlebar yang dilaporkan ada di Harvey's Legal Agent Benchmark dan Vals Finance Agent v2 — analisis hukum dan keuangan sungguhan, bukan tugas sintetis.

Pengambilan konteks panjang yang tetap akurat

Pada GraphWalks, yang menguji apakah model benar-benar bisa memakai konteks 256K sampai 1M, Google melaporkan keunggulan lebih dari sepuluh poin atas model unggulan lain.

Pemahaman video panjang

LVBench, yang mengukur pemahaman atas video panjang, dilaporkan di 91.7% — skor tertinggi yang Google cantumkan untuk Argon.
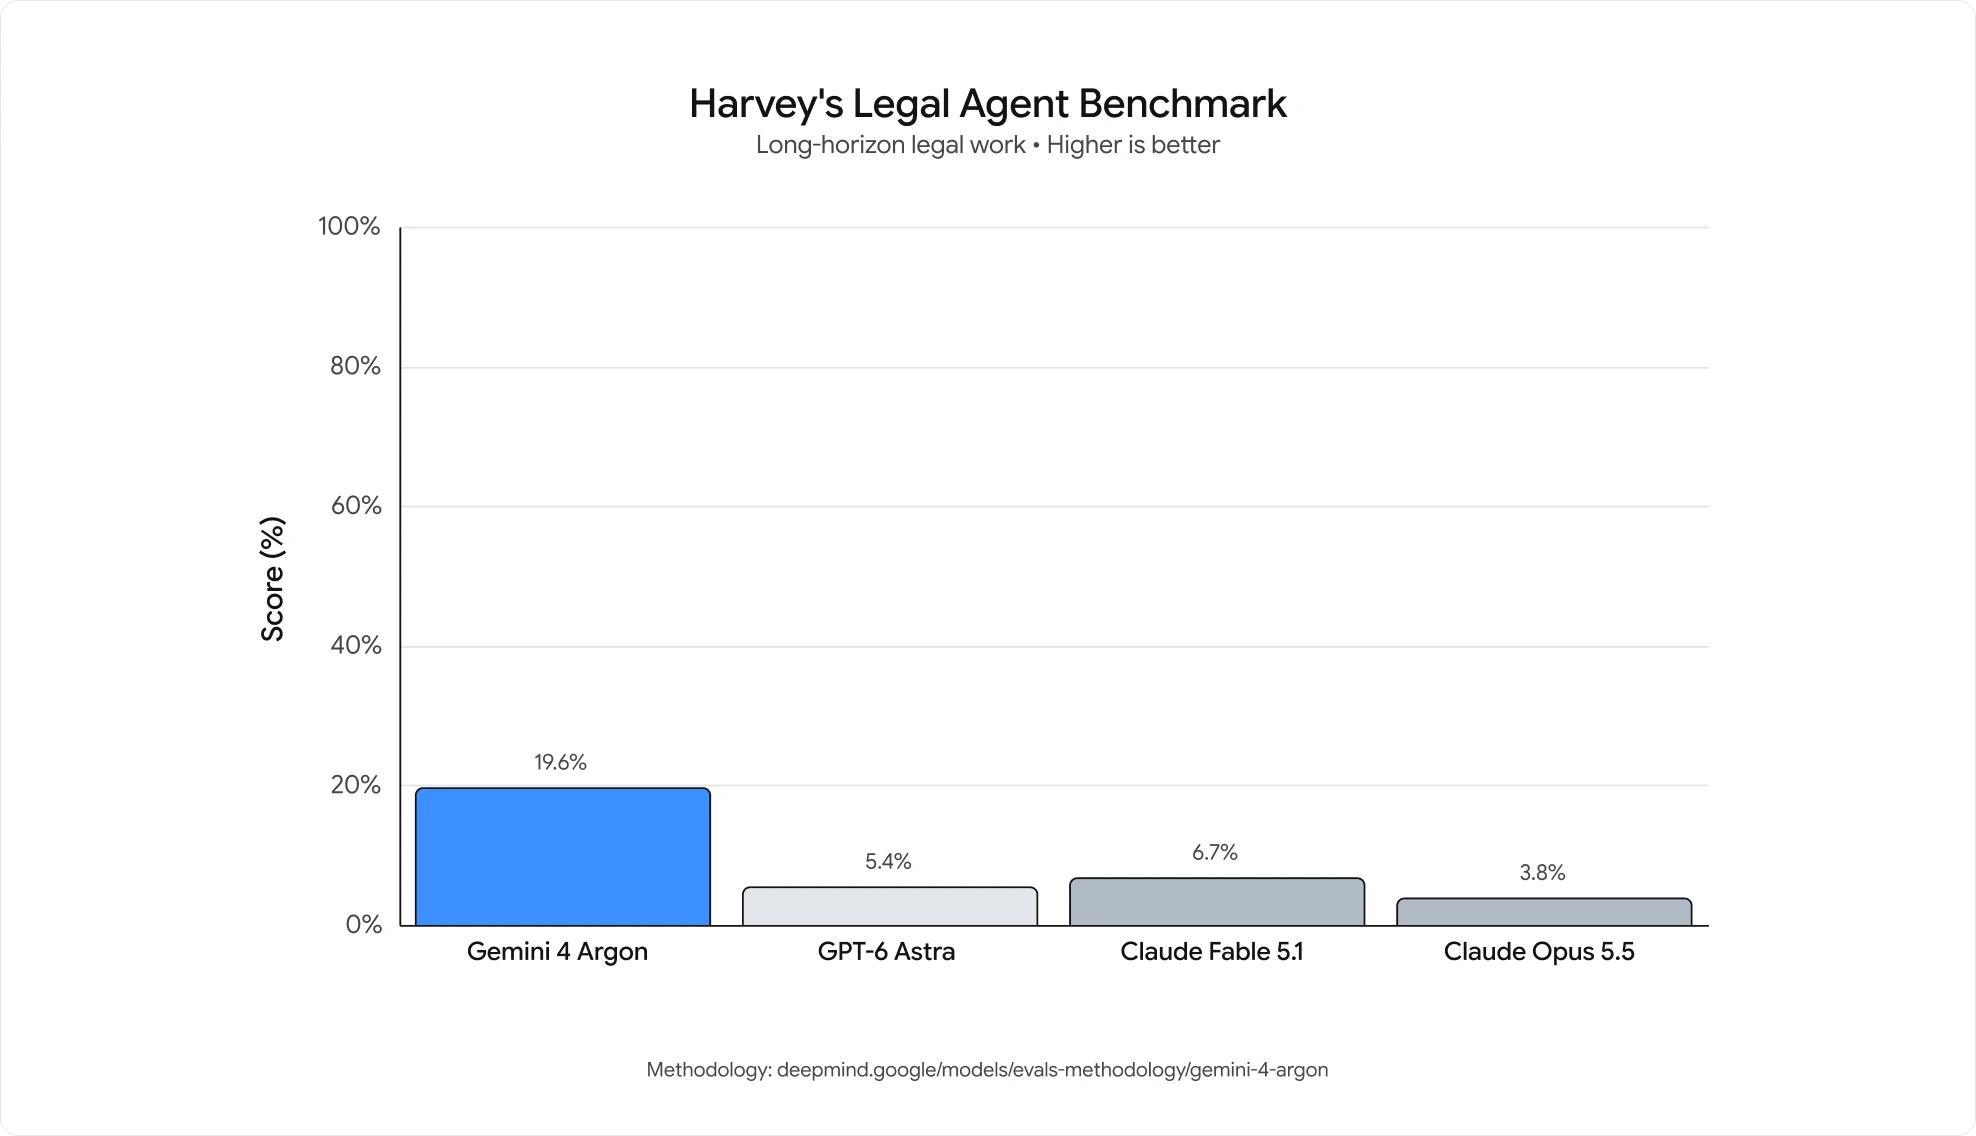
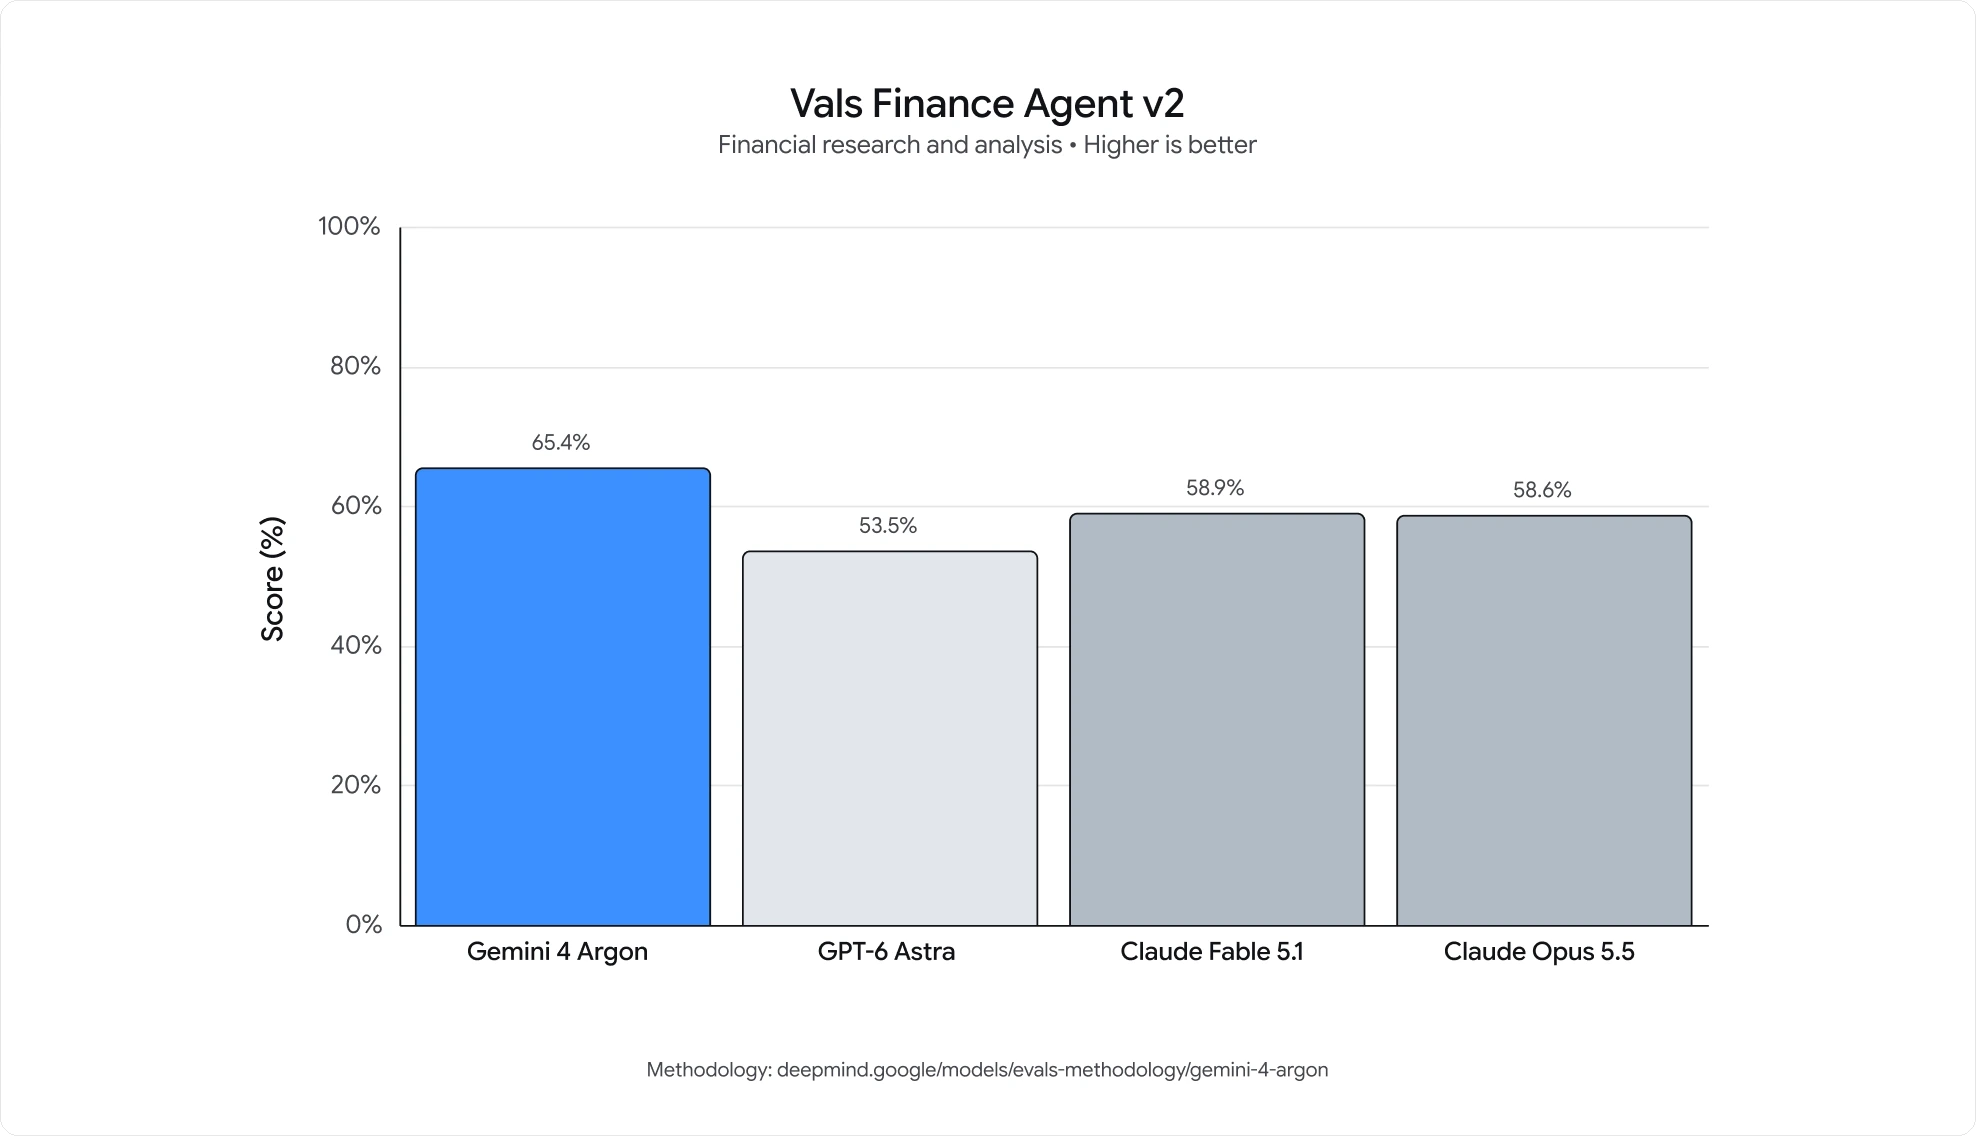
Diagram batang Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Pekerjaan hukum jangka panjang. Angka 19.6% Argon sekitar tiga kali lipat model berikutnya, dan inilah selisih terlebar dalam kumpulan data yang dipublikasikan Google.
Diagram batang Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Riset dan analisis keuangan, di 65.4% berbanding kelompok 53.5–58.9%. Selisihnya lebih sempit daripada pekerjaan hukum, tetapi urutannya sama.

Angka yang dipublikasikan

Posisi Argon di benchmark Google sendiri

Ini hasil yang dilaporkan vendor. Google belum merilis setelan thinking atau effort untuk skor utamanya, dan belum ada lab independen yang mereplikasinya.

Benchmark
Yang diukur
Argon
Pembanding terdekat
DeepSWE v1.1
Rekayasa perangkat lunak jangka panjang
77.9%
Opus 5.5 di 74.2%, GPT-6 Astra di 74.1%
CWE-bench v1
Menemukan dan menambal kerentanan
68%
Seri di peringkat pertama
AutomationBench
Tugas bisnis ujung ke ujung, dari Zapier
51.3%
Peringkat pertama
LVBench
Memahami video panjang
91.7%
Skor tertinggi yang Google laporkan untuk Argon

Anggap ini sebagai petunjuk arah. Benchmark vendor jarang bertahan utuh saat dipakai di beban produksi, dan Bloomberg melaporkan sebagian karyawan Google sendiri ragu bahwa keunggulan benchmark itu terbawa ke pekerjaan nyata.
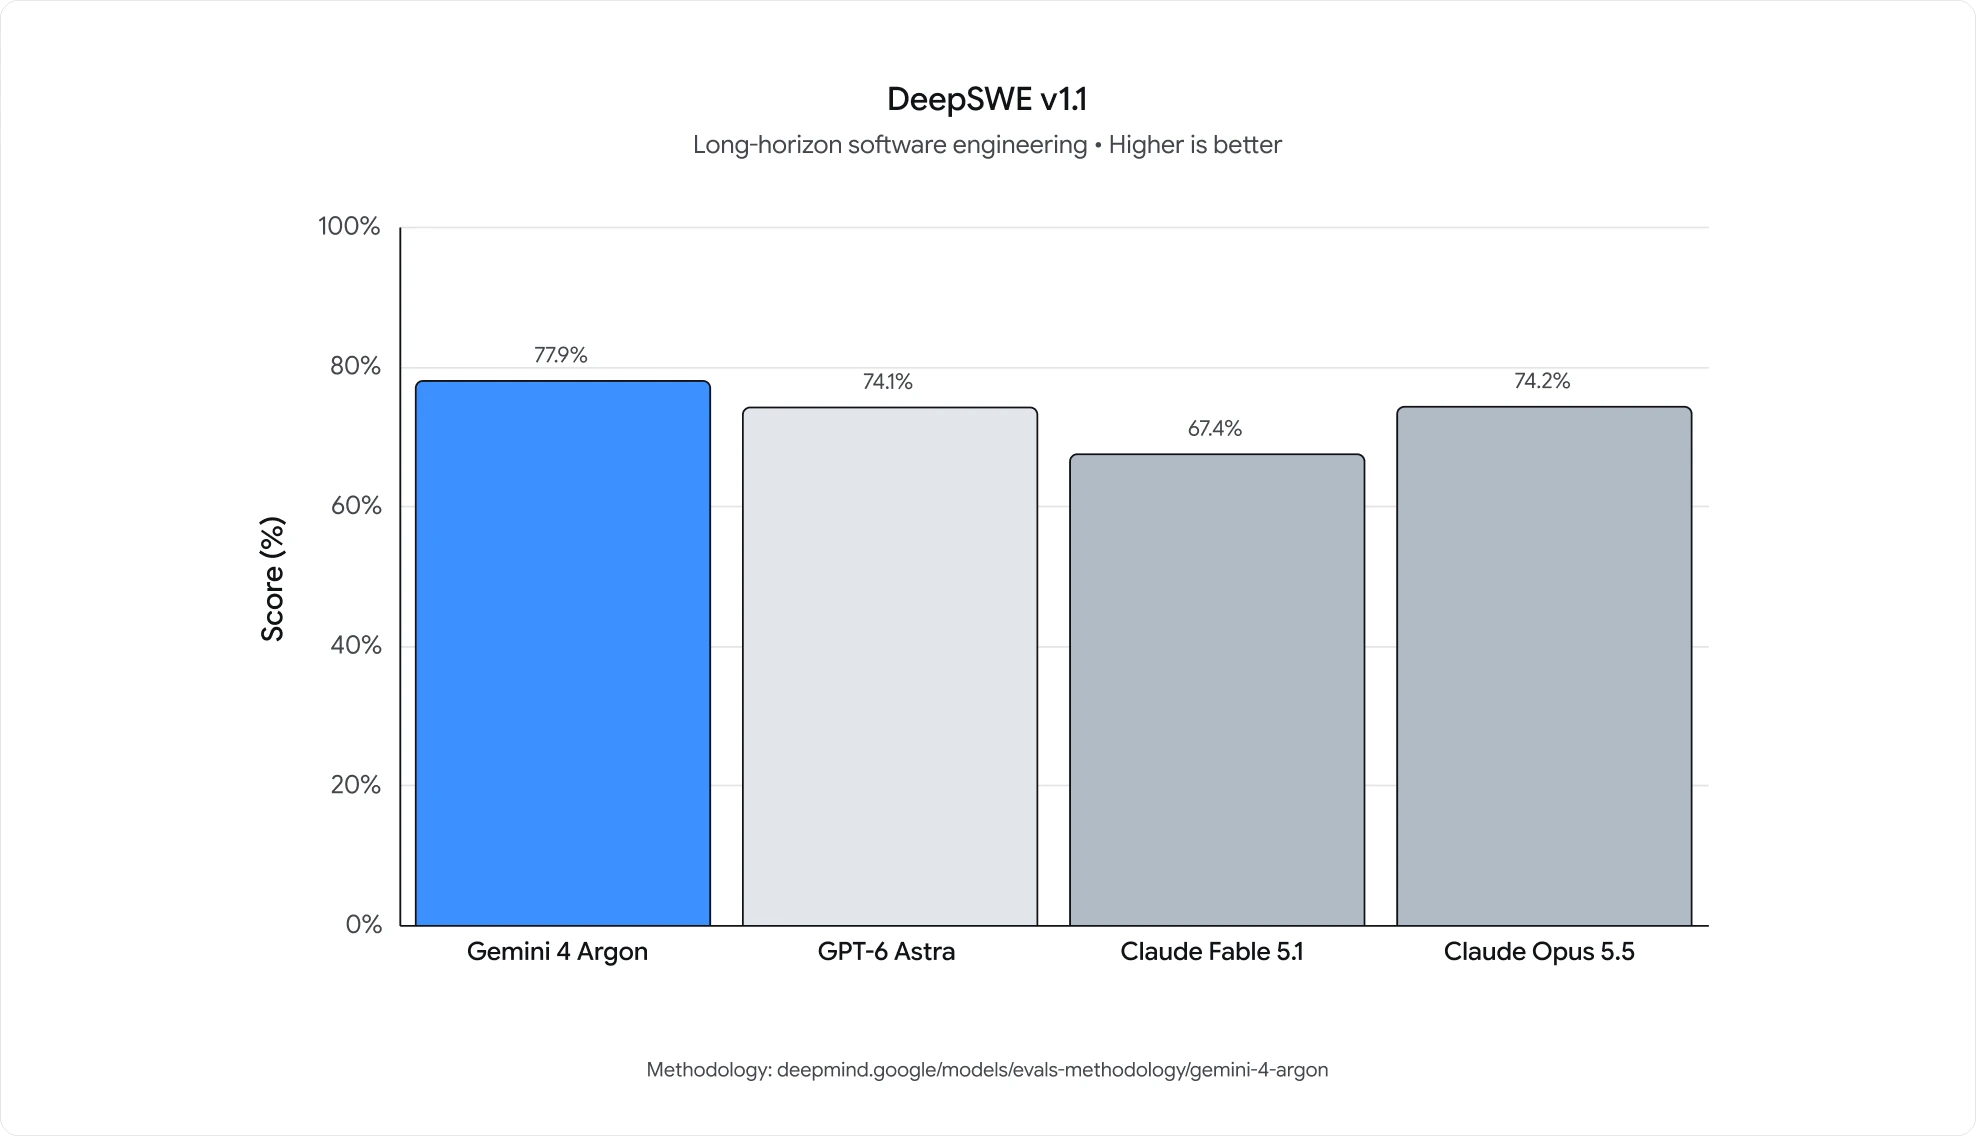
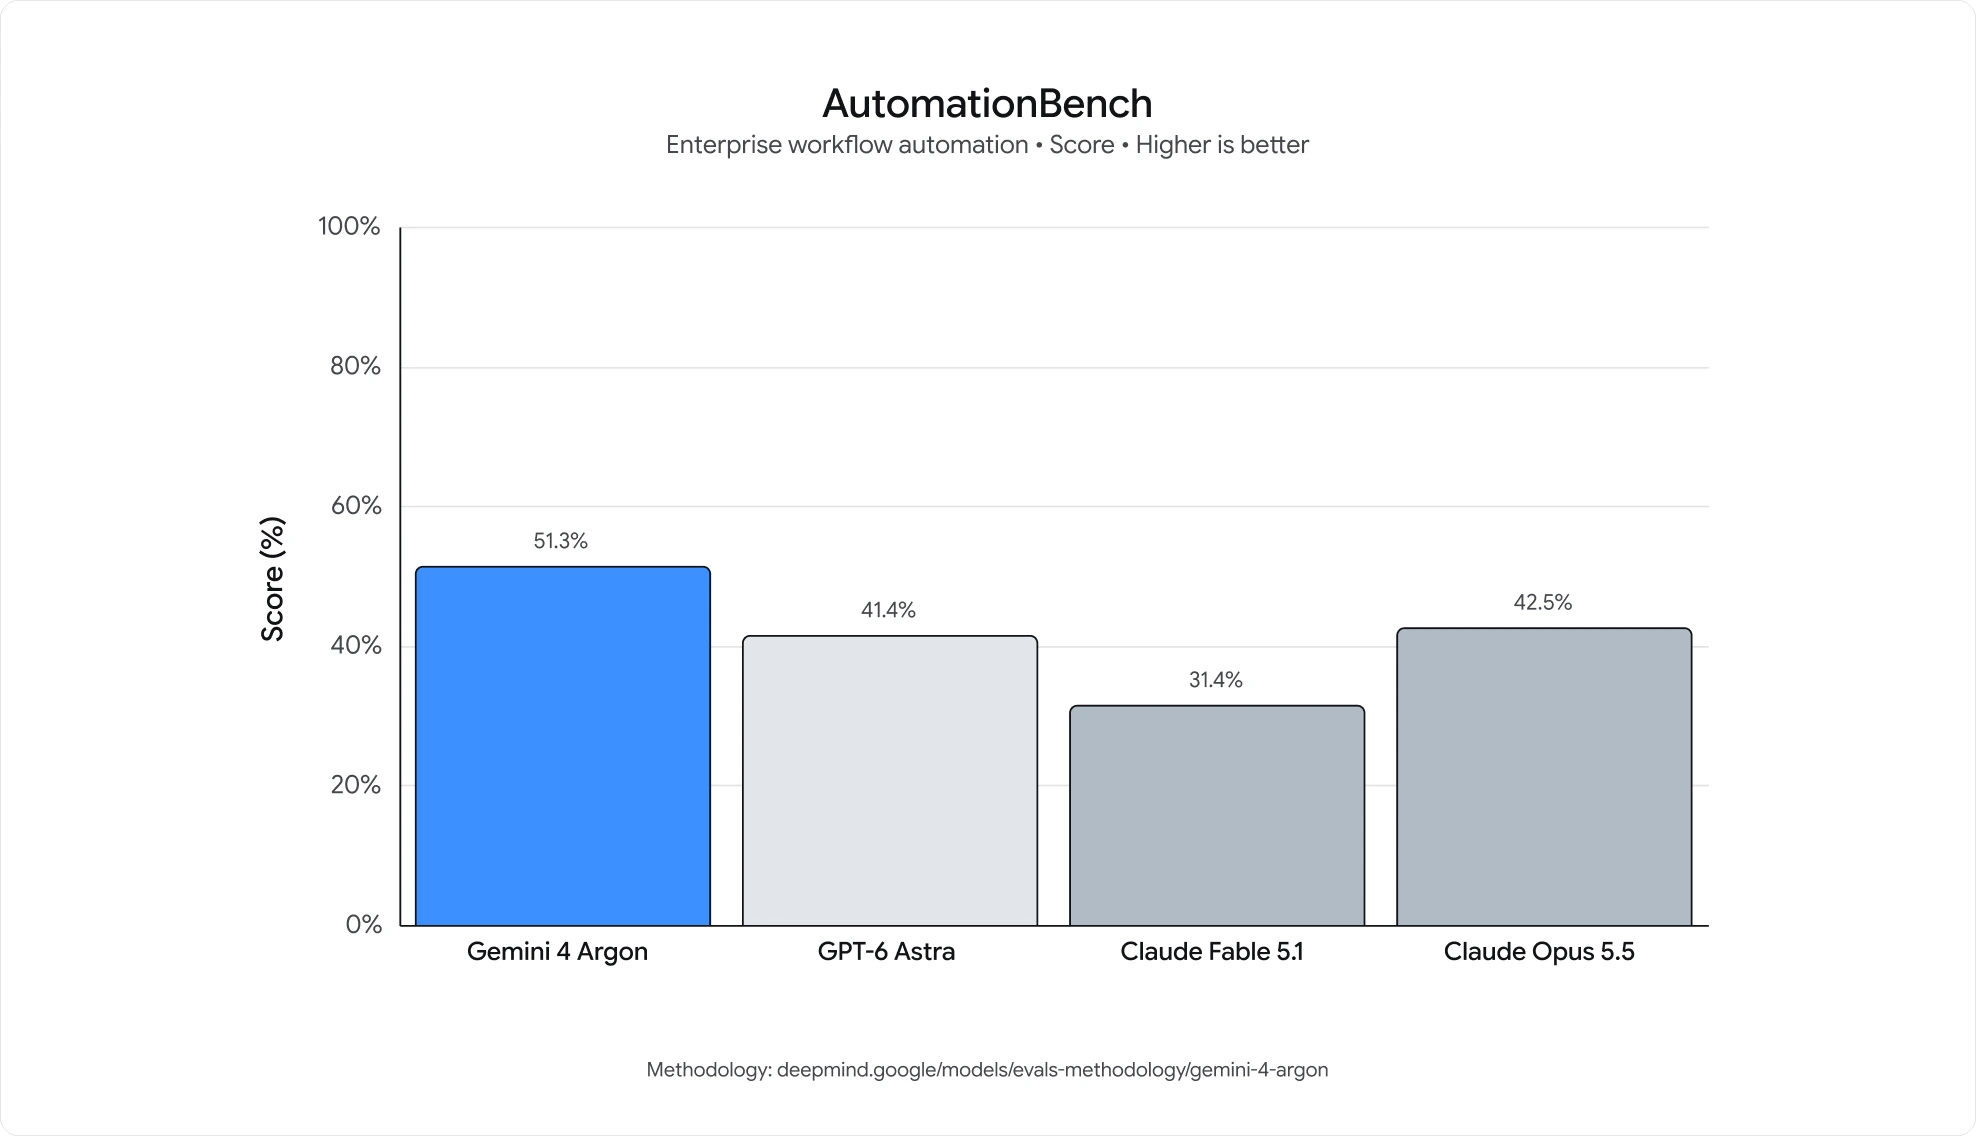
Diagram batang DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Rekayasa perangkat lunak jangka panjang. Angka utamanya 77.9%, dengan kedua pesaing terdekat berada dalam selisih empat poin.
Diagram batang AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Tugas bisnis ujung ke ujung yang dibuat Zapier. Argon melewati 50%, sementara semua model lain dalam perbandingan berada di kisaran tiga puluhan atau awal empat puluhan.
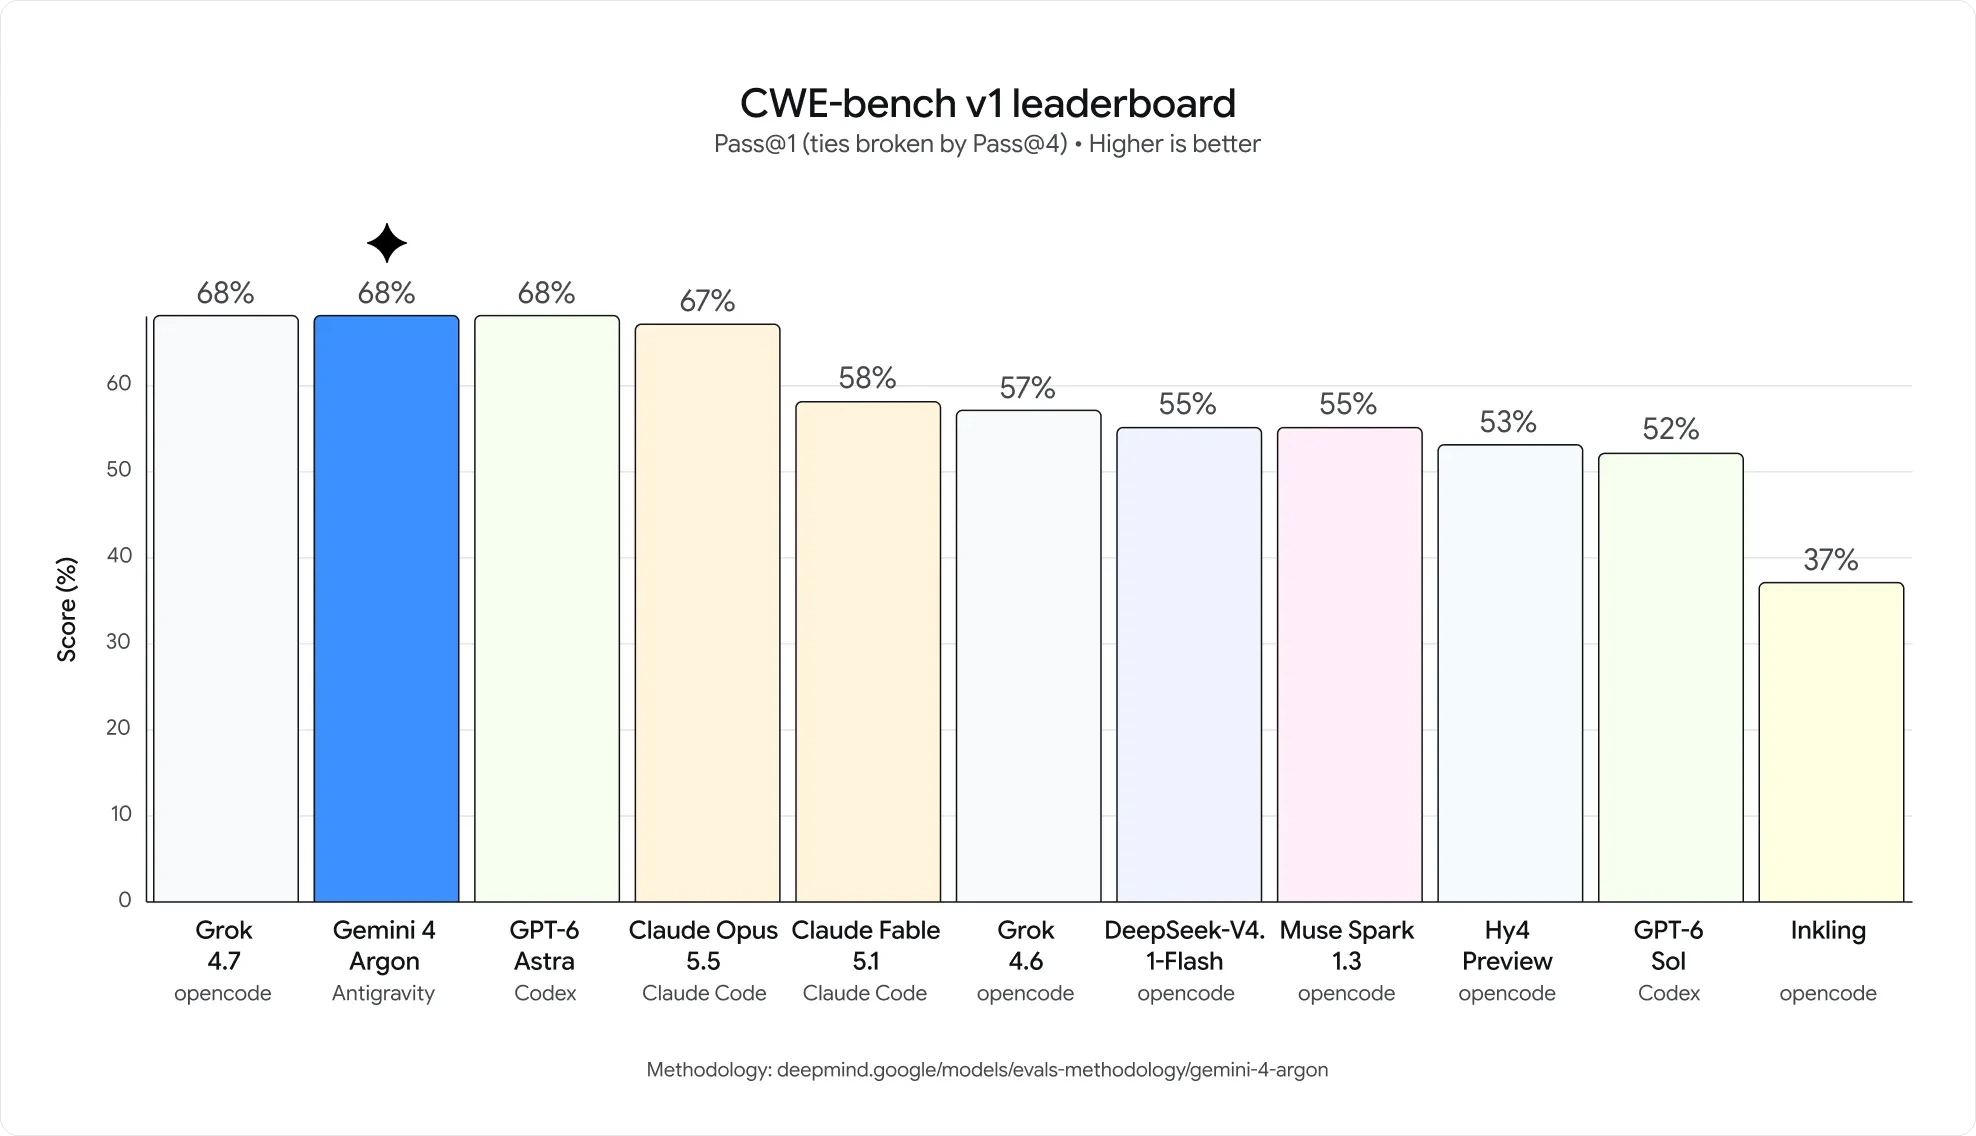
Papan peringkat CWE-bench v1: Gemini 4 Argon, Grok, dan GPT-6 Astra seri di 68%, Claude Opus 5.5 di 67%, menurun hingga Inkling di 37%
Penemuan kerentanan pada Pass@1. Argon seri di puncak papan yang padat, bukan membuka selisih, karena itulah tabel di atas menyebutnya seri di peringkat pertama.
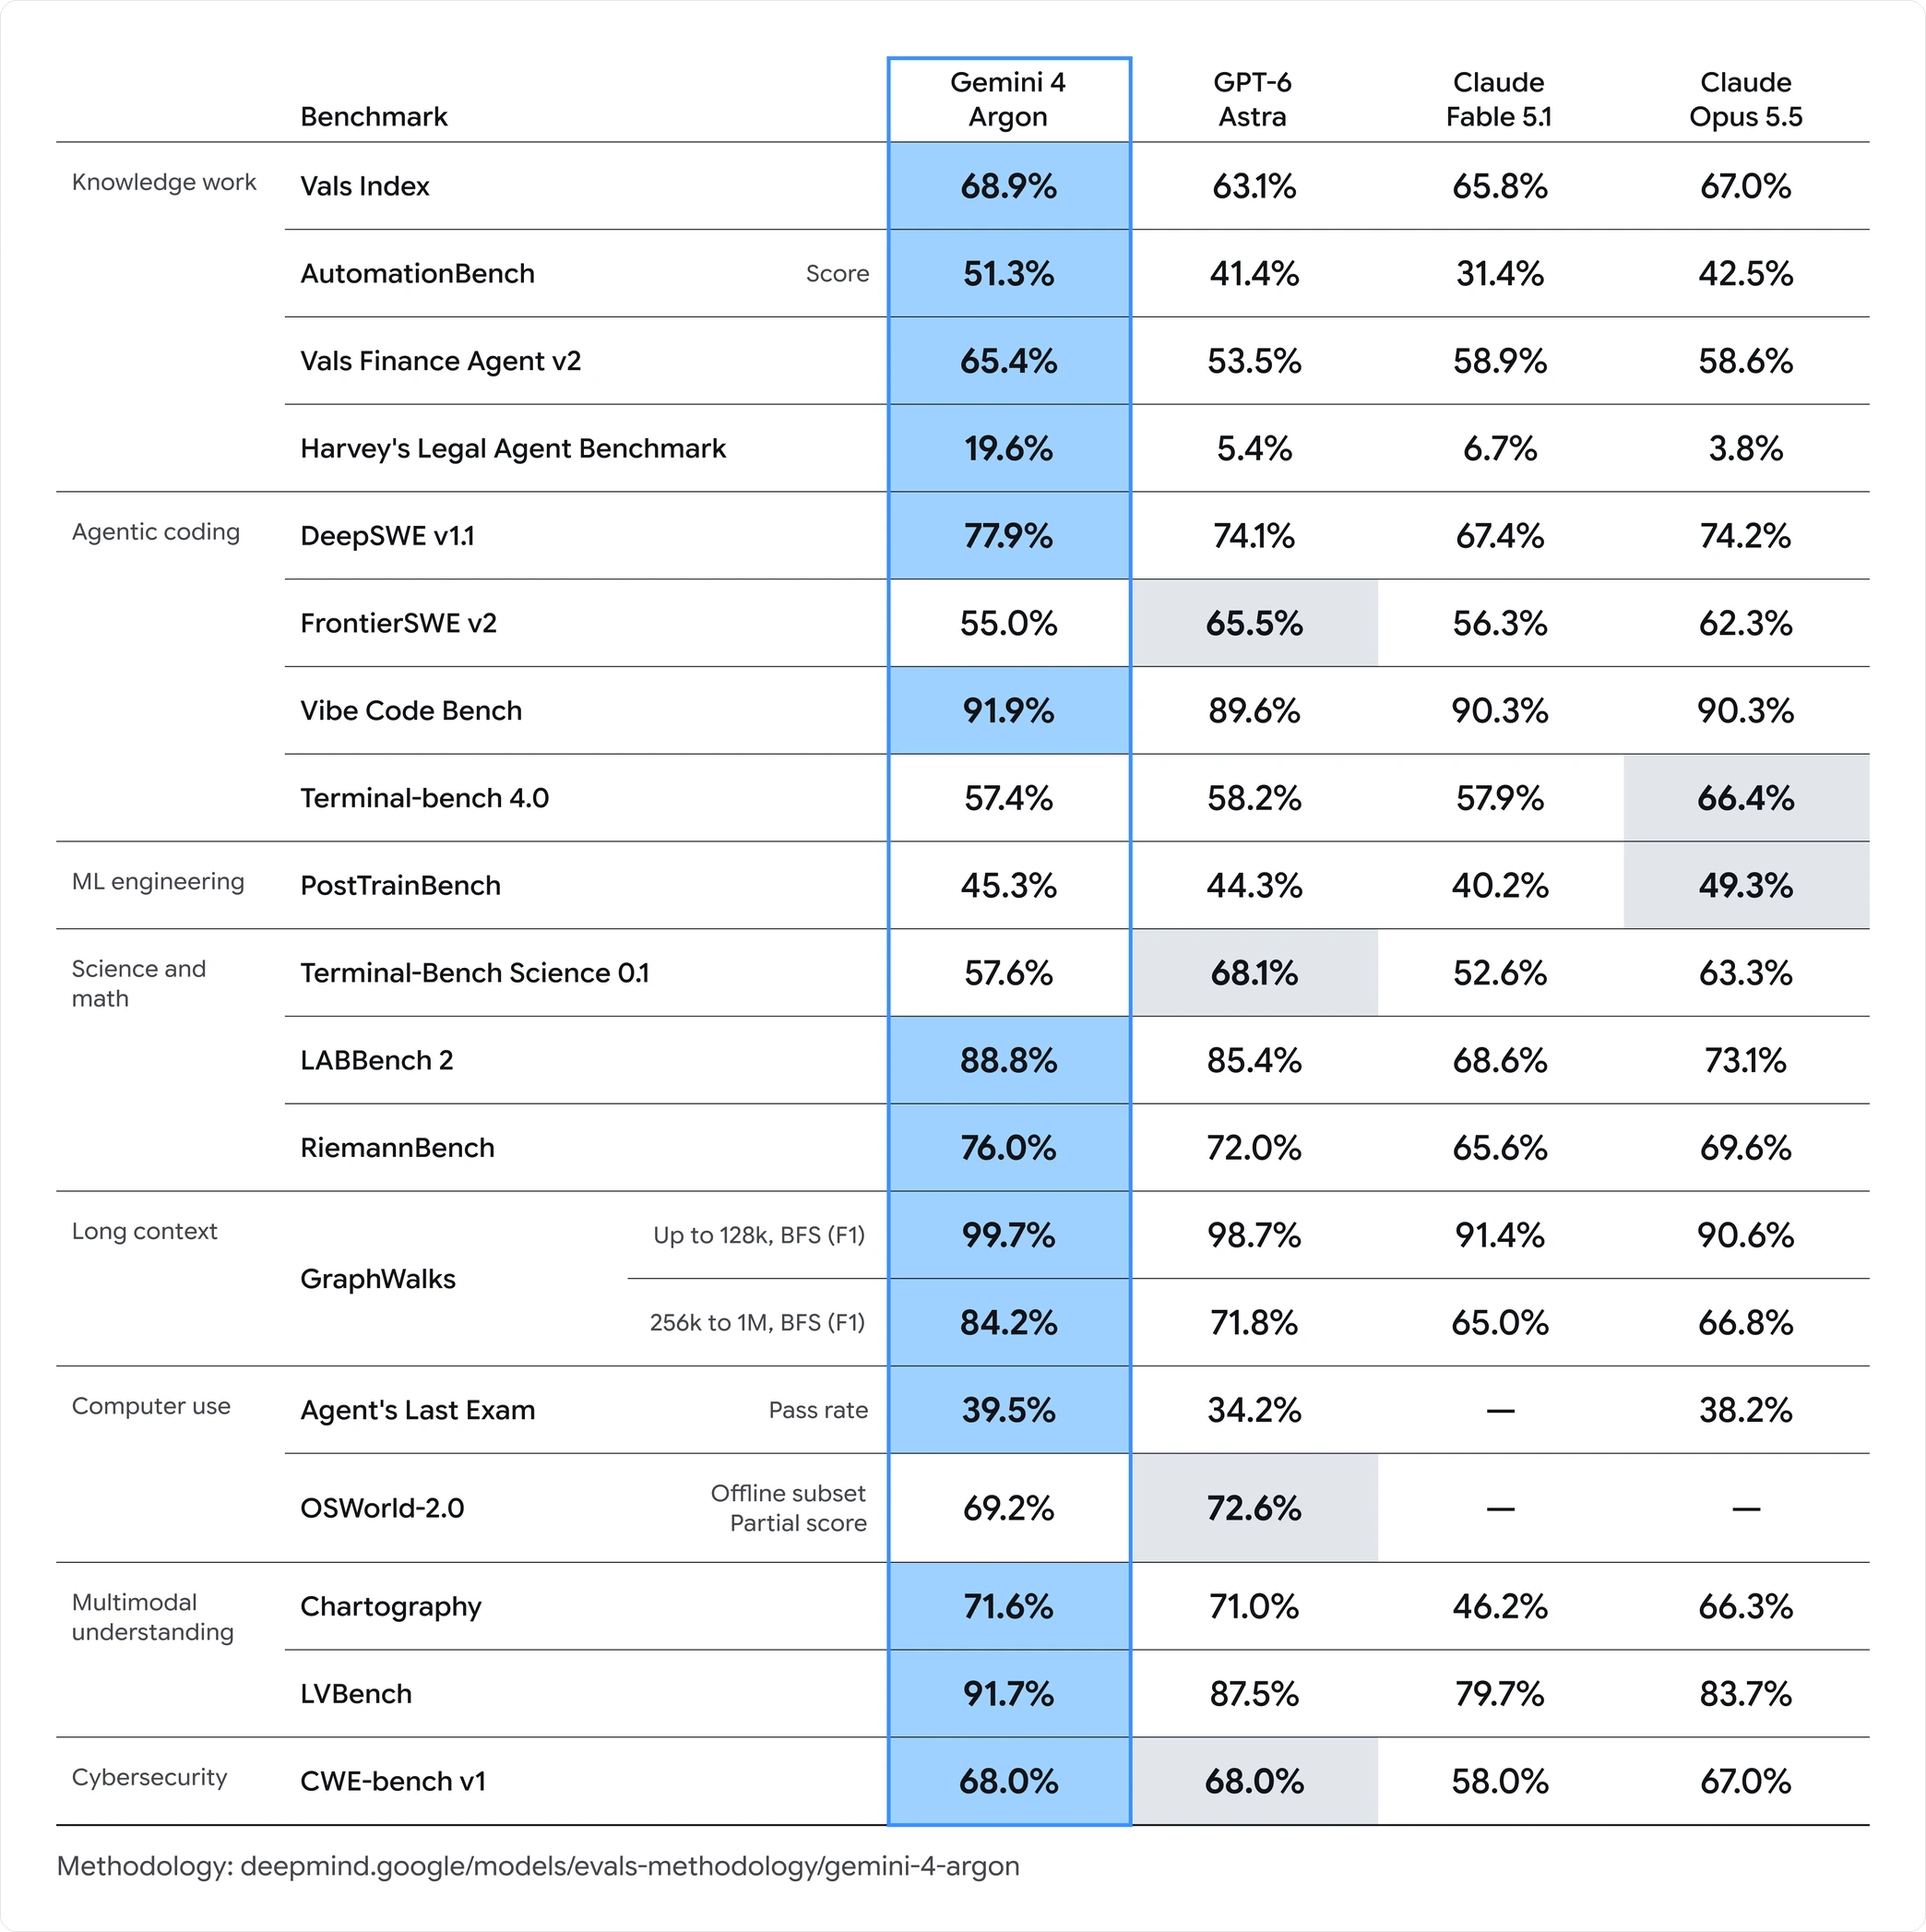
Tabel hasil lengkap Gemini 4 Argon dari Google untuk 16 benchmark, dikelompokkan menjadi pekerjaan pengetahuan, coding agentik, rekayasa ML, sains dan matematika, konteks panjang, penggunaan komputer, pemahaman multimodal, dan keamanan siber
Tabel lengkap dari pengumuman, dengan sel kemenangan Argon berwarna biru dan sel tempat pesaing unggul berwarna abu-abu. Baris tempat Argon tidak unggul adalah FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1, dan OSWorld-2.0.
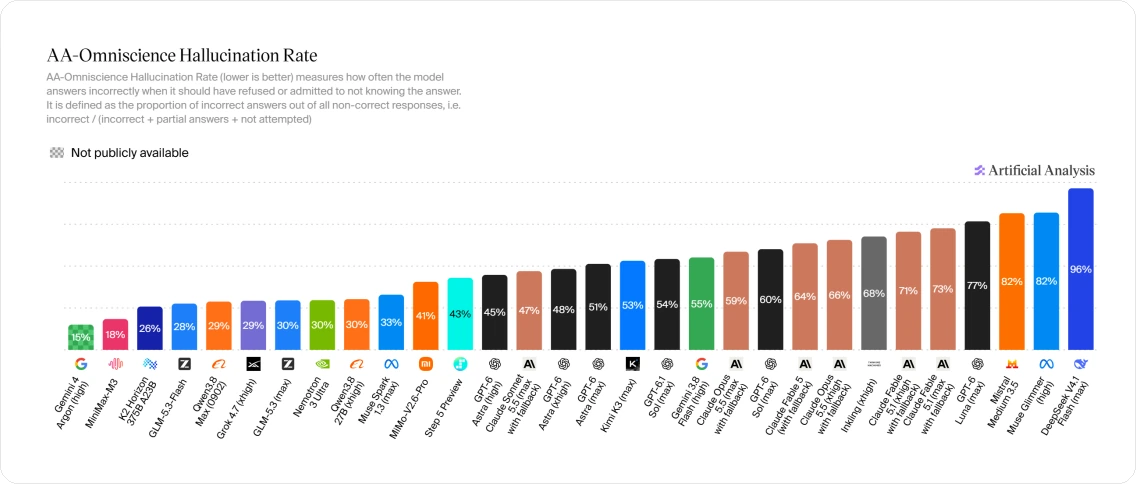
Diagram batang tingkat halusinasi AA-Omniscience dari Artificial Analysis pada 36 model, diurutkan dari yang terendah: Gemini 4 Argon (High) di 15%, lalu MiniMax-M3 di 18%, Kimi K2.5 di 26%, dan naik hingga DeepSeek-V4 Flash di 96%
Pengukuran independen dari Artificial Analysis, dan satu-satunya angka di halaman ini yang tidak dipasok vendor mana pun: seberapa sering tiap model menjawab salah alih-alih memilih untuk tidak menjawab. Angka 15% milik Argon adalah yang terendah dari 36 model yang ada di diagram; skalanya membentang hingga 96%.
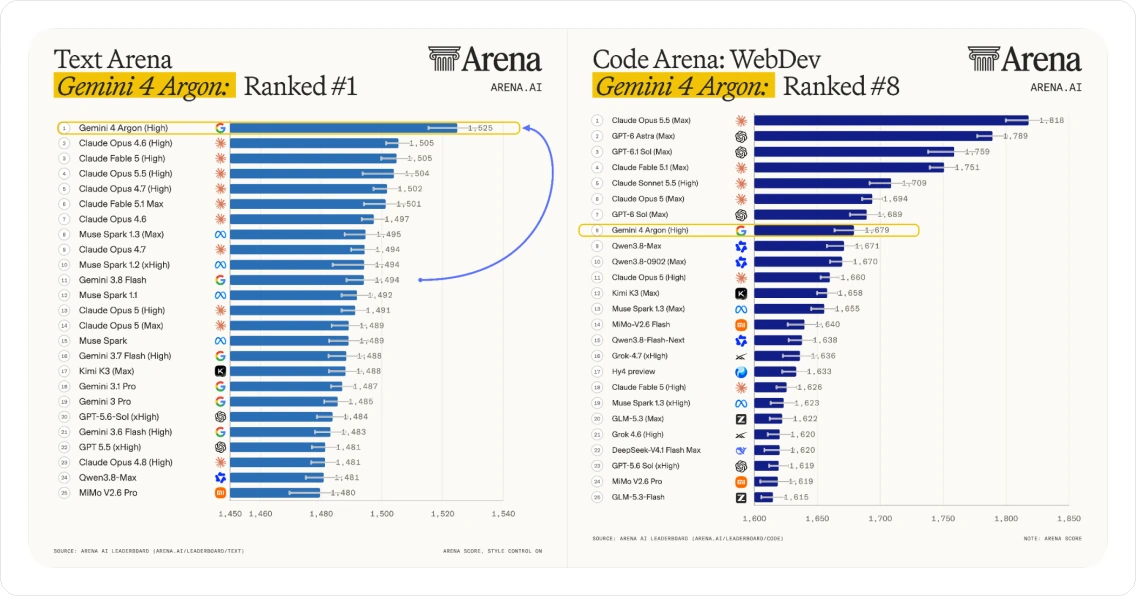
Papan peringkat Text Arena dan Code Arena: WebDev dari Arena.ai berdampingan: Gemini 4 Argon peringkat 1 di Text Arena dengan 1625, dan peringkat 8 di Code Arena: WebDev dengan 1679
Dua peringkat yang menjadi dasar paragraf di atas, berasal dari papan peringkat Arena.ai yang dipilih lewat voting publik. Argon memuncaki 25 model yang terdaftar di Text Arena; di Code Arena: WebDev ia kedelapan, di belakang empat model Claude dan tiga model dari lini GPT-6 milik OpenAI.

Di Felo

Seperti apa alur riset dengan penulis berkapasitas 1M token

Felo memadukan pencarian dengan pemahaman dokumen, jadi model beroutput panjang mengubah apa yang bisa dihasilkan satu sesi.

Riset yang berakhir jadi dokumen

Kumpulkan sumbernya, lalu minta model menulis sintesisnya dalam satu kali jalan, bukan menyusunnya bagian demi bagian lewat banyak prompt.

Seluruh kumpulan dokumen dalam satu tugas

Pengambilan konteks panjang adalah kemampuan terkuat Argon, dan itulah yang membuat set kontrak, laporan berkala, dan dokumen panjang jadi bisa ditangani.

Menulis draf saat nada penting

Profil Argon yang dilaporkan — teks kuat, coding sedang — cocok untuk tim yang butuh tulisan yang enak dibaca, bukan hasil rangkaian potongan.

Biaya

Berapa biaya Argon, dan apa yang berubah nanti

Google mempublikasikan tarif perkenalan dan tarif daftar yang lebih tinggi, tanpa menyebut kapan peralihannya. Susun anggaran Anda dengan angka yang lebih tinggi.

Jenis token
Perkenalan
Berikutnya
Input
2.00 $ / M
4.00 $ / M
Input cache
diskon 95%
diskon 95%
Output
10.00 $ / M
20.00 $ / M

Sebagai perbandingan, tarif perkenalan ini kurang lebih setara dengan GPT-6.1 Sol dan Sonnet 5.5, dan sekitar seperlima GPT-6 Astra. Ini harga daftar, bukan biaya per tugas yang terukur — Argon menjawab pertanyaan yang lebih sulit, jadi satu kali jalan tetap bisa lebih mahal.

Cara bekerja dengan Argon di Felo

01

Bawa seluruh pertanyaannya

Beri Felo seluruh set dokumen atau utas panjangnya, bukan ringkasannya. Keunggulan Argon mulai terasa saat konteksnya sudah tidak muat lagi dalam satu prompt.

02

Minta hasil akhirnya

Dengan batas output 1M token, Anda bisa meminta laporan utuh atau draf lengkap dalam satu instruksi, bukan per bagian.

03

Periksa dengan sumbernya

Felo menjaga sitasi tetap menempel pada jawaban, dan itulah yang membuat dokumen panjang hasil model bisa diperiksa.

Akses Argon di Felo Search masih dalam proses. Sampai dibuka, semua model lain di jajaran Felo sudah bisa dipakai sekarang.

Buka Felo AI Search

Gemini 4 Argon: pertanyaan yang sering muncul

Belum untuk umum. Google merilis Argon lebih dulu ke mitra terpilih di Fairwind Program, dan menyebut akses yang lebih luas akan dimulai dari pelanggan API berbayar serta pelanggan Google AI Ultra. Belum ada tanggal untuk tahap itu, dan langganan berbayar tidak memberi akses hari ini.

Coba model frontier Google di Felo

Cari, baca, dan tulis dengan model yang cocok untuk tugasnya. Argon bergabung ke jajaran saat peluncurannya sampai ke Felo.

Buka Felo AI Search

Tidak perlu kartu kredit untuk memakai Felo AI Search.