Анонс 30 сентября 2026 года · запуск поэтапно

Gemini 4 Argonдлинные исследования, написанные целиком

Первая флагманская модель Google после Gemini 3, созданная для глубоких рассуждений в долгой многошаговой работе. Она поднимает потолок вывода с 64K до 1M токенов и лидирует в опубликованных Google цифрах по работе со знаниями, а не по программированию.

Felo API в закрытой бете — доступ к Gemini 4 Argon появится скоро.
Ключевой визуал Gemini 4 Argon: название модели рядом с крупной цифрой 4 на синем градиенте
Изображение из анонса Google. Argon выходит по новой схеме названий, а не как обновление линейки Gemini 4.0, поэтому в имени нет номера версии.
1M
Максимум токенов вывода
Было 64K — полный отчёт, созданный за один проход.
2 $ / 10 $
Вводная цена API
За миллион входных и выходных токенов. Кэшированный ввод дешевле на 95%.
77.9%
DeepSWE v1.1
Заявленный Google результат, выше Claude Opus 5.5 и GPT-6 Astra.
15%
Уровень галлюцинаций
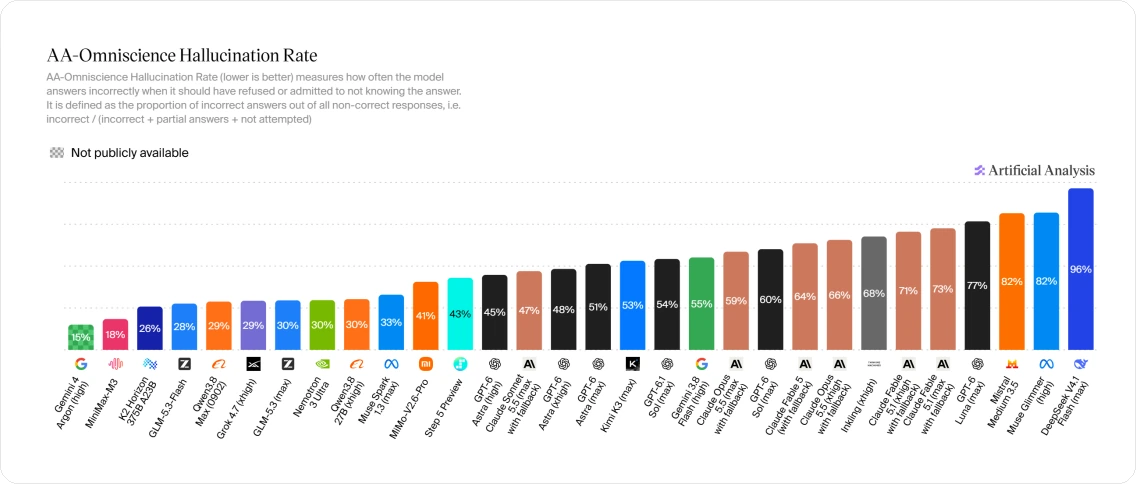
Самый низкий измеренный показатель среди флагманских моделей по данным Artificial Analysis.

Цифры и графики на этой странице взяты у организаций, которые их опубликовали, — Google, Arena.ai и Artificial Analysis, — и воспроизводятся без изменений.

Статус запуска

Argon пока не в общем доступе. Вот в каком порядке он появится.

Google выпускает Argon поэтапно, и первый этап не публичный. Доступ внутри Felo готовится параллельно с этим запуском.

Доступен сейчас

Проверенные специалисты по киберзащите

Отобранные партнёры программы Google Fairwind получают Argon первыми и без ограничений по кибербезопасности.

Заявлено следующим

Платные клиенты API и Google AI Ultra

По словам Google, более широкий доступ начинается здесь. Дата не названа, и одна подписка сегодня его не даёт.

Сроки не объявлены

Разработчики, компании и конечные пользователи

Идёт после платных уровней. Google не взяла на себя обязательств по срокам общего доступа.

Доступ к Argon в поиске Felo в работе. Страница обновится, когда он откроется.

В чём модель сильна

Модель, созданная доводить долгую работу до конца, а не отвечать быстро

Опубликованные сильные стороны Argon сосредоточены вокруг чтения, рассуждений и письма на длинных дистанциях. По форме это не то же самое, что флагманские модели, ориентированные на код, с которыми его сравнивают.

Рассуждения, которые выдерживают долгую задачу

Google предлагает Argon для многошаговой работы на часы, там где прежние модели уходят в сторону или останавливаются слишком рано.

1M токенов вывода за один проход

Так Google объясняет рост: модель с запасом на долгие рассуждения решает сложную задачу за один проход, а не за множество обращений.

Лидирует работа со знаниями, а не программирование

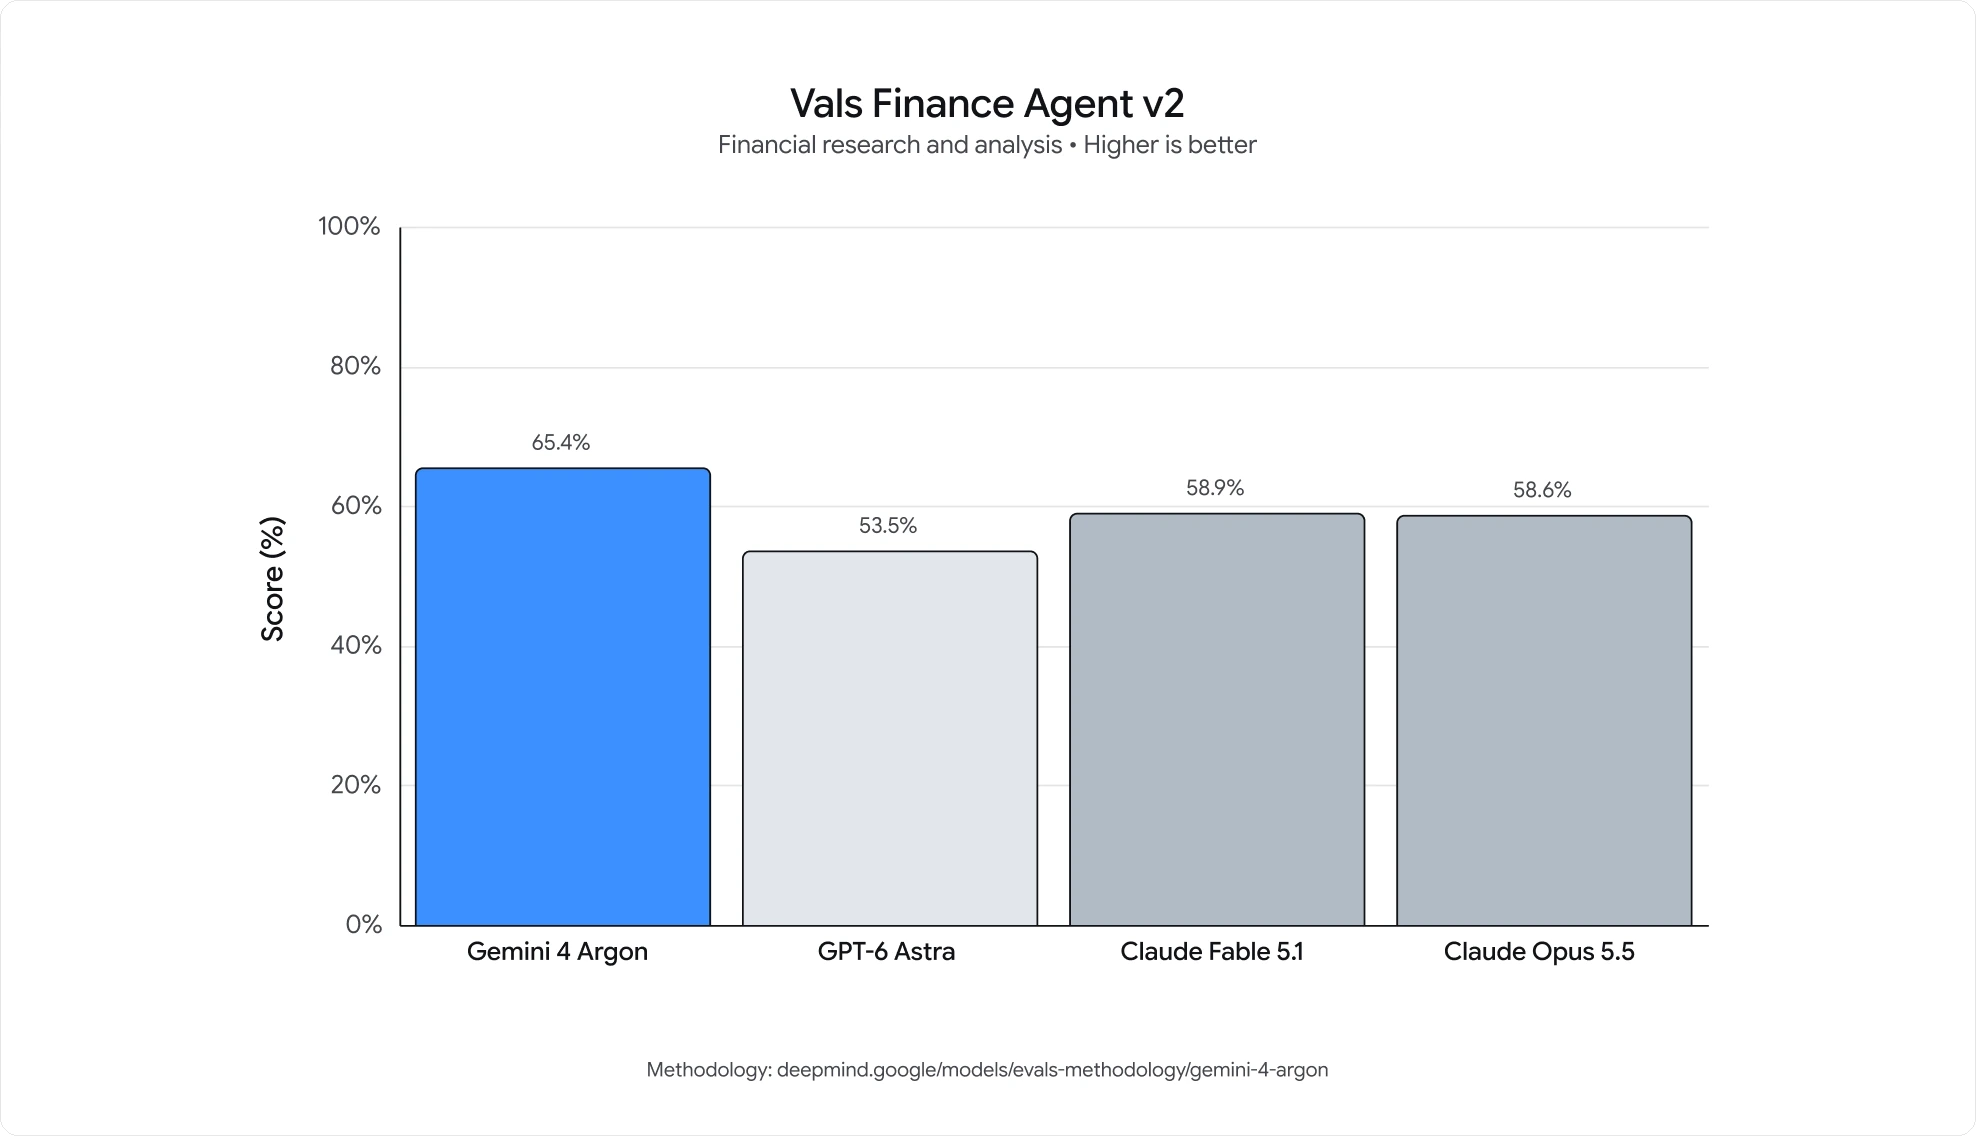
Самые заметные разрывы — в Harvey's Legal Agent Benchmark и Vals Finance Agent v2: настоящий юридический и финансовый анализ, а не синтетические задачи.

Работа с длинным контекстом, которая держится

В GraphWalks, где проверяют, умеет ли модель реально использовать контекст от 256K до 1M, Google сообщает об отрыве более чем в десять пунктов от других флагманов.

Понимание длинного видео

LVBench, измеряющий понимание длинных видео, заявлен на 91.7% — это самый высокий показатель Argon в списке Google.
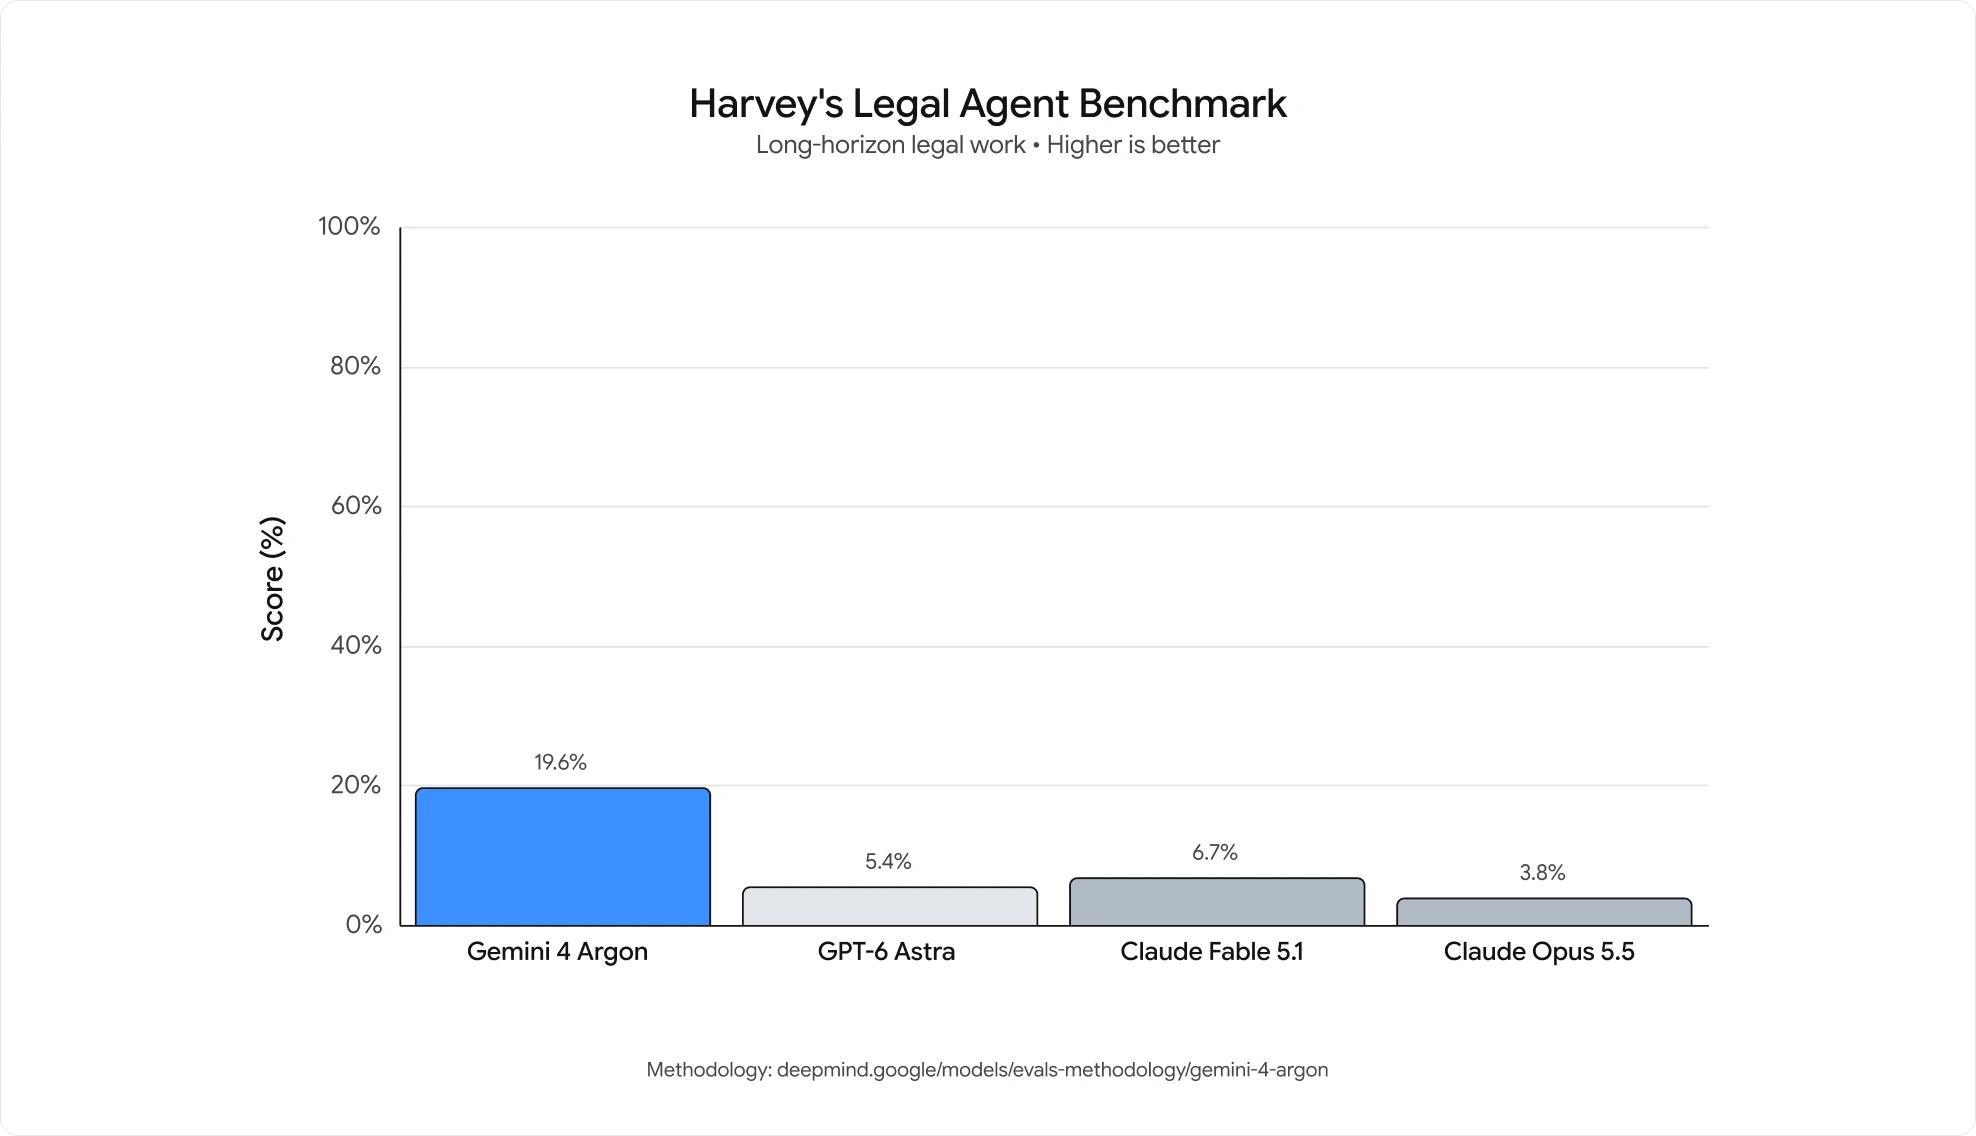
Столбчатая диаграмма Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Юридическая работа на длинной дистанции. 19.6% у Argon — примерно втрое больше результата ближайшей модели, и это самый большой отрыв в опубликованном наборе Google.
Столбчатая диаграмма Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Финансовые исследования и анализ: 65.4% против поля в 53.5–58.9%. Отрыв уже, чем в юридической работе, но порядок тот же.

Опубликованные цифры

Место Argon в собственных бенчмарках Google

Это результаты, заявленные производителем. Google не раскрыла настройку thinking или effort для главных цифр, и ни одна независимая лаборатория их пока не воспроизвела.

Бенчмарк
Что измеряет
Argon
Ближайшее сравнение
DeepSWE v1.1
Долгая работа над программными проектами
77.9%
Opus 5.5 — 74.2%, GPT-6 Astra — 74.1%
CWE-bench v1
Поиск и устранение уязвимостей
68%
Делит первое место
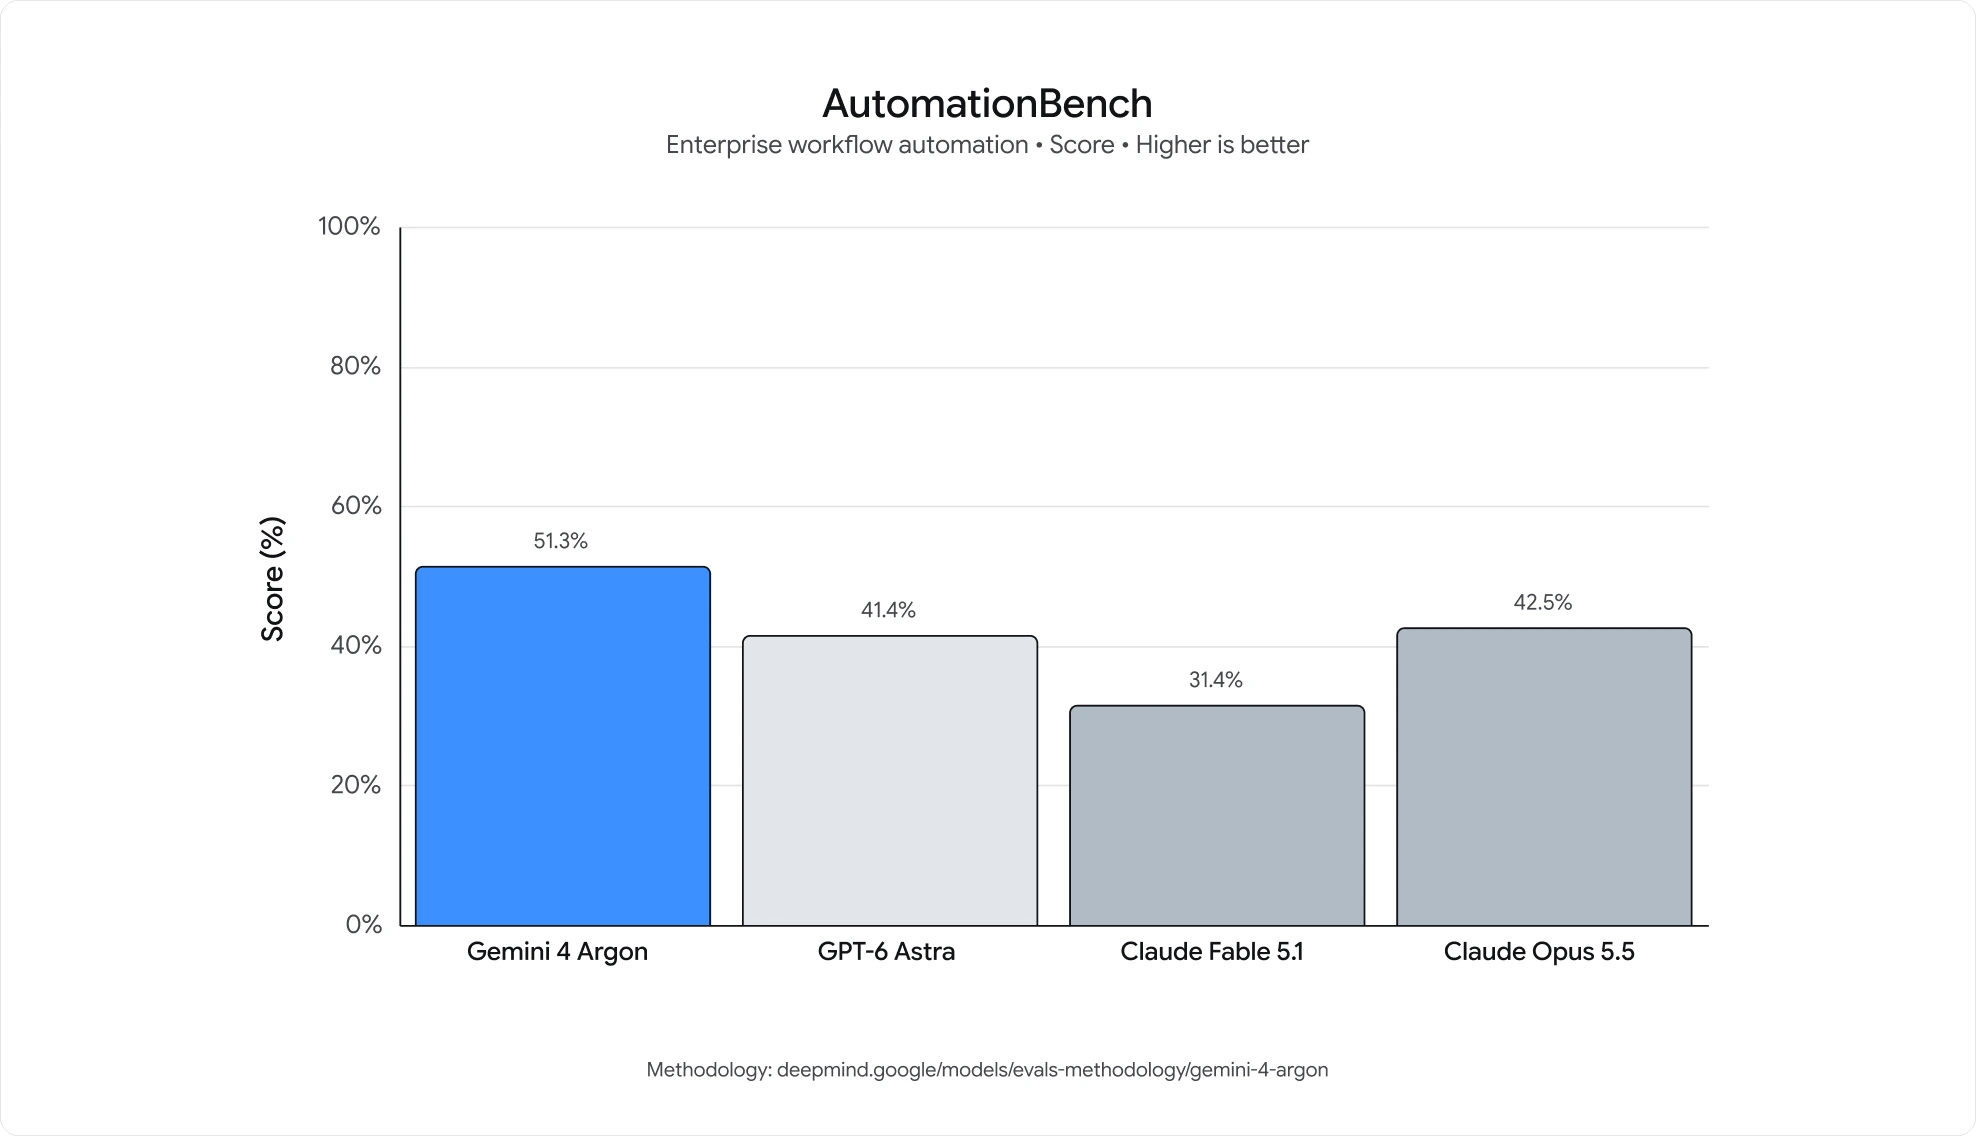
AutomationBench
Сквозные бизнес-задачи от Zapier
51.3%
Первое место
LVBench
Понимание длинного видео
91.7%
Лучший результат Argon по данным Google

Относитесь к ним как к ориентиру. Бенчмарки производителей редко переносятся на реальные нагрузки без изменений, а Bloomberg сообщил, что некоторые сотрудники Google сами сомневаются, что лидерство в бенчмарках переносится на реальную работу.
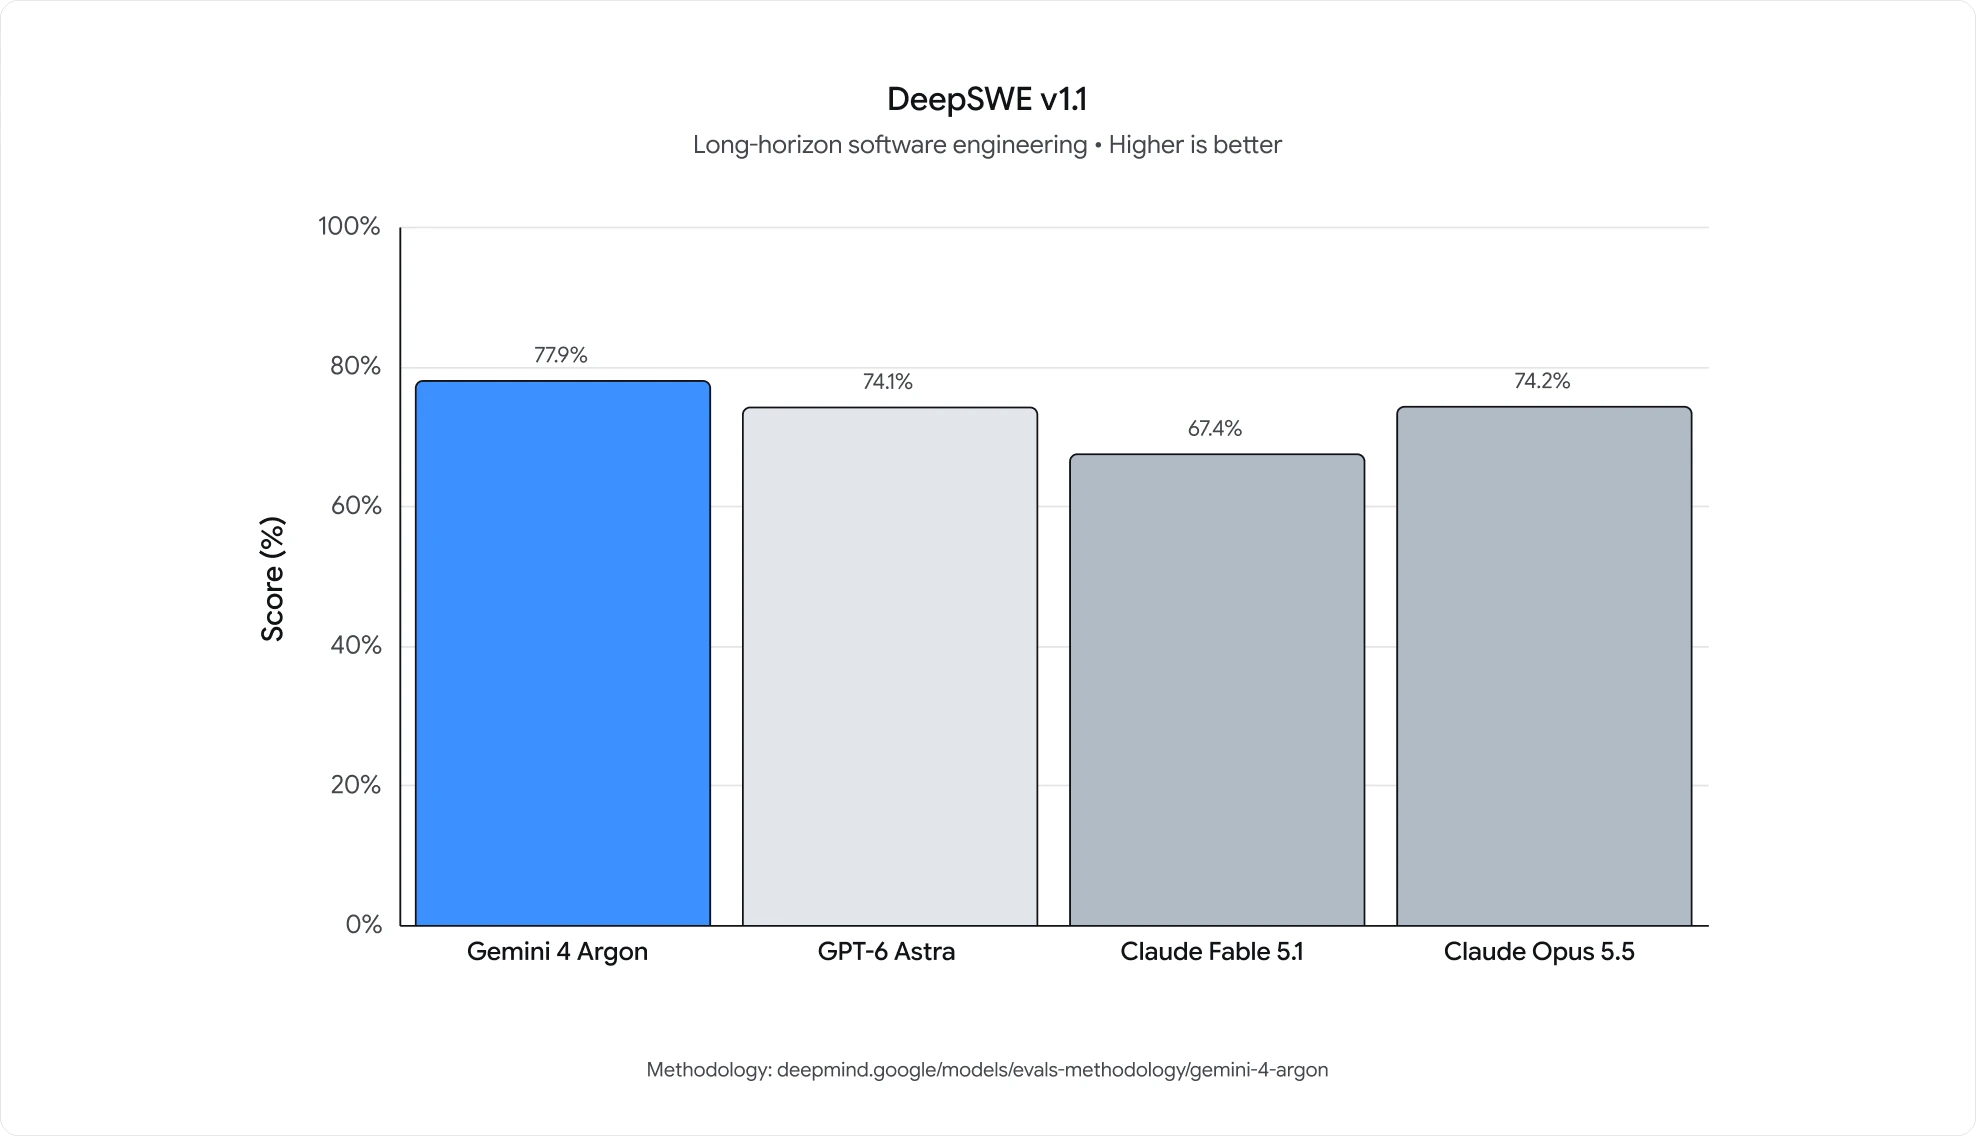
Столбчатая диаграмма DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Долгая работа над программными проектами. Главная цифра — 77.9%, и оба ближайших конкурента укладываются в четыре пункта от неё.
Столбчатая диаграмма AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Сквозные бизнес-задачи от Zapier. Argon переходит порог в 50%, тогда как все остальные модели в сравнении остаются в тридцатых или начале сороковых.
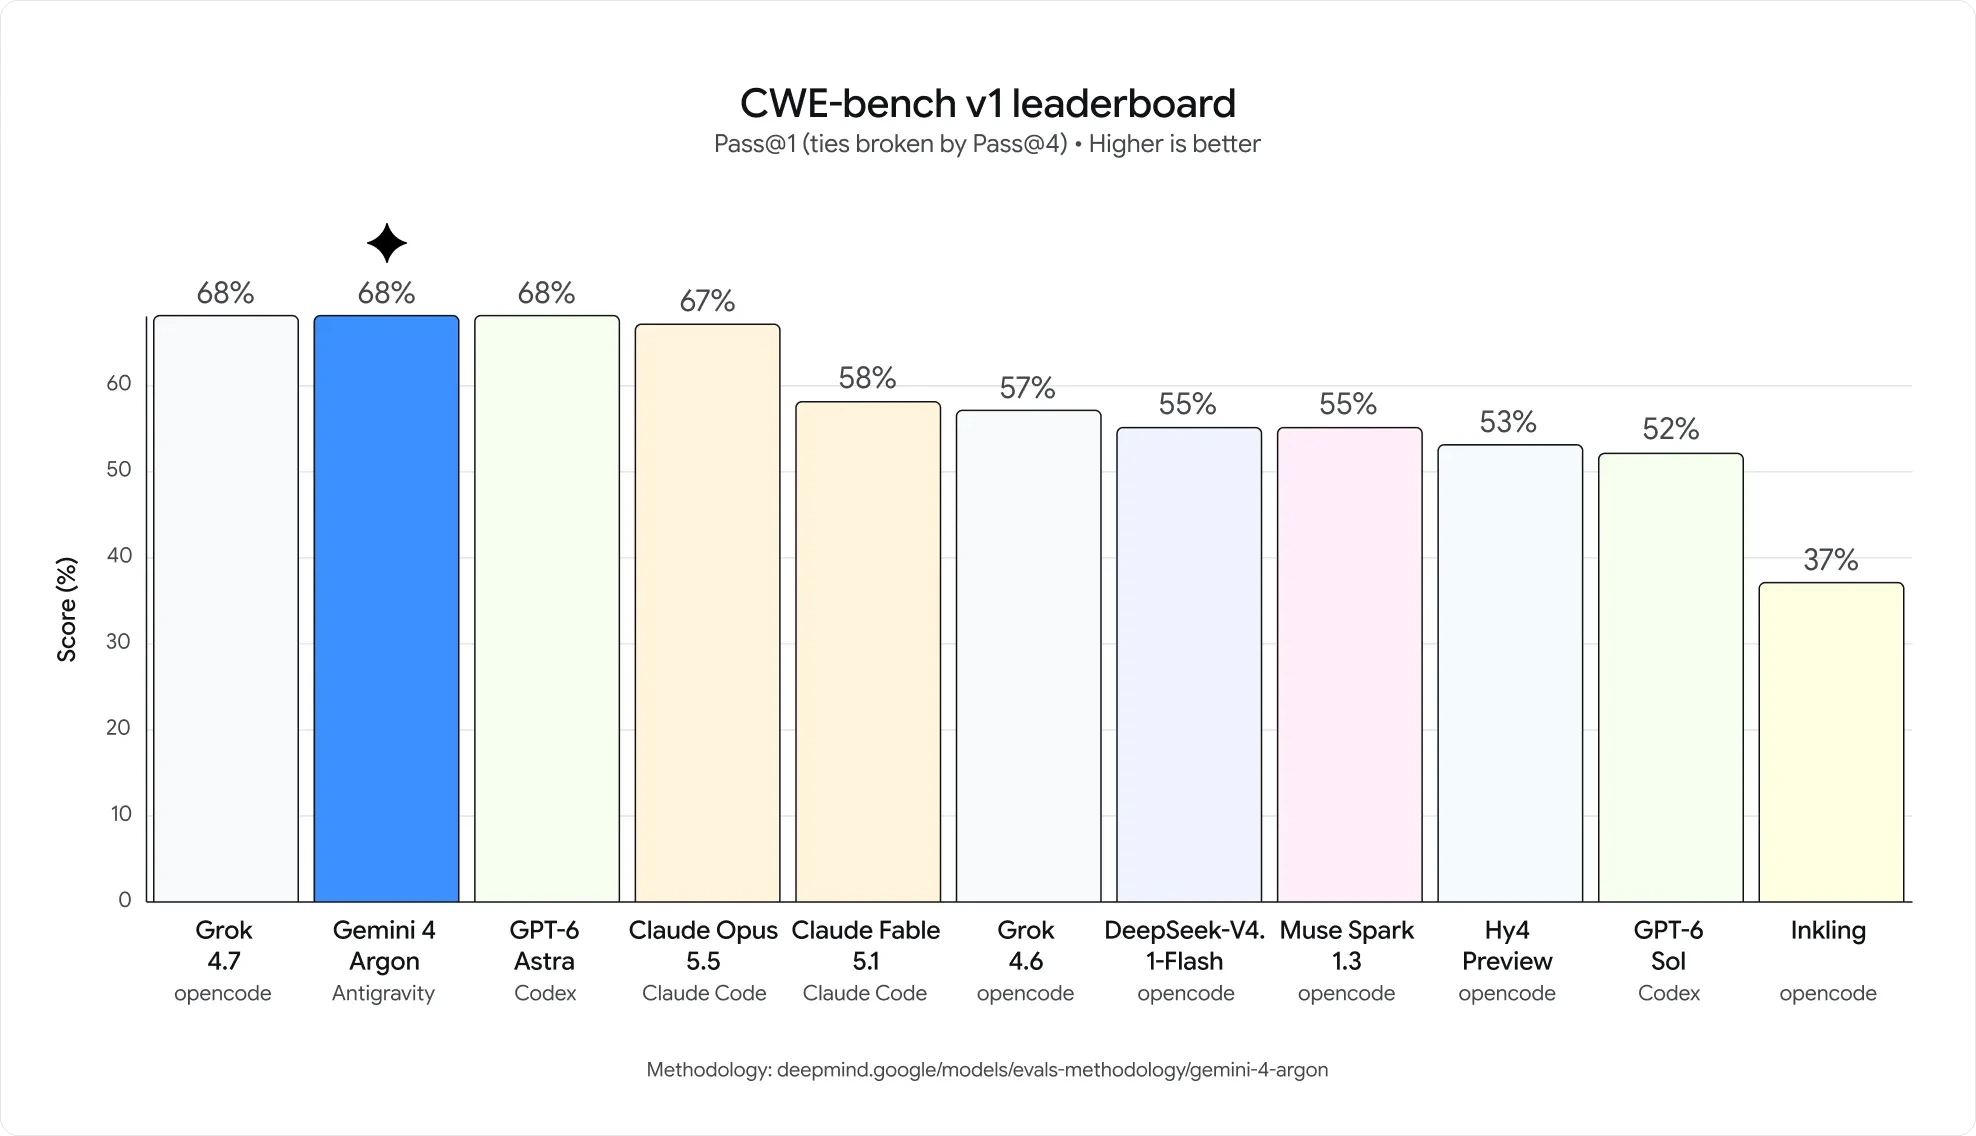
Таблица лидеров CWE-bench v1: Gemini 4 Argon, Grok и GPT-6 Astra делят 68%, Claude Opus 5.5 — 67%, дальше значения спадают до 37% у Inkling
Поиск уязвимостей при Pass@1. Argon делит вершину плотной таблицы, а не создаёт отрыв, поэтому таблица выше называет это дележом первого места.
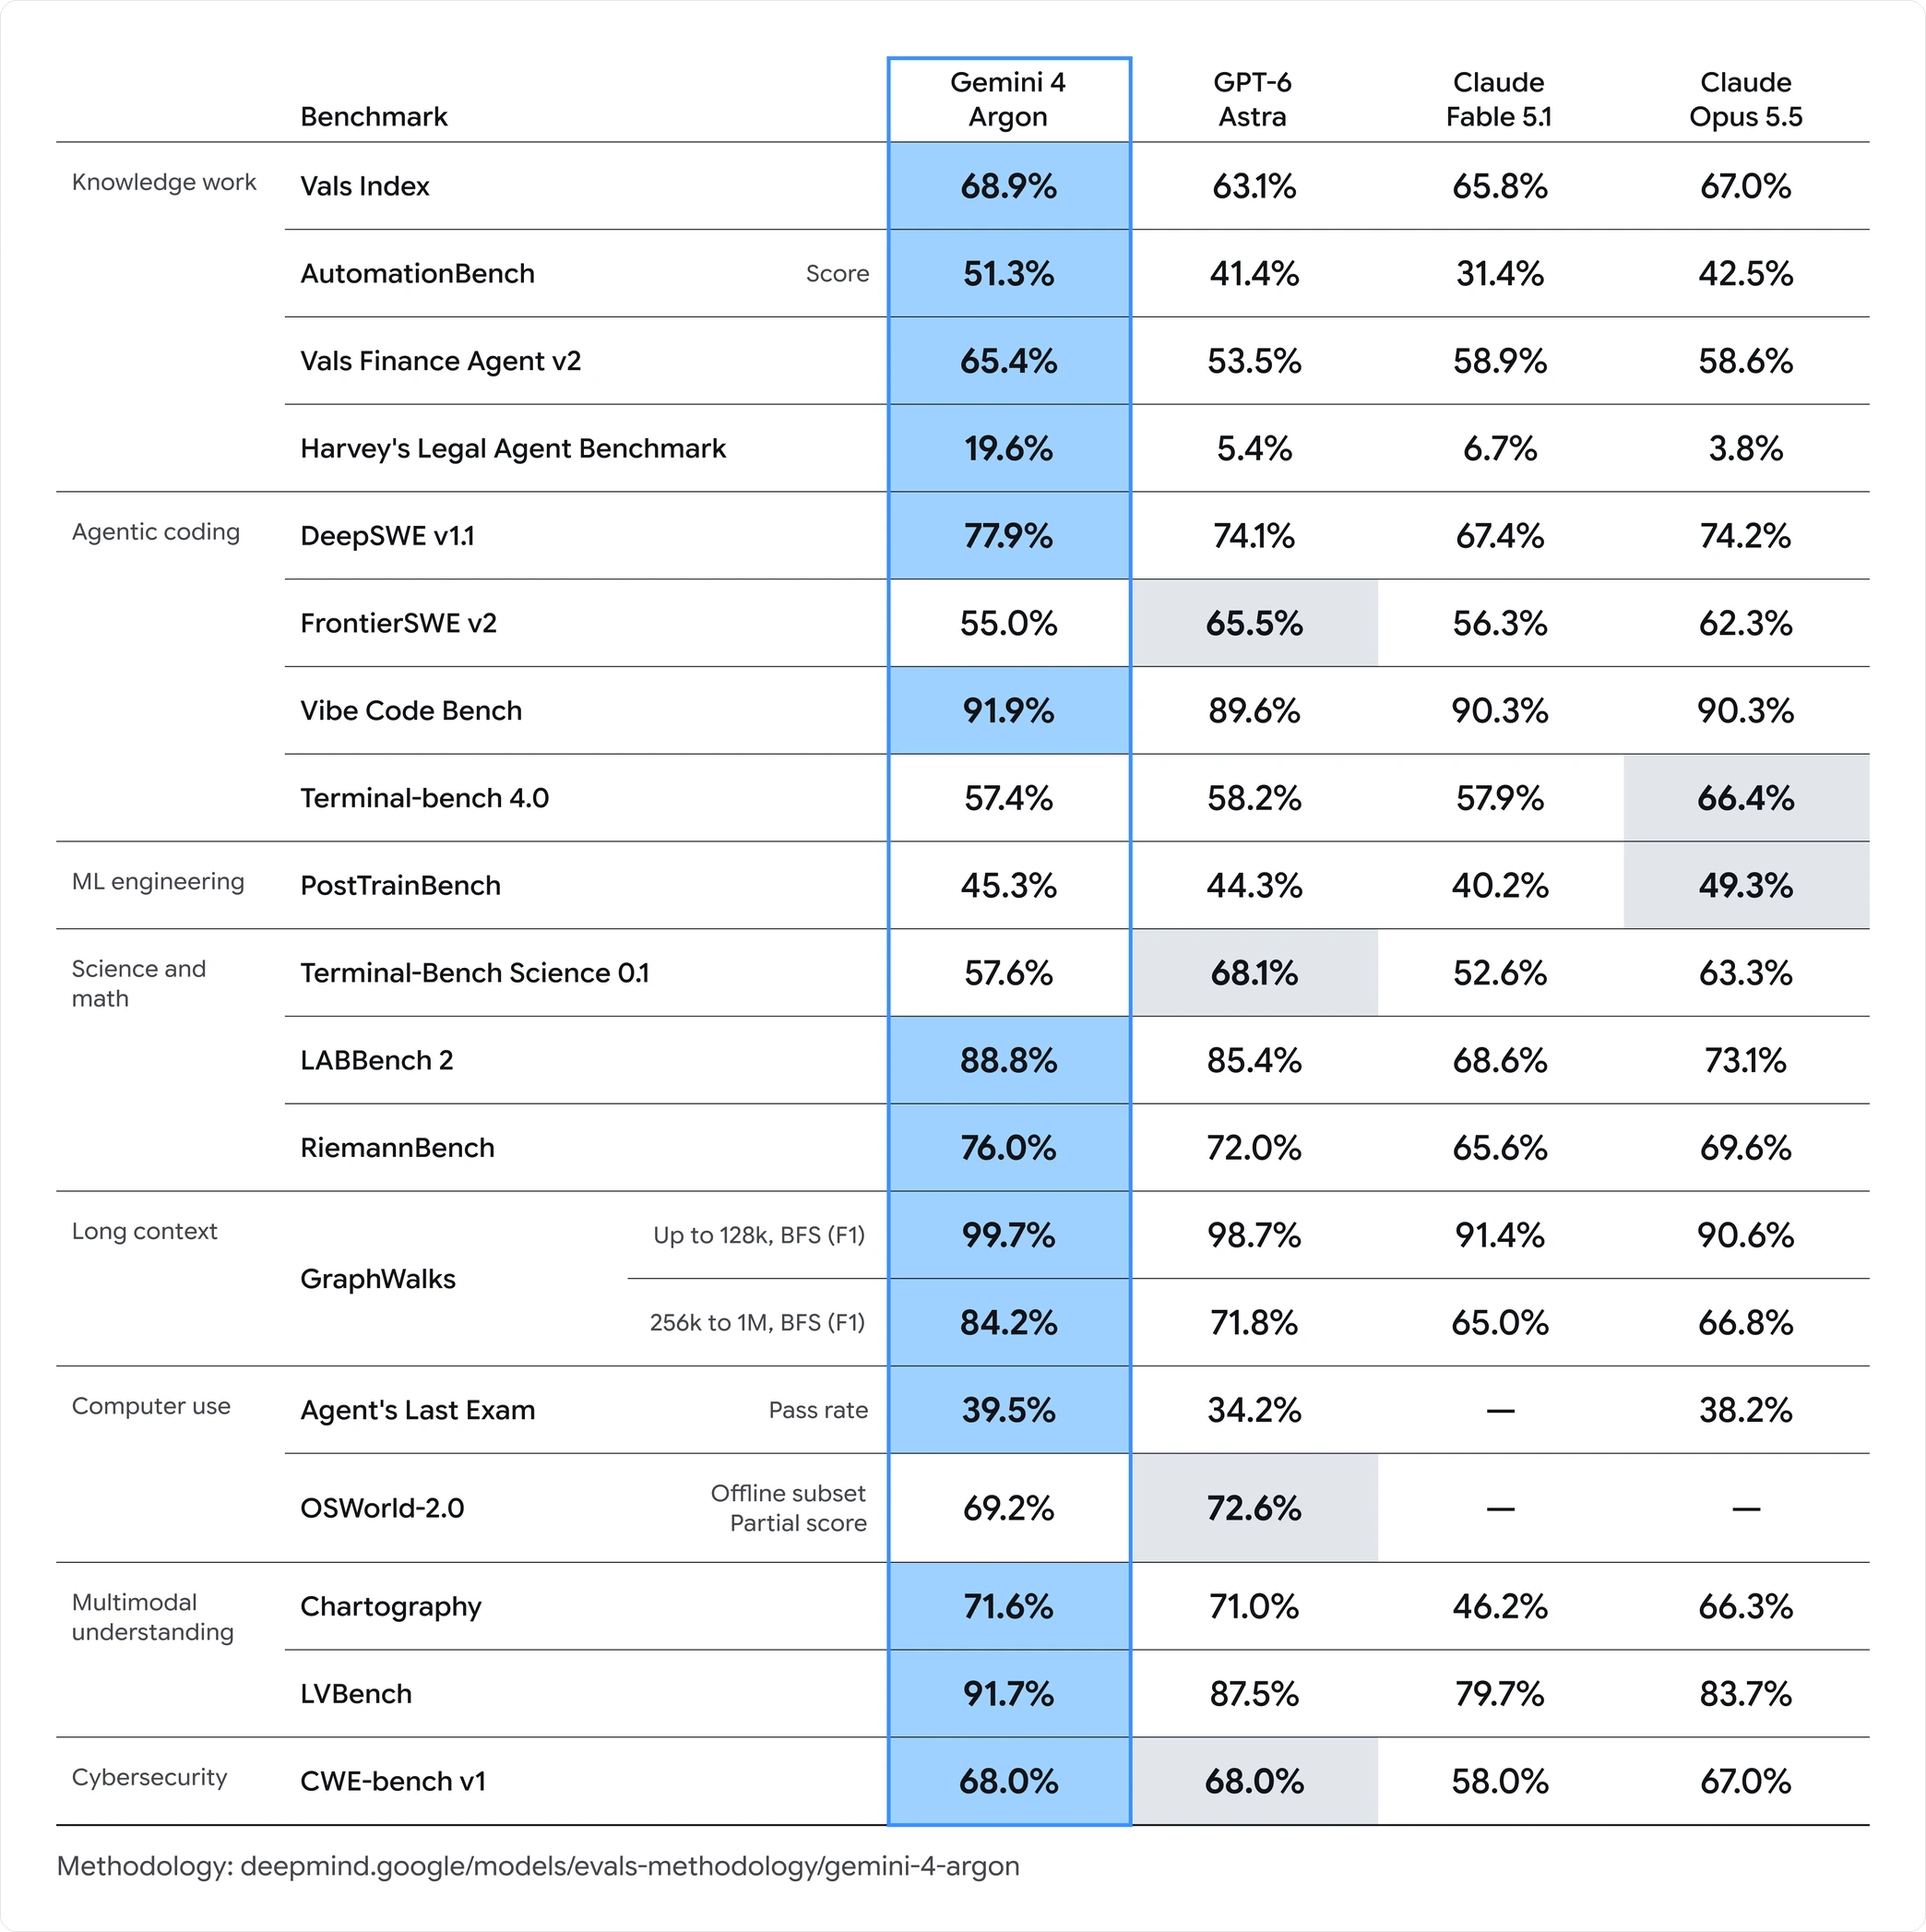
Полная таблица результатов Google по Gemini 4 Argon для 16 бенчмарков, сгруппированных в разделы: работа со знаниями, агентное программирование, ML-инженерия, наука и математика, длинный контекст, работа с компьютером, мультимодальное понимание и кибербезопасность
Полная таблица из анонса: победы Argon выделены синим, а ячейки, где лидирует конкурент, — серым. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 и OSWorld-2.0 — это строки, где Argon не впереди.
Столбчатая диаграмма доли галлюцинаций AA-Omniscience от Artificial Analysis по 36 моделям, от меньшего к большему: Gemini 4 Argon (High) — 15%, затем MiniMax-M3 — 18%, Kimi K2.5 — 26%, вплоть до DeepSeek-V4 Flash с 96%
Независимое измерение Artificial Analysis — единственная цифра на этой странице, которую не предоставил ни один вендор: как часто модель отвечает неправильно вместо того, чтобы отказаться от ответа. 15% у Argon — самый низкий показатель среди 36 моделей на графике; шкала доходит до 96%.
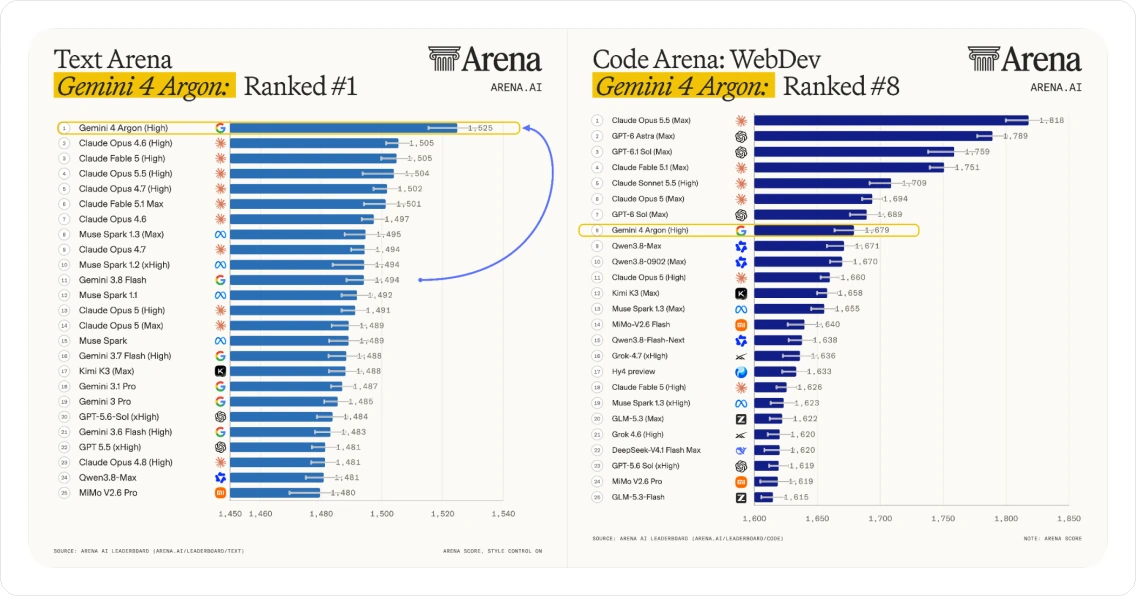
Две таблицы лидеров Arena.ai — Text Arena и Code Arena: WebDev — рядом: Gemini 4 Argon на 1-м месте в Text Arena с 1625 и на 8-м в Code Arena: WebDev с 1679
Два рейтинга, на которых держится абзац выше, из составляемых голосованием пользователей таблиц Arena.ai. Argon возглавляет 25 моделей в списке Text Arena; в Code Arena: WebDev он восьмой — позади четырёх моделей Claude и трёх из линейки GPT-6 от OpenAI.

В Felo

Как выглядит исследовательский процесс с моделью на 1M токенов вывода

Felo соединяет поиск с пониманием документов, поэтому модель с длинным выводом меняет то, что успевает сделать одна сессия.

Исследование, которое заканчивается документом

Соберите источники, а синтез поручите модели написать за один проход — вместо сборки по разделам через десятки запросов.

Целые наборы документов в одной задаче

Работа с длинным контекстом — сильнейшая сторона Argon. Именно она делает посильными пакеты договоров, отчётность и длинные отчёты.

Тексты, где важен тон

Заявленный профиль Argon — сильный текст, средний код — подходит командам, которым нужна проза, читающаяся как написанная, а не собранная.

Стоимость

Сколько стоит Argon и что изменится позже

Google опубликовала вводный тариф и более высокий прайсовый, не сообщив, когда произойдёт переход. Считайте бюджет по большей цифре.

Тип токенов
Вводная цена
Позже
Ввод
2,00 $ / млн
4,00 $ / млн
Кэшированный ввод
скидка 95%
скидка 95%
Вывод
10,00 $ / млн
20,00 $ / млн

Для сравнения: вводная цена примерно на уровне GPT-6.1 Sol и Sonnet 5.5 и около пятой части цены GPT-6 Astra. Это прайсовые цены, а не измеренная стоимость задачи — Argon отвечает на более сложные вопросы, поэтому один прогон всё равно может стоить дороже.

Как работать с Argon в Felo

01

Принесите весь вопрос целиком

Отдайте Felo набор документов или длинный тред, а не их пересказ. Преимущество Argon начинается там, где контекст перестаёт помещаться в промпт.

02

Просите готовый результат

С потолком вывода в 1M токенов можно запросить полный отчёт или готовый черновик одной инструкцией, а не по разделам.

03

Сверьте его с источниками

Felo оставляет ссылки на источники при ответе — именно это делает длинный документ, созданный моделью, проверяемым.

Доступ к Argon в поиске Felo в работе. Пока он не открылся, все остальные модели линейки Felo доступны уже сейчас.

Открыть поиск Felo AI

Gemini 4 Argon: частые вопросы

В общем доступе — нет. Google сначала выпустила Argon для отобранных партнёров программы Fairwind и говорит, что более широкий доступ начнётся с платных клиентов API и подписчиков Google AI Ultra. Дата для этого этапа не объявлена, и платная подписка сегодня доступа не даёт.

Попробуйте флагманские модели Google в Felo

Ищите, читайте и пишите с моделью, которая подходит задаче. Argon пополнит линейку, когда его запуск дойдёт до Felo.

Открыть поиск Felo AI

Для работы с поиском Felo AI карта не нужна.