01
Bağlamın tamamını tut
1 milyon token'lık bağlam penceresi ve Haziran 2026'ya kadar bilgi. Uzun bir yazışma, baştan sona bir depo ya da bir belge seti tek bir işte kalıyor.
Anthropic, Opus 5.5'i 22 Eylül 2026'da yayımladı
Claude 5.5 ailesinin ilk modeli. Çoğu işte Claude Fable 5.1 seviyesine ulaşıyor, çalıştırma maliyeti Opus 5'ten %40 düşük ve çıktıyı %30'dan fazla hızlı üretiyor.
Artık Felo Arama'da
Claude Opus 5.5, uzun girdili işler için Felo Arama'da kullanılabilir: dosyalar arasında sayıları karşılaştırmak, bir iddiayı kaynağına kadar izlemek ve başkasına olduğu gibi aktarabileceğiniz bir yanıt üretmek.
01
1 milyon token'lık bağlam penceresi ve Haziran 2026'ya kadar bilgi. Uzun bir yazışma, baştan sona bir depo ya da bir belge seti tek bir işte kalıyor.
02
Anthropic'in iç testinde 18 raporun 16'sı kalite eşiğini geçti. Uydurulmuş tek bir sayı ya da alıntı işi baştan sona düşürecekti.
03
Anthropic modelin iletişim biçimini yeniden tasarladı: en önemli bilgi başta geliyor ve rapor neyin bittiğini, neyin bulunduğunu, neyin açık kaldığını açıkça yazıyor.
Hızlı kılavuz
Claude Opus 5.5, hesabınızdaki diğer önde gelen modellerle birlikte model seçicisinde görünür.
Opus 5.5'in farkı
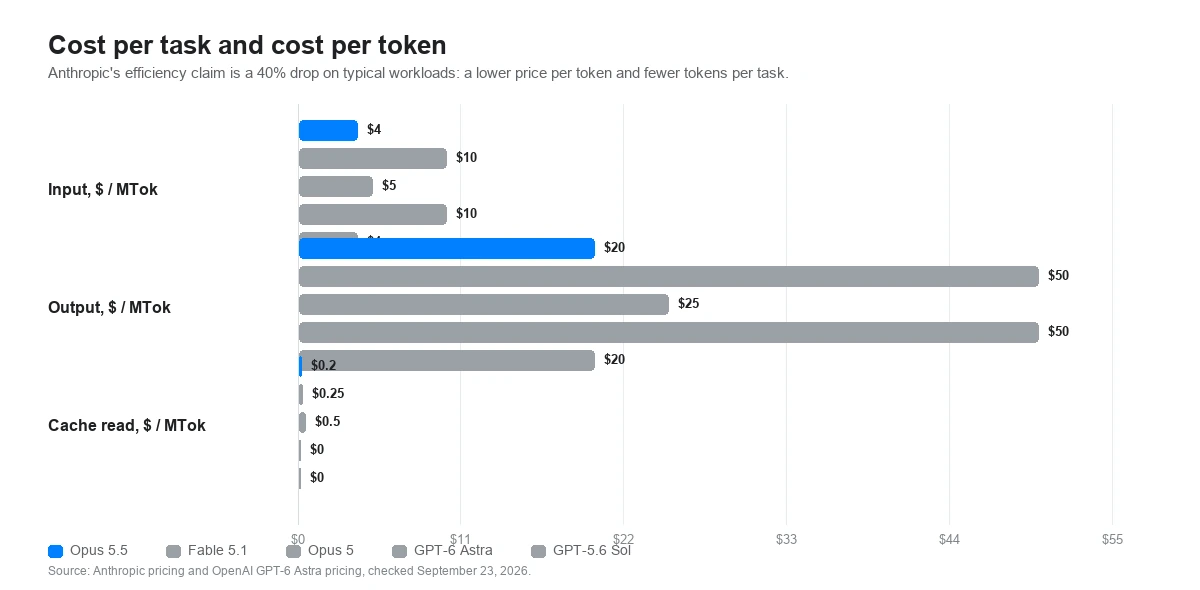
Anthropic daha yüksek bir benchmark puanı yerine verimliliği öne çıkarıyor: iş başına daha az token, token başına daha düşük fiyat ve tipik iş yüklerinde %40 daha az maliyet. Saatlerce çalışan bir ajanı bırakıp gitmeyi karşılanabilir kılan şey tam olarak bu.
01
Anthropic, bir erken test kullanıcısının 200.000 satırlık kod tabanını üç saatten kısa sürede denetleyip düzelttiğini aktarıyor; Opus 5 aynı işte 20 saatten fazla harcamış ve 2,5 kat daha fazla token kullanmış.
02
Deloitte, en düşük effort kademesinde bile Opus 5.5'in kod incelemesinde bilinen hataların %72'sini yakaladığını bildirdi; Opus 5 high kademesinde %56'da kalmış ve daha çok yanlış alarm üretmiş.
03
Metinleri daha kısa ve daha iyi yapılandırılmış. Box, doğruluk kaybı olmadan yanıtların %40 daha az uzun olduğunu ve Opus 5'in üçte biri kadar token kullanıldığını bildirdi.
Model seçimi
Aşağıdaki fiyatlar milyon token başına resmî genel API tarifeleridir; Felo abonelik ya da kullanım fiyatları değildir. Effort satırı en az fiyat satırı kadar önemli: aynı istem, modellerin başladığı kademeye göre çok farklı maliyete gelebilir.
Yukarıdaki genel API tarifeleri ve varsayılanlar 23 Eylül 2026'da Anthropic'in Claude Opus 5.5 duyurusu, Claude Platform model sayfaları ve OpenAI'nin GPT-6 Astra sayfasıyla karşılaştırıldı. Token fiyatı toplam iş maliyetinin yalnızca bir parçası. Anthropic'in verimlilik iddiası tipik iş yüklerinde %40 maliyet düşüşü; bu da token başına daha düşük fiyatla iş başına daha az token'ı birlikte içeriyor.
Anthropic'in yayımladığı sonuçlar
Anthropic kendi sayılarını Fable 5.1, Opus 5, GPT-6 Astra ve GPT-5.6 Sol ile yan yana yayımladı. Aşağıdaki dört grafikten ikisi tek başına doğruluk yerine doğruluğun iş başına maliyete oranını gösteriyor, çünkü Anthropic'in yaptığı karşılaştırma tam olarak bu.
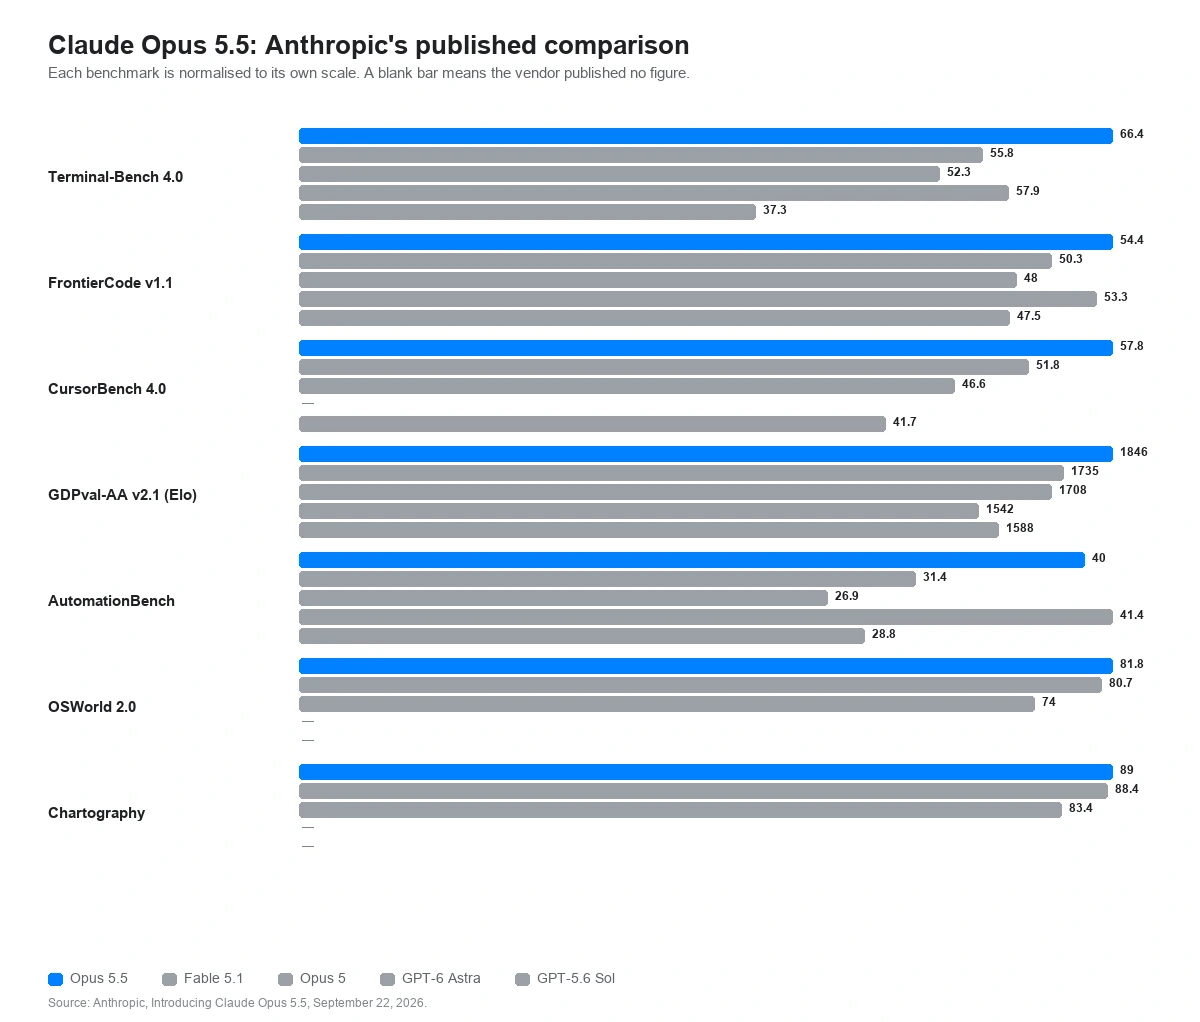
Yayımlanan karşılaştırmanın tamamı
Ölçülen beş model için ajan kodlama, bilgi işi, iş akışları, disiplinler arası muhakeme, bilimsel araştırma, bilgisayar kullanımı ve grafik okuma.
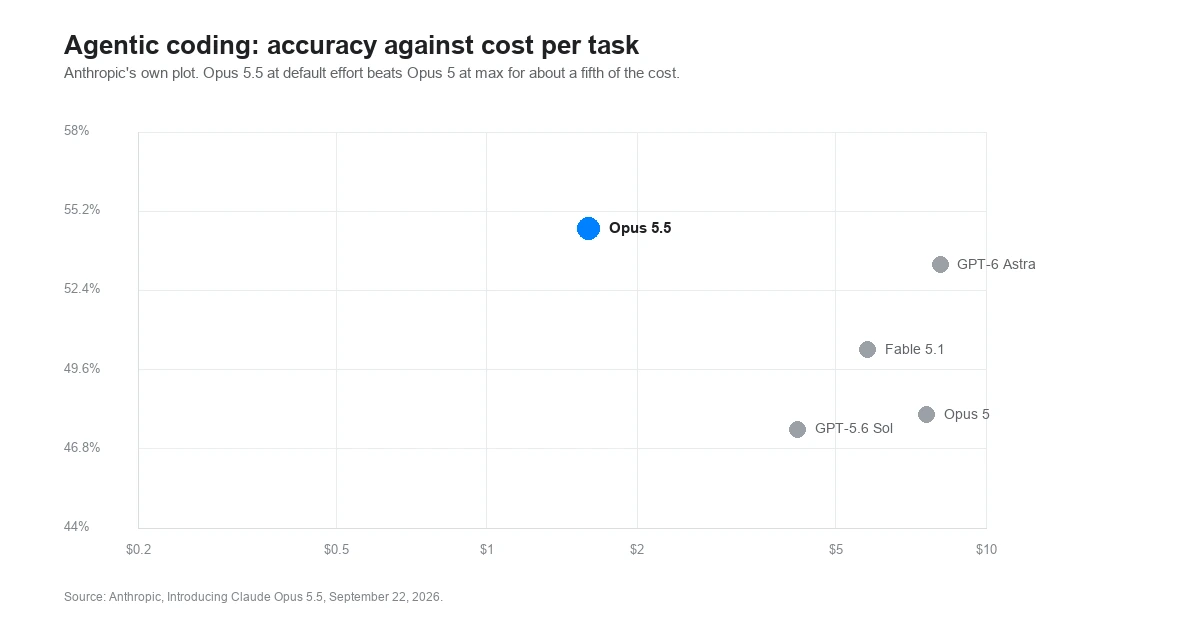
Ajan kodlama
Terminal-Bench 4.0, FrontierCode v1.1 ve CursorBench 4.0, iş başına maliyete karşı doğruluk olarak çizildi.
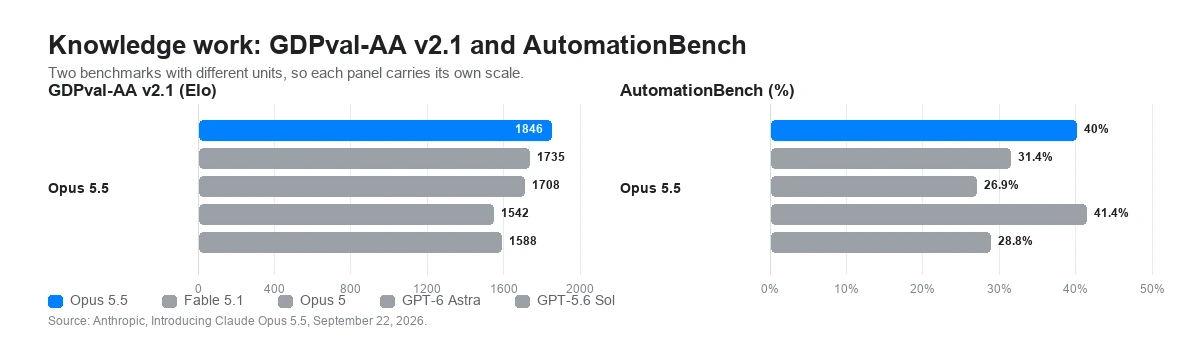
Bilgi işi
44 mesleği kapsayan GDPval-AA v2.1, AutomationBench ve Perplexity'nin veri toplama benchmark'ı WANDR.
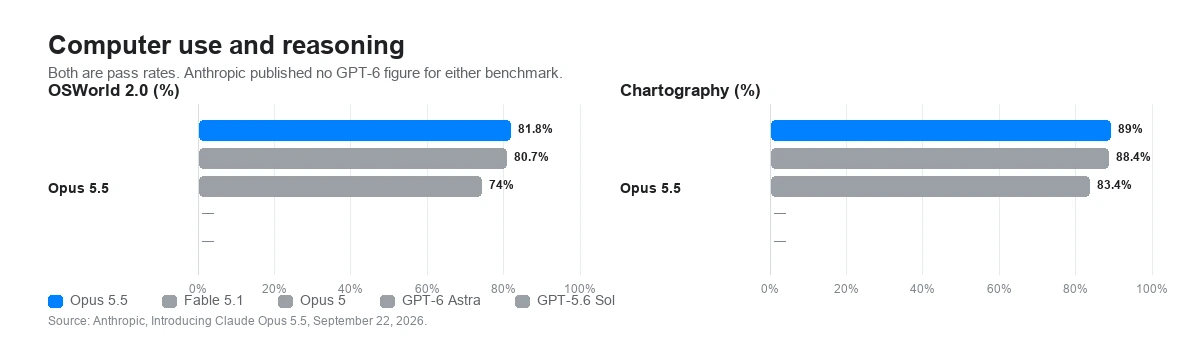
Bilgisayar kullanımı ve muhakeme
OSWorld 2.0, Humanity's Last Exam ve Chartography; sonuncusu bir grafikten değer okuma doğruluğunu ölçüyor.
İş başına maliyete karşı doğruluk
Anthropic'in temel iddiası her bedele daha yüksek puan değil, deneme başına maliyetin çok altında aynı ya da daha iyi puanı almak.
Üretici tarafından yayımlanan sayılar. Aksi belirtilmedikçe Anthropic, Opus 5.5'i max effort'ta uyarlanabilir düşünmeyle çalıştırdı ve üretim korumaları açıkken değerlendirdi. Bu korumalar devreye girdiğinde siber güvenlik işlerini Opus 4.8, biyoloji işlerini Opus 5 tamamladı; bu da o benchmark'larda yayımlanan Opus 5.5 sayılarını büyük olasılıkla düşürüyor. GPT-6 Astra ve GPT-5.6 Sol sayıları OpenAI'nin bildirdiği değerlerdir. Üreticiler arası benchmark farkları gerçek dünyadaki farklar için zayıf bir göstergedir; Anthropic'in bu sayılar hakkında söylediği de budur.
Opus 5'i hâlihazırda çalıştırıyorsanız
Anthropic, hâlihazırda Claude Opus 5 üzerinde çalışan entegrasyonlar için dört kırıcı değişiklik sıralıyor; buna hiçbir isteği başarısız kılmadan yanıt biçimini değiştiren beşinci bir değişiklik de ekleniyor. Model kimliğini değiştirmeden önce okumaya değer, çünkü dördünün üçü sessizce bozulmak yerine 400 hatası döndürüyor.
01
Opus 5'te düşünme high ve altında kapatılabiliyordu. Opus 5.5'te her zaman açık ve hem kapatma hem de elle token bütçesi 400 hatası döndürüyor. Tek denetim effort oldu ve varsayılan değer high yerine medium'a indi.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice "any" ya da belirli bir araç adıyla ayarlandığında 400 hatası döner; token sayım uç noktası da buna dahil. auto ile katı araç kullanımını ya da yapılandırılmış çıktıyı birleştirin ve aracın ne zaman kullanılacağını istemde belirtin.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Her düşünme bloğu onu üreten modeli kaydediyor. Opus 5.5, Opus 5 ile daha eski Opus, Sonnet ve Haiku modellerinin bloklarını okuyabiliyor; Fable ve Mythos'unkileri okuyamıyor. Bir yönlendirici konuşmayı başka modele taşırsa sonraki turlar önceki muhakeme olmadan çalışır.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 düşünmeyi korur; diğer modeller kaybeder
04
Claude API ve Google Cloud'da computer_20251124 aracı 400 hatası döndürüyor. Yerine computer_toolset_20260801 araç setini bildirin, beta başlığını kaldırın ve ajan döngüsünü member tool_use bloklarına uyarlayın. Amazon Bedrock'ta eski araç çalışmaya devam ediyor.
computer_20251124 -> computer_toolset_20260801
Düşünme kapatılamadığına göre ayarlanacak şey effort. Opus 5.5 beş kademeyi de destekliyor ve Opus 5'in bir kademe altında, medium'da başlıyor. Anthropic'in önerisi, bir ayarı taşımak yerine kendi değerlendirmelerinizde baştan tarama yapmak ve yüksek kademelerde max_tokens'ı geniş tutmak; çünkü düşünme metni döndürülmese bile düşünme token'ları bu sınıra sayılıyor.
Effort katı bir token bütçesi değil davranışsal bir sinyal: düşük kademede model gerçekten zor problemlerde yine düşünür, yalnızca yüksek kademeye göre daha az. Anthropic ayrıca aynı kademede Opus 5.5'in tur başına Opus 5'ten daha fazla düşündüğünü, bunun xhigh ve max'ta en belirgin olduğunu belirtiyor; Opus 5'ten taşınan bir ayar daha uzun ve daha pahalı turlar üretecek.
Nereye oturuyor
Opus 5.5, bir iş saatler sürdüğünde, bir kişinin akılda tutamayacağı kadar çok dosyaya yayıldığında ya da başka birinin kontrol etmesi gereken bir çıktı ürettiğinde karşılığını veriyor. Bunlar Anthropic'in ve ilk test kullanıcılarının anlattığı işler; genel sohbet istemleri değil.
İlk akla yatkın yamada durmak yerine, testler geçene kadar değişikliği büyük bir deponun tamamına taşımak. Anthropic, bir test kullanıcısının 680.000 satırlık taşımayı bir günden kısa sürede bitirdiğini aktarıyor.
Anthropic'in aktardığı test kullanıcısı Column, birkaç commit önce yanlış modellenen bir üçüncü taraf entegrasyonu için dış belgelere bakarak bir hatayı yakaladığını bildirdi.
Önce modeli, sonra tek sayfalık özeti üretmek ve çekinceleri korumak. Anthropic, bir birleşme analizinin 63 dakikada tamamlandığını, Opus 5'te bunun 93 dakika sürdüğünü ve maliyetin yarısı olduğunu aktarıyor.
Alt ajanlara devrediyor ve hızını bir zaman bütçesine göre ayarlıyor. Anthropic'in önerisi, çok ajanlı bir yapıya geçen süre sinyali vermek; böylece sıraya dizilmek yerine paralelleşiyor.
01
İşe yarar bir yanıtın hesaba katması gereken depoyu, belgeleri ve gereksinimleri ekleyin. 1 milyon token'lık pencere tam bunun için var.
02
İşin bitmiş sayılması için neyin doğru olması gerektiğini söyleyin. Anthropic'in gözetimsiz çalışmalar için önerisi, işin parçalarını modelin güncellediği bir kontrol listesinde tutmak.
03
Aynı işi Felo'da Opus 5.5, Opus 5 ve Fable 5.1 üzerinde çalıştırın. Yalnızca yanıtı değil testleri, çekinceleri ve token tüketimini de karşılaştırın.
Claude Opus 5.5 hesabınızın model seçicisinde göründüğünde seçin.
Opus 5.5'i Felo'da deneClaude Opus 5.5, Anthropic'in uzun süreli ajan kodlama ve bilgi işi için geliştirdiği model; 22 Eylül 2026'da Claude 5.5 ailesinin ilk modeli olarak yayımlandı. Anthropic'e göre çoğu işte Claude Fable 5.1 seviyesine ulaşıyor ve çalıştırma maliyeti Claude Opus 5'ten %40 düşük.
Claude Opus 5.5'i Felo'da diğer önde gelen modellerin yanına koyun, sonra saatler sürdüğü için ertelediğiniz işte deneyin.
Opus 5.5'i Felo'da deneFelo AI Arama'dan başlayın ve modeli kullanılabilir olduğu yerde seçin.