01
Утримати весь контекст
Вікно контексту на 1 млн токенів і знання станом на червень 2026 року. Довге листування, цілий репозиторій або пакет документів залишаються в одному завданні.
Anthropic випустила Opus 5.5 22 вересня 2026 року
Перша модель родини Claude 5.5. Вона сягає рівня Claude Fable 5.1 у більшості завдань, коштує на 40% менше в роботі, ніж Opus 5, і видає відповідь понад на 30% швидше.
Уже в пошуку Felo
Claude Opus 5.5 доступний у пошуку Felo для завдань із довгим введенням: звіряти цифри між файлами, простежувати твердження до джерела й видавати відповідь, яку можна передати далі.
01
Вікно контексту на 1 млн токенів і знання станом на червень 2026 року. Довге листування, цілий репозиторій або пакет документів залишаються в одному завданні.
02
У внутрішньому тесті Anthropic 16 звітів із 18 пройшли планку якості. Достатньо було однієї вигаданої цифри чи цитати, щоб робота провалилася.
03
Anthropic переписала те, як модель спілкується: головне йде першим, а звіт прямо повідомляє, що готово, що виявлено і що залишилося відкритим.
Коротка інструкція
Claude Opus 5.5 зʼявляється у виборі моделі поряд з іншими провідними моделями вашого акаунта.
Чим відрізняється Opus 5.5
Anthropic робить ставку на ефективність, а не на вищий бал у бенчмарку: менше токенів на завдання, нижча ціна за токен і на 40% менші витрати на типових навантаженнях. Саме це робить тривалу роботу агентів доступною.
01
Anthropic повідомляє, що один із перших тестувальників перевірив і виправив кодову базу на 200 000 рядків менш ніж за три години, тоді як Opus 5 витрачав понад 20 годин і в 2,5 раза більше токенів.
02
Deloitte повідомляє, що навіть на найнижчому щаблі effort Opus 5.5 знаходив 72% відомих помилок під час ревʼю коду проти 56% в Opus 5 на high, з меншою кількістю хибних спрацювань.
03
Тексти коротші й краще структуровані. Box повідомляє, що відповіді стали на 40% менш багатослівними без втрати точності, а токенів пішло втричі менше, ніж в Opus 5.
Вибір моделі
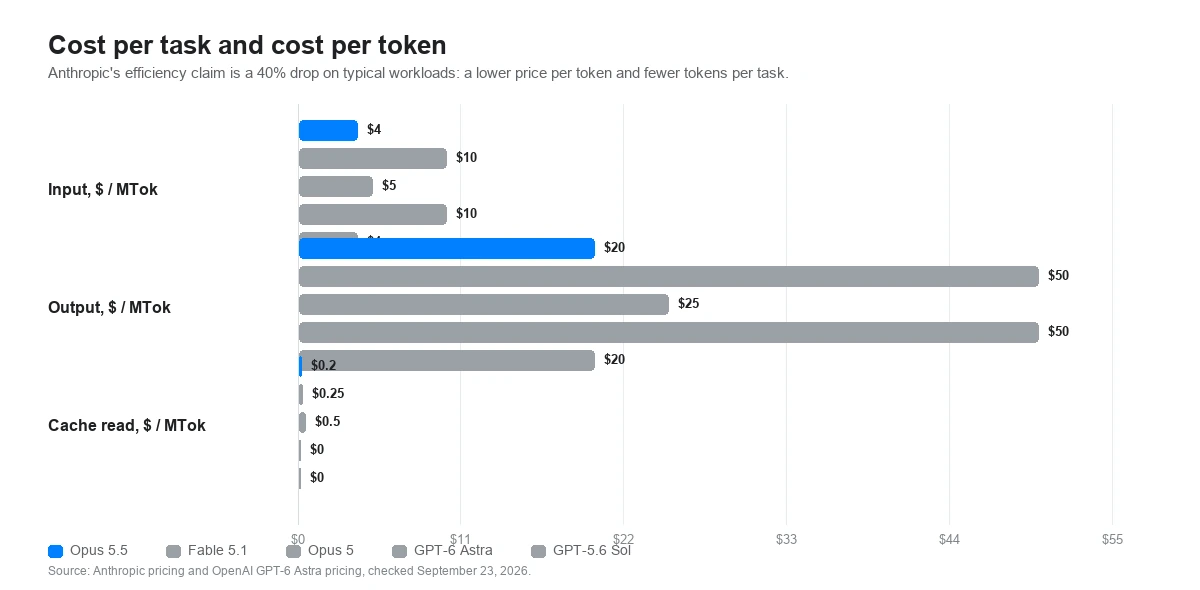
Нижче — офіційні публічні тарифи API за мільйон токенів, а не ціни підписки чи використання у Felo. Рядок effort важливий не менше за рядок ціни: той самий запит може коштувати дуже по-різному залежно від того, з якого щабля стартує модель.
Публічні тарифи API та значення за замовчуванням звірено 23 вересня 2026 року з анонсом Claude Opus 5.5 від Anthropic, сторінками моделей Claude Platform і сторінкою GPT-6 Astra від OpenAI. Ціна за токен — лише частина загальної вартості завдання. Заява Anthropic про ефективність — це зниження витрат на 40% на типових навантаженнях, що поєднує нижчу ціну за токен і меншу кількість токенів на завдання.
Оприлюднені результати Anthropic
Anthropic опублікувала свої цифри поряд із Fable 5.1, Opus 5, GPT-6 Astra і GPT-5.6 Sol. Два з чотирьох графіків нижче показують точність щодо вартості завдання, а не саму точність, бо саме таке порівняння й робить Anthropic.
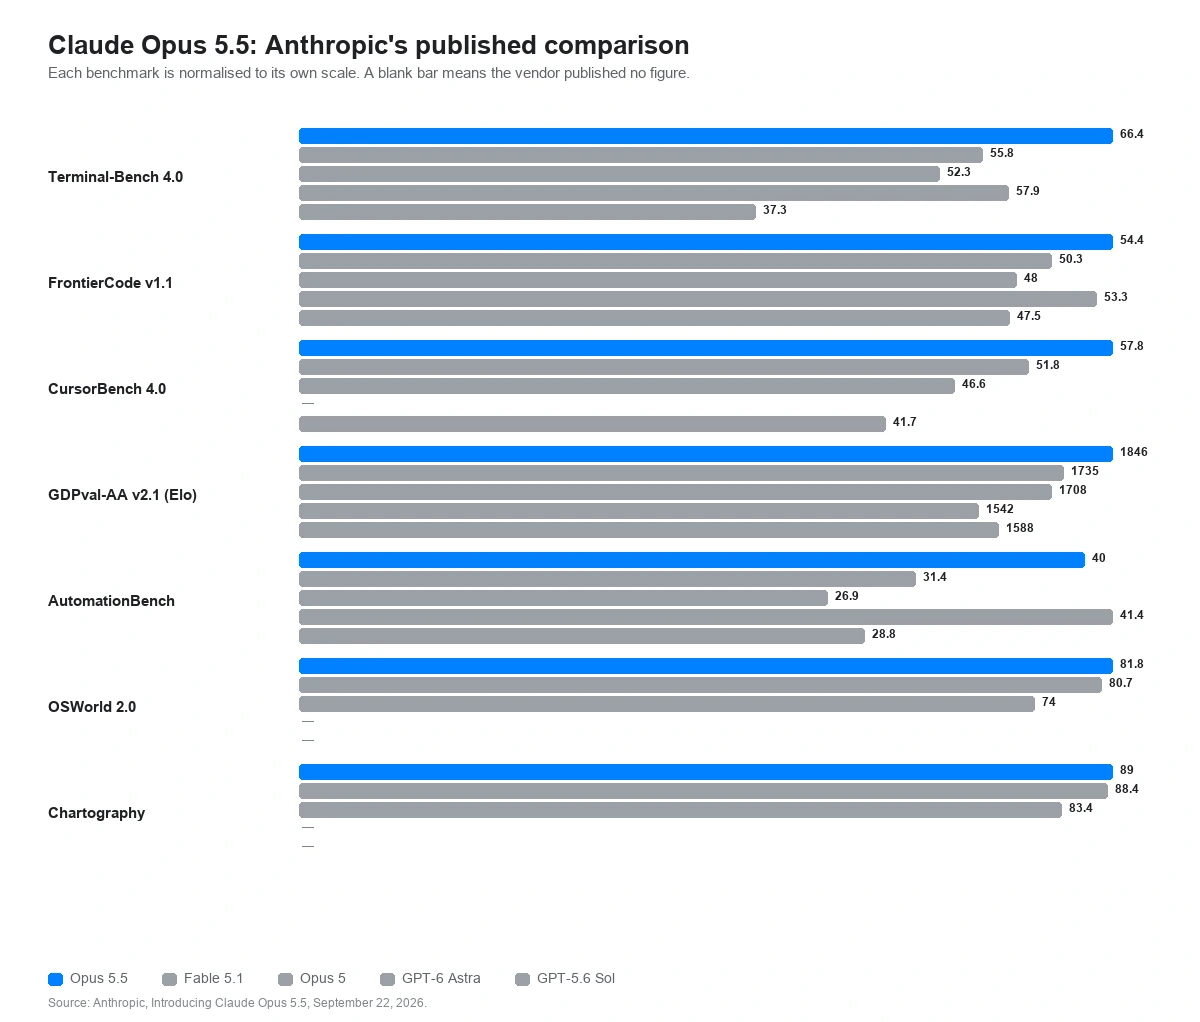
Повне опубліковане порівняння
Агентна робота з кодом, робота зі знаннями, бізнес-процеси, міждисциплінарні міркування, наукові дослідження, робота з компʼютером і розпізнавання графіків за всіма пʼятьма виміряними моделями.
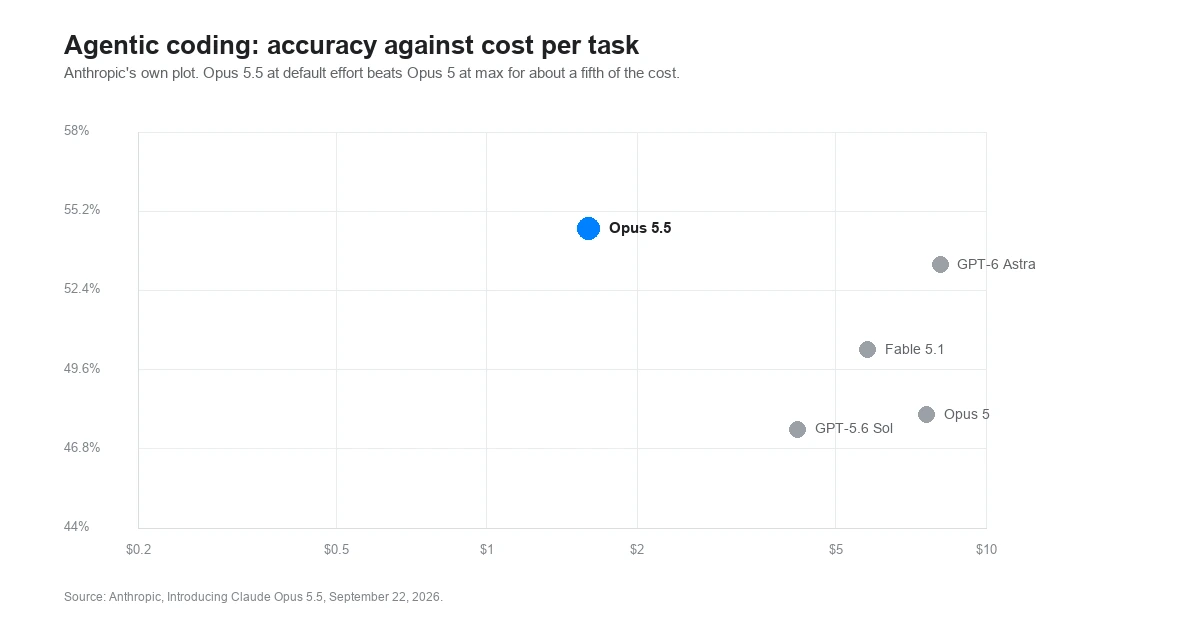
Агентна робота з кодом
Terminal-Bench 4.0, FrontierCode v1.1 і CursorBench 4.0 як залежність точності від вартості завдання.
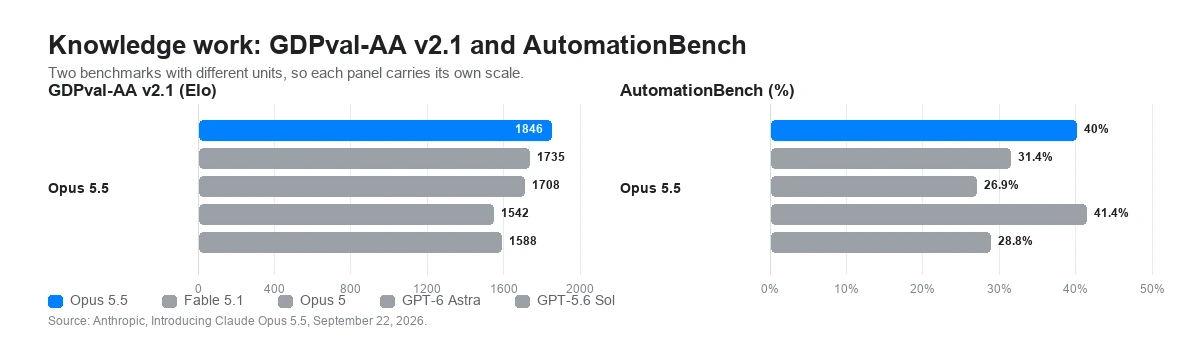
Робота зі знаннями
GDPval-AA v2.1 за 44 професіями, AutomationBench і WANDR — бенчмарк збору даних від Perplexity.
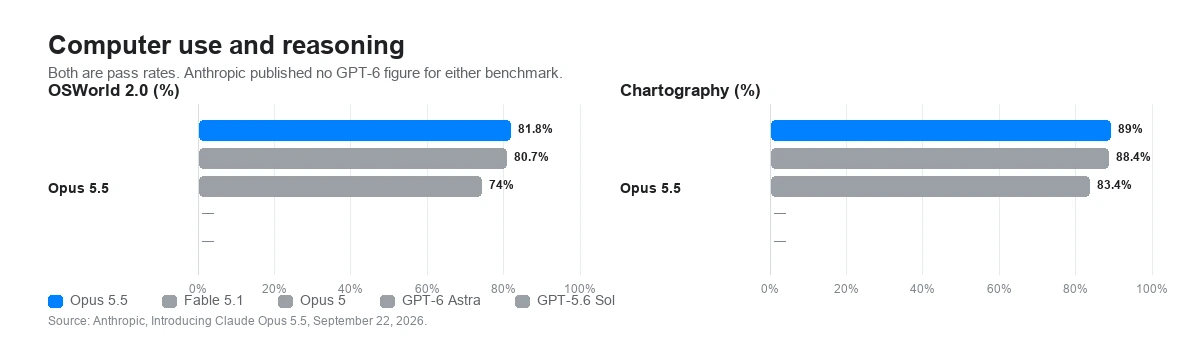
Робота з компʼютером і міркування
OSWorld 2.0, Humanity's Last Exam і Chartography, де останній вимірює точність зчитування значень із графіка.
Точність щодо вартості завдання
Головна теза Anthropic — не вищий бал за будь-яку ціну, а той самий або кращий результат за частку вартості спроби.
Цифри опубліковані виробником. Якщо не зазначено інше, Anthropic запускала Opus 5.5 з адаптивним мисленням на max effort і оцінювала його з увімкненими виробничими захистами. Коли ці захисти втручалися, завдання з кібербезпеки виконувала Opus 4.8, а з біології — Opus 5, що, ймовірно, занижує опубліковані показники Opus 5.5 у цих бенчмарках. Дані GPT-6 Astra і GPT-5.6 Sol наведено так, як їх повідомляє OpenAI. Розриви в бенчмарках між виробниками — слабкий орієнтир для реальних відмінностей, про що Anthropic каже й сама.
Якщо ви вже використовуєте Opus 5
Anthropic перелічує чотири несумісні зміни для інтеграцій, які вже працюють на Claude Opus 5, плюс пʼяту, що змінює форму відповіді, не спричиняючи помилки запиту. Їх варто прочитати до заміни ідентифікатора моделі, бо три з них повертають помилку 400 замість тихої деградації.
01
В Opus 5 мислення вимикалося на high і нижче. В Opus 5.5 воно завжди увімкнене, і як вимкнення, так і ручний бюджет токенів повертають помилку 400. Єдиним регулятором стає effort, а значення за замовчуванням змінюється з high на medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice зі значенням "any" або із зазначенням конкретного інструмента повертає помилку 400, зокрема на ендпоінті підрахунку токенів. Використовуйте auto разом зі строгим викликом інструментів або структурованим виводом і вказуйте в промпті, коли інструмент доречний.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Кожен блок мислення фіксує, яка модель його створила. Opus 5.5 читає блоки Opus 5 і давніших моделей Opus, Sonnet і Haiku, але не Fable і Mythos. Якщо маршрутизатор переводить діалог на іншу модель, наступні ходи виконуються без попередніх міркувань.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 зберігають мислення; інші моделі його втрачають
04
У Claude API та Google Cloud інструмент computer_20251124 повертає помилку 400. Оголосіть натомість набір computer_toolset_20260801, приберіть бета-заголовок і адаптуйте цикл агента під блоки member tool_use. В Amazon Bedrock старий інструмент продовжує працювати.
computer_20251124 -> computer_toolset_20260801
Оскільки мислення не можна вимкнути, налаштовують effort. Opus 5.5 підтримує всі пʼять щаблів і стартує з medium, на щабель нижче за Opus 5. Anthropic радить заново прогнати перебір на власних оцінках, а не переносити налаштування, і задавати великий max_tokens на високих щаблях: токени мислення враховуються в цій межі, навіть коли текст міркувань не повертається.
Effort — це поведінковий сигнал, а не жорсткий бюджет токенів: на низькому щаблі модель усе одно думає над справді складними задачами, просто менше, ніж на високому. Anthropic також зазначає, що на тому самому щаблі Opus 5.5 думає більше за хід, ніж Opus 5, особливо на xhigh і max, тому перенесене налаштування дасть довші й дорожчі ходи.
Де це доречно
Opus 5.5 виправданий, коли завдання триває годинами, охоплює більше файлів, ніж людина здатна втримати, або видає результат, який має перевірити хтось інший. Це ті випадки, які описують Anthropic і її перші тестувальники, а не звичайні чат-промпти.
Провести зміну через великий репозиторій, доки не пройдуть тести, замість зупинки на першому правдоподібному патчі. Anthropic повідомляє про міграцію на 680 000 рядків, завершену одним тестувальником менш ніж за день.
Тестувальник Anthropic на імʼя Column повідомив, що знайшов помилку, звірившись із зовнішньою документацією щодо сторонньої інтеграції, яку було неправильно змодельовано кілька комітів тому.
Спочатку побудувати модель, потім односторінкове резюме, зберігши застереження. Anthropic повідомляє про аналіз злиття за 63 хвилини проти 93 в Opus 5 і вдвічі дешевше.
Модель делегує субагентам і підлаштовує темп під бюджет часу. Anthropic радить передавати мультиагентній системі сигнал про минулий час, щоб вона розпаралелювалася, а не вишиковувалася в чергу.
01
Додайте репозиторій, документи й вимоги, які має врахувати корисна робота. Вікно на 1 млн токенів існує саме для цього.
02
Скажіть, що має бути істинним, щоб робота вважалася завершеною. Порада Anthropic для роботи без нагляду — тримати частини завдання в чек-листі, який модель оновлює.
03
Проженіть одне й те саме завдання на Opus 5.5, Opus 5 і Fable 5.1 у Felo. Порівнюйте не лише відповідь, а й тести, застереження та витрати токенів.
Виберіть Claude Opus 5.5, коли він зʼявиться у списку моделей вашого акаунта.
Спробувати Opus 5.5 у FeloClaude Opus 5.5 — модель Anthropic для тривалої агентної роботи з кодом і роботи зі знаннями, випущена 22 вересня 2026 року як перша модель родини Claude 5.5. За словами Anthropic, вона сягає рівня Claude Fable 5.1 у більшості завдань і коштує на 40% менше в роботі, ніж Claude Opus 5.
Поставте Claude Opus 5.5 поряд з іншими провідними моделями у Felo і перевірте його на тій роботі, яку ви відкладали, бо вона займає години.
Спробувати Opus 5.5 у FeloПочніть із пошуку Felo AI і виберіть модель там, де вона доступна.