01
Menampung seluruh konteks
Jendela konteks 1 juta token dan pengetahuan sampai Juni 2026. Percakapan panjang, satu repositori penuh, atau sekumpulan dokumen tetap berada dalam satu tugas.
Anthropic merilis Opus 5.5 pada 22 September 2026
Model pertama dari keluarga Claude 5.5. Kemampuannya menyamai Claude Fable 5.1 di sebagian besar pekerjaan, biaya jalannya 40% lebih rendah dari Opus 5, dan outputnya lebih dari 30% lebih cepat.
Kini di Felo Search
Claude Opus 5.5 tersedia di Felo Search untuk pekerjaan dengan input panjang: mencocokkan angka antar berkas, melacak klaim sampai ke sumbernya, dan menghasilkan jawaban yang bisa Anda teruskan ke orang lain.
01
Jendela konteks 1 juta token dan pengetahuan sampai Juni 2026. Percakapan panjang, satu repositori penuh, atau sekumpulan dokumen tetap berada dalam satu tugas.
02
Dalam uji internal Anthropic, 16 dari 18 laporan lolos ambang mutu. Satu angka atau kutipan yang dikarang saja sudah cukup membuat pekerjaan itu gagal.
03
Anthropic merombak cara model berkomunikasi: informasi terpenting ada di depan, dan laporannya menyebut dengan jelas apa yang selesai, apa yang ditemukan, dan apa yang masih terbuka.
Panduan singkat
Claude Opus 5.5 muncul di pemilih model bersama model unggulan lain di akun Anda.
Yang membedakan Opus 5.5
Anthropic menonjolkan efisiensi, bukan skor benchmark yang lebih tinggi: lebih sedikit token per tugas, harga per token lebih rendah, dan biaya 40% lebih rendah pada beban kerja umum. Inilah yang membuat pekerjaan agen berjam-jam jadi terjangkau.
01
Anthropic melaporkan seorang penguji awal mengaudit dan memperbaiki basis kode 200.000 baris dalam kurang dari tiga jam, sedangkan Opus 5 butuh lebih dari 20 jam dan memakai 2,5 kali lebih banyak token.
02
Deloitte melaporkan bahwa pada tingkat effort terendah pun Opus 5.5 menemukan 72% bug yang diketahui dalam tinjauan kode, dibanding 56% pada Opus 5 di high, dengan lebih sedikit alarm palsu.
03
Tulisannya lebih pendek dan lebih tertata. Box melaporkan jawaban 40% lebih ringkas tanpa kehilangan akurasi, dengan sepertiga token yang dipakai Opus 5.
Pemilihan model
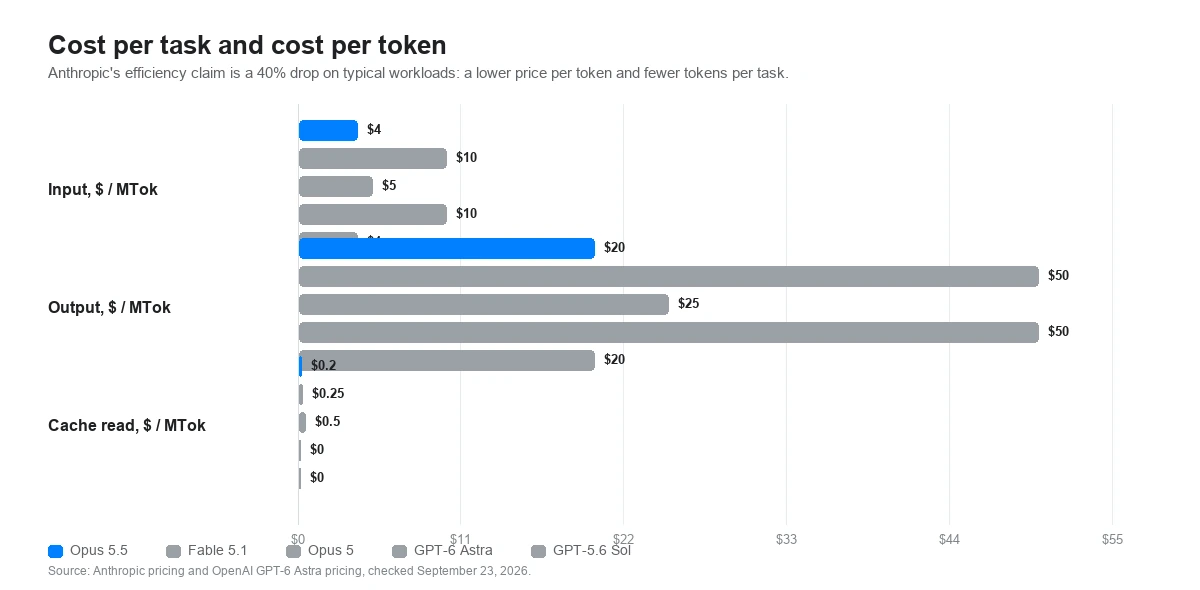
Harga di bawah adalah tarif API publik resmi per juta token, bukan harga langganan atau pemakaian Felo. Baris effort sama pentingnya dengan baris harga: prompt yang sama bisa jauh berbeda biayanya tergantung dari mana tiap model memulai.
Tarif API publik dan nilai bawaan diperiksa pada 23 September 2026 terhadap pengumuman Claude Opus 5.5 dari Anthropic, halaman model Claude Platform, dan halaman GPT-6 Astra dari OpenAI. Harga per token hanya satu bagian dari total biaya tugas. Klaim efisiensi Anthropic adalah penurunan biaya 40% pada beban kerja umum, yang menggabungkan harga per token lebih rendah dengan lebih sedikit token per tugas.
Hasil yang diterbitkan Anthropic
Anthropic menerbitkan angkanya sendiri bersanding dengan Fable 5.1, Opus 5, GPT-6 Astra, dan GPT-5.6 Sol. Dua dari empat grafik di bawah menunjukkan akurasi terhadap biaya per tugas, bukan akurasi semata, karena itulah perbandingan yang dilakukan Anthropic.
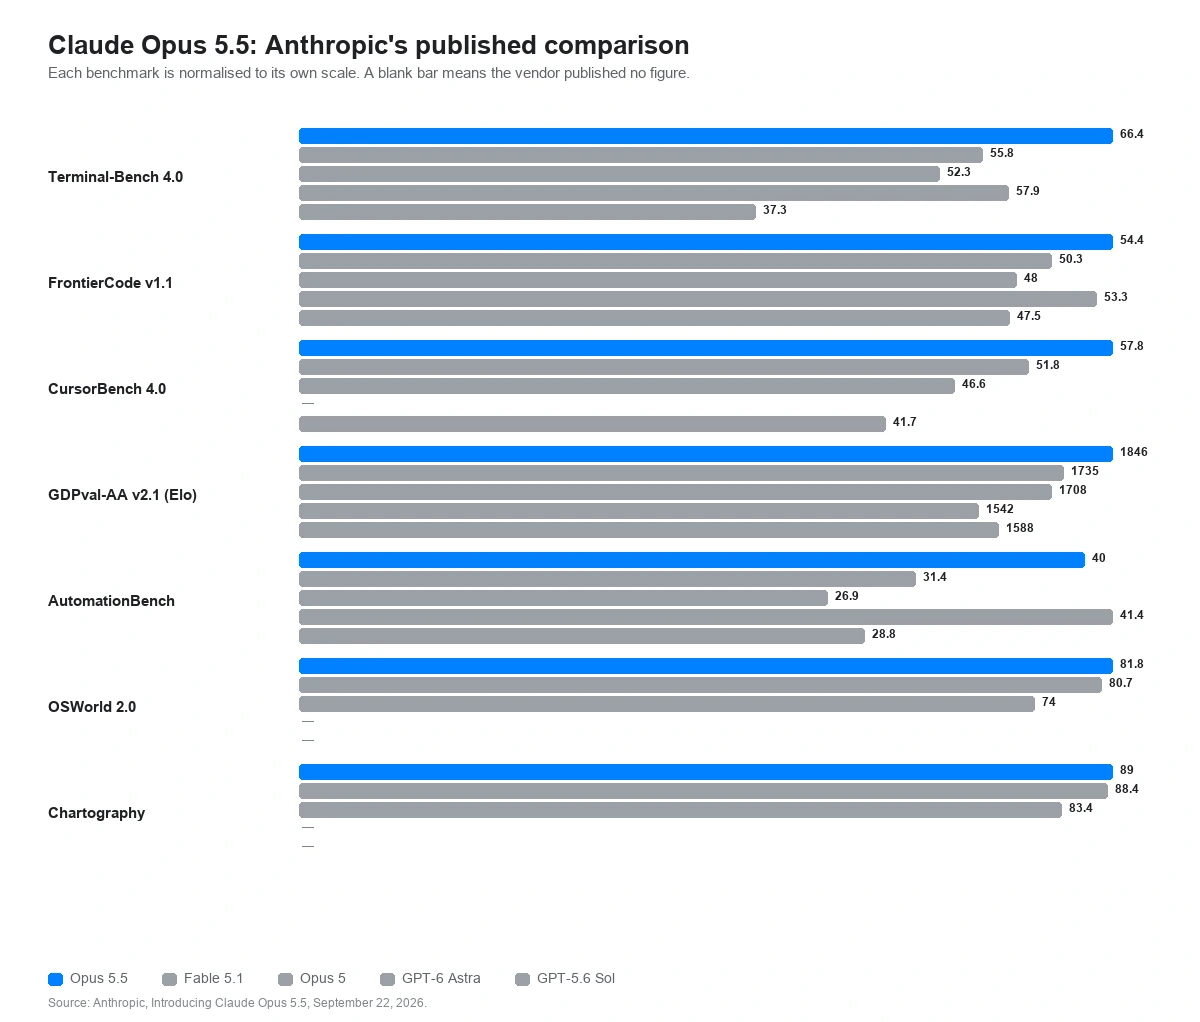
Perbandingan lengkap yang diterbitkan
Coding agen, pekerjaan pengetahuan, alur kerja bisnis, penalaran lintas disiplin, riset ilmiah, penggunaan komputer, dan pembacaan grafik pada kelima model yang diukur.
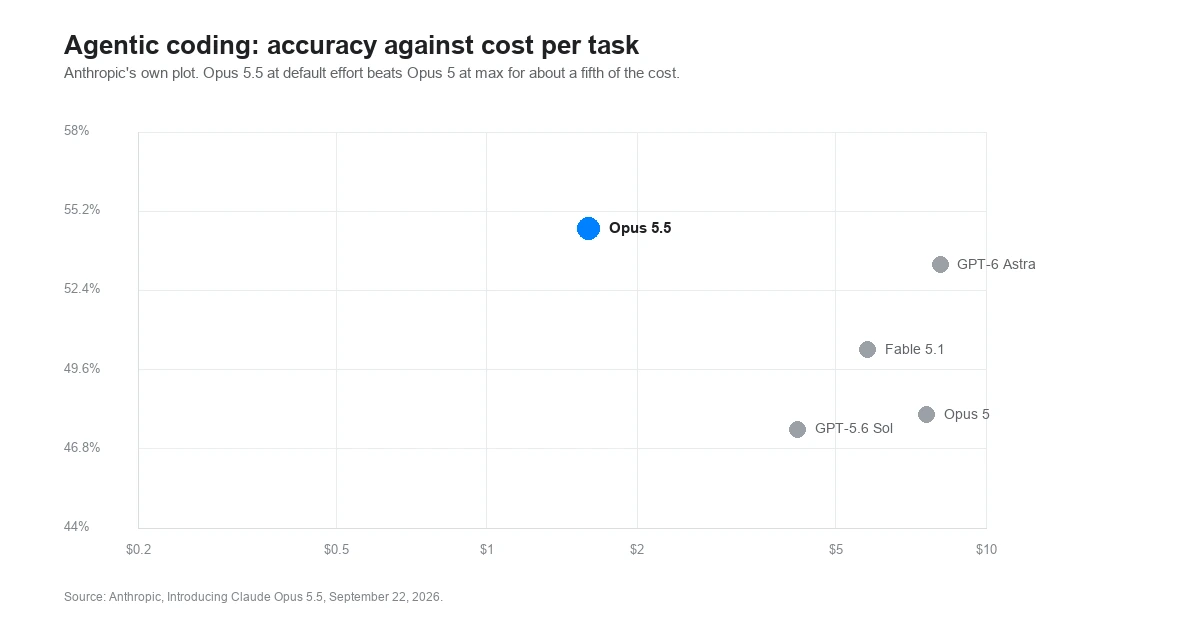
Coding agen
Terminal-Bench 4.0, FrontierCode v1.1, dan CursorBench 4.0, digambarkan sebagai akurasi terhadap biaya per tugas.
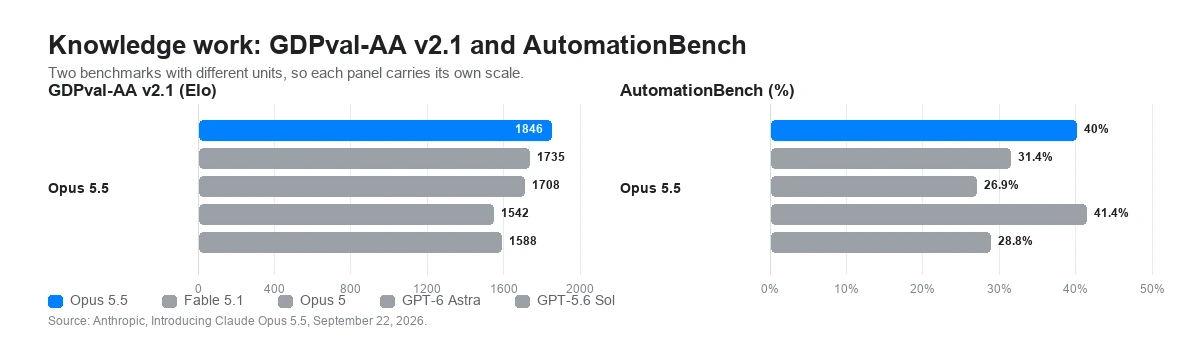
Pekerjaan pengetahuan
GDPval-AA v2.1 pada 44 profesi, AutomationBench, dan WANDR, benchmark pengumpulan data dari Perplexity.
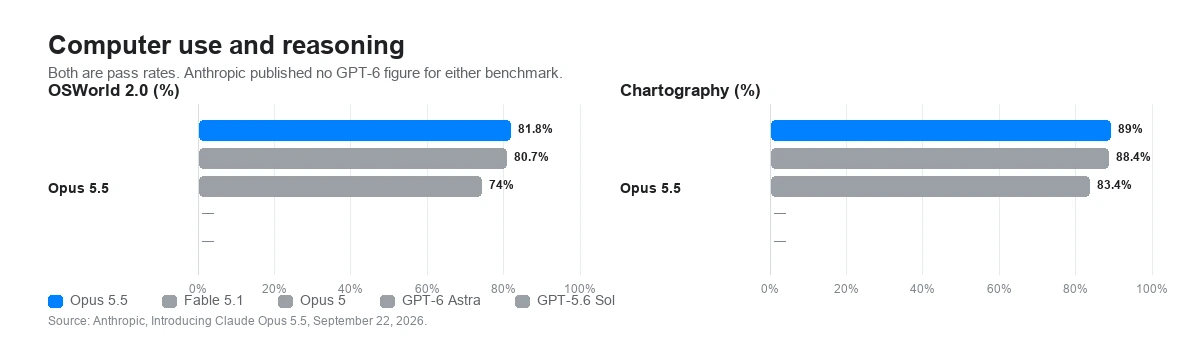
Penggunaan komputer dan penalaran
OSWorld 2.0, Humanity's Last Exam, dan Chartography, yang terakhir mengukur ketepatan membaca nilai dari sebuah grafik.
Akurasi terhadap biaya per tugas
Tesis utama Anthropic bukan skor lebih tinggi berapa pun biayanya, melainkan skor yang sama atau lebih baik dengan sebagian kecil biaya per percobaan.
Angka terbitan vendor. Kecuali disebut lain, Anthropic menjalankan Opus 5.5 dengan penalaran adaptif pada max effort dan menilainya dengan pengaman produksi aktif. Ketika pengaman itu turun tangan, tugas keamanan siber diselesaikan Opus 4.8 dan tugas biologi oleh Opus 5, yang kemungkinan menurunkan angka Opus 5.5 yang diterbitkan pada benchmark tersebut. Angka GPT-6 Astra dan GPT-5.6 Sol adalah yang dilaporkan OpenAI. Selisih benchmark antar vendor adalah petunjuk lemah soal perbedaan nyata, seperti yang Anthropic sendiri katakan soal angka-angka ini.
Jika Anda sudah menjalankan Opus 5
Anthropic mencantumkan empat perubahan yang tidak kompatibel untuk integrasi yang sudah berjalan di Claude Opus 5, plus perubahan kelima yang mengubah bentuk respons tanpa membuat permintaan gagal. Perlu dibaca sebelum menukar ID model, karena tiga di antaranya mengembalikan galat 400 alih-alih menurun diam-diam.
01
Di Opus 5 penalaran bisa dimatikan pada high ke bawah. Di Opus 5.5 selalu aktif, dan baik penonaktifan maupun anggaran token manual mengembalikan galat 400. Effort jadi satu-satunya kendali, dan nilai bawaannya berubah dari high ke medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice yang diatur ke "any" atau ke nama alat tertentu mengembalikan galat 400, termasuk di endpoint penghitungan token. Gunakan auto bersama pemakaian alat yang ketat atau output terstruktur, dan sebutkan di prompt kapan alat itu berlaku.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Setiap blok penalaran mencatat model yang menghasilkannya. Opus 5.5 membaca blok dari Opus 5 dan model Opus, Sonnet, serta Haiku sebelumnya, tetapi tidak dari Fable atau Mythos. Jika router memindahkan percakapan ke model lain, giliran berikutnya berjalan tanpa penalaran sebelumnya.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 mempertahankan penalaran; model lain membuangnya
04
Di Claude API dan Google Cloud, alat computer_20251124 mengembalikan galat 400. Deklarasikan toolset computer_toolset_20260801, hapus header beta, dan sesuaikan loop agen untuk blok member tool_use. Di Amazon Bedrock alat lama masih berfungsi.
computer_20251124 -> computer_toolset_20260801
Karena penalaran tidak bisa dimatikan, yang disetel adalah effort. Opus 5.5 mendukung kelima tingkat dan mulai dari medium, satu tingkat di bawah Opus 5. Anjuran Anthropic adalah mengulang penyapuan pada evaluasi Anda sendiri, bukan membawa setelan lama, dan menyiapkan max_tokens yang longgar di tingkat tinggi, sebab token penalaran dihitung ke batas itu meski teks penalarannya tidak dikembalikan.
Effort adalah sinyal perilaku, bukan anggaran token yang kaku: pada tingkat rendah model tetap berpikir untuk masalah yang benar-benar sulit, hanya lebih sedikit daripada di tingkat tinggi. Anthropic juga mencatat bahwa pada tingkat yang sama Opus 5.5 cenderung berpikir lebih banyak per giliran daripada Opus 5, terutama di xhigh dan max, jadi setelan yang dibawa dari Opus 5 akan menghasilkan giliran yang lebih panjang dan lebih mahal.
Tempat yang cocok
Opus 5.5 layak dipakai ketika sebuah tugas berjalan berjam-jam, mencakup lebih banyak berkas daripada yang bisa dipegang satu orang, atau menghasilkan sesuatu yang harus diperiksa orang lain. Ini kasus yang digambarkan Anthropic dan penguji awalnya, bukan prompt obrolan biasa.
Membawa perubahan menembus repositori besar sampai tesnya lulus, bukan berhenti di tambalan pertama yang terlihat masuk akal. Anthropic melaporkan migrasi 680.000 baris selesai dalam kurang dari sehari oleh seorang penguji.
Column, penguji yang dikutip Anthropic, melaporkan menemukan bug dengan memeriksa dokumentasi eksternal untuk integrasi pihak ketiga yang beberapa commit sebelumnya dimodelkan secara keliru.
Membangun model lalu ringkasan satu halaman, dengan catatan kaveatnya tetap utuh. Anthropic melaporkan analisis merger selesai dalam 63 menit dibanding 93 menit di Opus 5, dengan biaya separuh.
Model mendelegasikan ke subagen dan menyesuaikan tempo dengan anggaran waktu. Anjuran Anthropic adalah memberi arsitektur multiagen sinyal waktu berjalan agar memparalelkan alih-alih menyerialkan.
01
Sertakan repositori, dokumen, dan persyaratan yang harus diperhitungkan jawaban yang berguna. Jendela 1 juta token ada untuk ini.
02
Katakan apa yang harus benar agar pekerjaan dianggap tuntas. Anjuran Anthropic untuk sesi tanpa pengawasan adalah menyimpan bagian-bagian tugas dalam daftar periksa yang diperbarui model.
03
Jalankan tugas yang sama di Opus 5.5, Opus 5, dan Fable 5.1 di Felo. Bandingkan bukan hanya jawabannya, tetapi juga tes, kaveat, dan pemakaian token.
Pilih Claude Opus 5.5 begitu muncul di pemilih model akun Anda.
Coba Opus 5.5 di FeloClaude Opus 5.5 adalah model Anthropic untuk coding agen jangka panjang dan pekerjaan pengetahuan, dirilis 22 September 2026 sebagai model pertama keluarga Claude 5.5. Menurut Anthropic kemampuannya menyamai Claude Fable 5.1 di sebagian besar pekerjaan dengan biaya jalan 40% lebih rendah dari Claude Opus 5.
Letakkan Claude Opus 5.5 bersanding dengan model unggulan lain di Felo, lalu uji pada pekerjaan yang Anda tunda karena butuh berjam-jam.
Coba Opus 5.5 di FeloMulai dari Felo AI Search dan pilih modelnya di tempat yang tersedia.