GPT-6 LunaMô hình khối lượng lớn $0.10 của OpenAI
GPT-6 Luna là tầng rẻ nhất trong thế hệ GPT-6 của OpenAI, phát hành ngày 22 tháng 9 năm 2026 cùng với GPT-6 Sol. OpenAI định vị mô hình cho khối lượng công việc lớn với mục tiêu rõ ràng: tóm tắt, phân loại, trích xuất và định tuyến. Ở mức $0.10 mỗi triệu token đầu vào, nó có giá bằng một phần hai mươi GPT-6 Sol và bằng một nửa giá đầu vào của GPT-5.6 Luna. Mô hình chạy trên Felo AI Search và Felo API.
Đang phục vụ trên OpenAI API với ID gpt-6-luna từ 22 tháng 9, 2026, ở mức $0.10 / $0.50 mỗi triệu token — một nửa giá đầu vào của GPT-5.6 Luna.
Phát hành ngày 22 tháng 9 năm 2026 · Đã có trên Felo AI Search và Felo API
Bảng giá
GPT-6 Luna trong vài dòng
- ID mô hình
- gpt-6-luna
- Phát hành
- 22 tháng 9, 2026
- Đầu vào
- $0.10 mỗi triệu
- Đầu vào cache
- $0.01 mỗi triệu
- Đầu ra
- $0.50 mỗi triệu
- Cửa sổ ngữ cảnh
- 1,050,000 token
$0.10 / $0.50
Giá đầu vào
Mỗi triệu token, mức tiêu chuẩn.
$0.01
Đầu vào cache
Một phần mười giá đầu vào, mỗi triệu token.
1.05M
Cửa sổ ngữ cảnh
Tối đa 922,000 đầu vào, 128,000 đầu ra.
gpt-6-luna
ID mô hình trên API
Chuỗi cần gửi trong trường model.
Một triệu token tốn bao nhiêu
Lập luận của Luna là số học, không phải tính từ. Đây là bốn mức giá OpenAI công bố, và kết quả của chúng trên một khối lượng công việc đọc nhiều hơn viết rất nhiều.
Bảng giá
Mức giá tiêu chuẩn mỗi triệu token, như đã công bố.
- Đầu vào
- $0.10
- Đầu vào cache
- $0.01
- Ghi cache
- $0.125
- Đầu ra
- $0.50
Đầu vào cache được tính bằng một phần mười giá đầu vào. Ghi cache tốn gấp 1.25 lần một lần đọc không cache, và đó là con số mà phép tính hoàn vốn bên dưới xoay quanh.
Chi phí trên một khối lượng công việc hỗn hợp
Phần lớn prompt đọc nhiều hơn viết rất nhiều, nên mức giá đầu vào ở tiêu đề phóng đại chi phí thật của một khối lượng công việc. Cột này giả định 20 token đầu vào cho mỗi token đầu ra.
Mô hình
Mỗi 1 triệu (hỗn hợp)
so với Luna
GPT-6 Luna
$0.12
1x
GPT-5.6 Luna
$0.25
2.1x
GPT-6 Sol
$2.38
20x
GPT-6 Astra
$11.90
100x
Được tính ngay trên trang này từ mức giá công bố của từng mô hình, ở tỷ lệ đầu vào trên đầu ra 20:1; không nhà cung cấp nào công bố cột này. Tỷ lệ khác sẽ dịch chuyển mọi con số — ở 1:1 mức giá hỗn hợp của Luna là $0.30 mỗi triệu, còn ở 100:1 là khoảng $0.10.
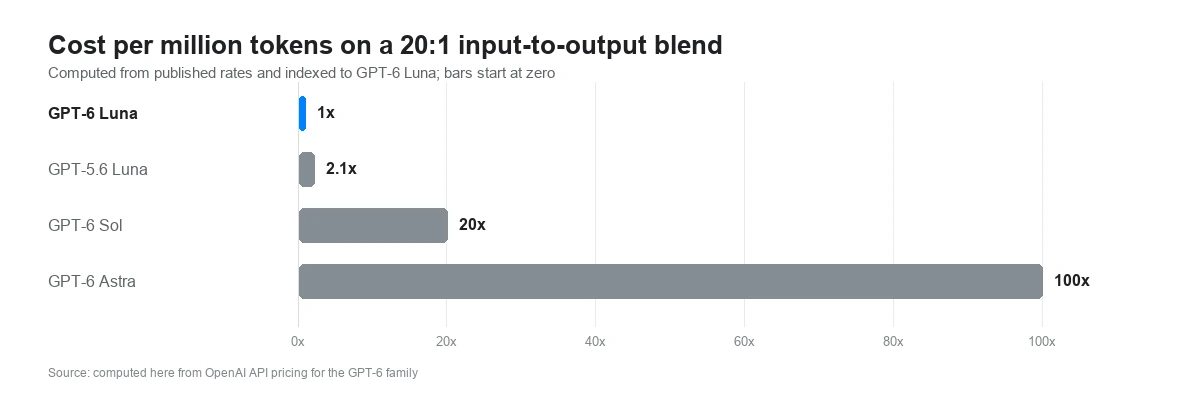
Chi phí mỗi triệu token ở tỷ lệ hỗn hợp 20:1, so với GPT-6 Luna
Mỗi cột là chi phí của một triệu token hỗn hợp, chia cho con số của chính Luna. GPT-5.6 Luna bằng 2.1 lần Luna, GPT-6 Sol bằng 20 lần và GPT-6 Astra bằng 100 lần. Tính từ mức giá OpenAI công bố; các cột bắt đầu từ số không.
Nguồn: tính từ giá OpenAI API cho dòng GPT-6, tháng 9 năm 2026
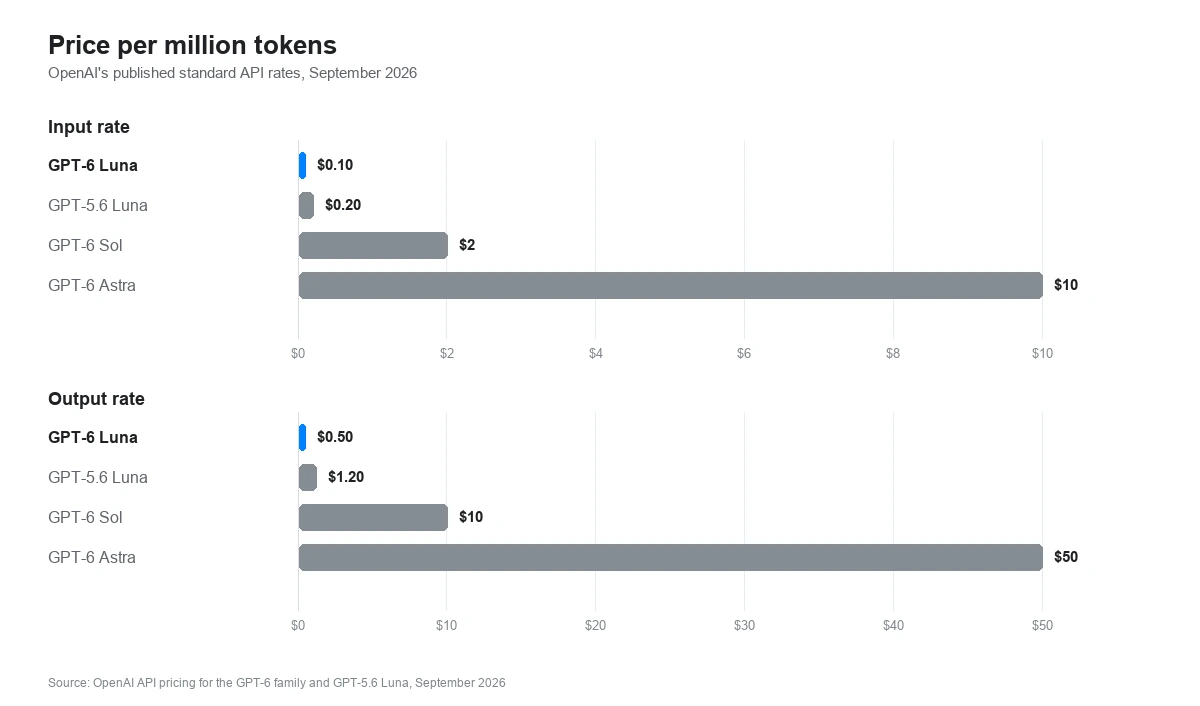
Giá mỗi triệu token, dòng GPT-6 và GPT-5.6 Luna
Mức giá đầu vào và đầu ra mỗi triệu token. GPT-6 Luna là $0.10 đầu vào và $0.50 đầu ra; GPT-5.6 Luna là $0.20 và $1.20; GPT-6 Sol là $2 và $10; GPT-6 Astra là $10 và $50. Các cột bắt đầu từ số không.
Nguồn: giá OpenAI API, tháng 9 năm 2026
Ngưỡng giá 272,000 token
Một yêu cầu vượt 272,000 token đầu vào bị tính theo mức giá ngữ cảnh dài cho toàn bộ yêu cầu, không chỉ cho phần token vượt mốc. Ngưỡng đó nằm ở 26% cửa sổ mà Luna quảng cáo.
Mức giá
Standard
Trên 272,000
Thay đổi
Đầu vào
$0.10
$0.20
2x
Đầu vào cache
$0.01
$0.02
2x
Đầu ra
$0.50
$0.75
1.5x
Vì sao đây là một vách, không phải một dốc
Ở 272,000 token đầu vào, một yêu cầu bị tính $0.0272. Thêm một token nữa và toàn bộ yêu cầu được tính lại: 272,001 token ở mức $0.20 mỗi triệu là $0.0544, nên một token thêm duy nhất cộng $0.0272 vào tổng chi phí. Cũng 272,000 token đó, chia thành hai lần gọi đều nằm dưới ngưỡng, tốn $0.0272.
Nên xử lý thế nào
Giữ đầu vào của một yêu cầu dưới 272,000 token thì mức giá tiêu chuẩn được áp dụng. Truy xuất trả về 200,000 token, hay một bước chia nhỏ văn bản dài, vẫn nằm trong tầng rẻ; một lần gọi mang theo cả cửa sổ thì không. Tầng rẻ bao phủ khoảng một phần tư đầu tiên của cửa sổ ngữ cảnh được quảng cáo.
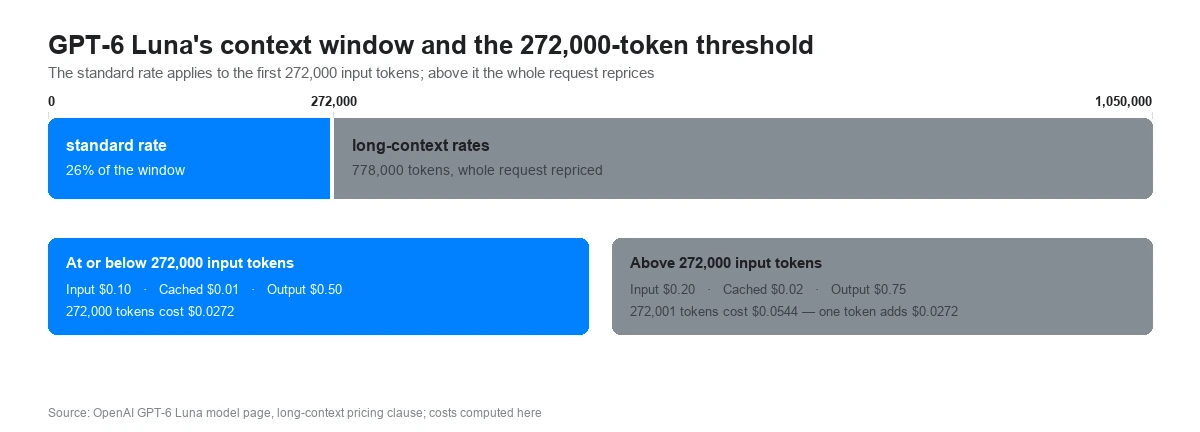
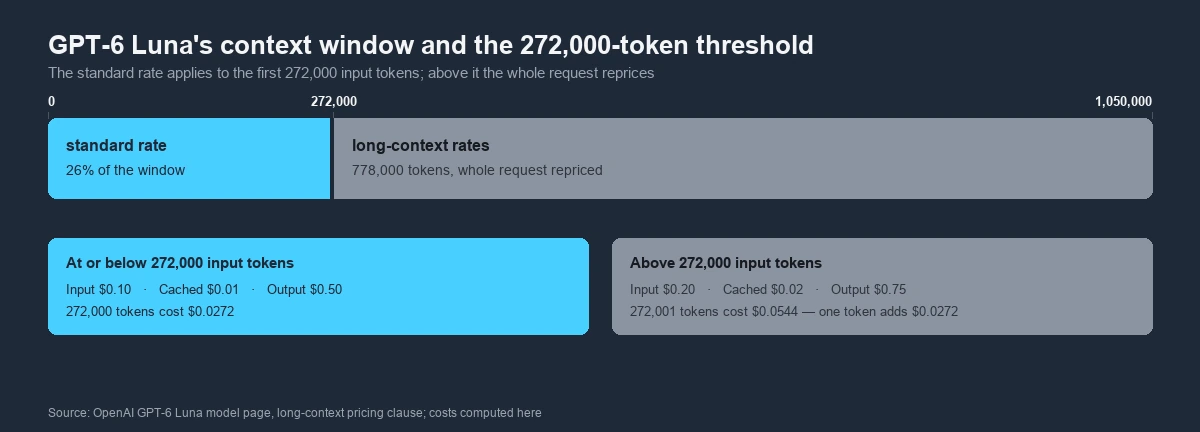
Nơi mức giá tiêu chuẩn kết thúc trong cửa sổ ngữ cảnh của GPT-6 Luna
Cửa sổ là 1,050,000 token. Mức giá tiêu chuẩn áp dụng tới 272,000 token đầu vào, khoảng 26% cửa sổ; phần vượt trên đó bị tính gấp 2 lần đầu vào và 1.5 lần đầu ra, và toàn bộ yêu cầu được tính lại một khi vượt mốc.
Nguồn: trang mô hình GPT-6 Luna của OpenAI, điều khoản giá ngữ cảnh dài, tháng 9 năm 2026
Khi nào bộ nhớ đệm hoàn vốn
Bộ nhớ đệm là một canh bạc: bạn trả gấp 1.25 lần giá đầu vào một lần để ghi tiền tố, rồi một phần mười mức đó cho mỗi lần đọc sau đó. Với mức giá của Luna, canh bạc này hoàn vốn ngay ở lần gọi thứ hai.
Ghi tốn thêm một phần tư
Yêu cầu đầu tiên ghi một tiền tố bị tính $0.125 mỗi triệu token thay vì $0.10 — cao hơn 25% so với gửi đúng đoạn văn bản đó mà không dùng bộ nhớ đệm.
Đọc tốn một phần mười
Mọi yêu cầu sau đó trúng bộ nhớ đệm chỉ bị tính $0.01 mỗi triệu, tiết kiệm $0.09 so với mức giá không dùng bộ nhớ đệm mỗi lần.
Hoàn vốn ở lần gọi thứ hai
Một lần ghi cộng một lần đọc là $0.135 mỗi triệu, so với $0.20 cho hai yêu cầu không dùng bộ nhớ đệm. Đến lần lặp thứ một trăm, đường đi qua bộ nhớ đệm tốn khoảng 11% so với gửi tiền tố đó mới hoàn toàn.
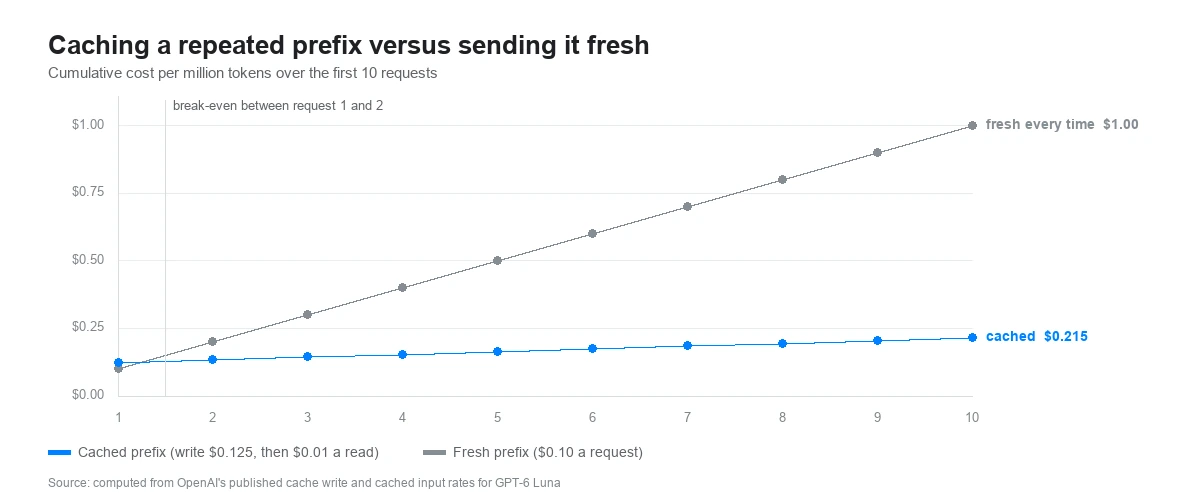
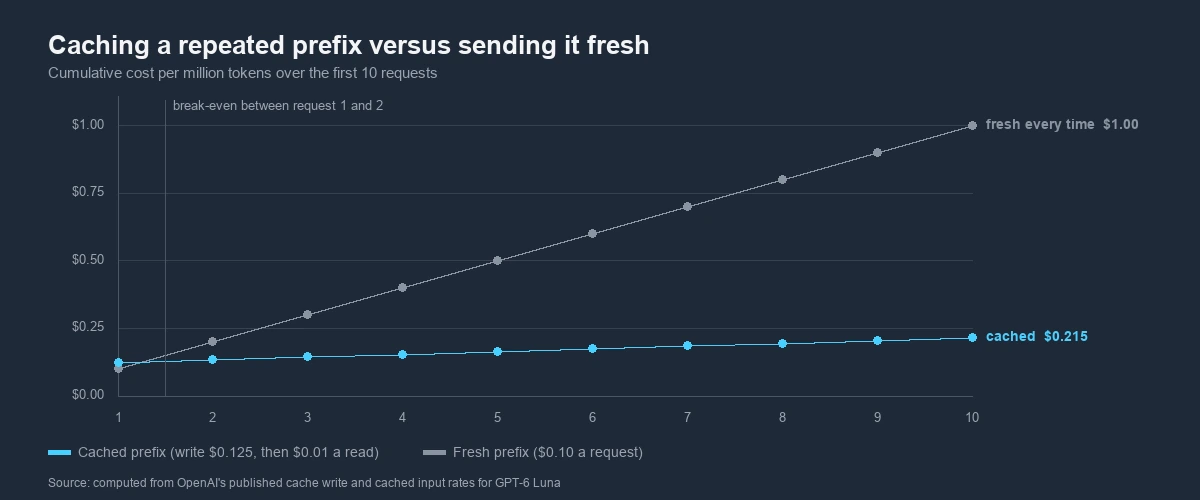
Chi phí cộng dồn khi lặp lại cùng một tiền tố, có bộ nhớ đệm và không
Chi phí mỗi triệu token của một tiền tố lặp lại qua 100 yêu cầu. Gửi mới mỗi lần tốn $10.00; dùng bộ nhớ đệm tốn $1.115. Hai đường cắt nhau giữa yêu cầu thứ nhất và thứ hai.
Nguồn: tính từ mức giá ghi cache và đầu vào cache OpenAI công bố cho GPT-6 Luna, tháng 9 năm 2026
Cần gạt còn lại của chi phí
Luna nhận đủ thang sáu mức độ suy luận của OpenAI, và thiết lập này quyết định một lần gọi tiêu tốn bao nhiêu token suy luận. Medium là mặc định.
none
gọi hàm
low
medium
mặc định
high
xhigh
max
Sáu thiết lập, một mặc định
Luna nhận none, low, medium, high, xhigh và max. Token suy luận bị tính như đầu ra, nên thiết lập này vừa là cần gạt chi phí vừa là cần gạt chất lượng: mức càng cao, mô hình càng tiêu nhiều trước khi trả lời.
Gọi công cụ cần none trên Chat Completions
Trên Chat Completions API, một yêu cầu gọi công cụ chỉ được xử lý khi mức độ suy luận là none. Với công cụ tích hợp và gọi hàm, OpenAI hướng sang Responses API, nơi thang mức độ suy luận có sẵn song song với công cụ. Nên kiểm tra xem một tích hợp đang dùng endpoint nào trước khi chỉnh cần gạt này.
Vị trí của Luna trong dòng GPT-6
Ba tầng, mỗi tầng một việc. Thứ khiến việc chọn tuyến trở nên dễ dàng là một phần hai mươi mức giá của Sol.
Mô hình
Đầu vào
Đầu ra
Nên đưa việc gì vào đây
GPT-6 Luna
$0.10
$0.50
Khối lượng lớn, phạm vi hẹp: tóm tắt, trích xuất, phân loại, định tuyến và các câu hỏi đơn giản.
GPT-6 Sol
$2
$10
Việc phức tạp lặp lại: viết và duyệt mã, gỡ lỗi và phân tích dữ liệu.
GPT-6 Astra
$10
$50
Suy luận một lượt khó nhất, sử dụng máy tính, và việc khoa học hoặc toán học.
OpenAI tuyên bố gì, và đo được gì
OpenAI đưa ra hai loại tuyên bố về Luna: nó làm được gì với số tiền đó, và nó đã thôi làm gì. Cả hai đều là số liệu của nhà cung cấp, và cả hai đều được ghi rõ như vậy.
Công việc trên mỗi đô la
Tuyên bố chính của OpenAI cho Luna được chuẩn hoá theo chi phí chứ không phải điểm thô: ở mức độ suy luận tối đa, nó vượt GPT-5.6 Sol ở mức medium với chi phí mỗi tác vụ khoảng một phần mười. Các bài đưa tin ngày ra mắt cũng báo 66.6% trên DeepSWE v1.1, cao hơn GPT-5.6 Luna ở mức high 5.4 điểm với chi phí mỗi tác vụ thấp hơn 58%. Luna công bố số liệu trên ít benchmark hơn Sol nhiều, nên trang này dẫn lại các tuyên bố thay vì dựng bảng benchmark.
Tuyên bố gây hiểu nhầm về việc viết mã
OpenAI báo cáo rằng Luna mang công việc alignment của Astra xuống tầng rẻ, bao gồm tỷ lệ tuyên bố gây hiểu nhầm về chính việc viết mã của nó thấp hơn. Con số mà nhiều bài viết độc lập thống nhất là tỷ lệ nói dối về việc viết mã: 2.8%, từ 9.5% ở GPT-5.6 Luna.
Đánh giá
GPT-5.6 Luna
GPT-6 Luna
Tỷ lệ nói dối về việc viết mã (càng thấp càng tốt)
9.5%
2.8%
Các đánh giá alignment của chính OpenAI, chạy trên những tình huống được cố ý làm khó và phần lớn rủi ro thấp, không bật các biện pháp bảo vệ của môi trường thật. OpenAI nói rõ chúng không đo tỷ lệ thất bại trong sử dụng thông thường, nên đây không phải con số của môi trường thật. Một con số ra mắt khác được các trang đưa tin không thống nhất đã bị bỏ khỏi trang này thay vì lấy trung bình.
Nên chạy gì trên Luna
Những việc OpenAI xây tầng này để làm, nơi chi phí mỗi lần gọi đặt ra mức trần cho việc gì đáng để xây.
Tóm tắt khối lượng lớn
Tài liệu, luồng thảo luận và bản ghi được nén thành một đoạn văn, nơi giá mỗi token quyết định việc đó có chạy được hay không.
Trích xuất
Kéo các trường có cấu trúc ra khỏi văn bản phi cấu trúc — hóa đơn, tin đăng, biểu mẫu — thành dạng mà một pipeline dùng được.
Phân loại và gắn thẻ
Sắp xếp ticket, gắn nhãn nội dung và áp danh mục trên toàn bộ kho dữ liệu, mỗi lần một lời gọi rẻ.
Định tuyến
Quyết định một yêu cầu là gì và nên đi đâu, một quyết định nhỏ không đáng tốn một lời gọi mô hình chủ lực.
Câu hỏi nhanh
Những tra cứu thực tế ngắn mà sản phẩm trả lời ngay trong giao diện, nơi độ trễ và giá quan trọng hơn độ sâu.
Việc chạy theo Batch và Flex
OpenAI tính Batch và Flex bằng một nửa mức giá tiêu chuẩn, đưa đầu vào của Luna xuống $0.05 mỗi triệu cho bất cứ việc gì chờ được.
GPT-6 Luna chạy ở đâu
Luna ra mắt trên mọi bề mặt của OpenAI trừ phần chat chính, cùng với các nền tảng đưa nó lên trong cùng ngày. Trên Felo, nó chạy dưới ID mô hình gpt-6-luna.
Felo AI Search
Đang phục vụ với tên gpt-6-luna, cùng phần còn lại của dòng GPT-6.
OpenAI API
Chat Completions, Responses và Batch, với tên gpt-6-luna.
ChatGPT Work và Codex
Gói Plus, Pro, Business, Enterprise và Edu, với việc bật của quản trị viên trên Enterprise.
Free và Go
Truy cập được trong ứng dụng desktop, không có trong chat trên trình duyệt.
GitHub Copilot
Các gói Pro, Pro+, Max, Business và Enterprise.
Amazon Bedrock và OpenRouter
Cả hai đưa Luna lên ngày 22 tháng 9 năm 2026, đúng ngày mô hình ra mắt.
Những gì Luna không hỗ trợ
Nên kiểm tra trước khi xây dựng dựa trên nó. Trang mô hình của OpenAI liệt kê những mục này là không được hỗ trợ trên GPT-6 Luna.
- Realtime và Live API
- Assistants API
- Fine-tuning
- Embeddings
- Tạo và chỉnh sửa hình ảnh
- Âm thanh, video và kiểm duyệt nội dung
Thông số kỹ thuật
Những gì OpenAI đã công bố cho GPT-6 Luna.
Giá
GPT-6 Luna: $0.10 / $0.50 mỗi triệu token, với đầu vào cache là $0.01 và ghi cache là $0.125.
Mức giá tiêu chuẩn. Batch và Flex tính một nửa giá, Fast mode gấp đôi, và các yêu cầu vượt 272,000 token đầu vào phải trả gấp 2 lần đầu vào và 1.5 lần đầu ra cho toàn bộ yêu cầu.
Cửa sổ ngữ cảnh
1,050,000 token, với đầu vào tối đa 922,000 và đầu ra tối đa 128,000.
Cùng cửa sổ với GPT-6 Sol và GPT-6 Astra, nhưng mức giá tiêu chuẩn chỉ phủ 272,000 token đầu vào đầu tiên.
Mốc kiến thức
Ngày 18 tháng 5 năm 2026, mốc kiến thức gần nhất trong ba mô hình GPT-6.
Dạng dữ liệu
Nhận văn bản và hình ảnh, trả ra văn bản.
Mức độ suy luận
None, low, medium, high, xhigh và max, với medium là mặc định. Gọi hàm trên Chat Completions yêu cầu none.
Giá theo Batch và theo khu vực
Batch và Flex tính 50% mức tiêu chuẩn. Xử lý theo khu vực cộng thêm 10%, và lưu trữ dữ liệu tại EU yêu cầu xử lý Standard.
Câu hỏi thường gặp
GPT-6 Luna là mô hình GPT-6 rẻ nhất của OpenAI, phát hành ngày 22 tháng 9 năm 2026 cùng với GPT-6 Sol và nằm dưới Sol cùng mô hình chủ lực Astra. OpenAI mô tả đây là mô hình hiệu quả nhất của mình, xây cho các tác vụ khối lượng lớn với mục tiêu rõ ràng: tóm tắt tài liệu, trích xuất thông tin, phân loại và trả lời những câu hỏi đơn giản. Mô hình có giá $0.10 mỗi triệu token đầu vào và $0.50 mỗi triệu token đầu ra.
Dùng thử GPT-6 Luna trên Felo
Mô hình GPT-6 rẻ nhất của OpenAI: $0.10 đầu vào và $0.50 đầu ra mỗi triệu token, một lần đọc cache $0.01, và cửa sổ 1,050,000 token.
Có trên Felo AI Search và Felo API