Anunciado el 30 de septiembre de 2026 · Despliegue por fases

Gemini 4 Argoninvestigación larga, escrita entera

El primer modelo frontera de Google desde Gemini 3, pensado para razonar a fondo en trabajos largos de varios pasos. Sube el techo de salida de 64K tokens a 1M, y lidera los números que publica Google en trabajo de conocimiento, no en programación.

La API de Felo está en beta cerrada — el acceso a Gemini 4 Argon llegará pronto.
Arte principal de Gemini 4 Argon: el nombre del modelo junto a un gran número 4 sobre un degradado azul
El arte del anuncio de Google. Argon llega con un nuevo esquema de nombres, no como una actualización de la línea Gemini 4.0, y por eso el nombre no lleva número de versión.
1M
Tokens de salida máximos
Frente a 64K — un informe completo generado en una sola trayectoria.
2 $ / 10 $
Precio introductorio de la API
Por millón de tokens de entrada y de salida. La entrada en caché tiene un 95 % de descuento.
77.9 %
DeepSWE v1.1
La puntuación que reporta Google, por delante de Claude Opus 5.5 y GPT-6 Astra.
15 %
Tasa de alucinación
La más baja medida entre modelos frontera por Artificial Analysis.

Las cifras y los gráficos de esta página proceden de las organizaciones que los publicaron — Google, Arena.ai y Artificial Analysis — y se reproducen sin modificaciones.

Estado del despliegue

Argon todavía no está disponible para todos. Este es el orden en que llega.

Google está lanzando Argon por fases, y la primera no es la pública. El acceso dentro de Felo se está preparando a la par de este despliegue.

Ya disponible

Defensores de ciberseguridad de confianza

Los socios seleccionados del programa Fairwind de Google reciben Argon primero, y lo reciben sin las salvaguardas habituales de ciberseguridad.

Anunciado a continuación

Clientes de pago de la API y Google AI Ultra

Google dice que el acceso ampliado empieza aquí. No ha dado ninguna fecha, y una suscripción por sí sola no lo concede hoy.

Aún sin fecha

Desarrolladores, empresas y consumidores

Va después de los niveles de pago. Google no se ha comprometido con un plazo para la disponibilidad general.

El acceso a Argon dentro de la búsqueda de Felo está en marcha. Esta página se actualizará cuando se abra.

En qué destaca

Un modelo hecho para terminar trabajos largos, no para responder rápido

Los puntos fuertes que publica Google para Argon se concentran en leer, razonar y escribir extensamente. Es una forma distinta de la de los modelos frontera centrados en código con los que se le compara.

Razonamiento que aguanta una tarea larga

Google sitúa Argon en trabajos de varios pasos que duran horas, donde los modelos anteriores se desvían o se detienen antes de tiempo.

1M tokens de salida en una sola pasada

El motivo que da Google para el aumento: un modelo con espacio para pensar largo puede resolver un problema difícil en una sola trayectoria en vez de en muchas idas y vueltas.

Lidera el trabajo de conocimiento, no la programación

Las diferencias más amplias que reporta están en Harvey's Legal Agent Benchmark y Vals Finance Agent v2: análisis jurídico y financiero real, no tareas sintéticas.

Recuperación en contexto largo que se sostiene

En GraphWalks, que comprueba si un modelo puede usar de verdad un contexto de 256K a 1M, Google reporta una ventaja de más de diez puntos sobre otros modelos insignia.

Comprensión de vídeo largo

LVBench, que mide la comprensión sobre vídeo largo, se reporta en 91.7 %, la puntuación más alta que Google lista para Argon.
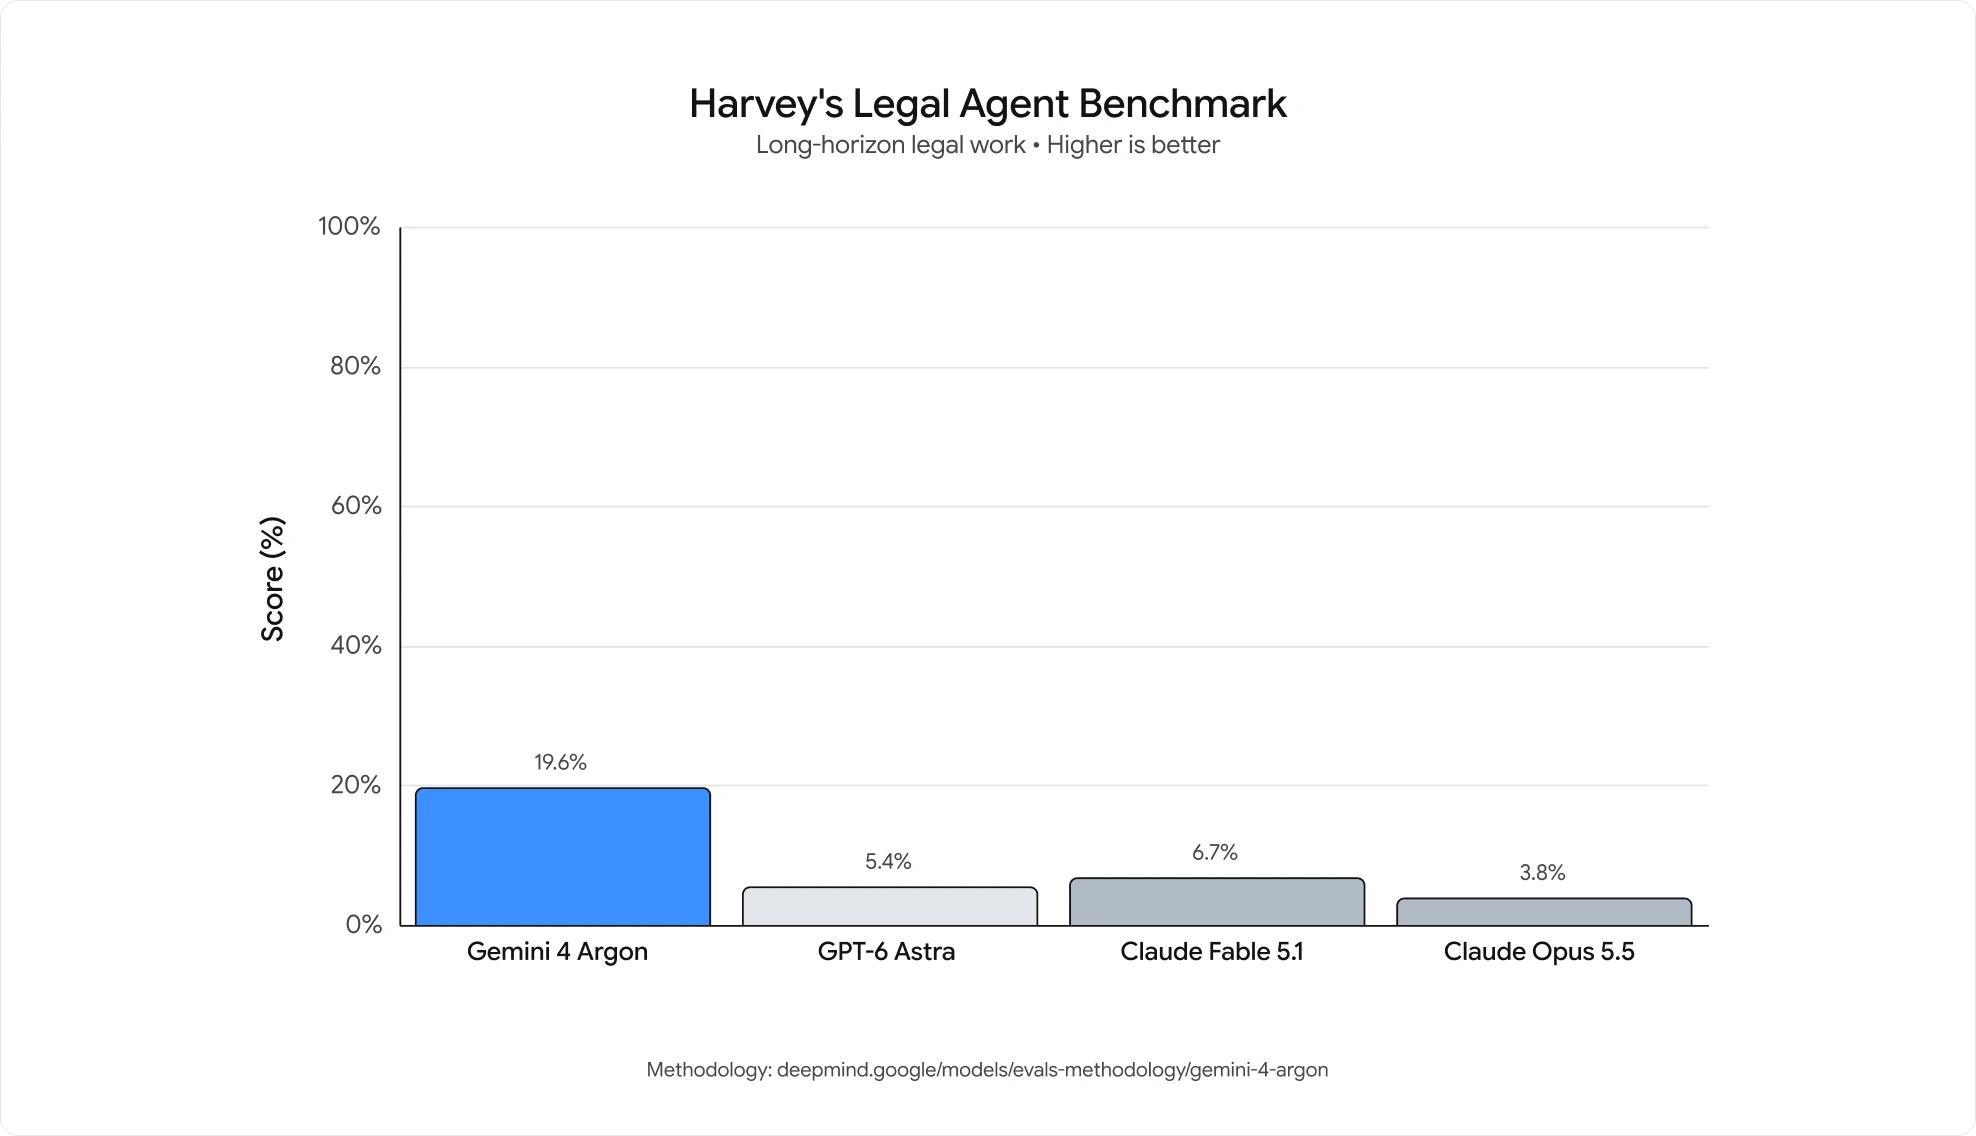
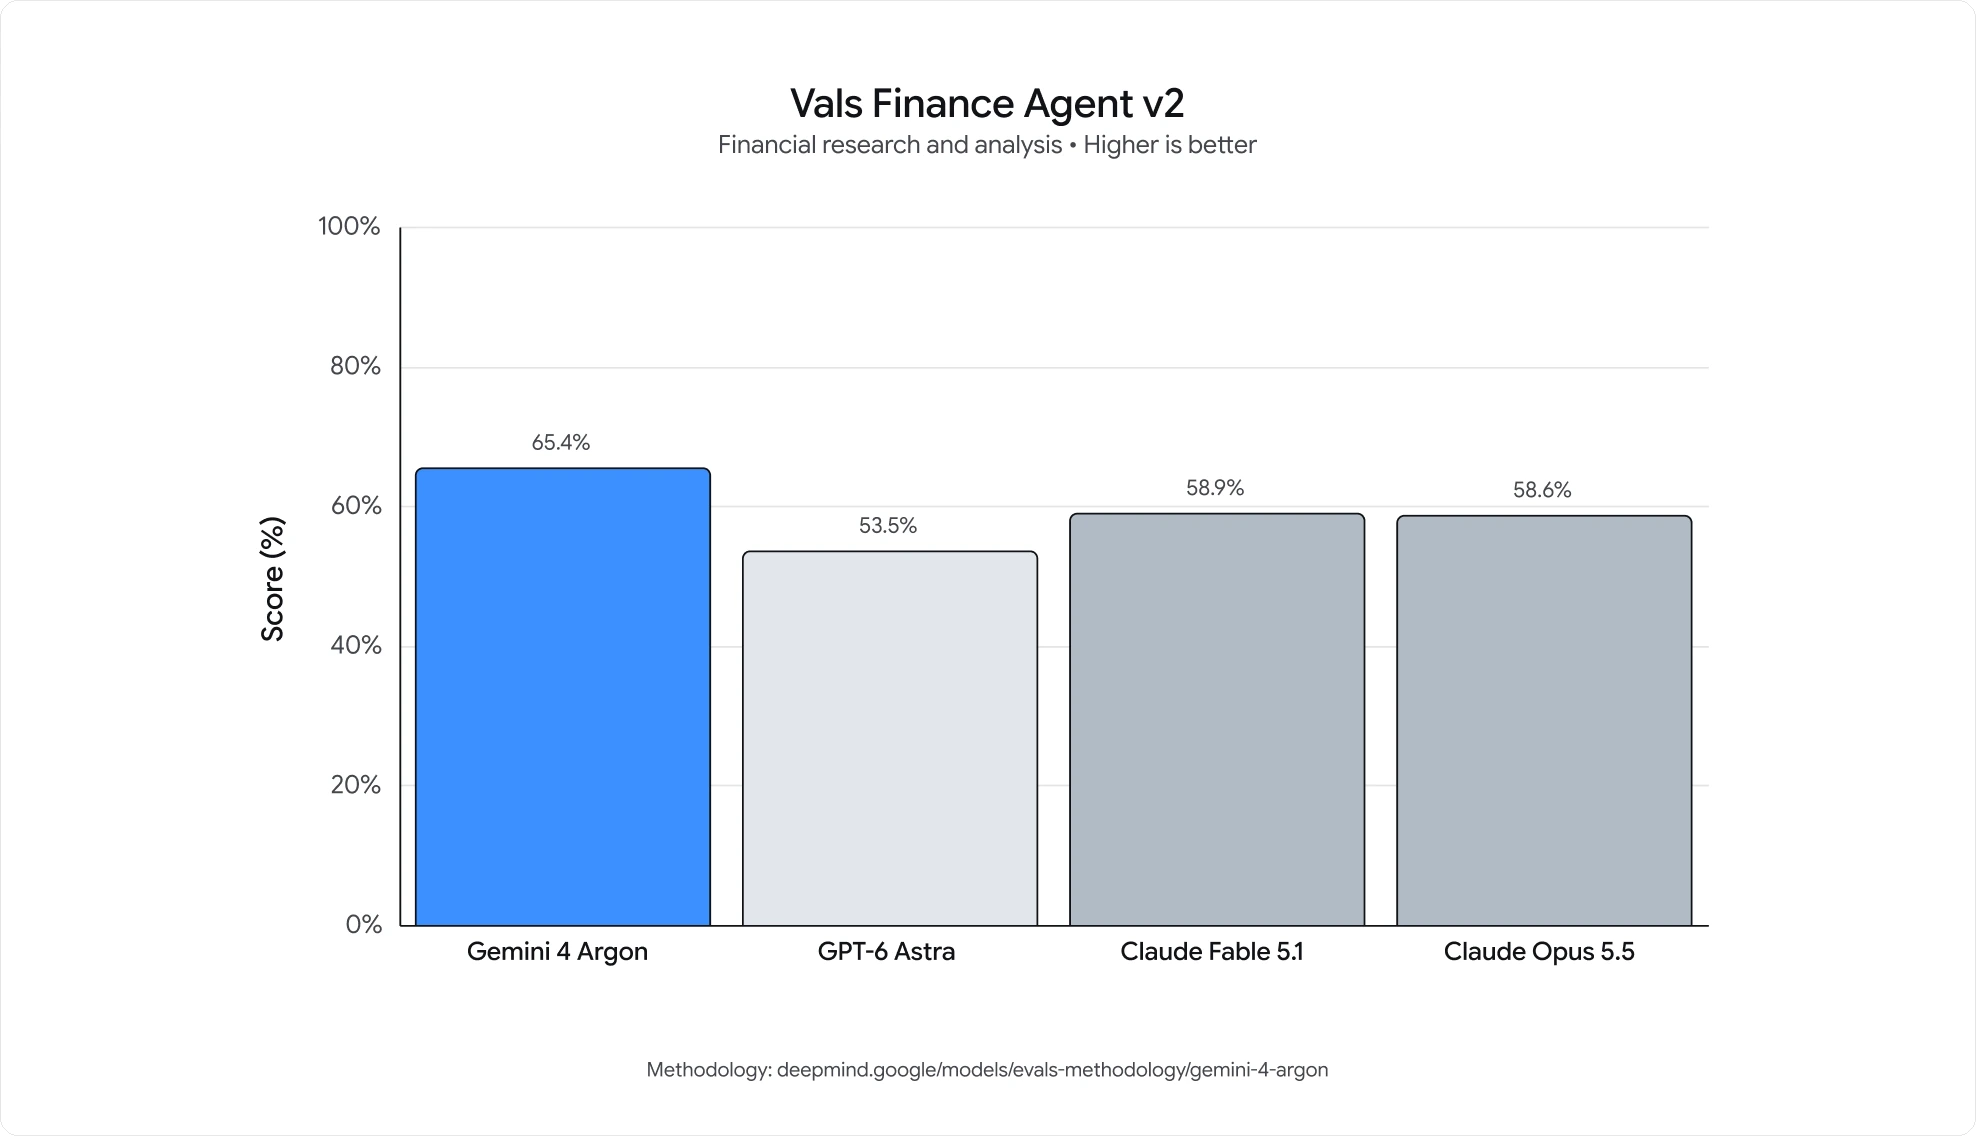
Gráfico de barras de Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6 %, Claude Fable 5.1 6.7 %, GPT-6 Astra 5.4 %, Claude Opus 5.5 3.8 %
Trabajo jurídico de horizonte largo. El 19.6 % de Argon triplica aproximadamente la puntuación del siguiente modelo, y es la ventaja más amplia del conjunto que publica Google.
Gráfico de barras de Vals Finance Agent v2: Gemini 4 Argon 65.4 %, Claude Fable 5.1 58.9 %, Claude Opus 5.5 58.6 %, GPT-6 Astra 53.5 %
Investigación y análisis financieros: 65.4 % frente a un grupo del 53.5 % al 58.9 %. Una ventaja más estrecha que en el trabajo jurídico, pero el mismo orden.

Cifras publicadas

Dónde se sitúa Argon en los benchmarks del propio Google

Son resultados reportados por el fabricante. Google no ha publicado un ajuste de razonamiento o effort para las puntuaciones destacadas, y ningún laboratorio independiente las ha replicado todavía.

Benchmark
Qué mide
Argon
Comparación más cercana
DeepSWE v1.1
Ingeniería de software de horizonte largo
77.9 %
Opus 5.5 con 74.2 %, GPT-6 Astra con 74.1 %
CWE-bench v1
Encontrar vulnerabilidades y parchearlas
68 %
Empata en el primer puesto
AutomationBench
Tareas de negocio de principio a fin, de Zapier
51.3 %
Clasificado en primer lugar
LVBench
Comprensión de vídeo largo
91.7 %
La puntuación más alta que Google reporta para Argon

Tómalas como orientativas. Los benchmarks de fabricante rara vez sobreviven sin cambios al contacto con cargas de trabajo reales, y Bloomberg ha informado de que algunos empleados de Google dudan de que la ventaja en benchmarks se traslade al trabajo real.
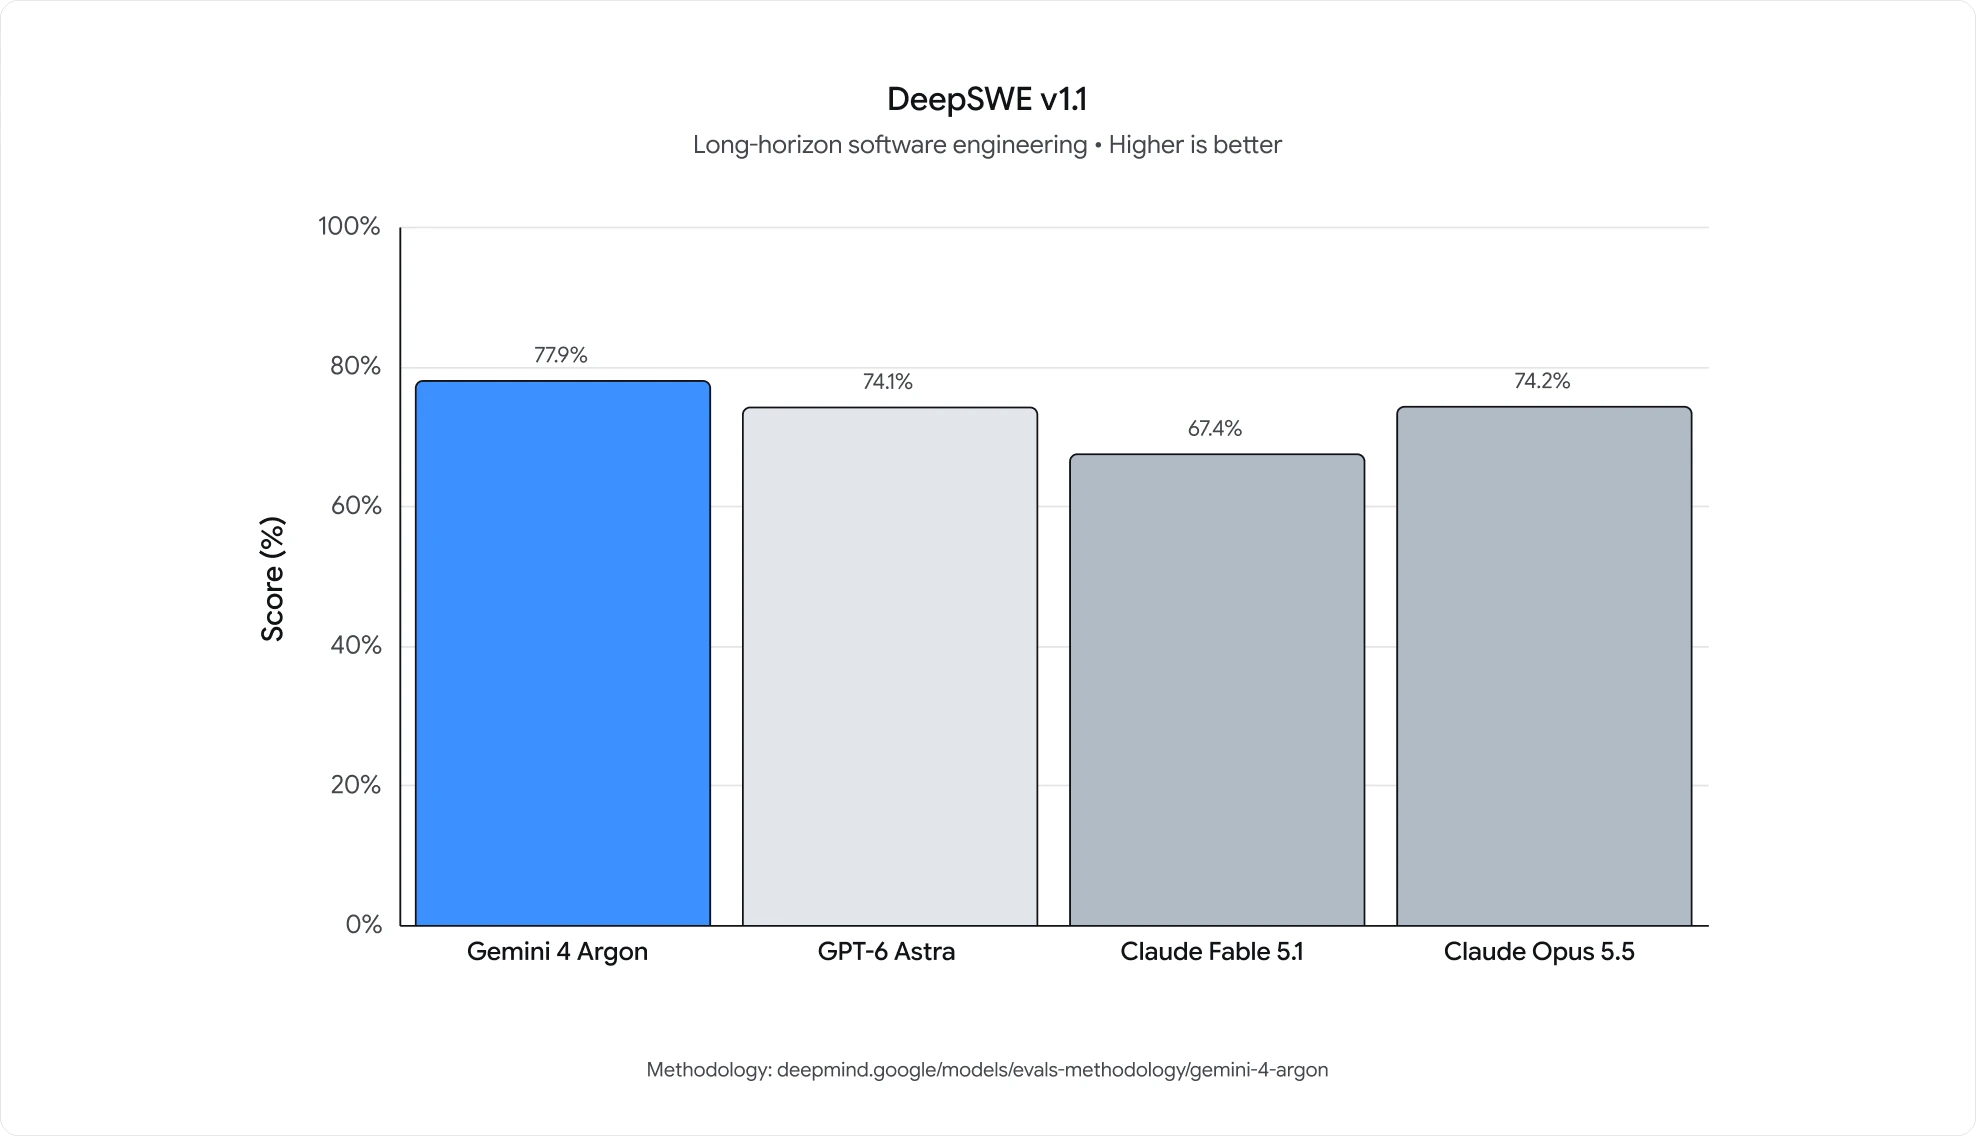
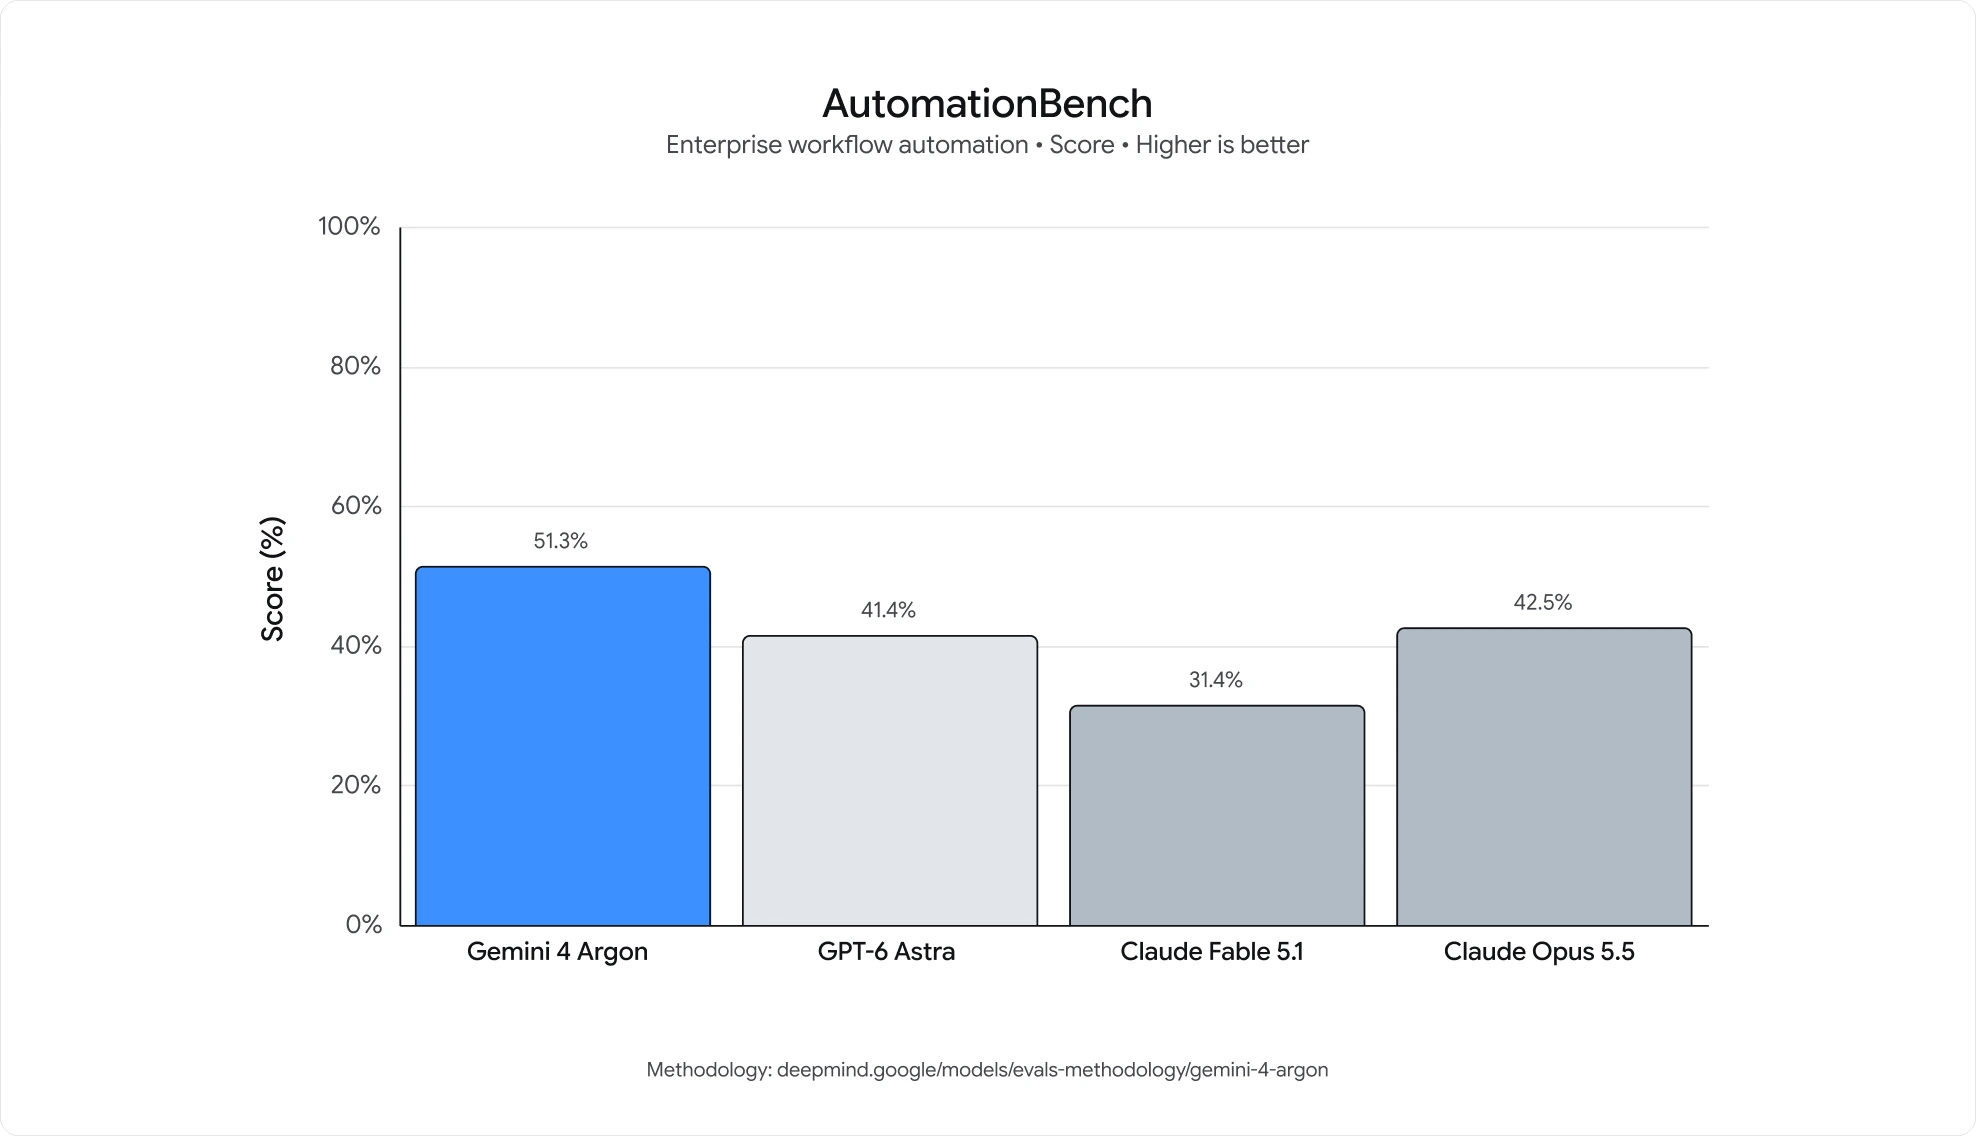
Gráfico de barras de DeepSWE v1.1: Gemini 4 Argon 77.9 %, Claude Opus 5.5 74.2 %, GPT-6 Astra 74.1 %, Claude Fable 5.1 67.4 %
Ingeniería de software de horizonte largo. La cifra destacada del 77.9 %, con sus dos competidores más cercanos a menos de cuatro puntos.
Gráfico de barras de AutomationBench: Gemini 4 Argon 51.3 %, Claude Opus 5.5 42.5 %, GPT-6 Astra 41.4 %, Claude Fable 5.1 31.4 %
Tareas de negocio de principio a fin, creadas por Zapier. Argon supera el 50 % mientras todos los demás modelos de la comparación se quedan en la treintena o en los cuarenta bajos.
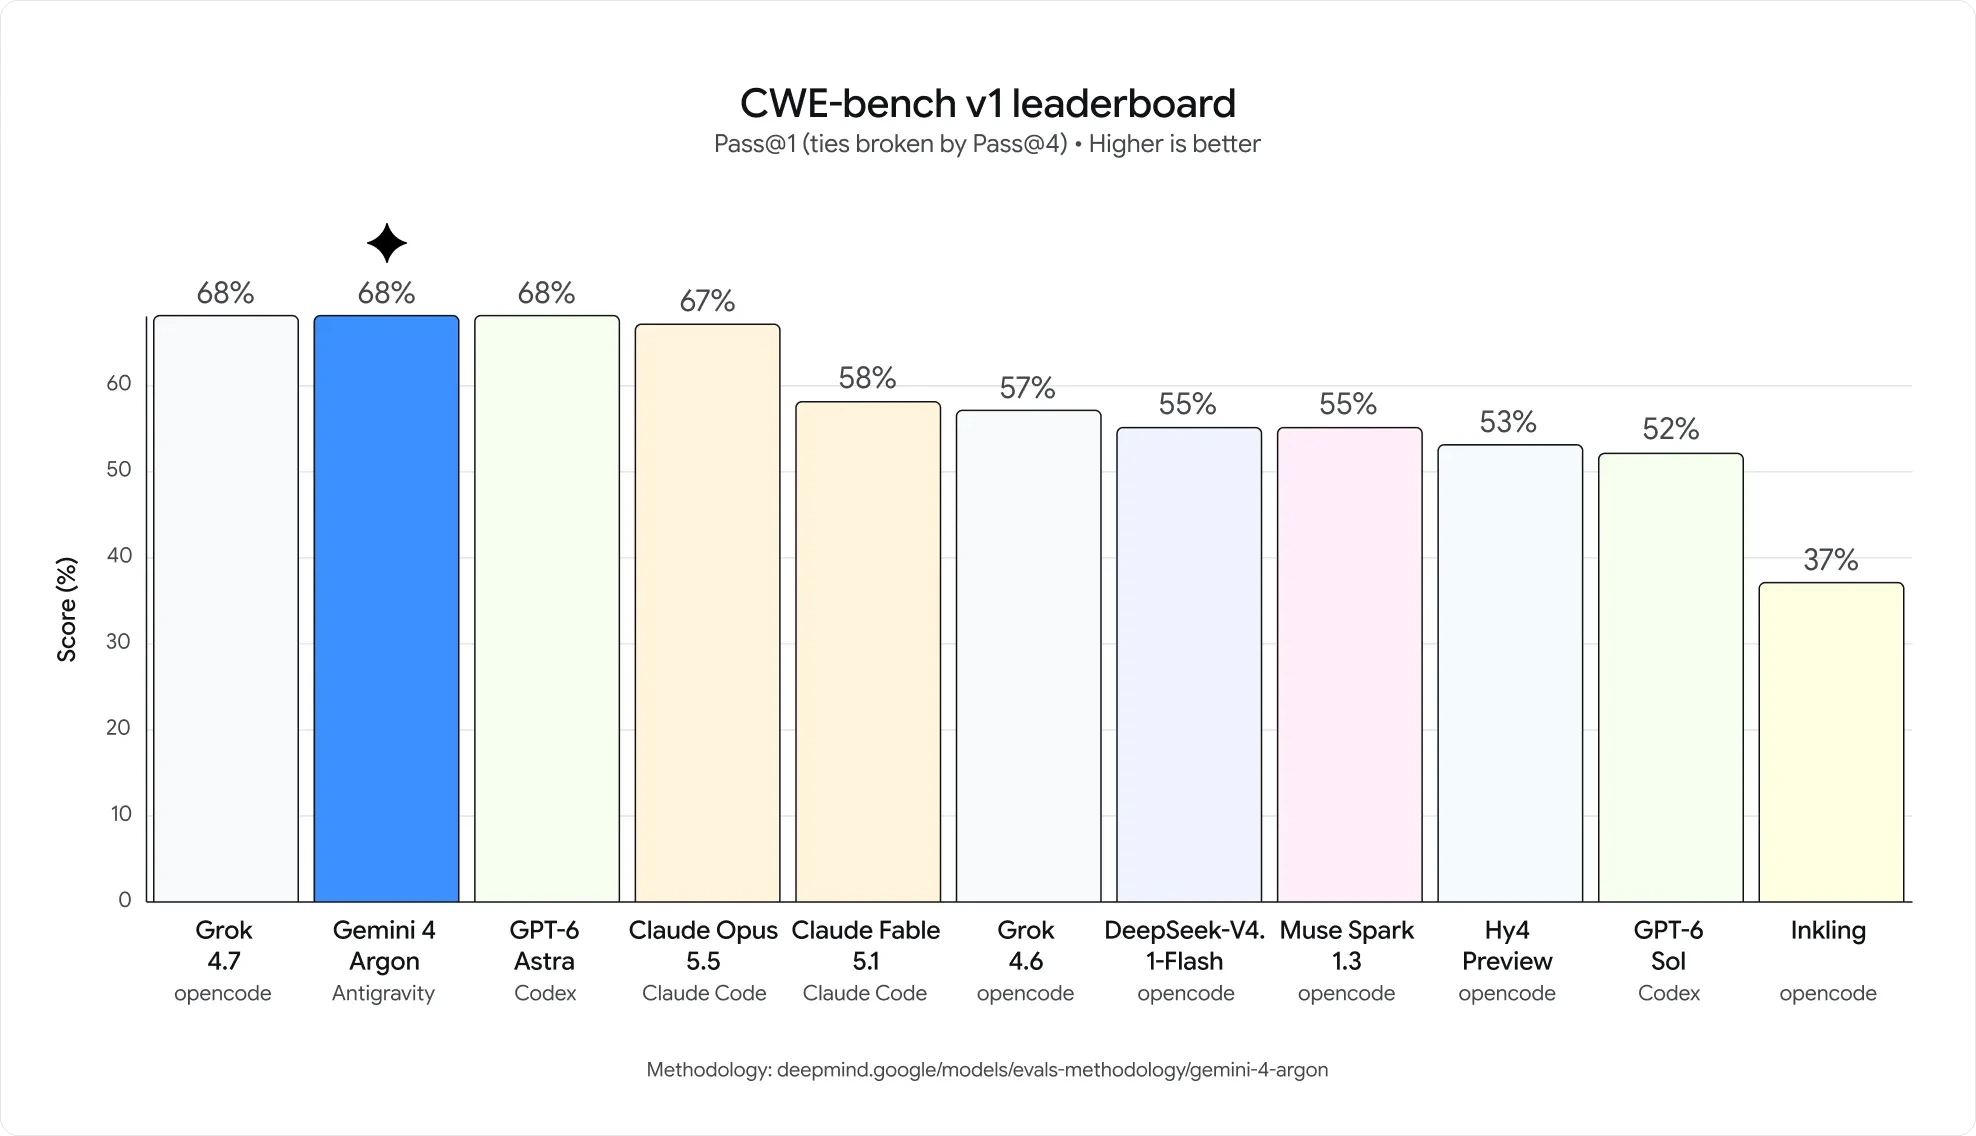
Clasificación de CWE-bench v1: Gemini 4 Argon, Grok y GPT-6 Astra empatan con 68 %, Claude Opus 5.5 con 67 %, bajando hasta Inkling con 37 %
Descubrimiento de vulnerabilidades en Pass@1. Argon empata en la cabeza de una tabla muy disputada en lugar de abrir brecha, y por eso la tabla de arriba habla de un empate en el primer puesto.
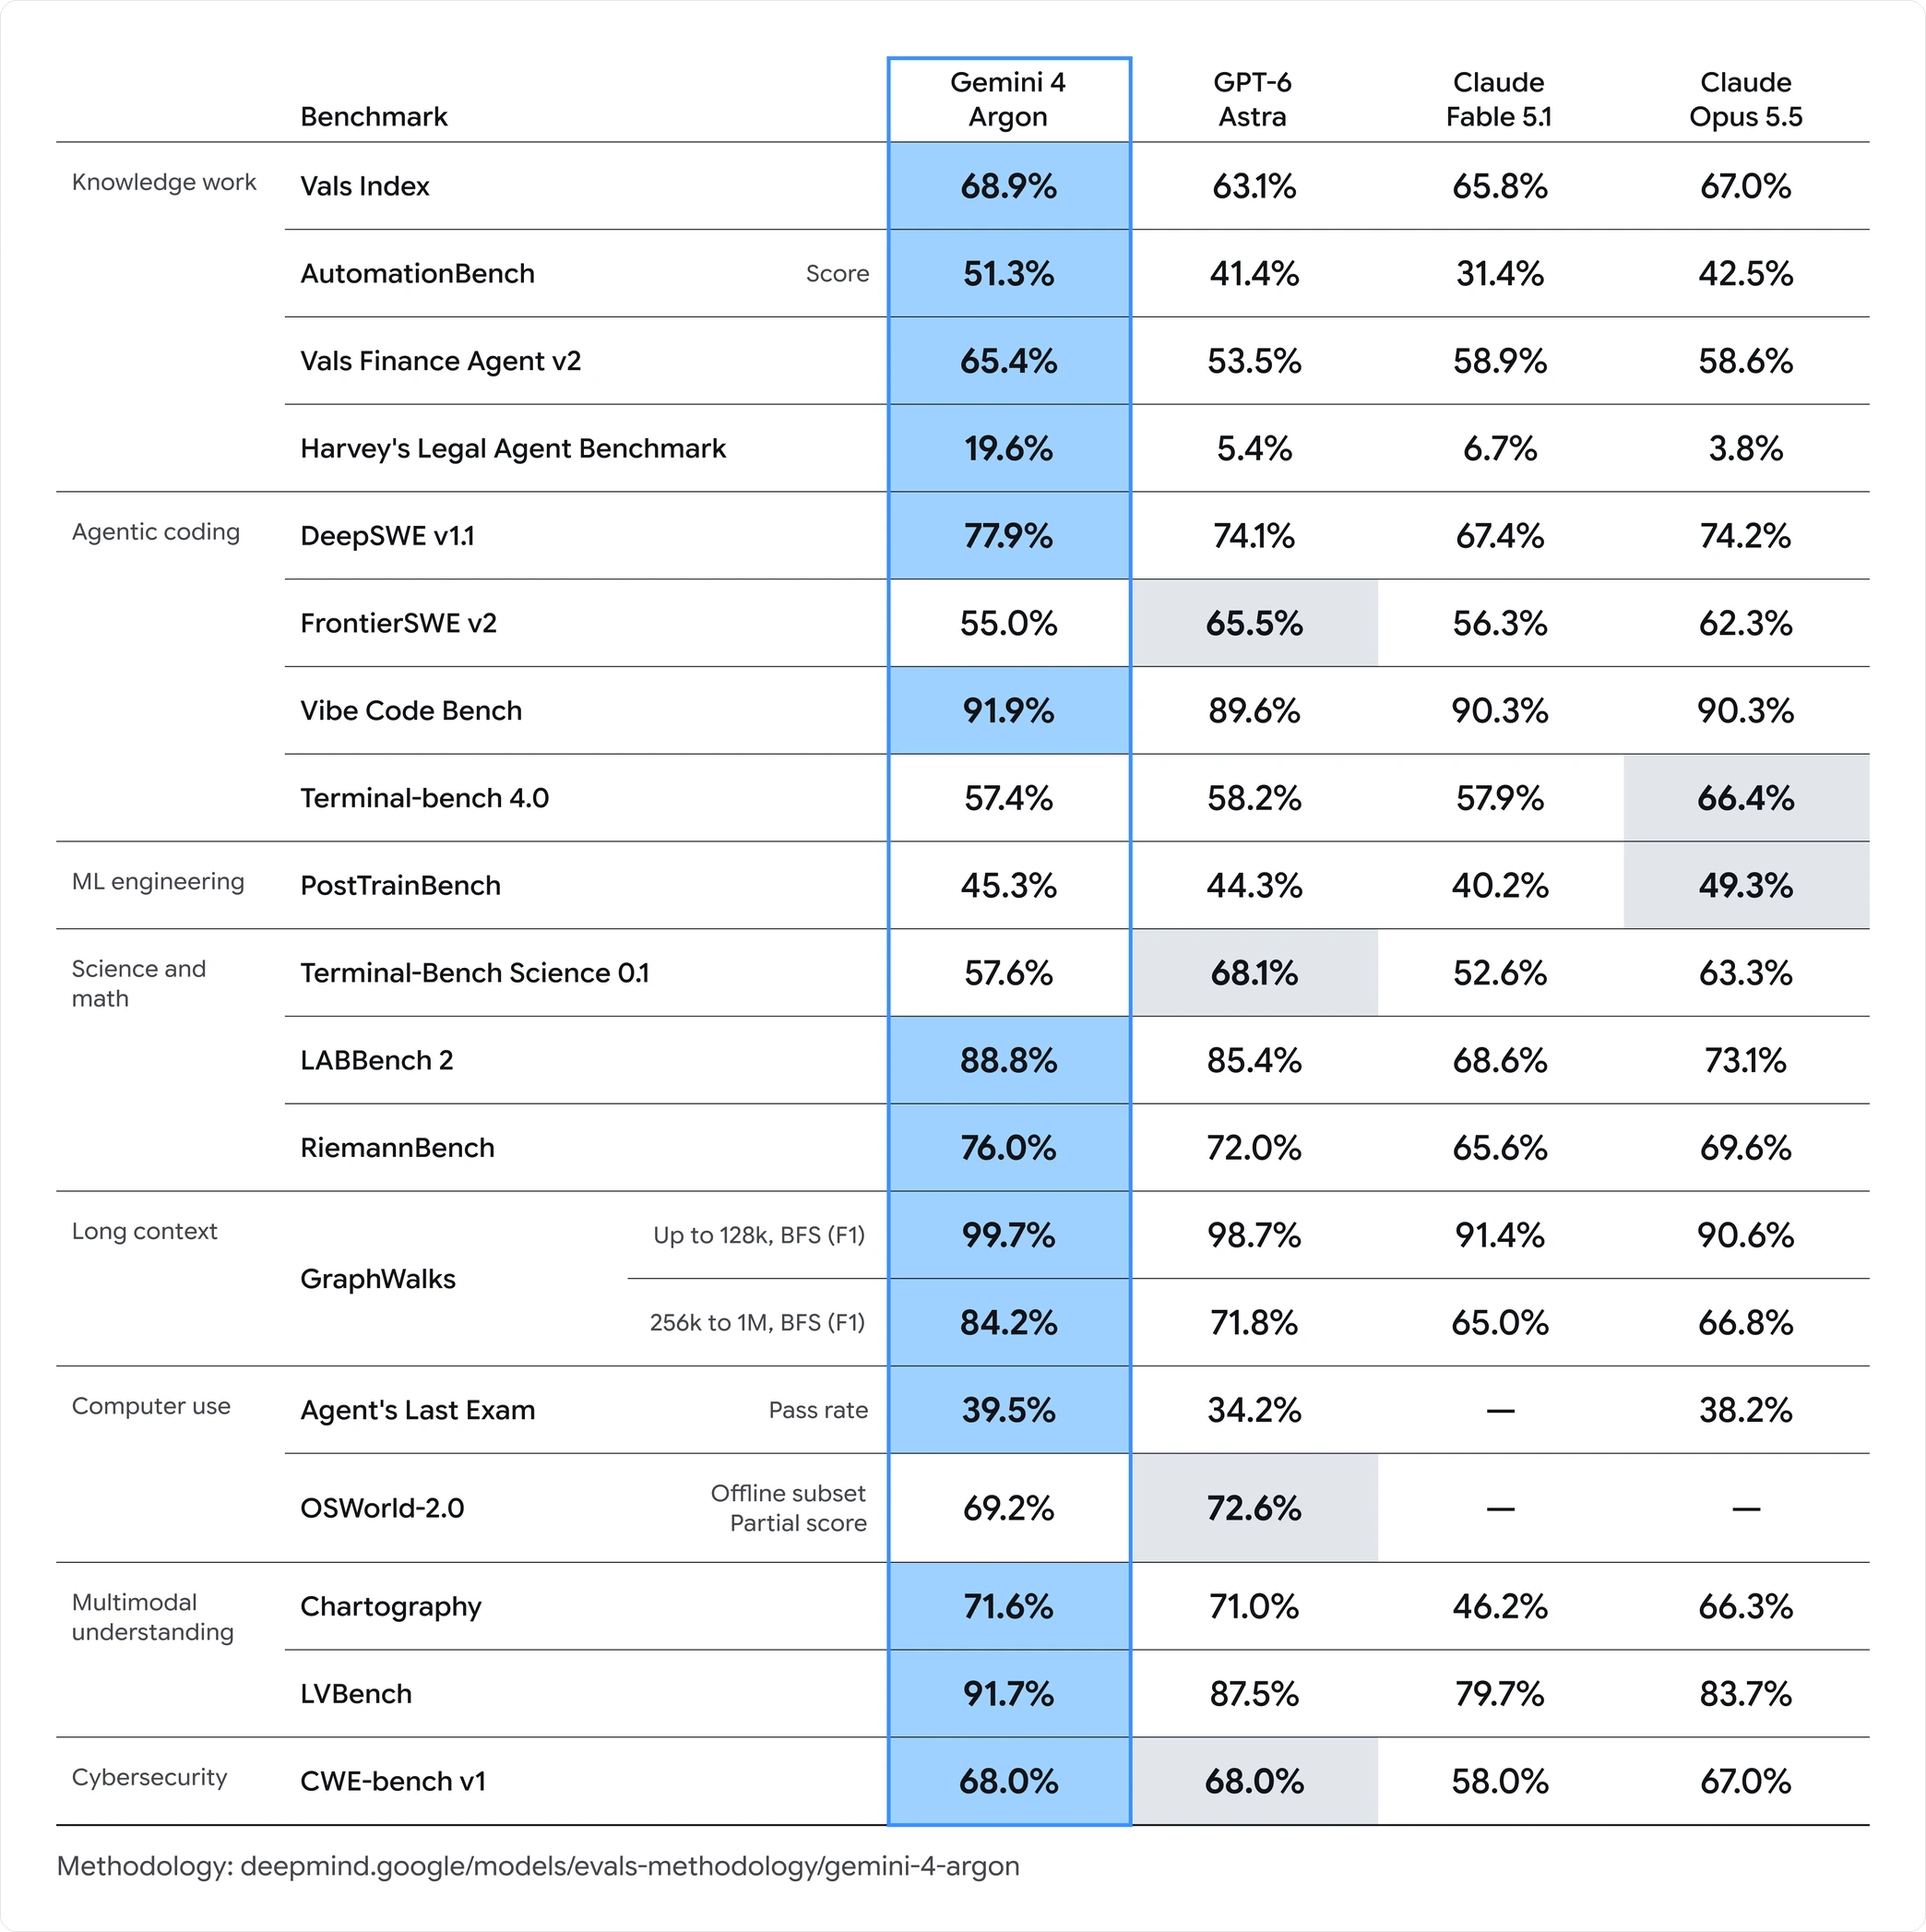
Tabla completa de resultados de Google para Gemini 4 Argon en 16 benchmarks, agrupada en trabajo de conocimiento, programación agéntica, ingeniería de ML, ciencia y matemáticas, contexto largo, uso del ordenador, comprensión multimodal y ciberseguridad
La tabla completa del anuncio, con las victorias de Argon en azul y las celdas donde lidera un competidor en gris. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 y OSWorld-2.0 son las filas en las que Argon no lidera.
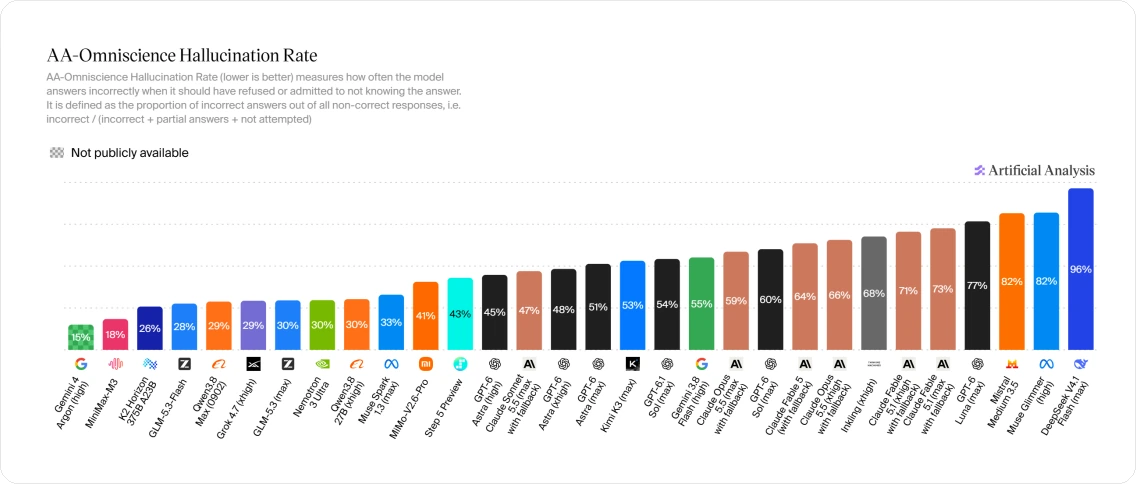
Gráfico de barras de la tasa de alucinación de AA-Omniscience de Artificial Analysis en 36 modelos, ordenados de menor a mayor: Gemini 4 Argon (High) con un 15 %, después MiniMax-M3 con un 18 %, Kimi K2.5 con un 26 %, y subiendo hasta DeepSeek-V4 Flash con un 96 %
La medición independiente de Artificial Analysis, y la única cifra de esta página que no aportó ningún proveedor: con qué frecuencia cada modelo responde de forma incorrecta en lugar de negarse a responder. El 15 % de Argon es el más bajo de los 36 modelos representados; la escala llega hasta el 96 %.
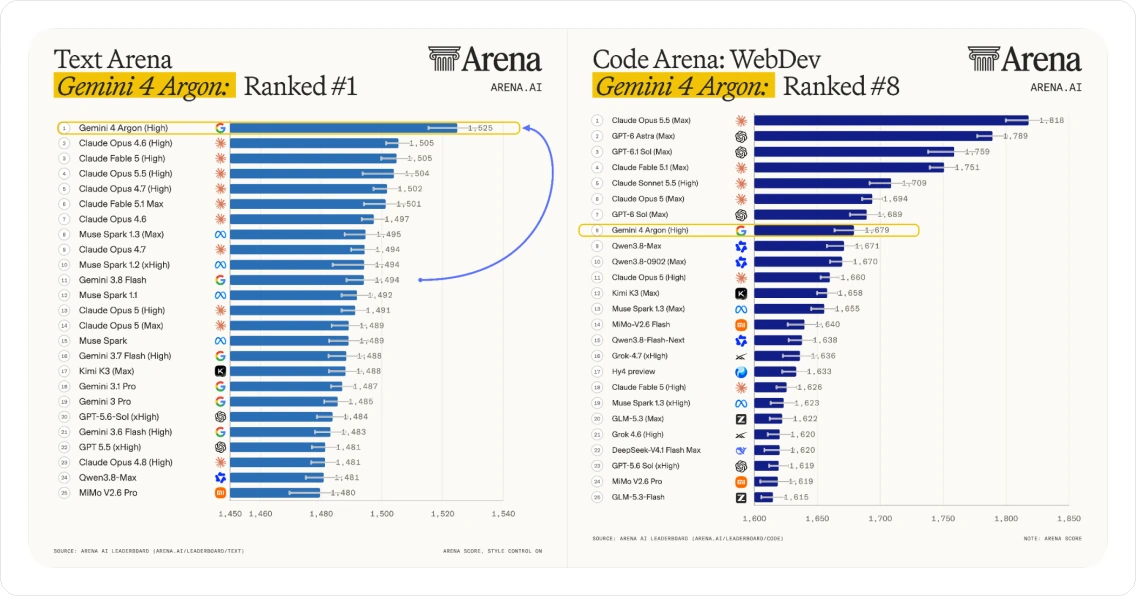
Las clasificaciones de Text Arena y Code Arena: WebDev de Arena.ai una junto a otra: Gemini 4 Argon en primer lugar de Text Arena con 1625, y octavo en Code Arena: WebDev con 1679
Las dos clasificaciones en las que se apoya el párrafo anterior, de las listas votadas por el público de Arena.ai. Argon encabeza los 25 modelos listados de Text Arena; en Code Arena: WebDev es octavo, por detrás de cuatro modelos Claude y tres de la línea GPT-6 de OpenAI.

En Felo

Cómo se ve un flujo de investigación con un redactor de 1M tokens

Felo combina búsqueda con comprensión de documentos, así que un modelo de salida larga cambia lo que puede producir una sola sesión.

Investigación que termina en un documento

Reúne las fuentes y pide al modelo que escriba la síntesis en una sola pasada, en vez de montarla sección a sección a lo largo de muchos prompts.

Conjuntos enteros de documentos en una tarea

La recuperación en contexto largo es la capacidad en la que Argon es más fuerte, y es lo que hace manejables los juegos de contratos, los registros y los informes largos.

Redactar donde el tono importa

El perfil que se reporta de Argon —texto fuerte, programación moderada— encaja con equipos que necesitan prosa que se lea como escrita y no como ensamblada.

Coste

Cuánto cuesta Argon y qué cambia después

Google ha publicado una tarifa introductoria y una tarifa de lista más alta, sin decir cuándo se produce el cambio. Haz tu presupuesto con la cifra alta.

Tipo de token
Introductoria
Posterior
Entrada
2,00 $ / M
4,00 $ / M
Entrada en caché
95 % de descuento
95 % de descuento
Salida
10,00 $ / M
20,00 $ / M

Como comparación, la tarifa introductoria queda más o menos al nivel de GPT-6.1 Sol y Sonnet 5.5, y cerca de un quinto de GPT-6 Astra. Son precios de lista, no coste medido por tarea: Argon responde preguntas más difíciles, así que una sola ejecución puede costar más.

Cómo trabajar con Argon en Felo

01

Trae la pregunta completa

Dale a Felo el conjunto de documentos o el hilo largo, no un resumen. La ventaja de Argon empieza donde el contexto deja de caber en un prompt.

02

Pide el artefacto terminado

Con un techo de salida de 1M tokens puedes pedir el informe completo o el borrador entero en una sola instrucción, en vez de por secciones.

03

Contrástalo con las fuentes

Felo mantiene las citas pegadas a la respuesta, que es lo que hace revisable un documento largo generado por el modelo.

El acceso a Argon en la búsqueda de Felo está en marcha. Hasta que se abra, todos los demás modelos de la gama de Felo están disponibles ya.

Abrir la búsqueda de Felo AI

Gemini 4 Argon: preguntas frecuentes

En general, no. Google lanzó Argon primero para socios seleccionados de su programa Fairwind, y dice que el acceso ampliado empezará con clientes de pago de la API y suscriptores de Google AI Ultra. No se ha anunciado fecha para esa fase, y una suscripción de pago no concede acceso hoy.

Prueba los modelos frontera de Google en Felo

Busca, lee y escribe con el modelo que encaje con la tarea. Argon se suma a la gama cuando su despliegue llegue a Felo.

Abrir la búsqueda de Felo AI

No hace falta tarjeta de crédito para usar la búsqueda de Felo AI.