GPT-6 LunaEl modelo de alto volumen de OpenAI a $0,10
GPT-6 Luna es el nivel más barato de la generación GPT-6 de OpenAI, publicado el 22 de septiembre de 2026 junto a GPT-6 Sol. OpenAI lo sitúa en trabajo de alto volumen con un objetivo definido: resumir, clasificar, extraer y enrutar. A $0,10 por millón de tokens de entrada cuesta una vigésima parte de GPT-6 Sol y la mitad del precio de entrada de GPT-5.6 Luna. Funciona en Felo AI Search y en la API de Felo.
En producción en la API de OpenAI como gpt-6-luna desde el 22 de septiembre de 2026, a $0,10 / $0,50 por millón de tokens: la mitad del precio de entrada de GPT-5.6 Luna.
Publicado el 22 de septiembre de 2026 · Ya disponible en Felo AI Search y en la API de Felo
Tarifas
GPT-6 Luna de un vistazo
- ID de modelo
- gpt-6-luna
- Publicado
- 22 de septiembre de 2026
- Entrada
- $0,10 por millón
- Entrada en caché
- $0,01 por millón
- Salida
- $0,50 por millón
- Ventana de contexto
- 1.050.000 tokens
$0,10 / $0,50
Precio de entrada
Por millón de tokens, tarifa estándar.
$0,01
Entrada en caché
Una décima parte de la tarifa de entrada, por millón de tokens.
1,05M
Ventana de contexto
922.000 de entrada y 128.000 de salida como máximo.
gpt-6-luna
ID de modelo de la API
La cadena que se envía en el campo model.
Lo que cuesta un millón de tokens
El argumento de Luna es aritmética, no adjetivos. Estas son las cuatro tarifas publicadas por OpenAI y lo que suman en una carga de trabajo que lee mucho más de lo que escribe.
Las cuatro tarifas
Tarifas estándar por millón de tokens, tal como se publican.
- Entrada
- $0,10
- Entrada en caché
- $0,01
- Escritura en caché
- $0,125
- Salida
- $0,50
La entrada en caché se factura a una décima parte de la tarifa de entrada. Una escritura en caché cuesta 1,25 veces una lectura sin caché, y de ahí sale la cuenta de amortización que aparece más abajo.
Coste en una carga mixta
La mayoría de los prompts leen mucho más de lo que escriben, así que la tarifa de entrada anunciada exagera lo que cuesta una carga. Esta columna supone 20 tokens de entrada por cada token de salida.
Modelo
Por 1 M mixto
frente a Luna
GPT-6 Luna
$0,12
1x
GPT-5.6 Luna
$0,25
2,1x
GPT-6 Sol
$2,38
20x
GPT-6 Astra
$11,90
100x
Calculado aquí a partir de las tarifas publicadas de cada modelo con una proporción de entrada a salida de 20:1; ningún proveedor publica esta columna. Otra proporción mueve todas las cifras: con 1:1 la tarifa mixta de Luna es de $0,30 por millón, y con 100:1 ronda los $0,10.
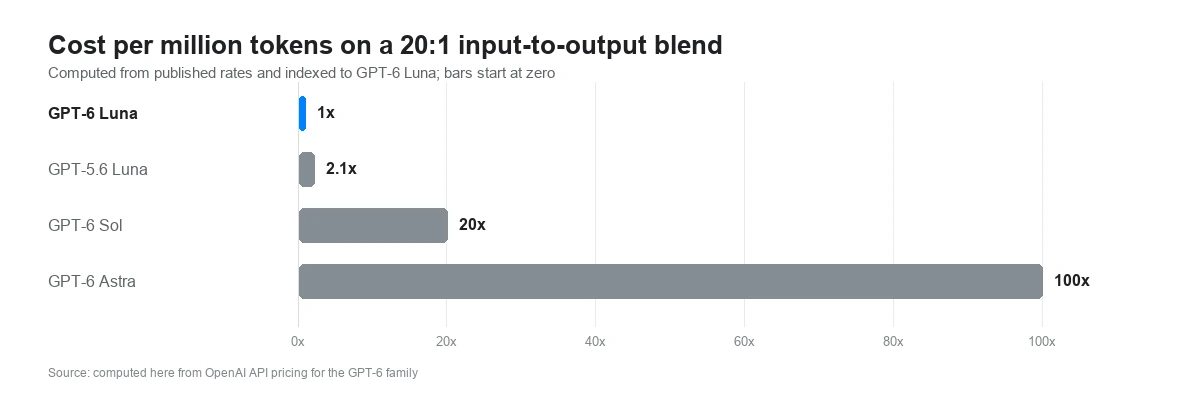
Coste por millón de tokens con una mezcla 20:1, en relación con GPT-6 Luna
Cada barra es lo que cuesta un millón de tokens mixtos dividido por la cifra de Luna. GPT-5.6 Luna es 2,1 veces Luna, GPT-6 Sol es 20 veces y GPT-6 Astra es 100 veces. Calculado a partir de las tarifas publicadas por OpenAI; las barras empiezan en cero.
Fuente: calculado a partir de los precios de la API de OpenAI para la familia GPT-6, septiembre de 2026
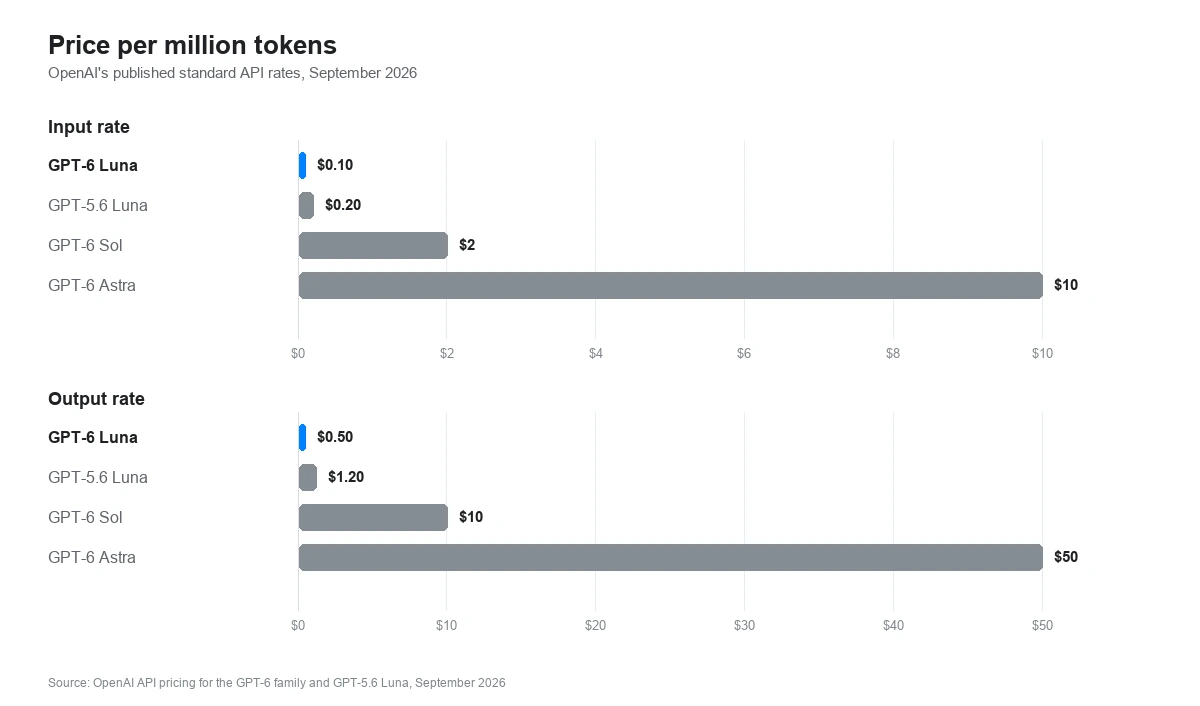
Precio por millón de tokens, familia GPT-6 y GPT-5.6 Luna
Tarifas de entrada y salida por millón de tokens. GPT-6 Luna está a $0,10 de entrada y $0,50 de salida; GPT-5.6 Luna a $0,20 y $1,20; GPT-6 Sol a $2 y $10; GPT-6 Astra a $10 y $50. Las barras empiezan en cero.
Fuente: precios de la API de OpenAI, septiembre de 2026
El salto de precio a 272.000 tokens
Una petición por encima de 272.000 tokens de entrada se factura a tarifas de contexto largo por la petición completa, no solo por los tokens que pasan la línea. Ese umbral cae en el 26 % de la ventana anunciada de Luna.
Tarifa
Estándar
Por encima de 272.000
Cambio
Entrada
$0,10
$0,20
2x
Entrada en caché
$0,01
$0,02
2x
Salida
$0,50
$0,75
1,5x
Por qué es un salto y no una pendiente
Con 272.000 tokens de entrada, una petición factura $0,0272. Un solo token más y la petición entera se vuelve a tarifar: 272.001 tokens a $0,20 por millón son $0,0544, así que un token extra añade $0,0272 a la factura. Esos mismos 272.000 tokens repartidos en dos llamadas que se quedan cada una por debajo del umbral cuestan $0,0272.
Qué hacer al respecto
Si la entrada de una sola petición se queda por debajo de 272.000 tokens, se aplica la tarifa estándar. Una recuperación que devuelve 200.000 tokens, o una pasada de troceado que parte un documento largo, se queda dentro del nivel barato; una llamada que carga la ventana entera, no. El nivel barato cubre aproximadamente el primer cuarto del contexto anunciado.
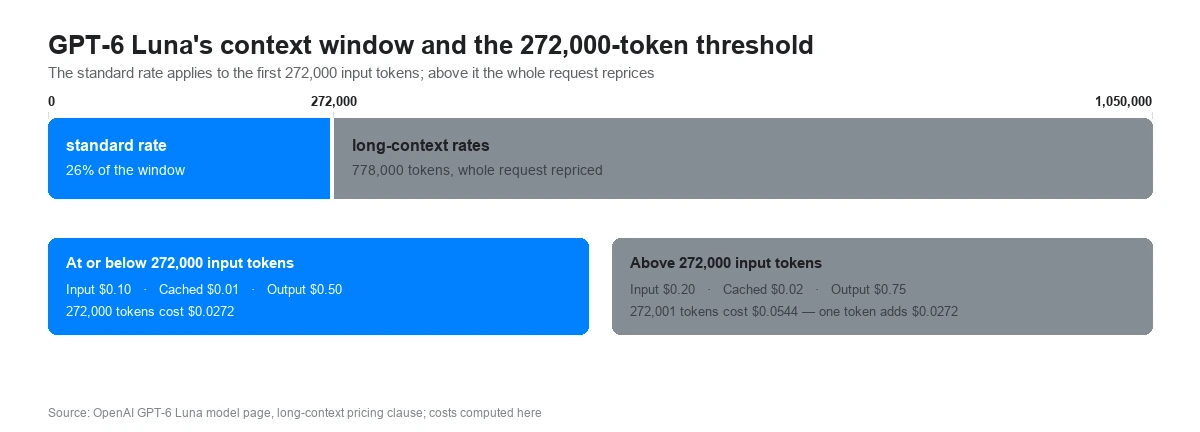
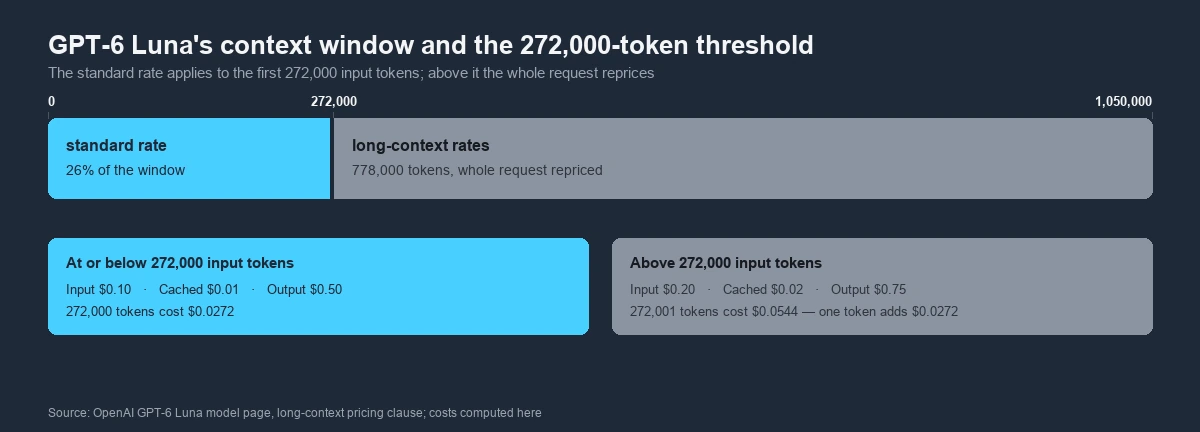
Dónde termina la tarifa estándar en la ventana de contexto de GPT-6 Luna
La ventana es de 1.050.000 tokens. La tarifa estándar se aplica hasta 272.000 tokens de entrada, alrededor del 26 % de ella; todo lo que supera esa cifra se factura a 2x en entrada y 1,5x en salida, y la petición entera se vuelve a tarifar en cuanto se cruza la línea.
Fuente: página del modelo GPT-6 Luna de OpenAI, cláusula de precios de contexto largo, septiembre de 2026
Cuándo se paga sola la caché
La caché es una apuesta: se paga 1,25 veces la tarifa de entrada una vez para escribir un prefijo y después una décima parte de esa tarifa en cada lectura. Con las tarifas de Luna la apuesta se gana en la segunda llamada.
Una escritura cuesta un cuarto más
La primera petición que escribe un prefijo se factura a $0,125 por millón de tokens en lugar de $0,10, un 25 % más que enviar el mismo texto sin caché.
Una lectura cuesta una décima parte
Cada petición posterior que acierta en la caché se factura a $0,01 por millón y ahorra $0,09 frente a la tarifa sin caché cada vez.
El punto de equilibrio llega en la segunda llamada
Una escritura más una lectura son $0,135 por millón, frente a $0,20 por dos peticiones sin caché. Para la centésima repetición, la ruta con caché cuesta alrededor del 11 % de enviar el mismo prefijo desde cero.
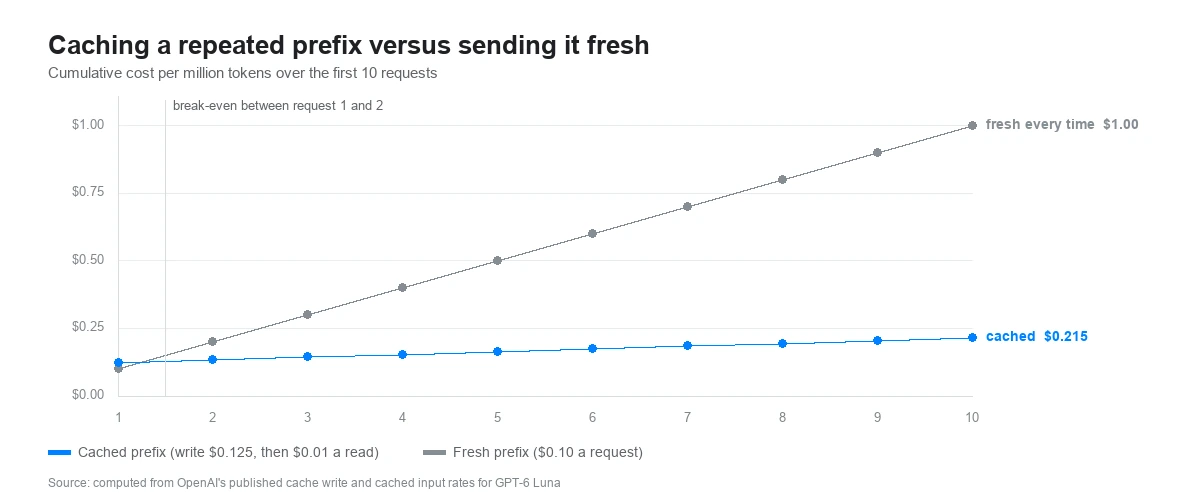
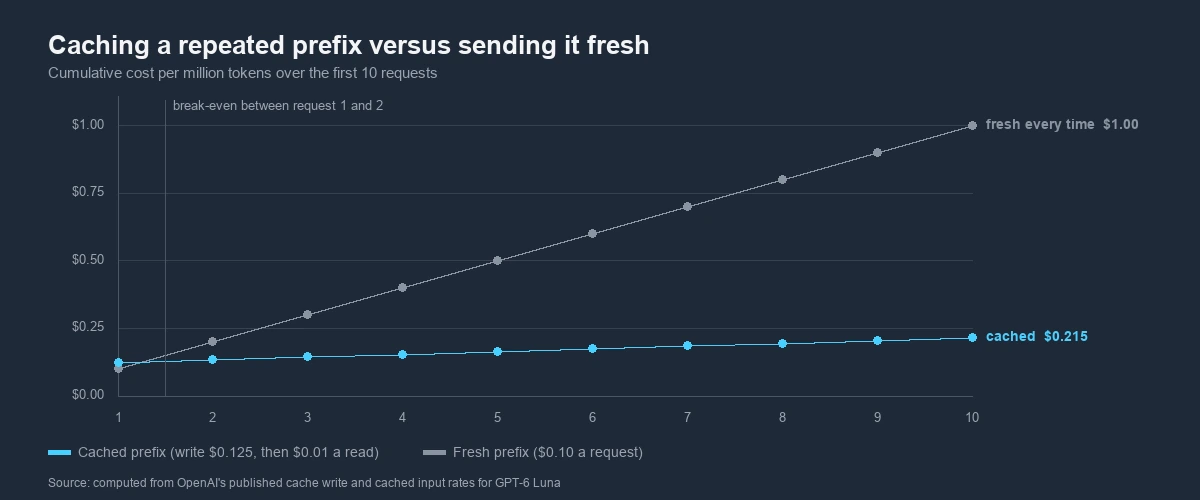
Coste acumulado de repetir el mismo prefijo, con y sin caché
Coste por millón de tokens de un prefijo repetido a lo largo de 100 peticiones. Enviarlo desde cero cada vez cuesta $10,00; guardarlo en caché cuesta $1,115. Las dos líneas se cruzan entre la primera y la segunda petición.
Fuente: calculado a partir de las tarifas publicadas por OpenAI para la escritura en caché y la entrada en caché de GPT-6 Luna, septiembre de 2026
La otra palanca de la factura
Luna admite la escala completa de esfuerzo de razonamiento de OpenAI, de seis niveles, y el ajuste decide cuántos tokens de razonamiento gasta una llamada. medium es el valor por defecto.
none
llamada a funciones
low
medium
por defecto
high
xhigh
max
Seis ajustes, un valor por defecto
Luna acepta none, low, medium, high, xhigh y max. Los tokens de razonamiento se facturan como salida, así que el ajuste es un mando de coste tanto como de calidad: cuanto mayor es el esfuerzo, más gasta el modelo antes de responder.
Las llamadas a herramientas necesitan none en Chat Completions
En la API Chat Completions, una petición con llamada a herramientas solo se atiende cuando el esfuerzo de razonamiento es none. Para las herramientas integradas y la llamada a funciones, OpenAI remite a la API Responses, donde la escala de esfuerzo está disponible junto a las herramientas. Merece la pena comprobar qué punto de conexión usa una integración antes de mover el mando.
Dónde encaja Luna en la familia GPT-6
Tres niveles, una tarea cada uno. una vigésima parte de la tarifa de Sol es lo que vuelve fácil la decisión de enrutamiento.
Modelo
Entrada
Salida
Qué enrutar aquí
GPT-6 Luna
$0,10
$0,50
Trabajo de alto volumen y bien definido: resumir, extraer, clasificar, enrutar y preguntas directas.
GPT-6 Sol
$2
$10
Trabajo complejo recurrente: escribir y revisar código, depurar y analizar datos.
GPT-6 Astra
$10
$50
El razonamiento puntual más difícil, el uso del ordenador y el trabajo científico o matemático.
Lo que OpenAI afirma y lo que midió
OpenAI hace dos tipos de afirmaciones sobre Luna: lo que hace por el dinero que cuesta y lo que ha dejado de hacer. Ambas son cifras del proveedor, y ambas están señaladas como tales.
Trabajo realizado por dólar
La afirmación principal de OpenAI sobre Luna está normalizada por coste y no es una puntuación bruta: con esfuerzo máximo supera a GPT-5.6 Sol con esfuerzo medio a cerca de una décima parte del coste por tarea. La cobertura del lanzamiento también informa de un 66,6 % en DeepSWE v1.1, 5,4 puntos por encima de GPT-5.6 Luna con esfuerzo alto y con un 58 % menos de coste por tarea. Luna tiene cifras publicadas en muchos menos benchmarks que Sol, así que esta página recoge las afirmaciones en lugar de una tabla de benchmarks.
Afirmaciones engañosas sobre el trabajo de código
OpenAI informa de que Luna traslada el trabajo de alineación de Astra al nivel barato, incluidos índices más bajos de afirmaciones engañosas sobre su propio trabajo de código. La cifra en la que coinciden varios análisis independientes es la tasa de engaño en código: 2,8 %, frente al 9,5 % de GPT-5.6 Luna.
Evaluación
GPT-5.6 Luna
GPT-6 Luna
Tasa de engaño en código (más baja es mejor)
9,5 %
2,8 %
Evaluaciones de alineación del propio OpenAI, ejecutadas sobre escenarios deliberadamente difíciles y en su mayoría de bajo riesgo, sin salvaguardas de producción. OpenAI declara que no miden tasas de fallo en el uso ordinario, así que no es una tasa de producción. Una segunda cifra del lanzamiento que los medios recogieron de forma contradictoria se deja fuera de esta página en lugar de promediarse.
Qué ejecutar en Luna
Las tareas para las que OpenAI construyó este nivel, donde el coste por llamada fija el techo de lo que merece la pena construir.
Resumir en volumen
Documentos, hilos y transcripciones comprimidos en un párrafo, donde el precio por token decide si la tarea llega a ejecutarse.
Extracción
Sacar campos estructurados de texto no estructurado —facturas, anuncios, formularios— hacia una forma que una canalización pueda consumir.
Clasificación y etiquetado
Ordenar tickets, etiquetar contenido y aplicar categorías a todo un corpus, una llamada barata cada vez.
Enrutamiento
Decidir qué es una petición y adónde debe ir, una decisión pequeña que no debería costar una llamada de un modelo insignia.
Preguntas rápidas
Las consultas factuales cortas que un producto responde en línea, donde la latencia y el precio importan más que la profundidad.
Trabajo Batch y Flex
OpenAI factura Batch y Flex a la mitad de la tarifa estándar, lo que deja la entrada de Luna en $0,05 por millón para todo lo que pueda esperar.
Dónde funciona GPT-6 Luna
Luna salió en todas las superficies de OpenAI menos en el chat principal, además de en las plataformas que lo listaron el mismo día. En Felo funciona con el ID de modelo gpt-6-luna.
Felo AI Search
En producción como gpt-6-luna, junto al resto de la familia GPT-6.
API de OpenAI
Chat Completions, Responses y Batch, como gpt-6-luna.
ChatGPT Work y Codex
Plus, Pro, Business, Enterprise y Edu, con activación por el administrador en Enterprise.
Free y Go
Accesible en la aplicación de escritorio, no en el chat del navegador.
GitHub Copilot
Planes Pro, Pro+, Max, Business y Enterprise.
Amazon Bedrock y OpenRouter
Ambos listaron Luna el 22 de septiembre de 2026, el día de su lanzamiento.
Lo que Luna no admite
Conviene comprobarlo antes de construir sobre él. La página del modelo de OpenAI incluye estos elementos como no admitidos en GPT-6 Luna.
- API Realtime y Live
- API Assistants
- Ajuste fino
- Embeddings
- Generación y edición de imágenes
- Audio, vídeo y moderación
Especificaciones
Lo que OpenAI ha publicado sobre GPT-6 Luna.
Precios
GPT-6 Luna: $0,10 / $0,50 por millón de tokens, con la entrada en caché a $0,01 y las escrituras en caché a $0,125.
Tarifas estándar. Batch y Flex se facturan a mitad de precio, el Fast mode al doble, y las peticiones por encima de 272.000 tokens de entrada pagan 2x en entrada y 1,5x en salida por la petición completa.
Ventana de contexto
1.050.000 tokens, con un máximo de 922.000 de entrada y 128.000 de salida.
La misma ventana que GPT-6 Sol y GPT-6 Astra, pero la tarifa estándar solo cubre los primeros 272.000 tokens de entrada.
Fecha de corte de conocimientos
18 de mayo de 2026, la fecha de corte más reciente de los tres modelos GPT-6.
Modalidades
Texto e imágenes de entrada, texto de salida.
Esfuerzo de razonamiento
none, low, medium, high, xhigh y max, con medium como valor por defecto. La llamada a funciones en Chat Completions exige none.
Precios de Batch y regionales
Batch y Flex se facturan al 50 % del estándar. El procesamiento regional añade un 10 %, y la residencia de datos en la UE exige procesamiento Standard.
Preguntas frecuentes
GPT-6 Luna es el modelo GPT-6 más barato de OpenAI, publicado el 22 de septiembre de 2026 junto a GPT-6 Sol y situado por debajo de Sol y del buque insignia Astra. OpenAI lo describe como su modelo más eficiente, construido para tareas de alto volumen con un objetivo claro: resumir documentos, extraer información, clasificar y responder a preguntas directas. Cuesta $0,10 por millón de tokens de entrada y $0,50 por millón de salida.
Probar GPT-6 Luna en Felo
El modelo GPT-6 más barato de OpenAI: $0,10 de entrada y $0,50 de salida por millón de tokens, una lectura en caché a $0,01 y una ventana de 1.050.000 tokens.
Disponible en Felo AI Search y en la API de Felo