Zapowiedziano 30 września 2026 · wdrażanie etapami

Gemini 4 ArgonDługie badania spisane w całości

Pierwszy flagowy model Google od czasów Gemini 3, stworzony do głębokiego rozumowania w długiej, wieloetapowej pracy. Podnosi limit wyjścia z 64K do 1M tokenów i prowadzi w publikowanych przez Google wynikach pracy z wiedzą, a nie w kodowaniu.

Felo API jest w zamkniętej becie — dostęp do Gemini 4 Argon pojawi się wkrótce.
Grafika główna Gemini 4 Argon: nazwa modelu obok dużej cyfry 4 na niebieskim gradiencie
Grafika z zapowiedzi Google. Argon trafia na rynek w nowym schemacie nazewnictwa, a nie jako aktualizacja linii Gemini 4.0 — dlatego nazwa nie zawiera numeru wersji.
1M
Maks. tokenów wyjścia
Wcześniej 64K — pełny raport wygenerowany w jednym przebiegu.
2 $ / 10 $
Wprowadzająca cena API
Za milion tokenów wejściowych i wyjściowych. Wejście z pamięci podręcznej jest o 95% tańsze.
77.9%
DeepSWE v1.1
Wynik podany przez Google, wyżej niż Claude Opus 5.5 i GPT-6 Astra.
15%
Wskaźnik halucynacji
Najniższy zmierzony wśród modeli flagowych według Artificial Analysis.

Liczby i wykresy na tej stronie pochodzą od organizacji, które je opublikowały — Google, Arena.ai i Artificial Analysis — i są przytaczane bez zmian.

Status wdrożenia

Argon nie jest jeszcze ogólnie dostępny. Oto kolejność.

Google wydaje Argon etapami, a pierwszy etap nie jest publiczny. Dostęp w Felo powstaje równolegle z tym wdrożeniem.

Dostępny teraz

Zaufani obrońcy cyberprzestrzeni

Wybrani partnerzy programu Google Fairwind dostają Argon jako pierwsi i bez zabezpieczeń z zakresu cyberbezpieczeństwa.

Zapowiedziany jako następny

Płatni klienci API i Google AI Ultra

Według Google tu zaczyna się szerszy dostęp. Daty nie podano, a sama subskrypcja dziś go nie daje.

Termin nieustalony

Programiści, firmy i użytkownicy indywidualni

Przychodzi po płatnych poziomach. Google nie zobowiązało się do terminu ogólnej dostępności.

Dostęp do Argon w wyszukiwaniu Felo jest w przygotowaniu. Strona zostanie zaktualizowana, gdy się otworzy.

W czym jest dobry

Model stworzony, by kończyć długą pracę, a nie szybko odpowiadać

Publikowane mocne strony Argon skupiają się wokół czytania, rozumowania i pisania na długich dystansach. To inny kształt niż zorientowane na kod modele flagowe, z którymi się go porównuje.

Rozumowanie, które wytrzymuje długie zadanie

Google pozycjonuje Argon do wieloetapowej pracy trwającej godzinami, tam gdzie wcześniejsze modele zbaczają z kursu albo kończą za wcześnie.

1M tokenów wyjścia w jednym przebiegu

Tak Google uzasadnia wzrost: model z przestrzenią na długie myślenie rozwiązuje trudny problem w jednym przebiegu, a nie w wielu turach.

Prowadzi praca z wiedzą, nie kodowanie

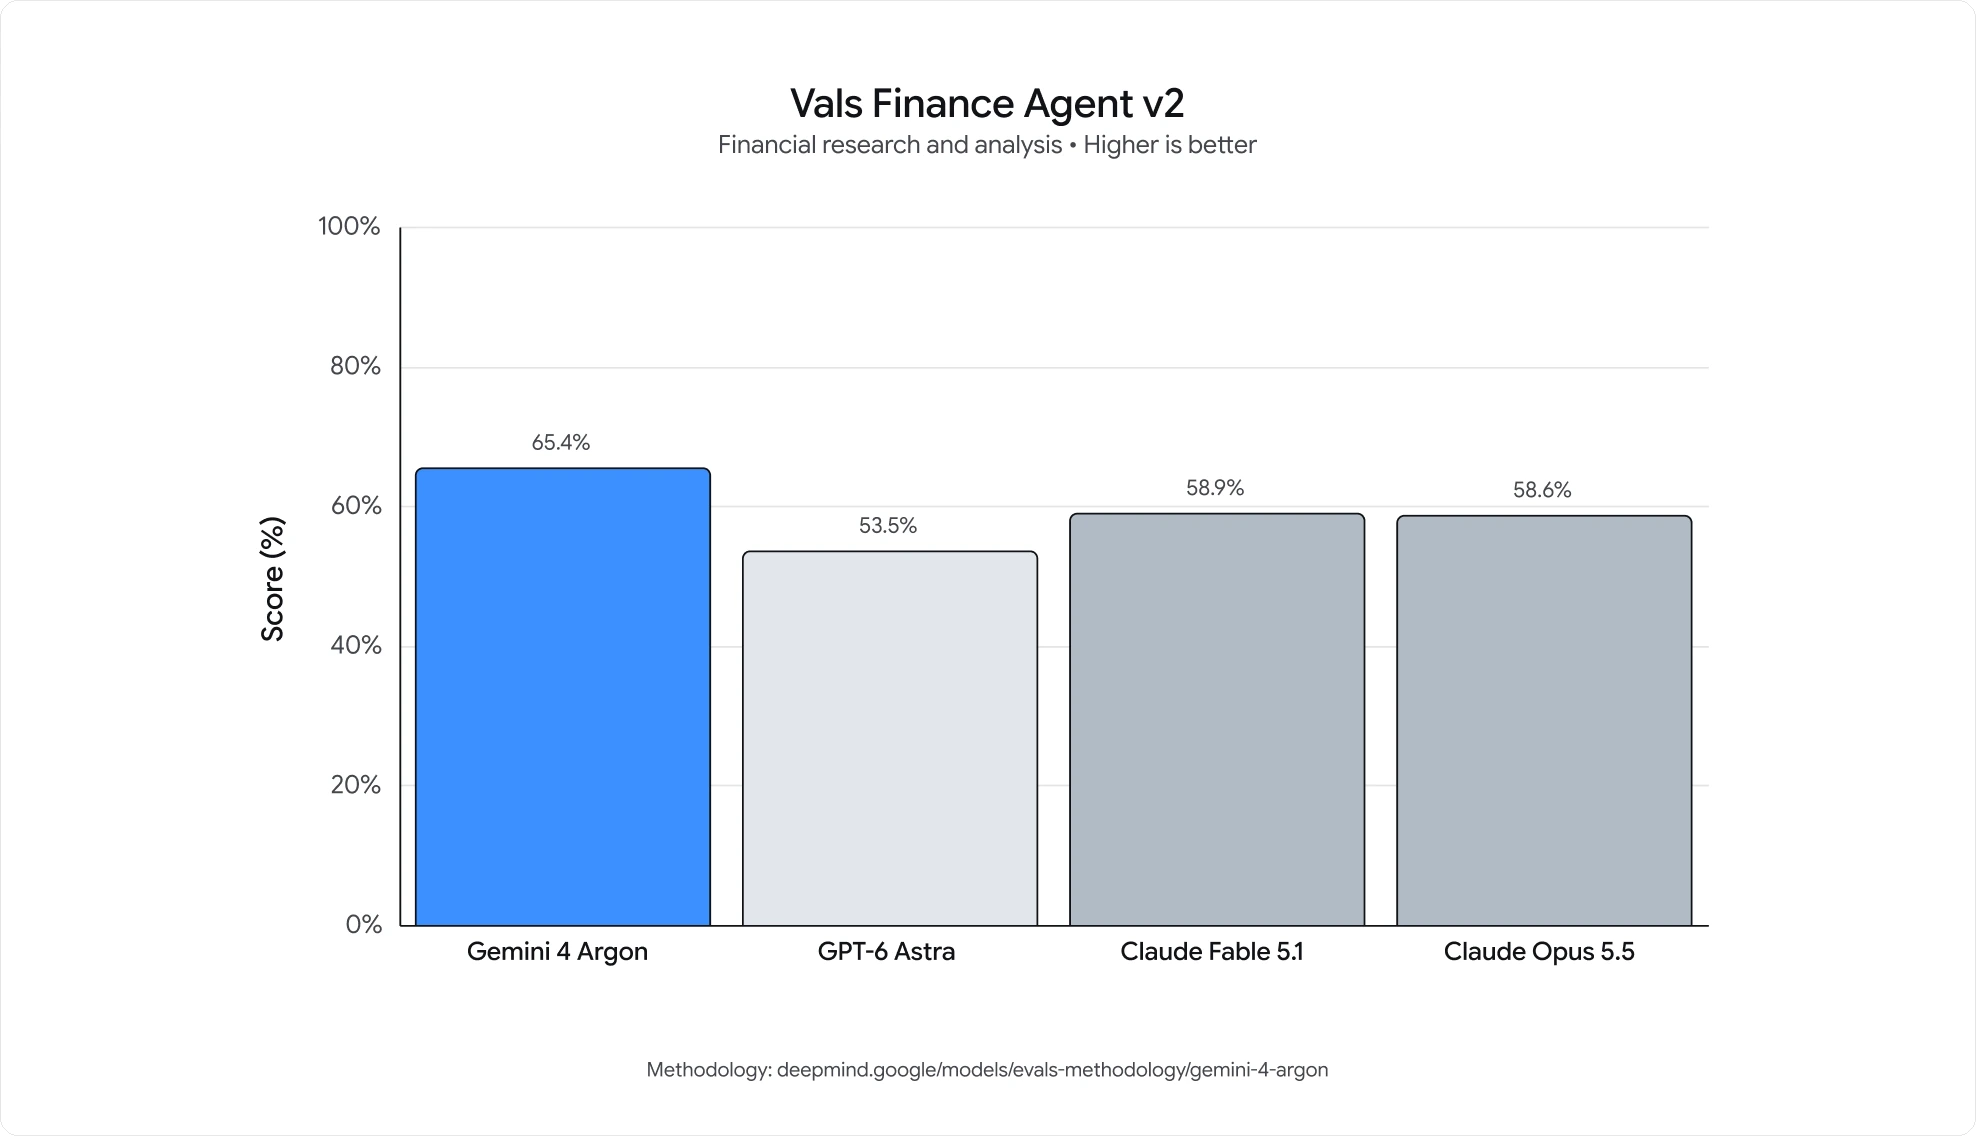
Największe podane różnice dotyczą Harvey's Legal Agent Benchmark i Vals Finance Agent v2 — prawdziwej analizy prawnej i finansowej, a nie zadań syntetycznych.

Praca z długim kontekstem, która się trzyma

W GraphWalks, który sprawdza, czy model naprawdę potrafi użyć kontekstu od 256K do 1M, Google podaje przewagę ponad dziesięciu punktów nad innymi flagowcami.

Rozumienie długiego wideo

LVBench, mierzący zrozumienie długiego wideo, wypada na 91.7% — to najwyższy wynik Argon na liście Google.
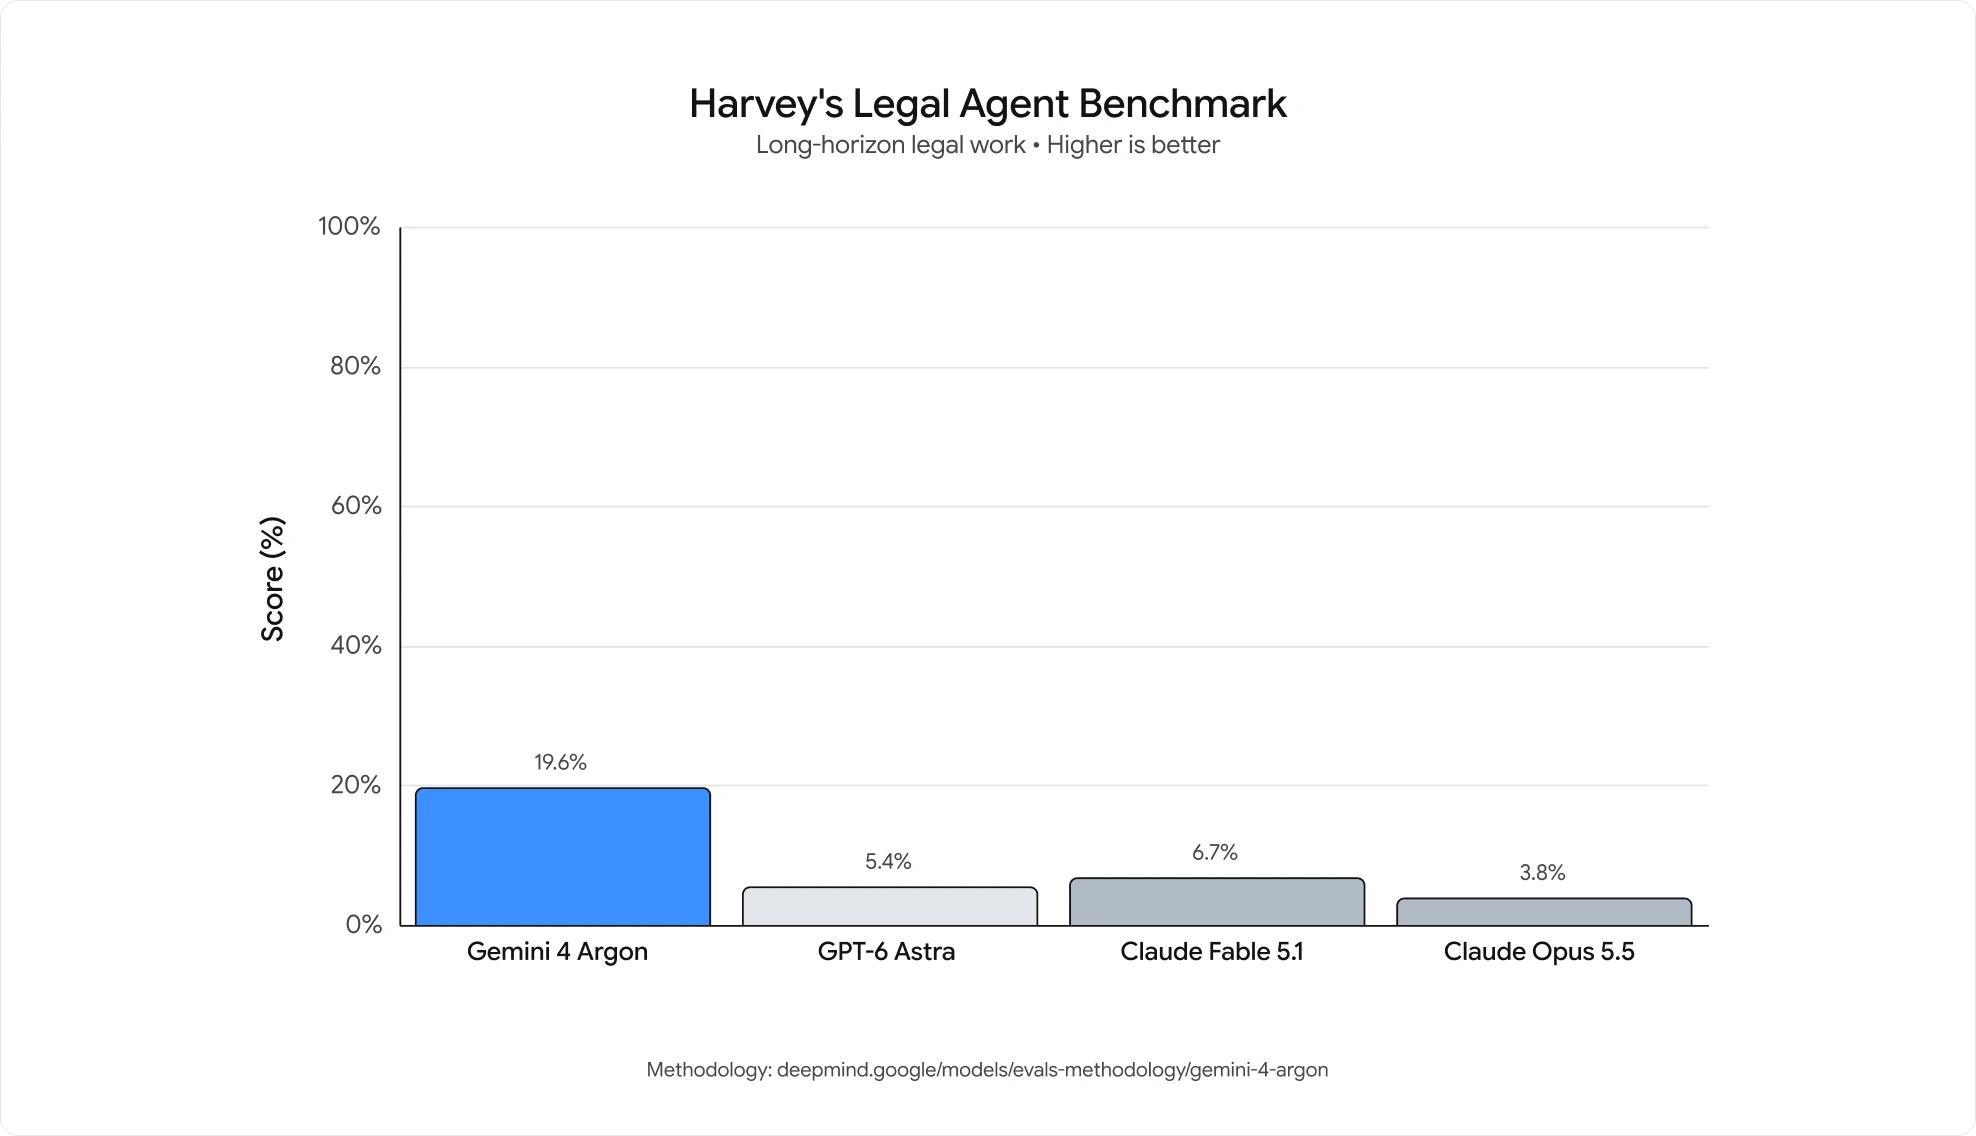
Wykres słupkowy Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Długotrwała praca prawnicza. 19.6% Argon to około trzy razy więcej niż wynik następnego modelu i największa przewaga w opublikowanym zestawie Google.
Wykres słupkowy Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Badania i analiza finansowa: 65.4% wobec stawki od 53.5% do 58.9%. Przewaga węższa niż w pracy prawniczej, ale kolejność ta sama.

Publikowane liczby

Gdzie Argon stoi w benchmarkach samego Google

To wyniki podane przez dostawcę. Google nie ujawniło ustawienia thinking ani effort dla głównych wyników i żadne niezależne laboratorium jeszcze ich nie powtórzyło.

Benchmark
Co mierzy
Argon
Najbliższe porównanie
DeepSWE v1.1
Długotrwała praca nad oprogramowaniem
77.9%
Opus 5.5 — 74.2%, GPT-6 Astra — 74.1%
CWE-bench v1
Wykrywanie i łatanie luk
68%
Dzieli pierwsze miejsce
AutomationBench
Kompleksowe zadania biznesowe od Zapier
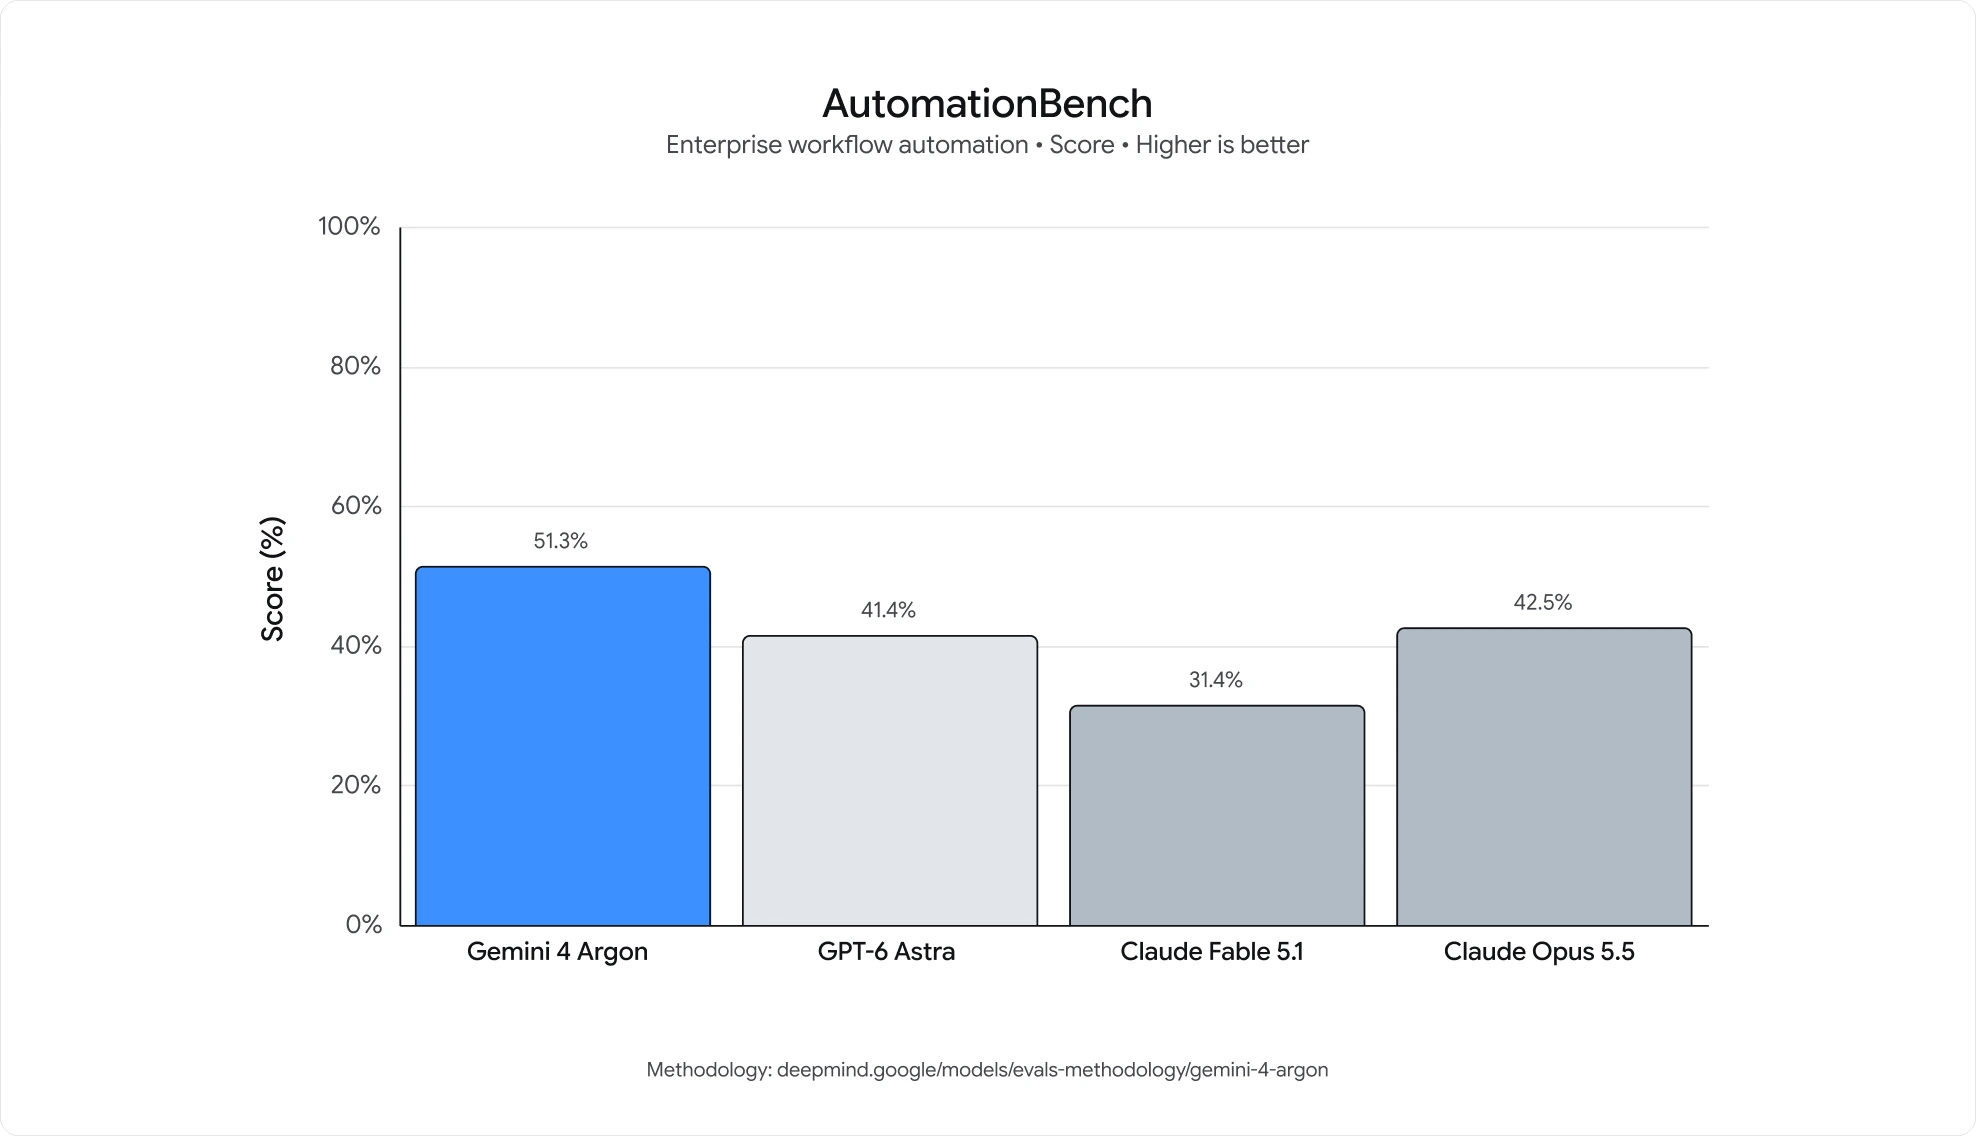
51.3%
Pierwsze miejsce
LVBench
Rozumienie długiego wideo
91.7%
Najwyższy wynik Argon podany przez Google

Traktuj je jako wskazówkę. Benchmarki dostawców rzadko przechodzą kontakt z produkcyjnym obciążeniem bez zmian, a Bloomberg podał, że część pracowników Google sama wątpi, czy przewaga w benchmarkach przekłada się na realną pracę.
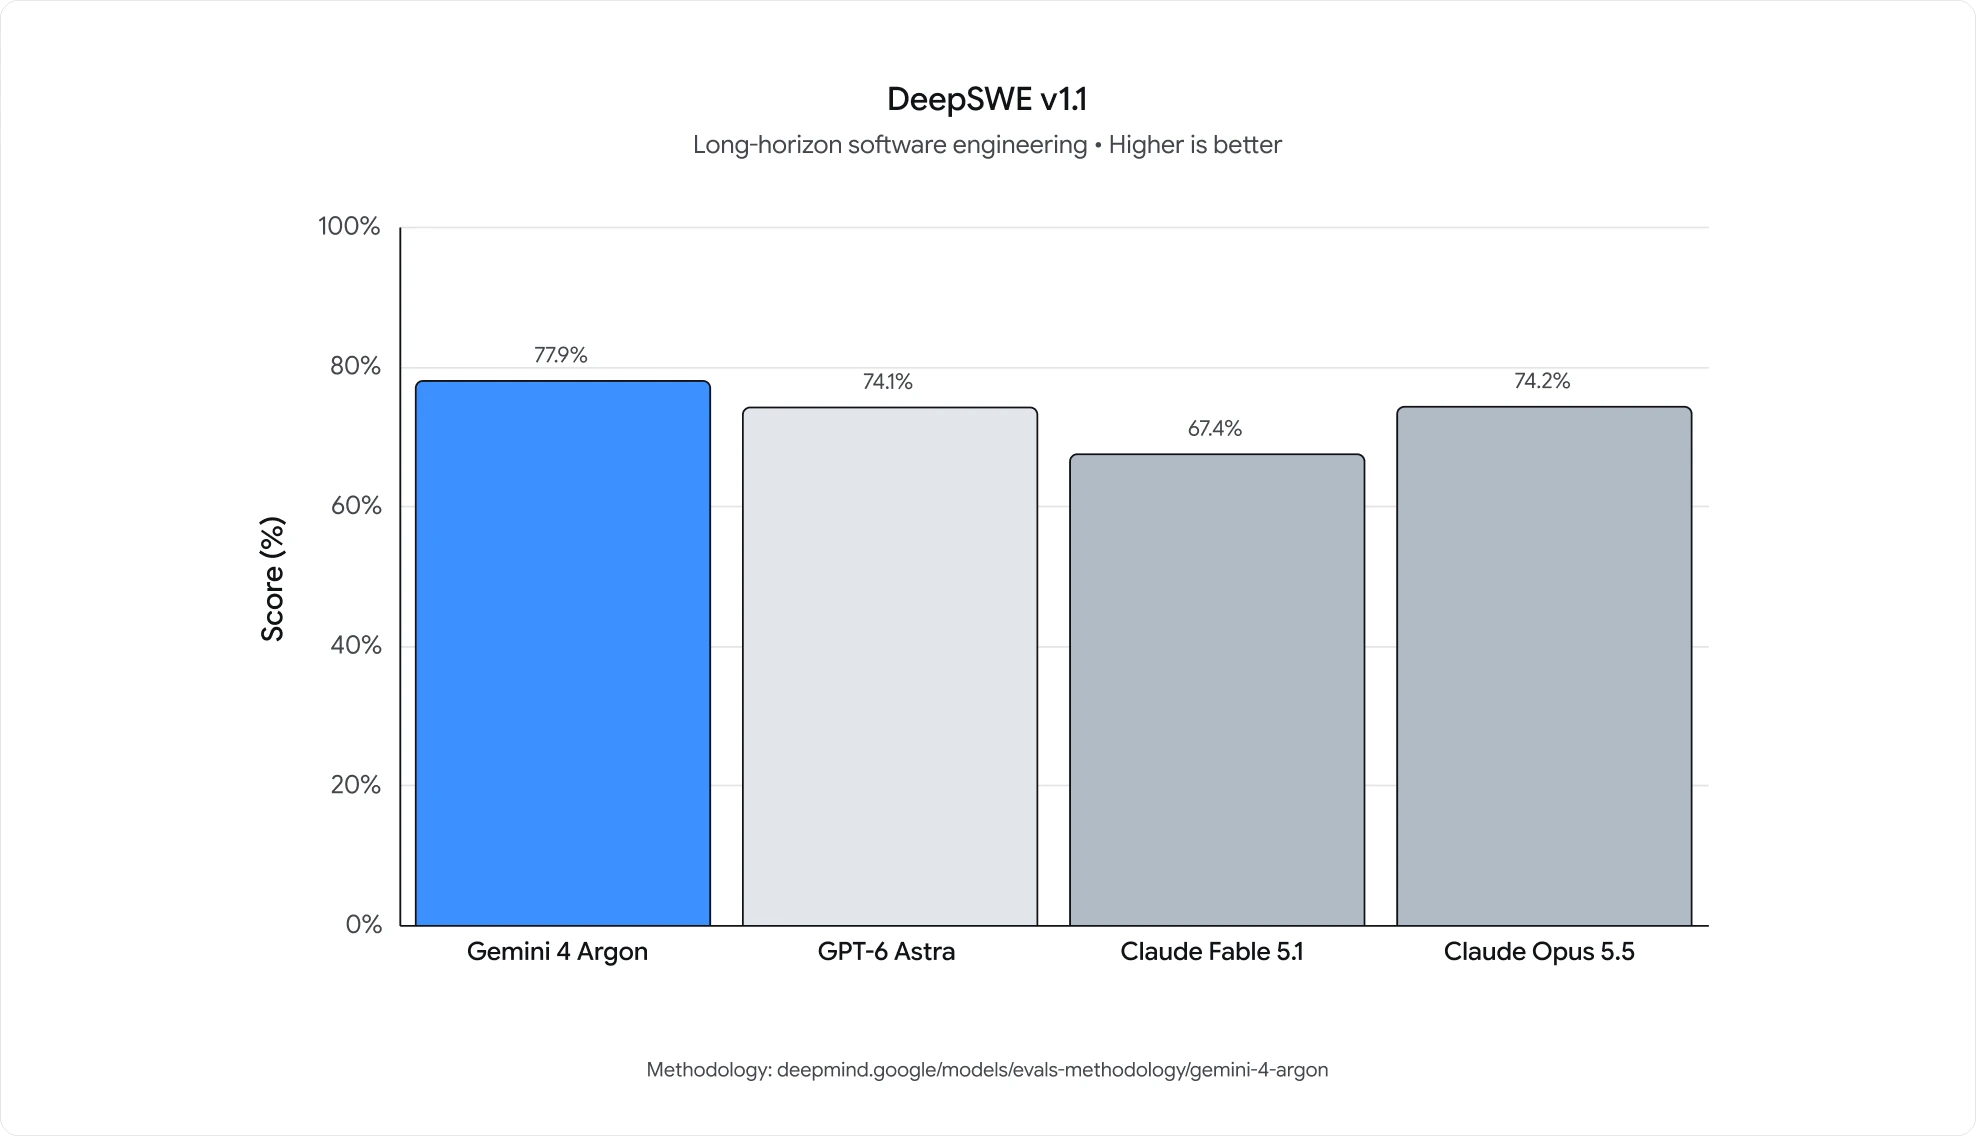
Wykres słupkowy DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Długotrwała praca nad oprogramowaniem. Główny wynik 77.9%, a obaj najbliżsi konkurenci w granicach czterech punktów.
Wykres słupkowy AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Kompleksowe zadania biznesowe, opracowane przez Zapier. Argon przekracza 50%, podczas gdy każdy inny model z porównania mieści się w przedziale od trzydziestu kilku do niskich czterdziestu procent.
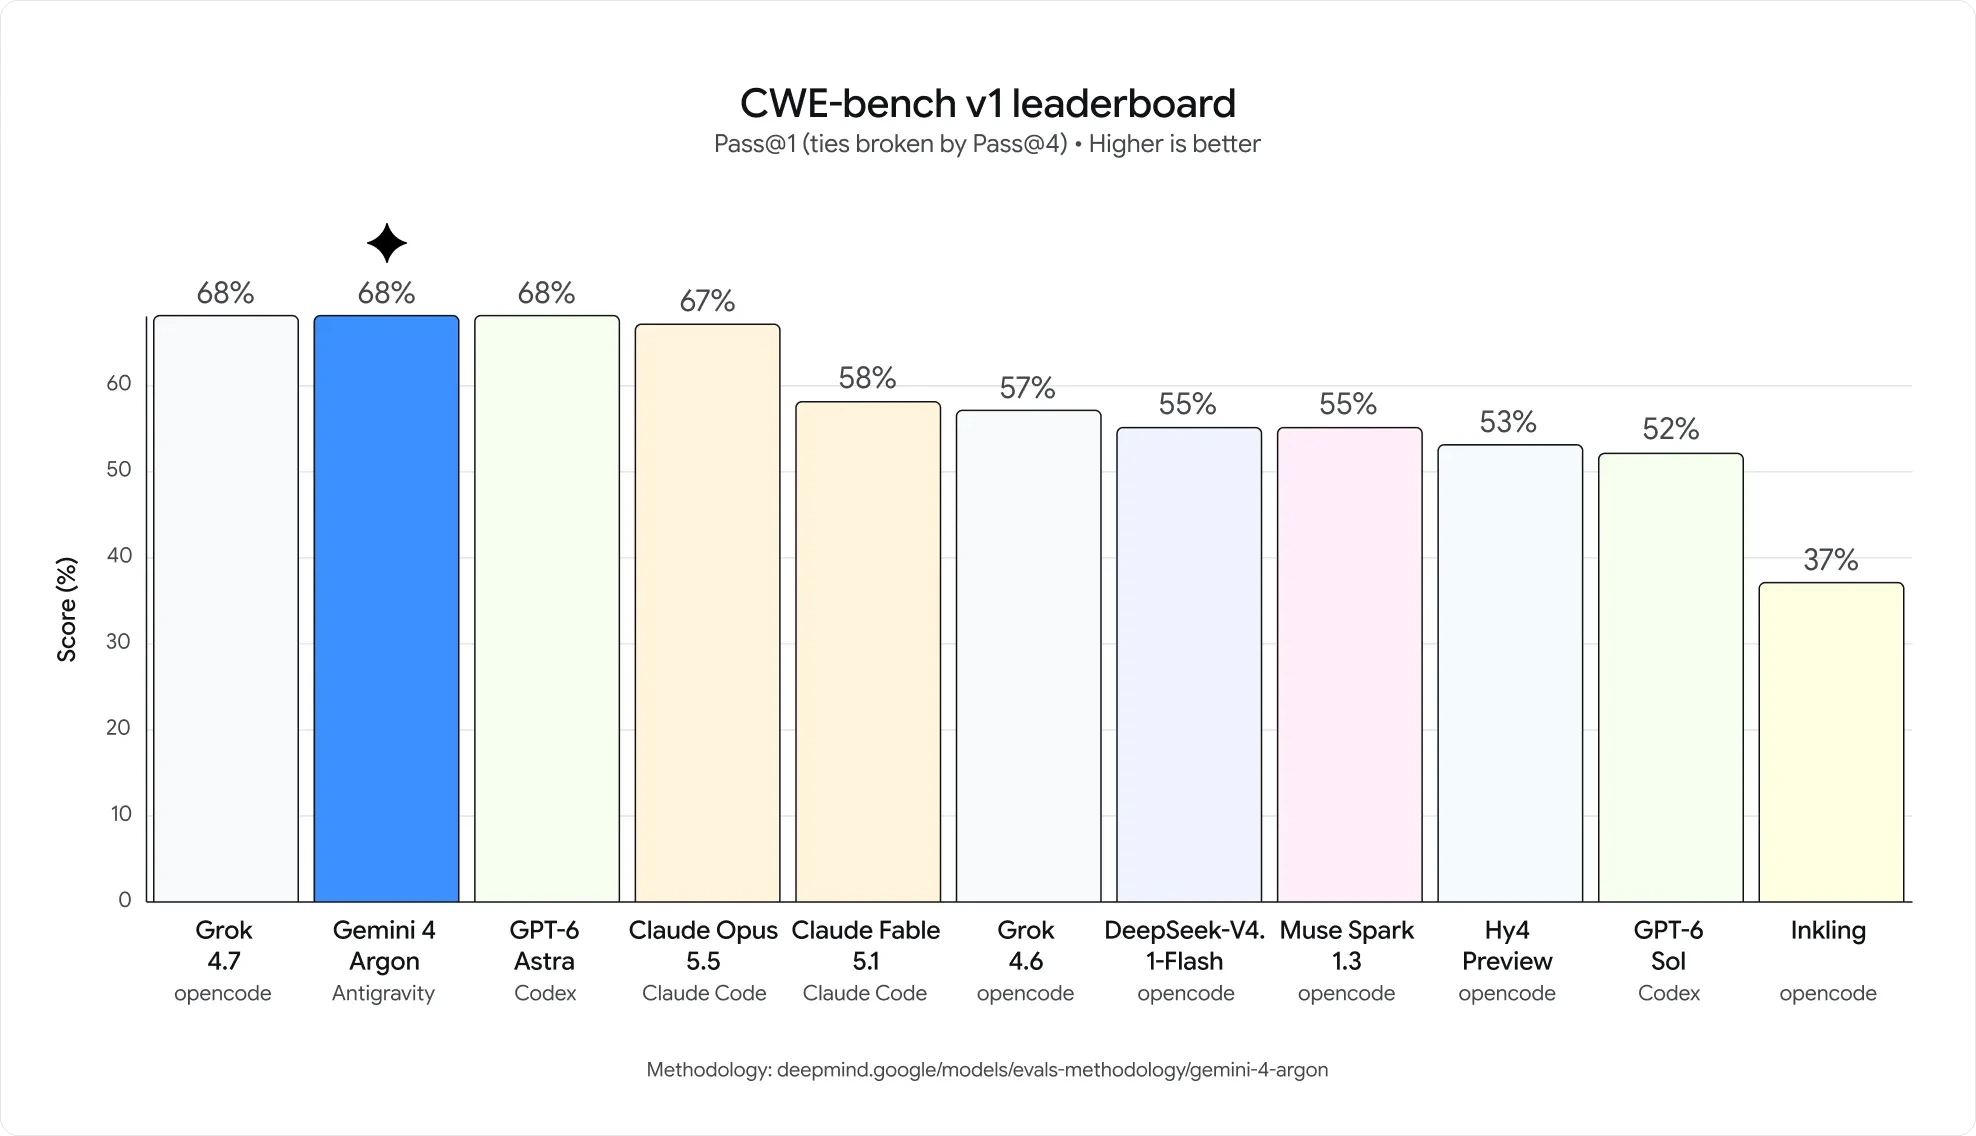
Ranking CWE-bench v1: Gemini 4 Argon, Grok i GPT-6 Astra remisują z 68%, Claude Opus 5.5 z 67%, schodząc do Inkling z 37%
Wykrywanie luk w zabezpieczeniach przy Pass@1. Argon dzieli szczyt gęsto obsadzonej tabeli, zamiast otwierać przewagę — dlatego tabela powyżej nazywa to podziałem pierwszego miejsca.
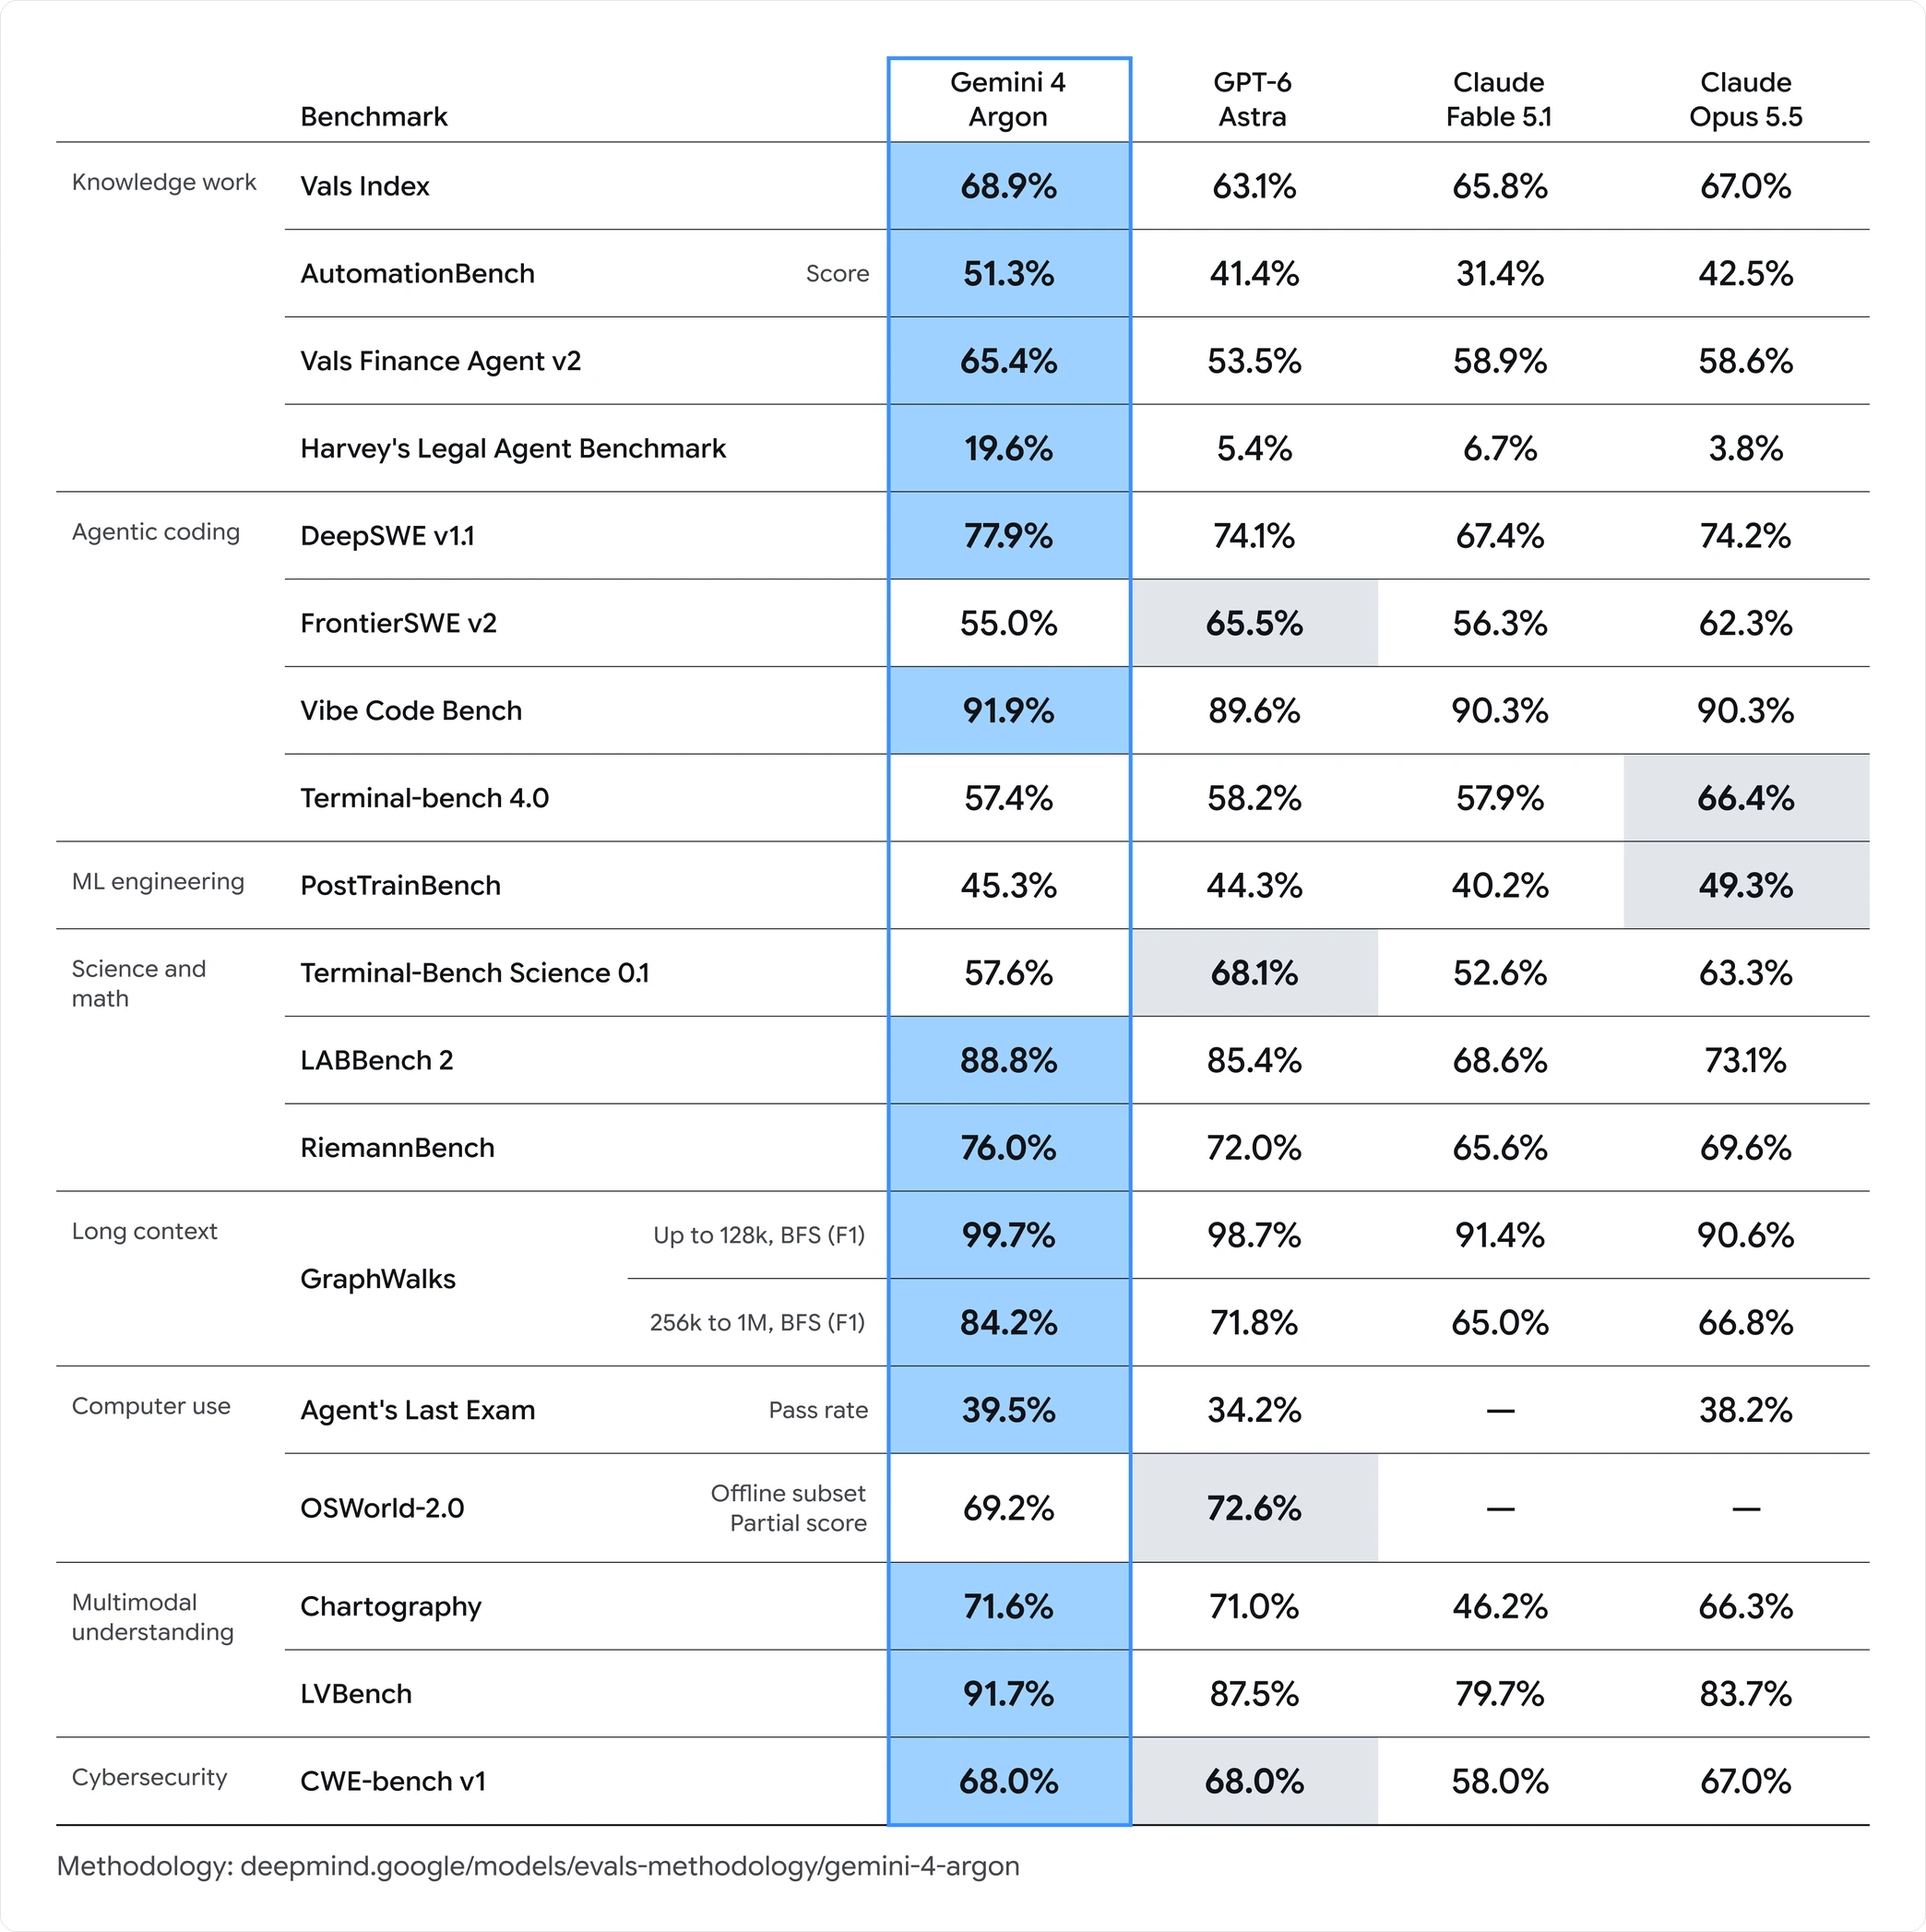
Pełna tabela wyników Google dla Gemini 4 Argon w 16 benchmarkach, pogrupowanych na pracę z wiedzą, kodowanie agentowe, inżynierię ML, naukę i matematykę, długi kontekst, obsługę komputera, rozumienie multimodalne i cyberbezpieczeństwo
Kompletna tabela z zapowiedzi: zwycięstwa Argon na niebiesko, a komórki, w których prowadzi konkurent, na szaro. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 i OSWorld-2.0 to wiersze, w których Argon nie prowadzi.
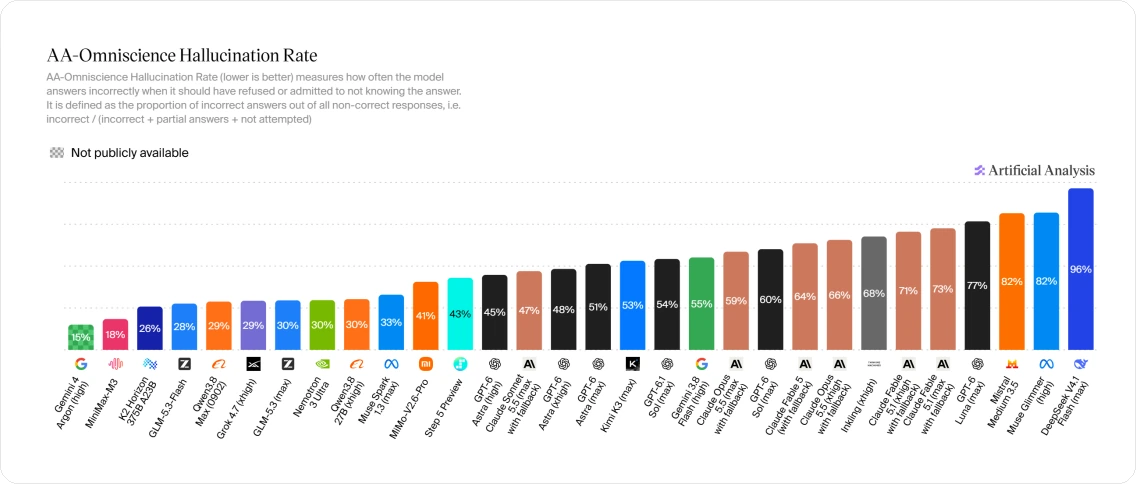
Wykres słupkowy wskaźnika halucynacji AA-Omniscience, który Artificial Analysis zmierzyła dla 36 modeli, od najniższego wyniku: Gemini 4 Argon (High) z 15%, następnie MiniMax-M3 z 18%, Kimi K2.5 z 26%, aż do DeepSeek-V4 Flash z 96%
Niezależny pomiar Artificial Analysis i jedyna liczba na tej stronie, której nie dostarczył żaden dostawca: jak często model odpowiada błędnie, zamiast odmówić odpowiedzi. Wynik Argon to 15% — najniższy spośród 36 przedstawionych modeli; skala sięga 96%.
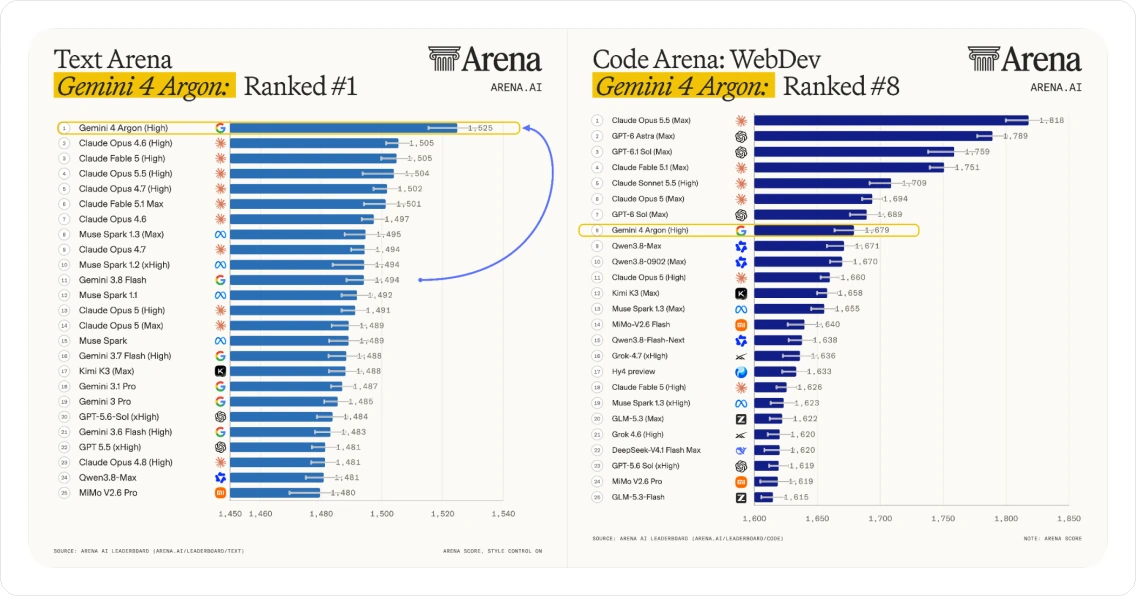
Rankingi Text Arena i Code Arena: WebDev od Arena.ai obok siebie: Gemini 4 Argon na 1. miejscu w Text Arena z wynikiem 1625 i na 8. miejscu w Code Arena: WebDev z wynikiem 1679
Dwa rankingi, na których opiera się powyższy akapit, z głosowanych przez użytkowników list Arena.ai. Argon prowadzi wśród 25 modeli na liście Text Arena; w Code Arena: WebDev jest ósmy — za czterema modelami Claude i trzema z linii GPT-6 OpenAI.

W Felo

Jak wygląda proces badawczy z modelem piszącym 1M tokenów

Felo łączy wyszukiwanie ze zrozumieniem dokumentów, więc model z długim wyjściem zmienia to, co może dać jedna sesja.

Badanie, które kończy się dokumentem

Zbierz źródła, a syntezę pozwól modelowi napisać w jednym przebiegu, zamiast składać ją sekcja po sekcji w wielu promptach.

Całe zestawy dokumentów w jednym zadaniu

Praca z długim kontekstem to najmocniejsza umiejętność Argon — właśnie dzięki niej zestawy umów, sprawozdania i długie raporty stają się wykonalne.

Pisanie, w którym liczy się ton

Profil Argon — mocny tekst, przeciętny kod — pasuje zespołom, które potrzebują prozy czytanej jak napisana, a nie złożona.

Koszt

Ile kosztuje Argon i co zmieni się później

Google opublikowało stawkę wprowadzającą i wyższą stawkę cennikową, nie mówiąc, kiedy nastąpi zmiana. Planuj budżet według wyższej liczby.

Typ tokenów
Wprowadzająca
Później
Wejście
2,00 $ / mln
4,00 $ / mln
Wejście z pamięci podręcznej
taniej o 95%
taniej o 95%
Wyjście
10,00 $ / mln
20,00 $ / mln

Dla porównania: stawka wprowadzająca jest mniej więcej na poziomie GPT-6.1 Sol i Sonnet 5.5 oraz około jednej piątej ceny GPT-6 Astra. To ceny cennikowe, a nie zmierzony koszt zadania — Argon odpowiada na trudniejsze pytania, więc jeden przebieg i tak może kosztować więcej.

Jak pracować z Argon w Felo

01

Przynieś całe pytanie

Daj Felo zestaw dokumentów albo długi wątek, a nie jego streszczenie. Przewaga Argon zaczyna się tam, gdzie kontekst przestaje mieścić się w promptcie.

02

Poproś o gotowy efekt

Przy limicie wyjścia 1M tokenów możesz zażądać pełnego raportu albo całego szkicu jednym poleceniem, a nie partiami.

03

Sprawdź go ze źródłami

Felo trzyma przypisy przy odpowiedzi i właśnie to czyni długi dokument wygenerowany przez model sprawdzalnym.

Dostęp do Argon w wyszukiwaniu Felo jest w przygotowaniu. Zanim się otworzy, każdy inny model z oferty Felo jest dostępny od razu.

Otwórz wyszukiwanie Felo AI

Gemini 4 Argon: częste pytania

Nie w ogólnym dostępie. Google wydało Argon najpierw wybranym partnerom programu Fairwind i zapowiada, że szerszy dostęp zacznie się od płatnych klientów API i subskrybentów Google AI Ultra. Daty tego etapu nie ogłoszono, a płatna subskrypcja dziś nie daje dostępu.

Wypróbuj flagowe modele Google w Felo

Szukaj, czytaj i pisz z modelem dopasowanym do zadania. Argon dołączy do oferty, gdy jego wdrożenie dotrze do Felo.

Otwórz wyszukiwanie Felo AI

Do korzystania z wyszukiwania Felo AI nie potrzebujesz karty.