01
Удержать весь контекст
Окно контекста на 1 млн токенов и знания по июнь 2026 года. Длинная переписка, целый репозиторий или пакет документов остаются в одной задаче.
Anthropic выпустила Opus 5.5 22 сентября 2026 года
Первая модель семейства Claude 5.5. Она выходит на уровень Claude Fable 5.1 в большинстве задач, стоит на 40% меньше в эксплуатации, чем Opus 5, и выдаёт ответ более чем на 30% быстрее.
Уже в поиске Felo
Claude Opus 5.5 доступен в поиске Felo для задач с длинным вводом: сверять цифры между файлами, прослеживать утверждение до источника и выдавать ответ, который можно передать дальше.
01
Окно контекста на 1 млн токенов и знания по июнь 2026 года. Длинная переписка, целый репозиторий или пакет документов остаются в одной задаче.
02
Во внутреннем тесте Anthropic 16 отчётов из 18 прошли планку качества. Достаточно было одной выдуманной цифры или цитаты, чтобы работа провалилась.
03
Anthropic переписала то, как модель общается: главное идёт первым, а отчёт прямо сообщает, что готово, что обнаружено и что осталось открытым.
Краткая инструкция
Claude Opus 5.5 появляется в выборе модели рядом с другими ведущими моделями вашего аккаунта.
Чем отличается Opus 5.5
Anthropic делает ставку на эффективность, а не на более высокий балл в бенчмарке: меньше токенов на задачу, ниже цена за токен и на 40% меньше затрат на типичных нагрузках. Именно это делает длительную работу агентов по средствам.
01
Anthropic сообщает, что один из первых тестировщиков проверил и починил кодовую базу на 200 000 строк меньше чем за три часа, тогда как Opus 5 тратил больше 20 часов и в 2,5 раза больше токенов.
02
Deloitte сообщает, что даже на самой низкой ступени effort Opus 5.5 находил 72% известных ошибок при ревью кода против 56% у Opus 5 на high, при меньшем числе ложных срабатываний.
03
Тексты короче и лучше структурированы. Box сообщает, что ответы стали на 40% менее многословными без потери точности, а токенов ушло втрое меньше, чем у Opus 5.
Выбор модели
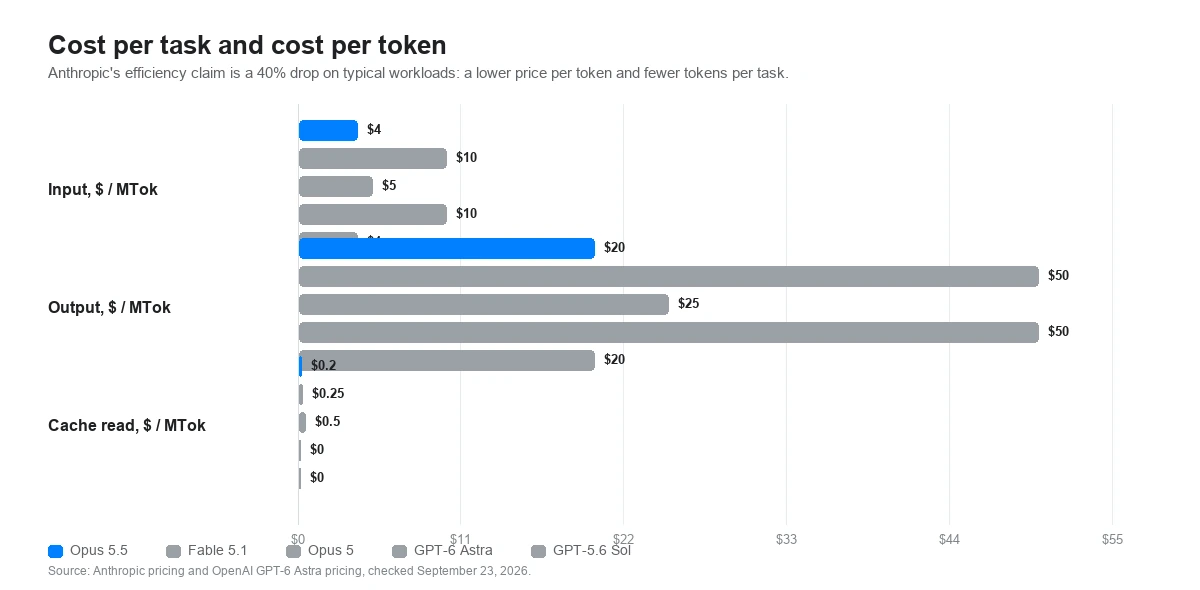
Ниже — официальные публичные тарифы API за миллион токенов, а не цены подписки или использования в Felo. Строка effort важна не меньше строки цены: один и тот же запрос может стоить очень по-разному в зависимости от того, с какой ступени стартует модель.
Публичные тарифы API и значения по умолчанию сверены 23 сентября 2026 года с анонсом Claude Opus 5.5 от Anthropic, страницами моделей Claude Platform и страницей GPT-6 Astra от OpenAI. Цена за токен — лишь часть общей стоимости задачи. Заявление Anthropic об эффективности — это снижение затрат на 40% на типичных нагрузках, что складывается из более низкой цены за токен и меньшего числа токенов на задачу.
Опубликованные результаты Anthropic
Anthropic опубликовала свои цифры рядом с Fable 5.1, Opus 5, GPT-6 Astra и GPT-5.6 Sol. Два из четырёх графиков ниже показывают точность относительно стоимости задачи, а не одну точность, потому что именно такое сравнение и проводит Anthropic.
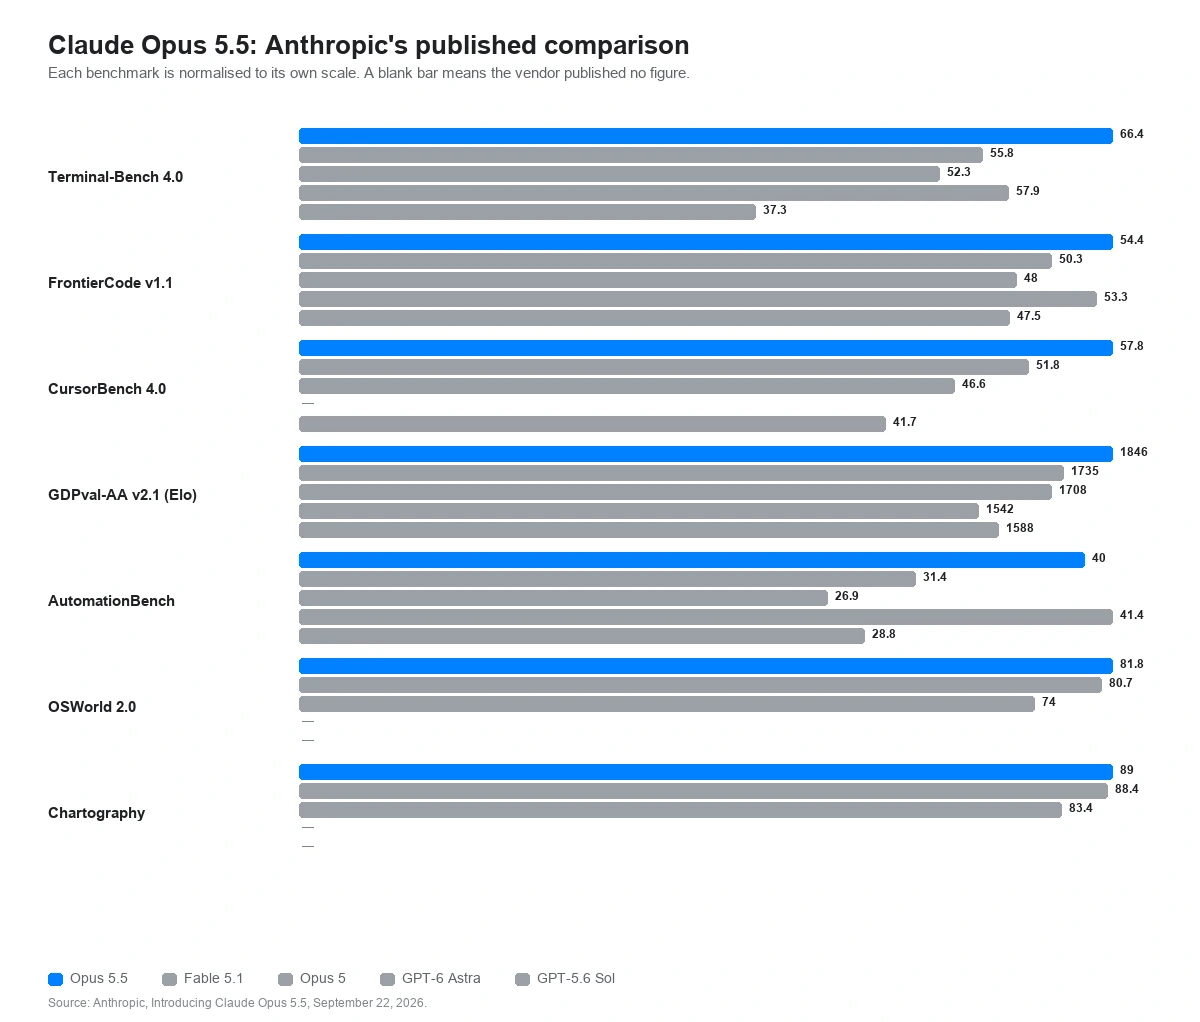
Полное опубликованное сравнение
Агентная работа с кодом, работа со знаниями, бизнес-процессы, междисциплинарные рассуждения, научные исследования, работа с компьютером и распознавание графиков по всем пяти измеренным моделям.
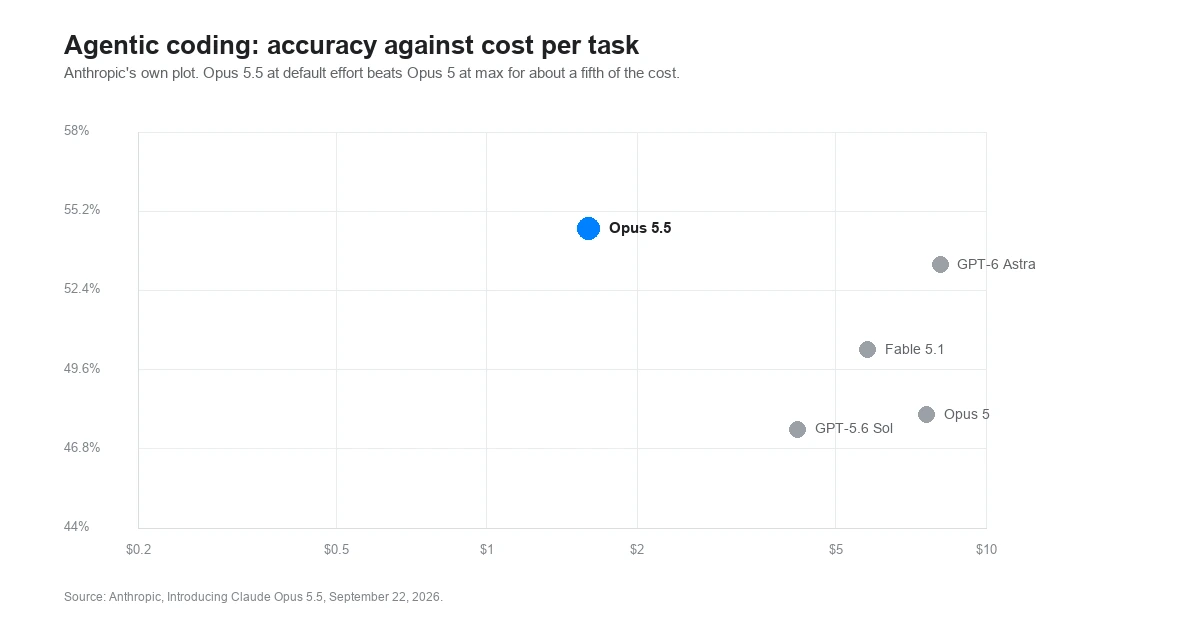
Агентная работа с кодом
Terminal-Bench 4.0, FrontierCode v1.1 и CursorBench 4.0 в виде зависимости точности от стоимости задачи.
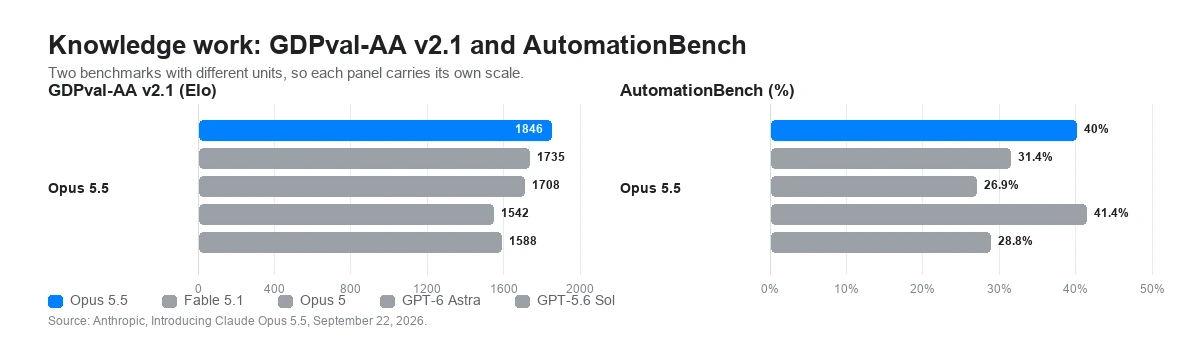
Работа со знаниями
GDPval-AA v2.1 по 44 профессиям, AutomationBench и WANDR — бенчмарк сбора данных от Perplexity.
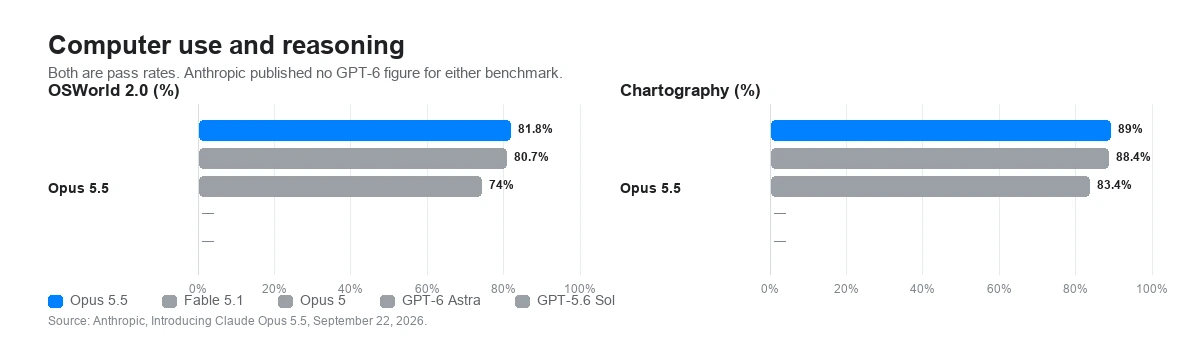
Работа с компьютером и рассуждения
OSWorld 2.0, Humanity's Last Exam и Chartography, где последний измеряет точность считывания значений с графика.
Точность относительно стоимости задачи
Главный тезис Anthropic — не более высокий балл любой ценой, а тот же или лучший результат за долю стоимости попытки.
Цифры опубликованы производителем. Если не указано иное, Anthropic запускала Opus 5.5 с адаптивным мышлением на max effort и оценивала его с включёнными производственными защитами. Когда эти защиты срабатывали, задачи по кибербезопасности выполняла Opus 4.8, а по биологии — Opus 5, что, вероятно, занижает опубликованные показатели Opus 5.5 в этих бенчмарках. Данные GPT-6 Astra и GPT-5.6 Sol приведены так, как их сообщает OpenAI. Разрывы в бенчмарках между производителями — слабый ориентир для реальных различий, о чём Anthropic говорит и сама.
Если вы уже используете Opus 5
Anthropic перечисляет четыре несовместимых изменения для интеграций, уже работающих на Claude Opus 5, плюс пятое, которое меняет форму ответа, не приводя к ошибке запроса. Их стоит прочитать до замены идентификатора модели, потому что три из них возвращают ошибку 400 вместо тихой деградации.
01
В Opus 5 мышление отключалось на high и ниже. В Opus 5.5 оно всегда включено, и как отключение, так и ручной бюджет токенов возвращают ошибку 400. Единственным регулятором становится effort, а значение по умолчанию меняется с high на medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice со значением "any" или с указанием конкретного инструмента возвращает ошибку 400, в том числе на эндпоинте подсчёта токенов. Используйте auto вместе со строгим вызовом инструментов или структурированным выводом и указывайте в промпте, когда инструмент уместен.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Каждый блок мышления фиксирует, какая модель его создала. Opus 5.5 читает блоки Opus 5 и более ранних моделей Opus, Sonnet и Haiku, но не Fable и Mythos. Если маршрутизатор переводит диалог на другую модель, последующие ходы выполняются без прежних рассуждений.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 сохраняют мышление; остальные модели его теряют
04
В Claude API и Google Cloud инструмент computer_20251124 возвращает ошибку 400. Объявите вместо него набор computer_toolset_20260801, уберите бета-заголовок и адаптируйте цикл агента под блоки member tool_use. В Amazon Bedrock старый инструмент продолжает работать.
computer_20251124 -> computer_toolset_20260801
Раз мышление нельзя отключить, настраивают effort. Opus 5.5 поддерживает все пять ступеней и стартует с medium, на ступень ниже Opus 5. Anthropic рекомендует заново прогнать перебор на своих оценках, а не переносить настройку, и задавать большой max_tokens на высоких ступенях: токены мышления учитываются в этом лимите, даже когда текст рассуждений не возвращается.
Effort — это поведенческий сигнал, а не жёсткий бюджет токенов: на низкой ступени модель всё равно думает над действительно сложными задачами, просто меньше, чем на высокой. Anthropic также отмечает, что на одной и той же ступени Opus 5.5 думает больше за ход, чем Opus 5, особенно на xhigh и max, поэтому перенесённая настройка даст более длинные и дорогие ходы.
Где это уместно
Opus 5.5 оправдан, когда задача идёт часами, охватывает больше файлов, чем человек способен удержать, или выдаёт результат, который должен проверить кто-то ещё. Это те случаи, которые описывают Anthropic и её первые тестировщики, а не обычные чат-промпты.
Провести изменение через большой репозиторий, пока не пройдут тесты, вместо остановки на первом правдоподобном патче. Anthropic сообщает о миграции на 680 000 строк, завершённой одним тестировщиком меньше чем за день.
Тестировщик Anthropic под названием Column сообщил, что нашёл ошибку, сверившись с внешней документацией по сторонней интеграции, которая была неверно смоделирована несколько коммитов назад.
Сначала построить модель, затем одностраничное резюме, сохранив оговорки. Anthropic сообщает об анализе слияния за 63 минуты против 93 у Opus 5 и вдвое дешевле.
Модель делегирует подагентам и подстраивает темп под бюджет времени. Anthropic рекомендует передавать мультиагентной системе сигнал о прошедшем времени, чтобы она распараллеливалась, а не выстраивалась в очередь.
01
Добавьте репозиторий, документы и требования, которые должна учесть полезная работа. Окно на 1 млн токенов существует именно для этого.
02
Скажите, что должно быть верно, чтобы работа считалась законченной. Совет Anthropic для работы без присмотра — держать части задачи в чек-листе, который модель обновляет.
03
Прогоните одну и ту же задачу на Opus 5.5, Opus 5 и Fable 5.1 в Felo. Сравнивайте не только ответ, но и тесты, оговорки и расход токенов.
Выберите Claude Opus 5.5, когда он появится в списке моделей вашего аккаунта.
Попробовать Opus 5.5 в FeloClaude Opus 5.5 — модель Anthropic для длительной агентной работы с кодом и работы со знаниями, выпущенная 22 сентября 2026 года как первая модель семейства Claude 5.5. По словам Anthropic, она выходит на уровень Claude Fable 5.1 в большинстве задач и стоит на 40% меньше в эксплуатации, чем Claude Opus 5.
Поставьте Claude Opus 5.5 рядом с другими ведущими моделями в Felo и проверьте его на той работе, которую вы откладывали, потому что она занимает часы.
Попробовать Opus 5.5 в FeloНачните с поиска Felo AI и выберите модель там, где она доступна.