01
Giữ trọn ngữ cảnh
Cửa sổ ngữ cảnh 1 triệu token và kiến thức đến tháng 6 năm 2026. Một mạch hội thoại dài, cả kho mã hay một bộ tài liệu đều nằm trong một tác vụ.
Anthropic ra mắt Opus 5.5 ngày 22 tháng 9 năm 2026
Mô hình đầu tiên trong dòng Claude 5.5. Nó đạt mức của Claude Fable 5.1 ở phần lớn công việc, chi phí vận hành thấp hơn Opus 5 40% và tạo đầu ra nhanh hơn trên 30%.
Đã có trong Felo Search
Claude Opus 5.5 đã có trong Felo Search cho những việc có đầu vào dài: đối chiếu số liệu giữa các tệp, truy vết một khẳng định về tận nguồn và trả về câu trả lời bạn có thể chuyển thẳng cho người khác.
01
Cửa sổ ngữ cảnh 1 triệu token và kiến thức đến tháng 6 năm 2026. Một mạch hội thoại dài, cả kho mã hay một bộ tài liệu đều nằm trong một tác vụ.
02
Trong một bài kiểm tra nội bộ của Anthropic, 16 trên 18 báo cáo đạt chuẩn chất lượng. Chỉ một con số hay trích dẫn bịa ra là đủ để cả bài thi trượt.
03
Anthropic làm lại cách mô hình giao tiếp: thông tin quan trọng nhất lên đầu, và báo cáo nói thẳng việc gì đã xong, phát hiện được gì và còn gì chưa khép lại.
Hướng dẫn nhanh
Claude Opus 5.5 xuất hiện trong trình chọn mô hình cùng các mô hình hàng đầu khác của tài khoản bạn.
Điểm khác của Opus 5.5
Anthropic đặt trọng tâm vào hiệu quả chứ không phải điểm benchmark cao hơn: ít token hơn mỗi tác vụ, giá mỗi token thấp hơn và chi phí thấp hơn 40% ở khối lượng công việc thông thường. Đó là điều khiến việc để một agent chạy hàng giờ trở nên vừa túi tiền.
01
Anthropic kể lại một người thử nghiệm sớm đã kiểm tra và sửa một kho mã 200.000 dòng trong chưa đầy ba giờ, trong khi Opus 5 mất hơn 20 giờ và dùng gấp 2,5 lần token.
02
Deloitte báo cáo rằng ngay ở bậc effort thấp nhất, Opus 5.5 vẫn tìm ra 72% lỗi đã biết khi duyệt mã, so với 56% của Opus 5 ở bậc high, và ít báo động nhầm hơn.
03
Câu chữ ngắn hơn và có cấu trúc rõ hơn. Box báo cáo câu trả lời bớt dài dòng 40% mà không mất độ chính xác, với lượng token chỉ bằng một phần ba Opus 5.
Chọn mô hình
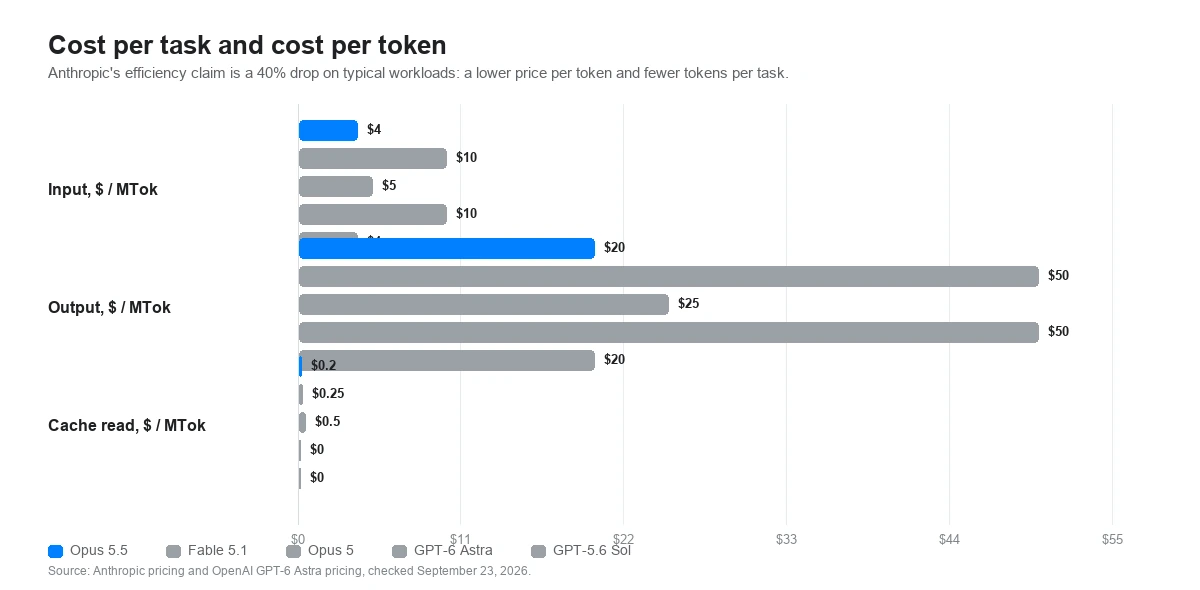
Giá bên dưới là đơn giá API công khai chính thức cho mỗi triệu token, không phải giá thuê bao hay giá sử dụng của Felo. Dòng effort quan trọng ngang dòng giá: cùng một câu lệnh có thể tốn rất khác nhau tuỳ mô hình xuất phát từ đâu.
Đơn giá API công khai và giá trị mặc định được đối chiếu ngày 23 tháng 9 năm 2026 với thông báo Claude Opus 5.5 của Anthropic, các trang mô hình của Claude Platform và trang GPT-6 Astra của OpenAI. Giá mỗi token chỉ là một phần của tổng chi phí tác vụ. Tuyên bố về hiệu quả của Anthropic là mức giảm 40% trên khối lượng công việc thông thường, kết hợp giá mỗi token thấp hơn với ít token hơn mỗi tác vụ.
Kết quả do Anthropic công bố
Anthropic công bố số liệu của mình bên cạnh Fable 5.1, Opus 5, GPT-6 Astra và GPT-5.6 Sol. Hai trong bốn biểu đồ bên dưới thể hiện độ chính xác so với chi phí mỗi tác vụ chứ không phải chỉ độ chính xác, vì đó chính là phép so sánh Anthropic đang thực hiện.
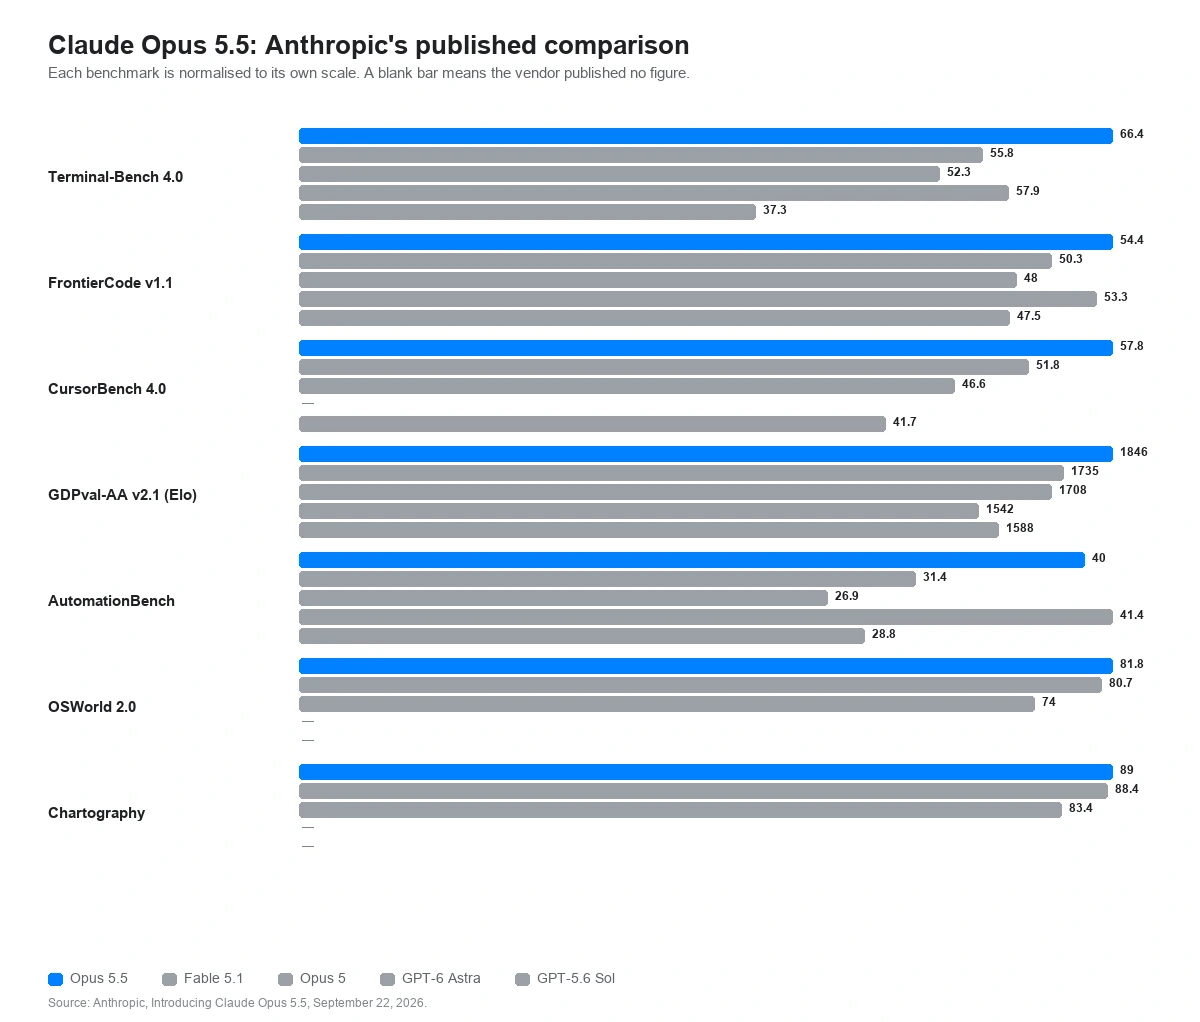
Toàn bộ bảng so sánh đã công bố
Lập trình agent, công việc tri thức, quy trình doanh nghiệp, suy luận liên ngành, nghiên cứu khoa học, sử dụng máy tính và đọc biểu đồ, trên cả năm mô hình được đo.
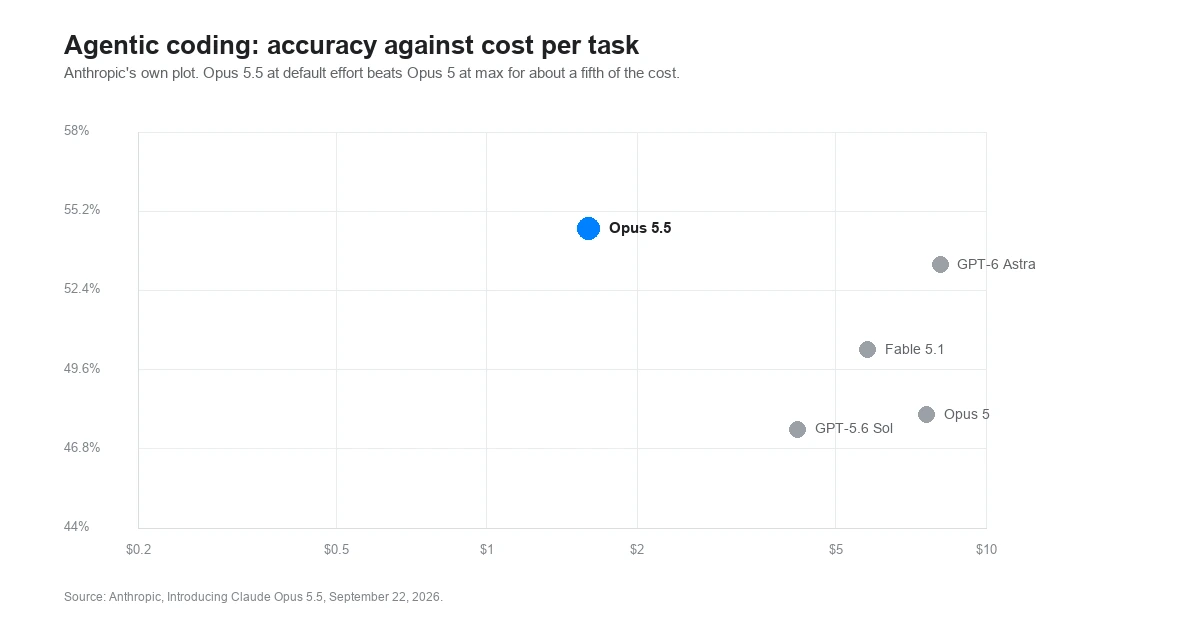
Lập trình agent
Terminal-Bench 4.0, FrontierCode v1.1 và CursorBench 4.0, vẽ theo độ chính xác so với chi phí mỗi tác vụ.
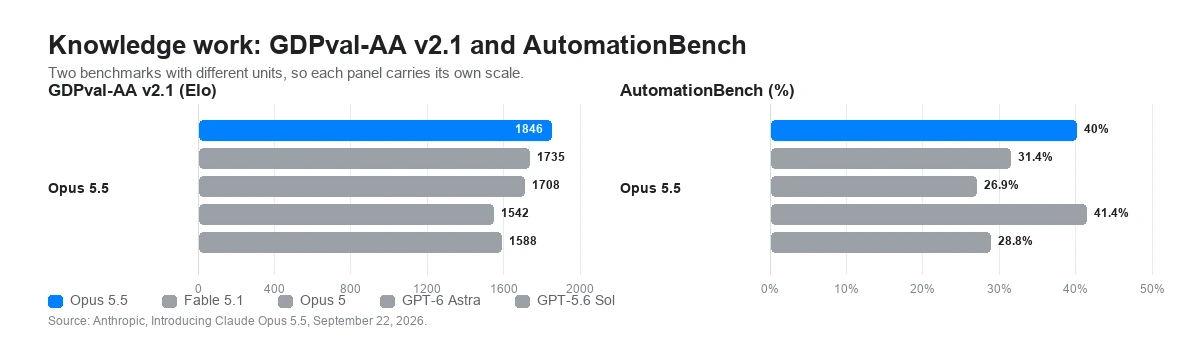
Công việc tri thức
GDPval-AA v2.1 trên 44 nghề, AutomationBench và WANDR, benchmark thu thập dữ liệu của Perplexity.
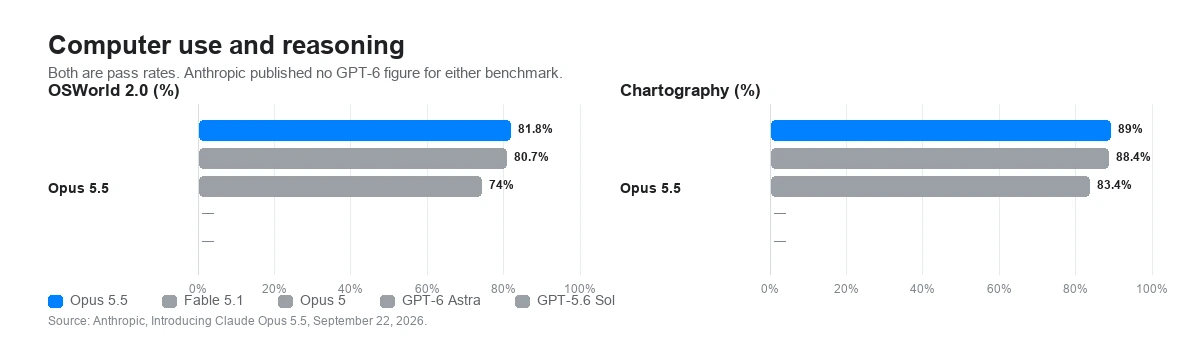
Sử dụng máy tính và suy luận
OSWorld 2.0, Humanity's Last Exam và Chartography, trong đó bài cuối đo độ chính xác khi đọc giá trị từ biểu đồ.
Độ chính xác so với chi phí mỗi tác vụ
Luận điểm trung tâm của Anthropic không phải điểm cao hơn bằng mọi giá, mà là điểm ngang bằng hoặc tốt hơn với một phần nhỏ chi phí mỗi lần thử.
Số liệu do nhà cung cấp công bố. Trừ khi có ghi chú khác, Anthropic chạy Opus 5.5 với suy luận thích ứng ở max effort và đánh giá khi các biện pháp bảo vệ môi trường sản xuất đang bật. Khi các biện pháp đó can thiệp, việc an ninh mạng do Opus 4.8 hoàn thành và việc sinh học do Opus 5 hoàn thành, điều này có thể làm giảm số liệu Opus 5.5 được công bố trên các benchmark đó. Số liệu GPT-6 Astra và GPT-5.6 Sol là mức OpenAI báo cáo. Khoảng cách benchmark giữa các nhà cung cấp chỉ là chỉ dấu yếu về khác biệt thực tế, đúng như chính Anthropic nói về những con số này.
Nếu bạn đã chạy Opus 5
Anthropic liệt kê bốn thay đổi không tương thích cho các tích hợp đang chạy trên Claude Opus 5, cộng thêm thay đổi thứ năm làm đổi hình dạng phản hồi mà không khiến yêu cầu thất bại. Nên đọc trước khi đổi ID mô hình, vì ba trong bốn thay đổi trả về lỗi 400 thay vì suy giảm âm thầm.
01
Ở Opus 5, có thể tắt suy luận ở bậc high trở xuống. Ở Opus 5.5, nó luôn bật, và cả việc tắt lẫn ngân sách token thủ công đều trả về lỗi 400. Effort trở thành tay điều khiển duy nhất, và giá trị mặc định đổi từ high sang medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice đặt thành "any" hoặc chỉ định tên công cụ sẽ trả về lỗi 400, kể cả ở điểm cuối đếm token. Hãy dùng auto cùng gọi công cụ nghiêm ngặt hoặc đầu ra có cấu trúc, và nói trong câu lệnh khi nào công cụ đó phù hợp.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Mỗi khối suy luận ghi lại mô hình đã tạo ra nó. Opus 5.5 đọc được khối từ Opus 5 và các mô hình Opus, Sonnet, Haiku trước đó, nhưng không đọc được từ Fable hay Mythos. Nếu bộ định tuyến chuyển hội thoại sang mô hình khác, các lượt sau chạy mà không có suy luận trước đó.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 giữ suy luận; mô hình khác bỏ đi
04
Trên Claude API và Google Cloud, công cụ computer_20251124 trả về lỗi 400. Hãy khai báo bộ công cụ computer_toolset_20260801, bỏ tiêu đề beta và chỉnh vòng lặp agent cho các khối member tool_use. Trên Amazon Bedrock, công cụ cũ vẫn hoạt động.
computer_20251124 -> computer_toolset_20260801
Vì không thể tắt suy luận, thứ cần chỉnh là effort. Opus 5.5 hỗ trợ cả năm bậc và khởi đầu ở medium, thấp hơn Opus 5 một bậc. Khuyến nghị của Anthropic là quét lại trên chính bộ đánh giá của bạn thay vì bê nguyên thiết lập cũ, và đặt max_tokens rộng rãi ở các bậc cao, vì token suy luận vẫn tính vào hạn mức đó dù phần chữ suy luận không được trả về.
Effort là tín hiệu hành vi chứ không phải ngân sách token cứng: ở bậc thấp, mô hình vẫn suy nghĩ với bài thật khó, chỉ ít hơn so với bậc cao. Anthropic cũng lưu ý rằng ở cùng một bậc, Opus 5.5 có xu hướng suy nghĩ nhiều hơn mỗi lượt so với Opus 5, rõ nhất ở xhigh và max, nên một thiết lập bê từ Opus 5 sang sẽ tạo ra những lượt dài hơn và tốn kém hơn.
Nơi nó phù hợp
Opus 5.5 đáng dùng khi một tác vụ kéo dài hàng giờ, trải trên nhiều tệp hơn mức một người nắm được, hoặc tạo ra thứ mà người khác phải kiểm lại. Đây là những việc Anthropic và những người thử nghiệm sớm mô tả, không phải câu lệnh trò chuyện chung chung.
Đưa một thay đổi xuyên suốt kho mã lớn cho đến khi test chạy qua, thay vì dừng ở bản vá đầu tiên có vẻ hợp lý. Anthropic báo cáo một cuộc di trú 680.000 dòng hoàn tất trong chưa đầy một ngày bởi một người thử nghiệm.
Column, một đơn vị thử nghiệm được Anthropic nêu, báo cáo đã tìm ra lỗi nhờ tra tài liệu bên ngoài cho một tích hợp bên thứ ba bị mô hình hoá sai từ vài commit trước.
Dựng mô hình, rồi viết bản tóm tắt một trang, giữ nguyên các lưu ý. Anthropic báo cáo một bài phân tích sáp nhập xong trong 63 phút so với 93 phút của Opus 5, với chi phí bằng một nửa.
Mô hình giao việc cho subagent và chỉnh nhịp theo ngân sách thời gian. Anthropic khuyến nghị cấp cho hệ nhiều agent một tín hiệu thời gian đã trôi qua để nó chạy song song thay vì xếp hàng.
01
Đưa vào kho mã, tài liệu và yêu cầu mà một câu trả lời hữu ích phải tính đến. Cửa sổ 1 triệu token sinh ra chính vì việc này.
02
Nói rõ điều gì phải đúng thì công việc mới được coi là xong. Lời khuyên của Anthropic cho các phiên không giám sát là giữ các phần việc trong một danh sách mà mô hình cập nhật.
03
Chạy cùng một tác vụ trên Opus 5.5, Opus 5 và Fable 5.1 trong Felo. So cả phần kiểm thử, các lưu ý và lượng token tiêu thụ, không chỉ câu trả lời.
Chọn Claude Opus 5.5 khi nó xuất hiện trong trình chọn mô hình của tài khoản bạn.
Dùng thử Opus 5.5 trên FeloClaude Opus 5.5 là mô hình của Anthropic cho lập trình agent chạy dài và công việc tri thức, phát hành ngày 22 tháng 9 năm 2026 với tư cách mô hình đầu tiên của dòng Claude 5.5. Theo Anthropic, nó đạt mức của Claude Fable 5.1 ở phần lớn công việc với chi phí vận hành thấp hơn Claude Opus 5 40%.
Đặt Claude Opus 5.5 cạnh các mô hình hàng đầu khác trong Felo, rồi thử nó với công việc bạn vẫn trì hoãn vì tốn hàng giờ.
Dùng thử Opus 5.5 trên FeloBắt đầu từ Felo AI Search và chọn mô hình ở nơi có sẵn.