01
الإمساك بالسياق كاملًا
نافذة سياق تبلغ مليون رمز ومعرفة حتى يونيو 2026. محادثة طويلة أو مستودع كامل أو مجموعة مستندات تبقى في مهمة واحدة.
أطلقت Anthropic نموذج Opus 5.5 في 22 سبتمبر 2026
أول نموذج في عائلة Claude 5.5. يبلغ مستوى Claude Fable 5.1 في معظم المهام، وتكلفة تشغيله أقل بنسبة 40% من Opus 5، ويولّد المخرجات أسرع بأكثر من 30%.
متاح الآن في بحث Felo
أصبح Claude Opus 5.5 متاحًا في بحث Felo للمهام ذات المدخلات الطويلة: مطابقة الأرقام بين الملفات، وتتبّع أي ادعاء حتى مصدره، وتسليم إجابة يمكنك تمريرها إلى شخص آخر.
01
نافذة سياق تبلغ مليون رمز ومعرفة حتى يونيو 2026. محادثة طويلة أو مستودع كامل أو مجموعة مستندات تبقى في مهمة واحدة.
02
في اختبار داخلي لـ Anthropic، اجتاز 16 تقريرًا من أصل 18 حدّ الجودة. كان يكفي رقم واحد أو اقتباس واحد مختلق لإفشال المهمة بأكملها.
03
أعادت Anthropic تصميم طريقة تواصل النموذج: تأتي المعلومات الأهم في البداية، ويوضّح التقرير ما أُنجز وما وُجد وما لا يزال مفتوحًا.
دليل سريع
يظهر Claude Opus 5.5 في مُحدِّد النماذج إلى جانب النماذج الرائدة الأخرى في حسابك.
ما يميّز Opus 5.5
تركّز Anthropic على الكفاءة لا على رفع نتيجة اختبار قياسي: رموز أقل لكل مهمة، وسعر أقل لكل رمز، وتكلفة أقل بنسبة 40% في أحمال العمل المعتادة. هذا ما يجعل ترك وكيل يعمل ساعات أمرًا ممكن التحمّل.
01
تذكر Anthropic أن أحد المختبِرين الأوائل دقّق قاعدة شيفرة من 200 ألف سطر وأصلحها في أقل من ثلاث ساعات، بينما استغرق Opus 5 أكثر من 20 ساعة واستخدم ضعف الرموز بمقدار 2.5 مرة.
02
ذكرت Deloitte أن Opus 5.5، حتى في أدنى مستوى effort، اكتشف 72% من العلل المعروفة في مراجعة الشيفرة، مقابل 56% لـ Opus 5 عند high، مع إنذارات خاطئة أقل.
03
النصوص أقصر وأفضل تنظيمًا. ذكرت Box أن الإجابات صارت أقل إسهابًا بنسبة 40% دون فقدان الدقة، وبثلث الرموز التي استخدمها Opus 5.
اختيار النموذج
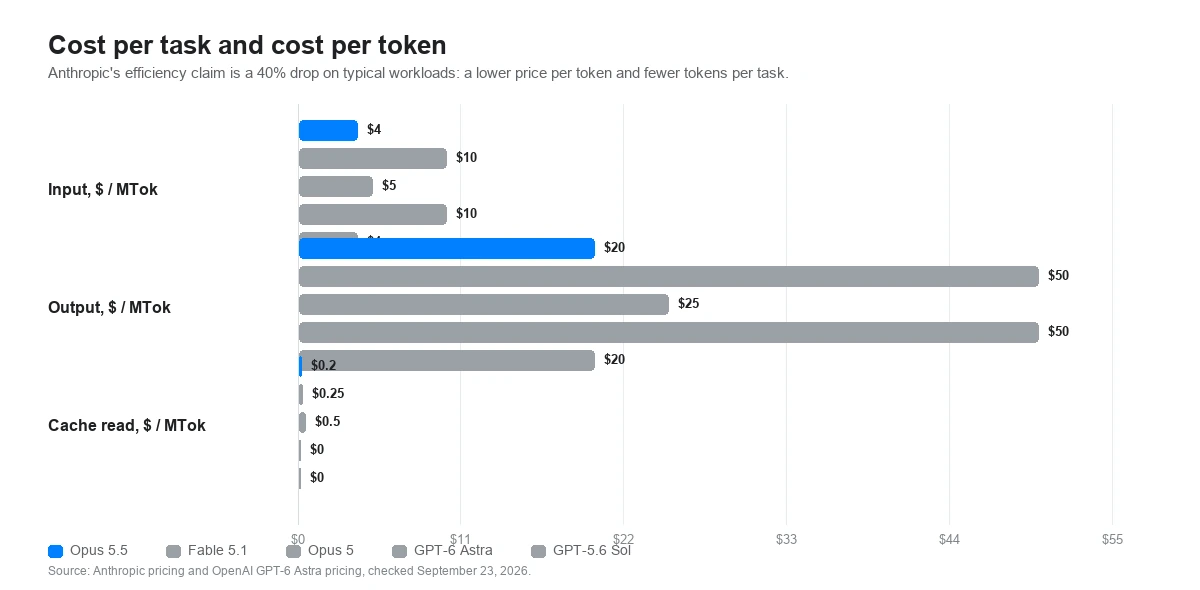
الأسعار أدناه هي أسعار API العامة الرسمية لكل مليون رمز، وليست أسعار اشتراك Felo أو استخدامها. سطر effort لا يقل أهمية عن سطر السعر: الطلب نفسه قد تختلف تكلفته كثيرًا بحسب نقطة انطلاق كل نموذج.
روجعت أسعار API العامة والقيم الافتراضية في 23 سبتمبر 2026 مقابل إعلان Claude Opus 5.5 من Anthropic وصفحات النماذج في Claude Platform وصفحة GPT-6 Astra من OpenAI. سعر الرمز جزء واحد من التكلفة الكلية للمهمة. ادّعاء الكفاءة عند Anthropic هو انخفاض بنسبة 40% في أحمال العمل المعتادة، وهو يجمع بين سعر أقل لكل رمز ورموز أقل لكل مهمة.
النتائج التي نشرتها Anthropic
نشرت Anthropic أرقامها إلى جانب Fable 5.1 وOpus 5 وGPT-6 Astra وGPT-5.6 Sol. اثنان من الرسوم الأربعة أدناه يعرضان الدقة مقابل التكلفة لكل مهمة لا الدقة وحدها، لأن هذه هي المقارنة التي تجريها Anthropic.
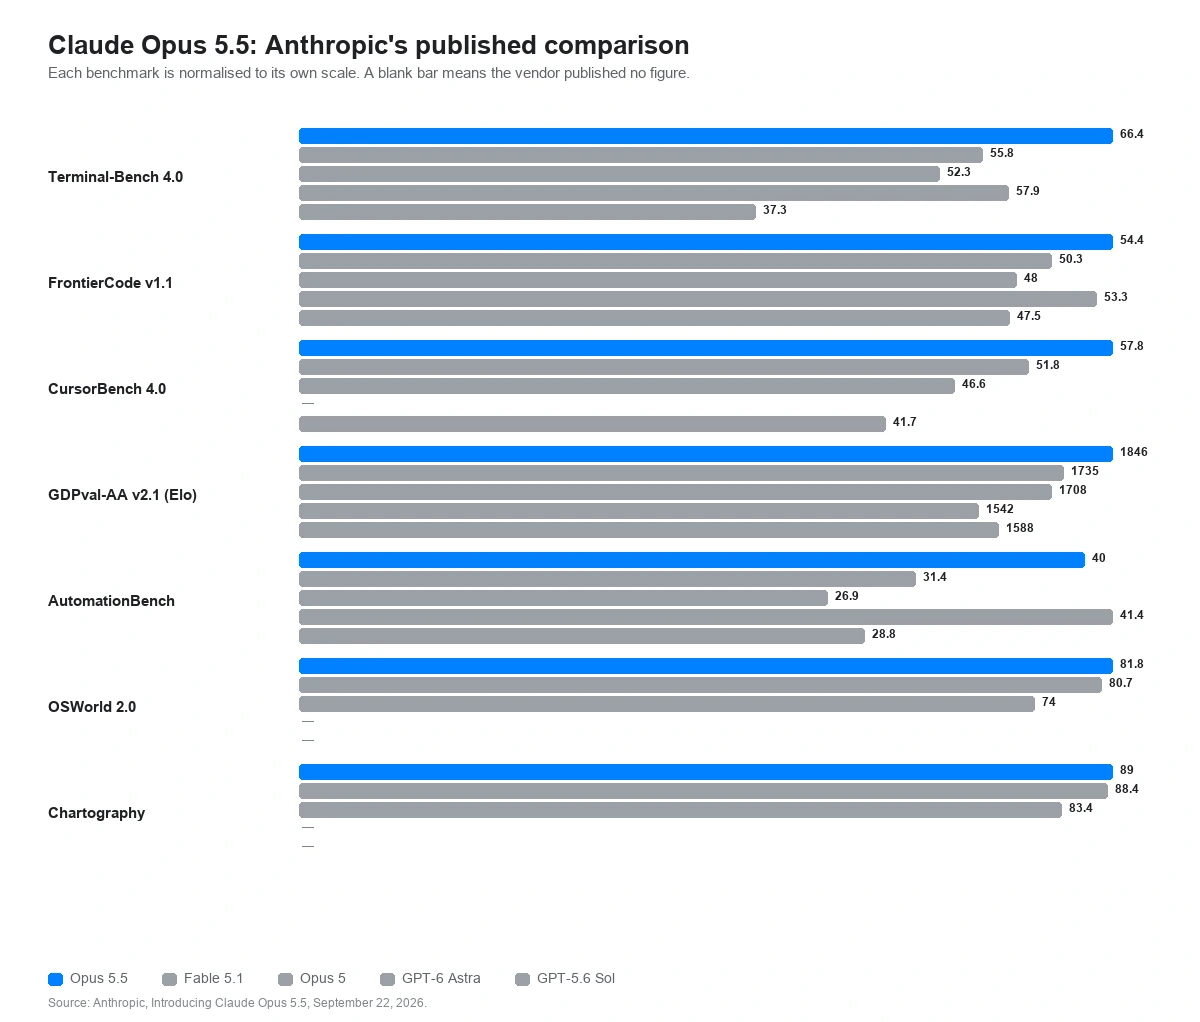
المقارنة الكاملة المنشورة
البرمجة الوكيلية، والعمل المعرفي، وسير العمل التجاري، والاستدلال متعدد التخصصات، والبحث العلمي، واستخدام الحاسوب، وقراءة الرسوم البيانية، على النماذج الخمسة المقيسة.
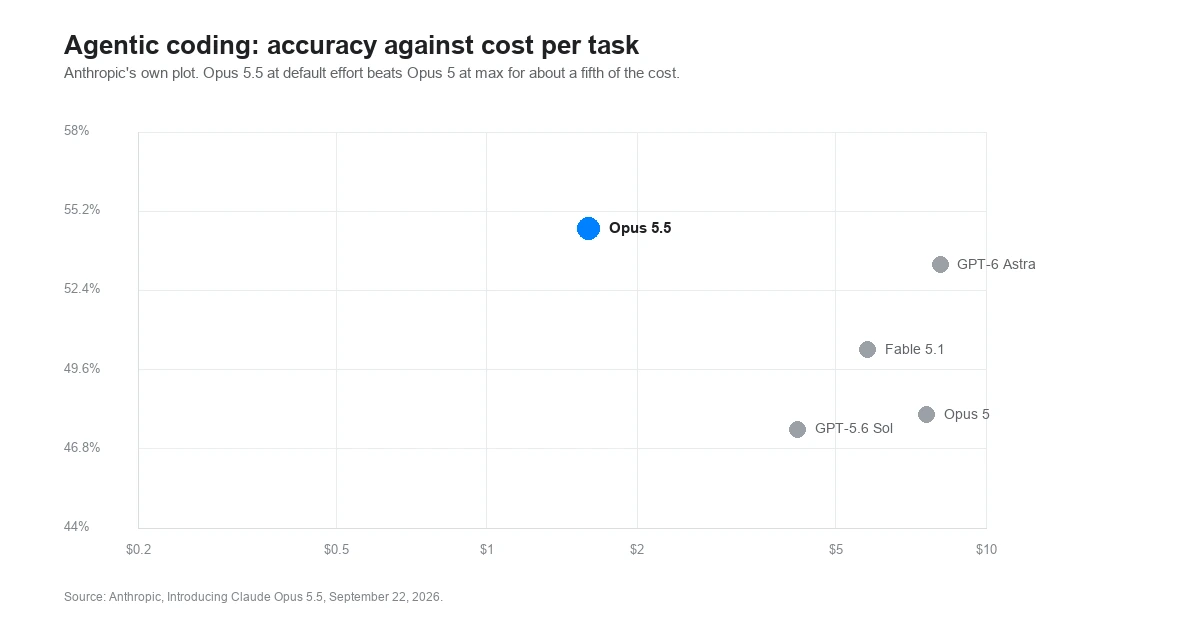
البرمجة الوكيلية
Terminal-Bench 4.0 وFrontierCode v1.1 وCursorBench 4.0، مرسومة كدقة مقابل التكلفة لكل مهمة.
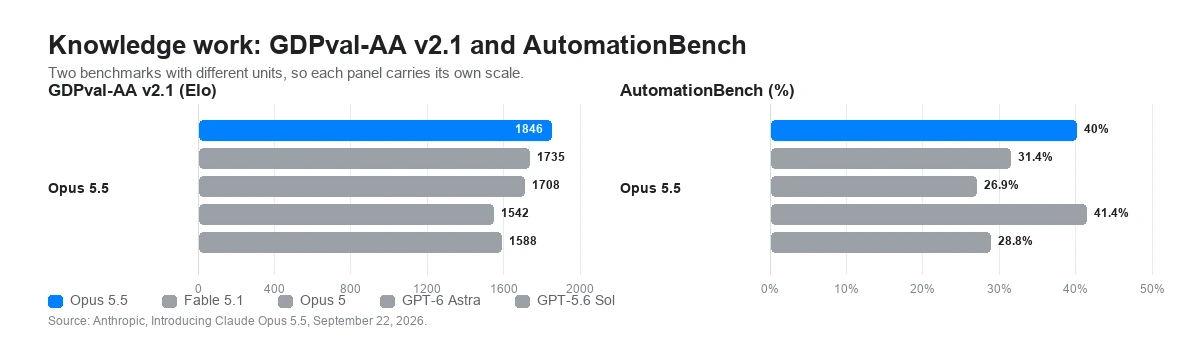
العمل المعرفي
GDPval-AA v2.1 عبر 44 مهنة، وAutomationBench، ومعيار WANDR لجمع البيانات من Perplexity.
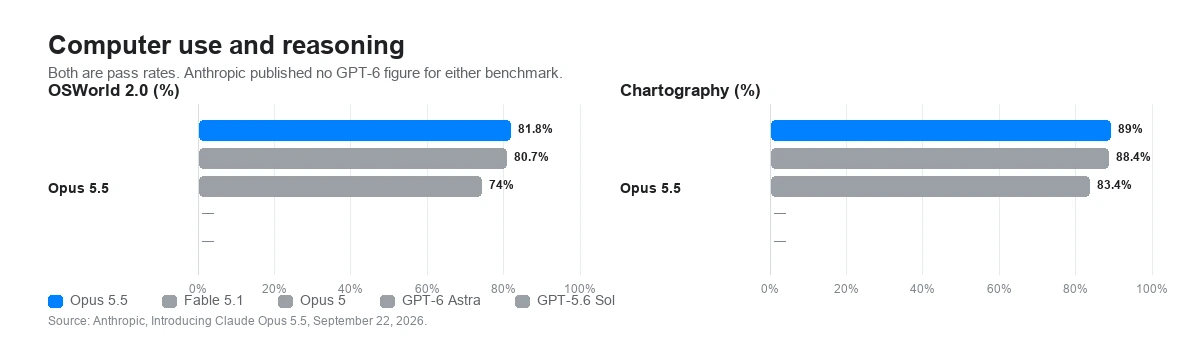
استخدام الحاسوب والاستدلال
OSWorld 2.0 وHumanity's Last Exam وChartography، والأخير يقيس دقة قراءة القيم من الرسم البياني.
الدقة مقابل التكلفة لكل مهمة
الطروحة المركزية عند Anthropic ليست نتيجة أعلى بأي ثمن، بل النتيجة نفسها أو أفضل بجزء يسير من التكلفة لكل محاولة.
أرقام منشورة من المزوّد. وما لم يُذكر خلاف ذلك، شغّلت Anthropic نموذج Opus 5.5 بتفكير تكيّفي عند max effort وقيّمته مع تفعيل ضمانات الإنتاج. وعندما تدخّلت تلك الضمانات، أنجز Opus 4.8 مهام الأمن السيبراني وOpus 5 مهام الأحياء، وهو ما يُرجّح أن يخفض أرقام Opus 5.5 المنشورة في تلك المعايير. أما أرقام GPT-6 Astra وGPT-5.6 Sol فهي كما أبلغت عنها OpenAI. وفروق المعايير بين المزوّدين مؤشر ضعيف على الفروق الفعلية، وهو ما تقوله Anthropic نفسها عن هذه الأرقام.
إذا كنت تشغّل Opus 5 بالفعل
تسرد Anthropic أربعة تغييرات غير متوافقة للتكاملات التي تعمل بالفعل على Claude Opus 5، إضافة إلى تغيير خامس يغيّر شكل الاستجابة دون إفشال أي طلب. يستحق الأمر قراءتها قبل تبديل معرّف النموذج، لأن ثلاثة منها تعيد خطأ 400 بدل أن تتراجع بصمت.
01
في Opus 5 كان التفكير قابلًا للإيقاف عند high وما دونها. أما في Opus 5.5 فهو يعمل دائمًا، وكلٌّ من صيغة الإيقاف وميزانية الرموز اليدوية يعيد خطأ 400. صار effort الضابط الوحيد، وتغيّرت قيمته الافتراضية من high إلى medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
ضبط tool_choice على "any" أو على أداة محدّدة بالاسم يعيد خطأ 400، بما في ذلك في نقطة عدّ الرموز. استخدم auto مع الاستخدام الصارم للأدوات أو المخرجات المنظّمة، ووضّح في الطلب متى تُستخدم الأداة.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
تسجّل كل كتلة تفكير النموذج الذي أنتجها. يقرأ Opus 5.5 كتل Opus 5 ونماذج Opus وSonnet وHaiku الأقدم، لكنه لا يقرأ كتل Fable أو Mythos. وإذا نقل موجّه المحادثة إلى نموذج آخر، تعمل الأدوار التالية دون الاستدلال السابق.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 يحتفظان بالتفكير؛ النماذج الأخرى تُسقطه
04
في Claude API وGoogle Cloud تعيد الأداة computer_20251124 خطأ 400. أعلن بدلًا منها مجموعة computer_toolset_20260801، وأزل ترويسة beta، وكيّف حلقة الوكيل مع كتل member tool_use. أما على Amazon Bedrock فالأداة القديمة ما زالت تعمل.
computer_20251124 -> computer_toolset_20260801
بما أن التفكير لا يمكن إيقافه، فالضبط يكون على effort. يدعم Opus 5.5 المستويات الخمسة كلها ويبدأ عند medium، أي درجة واحدة أقل من Opus 5. وتوصية Anthropic هي إعادة مسح المستويات على تقييماتك الخاصة بدل نقل الإعداد القديم، وتخصيص max_tokens واسع في المستويات العالية، لأن رموز التفكير تُحتسب في هذا الحد حتى عندما لا يُعاد نص التفكير.
effort إشارة سلوكية لا ميزانية رموز صارمة: في المستوى المنخفض يظل النموذج يفكّر في المسائل الصعبة فعلًا، لكن أقل مما يفعل في مستوى أعلى. وتشير Anthropic أيضًا إلى أن Opus 5.5 يميل إلى التفكير أكثر في كل دور مقارنة بـ Opus 5 عند المستوى نفسه، وأبرز ما يكون ذلك عند xhigh وmax، لذا فإن إعدادًا منقولًا من Opus 5 سينتج أدوارًا أطول وأكثر تكلفة.
أين يناسب
يستحق Opus 5.5 كلفته حين تستغرق المهمة ساعات، أو تمتد على ملفات أكثر مما يستطيع شخص واحد الإحاطة به، أو تُنتج شيئًا يجب أن يراجعه شخص آخر. هذه هي الحالات التي تصفها Anthropic ومختبِروها الأوائل، لا طلبات محادثة عامة.
إمرار التغيير عبر مستودع كبير حتى تنجح الاختبارات، بدل التوقف عند أول رقعة تبدو معقولة. تذكر Anthropic أن أحد المختبِرين أنهى ترحيل 680 ألف سطر في أقل من يوم.
ذكرت Column، وهي جهة اختبار استشهدت بها Anthropic، أنها وجدت علّة بالرجوع إلى وثائق خارجية لتكامل طرف ثالث كان قد نُموذج خطأً قبل عدة إيداعات.
بناء النموذج ثم الملخّص من صفحة واحدة، مع الحفاظ على التحفّظات. تذكر Anthropic أن تحليل اندماج انتهى في 63 دقيقة مقابل 93 دقيقة في Opus 5، بنصف التكلفة.
يفوّض النموذج إلى وكلاء فرعيين ويضبط إيقاعه وفق ميزانية زمنية. وتوصي Anthropic بمنح بنية متعددة الوكلاء إشارة بالوقت المنقضي لتتوازى بدل أن تتصفّف.
01
أضف المستودع والمستندات والمتطلبات التي يجب أن تراعيها أي إجابة مفيدة. نافذة المليون رمز موجودة لهذا الغرض.
02
قل ما يجب أن يكون صحيحًا ليُعدّ العمل منتهيًا. وتوصية Anthropic للجلسات غير المراقَبة هي إبقاء أجزاء المهمة في قائمة يحدّثها النموذج.
03
شغّل المهمة نفسها على Opus 5.5 وOpus 5 وFable 5.1 في Felo. قارن الاختبارات والتحفّظات واستهلاك الرموز، لا الإجابة وحدها.
اختر Claude Opus 5.5 عندما يظهر في مُحدِّد النماذج في حسابك.
جرّب Opus 5.5 على FeloClaude Opus 5.5 هو نموذج Anthropic للبرمجة الوكيلية الطويلة والعمل المعرفي، صدر في 22 سبتمبر 2026 كأول نموذج في عائلة Claude 5.5. وتقول Anthropic إنه يبلغ مستوى Claude Fable 5.1 في معظم المهام مع تكلفة تشغيل أقل بنسبة 40% من Claude Opus 5.
ضع Claude Opus 5.5 إلى جانب النماذج الرائدة الأخرى في Felo، ثم جرّبه على العمل الذي تؤجّله لأنه يستغرق ساعات.
جرّب Opus 5.5 على Feloابدأ من بحث Felo AI واختر النموذج حيث يكون متاحًا.