أُعلن في 30 سبتمبر 2026 · يُطرح على مراحل

Gemini 4 Argonبحث طويل، مكتوب كاملًا

أول نموذج رائد من Google منذ Gemini 3، بُني للاستدلال العميق في العمل الطويل متعدد الخطوات. يرفع سقف المخرجات من 64K رمزًا إلى 1M، ويتقدّم في أرقام Google المنشورة على العمل المعرفي لا على البرمجة.

‏Felo API في نسخة تجريبية مغلقة — والوصول إلى Gemini 4 Argon سيتاح قريبًا.
الصورة الرئيسية لـ Gemini 4 Argon: اسم النموذج إلى جانب الرقم 4 كبير على تدرّج أزرق
صورة الإعلان من Google. يصدر Argon ضمن نظام تسمية جديد لا كتحديث لخط Gemini 4.0، ولهذا لا يحمل الاسم رقم إصدار.
1M
أقصى رموز المخرجات
ارتفاع من 64K — تقرير كامل يُنتج في مسار واحد.
2 $ / 10 $
سعر API التمهيدي
لكل مليون رمز إدخال وإخراج. والإدخال المخزَّن مؤقتًا بخصم 95%.
77.9%
DeepSWE v1.1
النتيجة التي أعلنتها Google، متقدّمة على Claude Opus 5.5 وGPT-6 Astra.
15%
معدّل الهلوسة
الأدنى بين النماذج الرائدة بحسب قياس Artificial Analysis.

الأرقام والرسوم البيانية في هذه الصفحة مأخوذة من الجهات التي نشرتها — Google وArena.ai وArtificial Analysis — وتُعرض من دون تعديل.

حالة الإطلاق

‏Argon ليس متاحًا للعموم بعد. وهذا ترتيب وصوله.

تطلق Google نموذج Argon على مراحل، والمرحلة الأولى ليست العامة. ويجري تجهيز الوصول إليه داخل Felo بالتوازي مع هذا الإطلاق.

متاح الآن

مدافعون موثوقون في الأمن السيبراني

يحصل شركاء مختارون في برنامج Fairwind من Google على Argon أولًا، ويحصلون عليه من دون ضوابط الحماية السيبرانية.

المرحلة المُعلنة التالية

عملاء API المدفوع وGoogle AI Ultra

تقول Google إن الوصول الأوسع يبدأ من هنا. ولم يُحدَّد موعد، والاشتراك وحده لا يمنح الوصول اليوم.

بلا موعد بعد

المطوّرون والمؤسسات والمستخدمون

يأتي بعد الطبقتين المدفوعتين. ولم تلتزم Google بجدول زمني للإتاحة العامة.

الوصول إلى Argon داخل بحث Felo قيد التجهيز. وستُحدَّث هذه الصفحة عند فتحه.

ما يجيده

نموذج بُني لإنجاز العمل الطويل، لا للردّ السريع

تتمركز نقاط القوة المنشورة لـ Argon حول القراءة والاستدلال والكتابة الطويلة. وهذا شكل مختلف عن النماذج الرائدة الموجَّهة للبرمجة التي تُعقد معها المقارنة.

استدلال يصمد في مهمة طويلة

تضع Google نموذج Argon للعمل متعدد الخطوات الذي يمتد ساعات، حيث كانت النماذج السابقة تنحرف أو تتوقف مبكرًا.

‏1M رمز من المخرجات في مسار واحد

سبب الزيادة كما تذكره Google: النموذج الذي يملك مساحة للتفكير الطويل يحلّ مسألة صعبة في مسار واحد بدل جولات عديدة.

العمل المعرفي في المقدمة، لا البرمجة

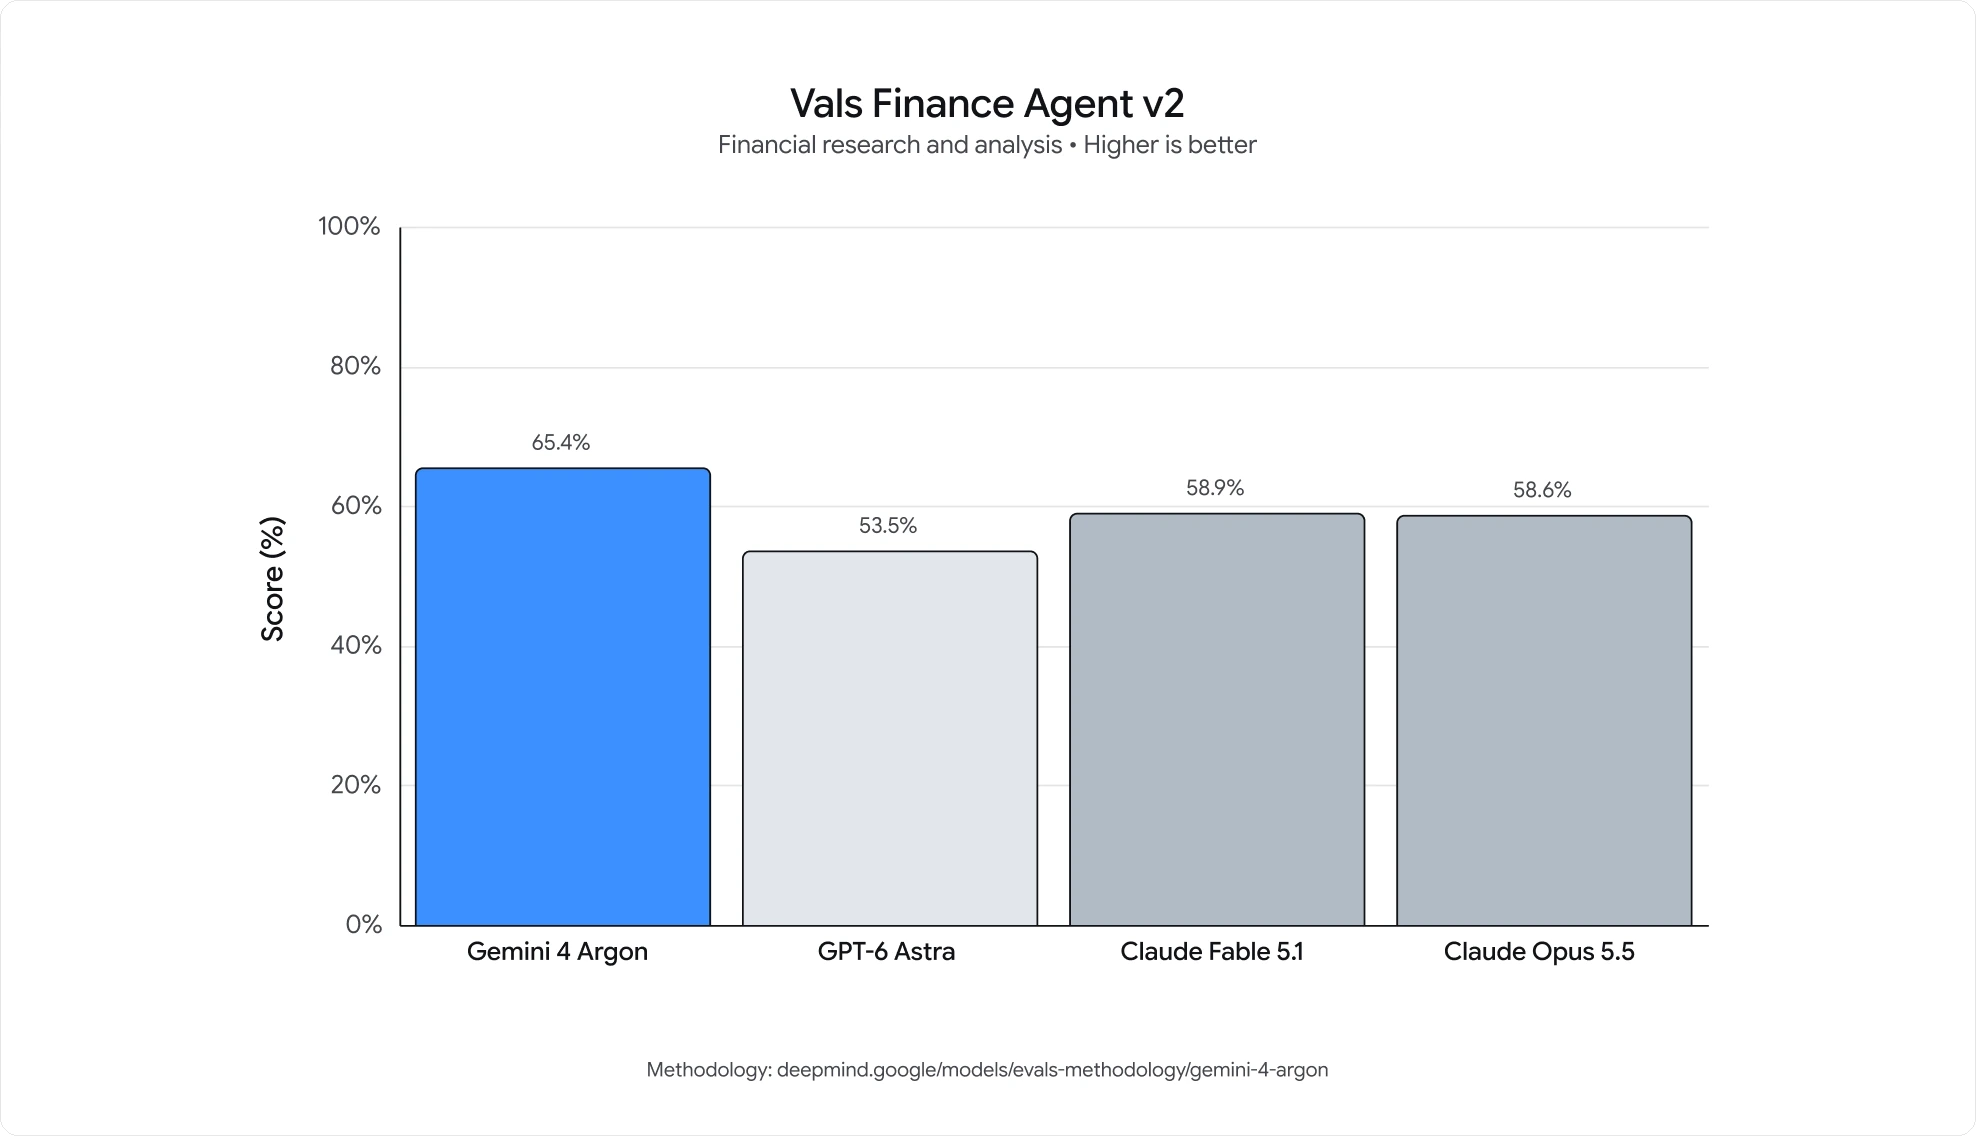
أوسع الفروق المُعلنة تأتي في Harvey's Legal Agent Benchmark وVals Finance Agent v2 — أي تحليل قانوني ومالي حقيقي، لا مهام اصطناعية.

استرجاع لسياق طويل يصمد

في GraphWalks، الذي يختبر هل يستطيع النموذج فعلًا استخدام سياق بين 256K و1M، تُعلن Google تقدّمًا يزيد على عشر نقاط على النماذج الرائدة الأخرى.

فهم الفيديو الطويل

‏LVBench، الذي يقيس الفهم في الفيديو الطويل، مسجَّل عند 91.7% — وهو أعلى نتيجة تدرجها Google لـ Argon.
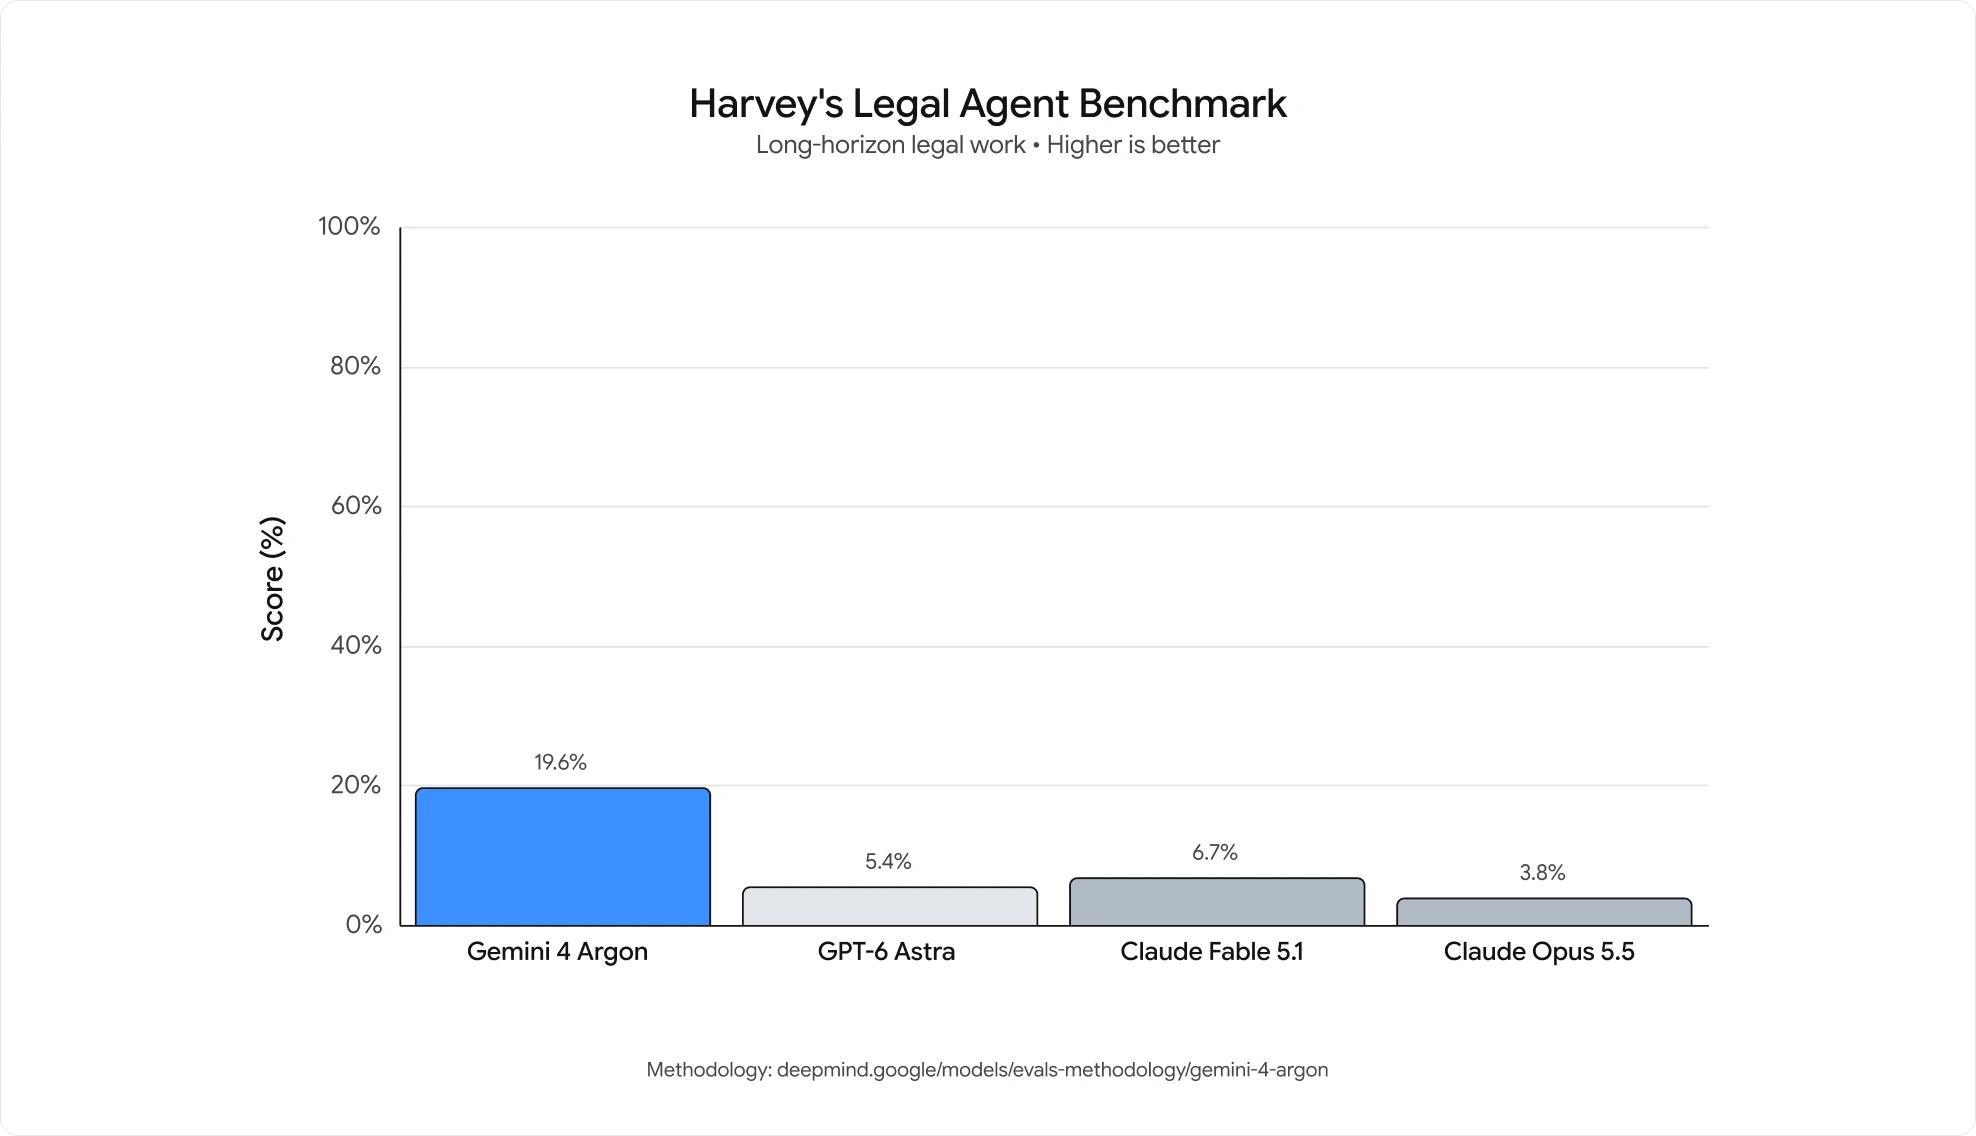
رسم بياني بالأعمدة لـ Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%، Claude Fable 5.1 6.7%، GPT-6 Astra 5.4%، Claude Opus 5.5 3.8%
عمل قانوني طويل المدى. نسبة Argon البالغة 19.6% تعادل نحو ثلاثة أضعاف نتيجة النموذج التالي، وهي أوسع فارق في مجموعة Google المنشورة.
رسم بياني بالأعمدة لـ Vals Finance Agent v2: Gemini 4 Argon 65.4%، Claude Fable 5.1 58.9%، Claude Opus 5.5 58.6%، GPT-6 Astra 53.5%
البحث والتحليل المالي، بنسبة 65.4% مقابل مجموعة تتراوح بين 53.5% و58.9%. فارق أضيق من العمل القانوني، لكن الترتيب نفسه.

الأرقام المنشورة

أين يقف Argon في معايير Google نفسها

هذه نتائج معلنة من المزوّد. ولم تنشر Google إعداد thinking أو effort للنتائج الرئيسية، ولم يكرّرها أي مختبر مستقل بعد.

المعيار
ما يقيسه
Argon
أقرب مقارنة
DeepSWE v1.1
هندسة برمجيات طويلة المدى
77.9%
‏Opus 5.5 عند 74.2% وGPT-6 Astra عند 74.1%
CWE-bench v1
إيجاد الثغرات وترقيعها
68%
يتقاسم المركز الأول
AutomationBench
مهام أعمال من طرف إلى طرف، من Zapier
51.3%
في المركز الأول
LVBench
فهم الفيديو الطويل
91.7%
أعلى نتيجة تعلنها Google لـ Argon

تعامل مع هذه الأرقام كإشارات اتجاه. فنادرًا ما تصمد معايير المزوّدين دون تغيير عند لقائها بأحمال العمل الفعلية، وقد ذكرت Bloomberg أن بعض العاملين في Google أنفسهم يشكّون في أن تقدّم المعايير ينتقل إلى العمل الحقيقي.
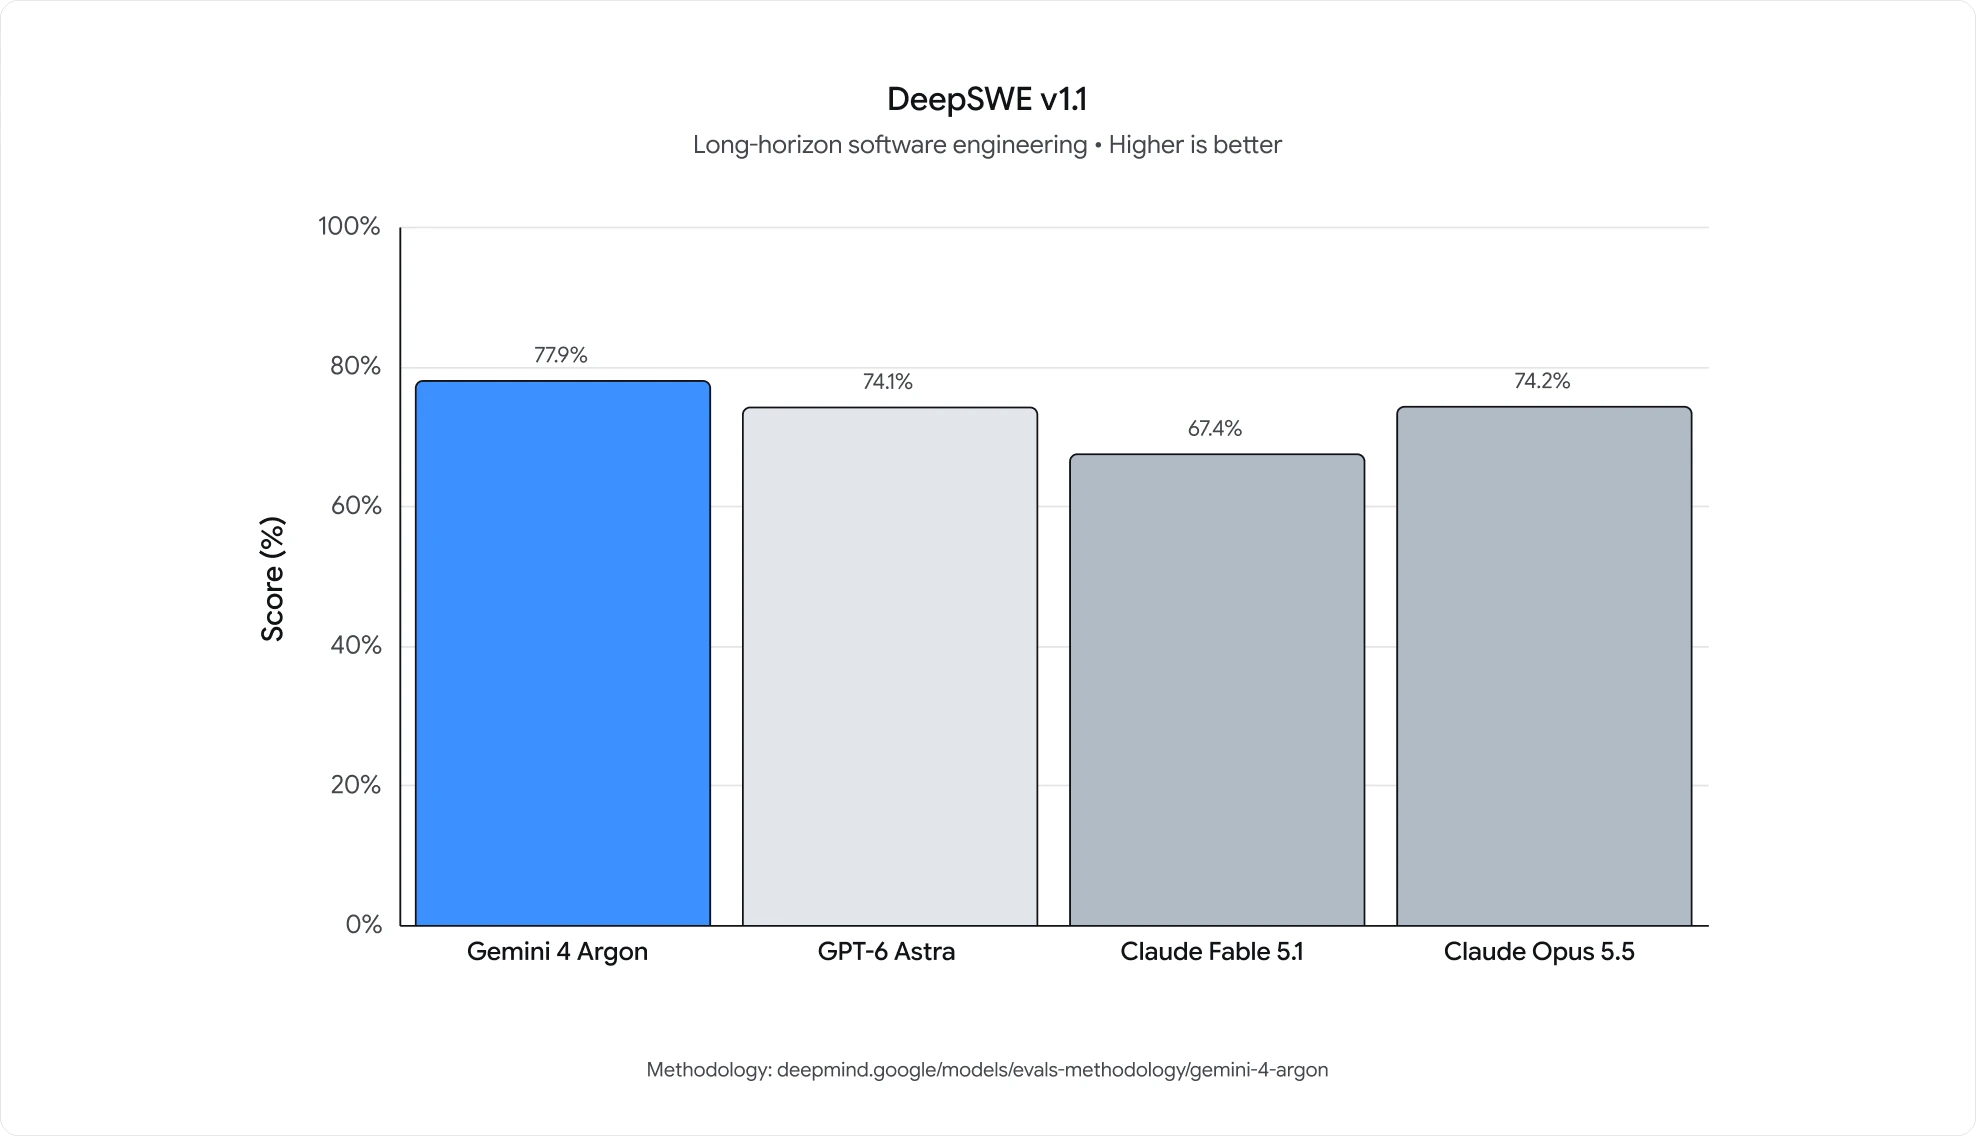
رسم بياني بالأعمدة لـ DeepSWE v1.1: Gemini 4 Argon 77.9%، Claude Opus 5.5 74.2%، GPT-6 Astra 74.1%، Claude Fable 5.1 67.4%
هندسة برمجيات طويلة المدى. الرقم الرئيسي 77.9%، مع أقرب منافسين في نطاق أربع نقاط منه.
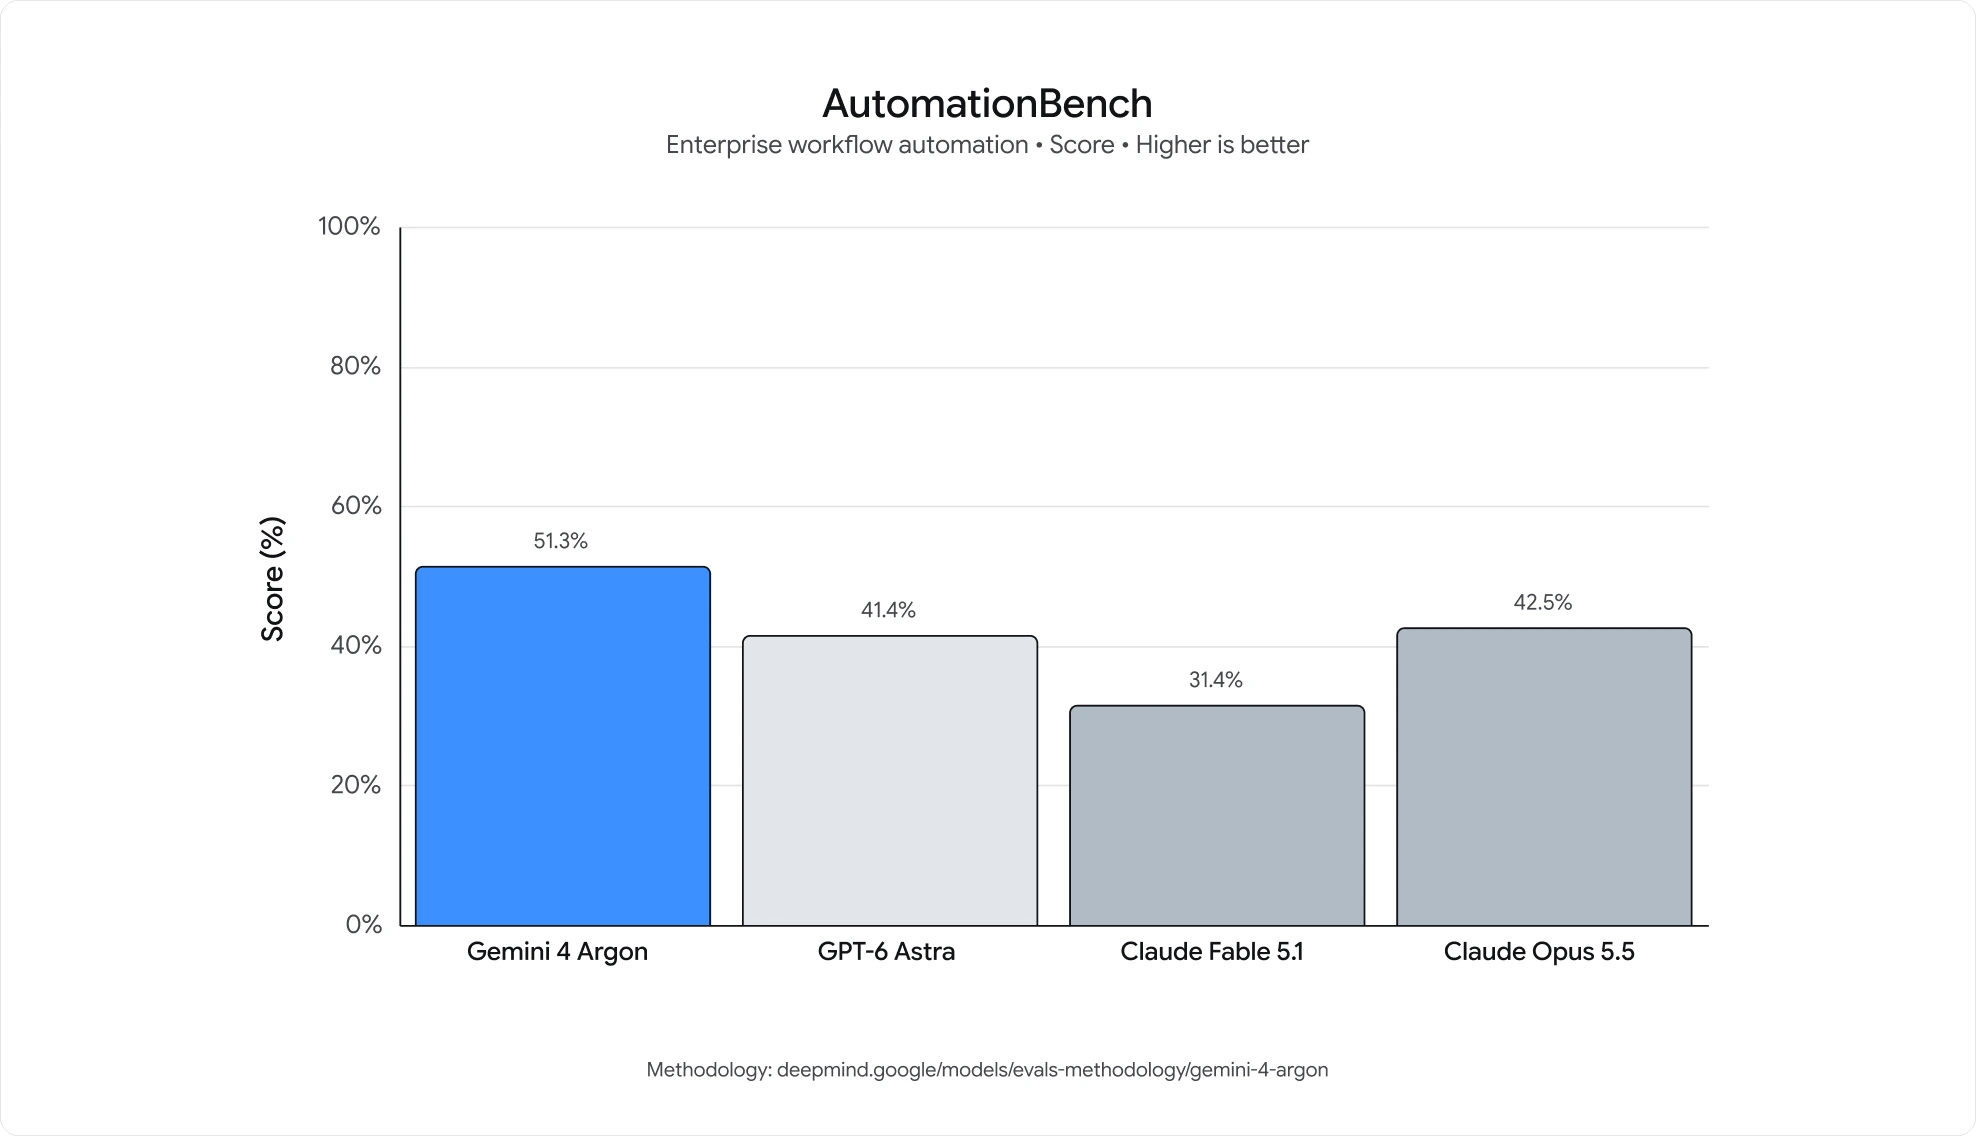
رسم بياني بالأعمدة لـ AutomationBench: Gemini 4 Argon 51.3%، Claude Opus 5.5 42.5%، GPT-6 Astra 41.4%، Claude Fable 5.1 31.4%
مهام أعمال من طرف إلى طرف، من بناء Zapier. يتجاوز Argon حاجز 50% بينما تقع كل النماذج الأخرى في المقارنة في الثلاثينيات أو أوائل الأربعينيات.
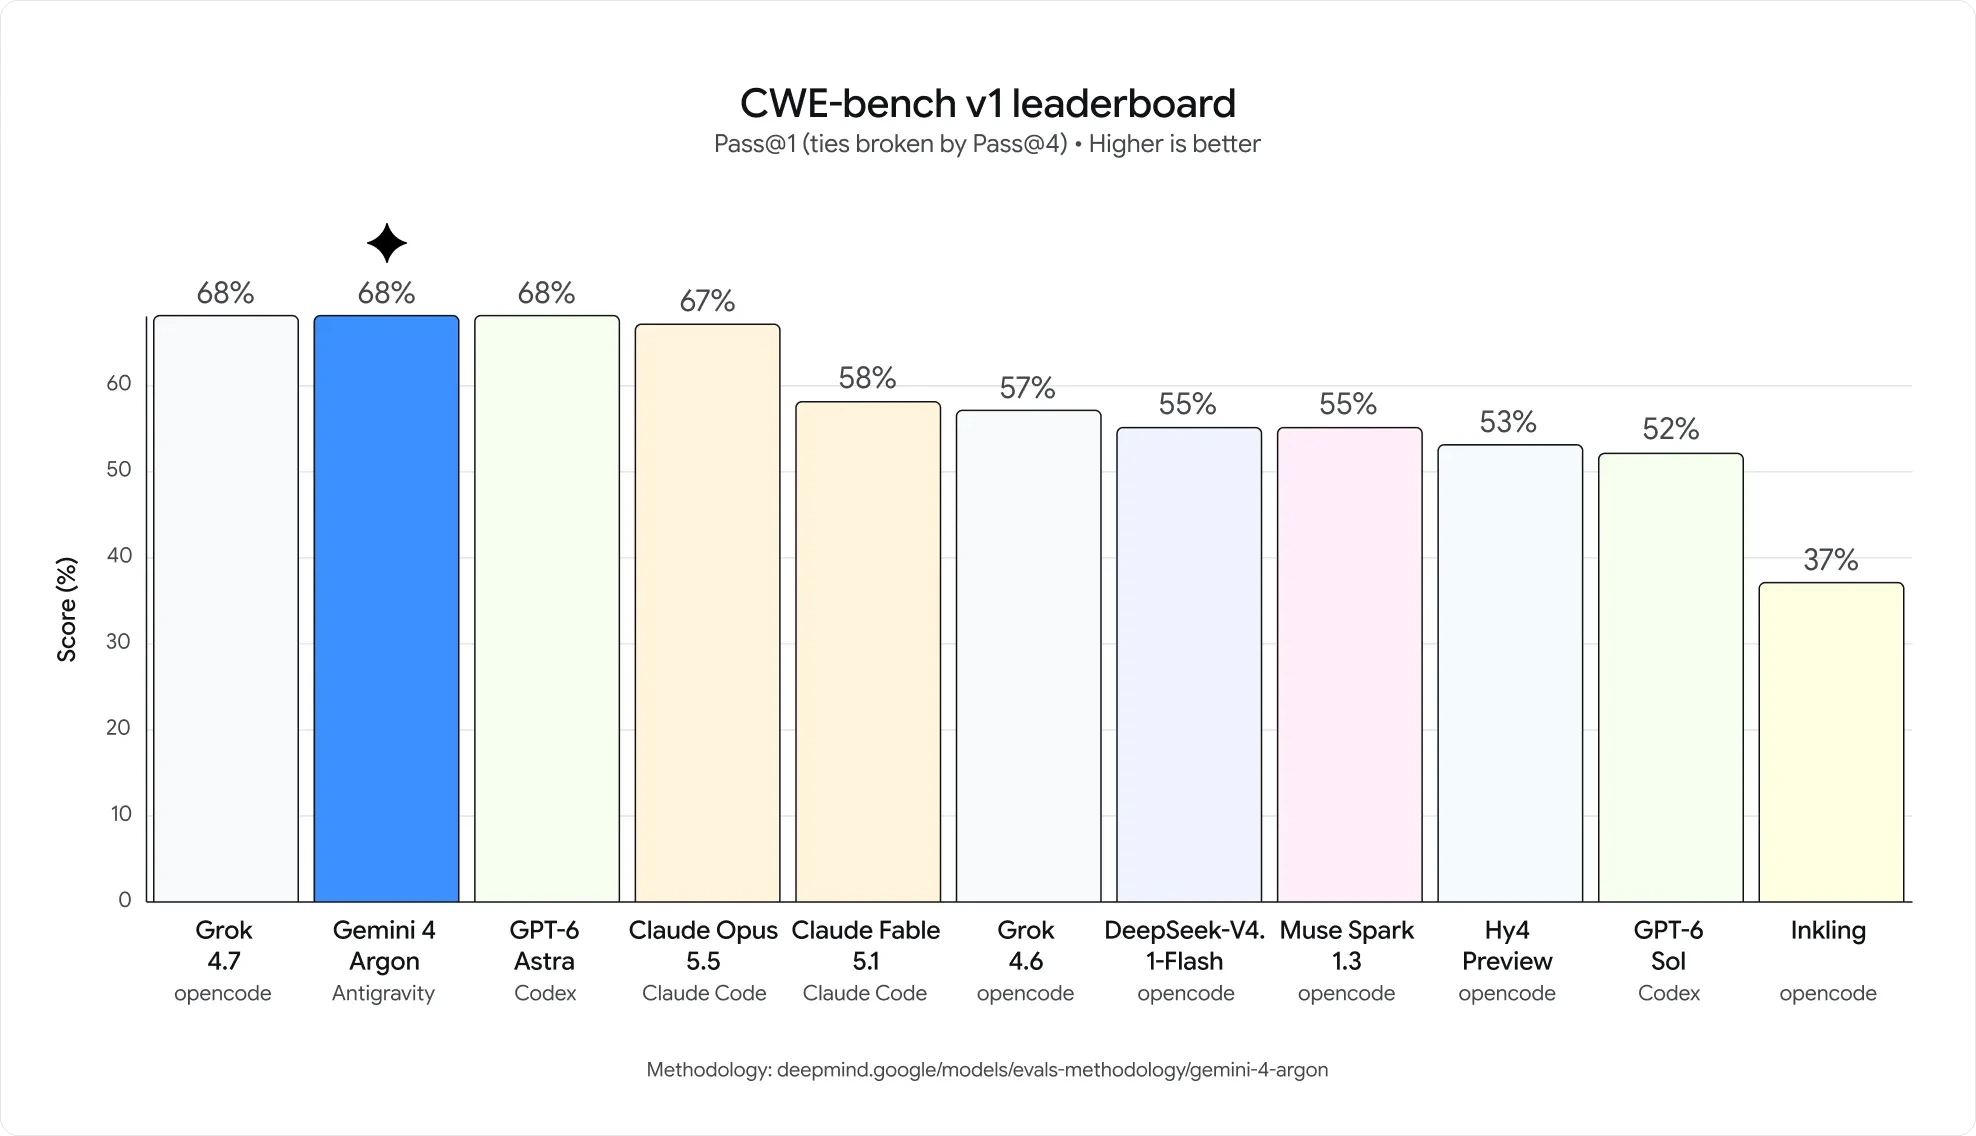
لوحة صدارة CWE-bench v1: Gemini 4 Argon وGrok وGPT-6 Astra في تعادل عند 68%، وClaude Opus 5.5 عند 67%، ثم ينحدر التدرّج إلى Inkling عند 37%
اكتشاف الثغرات عند Pass@1. يشارك Argon قمة لوحة مزدحمة بدل أن يصنع فجوة، ولهذا يصفه الجدول أعلاه بالتعادل في المركز الأول.
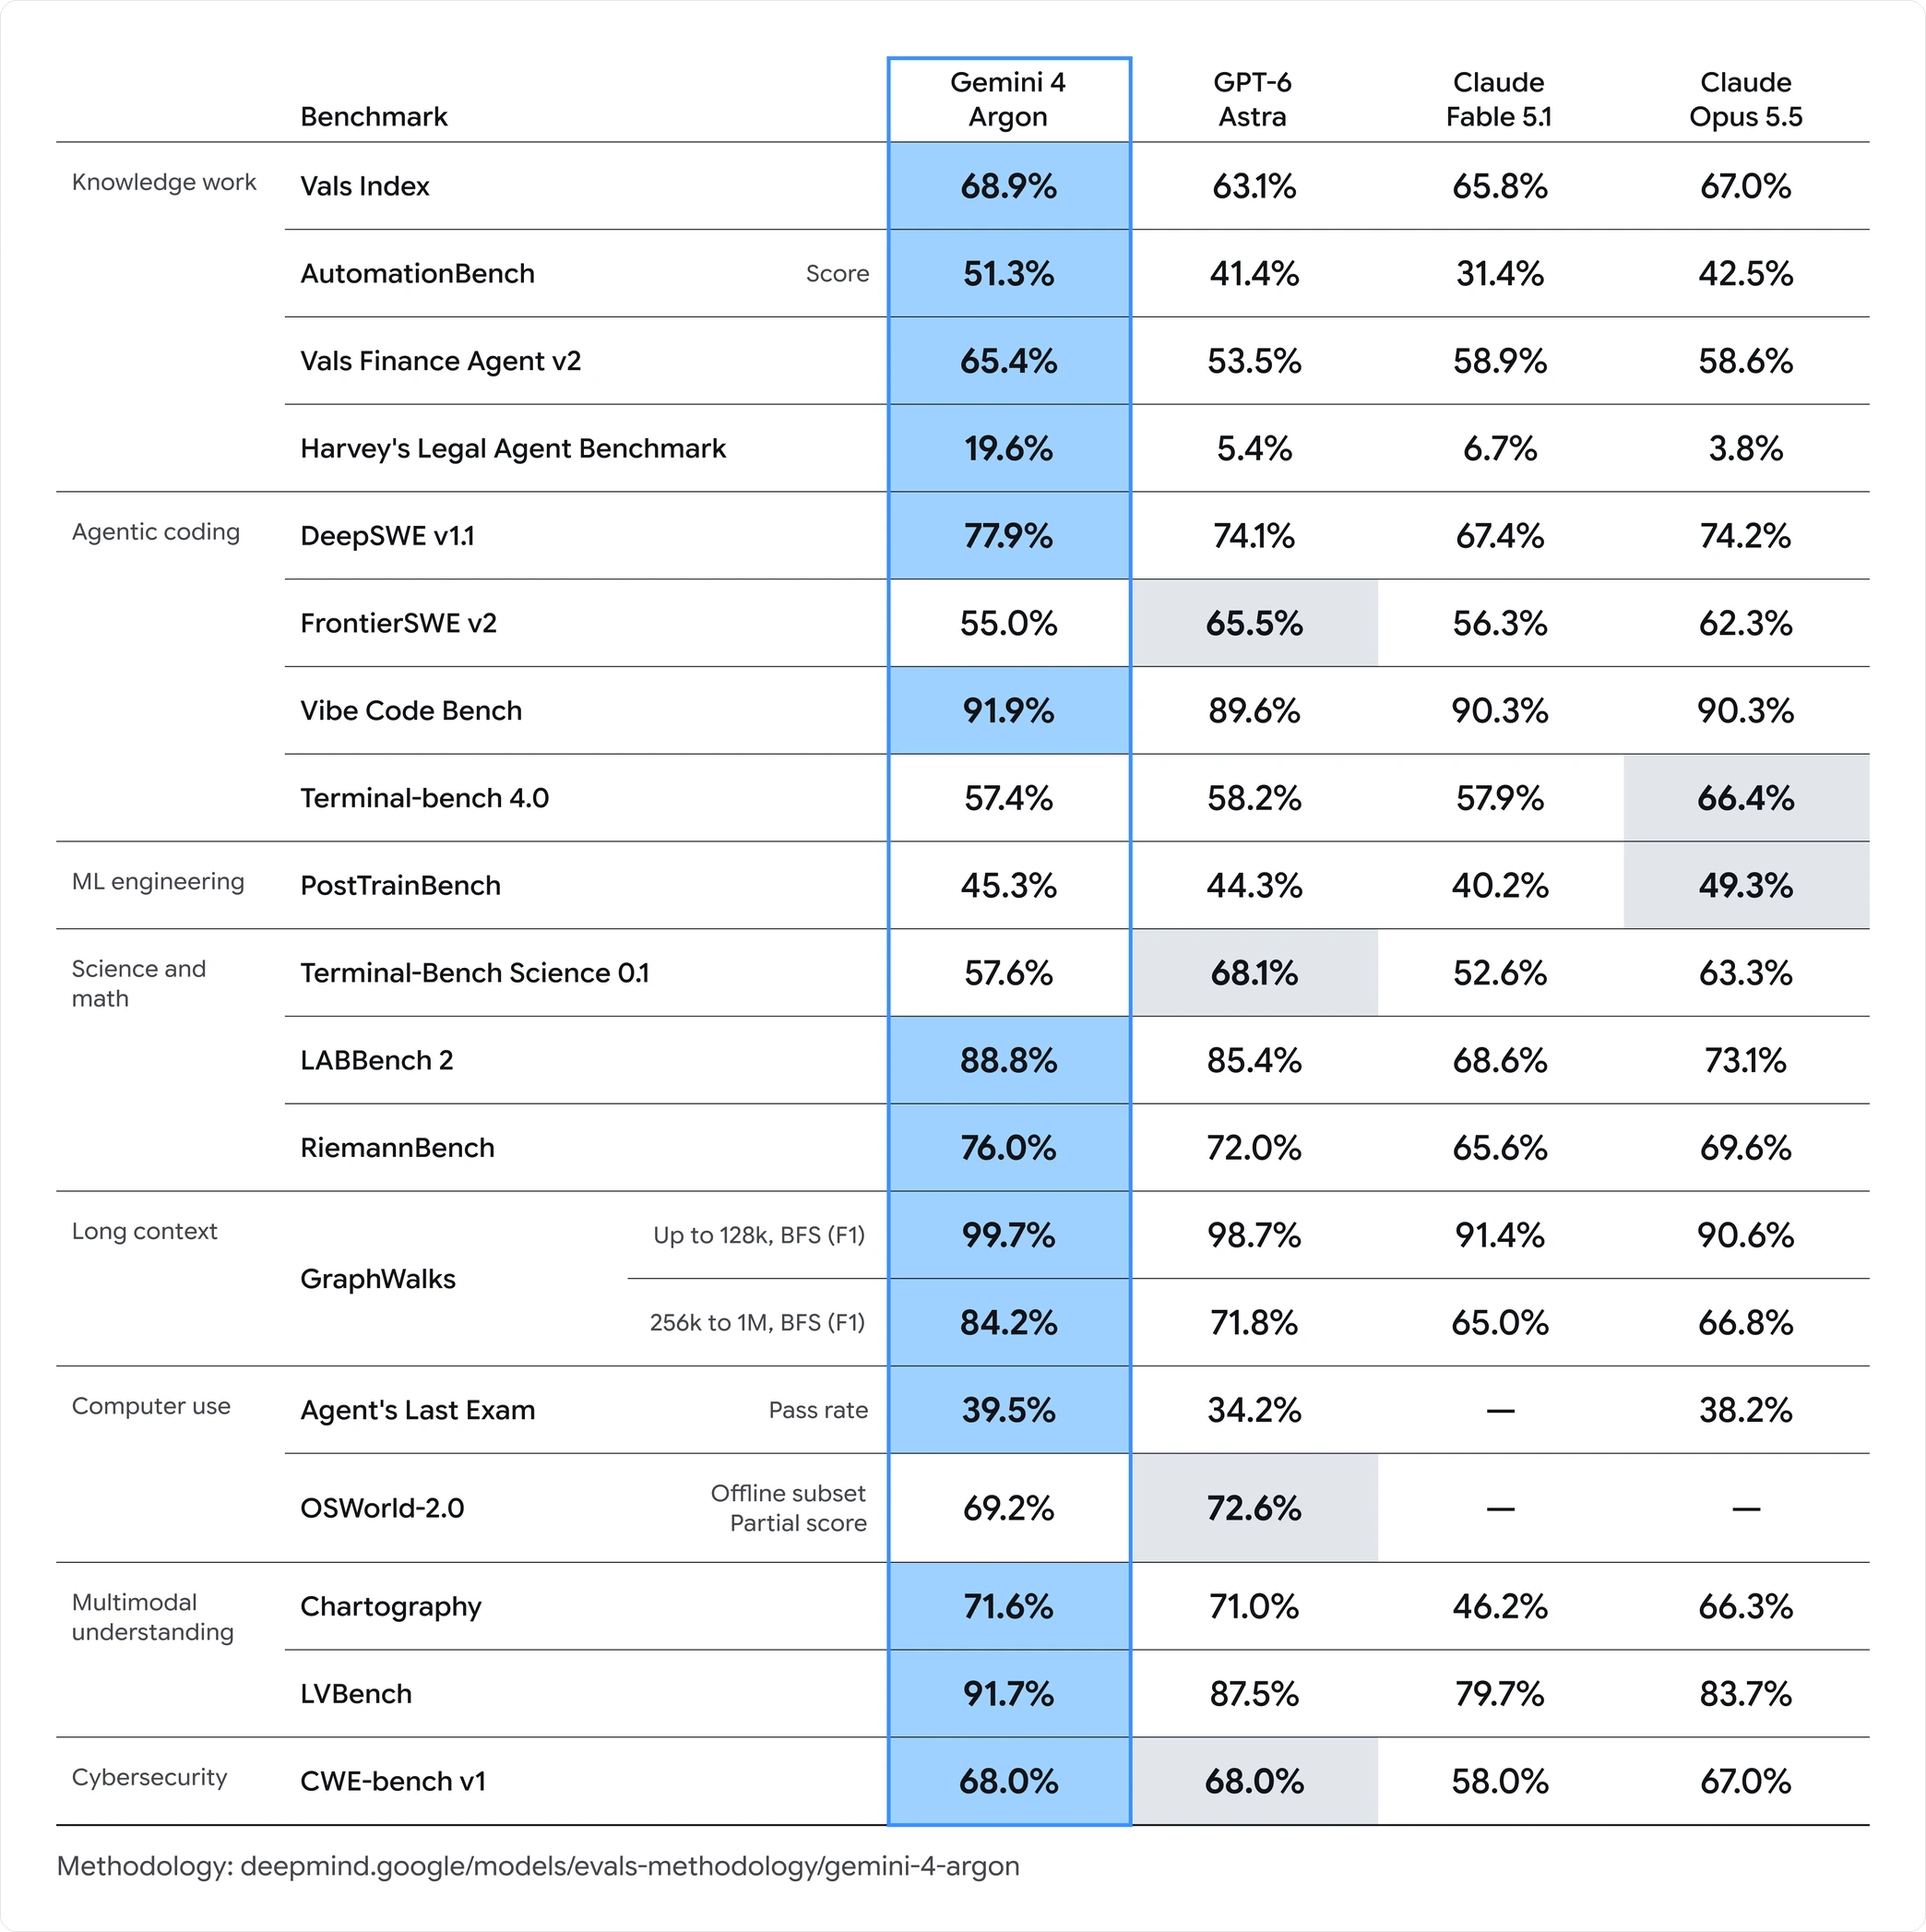
جدول نتائج Google الكامل لـ Gemini 4 Argon عبر 16 معيارًا، مصنَّفًا إلى العمل المعرفي، والبرمجة الوكيلية، وهندسة تعلّم الآلة، والعلوم والرياضيات، والسياق الطويل، واستخدام الحاسوب، والفهم متعدد الوسائط، والأمن السيبراني
الجدول الكامل من الإعلان، مع انتصارات Argon بالأزرق والخلايا التي يتقدّم فيها منافس بالرمادي. FrontierSWE v2 وTerminal-Bench 4.0 وPostTrainBench وTerminal-Bench Science 0.1 وOSWorld-2.0 هي الصفوف التي لا يتقدّم فيها Argon.
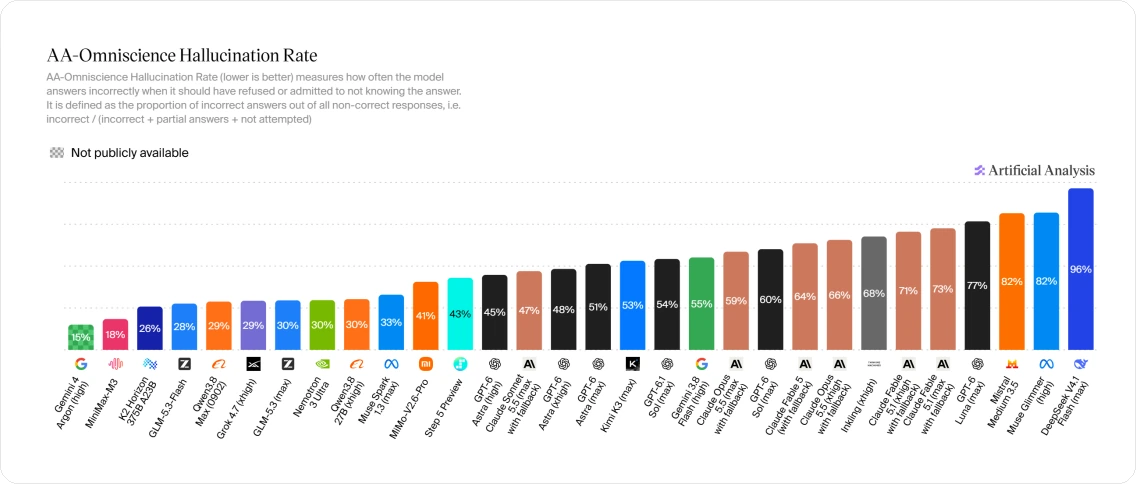
رسم بياني بالأعمدة لمعدّل الهلوسة في AA-Omniscience من Artificial Analysis عبر 36 نموذجًا، مرتّبة من الأدنى إلى الأعلى: Gemini 4 Argon (High) عند 15%، ثم MiniMax-M3 عند 18%، وKimi K2.5 عند 26%، وصولًا إلى DeepSeek-V4 Flash عند 96%
قياس مستقل من Artificial Analysis، وهو الرقم الوحيد في هذه الصفحة الذي لم يقدّمه أي مورّد: كم مرة يجيب كل نموذج إجابة خاطئة بدلًا من الامتناع عن الإجابة. نسبة Argon البالغة 15% هي الأدنى بين النماذج الـ36 المرسومة؛ ويمتد المقياس حتى 96%.
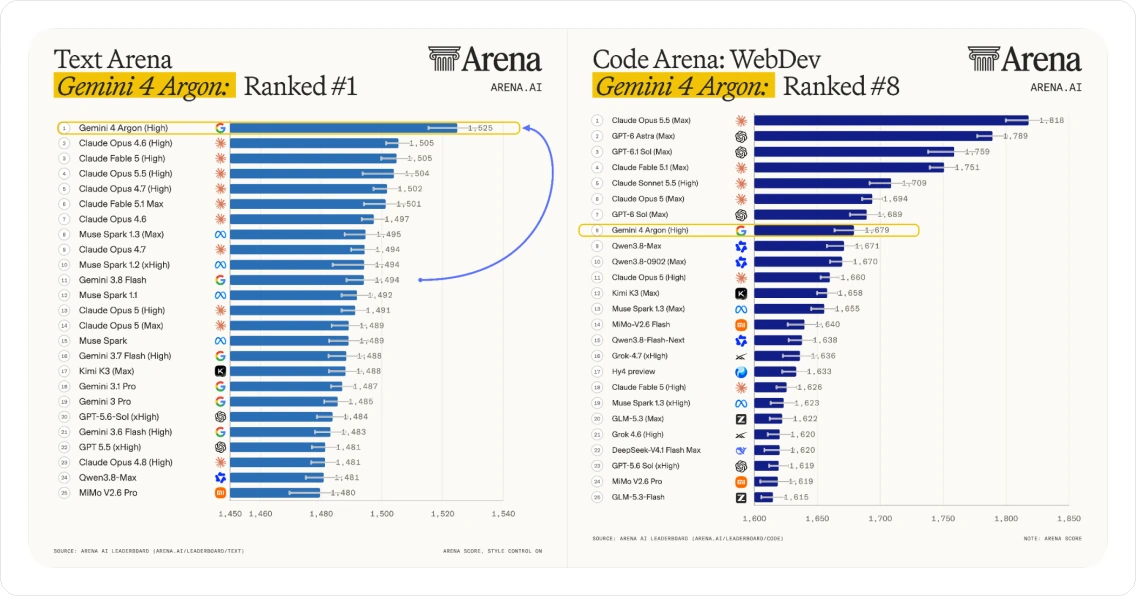
لوحتا الصدارة في Arena.ai — Text Arena وCode Arena: WebDev — جنبًا إلى جنب: Gemini 4 Argon في المركز الأول في Text Arena عند 1,625، والثامن في Code Arena: WebDev عند 1,679
الترتيبان اللذان تستند إليهما الفقرة أعلاه، من لوحات Arena.ai التي يحدّدها تصويت الجمهور. يتصدّر Argon قائمة Text Arena البالغ عدد نماذجها 25؛ وفي Code Arena: WebDev يحلّ ثامنًا، خلف أربعة نماذج من Claude وثلاثة من سلسلة GPT-6 من OpenAI.

على Felo

كيف يبدو مسار بحث مع نموذج يكتب 1M رمز

تجمع Felo بين البحث وفهم المستندات، لذا يغيّر نموذج ذو مخرجات طويلة ما يمكن أن تنتجه الجلسة الواحدة.

بحث ينتهي بمستند

اجمع المصادر، ثم اجعل النموذج يكتب التوليف في مسار واحد بدل تجميعه قسمًا قسمًا عبر مطالبات كثيرة.

مجموعات مستندات كاملة في مهمة واحدة

الاسترجاع من سياق طويل هو القدرة الأقوى عند Argon، وهي ما يجعل مجموعات العقود والإفصاحات والتقارير الطويلة قابلة للعمل.

كتابة تهمّ فيها النبرة

الملف المعلن لـ Argon — نص قوي وبرمجة متوسطة — يناسب الفرق التي تحتاج نصًا يُقرأ كأنه مكتوب، لا مُجمَّع.

التكلفة

كم يكلّف Argon، وما الذي يتغيّر لاحقًا

نشرت Google سعرًا تمهيديًا وسعرًا أعلى في القائمة، دون أن تقول متى يحدث التحوّل. فابنِ ميزانيتك على الرقم الأعلى.

نوع الرمز
تمهيدي
لاحقًا
الإدخال
2.00 $ / M
4.00 $ / M
الإدخال المخزَّن مؤقتًا
خصم 95%
خصم 95%
الإخراج
10.00 $ / M
20.00 $ / M

للمقارنة، يأتي السعر التمهيدي قريبًا من مستوى GPT-6.1 Sol وSonnet 5.5، وعند نحو خُمس GPT-6 Astra. وهذه أسعار قائمة لا تكلفة مقيسة لكل مهمة — فـ Argon يجيب عن أسئلة أصعب، لذا قد تظل التكلفة أعلى في التشغيل الواحد.

كيف تعمل مع Argon على Felo

01

أحضر السؤال كاملًا

أعطِ Felo مجموعة المستندات أو المحادثة الطويلة نفسها، لا ملخّصًا لها. فميزة Argon تبدأ حيث يتوقف السياق عن الاتساع في مطالبة واحدة.

02

اطلب الناتج النهائي

مع سقف مخرجات يبلغ 1M رمز يمكنك طلب التقرير الكامل أو المسودة الكاملة بتعليمة واحدة بدل تقسيمها إلى أقسام.

03

تحقّق منه مقابل المصادر

تُبقي Felo الاستشهادات ملتصقة بالجواب، وهو ما يجعل مستندًا طويلًا مولَّدًا من نموذج قابلًا للمراجعة.

الوصول إلى Argon داخل بحث Felo قيد التجهيز. وإلى أن يُفتح، تبقى كل النماذج الأخرى في تشكيلة Felo متاحة الآن.

افتح بحث Felo AI

Gemini 4 Argon: أسئلة شائعة

ليس للعموم. فقد أطلقت Google نموذج Argon أولًا لشركاء مختارين في برنامج Fairwind، وتقول إن الوصول الأوسع سيبدأ بعملاء API المدفوع ومشتركي Google AI Ultra. ولم يُعلن موعد لتلك المرحلة، والاشتراك المدفوع لا يمنح الوصول اليوم.

جرّب النماذج الرائدة من Google على Felo

ابحث واقرأ واكتب بالنموذج الذي يناسب المهمة. وينضم Argon إلى التشكيلة عندما يصل إطلاقه إلى Felo.

افتح بحث Felo AI

لا حاجة إلى بطاقة ائتمان لاستخدام بحث Felo AI.