Disponible maintenant
Défenseurs cyber de confiance
Les partenaires sélectionnés du programme Fairwind de Google reçoivent Argon en premier, et sans les garde-fous habituels en cybersécurité.
Annoncé le 30 septembre 2026 · Déploiement par étapes
Le premier modèle frontière de Google depuis Gemini 3, conçu pour raisonner en profondeur sur de longs travaux en plusieurs étapes. Il fait passer le plafond de sortie de 64K à 1M tokens et mène les chiffres publiés par Google sur le travail de connaissance, pas sur le code.
L'API Felo est en bêta fermée — l'accès à Gemini 4 Argon arrive bientôt.
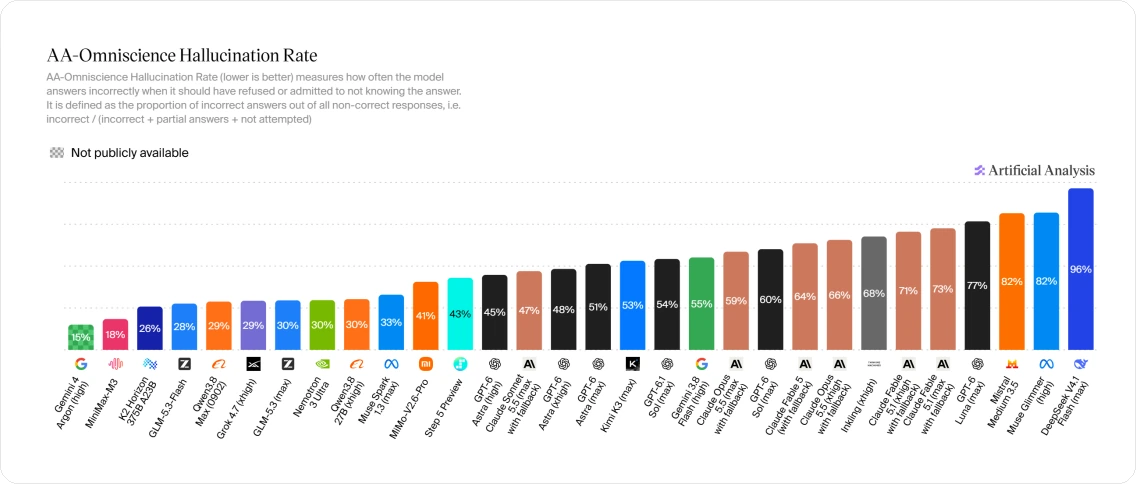
Les chiffres et les graphiques de cette page proviennent des organisations qui les ont publiés — Google, Arena.ai et Artificial Analysis — et sont reproduits sans modification.
État du déploiement
Google déploie Argon par étapes, et la première n'est pas publique. L'accès dans Felo est en cours de préparation, en parallèle de ce déploiement.
Disponible maintenant
Les partenaires sélectionnés du programme Fairwind de Google reçoivent Argon en premier, et sans les garde-fous habituels en cybersécurité.
Annoncé ensuite
Google indique que l'accès élargi commence ici. Aucune date n'a été donnée, et un abonnement seul ne l'ouvre pas aujourd'hui.
Pas encore planifié
Vient après les offres payantes. Google ne s'est pas engagé sur un calendrier pour la disponibilité générale.
L'accès à Argon dans la recherche Felo est en cours. Cette page sera mise à jour à son ouverture.
Ses points forts
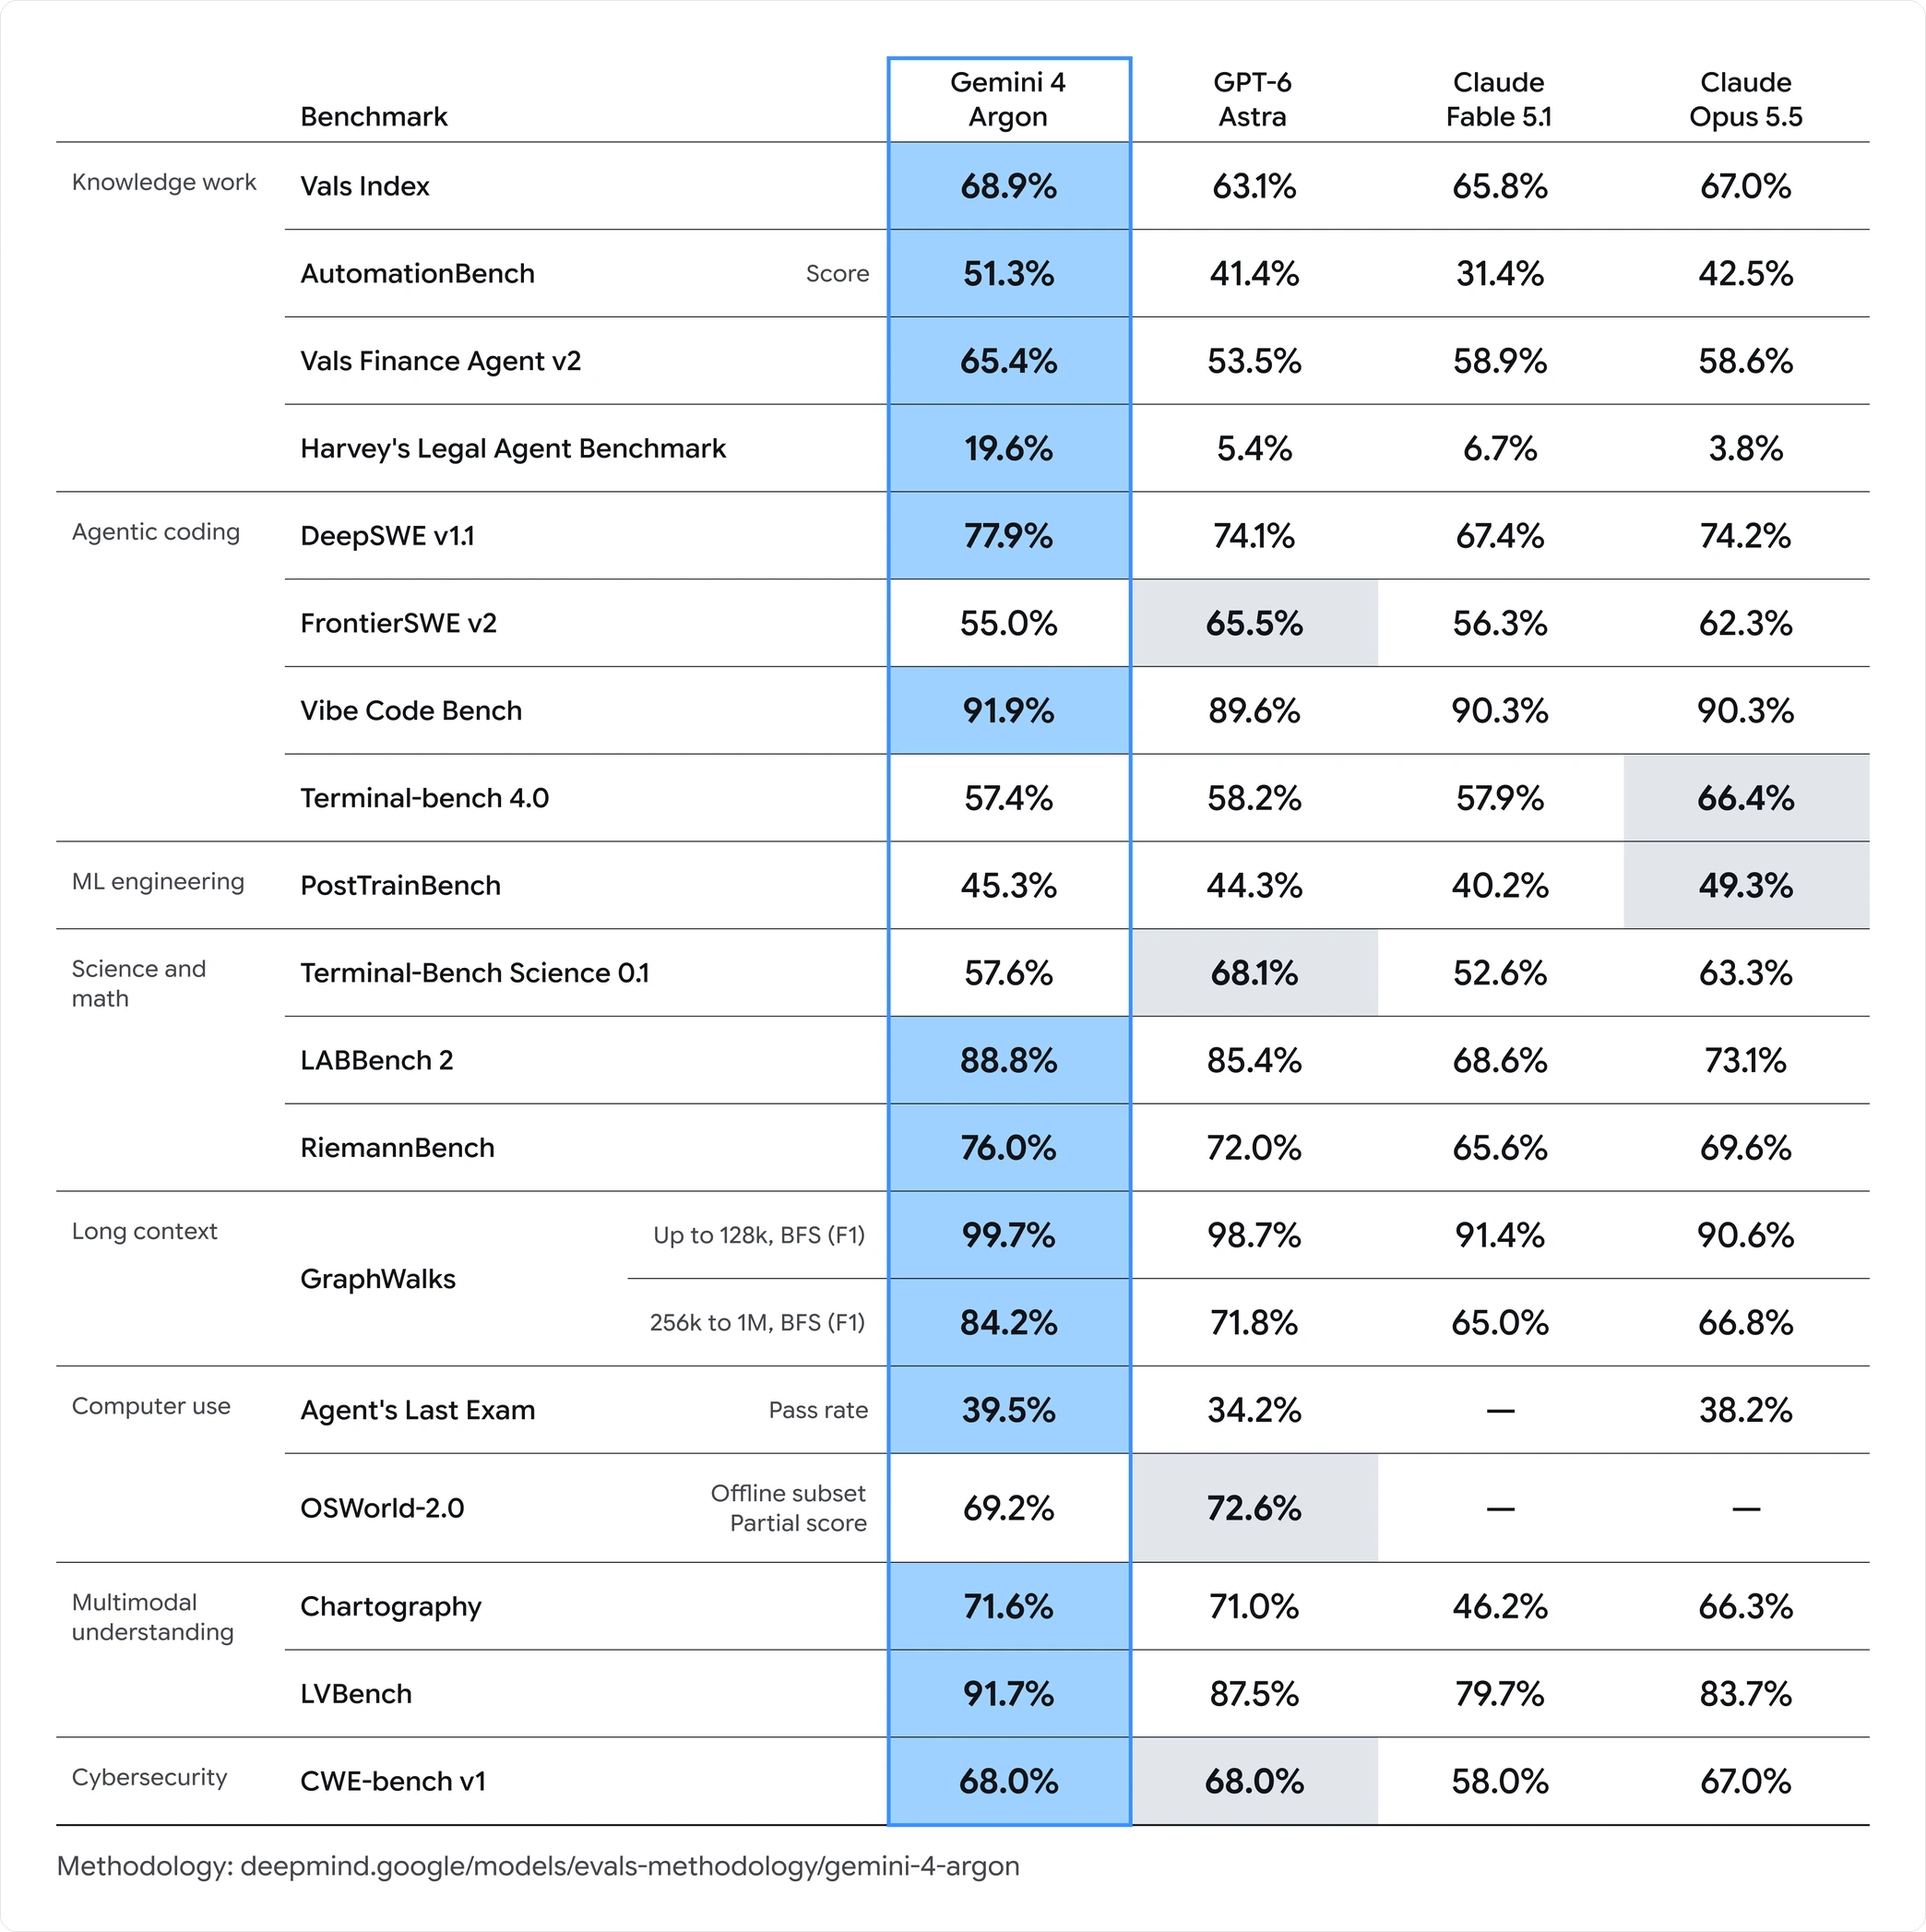
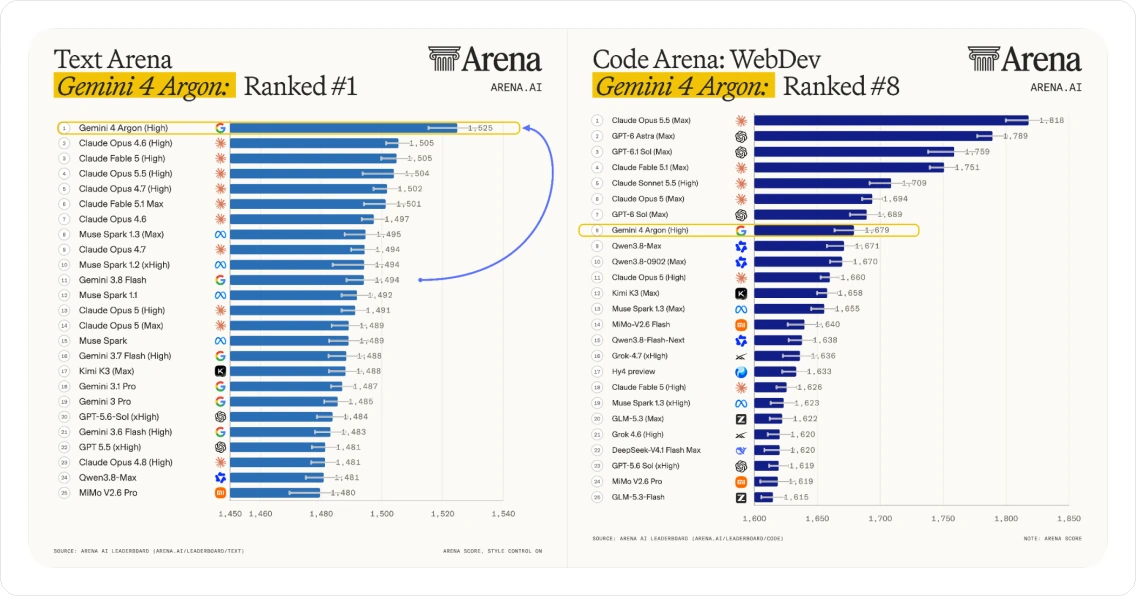
Les points forts publiés d'Argon se concentrent sur la lecture, le raisonnement et l'écriture au long cours. C'est un profil différent de celui des modèles frontière axés sur le code auxquels on le compare.
Google positionne Argon sur des travaux en plusieurs étapes qui durent des heures, là où les modèles précédents dérivent ou s'arrêtent trop tôt.
La raison donnée par Google pour cette hausse : un modèle qui a la place de réfléchir longuement peut résoudre un problème difficile en une seule trajectoire plutôt qu'en de nombreux allers-retours.
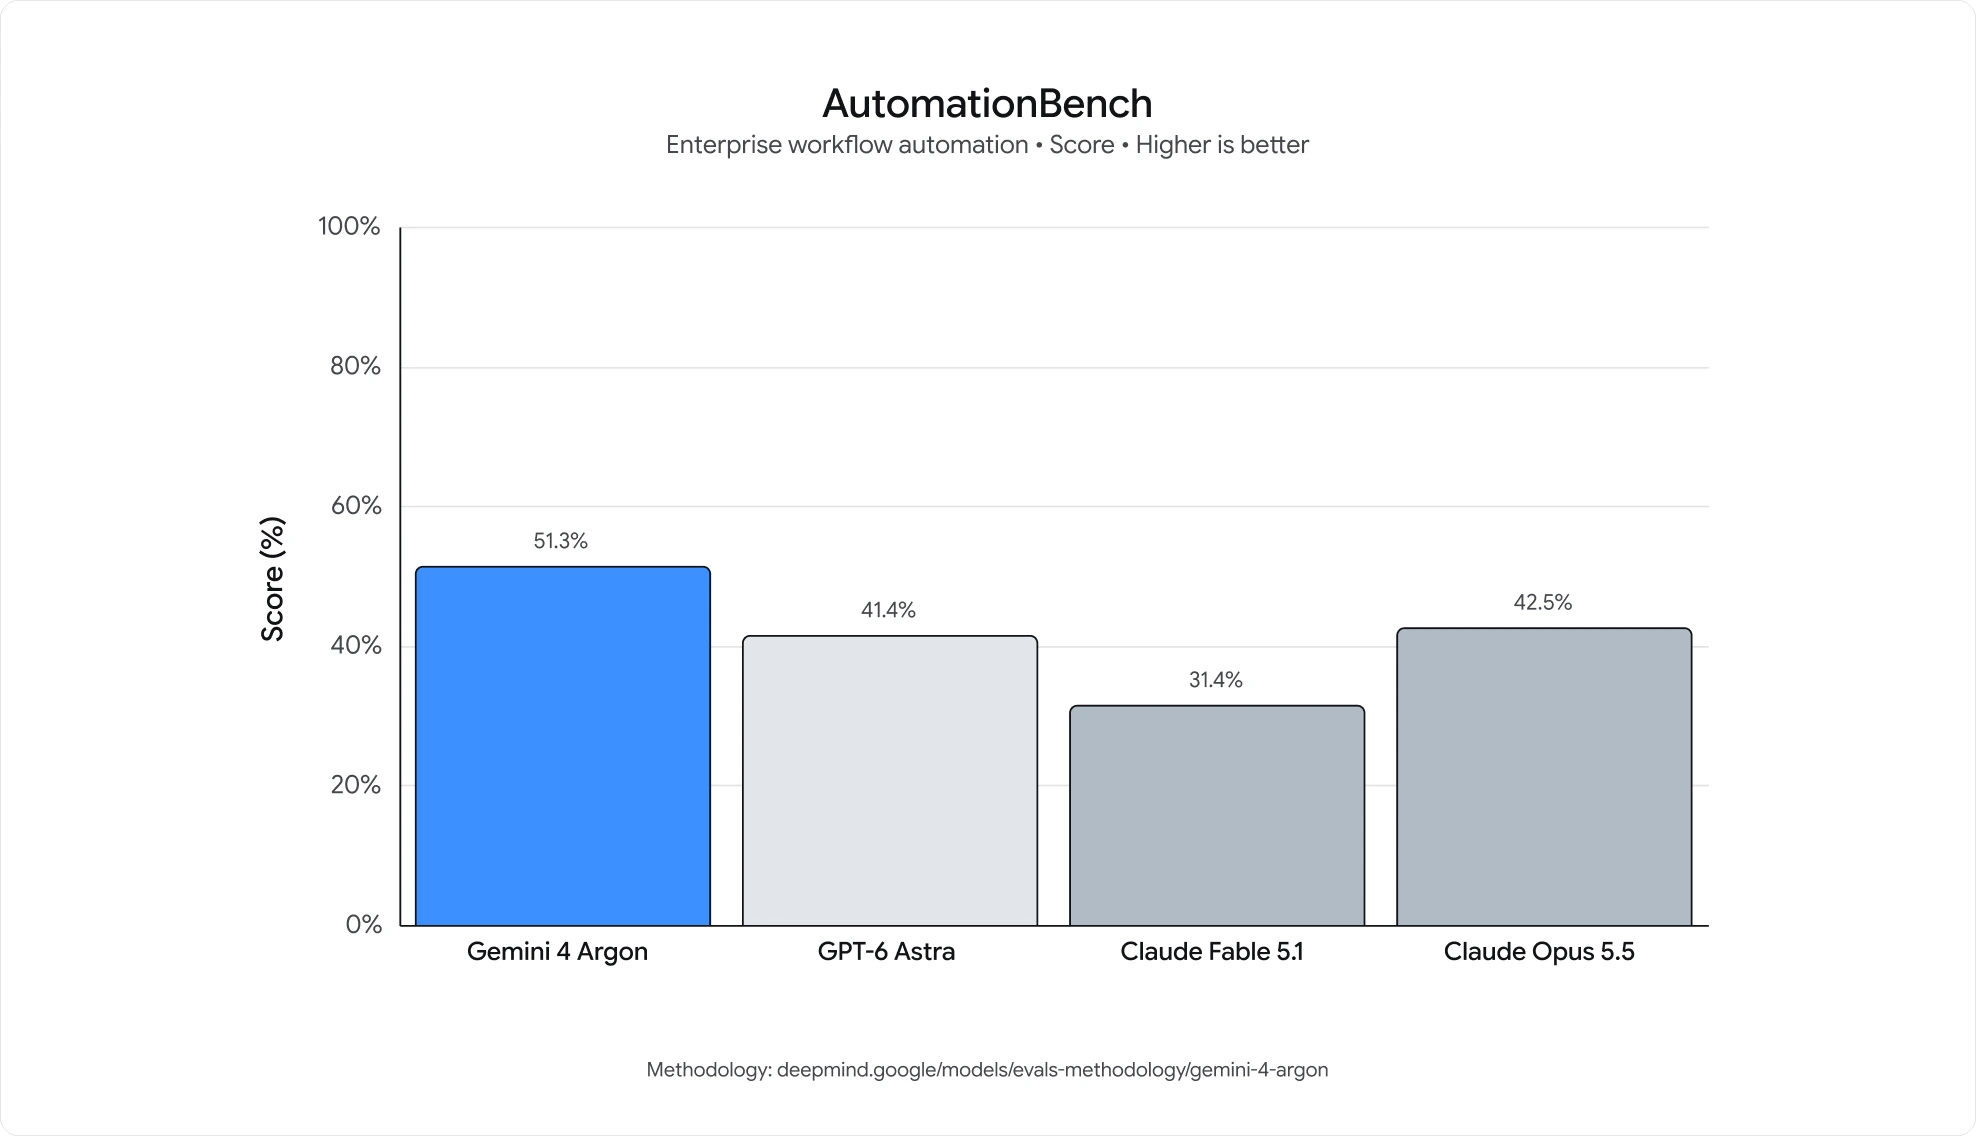
Les écarts les plus larges rapportés concernent Harvey's Legal Agent Benchmark et Vals Finance Agent v2 — de l'analyse juridique et financière réelle, pas des tâches synthétiques.
Sur GraphWalks, qui vérifie si un modèle sait réellement exploiter un contexte de 256K à 1M, Google rapporte une avance de plus de dix points sur les autres modèles phares.
LVBench, qui mesure la compréhension sur de longues vidéos, est rapporté à 91.7 % — le meilleur score que Google liste pour Argon.
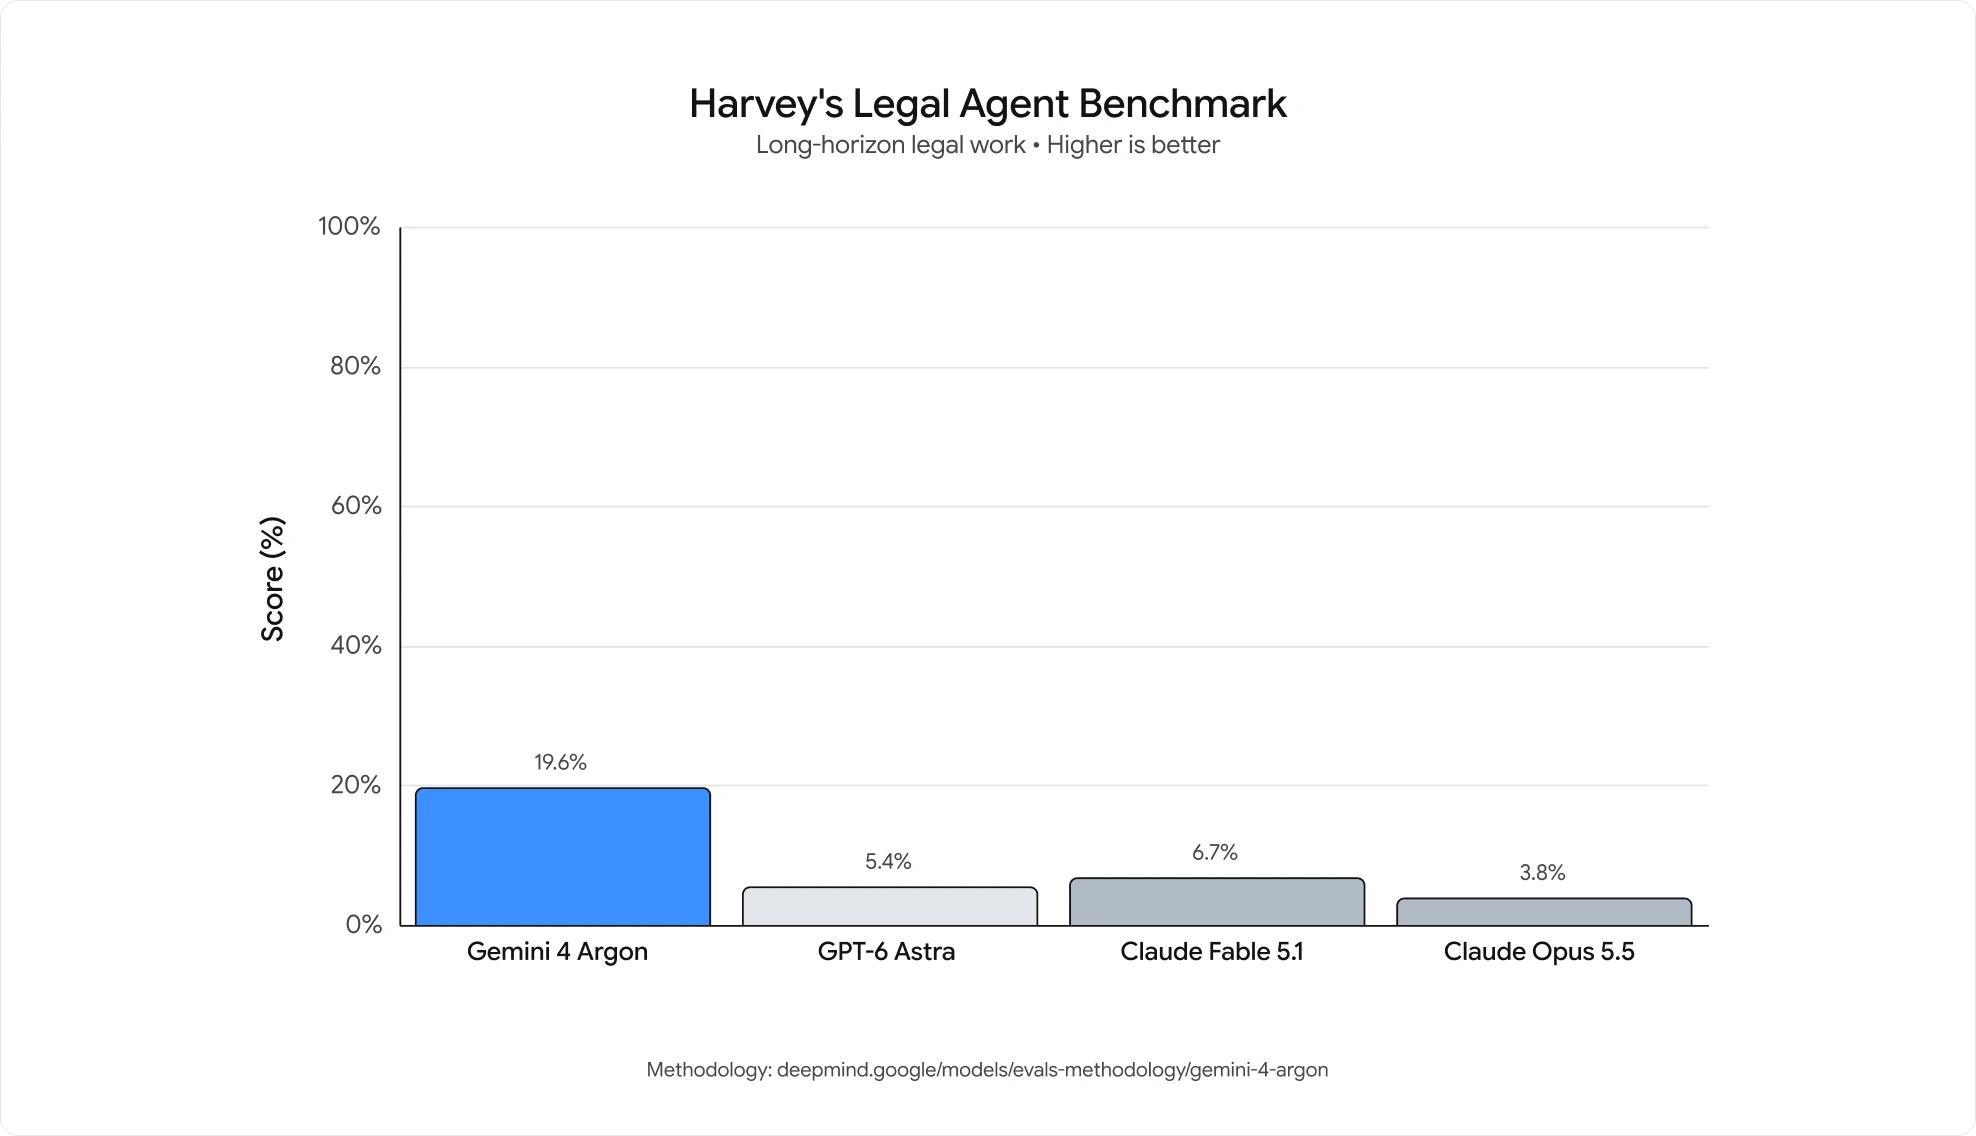
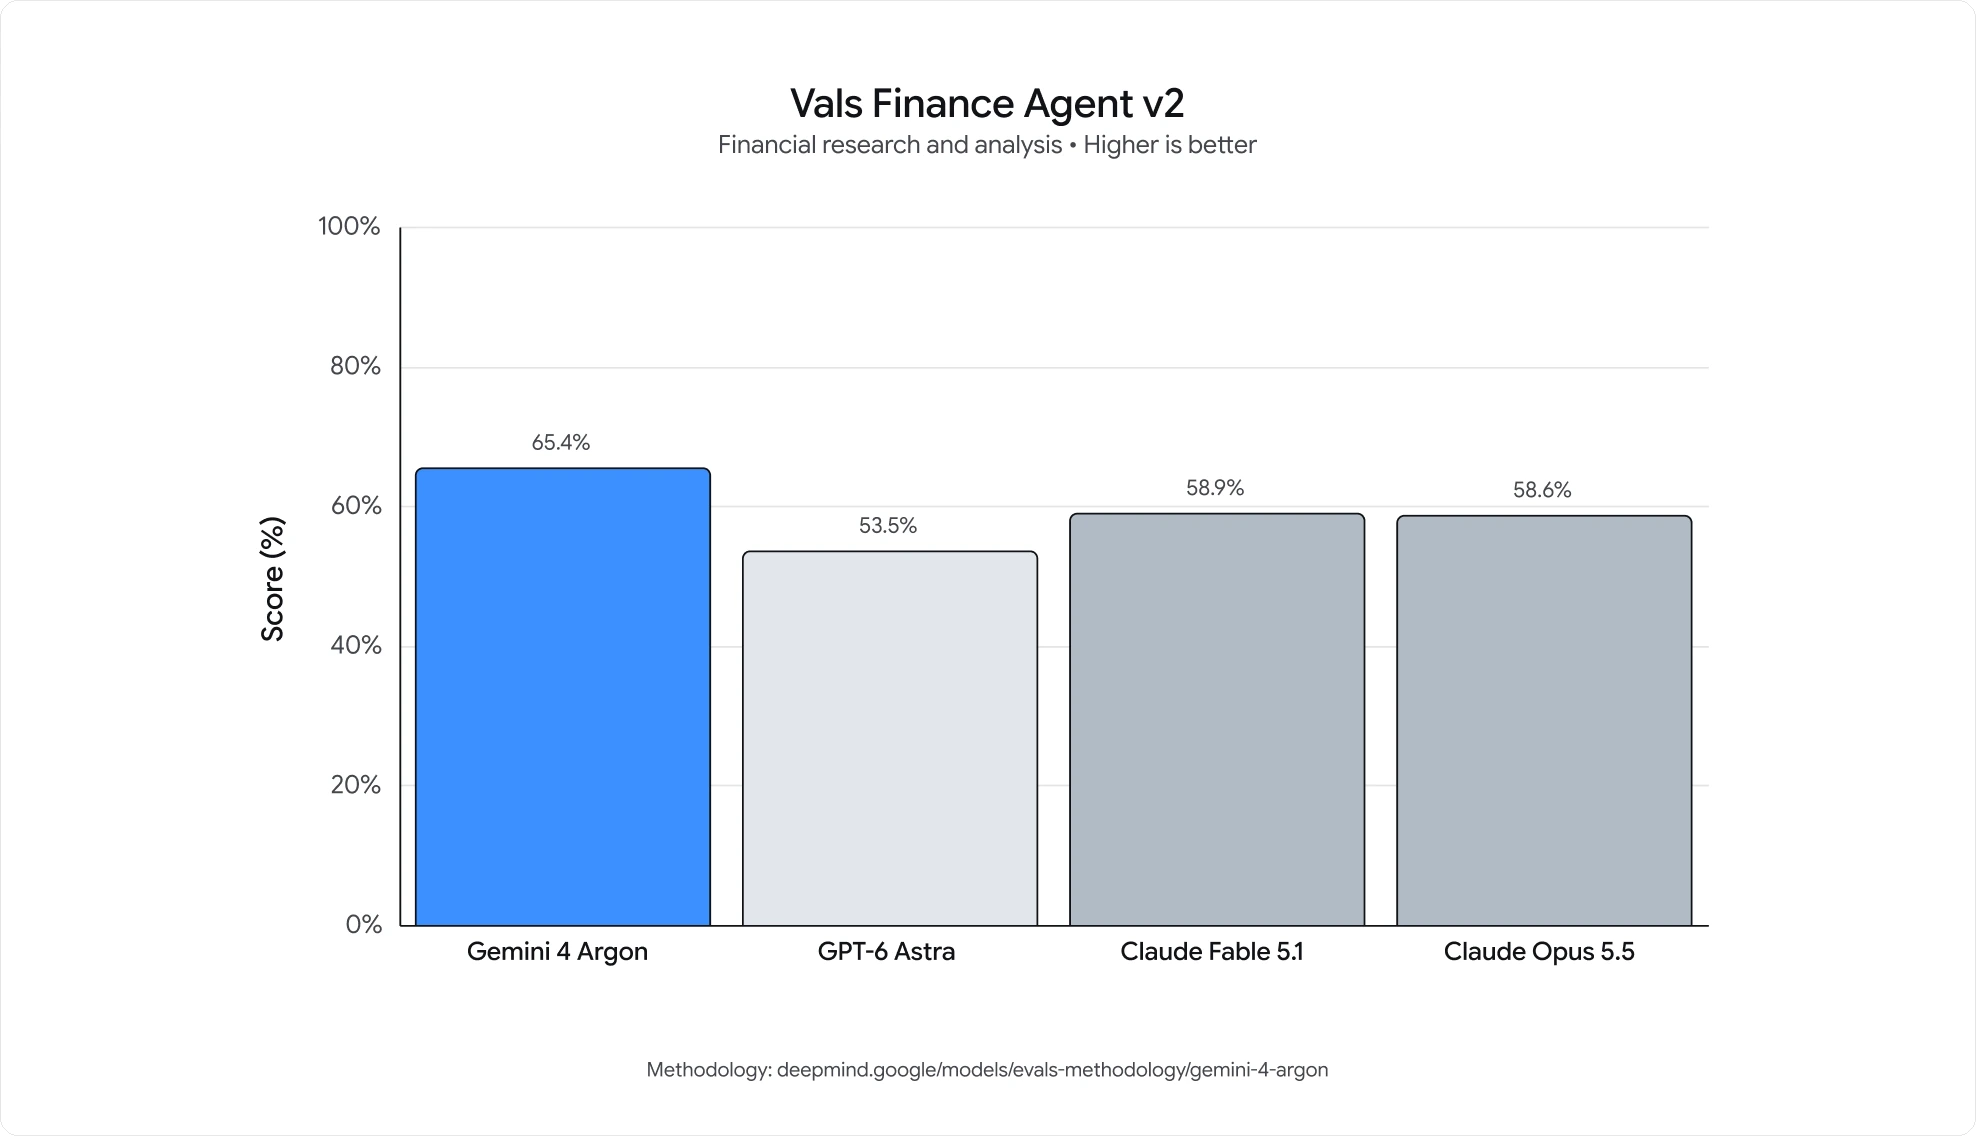
Chiffres publiés
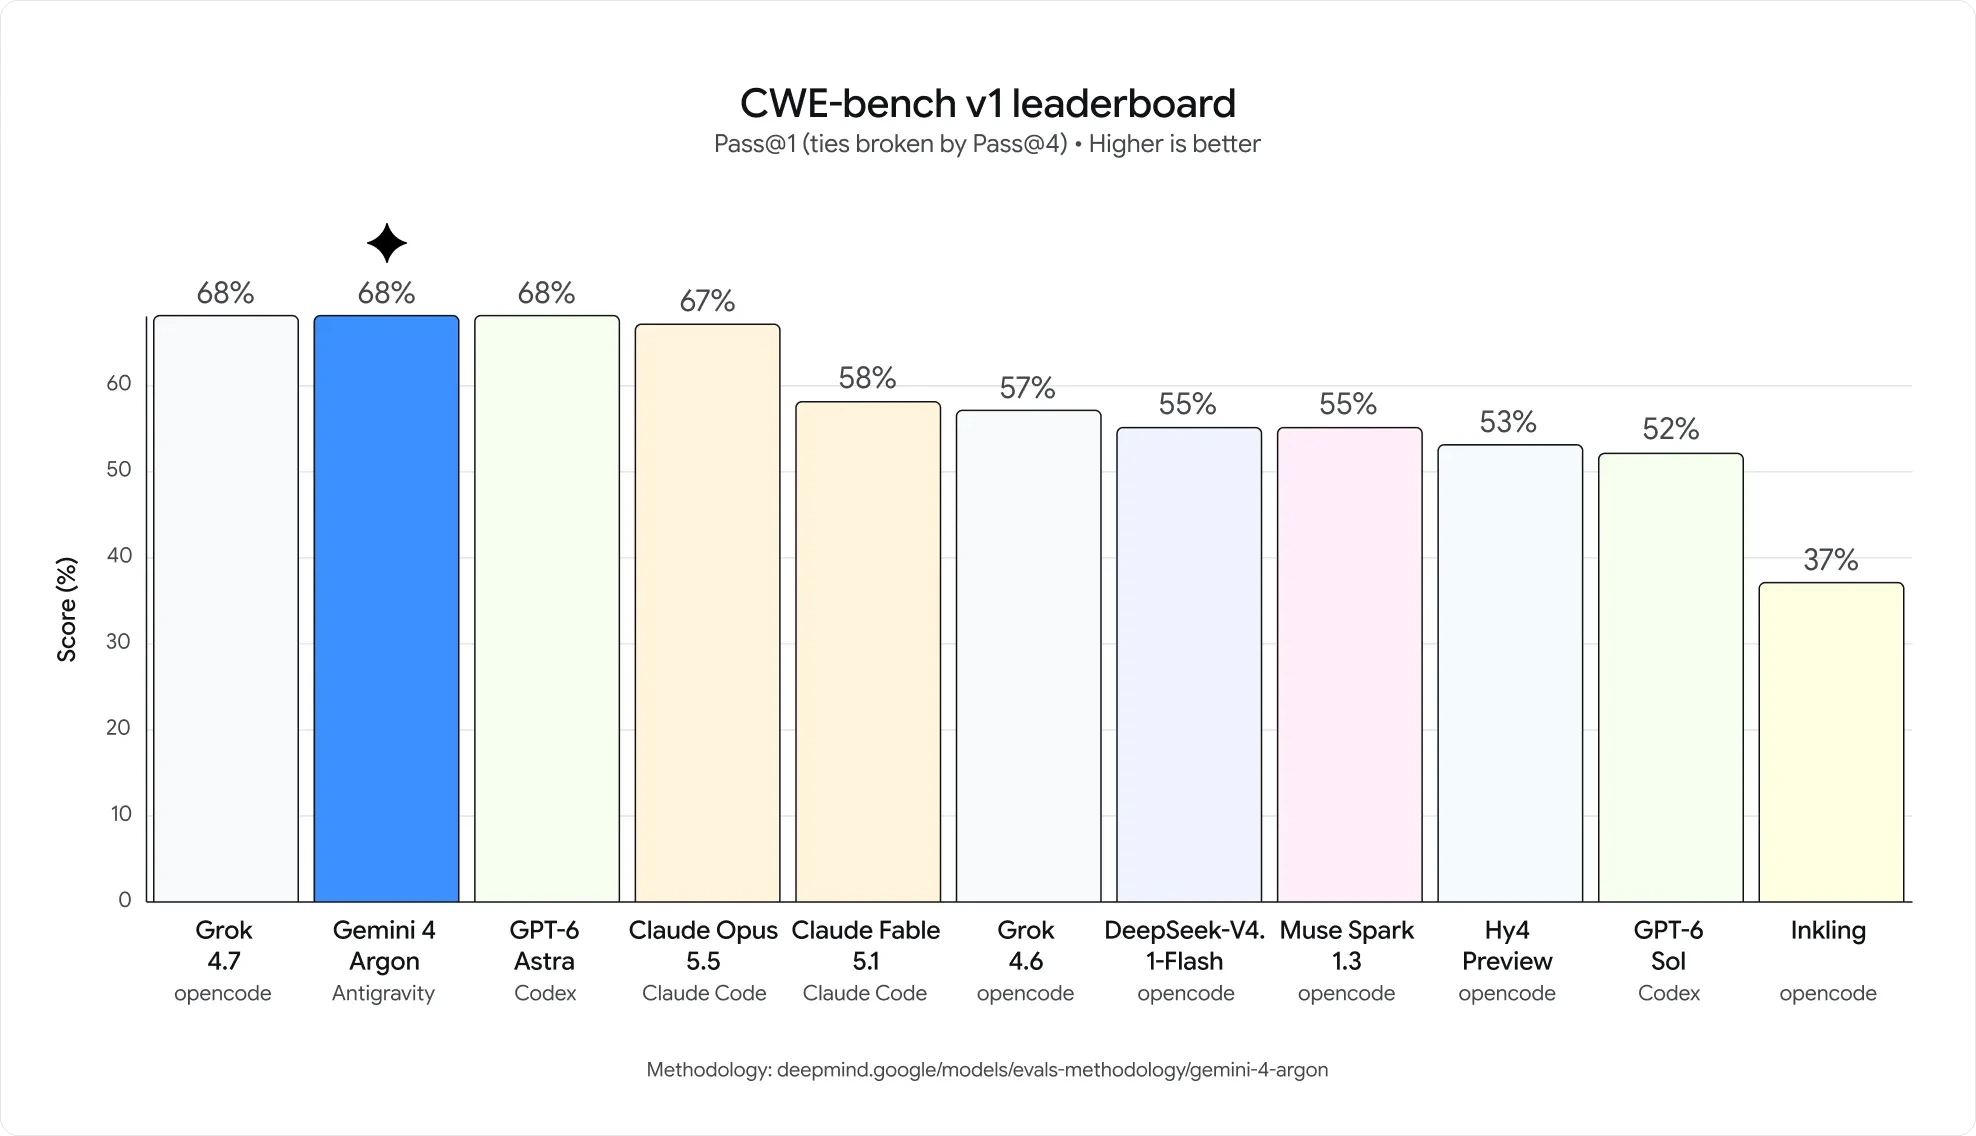
Ce sont des résultats rapportés par l'éditeur. Google n'a pas précisé de réglage de raisonnement ou d'effort pour les scores mis en avant, et aucun laboratoire indépendant ne les a encore reproduits.
À prendre comme un ordre de grandeur. Les benchmarks d'éditeur survivent rarement tels quels au contact des charges de production, et Bloomberg a rapporté que certains employés de Google doutent eux-mêmes que cette avance se transpose au travail réel.
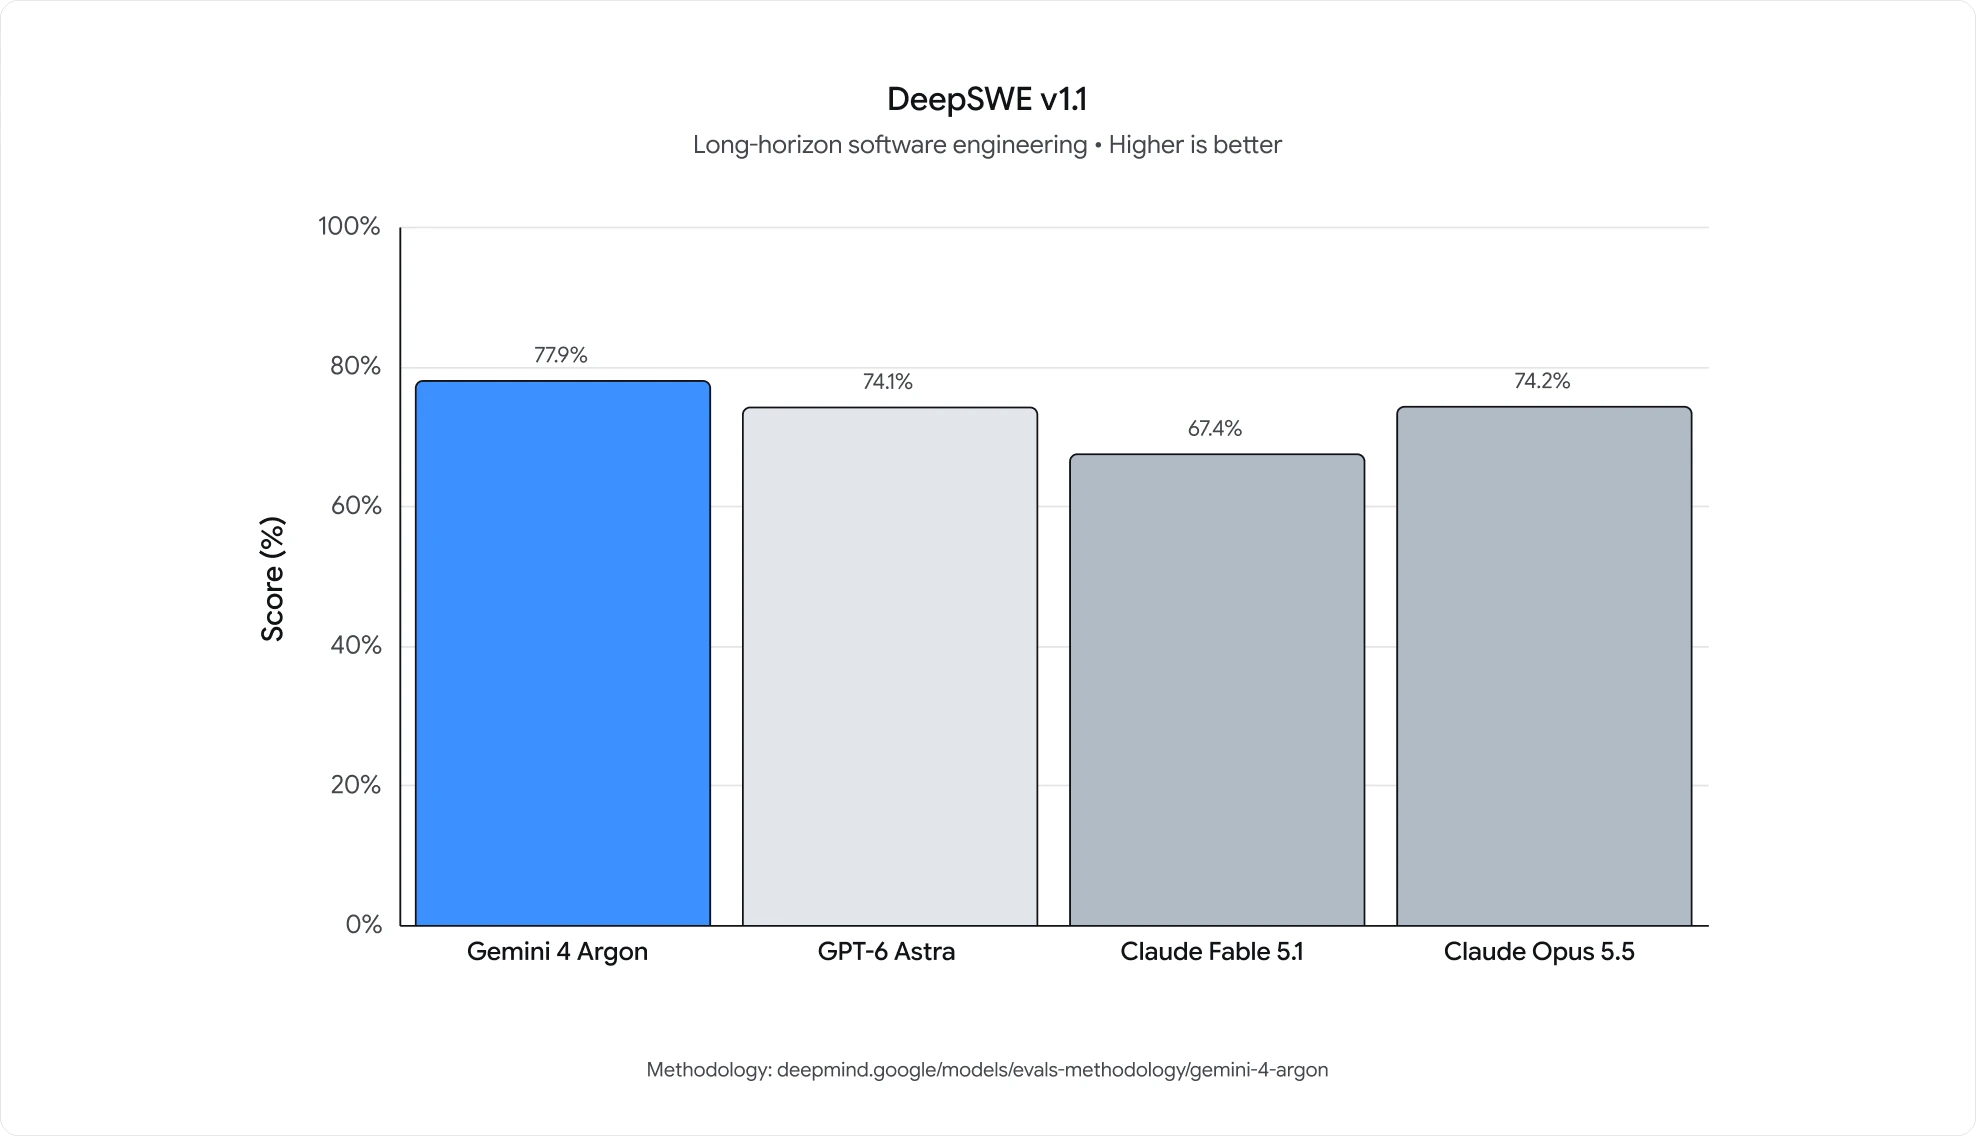
Sur Felo
Felo associe la recherche à la compréhension de documents : un modèle à longue sortie change donc ce qu'une seule session peut produire.
Rassemblez les sources, puis demandez au modèle d'écrire la synthèse en une seule passe au lieu de la reconstituer section par section sur de nombreux prompts.
La récupération en contexte long est la capacité où Argon est le plus fort, et c'est ce qui rend traitables les liasses de contrats, les dépôts réglementaires et les longs rapports.
Le profil rapporté d'Argon — texte solide, code modéré — convient aux équipes qui veulent une prose qui se lit comme écrite, et non assemblée.
Coût
Google a publié un tarif d'introduction et un tarif catalogue plus élevé, sans dire quand la bascule intervient. Budgétez sur le montant le plus haut.
Pour comparaison, le tarif d'introduction se situe à peu près au niveau de GPT-6.1 Sol et de Sonnet 5.5, et près d'un cinquième de GPT-6 Astra. Ce sont des prix catalogue, pas un coût mesuré par tâche : Argon répond à des questions plus difficiles, donc une seule exécution peut coûter plus cher.
01
Donnez à Felo le jeu de documents ou le long fil, pas un résumé. L'avantage d'Argon commence là où le contexte cesse de tenir dans un prompt.
02
Avec un plafond de sortie de 1M tokens, vous pouvez demander le rapport complet ou la version entière en une seule instruction plutôt que par sections.
03
Felo garde les citations attachées à la réponse, et c'est ce qui rend vérifiable un long document produit par le modèle.
L'accès à Argon dans la recherche Felo est en cours. D'ici son ouverture, tous les autres modèles de la gamme Felo sont disponibles dès maintenant.
Ouvrir la recherche Felo AIPas de façon générale. Google a d'abord ouvert Argon à des partenaires sélectionnés de son programme Fairwind, et indique que l'accès élargi commencera par les clients payants de l'API et les abonnés Google AI Ultra. Aucune date n'a été annoncée pour cette étape, et un abonnement payant ne donne pas accès aujourd'hui.
Cherchez, lisez et rédigez avec le modèle qui convient à la tâche. Argon rejoint la gamme quand son déploiement atteindra Felo.
Ouvrir la recherche Felo AIAucune carte bancaire n'est requise pour utiliser la recherche Felo AI.