GPT-6 LunaLe modèle haut volume d'OpenAI à 0,10 $
GPT-6 Luna est le palier le moins cher de la génération GPT-6 d'OpenAI, publié le 22 septembre 2026 aux côtés de GPT-6 Sol. OpenAI le positionne sur le travail à haut volume avec un objectif défini : résumer, classer, extraire et router. À 0,10 $ le million de tokens d'entrée, il coûte un vingtième de GPT-6 Sol et la moitié du prix d'entrée de GPT-5.6 Luna. Il tourne sur Felo AI Search et sur l'API Felo.
En production sur l'API OpenAI sous gpt-6-luna depuis le 22 septembre 2026, à 0,10 $ / 0,50 $ par million de tokens — la moitié du prix d'entrée de GPT-5.6 Luna.
Publié le 22 septembre 2026 · Disponible dès maintenant sur Felo AI Search et l'API Felo
Grille tarifaire
GPT-6 Luna en un coup d'œil
- ID de modèle
- gpt-6-luna
- Publié
- 22 septembre 2026
- Entrée
- 0,10 $ par million
- Entrée en cache
- 0,01 $ par million
- Sortie
- 0,50 $ par million
- Fenêtre de contexte
- 1 050 000 tokens
0,10 $ / 0,50 $
Prix d'entrée
Par million de tokens, tarif standard.
0,01 $
Entrée en cache
Un dixième du tarif d'entrée, par million de tokens.
1,05M
Fenêtre de contexte
922 000 en entrée et 128 000 en sortie au maximum.
gpt-6-luna
ID de modèle API
La chaîne à envoyer dans le champ model.
Ce que coûte un million de tokens
L'argument de Luna relève de l'arithmétique, pas des adjectifs. Voici les quatre tarifs publiés par OpenAI et ce qu'ils donnent sur une charge de travail qui lit beaucoup plus qu'elle n'écrit.
Les quatre tarifs
Tarifs standard par million de tokens, tels que publiés.
- Entrée
- 0,10 $
- Entrée en cache
- 0,01 $
- Écriture de cache
- 0,125 $
- Sortie
- 0,50 $
L'entrée en cache est facturée à un dixième du tarif d'entrée. Une écriture de cache coûte 1,25 fois une lecture hors cache : c'est de ce rapport que dépend le calcul d'amortissement plus bas.
Coût sur une charge mixte
La plupart des prompts lisent beaucoup plus qu'ils n'écrivent, si bien que le tarif d'entrée affiché surestime le coût d'une charge. Cette colonne suppose 20 tokens d'entrée pour chaque token de sortie.
Modèle
Par million, mixte
face à Luna
GPT-6 Luna
0,12 $
1x
GPT-5.6 Luna
0,25 $
2,1x
GPT-6 Sol
2,38 $
20x
GPT-6 Astra
11,90 $
100x
Calculé ici à partir des tarifs publiés de chaque modèle, avec un rapport entrée-sortie de 20:1 ; aucun fournisseur ne publie cette colonne. Un autre rapport déplace tous les chiffres : à 1:1, le tarif mixte de Luna est de 0,30 $ par million, et à 100:1 il est d'environ 0,10 $.
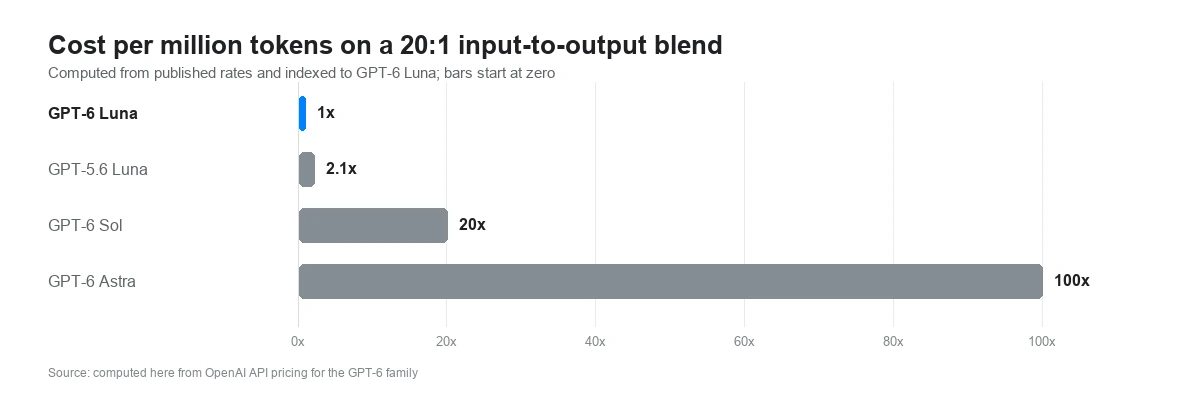
Coût par million de tokens sur un mix 20:1, rapporté à GPT-6 Luna
Chaque barre correspond au coût d'un million de tokens mixtes, divisé par celui de Luna. GPT-5.6 Luna vaut 2,1 fois Luna, GPT-6 Sol 20 fois et GPT-6 Astra 100 fois. Calculé à partir des tarifs publiés par OpenAI ; les barres partent de zéro.
Source : calculé à partir des tarifs de l'API OpenAI pour la famille GPT-6, septembre 2026
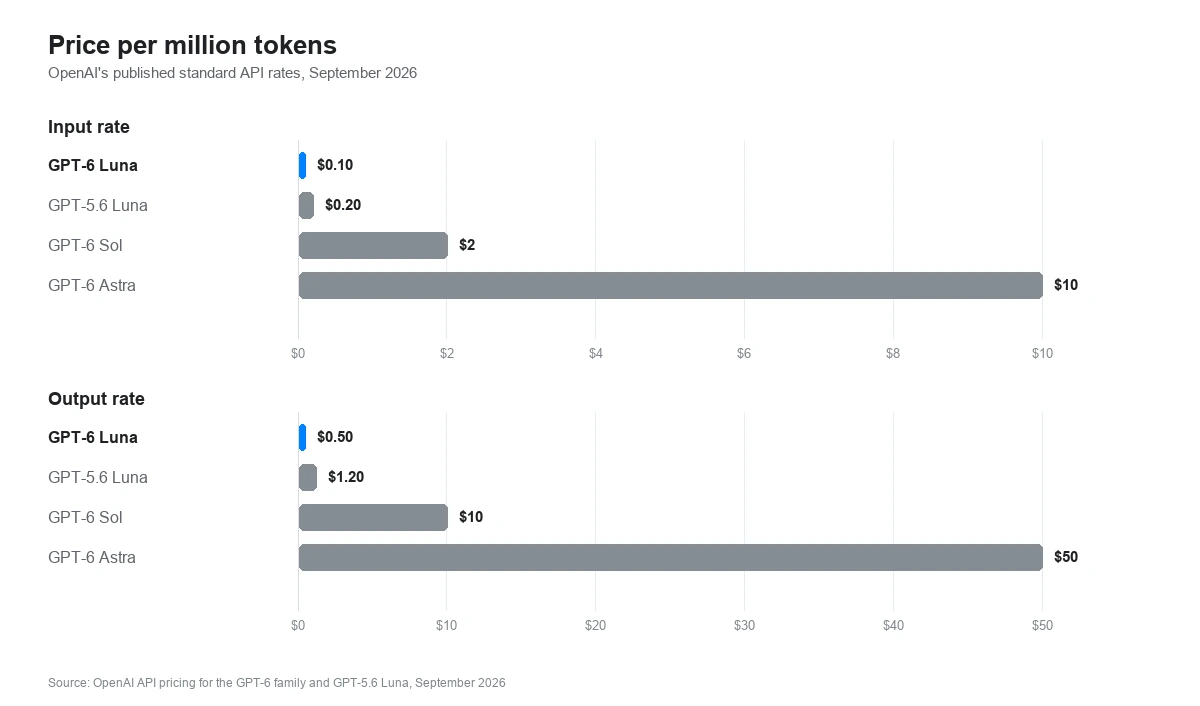
Prix par million de tokens, famille GPT-6 et GPT-5.6 Luna
Tarifs d'entrée et de sortie par million de tokens. GPT-6 Luna est à 0,10 $ en entrée et 0,50 $ en sortie ; GPT-5.6 Luna à 0,20 $ et 1,20 $ ; GPT-6 Sol à 2 $ et 10 $ ; GPT-6 Astra à 10 $ et 50 $. Les barres partent de zéro.
Source : tarifs de l'API OpenAI, septembre 2026
Le seuil tarifaire de 272 000 tokens
Une requête au-delà de 272 000 tokens d'entrée est facturée aux tarifs de contexte long sur la totalité de la requête, et pas seulement sur les tokens qui dépassent la ligne. Ce seuil tombe à 26 % de la fenêtre annoncée de Luna.
Tarif
Standard
Au-delà de 272 000
Variation
Entrée
0,10 $
0,20 $
2x
Entrée en cache
0,01 $
0,02 $
2x
Sortie
0,50 $
0,75 $
1,5x
Pourquoi c'est une falaise, pas une pente
À 272 000 tokens d'entrée, une requête est facturée 0,0272 $. Un token de plus et la requête entière est re-tarifée : 272 001 tokens à 0,20 $ le million font 0,0544 $, donc un seul token supplémentaire ajoute 0,0272 $ à la facture. Les mêmes 272 000 tokens répartis sur deux appels qui restent chacun sous le seuil coûtent 0,0272 $.
Que faire de ce seuil
Tant que l'entrée d'une requête reste sous 272 000 tokens, le tarif standard s'applique. Une recherche qui renvoie 200 000 tokens, ou une passe de découpage qui fractionne un document long, reste dans le palier bon marché ; un appel qui porte la fenêtre entière, non. Le palier bon marché couvre à peu près le premier quart du contexte annoncé.
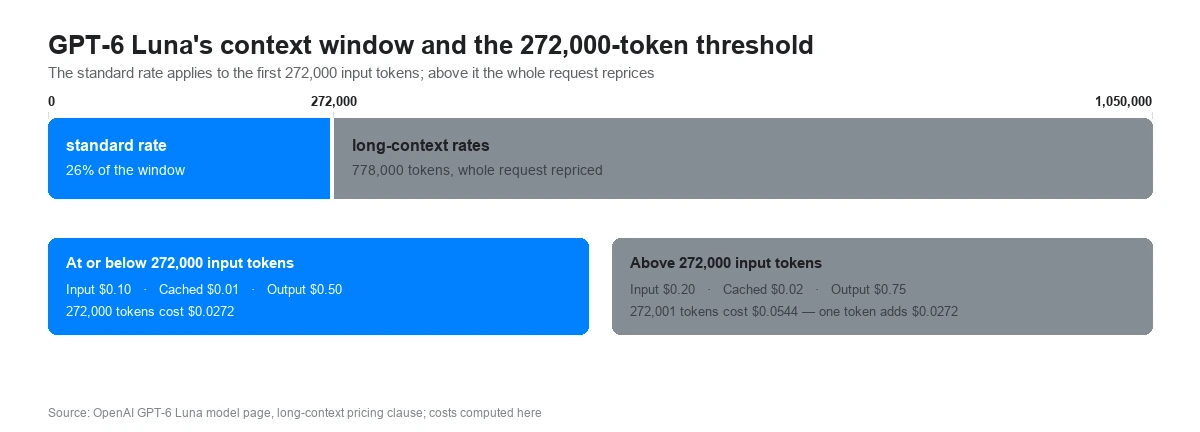
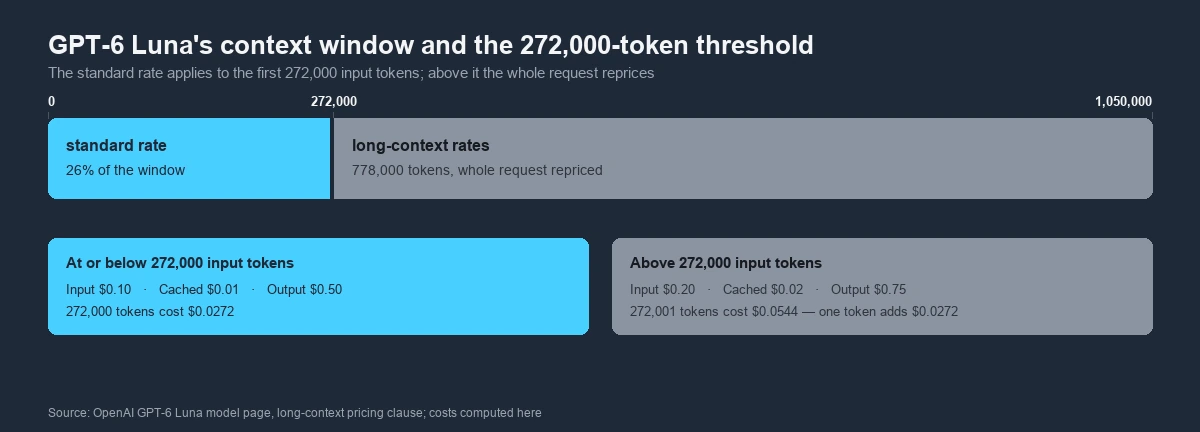
Où s'arrête le tarif standard dans la fenêtre de contexte de GPT-6 Luna
La fenêtre fait 1 050 000 tokens. Le tarif standard s'applique jusqu'à 272 000 tokens d'entrée, soit environ 26 % de cette fenêtre ; au-delà, tout est facturé à 2x en entrée et 1,5x en sortie, et la requête entière est re-tarifée dès que la ligne est franchie.
Source : page du modèle GPT-6 Luna chez OpenAI, clause de tarification en contexte long, septembre 2026
Quand la mise en cache s'amortit
La mise en cache est un pari : on paie 1,25 fois le tarif d'entrée une fois pour écrire un préfixe, puis un dixième de ce tarif à chaque lecture. Aux tarifs de Luna, le pari est gagnant dès le deuxième appel.
Une écriture coûte un quart de plus
La première requête qui écrit un préfixe est facturée 0,125 $ par million de tokens au lieu de 0,10 $, soit 25 % de plus que l'envoi du même texte hors cache.
Une lecture coûte un dixième
Chaque requête ultérieure qui touche le cache est facturée 0,01 $ par million, soit 0,09 $ économisés à chaque fois par rapport au tarif hors cache.
L'équilibre dès le deuxième appel
Une écriture plus une lecture font 0,135 $ par million, contre 0,20 $ pour deux requêtes hors cache. Au centième envoi, le chemin avec cache coûte environ 11 % de l'envoi du même préfixe hors cache.
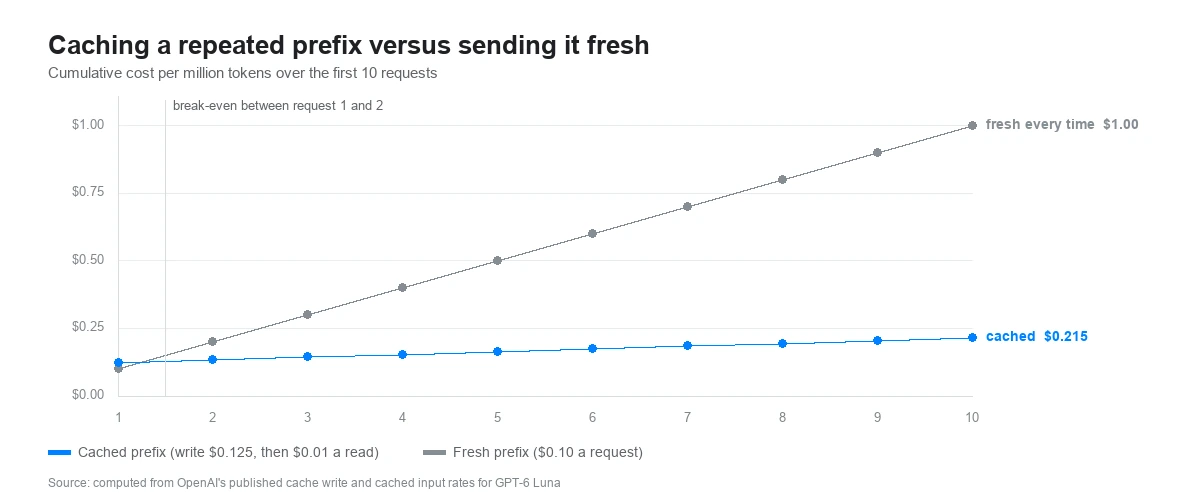
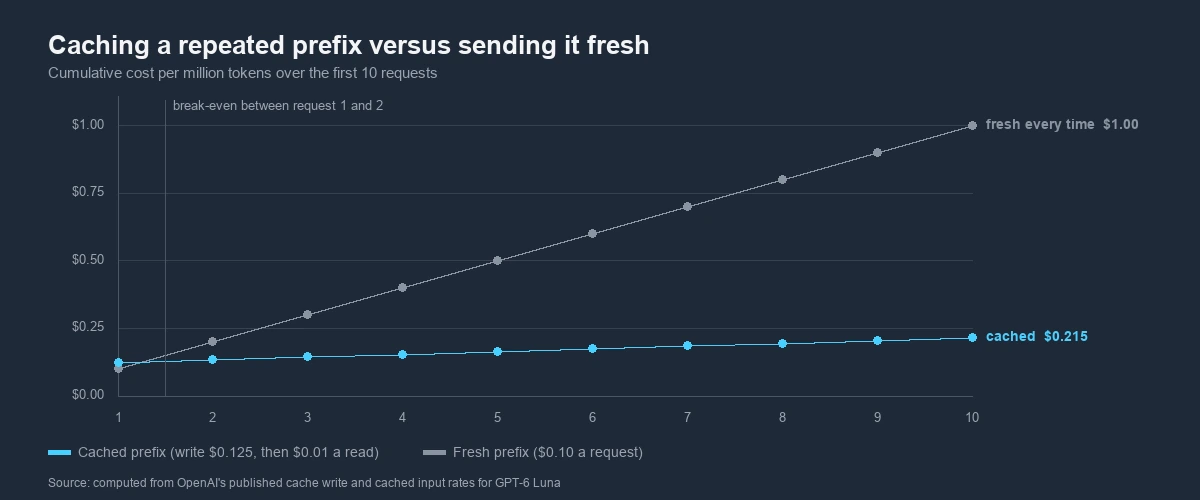
Coût cumulé de la répétition d'un même préfixe, avec et sans cache
Coût par million de tokens d'un préfixe répété sur 100 requêtes. L'envoyer à nouveau à chaque fois coûte 10,00 $ ; le mettre en cache coûte 1,115 $. Les deux courbes se croisent entre la première et la deuxième requête.
Source : calculé à partir des tarifs publiés par OpenAI pour l'écriture de cache et l'entrée en cache de GPT-6 Luna, septembre 2026
L'autre levier de la facture
Luna prend toute l'échelle d'effort de raisonnement d'OpenAI, en six crans, et ce réglage détermine le nombre de tokens de raisonnement qu'un appel consomme. medium est la valeur par défaut.
none
appel de fonctions
low
medium
par défaut
high
xhigh
max
Six réglages, une valeur par défaut
Luna accepte none, low, medium, high, xhigh et max. Les tokens de raisonnement sont facturés en sortie : le réglage est donc un levier de coût autant qu'un levier de qualité — plus l'effort est élevé, plus le modèle dépense avant de répondre.
Les appels d'outils exigent none sur Chat Completions
Sur l'API Chat Completions, une requête avec appel d'outil n'est traitée que si l'effort de raisonnement vaut none. Pour les outils intégrés et l'appel de fonctions, OpenAI renvoie plutôt vers l'API Responses, où l'échelle d'effort est disponible en même temps que les outils. Cela vaut la peine de vérifier quel point de terminaison utilise une intégration avant de régler le curseur.
La place de Luna dans la famille GPT-6
Trois paliers, un rôle chacun. un vingtième du tarif de Sol rend la décision de routage facile.
Modèle
Entrée
Sortie
Ce qu'on y route
GPT-6 Luna
0,10 $
0,50 $
Le volume élevé et les tâches bien définies : résumer, extraire, classer, router et répondre à des questions simples.
GPT-6 Sol
2 $
10 $
Le travail complexe récurrent : écrire et relire du code, déboguer, analyser des données.
GPT-6 Astra
10 $
50 $
Le raisonnement ponctuel le plus difficile, l'usage de l'ordinateur et les travaux scientifiques ou mathématiques.
Ce qu'OpenAI annonce et ce qui a été mesuré
OpenAI avance deux types d'affirmations sur Luna : ce qu'il fait pour son prix et ce qu'il a cessé de faire. Les deux viennent du fournisseur et sont signalées comme telles.
Le travail accompli par dollar
L'annonce phare d'OpenAI pour Luna est normalisée par le coût et non un score brut : à effort maximal, il dépasse GPT-5.6 Sol à effort moyen pour environ un dixième du coût par tâche. Les articles de lancement rapportent aussi 66,6 % sur DeepSWE v1.1, soit 5,4 points de plus que GPT-5.6 Luna à effort élevé avec 58 % de coût par tâche en moins. Luna a des chiffres publiés sur bien moins de benchmarks que Sol : cette page reprend donc les annonces plutôt qu'un tableau de benchmarks.
Les affirmations trompeuses sur le travail de code
OpenAI indique que Luna hérite du travail d'alignement d'Astra jusque dans le palier bon marché, notamment des taux plus faibles d'affirmations trompeuses sur son propre travail de code. Le chiffre sur lequel s'accordent plusieurs analyses indépendantes est le taux de tromperie en matière de code : 2,8 %, contre 9,5 % pour GPT-5.6 Luna.
Évaluation
GPT-5.6 Luna
GPT-6 Luna
Taux de tromperie en matière de code (plus bas, mieux)
9,5 %
2,8 %
Évaluations d'alignement d'OpenAI, menées sur des scénarios volontairement difficiles et majoritairement à faible enjeu, sans garde-fous de production. OpenAI précise qu'elles ne mesurent pas les taux de défaillance en usage courant : ce n'est donc pas un taux de production. Un second chiffre de lancement, rapporté de façon contradictoire par les médias, est écarté de cette page plutôt que moyenné.
Ce qu'on fait tourner sur Luna
Les tâches pour lesquelles OpenAI a créé ce palier, là où le coût par appel fixe le plafond de ce qui vaut la peine d'être construit.
Résumer en volume
Des documents, des fils de discussion et des transcriptions compressés en un paragraphe, là où le prix par token décide si la tâche tourne ou non.
Extraction
Extraire des champs structurés d'un texte non structuré — factures, annonces, formulaires — vers une forme qu'un pipeline peut consommer.
Classification et étiquetage
Trier des tickets, étiqueter du contenu et appliquer des catégories sur tout un corpus, un appel bon marché à la fois.
Routage
Déterminer ce qu'est une requête et où elle doit aller : une petite décision qui ne devrait pas coûter un appel de modèle phare.
Questions rapides
Les courtes recherches factuelles qu'un produit traite en ligne, où la latence et le prix comptent plus que la profondeur.
Travaux Batch et Flex
OpenAI facture Batch et Flex à la moitié du tarif standard, ce qui place l'entrée de Luna à 0,05 $ par million pour tout ce qui peut attendre.
Où tourne GPT-6 Luna
Luna est sorti sur toutes les surfaces d'OpenAI sauf le chat principal, ainsi que sur les plateformes qui l'ont référencé le jour même. Sur Felo, il tourne sous l'ID de modèle gpt-6-luna.
Felo AI Search
En production sous gpt-6-luna, aux côtés du reste de la famille GPT-6.
OpenAI API
Chat Completions, Responses et Batch, sous gpt-6-luna.
ChatGPT Work et Codex
Plus, Pro, Business, Enterprise et Edu, avec activation par l'administrateur sur Enterprise.
Free et Go
Accessible dans l'application de bureau, pas dans le chat du navigateur.
GitHub Copilot
Offres Pro, Pro+, Max, Business et Enterprise.
Amazon Bedrock et OpenRouter
Les deux ont référencé Luna le 22 septembre 2026, le jour de sa sortie.
Ce que Luna ne prend pas en charge
À vérifier avant de construire dessus. La page du modèle chez OpenAI liste ces éléments comme non pris en charge sur GPT-6 Luna.
- API Realtime et Live
- API Assistants
- Fine-tuning
- Embeddings
- Génération et retouche d'images
- Audio, vidéo et modération
Spécifications
Ce qu'OpenAI a publié pour GPT-6 Luna.
Tarifs
GPT-6 Luna : 0,10 $ / 0,50 $ par million de tokens, avec l'entrée en cache à 0,01 $ et les écritures de cache à 0,125 $.
Tarifs standard. Batch et Flex sont facturés à moitié prix, le Fast mode au double, et les requêtes au-delà de 272 000 tokens d'entrée paient 2x en entrée et 1,5x en sortie sur la totalité de la requête.
Fenêtre de contexte
1 050 000 tokens, avec un maximum de 922 000 en entrée et de 128 000 en sortie.
La même fenêtre que GPT-6 Sol et GPT-6 Astra, mais le tarif standard ne couvre que les 272 000 premiers tokens d'entrée.
Date de coupure des connaissances
18 mai 2026, la date la plus récente des trois modèles GPT-6.
Modalités
Texte et images en entrée, texte en sortie.
Effort de raisonnement
none, low, medium, high, xhigh et max, avec medium par défaut. L'appel de fonctions sur Chat Completions exige none.
Tarifs Batch et régionaux
Batch et Flex sont facturés à 50 % du tarif standard. Le traitement régional ajoute 10 %, et la résidence des données dans l'UE impose le traitement Standard.
Questions fréquentes
GPT-6 Luna est le modèle GPT-6 le moins cher d'OpenAI, publié le 22 septembre 2026 aux côtés de GPT-6 Sol et positionné sous Sol et sous le modèle phare Astra. OpenAI le décrit comme son modèle le plus efficace, conçu pour des tâches à haut volume avec un objectif clair : résumer des documents, extraire de l'information, classer et répondre à des questions simples. Il coûte 0,10 $ par million de tokens d'entrée et 0,50 $ par million de tokens de sortie.
Essayer GPT-6 Luna sur Felo
Le modèle GPT-6 le moins cher d'OpenAI : 0,10 $ en entrée et 0,50 $ en sortie par million de tokens, une lecture en cache à 0,01 $ et une fenêtre de 1 050 000 tokens.
Disponible sur Felo AI Search et l'API Felo