Annunciato il 30 settembre 2026 · Rilascio per fasi

Gemini 4 Argonricerca lunga, scritta per intero

Il primo modello di frontiera di Google dal Gemini 3, pensato per ragionare a fondo su lavori lunghi in più passaggi. Alza il tetto di output da 64K a 1M token e guida i numeri pubblicati da Google sul lavoro di conoscenza, non sulla programmazione.

L'API Felo è in beta chiusa — l'accesso a Gemini 4 Argon arriverà presto.
Immagine principale di Gemini 4 Argon: il nome del modello accanto a un grande numero 4 su un gradiente blu
L'immagine dell'annuncio di Google. Argon arriva con un nuovo schema di denominazione, non come aggiornamento della linea Gemini 4.0: per questo il nome non porta alcun numero di versione.
1M
Token di output massimi
Prima 64K — un report completo generato in una sola traiettoria.
2 $ / 10 $
Prezzo API introduttivo
Per milione di token di input e di output. L'input in cache ha il 95% di sconto.
77.9%
DeepSWE v1.1
Il punteggio riportato da Google, davanti a Claude Opus 5.5 e GPT-6 Astra.
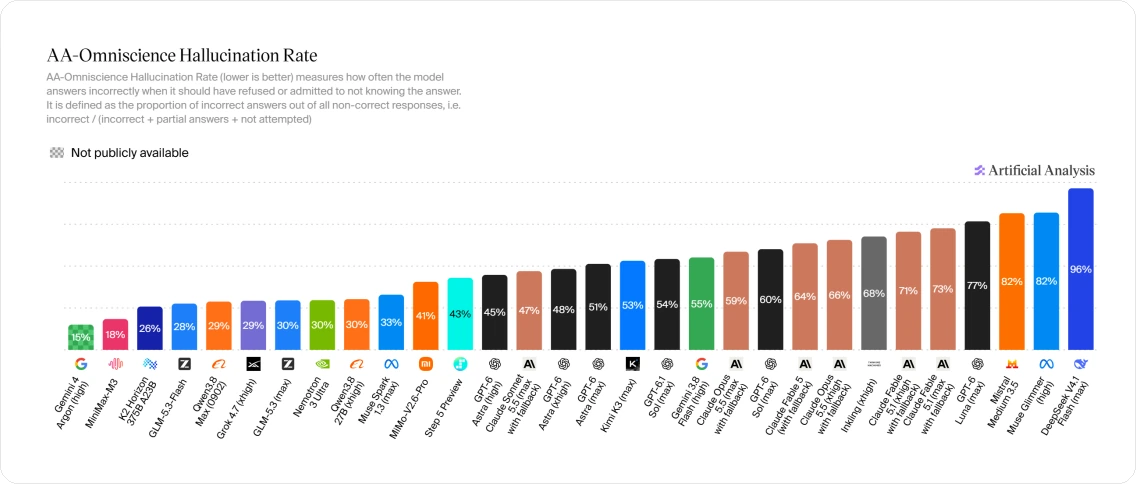
15%
Tasso di allucinazione
Il più basso misurato tra i modelli di frontiera da Artificial Analysis.

Le cifre e i grafici di questa pagina provengono dalle organizzazioni che li hanno pubblicati — Google, Arena.ai e Artificial Analysis — e sono riprodotti senza modifiche.

Stato del rilascio

Argon non è ancora disponibile per tutti. Questo è l'ordine con cui arriva.

Google sta rilasciando Argon per fasi, e la prima non è quella pubblica. L'accesso dentro Felo è in preparazione insieme a questo rilascio.

Già disponibile

Difensori informatici di fiducia

I partner selezionati del programma Fairwind di Google ricevono Argon per primi, e lo ricevono senza le protezioni di sicurezza informatica.

Annunciato subito dopo

Clienti paganti dell'API e Google AI Ultra

Google dice che l'accesso più ampio inizia qui. Non è stata data una data, e il solo abbonamento non lo concede oggi.

Non ancora pianificato

Sviluppatori, aziende e consumatori

Arriva dopo i livelli a pagamento. Google non si è impegnata su una tempistica per la disponibilità generale.

L'accesso ad Argon nella ricerca Felo è in corso. Questa pagina sarà aggiornata quando si aprirà.

In cosa è forte

Un modello fatto per portare a termine lavori lunghi, non per rispondere in fretta

I punti di forza pubblicati di Argon si concentrano sul leggere, ragionare e scrivere a lungo. È una forma diversa da quella dei modelli di frontiera orientati al codice con cui viene confrontato.

Un ragionamento che regge un'attività lunga

Google posiziona Argon su lavori in più passaggi che durano ore, dove i modelli precedenti deviano o si fermano prima.

1M token di output in una sola passata

Il motivo dichiarato da Google per l'aumento: un modello con spazio per pensare a lungo risolve un problema difficile in una sola traiettoria invece che in molti scambi.

Guida il lavoro di conoscenza, non la programmazione

I divari più ampi riportati sono su Harvey's Legal Agent Benchmark e Vals Finance Agent v2 — analisi legale e finanziaria reale, non compiti sintetici.

Recupero su contesto lungo che tiene

Su GraphWalks, che verifica se un modello riesce davvero a usare un contesto da 256K a 1M, Google riporta un vantaggio di oltre dieci punti sugli altri modelli di punta.

Comprensione di video lunghi

LVBench, che misura la comprensione su video lunghi, è riportato al 91.7% — il punteggio più alto che Google elenca per Argon.
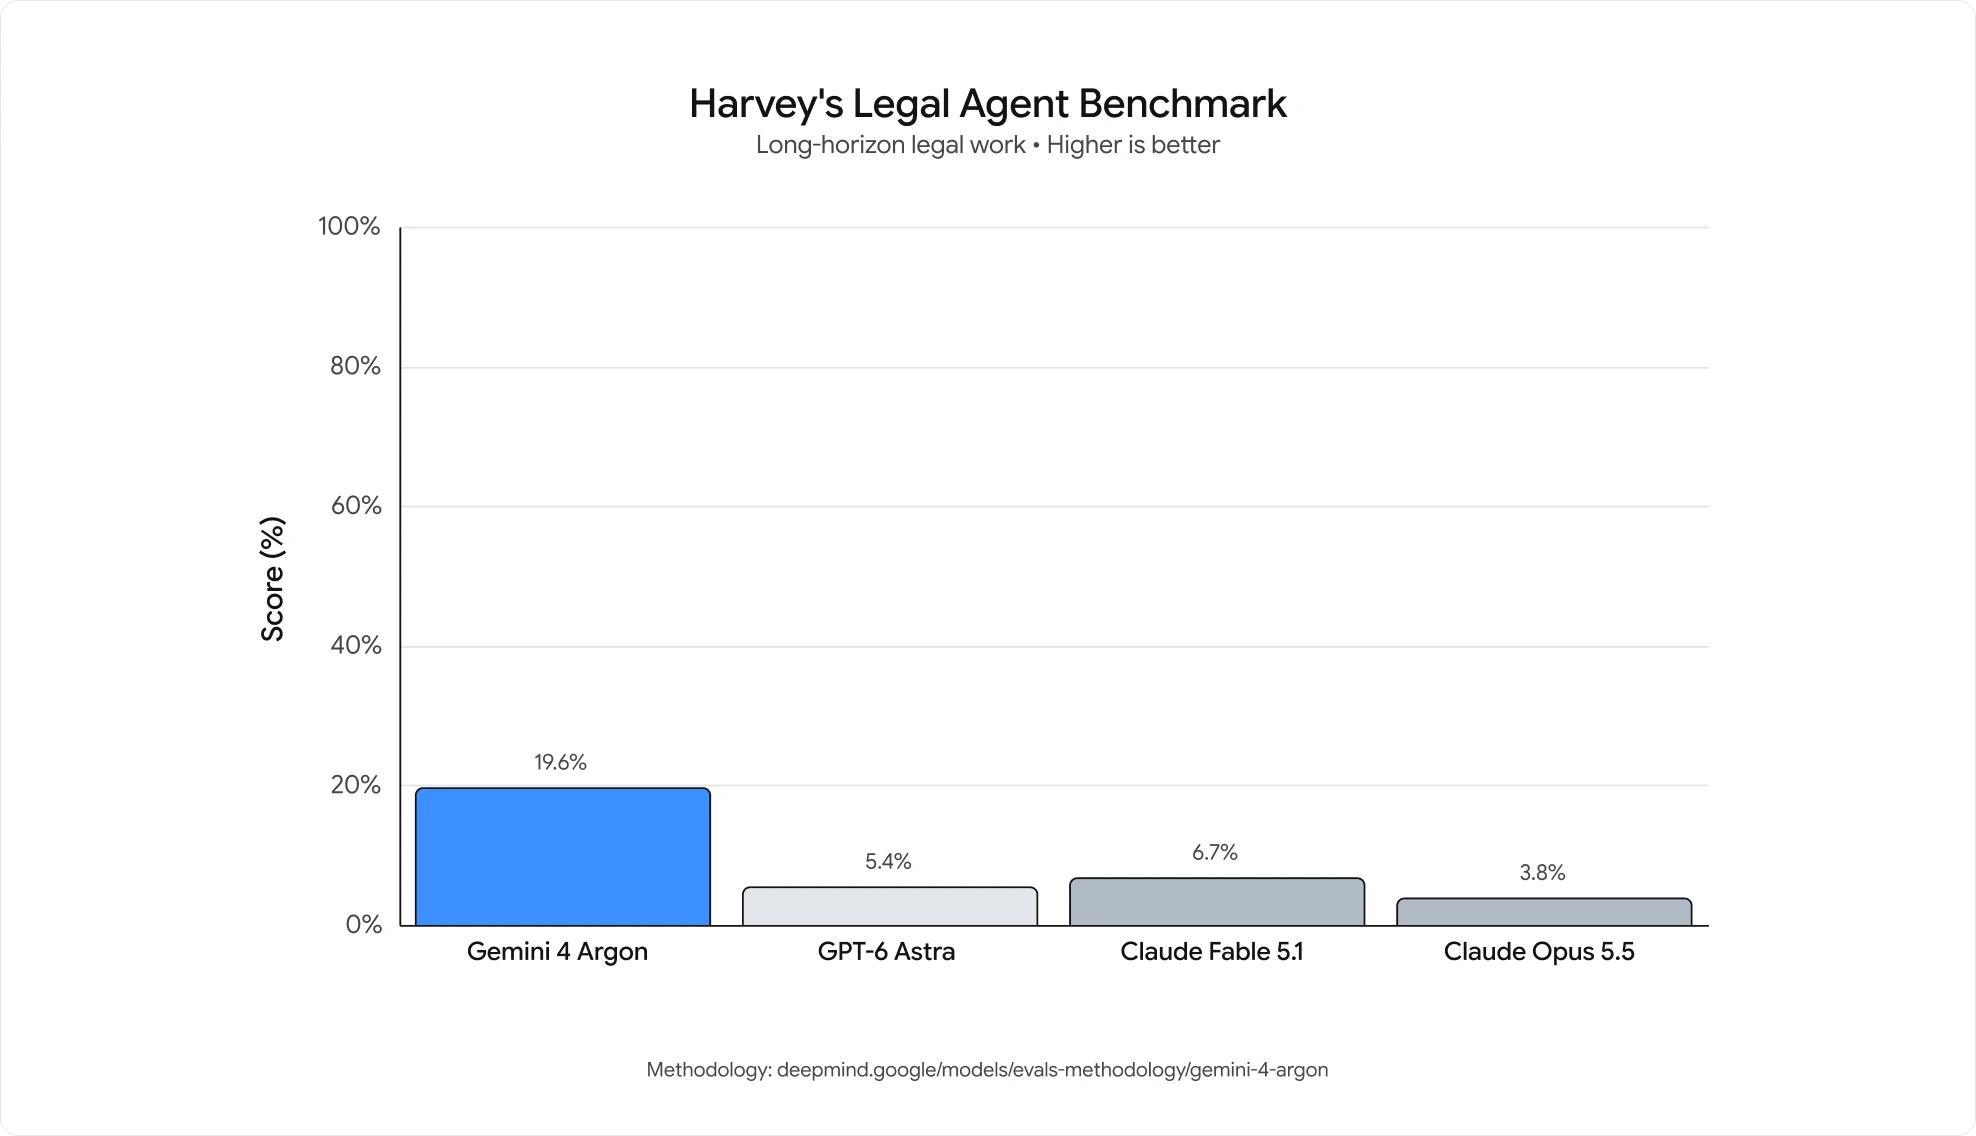
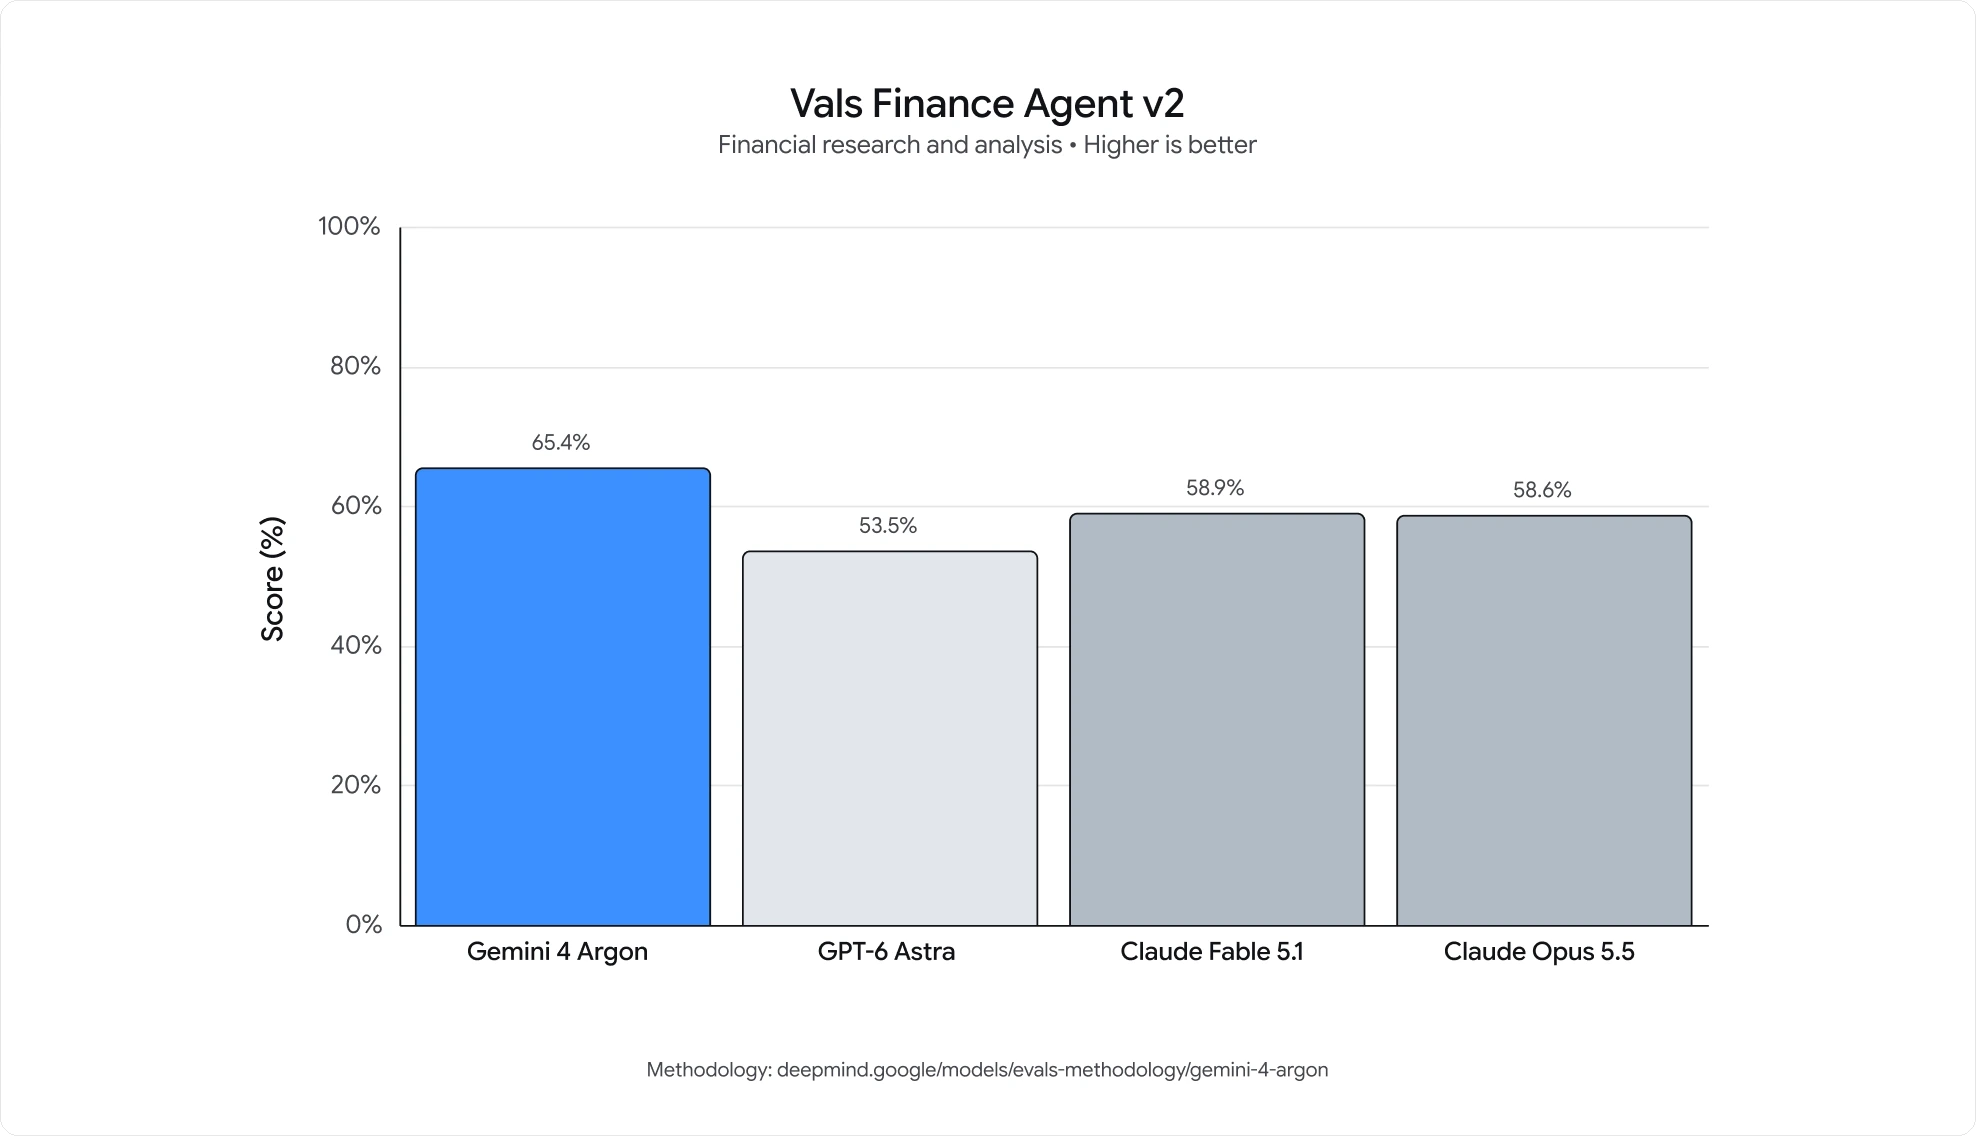
Grafico a barre di Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Lavoro legale su orizzonte lungo. Il 19.6% di Argon è circa il triplo del punteggio del modello successivo, ed è il vantaggio più ampio del set pubblicato da Google.
Grafico a barre di Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Ricerca e analisi finanziaria, al 65.4% contro un gruppo tra il 53.5% e il 58.9%. Un vantaggio più stretto rispetto al lavoro legale, ma lo stesso ordine.

Numeri pubblicati

Dove si colloca Argon nei benchmark di Google

Sono risultati riportati dal produttore. Google non ha indicato un'impostazione di ragionamento o effort per i punteggi principali, e nessun laboratorio indipendente li ha ancora replicati.

Benchmark
Cosa misura
Argon
Confronto più vicino
DeepSWE v1.1
Ingegneria del software su orizzonte lungo
77.9%
Opus 5.5 al 74.2%, GPT-6 Astra al 74.1%
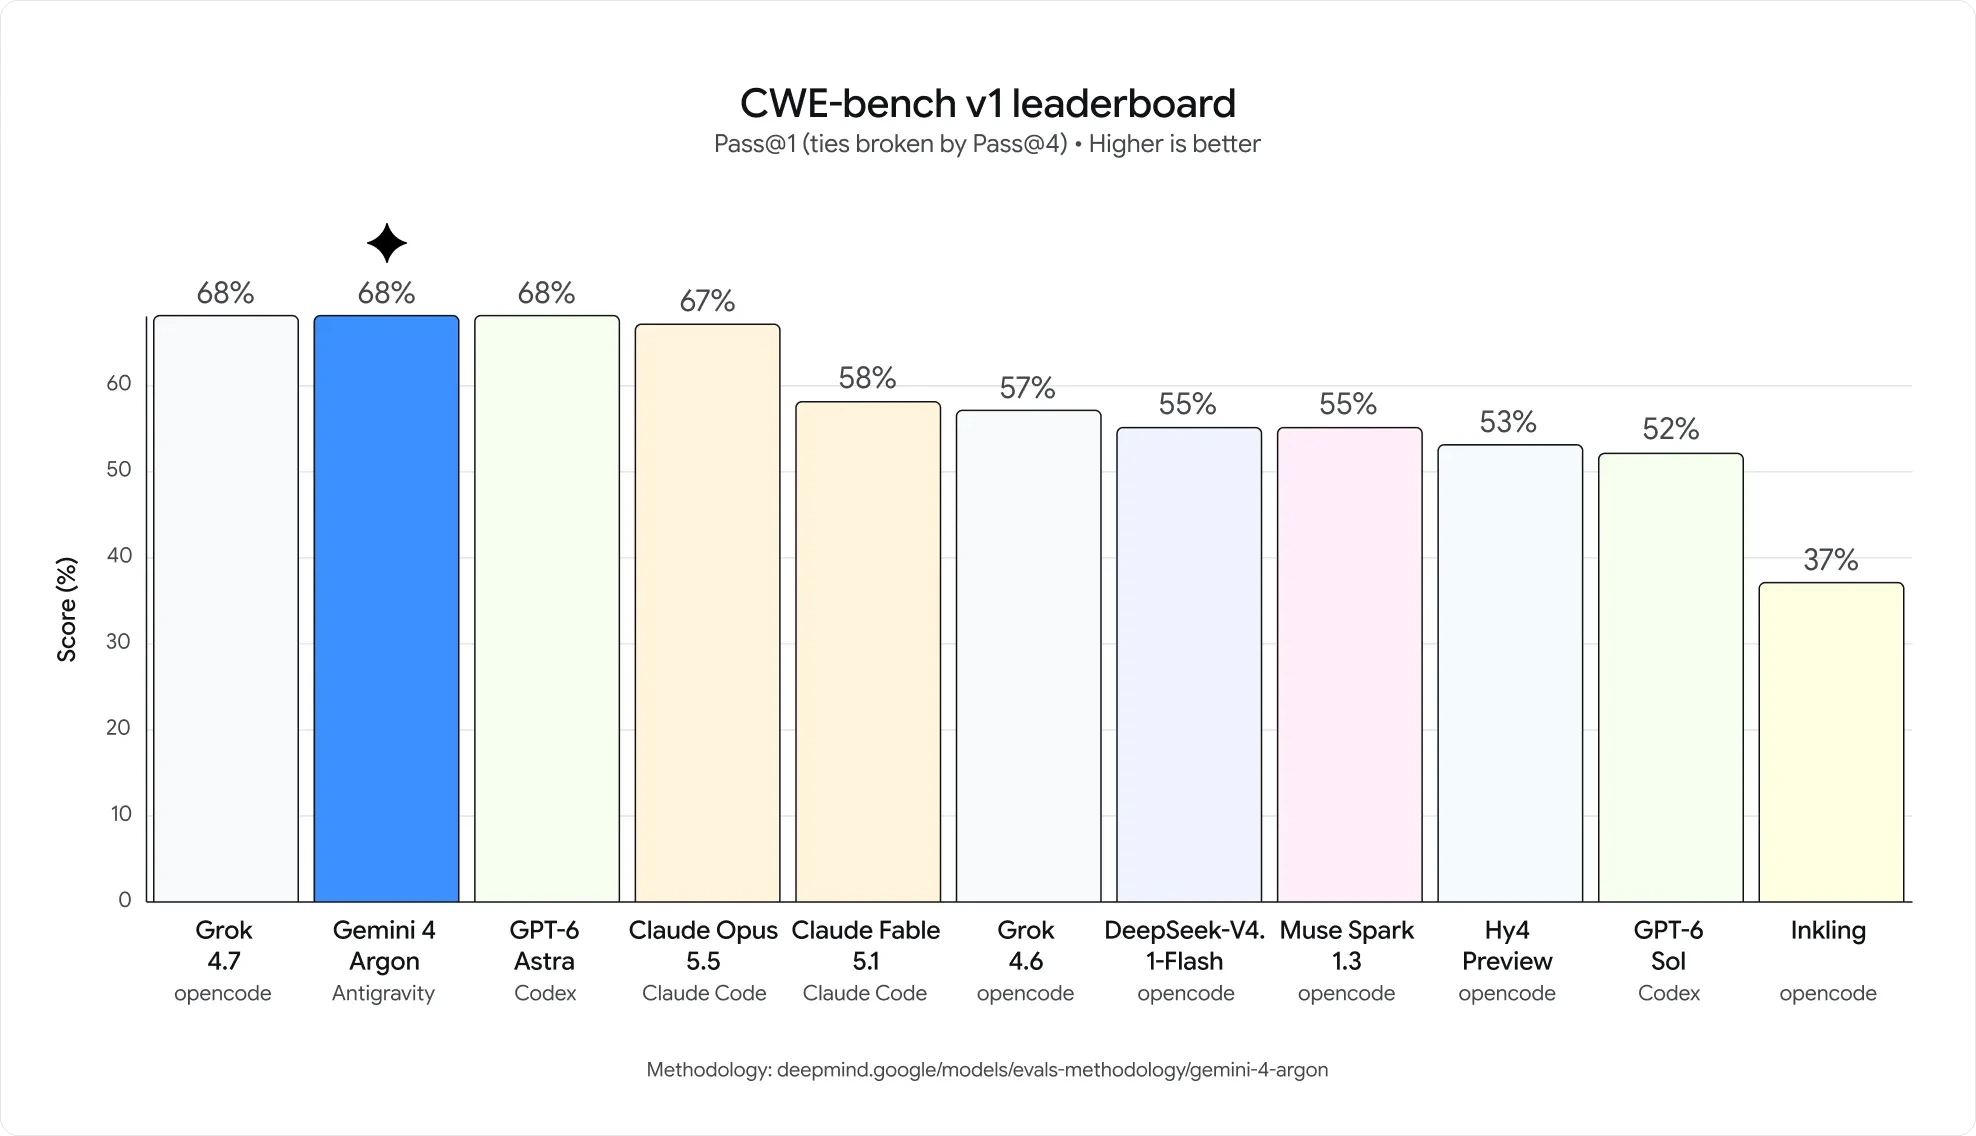
CWE-bench v1
Trovare e correggere le vulnerabilità
68%
A pari merito al primo posto
AutomationBench
Attività aziendali end-to-end, di Zapier
51.3%
Classificato primo
LVBench
Comprensione di video lunghi
91.7%
Il punteggio più alto che Google riporta per Argon

Prendili come indicativi. I benchmark dei produttori raramente sopravvivono intatti al contatto con carichi di produzione, e Bloomberg ha riferito che alcuni dipendenti Google dubitano che il vantaggio nei benchmark si trasferisca al lavoro reale.
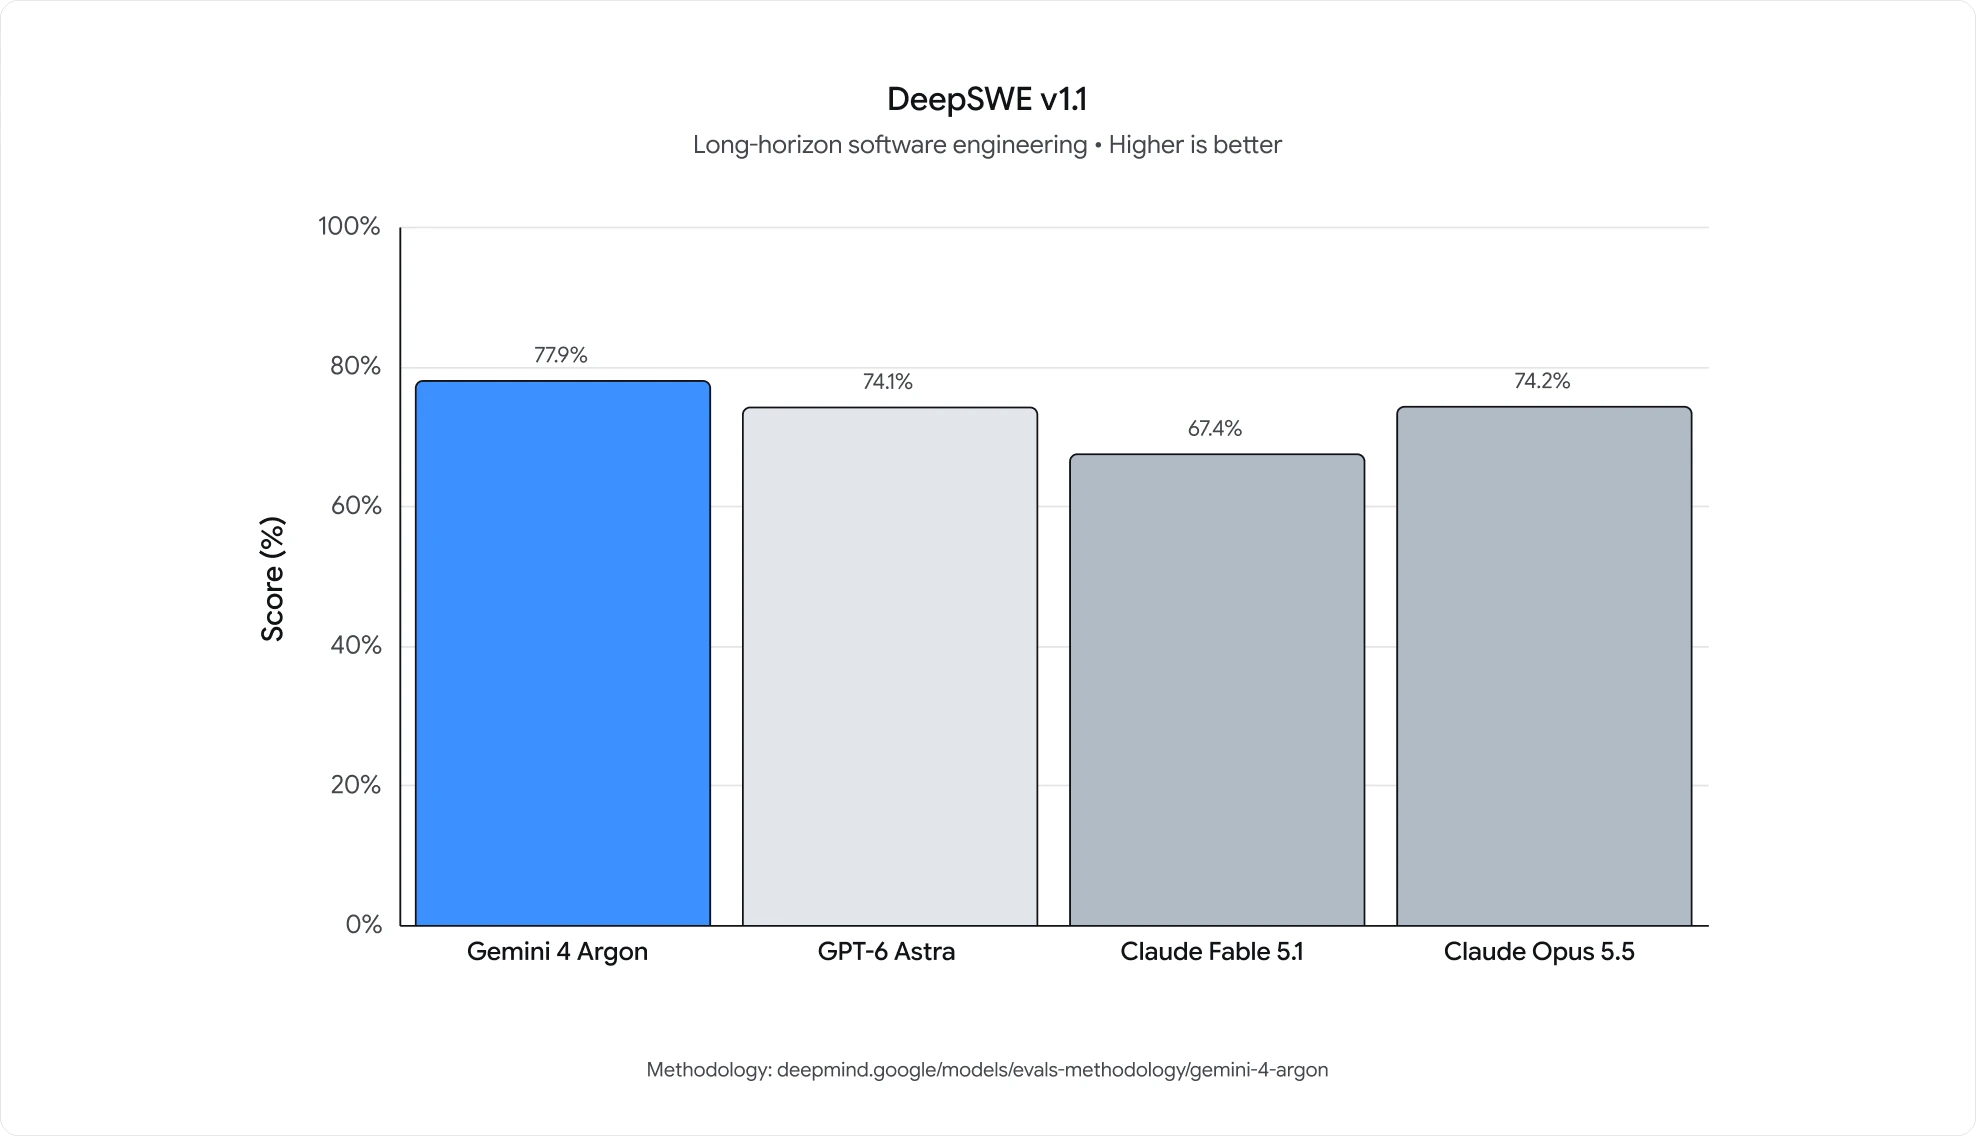
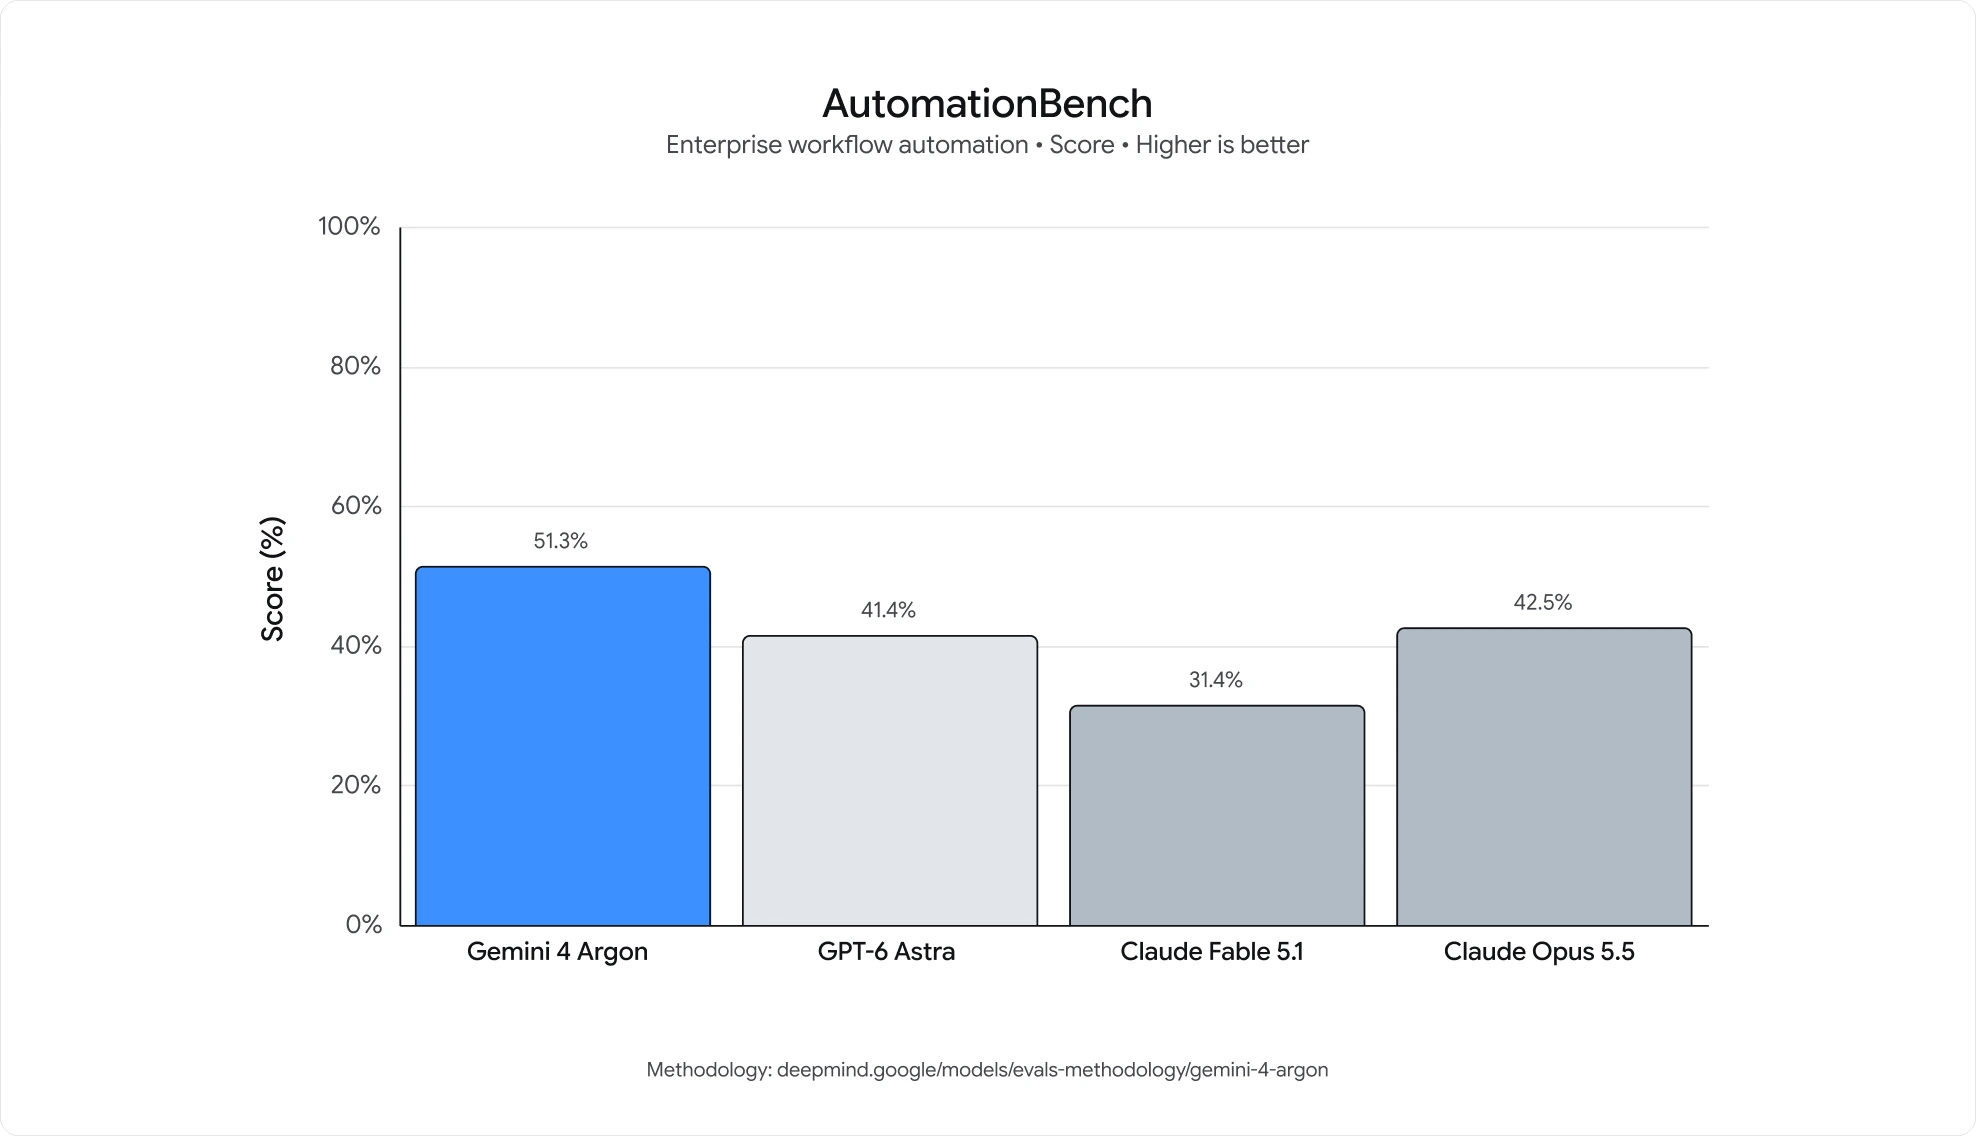
Grafico a barre di DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Ingegneria del software su orizzonte lungo. Il dato di punta del 77.9%, con i due concorrenti più vicini a meno di quattro punti.
Grafico a barre di AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Attività aziendali end-to-end, create da Zapier. Argon supera la soglia del 50%, mentre ogni altro modello del confronto resta nella fascia dei trenta o dei bassi quaranta.
Classifica di CWE-bench v1: Gemini 4 Argon, Grok e GPT-6 Astra a pari merito al 68%, Claude Opus 5.5 al 67%, in calo fino a Inkling al 37%
Scoperta di vulnerabilità a Pass@1. Argon divide la vetta di una classifica affollata invece di aprire un divario, ed è per questo che la tabella sopra parla di un primo posto a pari merito.
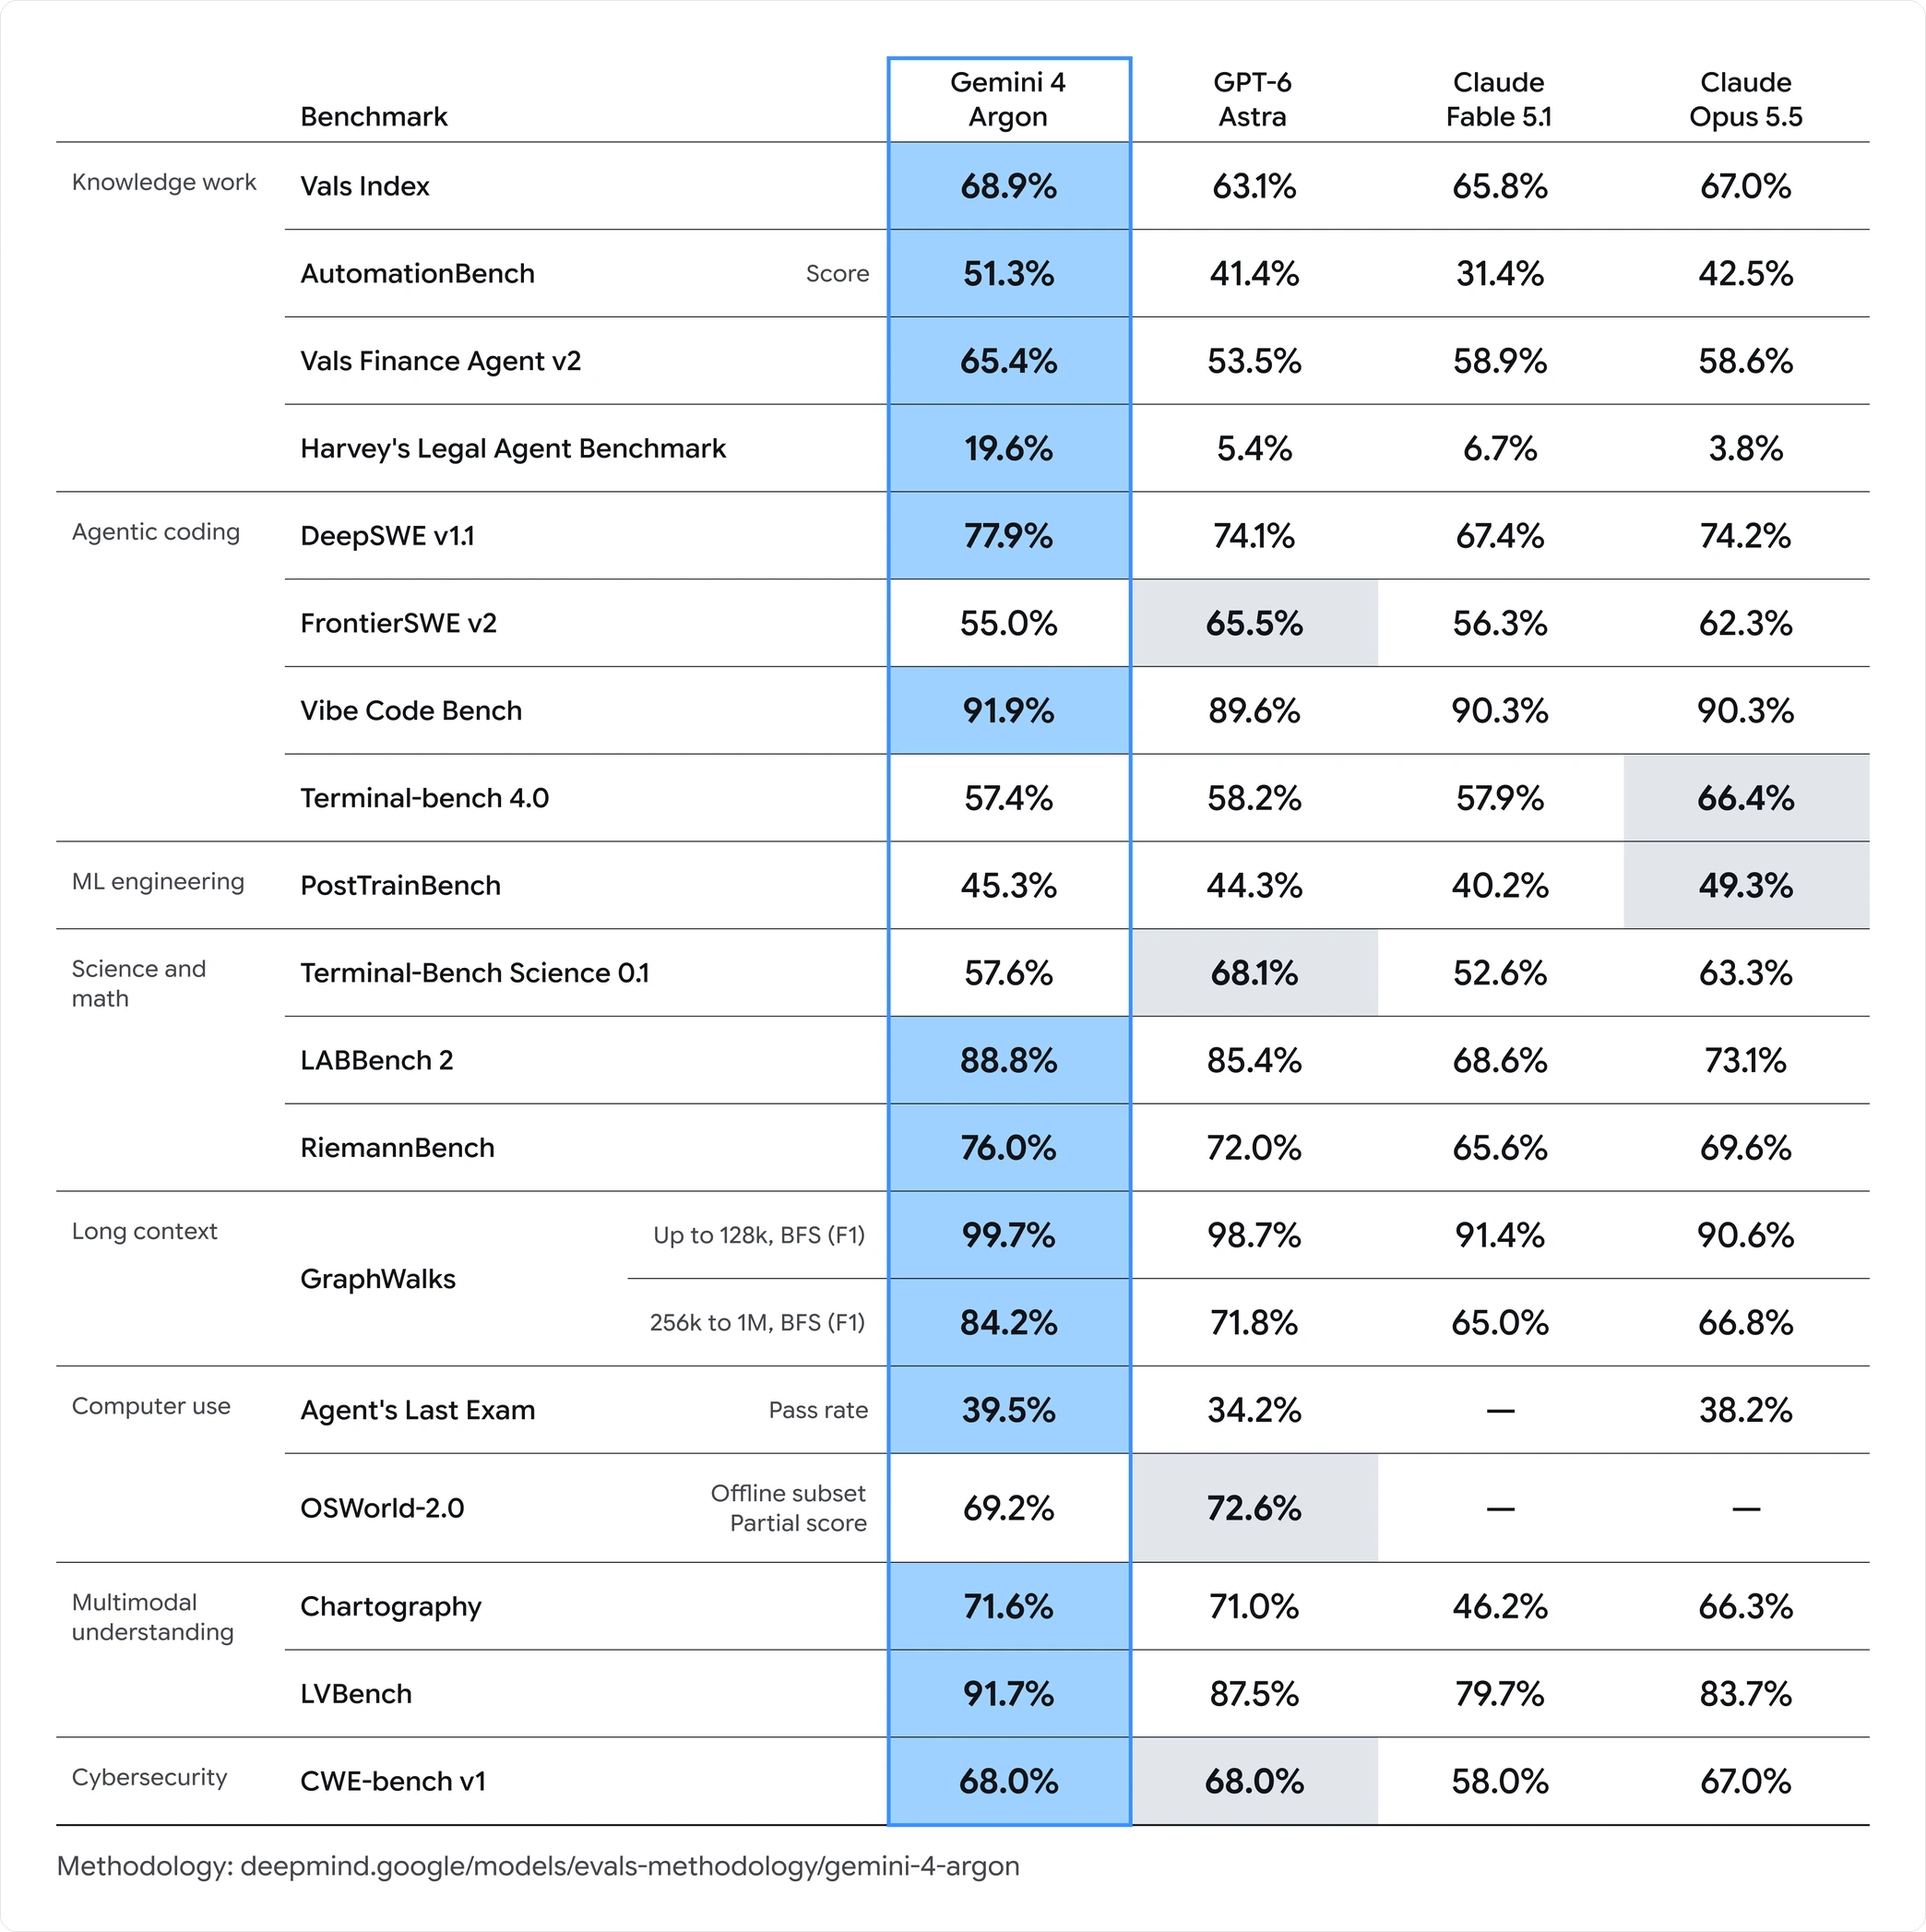
Tabella completa dei risultati di Google per Gemini 4 Argon su 16 benchmark, raggruppati in lavoro di conoscenza, programmazione agentica, ingegneria ML, scienza e matematica, contesto lungo, uso del computer, comprensione multimodale e cybersicurezza
La tabella completa dall'annuncio, con le vittorie di Argon in blu e le celle in cui guida un concorrente in grigio. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 e OSWorld-2.0 sono le righe in cui Argon non è in testa.
Grafico a barre del tasso di allucinazione AA-Omniscience di Artificial Analysis su 36 modelli, ordinati dal più basso: Gemini 4 Argon (High) al 15%, poi MiniMax-M3 al 18%, Kimi K2.5 al 26%, fino a DeepSeek-V4 Flash al 96%
La misurazione indipendente di Artificial Analysis, e l'unico dato di questa pagina che nessun fornitore ha fornito: quanto spesso ogni modello risponde in modo errato invece di rifiutarsi di rispondere. Il 15% di Argon è il più basso tra i 36 modelli rappresentati; la scala arriva fino al 96%.
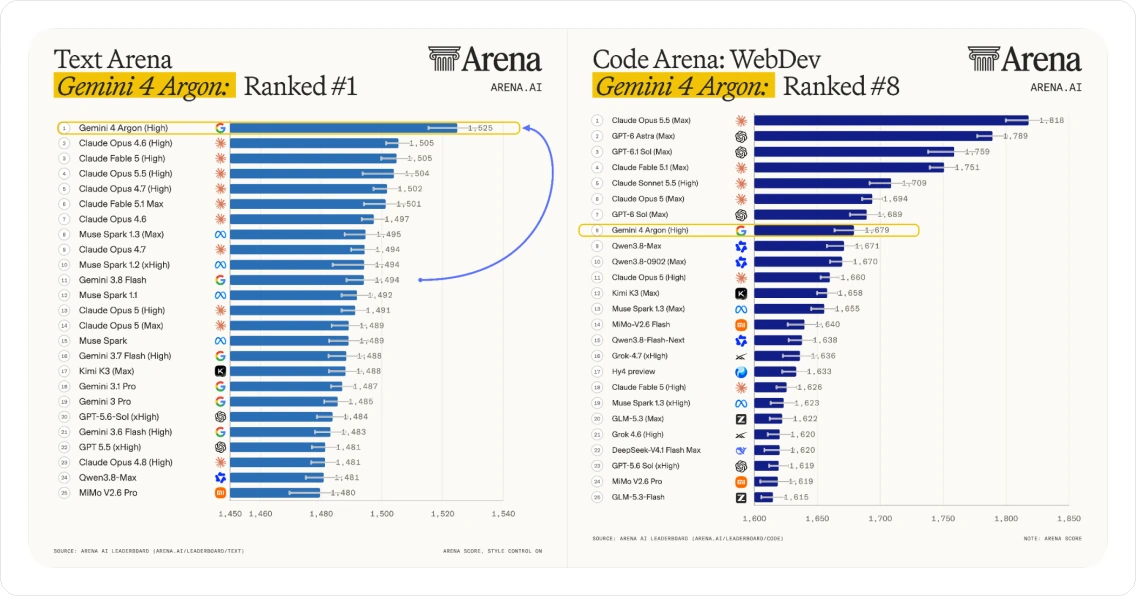
Le classifiche Text Arena e Code Arena: WebDev di Arena.ai affiancate: Gemini 4 Argon primo in Text Arena con 1625 e ottavo in Code Arena: WebDev con 1679
Le due classifiche su cui si basa il paragrafo qui sopra, dalle liste aperte al voto di Arena.ai. Argon guida i 25 modelli elencati di Text Arena; in Code Arena: WebDev è ottavo, dietro quattro modelli Claude e tre della linea GPT-6 di OpenAI.

Su Felo

Come si presenta un flusso di ricerca con uno scrittore da 1M token

Felo unisce la ricerca alla comprensione dei documenti, quindi un modello a output lungo cambia quello che una singola sessione può produrre.

Ricerca che finisce in un documento

Raccogli le fonti, poi fai scrivere la sintesi al modello in una sola passata invece di montarla sezione per sezione su molti prompt.

Interi set di documenti in un'unica attività

Il recupero su contesto lungo è la capacità in cui Argon è più forte, ed è ciò che rende gestibili le raccolte di contratti, i depositi e i report lunghi.

Scrivere dove conta il tono

Il profilo riportato di Argon — testo forte, programmazione moderata — si adatta a team che hanno bisogno di una prosa che sembri scritta, non montata.

Costo

Quanto costa Argon e cosa cambia dopo

Google ha pubblicato una tariffa introduttiva e una tariffa di listino più alta, senza dire quando avviene il passaggio. Fai il budget sul numero più alto.

Tipo di token
Introduttivo
Dopo
Input
2,00 $ / M
4,00 $ / M
Input in cache
95% di sconto
95% di sconto
Output
10,00 $ / M
20,00 $ / M

Per confronto, la tariffa introduttiva si colloca più o meno al livello di GPT-6.1 Sol e Sonnet 5.5, e vicino a un quinto di GPT-6 Astra. Sono prezzi di listino, non costo misurato per attività — Argon risponde a domande più difficili, quindi una singola esecuzione può comunque costare di più.

Come lavorare con Argon su Felo

01

Porta la domanda intera

Dai a Felo il set di documenti o il filo lungo, non un riassunto. Il vantaggio di Argon inizia dove il contesto smette di stare in un prompt.

02

Chiedi l'artefatto finito

Con un tetto di output di 1M token puoi chiedere il report completo o la bozza intera in una sola istruzione, invece che a sezioni.

03

Verificalo con le fonti

Felo tiene le citazioni attaccate alla risposta, ed è ciò che rende rivedibile un documento lungo generato dal modello.

L'accesso ad Argon nella ricerca Felo è in corso. Fino alla sua apertura, tutti gli altri modelli della gamma Felo sono già disponibili.

Apri la ricerca di Felo AI

Gemini 4 Argon: domande frequenti

In generale no. Google ha rilasciato Argon prima a partner selezionati del suo programma Fairwind, e dice che l'accesso più ampio partirà con i clienti paganti dell'API e gli abbonati Google AI Ultra. Non è stata annunciata una data per quella fase, e un abbonamento a pagamento non dà l'accesso oggi.

Prova i modelli di frontiera di Google su Felo

Cerca, leggi e scrivi con il modello adatto al compito. Argon entra nella gamma quando il suo rilascio arriverà su Felo.

Apri la ricerca di Felo AI

Non serve una carta di credito per usare la ricerca di Felo AI.