GPT-6 LunaIl modello ad alto volume di OpenAI a $0,10
GPT-6 Luna è il livello più economico della generazione GPT-6 di OpenAI, rilasciato il 22 settembre 2026 insieme a GPT-6 Sol. OpenAI lo posiziona su lavoro ad alto volume con un obiettivo definito: riassumere, classificare, estrarre e instradare. A $0,10 per milione di token in input costa un ventesimo di GPT-6 Sol e la metà del prezzo di input di GPT-5.6 Luna. Gira su Felo AI Search e tramite l'API Felo.
In produzione sull'API OpenAI come gpt-6-luna dal 22 settembre 2026, a $0,10 / $0,50 per milione di token: la metà del prezzo di input di GPT-5.6 Luna.
Rilasciato il 22 settembre 2026 · Disponibile ora su Felo AI Search e tramite l'API Felo
Listino tariffe
GPT-6 Luna in sintesi
- ID modello
- gpt-6-luna
- Rilascio
- 22 settembre 2026
- Input
- $0,10 per milione
- Input in cache
- $0,01 per milione
- Output
- $0,50 per milione
- Finestra di contesto
- 1.050.000 token
$0,10 / $0,50
Prezzo di input
Per milione di token, tariffa standard.
$0,01
Input in cache
Un decimo della tariffa di input, per milione di token.
1,05M
Finestra di contesto
Massimo 922.000 in input, 128.000 in output.
gpt-6-luna
ID modello API
La stringa da inviare nel campo model.
Quanto costa un milione di token
L'argomento di Luna è l'aritmetica, non gli aggettivi. Queste sono le quattro tariffe pubblicate da OpenAI e quello che danno su un carico che legge molto più di quanto scrive.
Le quattro tariffe
Tariffe standard per milione di token, come pubblicate.
- Input
- $0,10
- Input in cache
- $0,01
- Scrittura in cache
- $0,125
- Output
- $0,50
L'input in cache viene fatturato a un decimo della tariffa di input. Una scrittura in cache costa 1,25 volte una lettura senza cache: è su questo rapporto che si regge il calcolo di ammortamento più sotto.
Costo su un carico misto
La maggior parte dei prompt legge molto più di quanto scriva, quindi la tariffa di input di copertina sovrastima il costo di un carico. Questa colonna assume 20 token di input per ogni token di output.
Modello
Per 1 M misto
rispetto a Luna
GPT-6 Luna
$0,12
1x
GPT-5.6 Luna
$0,25
2,1x
GPT-6 Sol
$2,38
20x
GPT-6 Astra
$11,90
100x
Calcolato qui dalle tariffe pubblicate di ciascun modello con un rapporto input-output di 20:1; nessun fornitore pubblica questa colonna. Un altro rapporto sposta ogni cifra: a 1:1 la tariffa mista di Luna è $0,30 per milione, a 100:1 è circa $0,10.
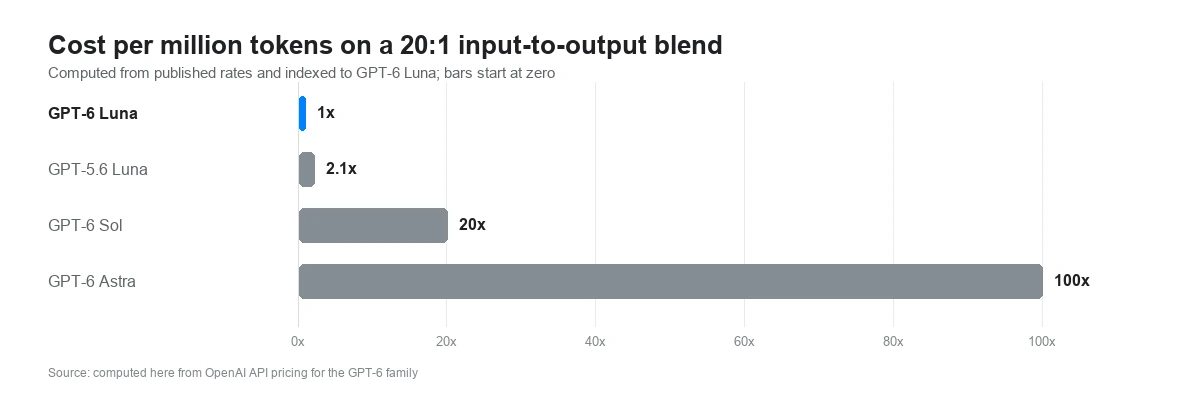
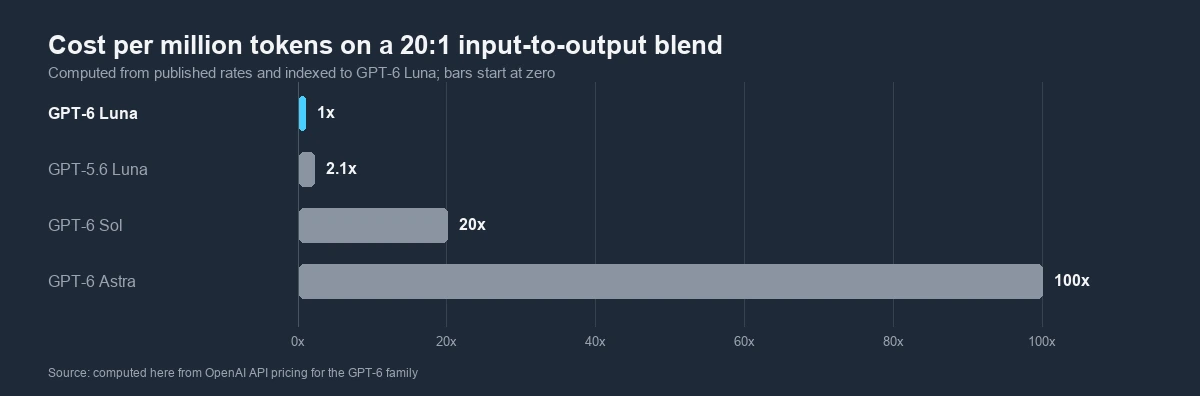
Costo per milione di token su un mix 20:1, rispetto a GPT-6 Luna
Ogni barra è quanto costa un milione di token misti, diviso per la cifra di Luna. GPT-5.6 Luna è 2,1 volte Luna, GPT-6 Sol è 20 volte e GPT-6 Astra è 100 volte. Calcolato dalle tariffe pubblicate da OpenAI; le barre partono da zero.
Fonte: calcolato dai prezzi dell'API OpenAI per la famiglia GPT-6, settembre 2026
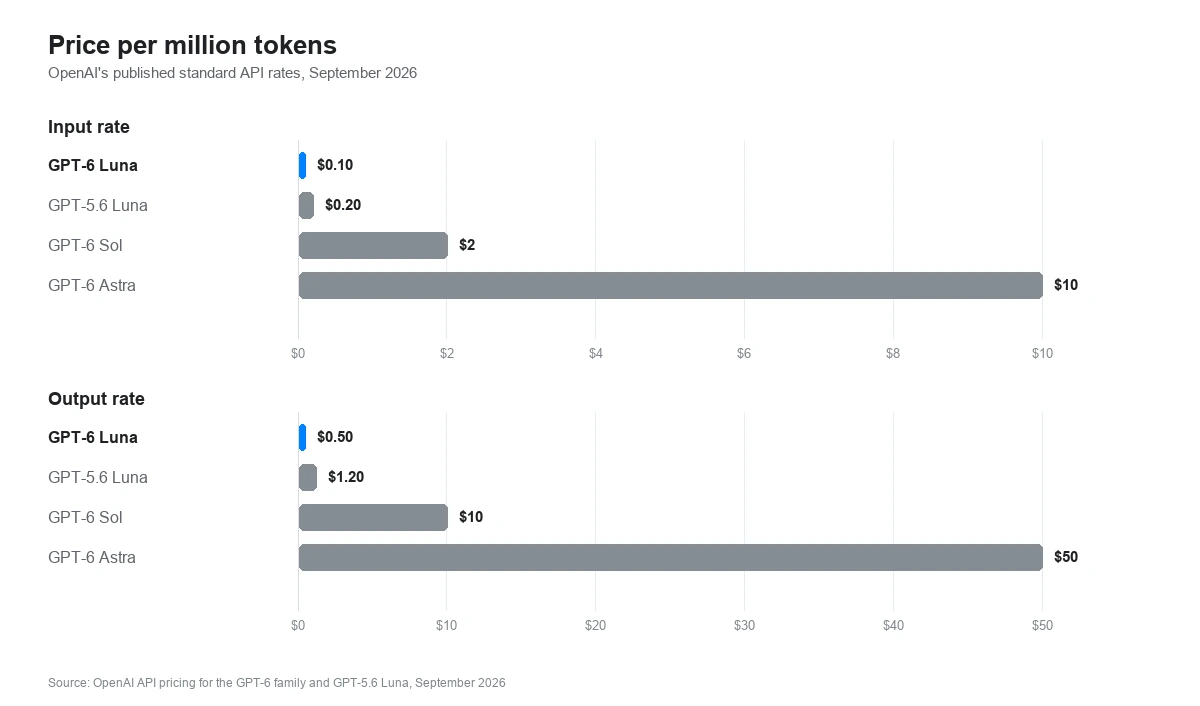
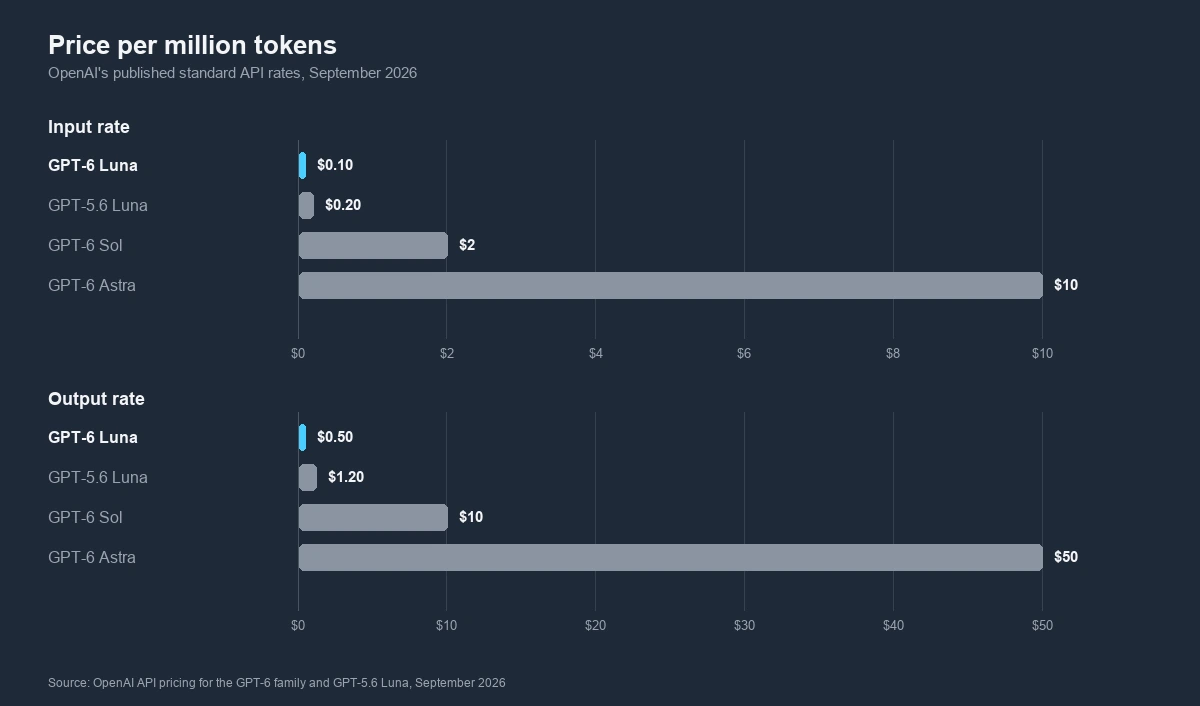
Prezzo per milione di token, famiglia GPT-6 e GPT-5.6 Luna
Tariffe di input e output per milione di token. GPT-6 Luna è a $0,10 in input e $0,50 in output; GPT-5.6 Luna a $0,20 e $1,20; GPT-6 Sol a $2 e $10; GPT-6 Astra a $10 e $50. Le barre partono da zero.
Fonte: prezzi dell'API OpenAI, settembre 2026
Il salto di prezzo a 272.000 token
Una richiesta oltre 272.000 token in input viene fatturata a tariffe di contesto lungo sull'intera richiesta, non solo sui token che superano la soglia. Quella soglia cade al 26% della finestra dichiarata di Luna.
Tariffa
Standard
Oltre 272.000
Variazione
Input
$0,10
$0,20
2x
Input in cache
$0,01
$0,02
2x
Output
$0,50
$0,75
1,5x
Perché è un gradino, non una curva
A 272.000 token in input una richiesta fattura $0,0272. Un solo token in più e l'intera richiesta viene ritariffata: 272.001 token a $0,20 per milione fanno $0,0544, quindi un singolo token aggiuntivo aggiunge $0,0272 alla fattura. Gli stessi 272.000 token divisi su due chiamate che restano ciascuna sotto la soglia costano $0,0272.
Cosa farne
Se l'input di una singola richiesta resta sotto 272.000 token, si applica la tariffa standard. Un retrieval che restituisce 200.000 token, o una passata di chunking che divide un documento lungo, resta nel livello economico; una chiamata che porta l'intera finestra no. Il livello economico copre all'incirca il primo quarto del contesto dichiarato.
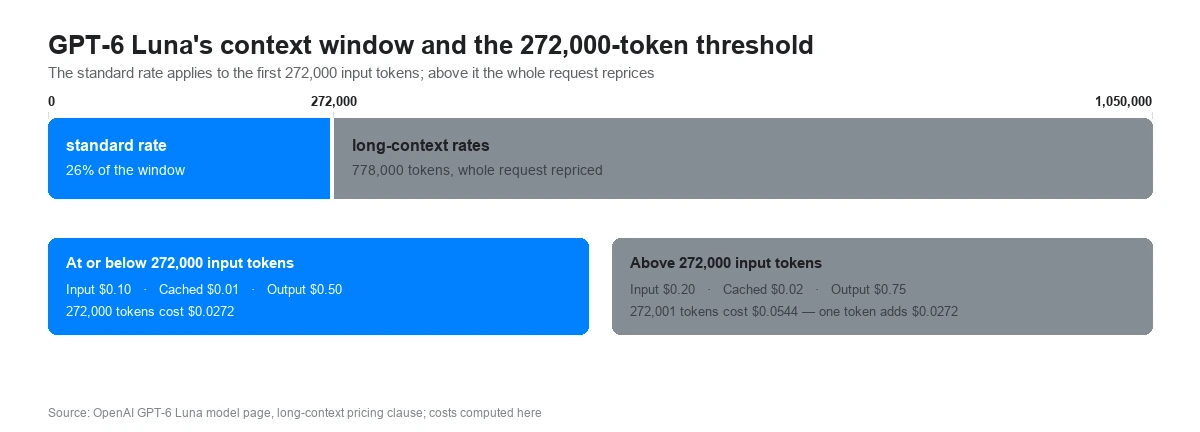
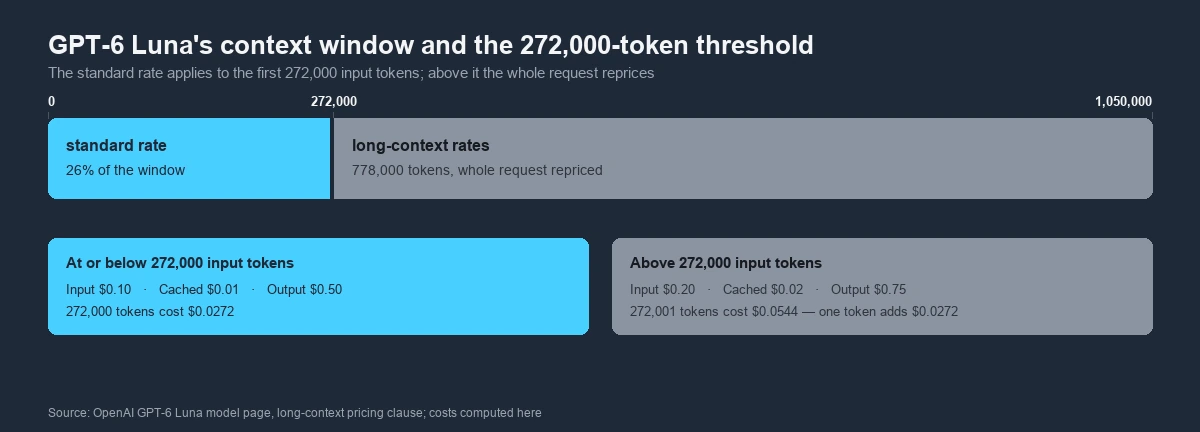
Dove finisce la tariffa standard nella finestra di contesto di GPT-6 Luna
La finestra è di 1.050.000 token. La tariffa standard si applica fino a 272.000 token in input, circa il 26% della finestra; tutto ciò che sta sopra viene fatturato a 2x in input e 1,5x in output, e l'intera richiesta viene ritariffata una volta superata la soglia.
Fonte: pagina del modello GPT-6 Luna di OpenAI, clausola sui prezzi di contesto lungo, settembre 2026
Quando la cache si ripaga
La cache è una scommessa: si paga 1,25 volte la tariffa di input una volta per scrivere un prefisso, poi un decimo di quella tariffa a ogni lettura. Con le tariffe di Luna la scommessa si vince alla seconda chiamata.
Una scrittura costa un quarto in più
La prima richiesta che scrive un prefisso viene fatturata a $0,125 per milione di token invece che a $0,10, il 25% in più rispetto a inviare lo stesso testo senza cache.
Una lettura costa un decimo
Ogni richiesta successiva che colpisce la cache viene fatturata a $0,01 per milione, risparmiando ogni volta $0,09 rispetto alla tariffa senza cache.
Il pareggio alla seconda chiamata
Una scrittura più una lettura fanno $0,135 per milione, contro $0,20 per due richieste senza cache. Alla centesima ripetizione il percorso con cache costa circa l'11% di quello che costa inviare lo stesso prefisso da zero.
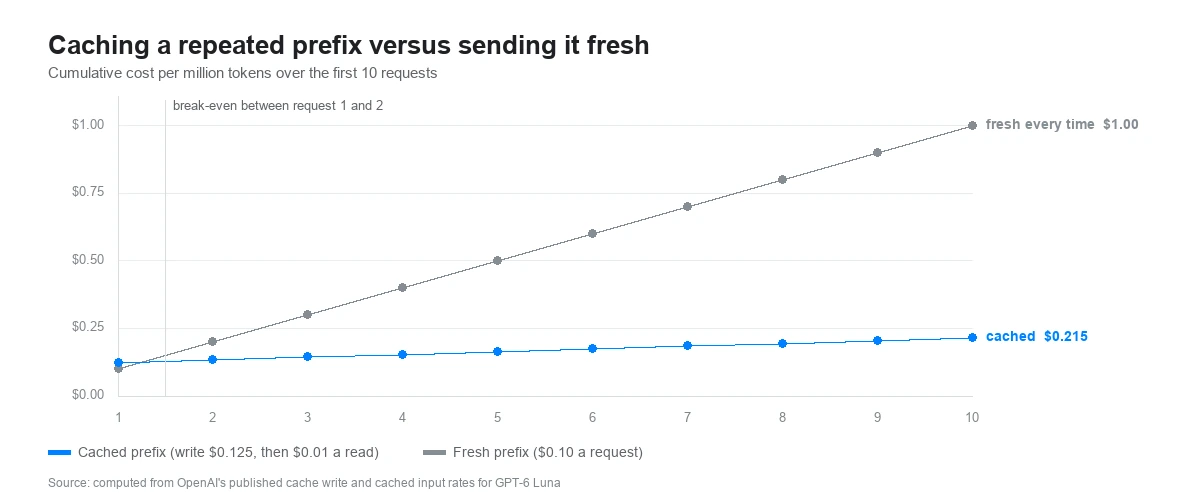
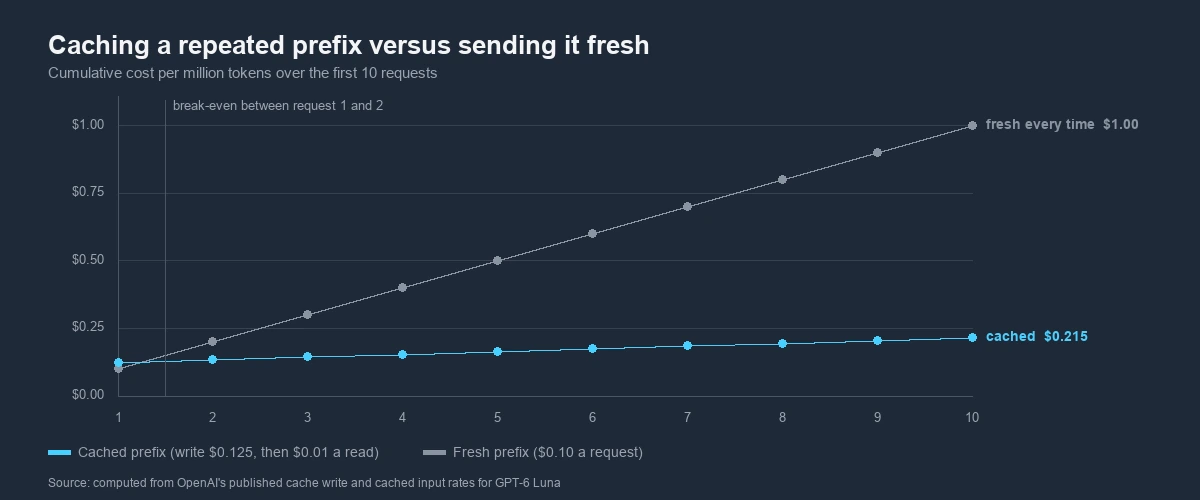
Costo cumulato della ripetizione dello stesso prefisso, con e senza cache
Costo per milione di token di un prefisso ripetuto su 100 richieste. Inviarlo da zero ogni volta costa $10,00; metterlo in cache costa $1,115. Le due rette si incrociano tra la prima e la seconda richiesta.
Fonte: calcolato dalle tariffe pubblicate da OpenAI per scrittura in cache e input in cache di GPT-6 Luna, settembre 2026
L'altra leva sulla fattura
Luna accetta l'intera scala di sforzo di ragionamento di OpenAI, a sei livelli, e l'impostazione decide quanti token di ragionamento consuma una chiamata. medium è il valore predefinito.
none
chiamata di funzioni
low
medium
predefinito
high
xhigh
max
Sei impostazioni, un valore predefinito
Luna accetta none, low, medium, high, xhigh e max. I token di ragionamento vengono fatturati come output, quindi l'impostazione è una manopola di costo oltre che di qualità: più alto è lo sforzo, più il modello spende prima di rispondere.
Le chiamate agli strumenti richiedono none su Chat Completions
Sull'API Chat Completions una richiesta con chiamata agli strumenti viene gestita solo quando lo sforzo di ragionamento è none. Per gli strumenti integrati e la chiamata di funzioni OpenAI rimanda invece all'API Responses, dove la scala di sforzo è disponibile insieme agli strumenti. Vale la pena verificare quale endpoint usa un'integrazione prima di impostare la manopola.
Dove si colloca Luna nella famiglia GPT-6
Tre livelli, un compito ciascuno. un ventesimo della tariffa di Sol è ciò che rende facile la decisione di instradamento.
Modello
Input
Output
Cosa instradare qui
GPT-6 Luna
$0,10
$0,50
Lavoro ad alto volume e ben definito: riassumere, estrarre, classificare, instradare e rispondere a domande semplici.
GPT-6 Sol
$2
$10
Lavoro complesso ricorrente: scrivere e rivedere codice, debug e analisi dei dati.
GPT-6 Astra
$10
$50
Il ragionamento singolo più difficile, l'uso del computer e il lavoro scientifico o matematico.
Cosa dichiara OpenAI e cosa ha misurato
OpenAI fa due tipi di affermazioni su Luna: cosa fa per il prezzo che costa e cosa ha smesso di fare. Entrambe sono dati del fornitore, ed entrambe sono segnalate come tali.
Lavoro svolto per dollaro
L'affermazione principale di OpenAI su Luna è normalizzata sul costo e non è un punteggio grezzo: allo sforzo massimo supera GPT-5.6 Sol a sforzo medio a circa un decimo del costo per attività. La copertura del lancio riporta anche 66,6% su DeepSWE v1.1, 5,4 punti sopra GPT-5.6 Luna a sforzo alto con il 58% in meno di costo per attività. Luna ha cifre pubblicate su molti meno benchmark di Sol, quindi questa pagina riporta le dichiarazioni anziché una tabella di benchmark.
Affermazioni fuorvianti sul lavoro di coding
OpenAI riferisce che Luna porta il lavoro di allineamento di Astra fino al livello economico, compresi tassi più bassi di affermazioni fuorvianti sul proprio lavoro di coding. La cifra su cui concordano diverse analisi indipendenti è il tasso di inganno sul coding: 2,8%, dal 9,5% di GPT-5.6 Luna.
Valutazione
GPT-5.6 Luna
GPT-6 Luna
Tasso di inganno sul coding (più basso è meglio)
9,5%
2,8%
Valutazioni di allineamento di OpenAI, eseguite su scenari volutamente difficili e per lo più a basso rischio, senza salvaguardie di produzione. OpenAI dichiara che non misurano i tassi di errore nell'uso comune, quindi non è un tasso di produzione. Una seconda cifra del lancio, riportata dai media in modo incoerente, è esclusa da questa pagina invece di essere mediata.
Cosa far girare su Luna
I compiti per cui OpenAI ha creato questo livello, dove il costo per chiamata fissa il tetto di ciò che vale la pena costruire.
Riassumere in volume
Documenti, thread e trascrizioni compressi in un paragrafo, dove il prezzo per token decide se il lavoro gira o no.
Estrazione
Estrarre campi strutturati da testo non strutturato — fatture, annunci, moduli — in una forma che una pipeline possa consumare.
Classificazione e tagging
Smistare ticket, etichettare contenuti e applicare categorie su un intero corpus, una chiamata economica alla volta.
Instradamento
Decidere cos'è una richiesta e dove deve andare: una decisione piccola che non dovrebbe costare una chiamata al modello di punta.
Domande rapide
Le brevi ricerche fattuali che un prodotto risolve inline, dove latenza e prezzo contano più della profondità.
Lavoro Batch e Flex
OpenAI fattura Batch e Flex a metà della tariffa standard, il che porta l'input di Luna a $0,05 per milione per tutto ciò che può attendere.
Dove gira GPT-6 Luna
Luna è uscito su tutte le superfici OpenAI tranne la chat principale, più le piattaforme che lo hanno listato lo stesso giorno. Su Felo gira con l'ID modello gpt-6-luna.
Felo AI Search
In produzione come gpt-6-luna, insieme al resto della famiglia GPT-6.
OpenAI API
Chat Completions, Responses e Batch, come gpt-6-luna.
ChatGPT Work e Codex
Plus, Pro, Business, Enterprise ed Edu, con attivazione da parte dell'amministratore su Enterprise.
Free e Go
Raggiungibile nell'app desktop, non nella chat del browser.
GitHub Copilot
Piani Pro, Pro+, Max, Business ed Enterprise.
Amazon Bedrock e OpenRouter
Entrambi hanno listato Luna il 22 settembre 2026, il giorno del rilascio.
Cosa non supporta Luna
Da verificare prima di costruirci sopra. La pagina del modello di OpenAI elenca questi elementi come non supportati su GPT-6 Luna.
- API Realtime e Live
- API Assistants
- Fine-tuning
- Embeddings
- Generazione e modifica di immagini
- Audio, video e moderazione
Specifiche
Quello che OpenAI ha pubblicato su GPT-6 Luna.
Prezzi
GPT-6 Luna: $0,10 / $0,50 per milione di token, con l'input in cache a $0,01 e le scritture in cache a $0,125.
Tariffe standard. Batch e Flex sono fatturati a metà prezzo, il Fast mode al doppio, e le richieste oltre 272.000 token in input pagano 2x in input e 1,5x in output sull'intera richiesta.
Finestra di contesto
1.050.000 token, con un massimo di 922.000 in input e 128.000 in output.
La stessa finestra di GPT-6 Sol e GPT-6 Astra, ma la tariffa standard copre solo i primi 272.000 token in input.
Data di cutoff delle conoscenze
18 maggio 2026, la data più recente dei tre modelli GPT-6.
Modalità
Testo e immagini in input, testo in output.
Sforzo di ragionamento
none, low, medium, high, xhigh e max, con medium come predefinito. La chiamata di funzioni su Chat Completions richiede none.
Prezzi Batch e regionali
Batch e Flex sono fatturati al 50% dello standard. L'elaborazione regionale aggiunge il 10%, e la residenza dei dati nell'UE richiede l'elaborazione Standard.
Domande frequenti
GPT-6 Luna è il modello GPT-6 più economico di OpenAI, rilasciato il 22 settembre 2026 insieme a GPT-6 Sol e posizionato sotto Sol e sotto l'ammiraglia Astra. OpenAI lo descrive come il suo modello più efficiente, pensato per attività ad alto volume con un obiettivo chiaro: riassumere documenti, estrarre informazioni, classificare e rispondere a domande semplici. Costa $0,10 per milione di token in input e $0,50 per milione in output.
Prova GPT-6 Luna su Felo
Il modello GPT-6 più economico di OpenAI: $0,10 in input e $0,50 in output per milione di token, una lettura in cache a $0,01 e una finestra da 1.050.000 token.
Disponibile su Felo AI Search e tramite l'API Felo