01
Sostener todo el contexto
Una ventana de contexto de un millón de tokens y conocimientos hasta junio de 2026. Un hilo largo, un repositorio entero o un conjunto de documentos caben en una sola tarea.
Anthropic publicó Opus 5.5 el 22 de septiembre de 2026
El primer modelo de la familia Claude 5.5. Alcanza el nivel de Claude Fable 5.1 en la mayoría de las tareas, cuesta un 40 % menos de ejecutar que Opus 5 y genera la salida más de un 30 % más rápido.
Ya disponible en la búsqueda de Felo
Claude Opus 5.5 está disponible en la búsqueda de Felo para tareas con entradas largas: cuadrar cifras entre archivos, rastrear una afirmación hasta su fuente y devolver una respuesta que puedas pasar a otra persona.
01
Una ventana de contexto de un millón de tokens y conocimientos hasta junio de 2026. Un hilo largo, un repositorio entero o un conjunto de documentos caben en una sola tarea.
02
En una prueba interna de Anthropic, 16 de 18 informes superaron el listón de calidad. Una sola cifra o cita inventada habría hecho fracasar el ejercicio.
03
Anthropic rehizo la forma de comunicarse del modelo: lo más importante va primero y el informe dice sin rodeos qué está hecho, qué se encontró y qué queda abierto.
Guía rápida
Claude Opus 5.5 aparece en el selector de modelos junto a los demás modelos punteros de tu cuenta.
La diferencia de Opus 5.5
Anthropic pone el foco en la eficiencia y no en una puntuación más alta: menos tokens por tarea, un precio por token más bajo y un 40 % menos de coste en cargas de trabajo típicas. Eso es lo que hace pagable dejar un agente trabajando durante horas.
01
Anthropic cuenta que un probador auditó y corrigió una base de código de 200.000 líneas en menos de tres horas, donde Opus 5 tardaba más de 20 horas y usaba 2,5 veces más tokens.
02
Deloitte informó de que, en el nivel de effort más bajo, Opus 5.5 detectó el 72 % de los errores conocidos en revisión de código, frente al 56 % de Opus 5 en high, con menos falsos positivos.
03
Sus textos son más cortos y están mejor estructurados. Box informó de respuestas un 40 % menos verbosas sin perder precisión y con un tercio de los tokens de Opus 5.
Elección de modelo
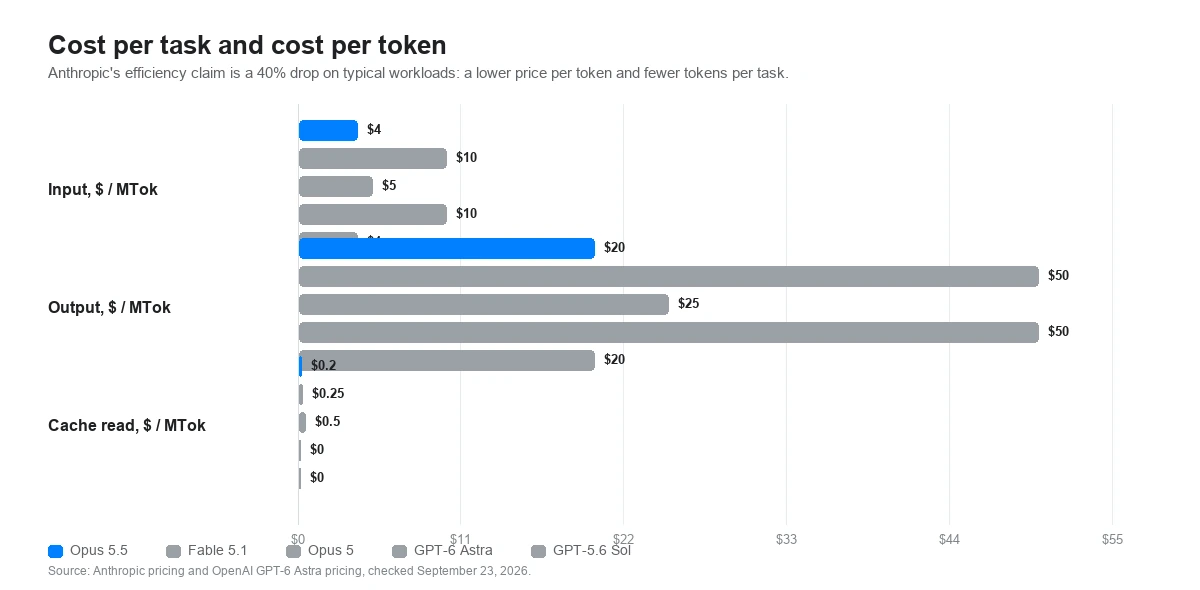
Los precios de abajo son tarifas públicas oficiales de la API por millón de tokens, no precios de suscripción ni de uso de Felo. La fila de effort importa tanto como la de precio: el mismo prompt puede costar muy distinto según dónde arranque cada modelo.
Las tarifas públicas de la API y los valores por defecto se comprobaron el 23 de septiembre de 2026 en el anuncio de Claude Opus 5.5 de Anthropic, las páginas de modelos de Claude Platform y la página de GPT-6 Astra de OpenAI. El precio por token es solo una parte del coste total de una tarea. La afirmación de eficiencia de Anthropic es una bajada del 40 % en cargas típicas, que combina un precio por token menor con menos tokens por tarea.
Resultados publicados por Anthropic
Anthropic publicó sus propias cifras junto a Fable 5.1, Opus 5, GPT-6 Astra y GPT-5.6 Sol. Dos de los cuatro gráficos de abajo muestran precisión frente a coste por tarea en lugar de precisión a secas, porque esa es justo la comparación que plantea Anthropic.
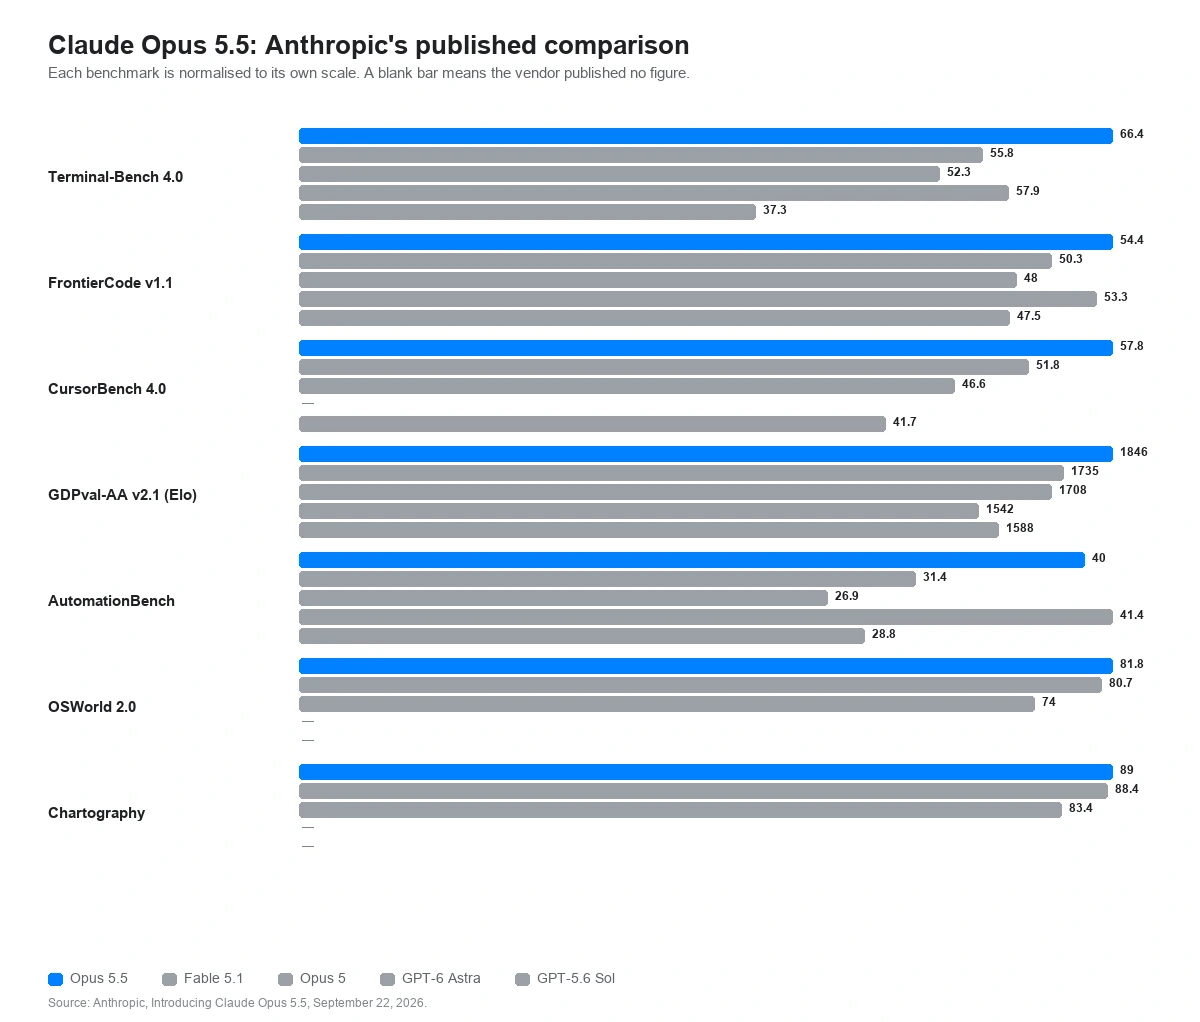
La comparativa publicada al completo
Programación agéntica, trabajo de conocimiento, flujos de negocio, razonamiento multidisciplinar, investigación científica, uso del ordenador y lectura de gráficos, en los cinco modelos medidos.
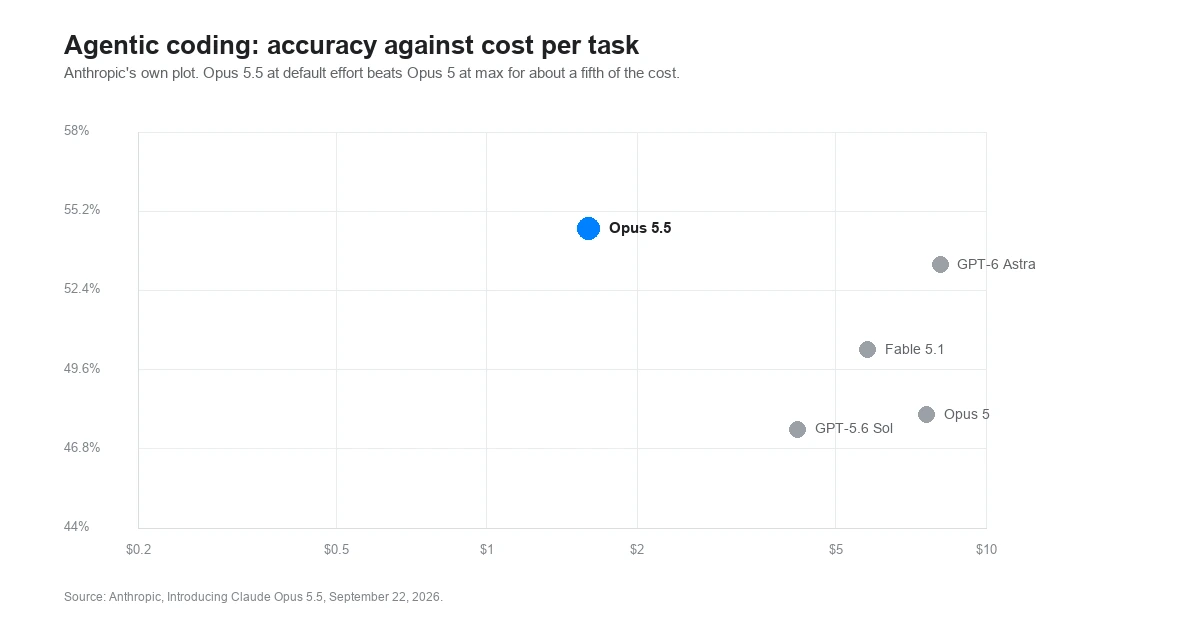
Programación agéntica
Terminal-Bench 4.0, FrontierCode v1.1 y CursorBench 4.0, representados como precisión frente a coste por tarea.
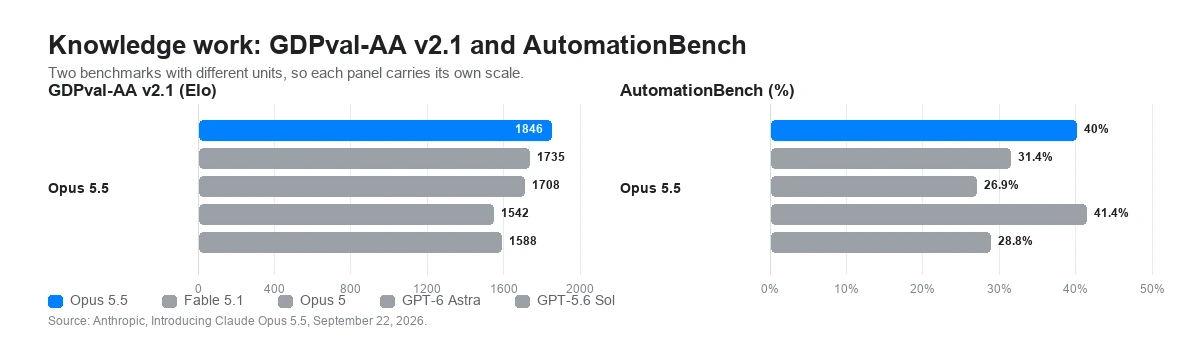
Trabajo de conocimiento
GDPval-AA v2.1 en 44 ocupaciones, AutomationBench y WANDR, el benchmark de recogida de datos de Perplexity.
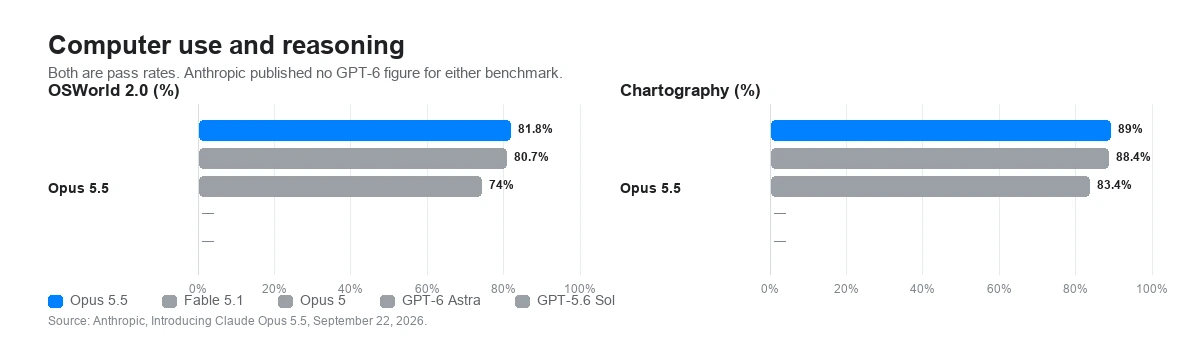
Uso del ordenador y razonamiento
OSWorld 2.0, Humanity's Last Exam y Chartography, este último mide la precisión al leer valores de un gráfico.
Precisión frente a coste por tarea
La tesis central de Anthropic no es una puntuación más alta a cualquier precio, sino la misma puntuación o mejor por una fracción del coste por intento.
Cifras publicadas por el fabricante. Salvo que se indique lo contrario, Anthropic ejecutó Opus 5.5 con razonamiento adaptativo en max effort y lo evaluó con las protecciones de producción activadas. Cuando esas protecciones intervinieron, las tareas de ciberseguridad las completó Opus 4.8 y las de biología Opus 5, lo que probablemente rebaja las cifras publicadas de Opus 5.5 en esos benchmarks. Las cifras de GPT-6 Astra y GPT-5.6 Sol son las que reporta OpenAI. Las diferencias de benchmark entre fabricantes son una señal débil de las diferencias reales, algo que la propia Anthropic dice de estos números.
Si ya ejecutas Opus 5
Anthropic enumera cuatro cambios incompatibles para integraciones que ya corren sobre Claude Opus 5, más un quinto que altera la forma de la respuesta sin hacer fallar ninguna petición. Merece la pena leerlos antes de cambiar el ID del modelo, porque tres de ellos devuelven un error 400 en lugar de degradarse en silencio.
01
En Opus 5 se podía desactivar el razonamiento hasta high incluido. En Opus 5.5 está siempre activo, y tanto la desactivación como un presupuesto manual de tokens devuelven un error 400. El effort pasa a ser el único control, y su valor por defecto cambia de high a medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice con "any" o con una herramienta concreta devuelve un error 400, también en el endpoint de conteo de tokens. Usa auto junto con uso estricto de herramientas o salidas estructuradas, y di en el prompt cuándo toca usar la herramienta.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Cada bloque de razonamiento registra qué modelo lo produjo. Opus 5.5 lee los bloques de Opus 5 y de modelos Opus, Sonnet y Haiku anteriores, pero no los de Fable ni Mythos. Si un enrutador mueve la conversación a otro modelo, los turnos siguientes se ejecutan sin el razonamiento previo.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 conservan el razonamiento; los demás modelos lo pierden
04
En la API de Claude y Google Cloud, la herramienta computer_20251124 devuelve un error 400. Declara en su lugar el toolset computer_toolset_20260801, quita la cabecera beta y adapta el bucle del agente a los bloques member tool_use. En Amazon Bedrock la herramienta antigua sigue funcionando.
computer_20251124 -> computer_toolset_20260801
Como el razonamiento no se puede desactivar, lo que se ajusta es el effort. Opus 5.5 admite los cinco niveles y arranca en medium, un nivel por debajo de Opus 5. La recomendación de Anthropic es repetir el barrido sobre tus propias evaluaciones en lugar de arrastrar un ajuste, y poner un max_tokens amplio en los niveles altos, porque los tokens de razonamiento cuentan para ese límite aunque no se devuelva el texto del razonamiento.
El effort es una señal de comportamiento, no un presupuesto estricto de tokens: en un nivel bajo el modelo sigue razonando ante problemas realmente difíciles, solo que menos que en uno alto. Anthropic también señala que Opus 5.5 tiende a pensar más por turno que Opus 5 en el mismo nivel, sobre todo en xhigh y max, así que un ajuste heredado de Opus 5 producirá turnos más largos y más caros.
Dónde encaja
Opus 5.5 aporta valor cuando una tarea dura horas, abarca más archivos de los que una persona puede retener o produce algo que otra persona tiene que revisar. Son los casos que describen Anthropic y sus primeros probadores, no prompts de chat genéricos.
Llevar un cambio por todo un repositorio grande hasta que pasen las pruebas, en lugar de parar en el primer parche que parece funcionar. Anthropic informa de una migración de 680.000 líneas terminada en menos de un día por un probador.
Column, uno de los probadores citados por Anthropic, informó de que detectó un error consultando documentación externa de una integración de terceros que se había modelado mal varios commits antes.
Construir el modelo y después el resumen de una página, manteniendo las salvedades. Anthropic informa de un análisis de fusión resuelto en 63 minutos frente a 93 de Opus 5, por la mitad de coste.
Delega en subagentes y ajusta su ritmo a un presupuesto de tiempo. Anthropic recomienda dar a una arquitectura multiagente una señal de tiempo transcurrido para que paralelice en vez de serializar.
01
Añade el repositorio, los documentos y los requisitos que una respuesta útil tiene que tener en cuenta. La ventana de un millón de tokens está para eso.
02
Di qué tiene que cumplirse para dar el trabajo por terminado. El consejo de Anthropic para ejecuciones sin supervisión es mantener las partes de la tarea en una lista que el modelo actualice.
03
Lanza la misma tarea en Opus 5.5, Opus 5 y Fable 5.1 dentro de Felo. Compara las pruebas, las salvedades y el consumo de tokens, no solo la respuesta.
Selecciona Claude Opus 5.5 cuando aparezca en el selector de modelos de tu cuenta.
Probar Opus 5.5 en FeloClaude Opus 5.5 es el modelo de Anthropic para programación agéntica de larga duración y trabajo de conocimiento, publicado el 22 de septiembre de 2026 como primer modelo de la familia Claude 5.5. Según Anthropic, alcanza el nivel de Claude Fable 5.1 en la mayoría de las tareas y cuesta un 40 % menos de ejecutar que Claude Opus 5.
Pon Claude Opus 5.5 junto a los demás modelos punteros en Felo y pruébalo con ese trabajo que llevas aplazando porque lleva horas.
Probar Opus 5.5 en FeloEmpieza en la búsqueda de Felo AI y selecciona el modelo donde esté disponible.