Anunciado em 30 de setembro de 2026 · Lançamento por etapas

Gemini 4 Argonpesquisa longa, escrita por inteiro

O primeiro modelo de fronteira do Google desde o Gemini 3, feito para raciocínio profundo em trabalhos longos de várias etapas. Eleva o teto de saída de 64K para 1M tokens e lidera os números que o Google publica em trabalho de conhecimento, não em programação.

A API Felo está em beta fechado — o acesso ao Gemini 4 Argon chega em breve.
Arte principal do Gemini 4 Argon: o nome do modelo ao lado de um grande número 4 sobre um gradiente azul
A arte do anúncio do Google. O Argon chega com um novo esquema de nomes, e não como atualização da linha Gemini 4.0 — por isso o nome não traz número de versão.
1M
Máximo de tokens de saída
Antes eram 64K — um relatório inteiro gerado em uma única trajetória.
US$ 2 / US$ 10
Preço introdutório da API
Por milhão de tokens de entrada e de saída. A entrada em cache tem 95% de desconto.
77.9%
DeepSWE v1.1
A pontuação que o Google reporta, à frente de Claude Opus 5.5 e GPT-6 Astra.
15%
Taxa de alucinação
A mais baixa medida entre modelos de fronteira pela Artificial Analysis.

Os números e gráficos desta página vêm das organizações que os publicaram — Google, Arena.ai e Artificial Analysis — e são reproduzidos sem alterações.

Status do lançamento

O Argon ainda não está disponível para todos. Esta é a ordem em que ele chega.

O Google está liberando o Argon por etapas, e a primeira não é a pública. O acesso dentro do Felo está sendo preparado junto com esse lançamento.

Já disponível

Defensores de cibersegurança de confiança

Parceiros selecionados do programa Fairwind do Google recebem o Argon primeiro, e recebem sem as barreiras de segurança cibernética.

Anunciado em seguida

Clientes pagos da API e Google AI Ultra

O Google diz que o acesso mais amplo começa aqui. Nenhuma data foi dada, e só a assinatura não garante o acesso hoje.

Ainda sem data

Desenvolvedores, empresas e consumidores

Vem depois das faixas pagas. O Google não assumiu um prazo para a disponibilidade geral.

O acesso ao Argon dentro da busca do Felo está em andamento. Esta página será atualizada quando ele abrir.

No que ele é bom

Um modelo feito para terminar trabalhos longos, não para responder rápido

Os pontos fortes que o Google publica para o Argon se concentram em ler, raciocinar e escrever longamente. É um formato diferente dos modelos de fronteira focados em código com os quais ele é comparado.

Raciocínio que aguenta uma tarefa longa

O Google posiciona o Argon para trabalhos de várias etapas que duram horas, onde os modelos anteriores se desviam ou param antes da hora.

1M tokens de saída em uma única passada

O motivo que o Google declara para o aumento: um modelo com espaço para pensar longamente resolve um problema difícil em uma trajetória, em vez de em muitas idas e voltas.

Lidera em trabalho de conhecimento, não em programação

As diferenças mais amplas reportadas estão no Harvey's Legal Agent Benchmark e no Vals Finance Agent v2 — análise jurídica e financeira de verdade, não tarefas sintéticas.

Recuperação em contexto longo que se sustenta

No GraphWalks, que testa se o modelo consegue de fato usar um contexto de 256K a 1M, o Google reporta uma vantagem de mais de dez pontos sobre outros modelos de ponta.

Compreensão de vídeo longo

O LVBench, que mede a compreensão em vídeo longo, é reportado em 91.7% — a pontuação mais alta que o Google lista para o Argon.
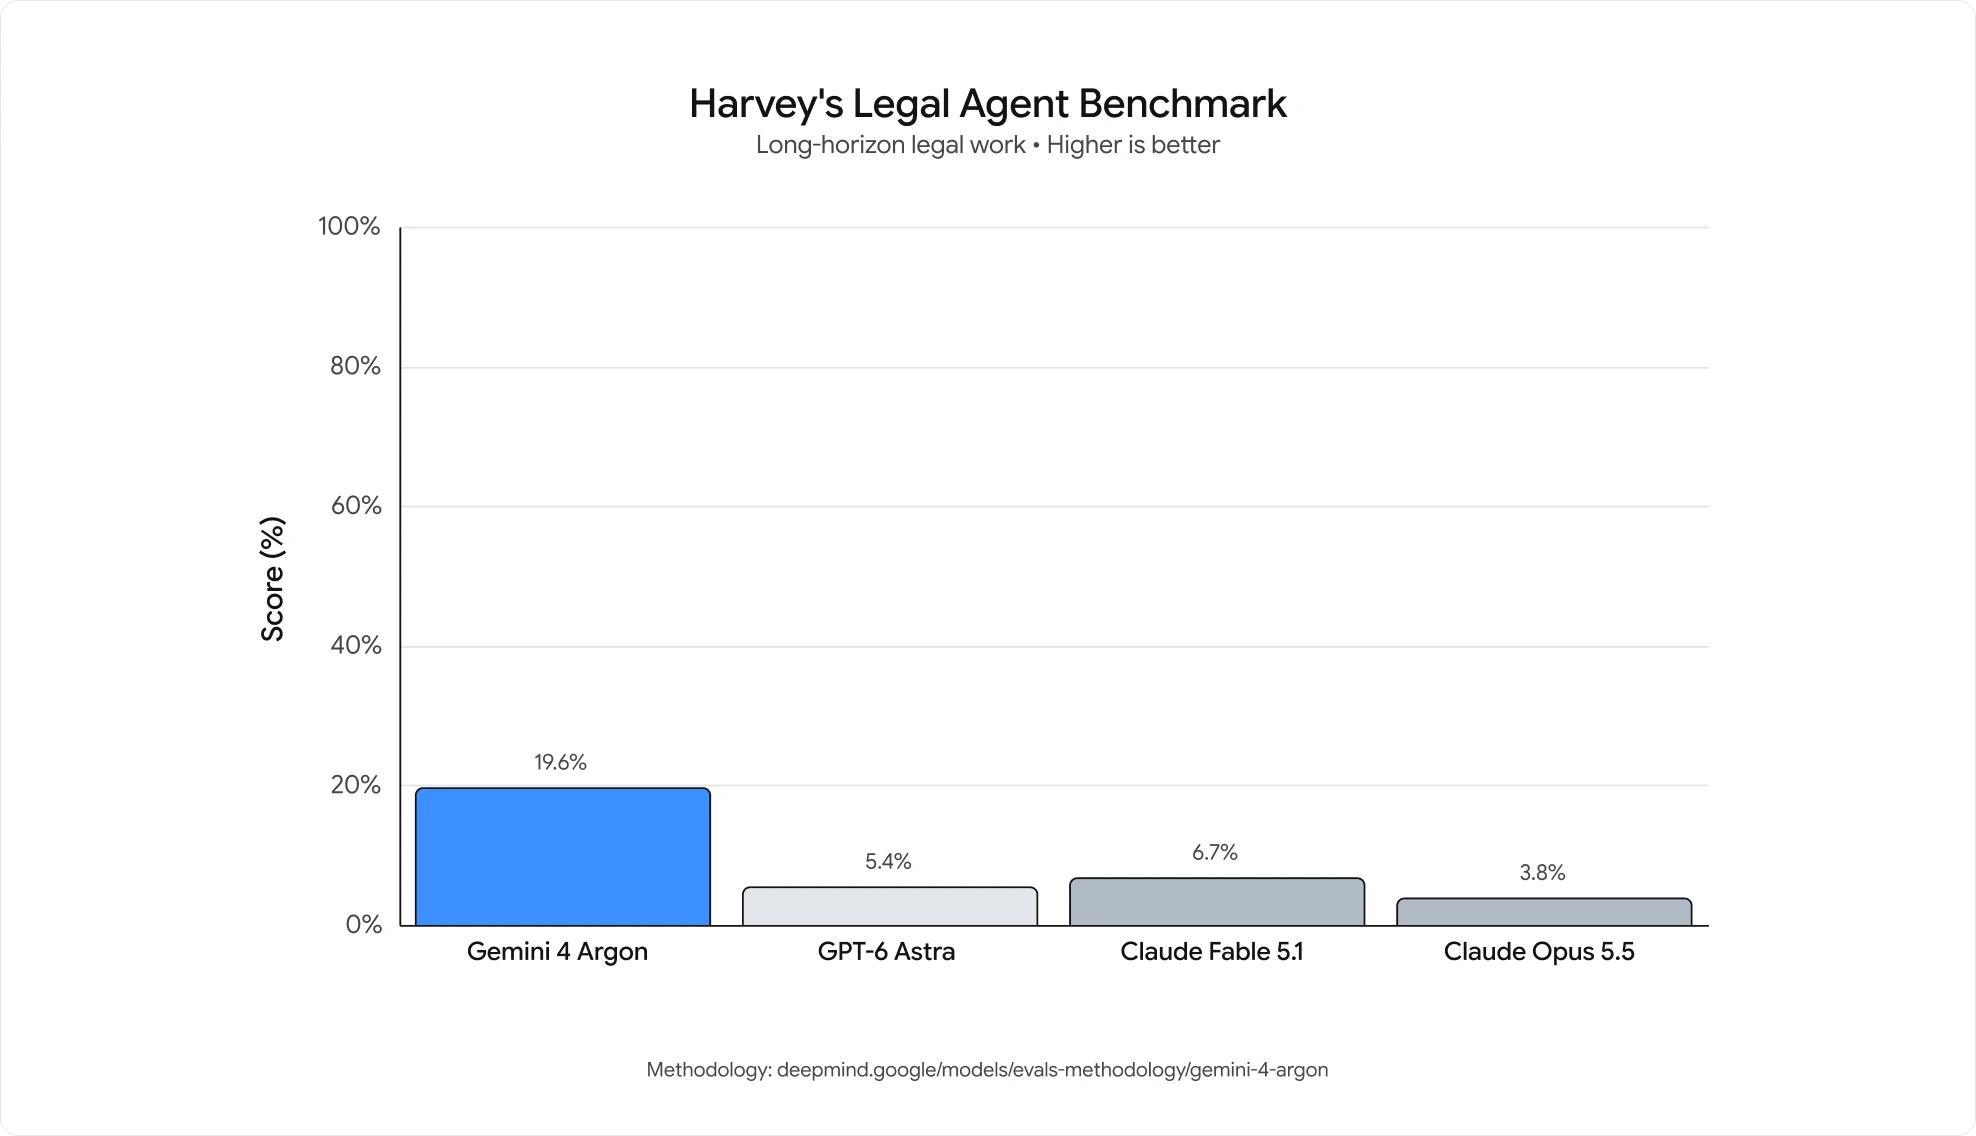
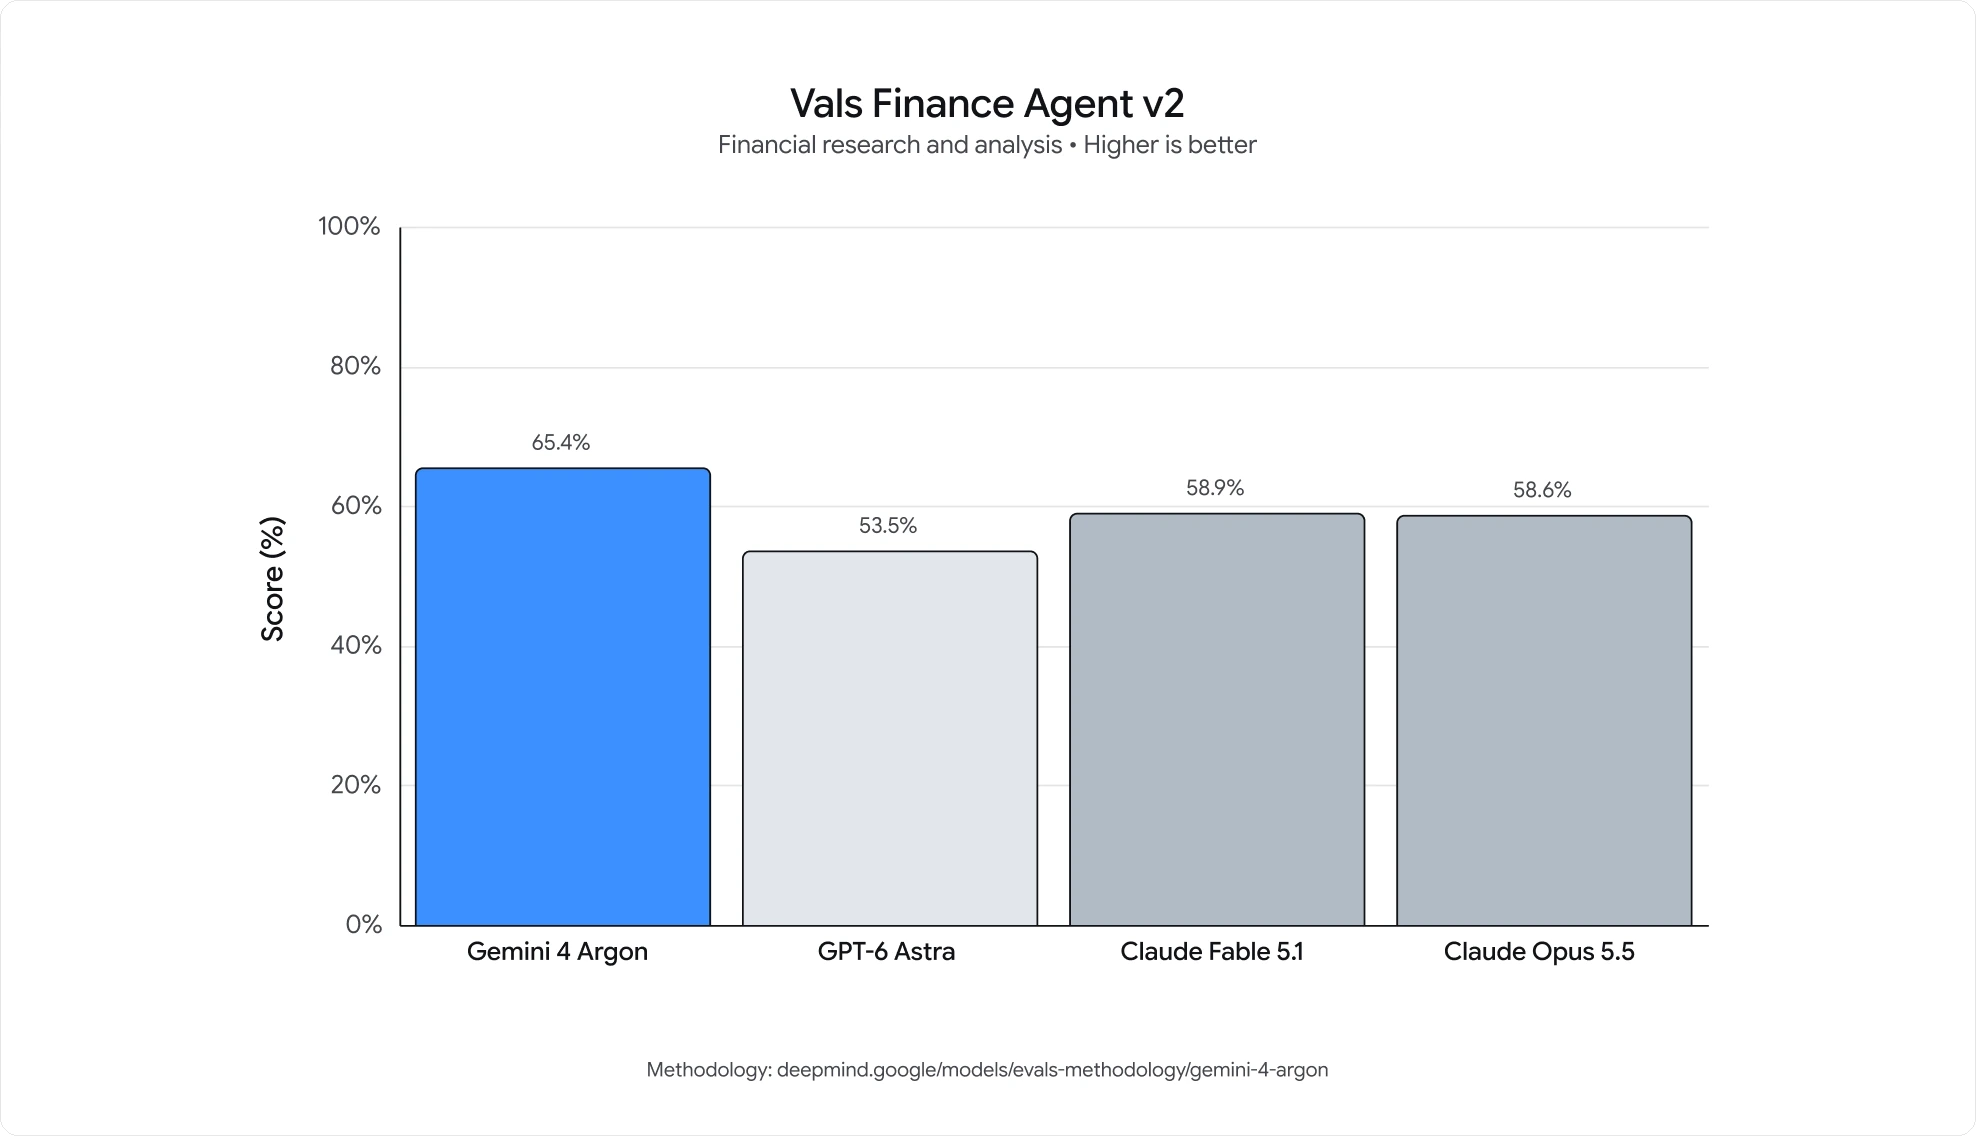
Gráfico de barras do Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Trabalho jurídico de horizonte longo. Os 19.6% do Argon são cerca de três vezes a pontuação do modelo seguinte, e é a maior vantagem do conjunto publicado pelo Google.
Gráfico de barras do Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Pesquisa e análise financeira, com 65.4% contra um grupo de 53.5% a 58.9%. Uma vantagem mais estreita do que no trabalho jurídico, mas a mesma ordem.

Números publicados

Onde o Argon fica nos benchmarks do próprio Google

São resultados reportados pelo fabricante. O Google não divulgou um ajuste de raciocínio ou effort para as pontuações principais, e nenhum laboratório independente as replicou ainda.

Benchmark
O que mede
Argon
Comparação mais próxima
DeepSWE v1.1
Engenharia de software de horizonte longo
77.9%
Opus 5.5 com 74.2%, GPT-6 Astra com 74.1%
CWE-bench v1
Encontrar vulnerabilidades e corrigi-las
68%
Empata em primeiro lugar
AutomationBench
Tarefas de negócio de ponta a ponta, da Zapier
51.3%
Classificado em primeiro
LVBench
Compreensão de vídeo longo
91.7%
A pontuação mais alta que o Google reporta para o Argon

Trate esses números como indicativos. Benchmarks de fabricante raramente sobrevivem sem mudanças ao contato com cargas de trabalho reais, e a Bloomberg reportou que alguns funcionários do Google duvidam que a liderança em benchmarks se transfira para o trabalho real.
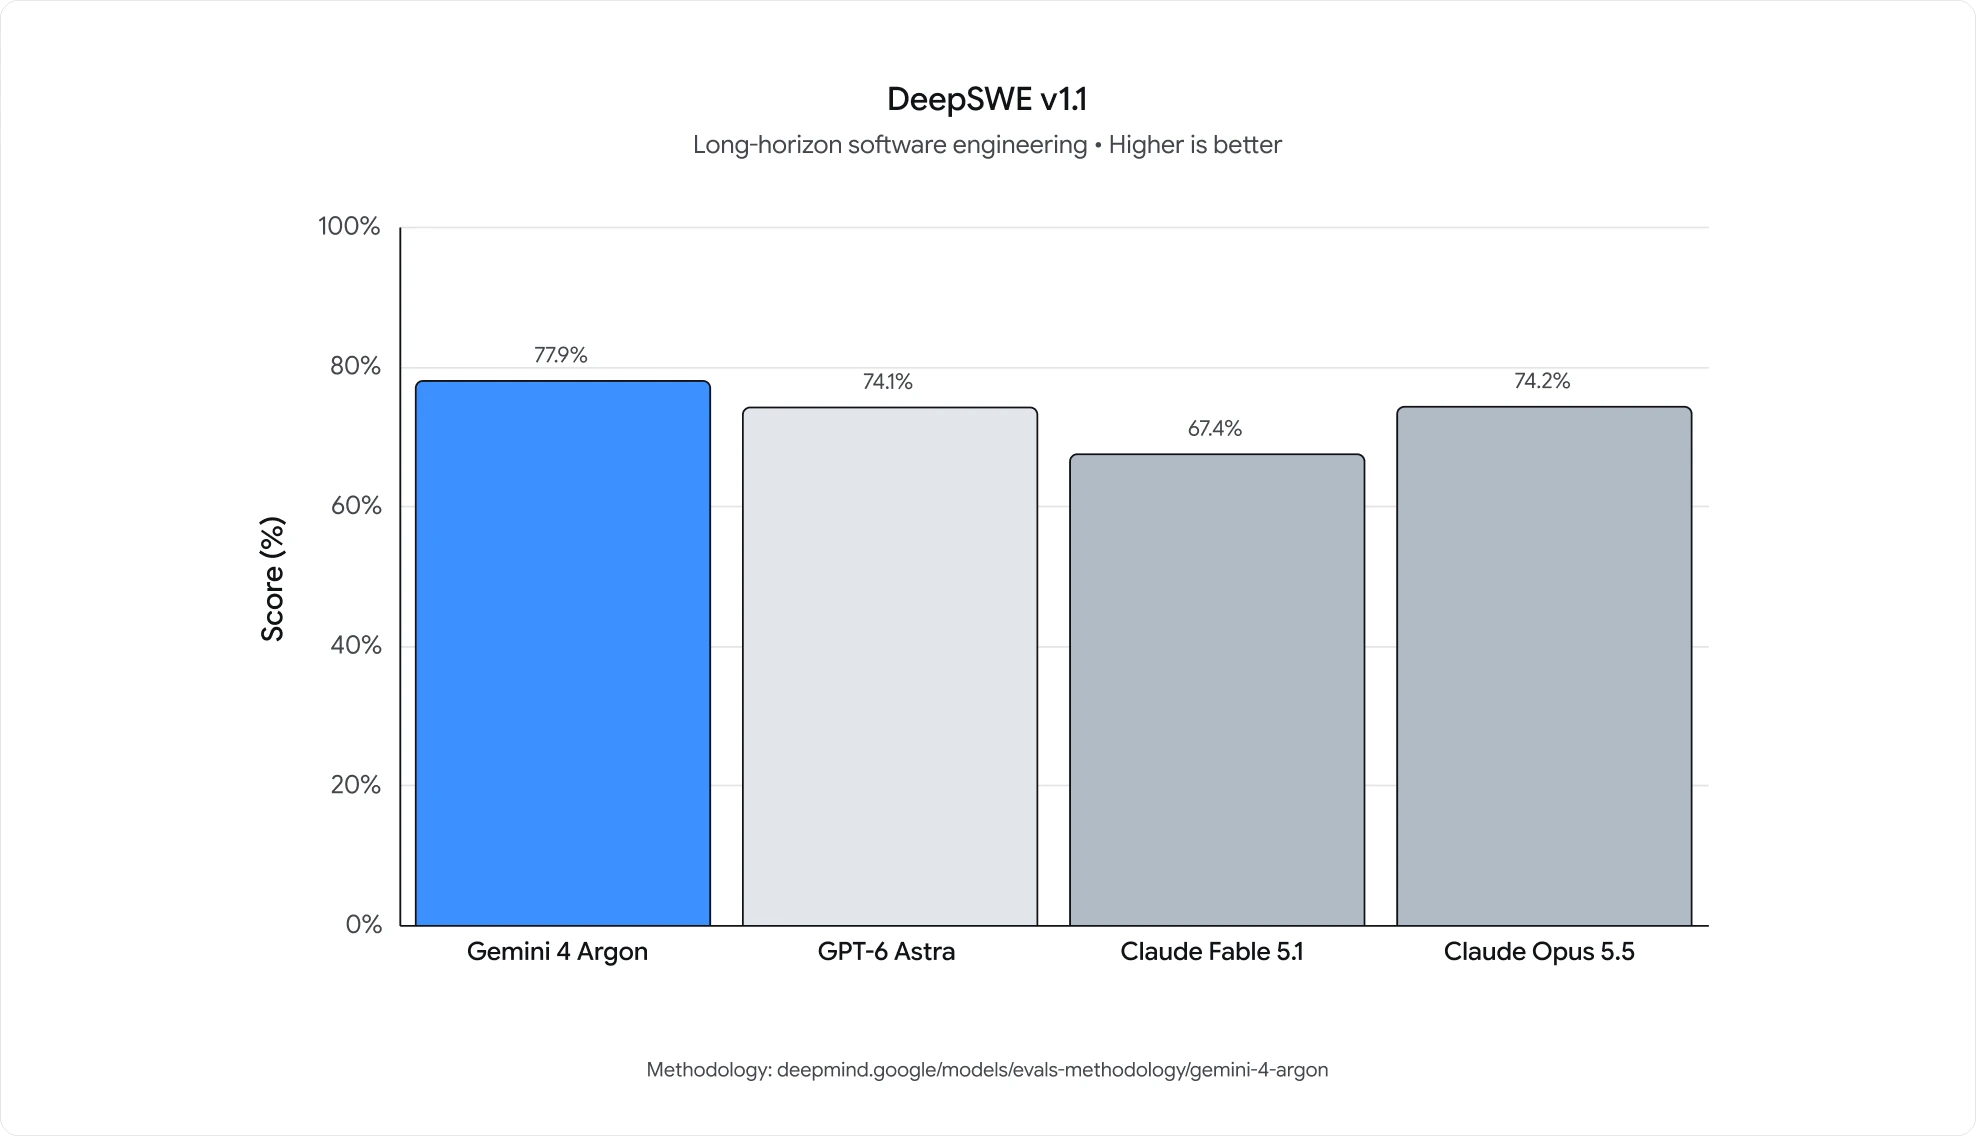
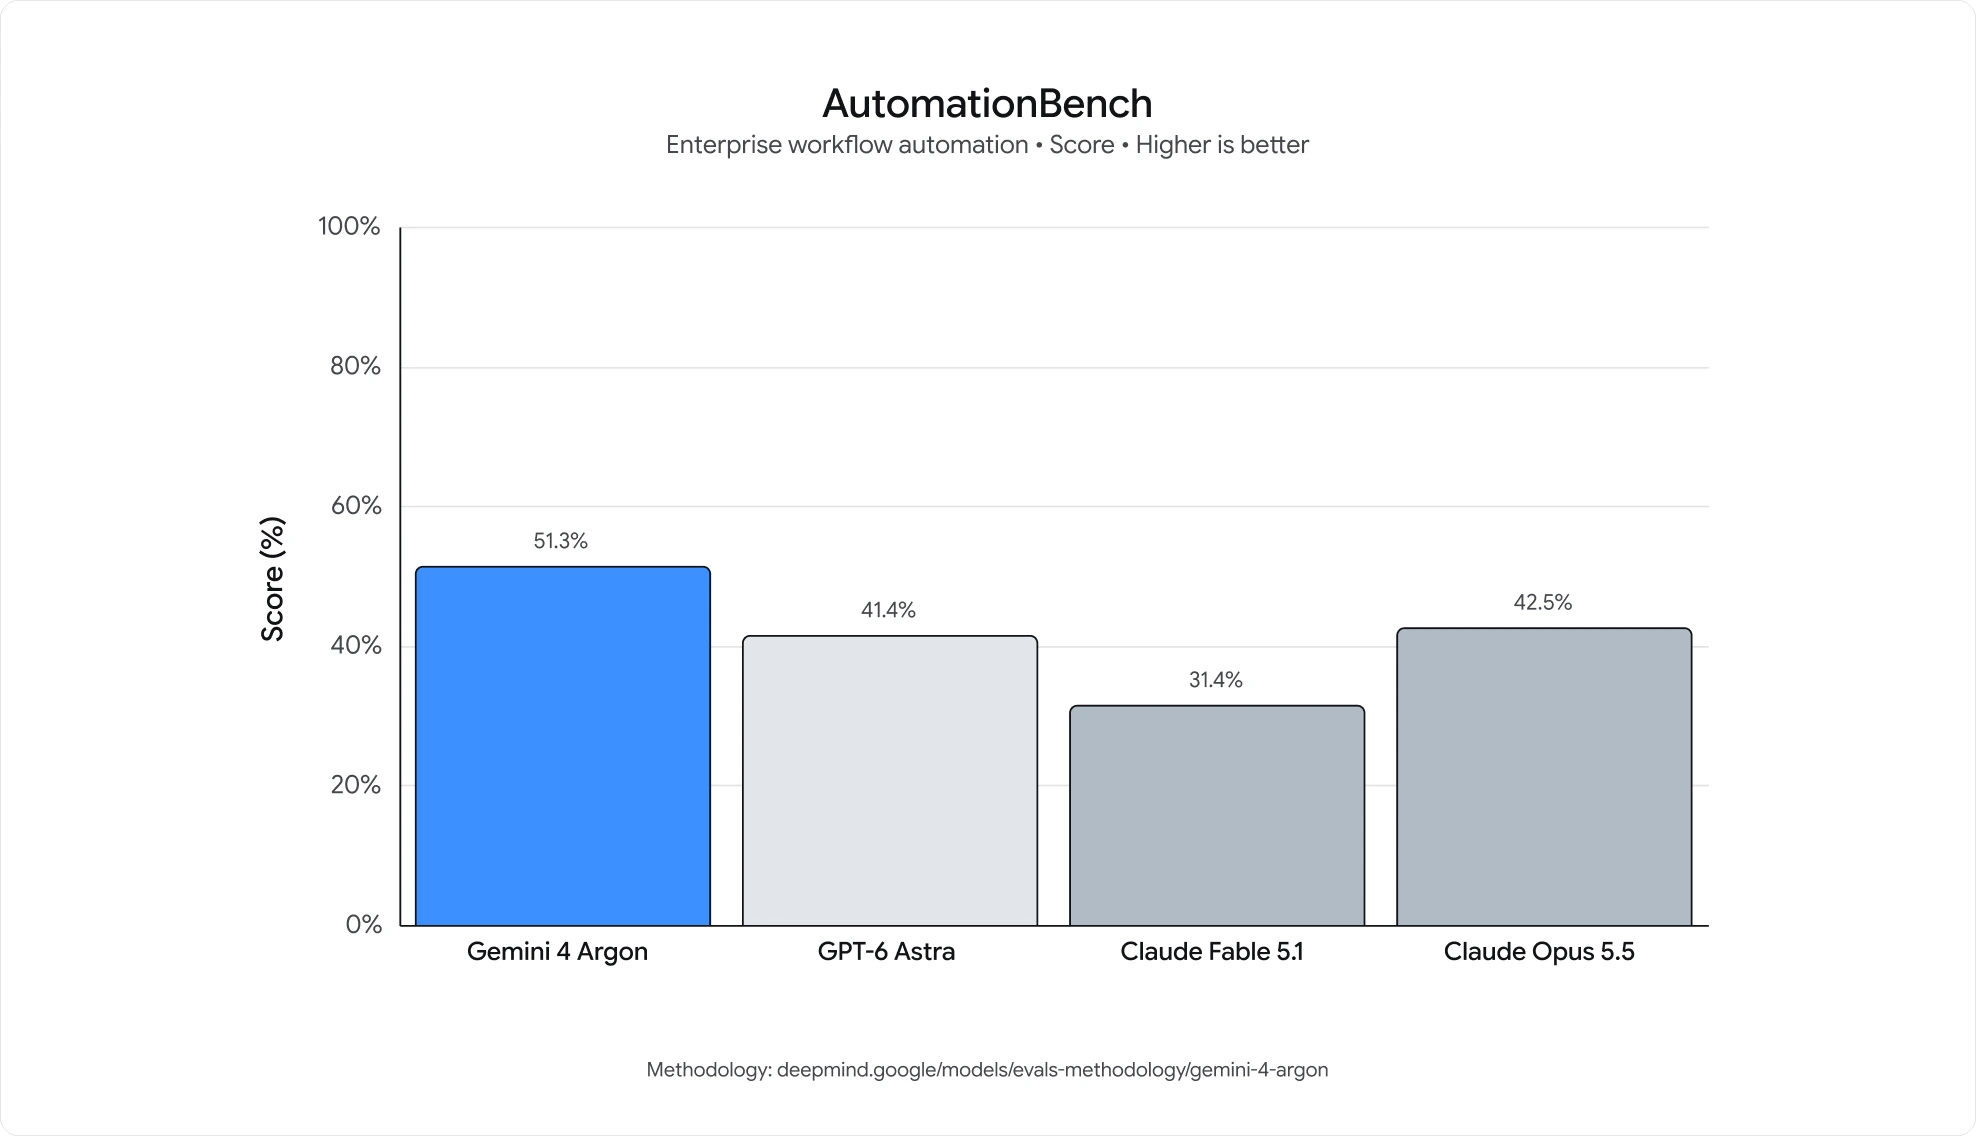
Gráfico de barras do DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Engenharia de software de horizonte longo. O número de destaque de 77.9%, com os dois concorrentes mais próximos a menos de quatro pontos.
Gráfico de barras do AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Tarefas de negócio de ponta a ponta, criadas pela Zapier. O Argon passa dos 50%, enquanto todos os outros modelos da comparação ficam na casa dos trinta ou no início dos quarenta.
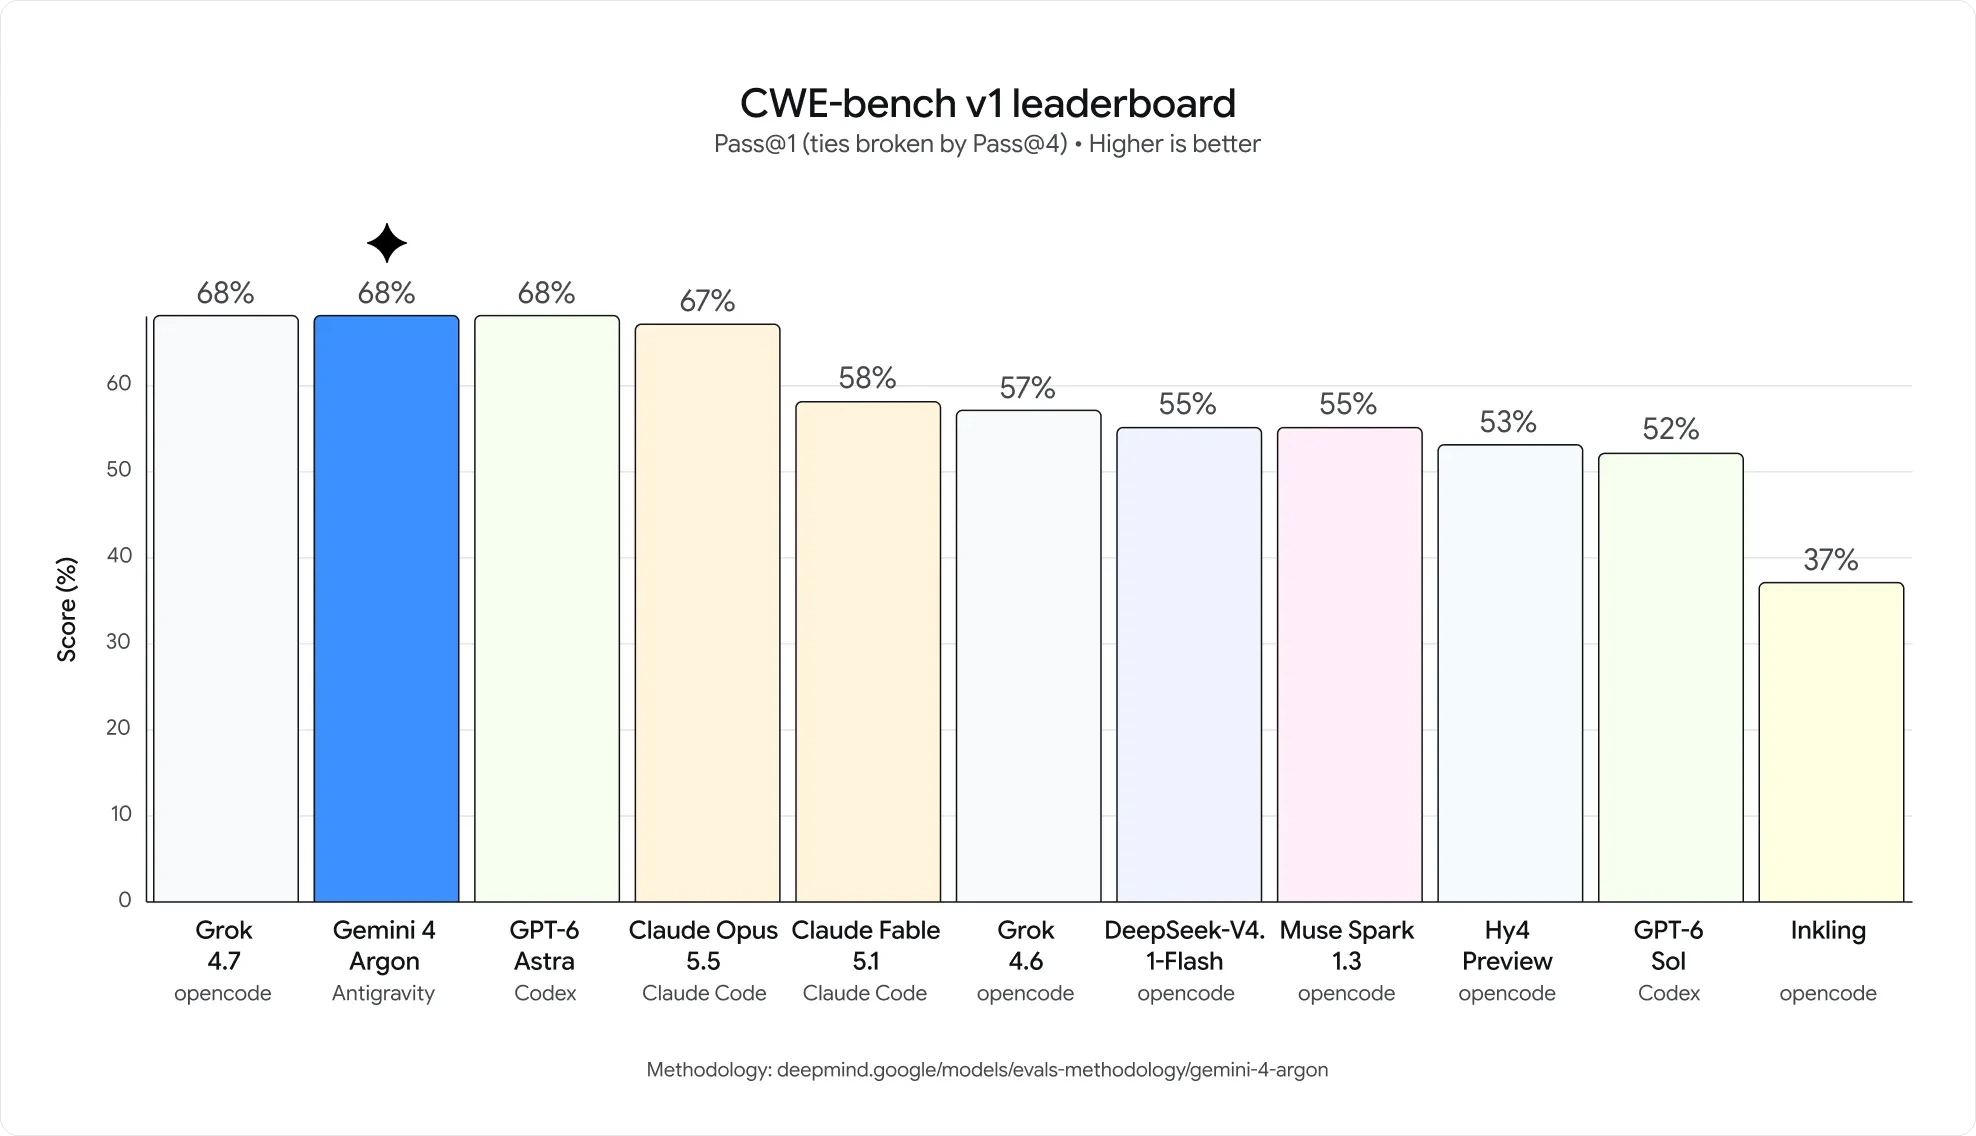
Ranking do CWE-bench v1: Gemini 4 Argon, Grok e GPT-6 Astra empatados em 68%, Claude Opus 5.5 com 67%, caindo até Inkling com 37%
Descoberta de vulnerabilidades em Pass@1. O Argon divide o topo de uma tabela disputada em vez de abrir vantagem, e é por isso que a tabela acima fala de um empate em primeiro lugar.
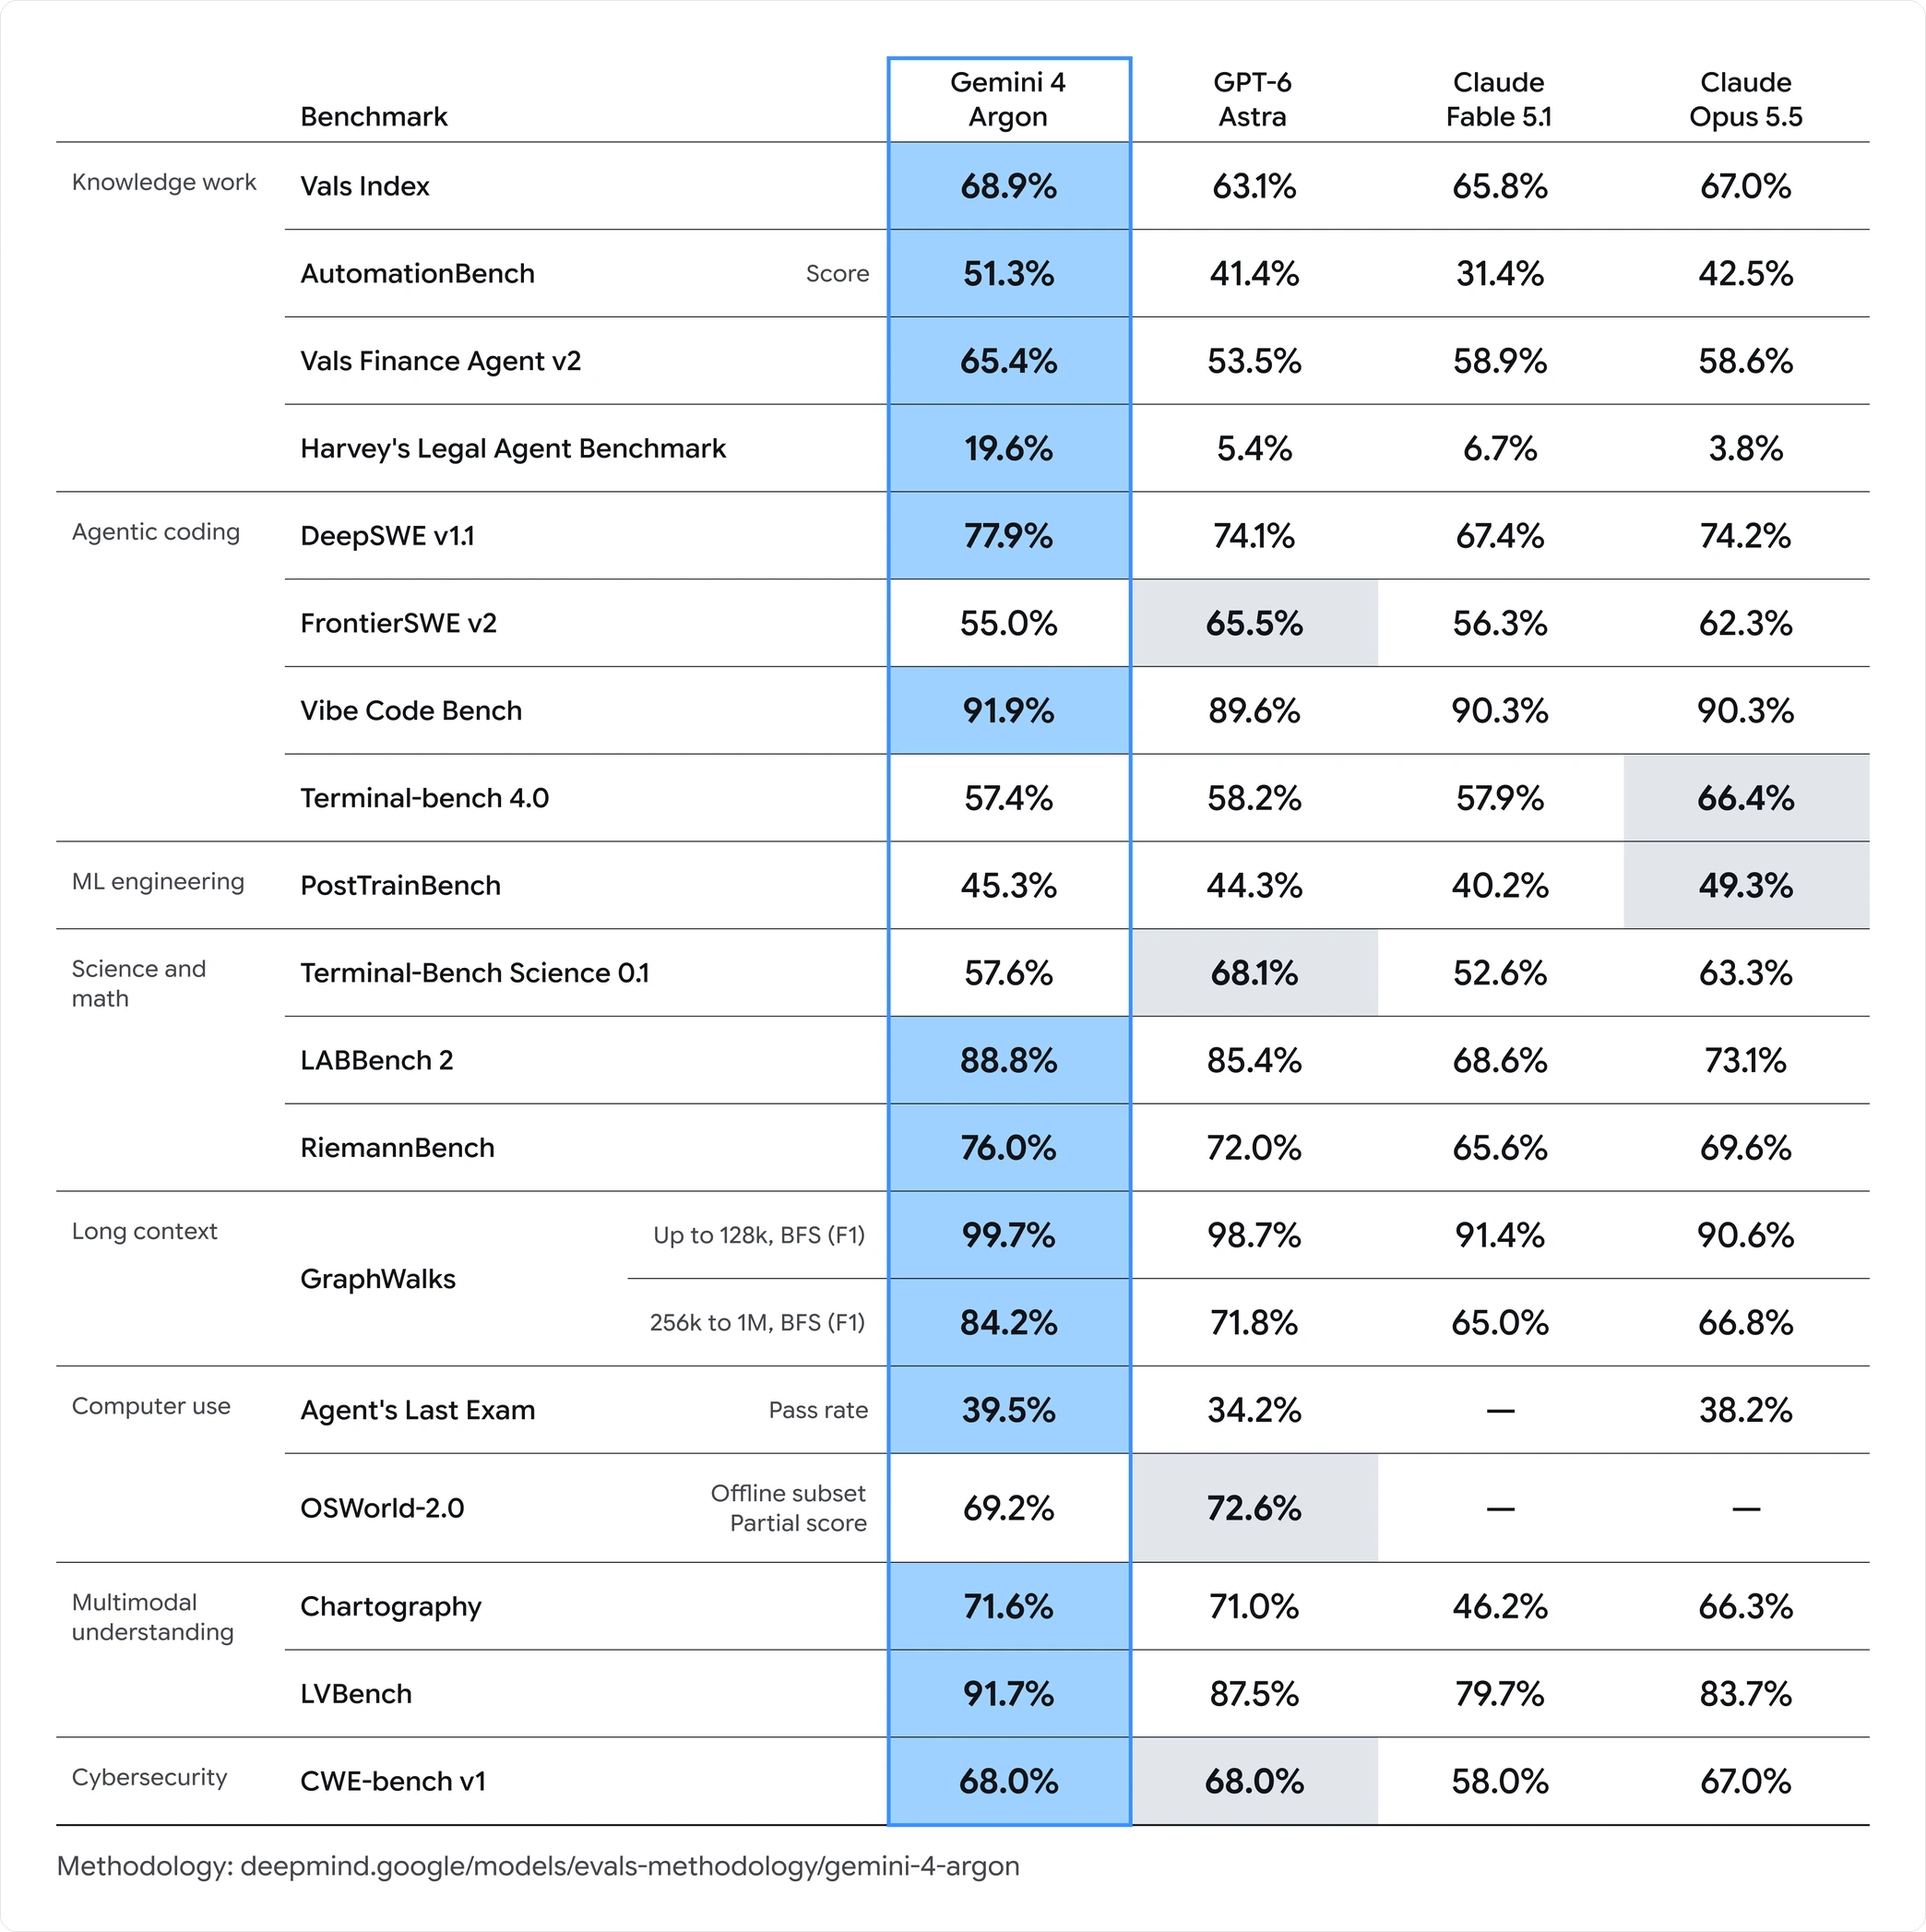
Tabela completa de resultados do Google para o Gemini 4 Argon em 16 benchmarks, agrupados em trabalho de conhecimento, programação agêntica, engenharia de ML, ciência e matemática, contexto longo, uso de computador, compreensão multimodal e cibersegurança
A tabela completa do anúncio, com as vitórias do Argon em azul e as células em que um concorrente lidera em cinza. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 e OSWorld-2.0 são as linhas em que o Argon não lidera.
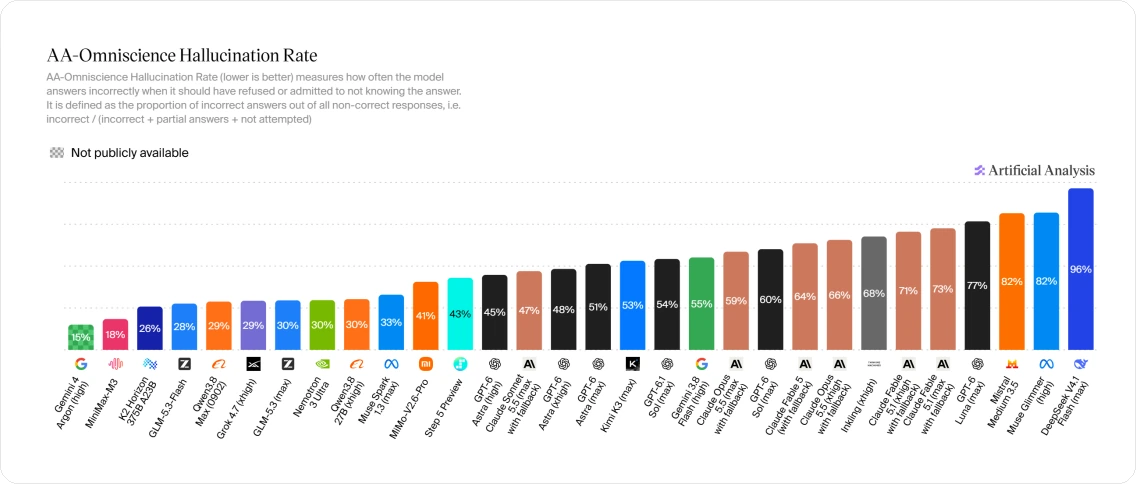
Gráfico de barras da taxa de alucinação do AA-Omniscience da Artificial Analysis em 36 modelos, ordenados do menor para o maior: Gemini 4 Argon (High) com 15%, depois MiniMax-M3 com 18%, Kimi K2.5 com 26%, subindo até DeepSeek-V4 Flash com 96%
A medição independente da Artificial Analysis, e o único número desta página que não veio de nenhum fornecedor: com que frequência cada modelo responde de forma incorreta em vez de se recusar a responder. Os 15% do Argon são os mais baixos entre os 36 modelos representados; a escala vai até 96%.
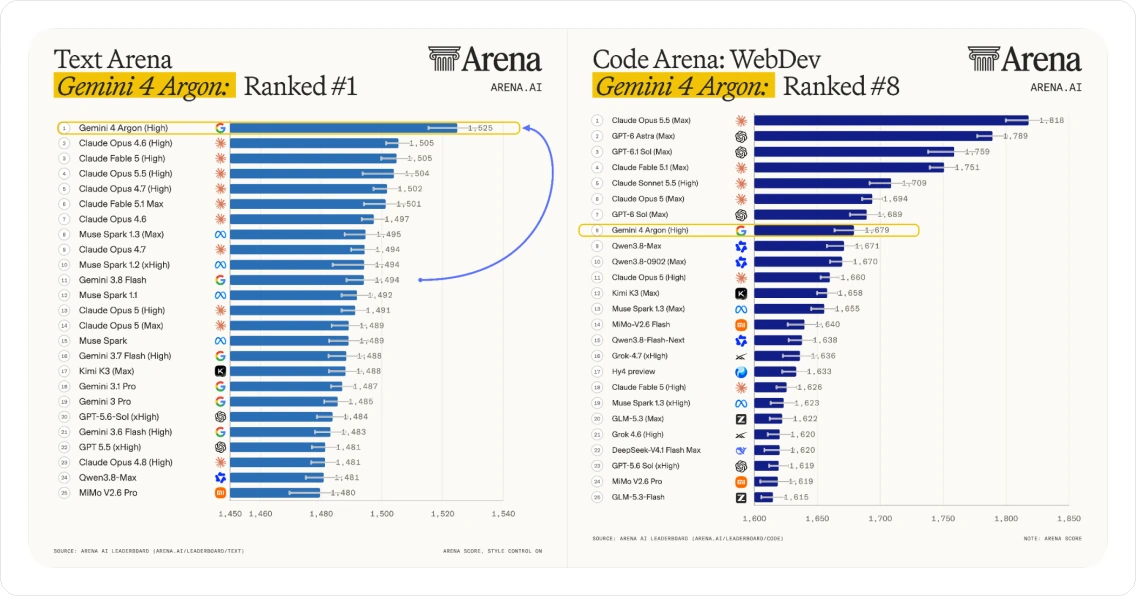
Os rankings Text Arena e Code Arena: WebDev da Arena.ai lado a lado: Gemini 4 Argon em primeiro na Text Arena com 1625, e em oitavo na Code Arena: WebDev com 1679
Os dois rankings em que o parágrafo acima se apoia, das listas votadas pelo público da Arena.ai. O Argon lidera os 25 modelos listados da Text Arena; na Code Arena: WebDev, é o oitavo, atrás de quatro modelos Claude e três da linha GPT-6 da OpenAI.

No Felo

Como fica um fluxo de pesquisa com um redator de 1M tokens

O Felo une busca e compreensão de documentos, então um modelo de saída longa muda o que uma única sessão consegue produzir.

Pesquisa que termina em um documento

Reúna as fontes e peça ao modelo que escreva a síntese em uma passada, em vez de montá-la seção por seção ao longo de muitos prompts.

Conjuntos inteiros de documentos em uma tarefa

A recuperação em contexto longo é a capacidade em que o Argon é mais forte, e é o que torna tratáveis conjuntos de contratos, registros e relatórios longos.

Redigir onde o tom importa

O perfil que o Google reporta para o Argon — texto forte, programação moderada — serve times que precisam de texto que pareça escrito, e não montado.

Custo

Quanto custa o Argon e o que muda depois

O Google publicou uma tarifa introdutória e uma tarifa de tabela mais alta, sem dizer quando a virada acontece. Faça seu orçamento com o número mais alto.

Tipo de token
Introdutório
Depois
Entrada
US$ 2,00 / M
US$ 4,00 / M
Entrada em cache
95% de desconto
95% de desconto
Saída
US$ 10,00 / M
US$ 20,00 / M

Para comparar, a tarifa introdutória fica mais ou menos no nível do GPT-6.1 Sol e do Sonnet 5.5, e perto de um quinto do GPT-6 Astra. São preços de tabela, não custo medido por tarefa — o Argon responde perguntas mais difíceis, então uma única execução ainda pode sair mais cara.

Como trabalhar com o Argon no Felo

01

Traga a pergunta inteira

Entregue ao Felo o conjunto de documentos ou o tópico longo, não um resumo dele. A vantagem do Argon começa onde o contexto deixa de caber em um prompt.

02

Peça o artefato pronto

Com um teto de saída de 1M tokens, você pode pedir o relatório completo ou o rascunho inteiro em uma única instrução, em vez de por seções.

03

Confira com as fontes

O Felo mantém as citações junto da resposta, e é isso que torna revisável um documento longo gerado pelo modelo.

O acesso ao Argon na busca do Felo está em andamento. Até ele abrir, todos os outros modelos da linha Felo estão disponíveis agora.

Abrir a busca do Felo AI

Gemini 4 Argon: perguntas frequentes

Em geral, não. O Google liberou o Argon primeiro para parceiros selecionados do programa Fairwind, e diz que o acesso mais amplo vai começar com clientes pagos da API e assinantes do Google AI Ultra. Nenhuma data foi anunciada para essa etapa, e uma assinatura paga não garante acesso hoje.

Teste os modelos de fronteira do Google no Felo

Pesquise, leia e escreva com o modelo que combina com a tarefa. O Argon entra na linha quando o lançamento dele chegar ao Felo.

Abrir a busca do Felo AI

Não é preciso cartão de crédito para usar a busca do Felo AI.