GPT-6 LunaO modelo de alto volume da OpenAI por US$ 0,10
O GPT-6 Luna é a faixa mais barata da geração GPT-6 da OpenAI, lançada em 22 de setembro de 2026 junto com o GPT-6 Sol. A OpenAI o posiciona para trabalho de alto volume com um objetivo definido: resumir, classificar, extrair e rotear. A US$ 0,10 por milhão de tokens de entrada, custa um vigésimo do GPT-6 Sol e metade do preço de entrada do GPT-5.6 Luna. Ele roda no Felo AI Search e na API da Felo.
Em produção na API da OpenAI como gpt-6-luna desde 22 de setembro de 2026, a $0,10 / $0,50 por milhão de tokens — metade do preço de entrada do GPT-5.6 Luna.
Lançado em 22 de setembro de 2026 · Já disponível no Felo AI Search e na API da Felo
Ficha de tarifas
O GPT-6 Luna em resumo
- Model ID
- gpt-6-luna
- Lançamento
- 22 de setembro de 2026
- Entrada
- US$ 0,10 por milhão
- Entrada em cache
- US$ 0,01 por milhão
- Saída
- US$ 0,50 por milhão
- Janela de contexto
- 1.050.000 tokens
$0,10 / $0,50
Preço de entrada
Por milhão de tokens, tarifa padrão.
$0,01
Entrada em cache
Um décimo da tarifa de entrada, por milhão de tokens.
1,05M
Janela de contexto
Máximo de 922.000 na entrada e 128.000 na saída.
gpt-6-luna
Model ID na API
A string que vai no campo model.
Quanto custa um milhão de tokens
O argumento do Luna é aritmética, não adjetivos. Estas são as quatro tarifas publicadas da OpenAI e no que elas dão numa carga que lê muito mais do que escreve.
A tabela de tarifas
Tarifas padrão por milhão de tokens, conforme publicadas.
- Entrada
- $0,10
- Entrada em cache
- $0,01
- Gravação em cache
- $0,125
- Saída
- $0,50
A entrada em cache é cobrada a um décimo da tarifa de entrada. Uma gravação em cache custa 1,25 vez uma leitura sem cache, e é nisso que se apoia a conta de retorno mais abaixo.
Custo numa carga mista
A maioria dos prompts lê muito mais do que escreve, então a tarifa de entrada de vitrine exagera o custo de uma carga. Esta coluna assume 20 tokens de entrada para cada token de saída.
Modelo
Por 1 mi combinado
vs. Luna
GPT-6 Luna
$0,12
1x
GPT-5.6 Luna
$0,25
2,1x
GPT-6 Sol
$2,38
20x
GPT-6 Astra
$11,90
100x
Calculado aqui a partir das tarifas publicadas de cada modelo numa proporção de 20:1 entre entrada e saída; nenhum fornecedor publica esta coluna. Outra proporção desloca todos os números: em 1:1 a tarifa combinada do Luna é US$ 0,30 por milhão, e em 100:1 fica em torno de US$ 0,10.
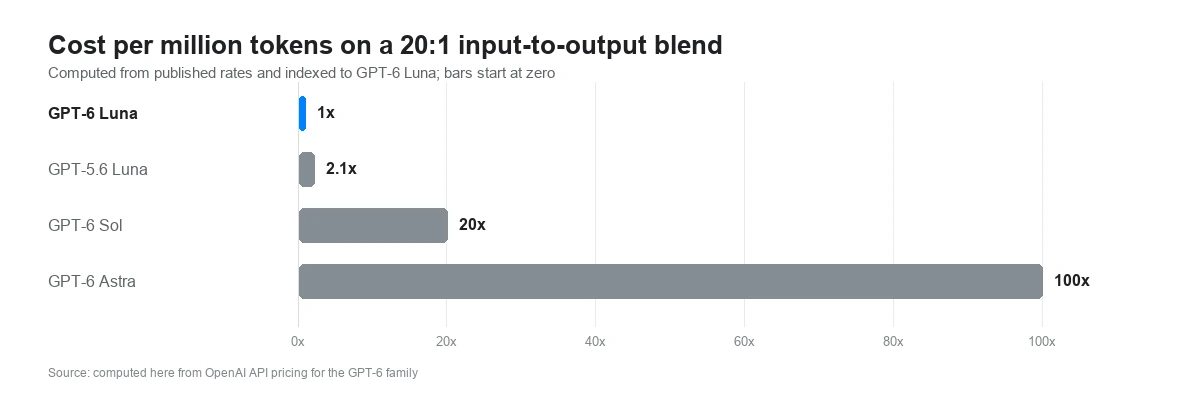
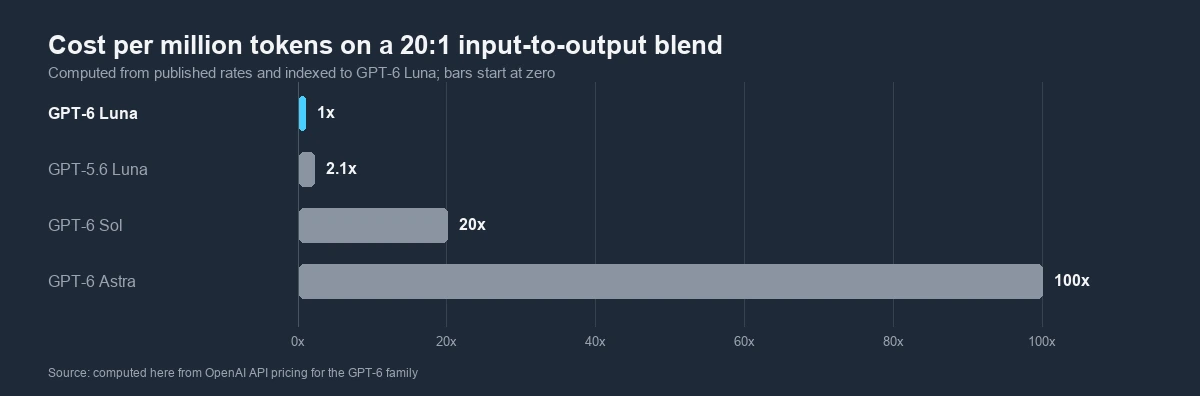
Custo por milhão de tokens numa mistura de 20:1, em relação ao GPT-6 Luna
Cada barra é o custo de um milhão de tokens mistos dividido pelo valor do próprio Luna. O GPT-5.6 Luna é 2,1 vezes o Luna, o GPT-6 Sol é 20 vezes e o GPT-6 Astra é 100 vezes. Calculado a partir das tarifas publicadas da OpenAI; as barras começam em zero.
Fonte: cálculo a partir dos preços da API da OpenAI para a família GPT-6, setembro de 2026
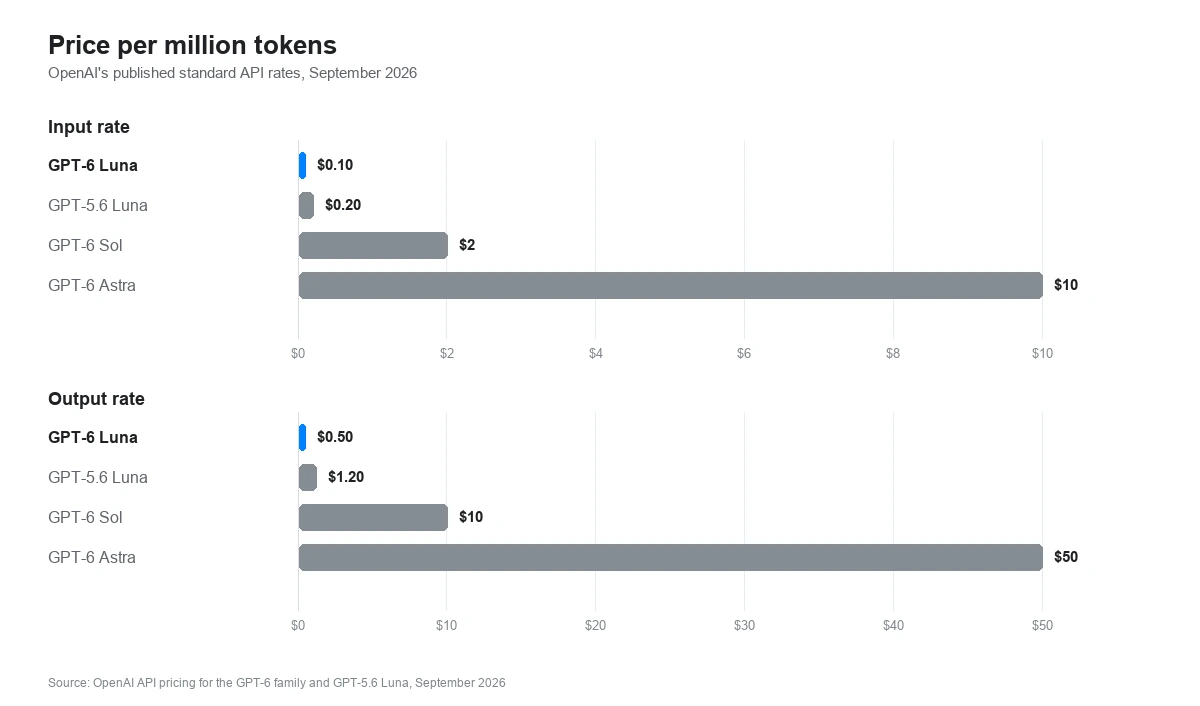
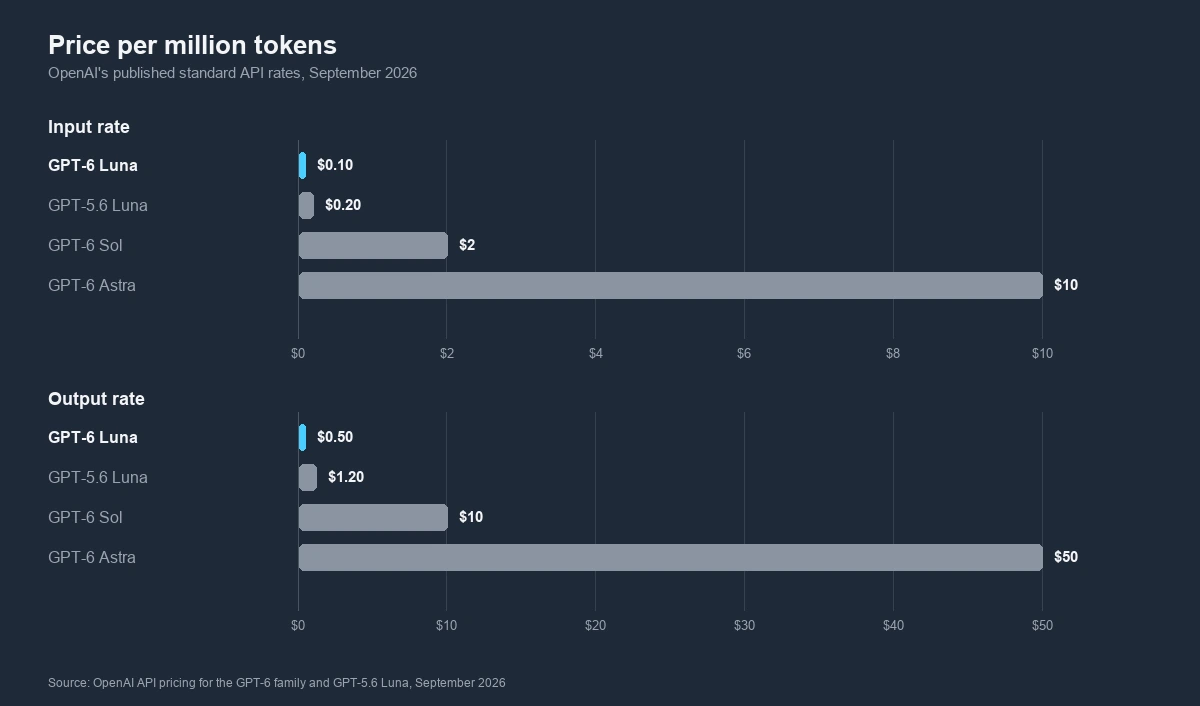
Preço por milhão de tokens: família GPT-6 e GPT-5.6 Luna
Tarifas de entrada e saída por milhão de tokens. O GPT-6 Luna é US$ 0,10 de entrada e US$ 0,50 de saída; o GPT-5.6 Luna, US$ 0,20 e US$ 1,20; o GPT-6 Sol, US$ 2 e US$ 10; o GPT-6 Astra, US$ 10 e US$ 50. As barras começam em zero.
Fonte: preços da API da OpenAI, setembro de 2026
O corte de preço em 272.000 tokens
Uma requisição acima de 272.000 tokens de entrada é cobrada pelas tarifas de contexto longo inteira, não apenas pelos tokens que passam da linha. Esse limite cai em 26% da janela anunciada do Luna.
Tarifa
Padrão
Acima de 272.000
Mudança
Entrada
$0,10
$0,20
2x
Entrada em cache
$0,01
$0,02
2x
Saída
$0,50
$0,75
1,5x
Por que é um corte, e não uma rampa
Com 272.000 tokens de entrada, uma requisição custa US$ 0,0272. Some um token e a requisição inteira é recalculada: 272.001 tokens a US$ 0,20 por milhão dão US$ 0,0544, ou seja, um único token extra acrescenta US$ 0,0272 à conta. Os mesmos 272.000 tokens divididos em duas chamadas que fiquem abaixo do limite custam US$ 0,0272.
O que fazer a respeito
Mantenha a entrada de uma requisição abaixo de 272.000 tokens e a tarifa padrão se aplica. Uma busca que devolve 200.000 tokens ou a divisão de um documento longo em partes ficam na faixa barata; uma chamada que carrega a janela inteira, não. A faixa barata cobre mais ou menos o primeiro quarto do contexto anunciado.
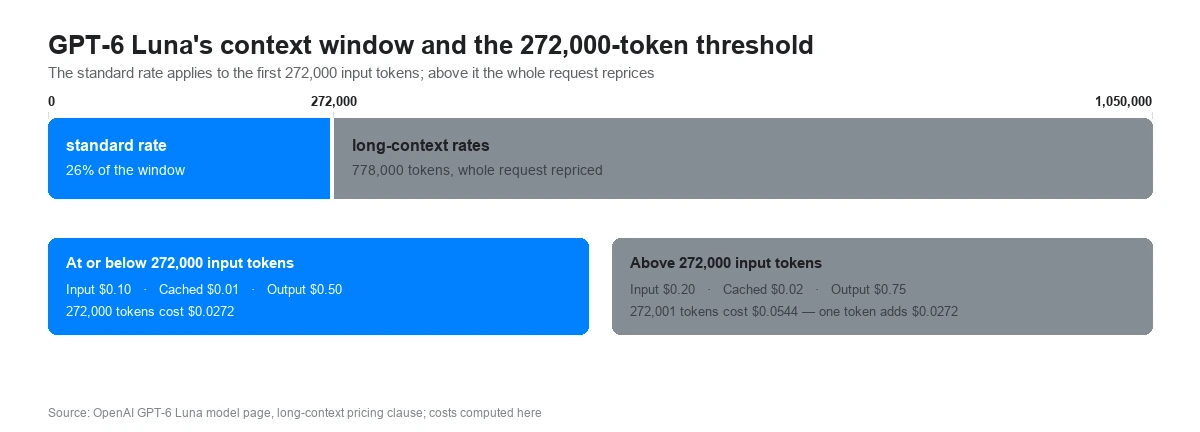
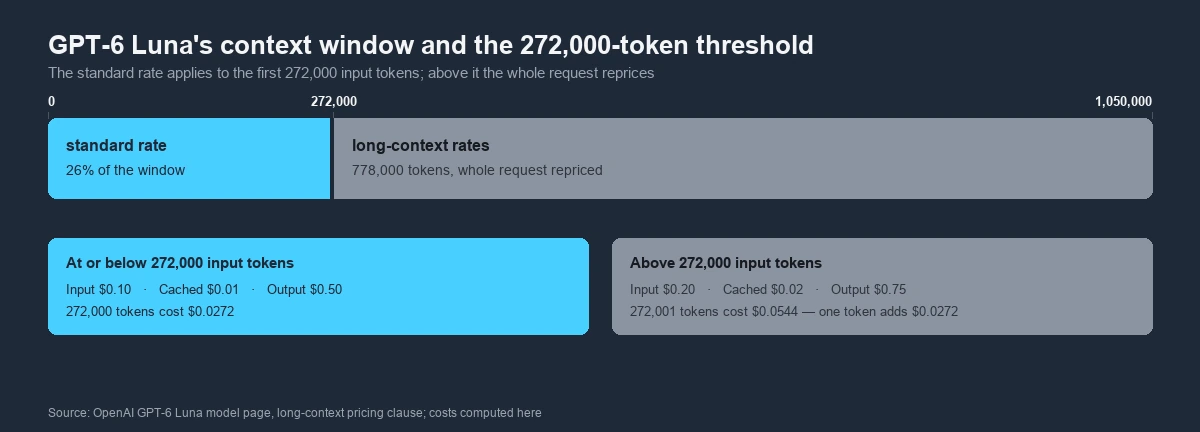
Onde a tarifa padrão termina na janela de contexto do GPT-6 Luna
A janela é de 1.050.000 tokens. A tarifa padrão vale até 272.000 tokens de entrada, cerca de 26% dela; tudo acima é cobrado a 2x na entrada e 1,5x na saída, e a requisição inteira é recalculada quando a linha é cruzada.
Fonte: página do modelo GPT-6 Luna da OpenAI, cláusula de preço para contexto longo, setembro de 2026
Quando o cache se paga
Cache é uma aposta: você paga 1,25 vez a tarifa de entrada uma vez para gravar um prefixo, e depois um décimo dela a cada leitura. Nas tarifas do Luna, a aposta se paga já na segunda chamada.
Uma gravação custa um quarto a mais
A primeira requisição que grava um prefixo é cobrada a US$ 0,125 por milhão de tokens em vez de US$ 0,10 — 25% a mais do que enviar o mesmo texto sem cache.
Uma leitura custa um décimo
Toda requisição seguinte que acerta o cache é cobrada a US$ 0,01 por milhão, economizando US$ 0,09 em relação à tarifa sem cache a cada vez.
Empate na segunda chamada
Uma gravação mais uma leitura dão US$ 0,135 por milhão, contra US$ 0,20 de duas requisições sem cache. Na centésima repetição, o caminho com cache custa cerca de 11% do envio do mesmo prefixo do zero.
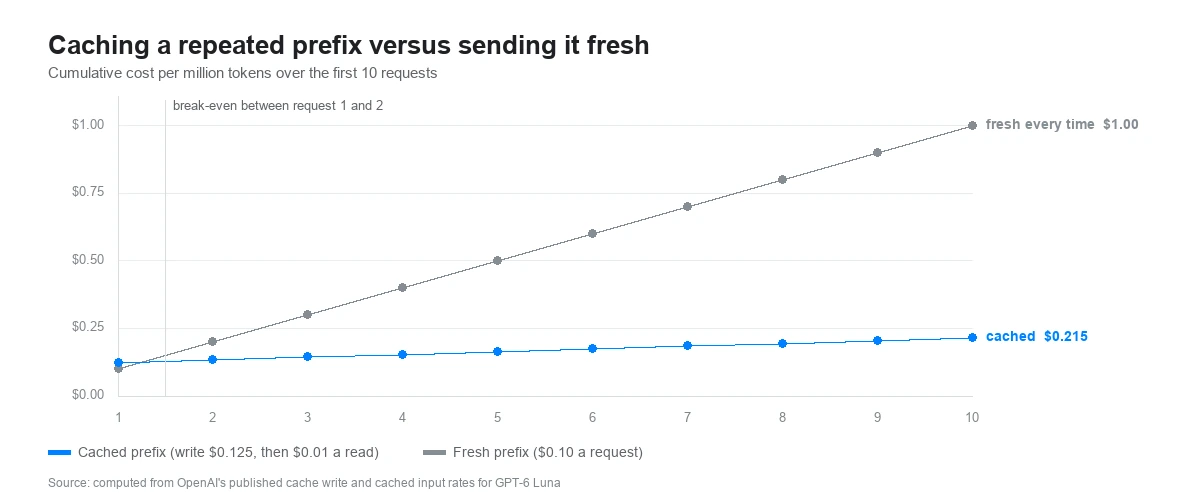
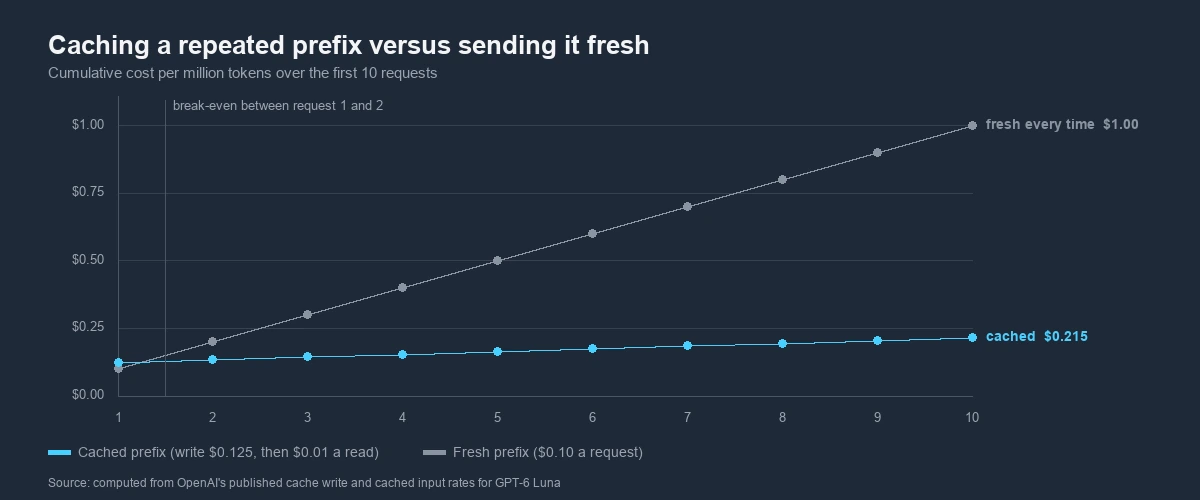
Custo acumulado de repetir o mesmo prefixo, com e sem cache
Custo por milhão de tokens de um prefixo repetido ao longo de 100 requisições. Enviá-lo do zero toda vez custa US$ 10,00; mantê-lo em cache custa US$ 1,115. As duas linhas se cruzam entre a primeira e a segunda requisição.
Fonte: cálculo a partir das tarifas publicadas da OpenAI de gravação em cache e entrada em cache para o GPT-6 Luna, setembro de 2026
A outra alavanca da conta
O Luna aceita a escala completa de seis níveis de esforço de raciocínio da OpenAI, e a configuração decide quantos tokens de raciocínio uma chamada gasta. O padrão é medium.
none
chamada de função
low
medium
padrão
high
xhigh
max
Seis configurações, um padrão
O Luna aceita none, low, medium, high, xhigh e max. Tokens de raciocínio são cobrados como saída, então a configuração é tanto um botão de custo quanto de qualidade: quanto maior o esforço, mais o modelo gasta antes de responder.
Chamada de ferramenta exige none no Chat Completions
Na API Chat Completions, uma requisição que chama ferramentas só é atendida quando o esforço de raciocínio é none. Para ferramentas embutidas e chamada de funções, a OpenAI aponta para a Responses API, onde a escala de esforço está disponível junto com as ferramentas. Vale checar qual endpoint uma integração usa antes de mexer no botão.
Onde o Luna fica na família GPT-6
Três faixas, uma função cada. É um vigésimo da tarifa do Sol que torna a decisão de roteamento fácil.
Modelo
Entrada
Saída
O que rotear para cá
GPT-6 Luna
$0,10
$0,50
Trabalho de alto volume e bem definido: resumir, extrair, classificar, rotear e responder perguntas diretas.
GPT-6 Sol
$2
$10
Trabalho complexo e recorrente: escrever e revisar código, depurar e analisar dados.
GPT-6 Astra
$10
$50
O raciocínio mais difícil numa única passada, uso de computador e trabalho científico ou matemático.
O que a OpenAI afirma e o que ela mediu
A OpenAI faz dois tipos de afirmação sobre o Luna: o que ele entrega pelo dinheiro e o que ele deixou de fazer. As duas são números do fornecedor, e as duas estão marcadas como tal.
Trabalho entregue por dólar
A principal afirmação da OpenAI sobre o Luna é normalizada por custo, e não uma pontuação bruta: no esforço máximo ele supera o GPT-5.6 Sol em esforço médio a cerca de um décimo do custo da tarefa. A cobertura do lançamento também reporta 66,6% no DeepSWE v1.1, 5,4 pontos acima do GPT-5.6 Luna em esforço alto, com 58% menos custo por tarefa. O Luna tem números publicados em bem menos benchmarks que o Sol, então esta página traz as afirmações em vez de uma tabela de benchmarks.
Afirmações enganosas sobre trabalho de código
A OpenAI relata que o Luna leva o trabalho de alinhamento do Astra para a faixa barata, incluindo taxas menores de afirmações enganosas sobre o próprio trabalho de código. O número em que vários textos independentes concordam é a taxa de engano sobre código: 2,8%, contra 9,5% no GPT-5.6 Luna.
Avaliação
GPT-5.6 Luna
GPT-6 Luna
Taxa de engano sobre código (menor é melhor)
9,5%
2,8%
Avaliações de alinhamento da própria OpenAI, rodadas em cenários deliberadamente difíceis e em sua maioria de baixo risco, sem as proteções de produção. A OpenAI declara que elas não medem taxas de falha no uso comum, então isto não é uma taxa de produção. Um segundo número do lançamento, que a imprensa reportou de formas inconsistentes, fica fora desta página em vez de ser promediado.
O que rodar no Luna
As tarefas para as quais a OpenAI criou esta faixa, onde o custo por chamada define o teto do que vale a pena construir.
Resumo em volume
Documentos, conversas e transcrições comprimidos em um parágrafo, onde o preço por token decide se a tarefa roda ou não.
Extração
Tirar campos estruturados de texto não estruturado — notas fiscais, anúncios, formulários — num formato que um pipeline consiga consumir.
Classificação e marcação
Triar tickets, rotular conteúdo e aplicar categorias em todo um corpus, uma chamada barata de cada vez.
Roteamento
Decidir o que uma requisição é e para onde deve ir, uma decisão pequena que não deveria custar uma chamada do modelo principal.
Perguntas rápidas
As consultas factuais curtas que um produto responde na própria interface, onde latência e preço importam mais que profundidade.
Trabalho em lote e Flex
A OpenAI cobra Batch e Flex pela metade da tarifa padrão, o que deixa a entrada do Luna em US$ 0,05 por milhão para tudo o que pode esperar.
Onde o GPT-6 Luna roda
O Luna saiu em todas as superfícies da OpenAI menos no chat principal, além das plataformas que o listaram no mesmo dia. No Felo, ele roda sob o ID de modelo gpt-6-luna.
Felo AI Search
Disponível como gpt-6-luna, junto com o resto da família GPT-6.
API da OpenAI
Chat Completions, Responses e Batch, como gpt-6-luna.
ChatGPT Work e Codex
Plus, Pro, Business, Enterprise e Edu, com liberação pelo administrador no Enterprise.
Free e Go
Acessível no aplicativo para desktop, não no chat do navegador.
GitHub Copilot
Planos Pro, Pro+, Max, Business e Enterprise.
Amazon Bedrock e OpenRouter
As duas plataformas listaram o Luna em 22 de setembro de 2026, no dia do lançamento.
O que o Luna não suporta
Vale checar antes de construir em cima dele. A página do modelo da OpenAI lista estes itens como não suportados no GPT-6 Luna.
- APIs Realtime e Live
- Assistants API
- Ajuste fino
- Embeddings
- Geração e edição de imagens
- Áudio, vídeo e moderação
Especificações
O que a OpenAI publicou para o GPT-6 Luna.
Preços
GPT-6 Luna: $0,10 / $0,50 por milhão de tokens, com entrada em cache a $0,01 e gravação em cache a US$ 0,125.
Tarifas padrão. Batch e Flex custam metade, Fast mode custa o dobro, e requisições acima de 272.000 tokens de entrada pagam 2x na entrada e 1,5x na saída pela requisição inteira.
Janela de contexto
1.050.000 tokens, com máximo de 922.000 na entrada e 128.000 na saída.
A mesma janela do GPT-6 Sol e do GPT-6 Astra, mas a tarifa padrão cobre apenas os primeiros 272.000 tokens de entrada.
Data de corte do conhecimento
18 de maio de 2026, o corte mais recente dos três modelos GPT-6.
Modalidades
Texto e imagens na entrada, texto na saída.
Esforço de raciocínio
None, low, medium, high, xhigh e max, com medium como padrão. Chamada de funções no Chat Completions exige none.
Lote e preços regionais
Batch e Flex custam 50% da tarifa padrão. Processamento regional acrescenta 10%, e residência de dados na EU exige processamento Standard.
Perguntas frequentes
O GPT-6 Luna é o modelo GPT-6 mais barato da OpenAI, lançado em 22 de setembro de 2026 junto com o GPT-6 Sol e posicionado abaixo do Sol e do Astra, o principal. A OpenAI o descreve como seu modelo mais eficiente, feito para tarefas de alto volume com um objetivo claro: resumir documentos, extrair informações, classificar e responder perguntas diretas. Ele custa US$ 0,10 por milhão de tokens de entrada e US$ 0,50 por milhão de saída.
Experimente o GPT-6 Luna no Felo
O modelo GPT-6 mais barato da OpenAI: US$ 0,10 na entrada e US$ 0,50 na saída por milhão de tokens, leitura em cache a US$ 0,01 e uma janela de 1.050.000 tokens.
Disponível no Felo AI Search e na API da Felo