01
Tenere tutto il contesto
Finestra di contesto da 1 milione di token e conoscenze aggiornate a giugno 2026. Un thread lungo, un intero repository o un fascicolo di documenti restano in un'unica attività.
Anthropic ha pubblicato Opus 5.5 il 22 settembre 2026
Il primo modello della famiglia Claude 5.5. Raggiunge il livello di Claude Fable 5.1 sulla maggior parte dei compiti, costa il 40% in meno da eseguire rispetto a Opus 5 e genera l'output oltre il 30% più velocemente.
Ora nella ricerca Felo
Claude Opus 5.5 è disponibile nella ricerca Felo per i compiti con input lunghi: incrociare cifre tra file diversi, risalire da un'affermazione alla sua fonte e restituire una risposta che puoi girare a qualcun altro.
01
Finestra di contesto da 1 milione di token e conoscenze aggiornate a giugno 2026. Un thread lungo, un intero repository o un fascicolo di documenti restano in un'unica attività.
02
In un test interno di Anthropic, 16 rapporti su 18 hanno superato la soglia di qualità. Un solo dato o una sola citazione inventati avrebbero fatto fallire la prova.
03
Anthropic ha riscritto il modo in cui il modello comunica: le informazioni più importanti vengono prima e il rapporto dice chiaramente cosa è pronto, cosa è emerso e cosa resta aperto.
Guida rapida
Claude Opus 5.5 compare nel selettore dei modelli accanto agli altri modelli di punta del tuo account.
La differenza di Opus 5.5
Anthropic punta sull'efficienza, non su un punteggio di benchmark più alto: meno token per attività, prezzo per token più basso e il 40% di costo in meno sui carichi di lavoro tipici. È questo che rende sostenibile lasciare un agente al lavoro per ore.
01
Anthropic riferisce che un tester ha analizzato e corretto una base di codice da 200.000 righe in meno di tre ore, dove Opus 5 impiegava oltre 20 ore e usava 2,5 volte i token.
02
Deloitte ha riferito che, al livello di effort più basso, Opus 5.5 ha individuato il 72% dei bug noti in code review, contro il 56% di Opus 5 in high, con meno falsi allarmi.
03
I testi sono più brevi e meglio strutturati. Box ha riferito risposte il 40% meno prolisse senza perdita di accuratezza e con un terzo dei token di Opus 5.
Scelta del modello
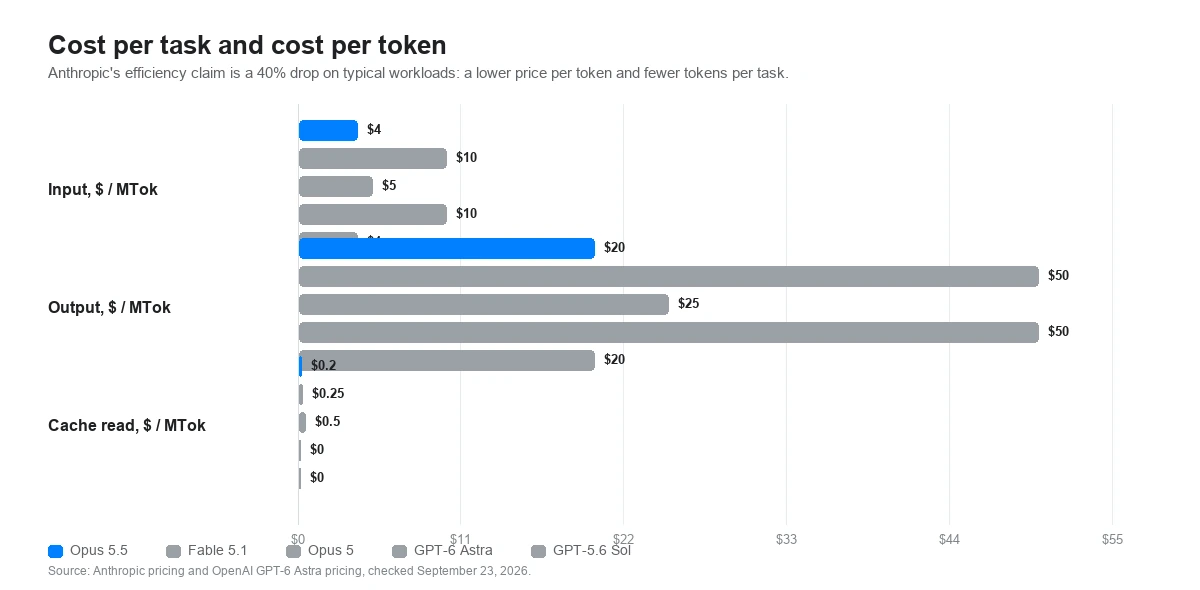
I prezzi sotto sono tariffe pubbliche ufficiali delle API per milione di token, non prezzi di abbonamento o di utilizzo di Felo. La riga dell'effort conta quanto quella del prezzo: lo stesso prompt può costare molto diversamente a seconda di dove parte ciascun modello.
Le tariffe pubbliche delle API e i valori predefiniti sono stati verificati il 23 settembre 2026 sull'annuncio di Claude Opus 5.5 di Anthropic, sulle pagine dei modelli di Claude Platform e sulla pagina di GPT-6 Astra di OpenAI. Il prezzo per token è solo una parte del costo totale di un'attività. L'affermazione di efficienza di Anthropic è un calo del 40% su carichi tipici, che combina prezzo per token più basso e meno token per attività.
Risultati pubblicati da Anthropic
Anthropic ha pubblicato i propri numeri accanto a Fable 5.1, Opus 5, GPT-6 Astra e GPT-5.6 Sol. Due dei quattro grafici qui sotto mostrano l'accuratezza rispetto al costo per attività invece dell'accuratezza da sola, perché è esattamente il confronto che Anthropic sta facendo.
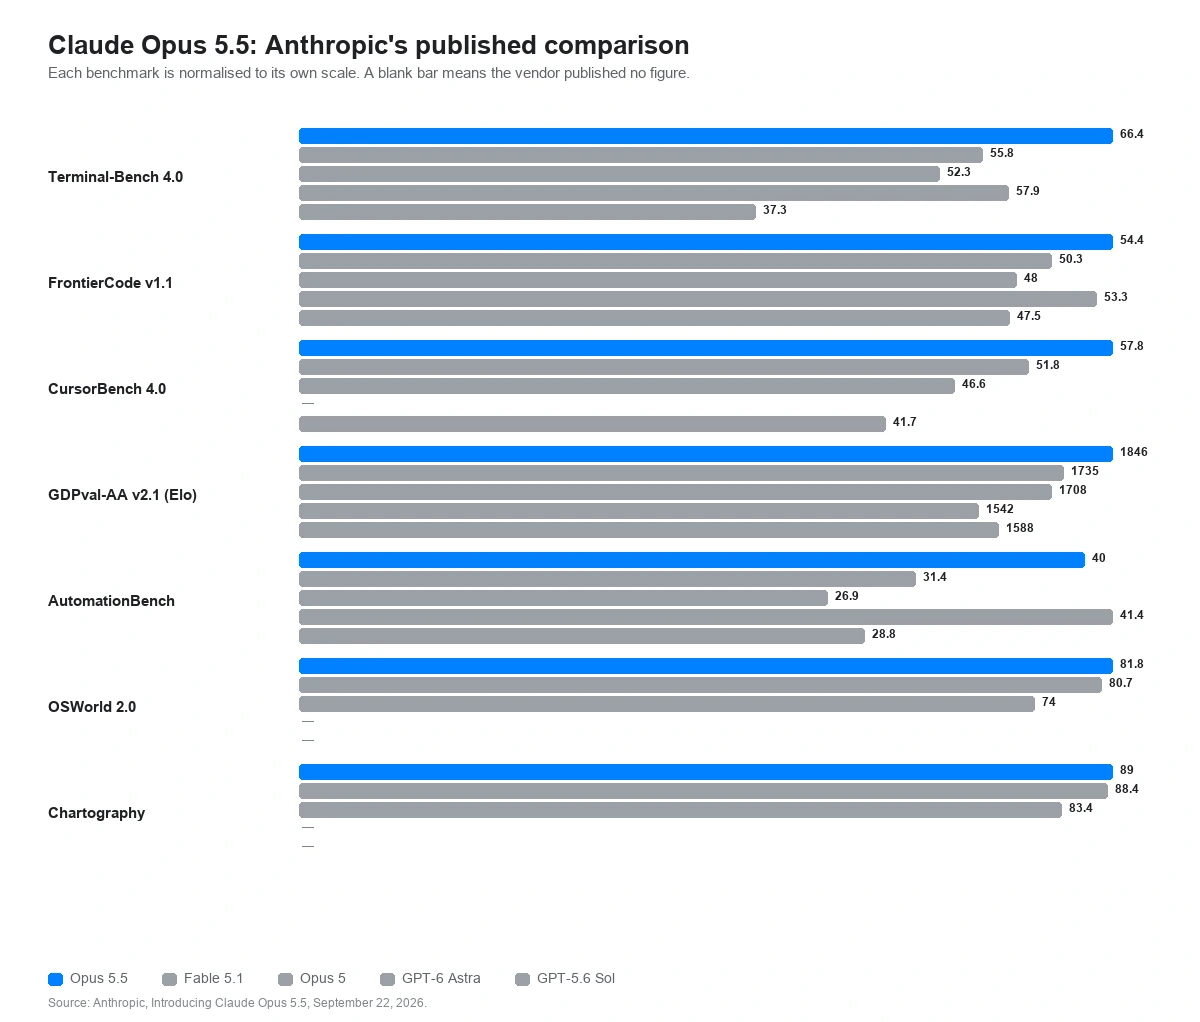
Il confronto pubblicato per intero
Codifica agentica, lavoro di conoscenza, flussi di lavoro aziendali, ragionamento multidisciplinare, ricerca scientifica, uso del computer e lettura di grafici, su tutti e cinque i modelli misurati.
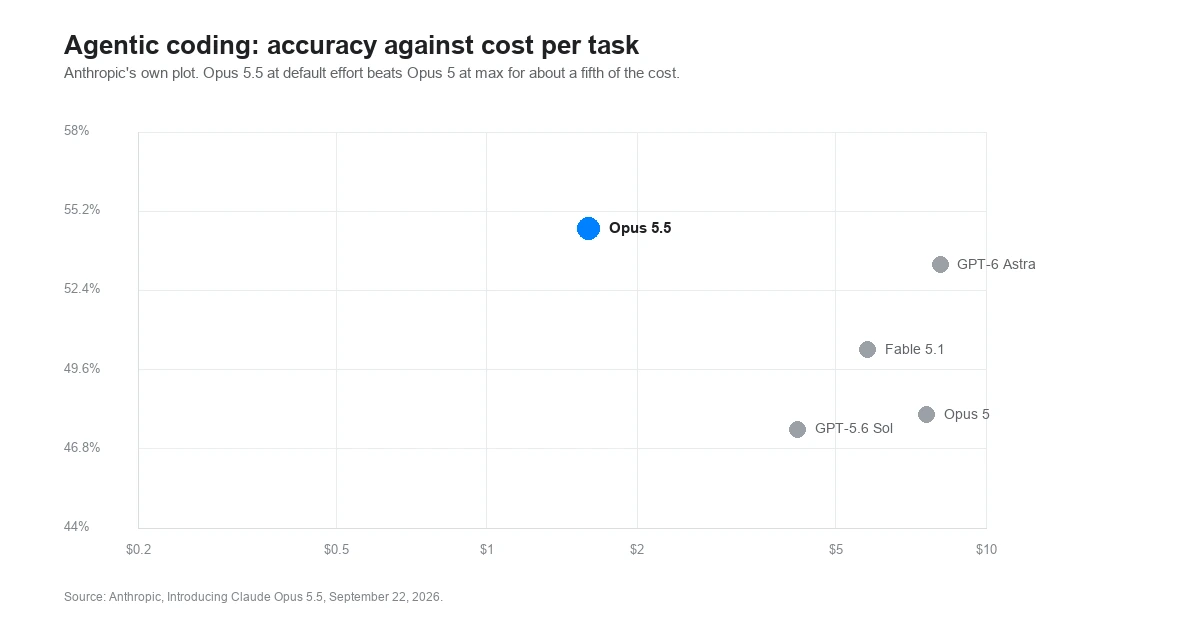
Codifica agentica
Terminal-Bench 4.0, FrontierCode v1.1 e CursorBench 4.0, tracciati come accuratezza rispetto al costo per attività.
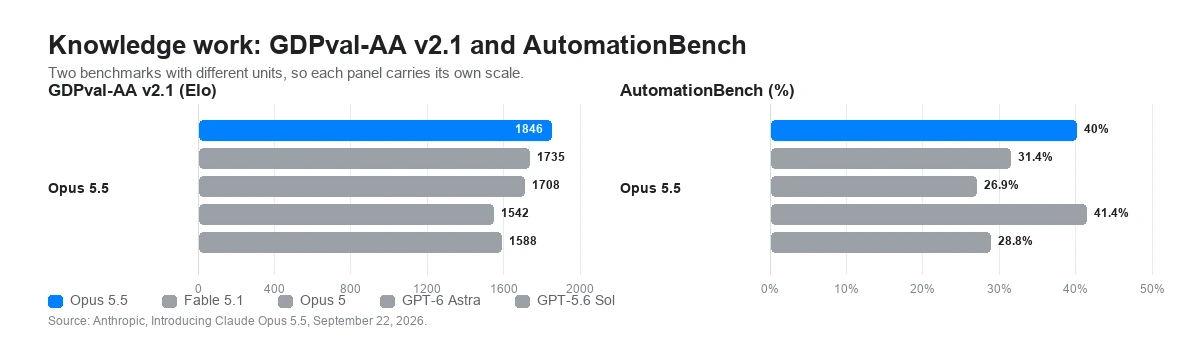
Lavoro di conoscenza
GDPval-AA v2.1 su 44 occupazioni, AutomationBench e WANDR, il benchmark di raccolta dati di Perplexity.
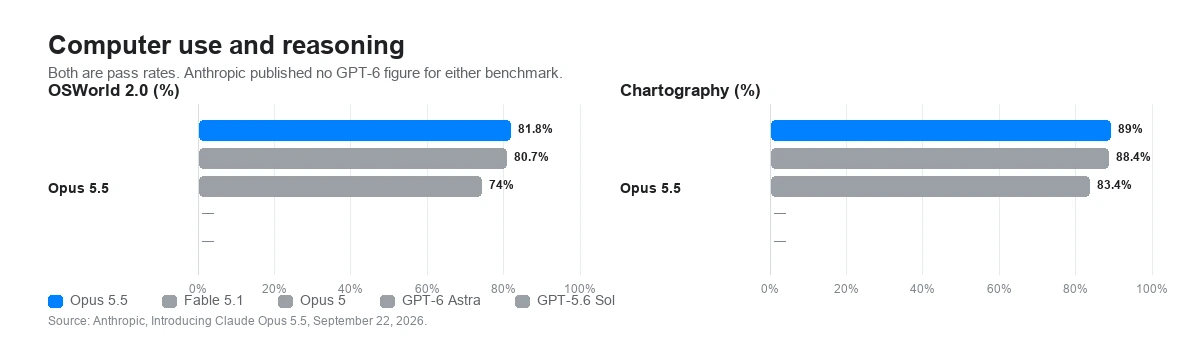
Uso del computer e ragionamento
OSWorld 2.0, Humanity's Last Exam e Chartography, che misura la precisione nel leggere valori da un grafico.
Accuratezza rispetto al costo per attività
La tesi centrale di Anthropic non è un punteggio più alto a qualsiasi prezzo, ma lo stesso punteggio, o migliore, a una frazione del costo per tentativo.
Numeri pubblicati dal fornitore. Salvo diversa indicazione, Anthropic ha eseguito Opus 5.5 con ragionamento adattivo in max effort e lo ha valutato con le protezioni di produzione attive. Quando queste protezioni sono intervenute, i compiti di cybersicurezza sono stati completati da Opus 4.8 e quelli di biologia da Opus 5, il che probabilmente abbassa i numeri pubblicati di Opus 5.5 su quei benchmark. I numeri di GPT-6 Astra e GPT-5.6 Sol sono quelli riportati da OpenAI. I divari di benchmark tra fornitori sono un indizio debole delle differenze reali, come dice Anthropic stessa di questi numeri.
Se già esegui Opus 5
Anthropic elenca quattro modifiche incompatibili per le integrazioni che già girano su Claude Opus 5, più una quinta che cambia la forma della risposta senza far fallire alcuna richiesta. Vale la pena leggerle prima di cambiare l'ID del modello, perché tre di esse restituiscono un errore 400 invece di degradare in silenzio.
01
Su Opus 5 il ragionamento si poteva disattivare fino a high compreso. Su Opus 5.5 è sempre attivo, e sia la disattivazione sia un budget manuale di token restituiscono un errore 400. L'effort diventa l'unico controllo e il valore predefinito passa da high a medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice impostato su "any" o su uno strumento specifico restituisce un errore 400, anche sull'endpoint di conteggio dei token. Usa auto con l'uso rigoroso degli strumenti o gli output strutturati, e indica nel prompt quando lo strumento serve.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Ogni blocco di ragionamento registra quale modello lo ha prodotto. Opus 5.5 legge i blocchi di Opus 5 e dei precedenti modelli Opus, Sonnet e Haiku, ma non quelli di Fable o Mythos. Se un router sposta la conversazione su un altro modello, i turni successivi girano senza il ragionamento precedente.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 conservano il ragionamento; gli altri modelli lo perdono
04
Nell'API Claude e su Google Cloud lo strumento computer_20251124 restituisce un errore 400. Dichiara invece il toolset computer_toolset_20260801, rimuovi l'header beta e adatta il loop dell'agente ai blocchi member tool_use. Su Amazon Bedrock il vecchio strumento continua a funzionare.
computer_20251124 -> computer_toolset_20260801
Dato che il ragionamento non si può disattivare, ciò che si regola è l'effort. Opus 5.5 supporta tutti e cinque i livelli e parte da medium, un livello sotto Opus 5. La raccomandazione di Anthropic è rifare la scansione sulle proprie valutazioni invece di riportare un'impostazione, e impostare un max_tokens ampio ai livelli alti, perché i token di ragionamento contano su quel limite anche quando il testo del ragionamento non viene restituito.
L'effort è un segnale comportamentale, non un budget rigido di token: a un livello basso il modello ragiona comunque sui problemi davvero difficili, solo meno di quanto farebbe a un livello alto. Anthropic osserva inoltre che Opus 5.5 tende a pensare più per turno rispetto a Opus 5 allo stesso livello, soprattutto in xhigh e max, quindi un'impostazione ereditata da Opus 5 produrrà turni più lunghi e più costosi.
Dove si inserisce
Opus 5.5 vale la spesa quando un'attività dura ore, copre più file di quanti una persona possa tenerne a mente o produce qualcosa che un'altra persona deve verificare. Sono i casi descritti da Anthropic e dai suoi primi tester, non prompt di chat generici.
Portare una modifica attraverso un repository grande finché i test passano, invece di fermarsi alla prima patch plausibile. Anthropic riferisce di una migrazione da 680.000 righe conclusa in meno di un giorno da un tester.
Column, tester citato da Anthropic, ha riferito di aver trovato un bug consultando la documentazione esterna di un'integrazione di terze parti modellata male diversi commit prima.
Costruire il modello e poi il riassunto di una pagina, mantenendo le avvertenze. Anthropic riferisce un'analisi di fusione conclusa in 63 minuti contro 93 di Opus 5, a metà costo.
Delega ai subagenti e calibra il ritmo su un budget di tempo. La raccomandazione di Anthropic è dare a un'architettura multi-agente un segnale di tempo trascorso, così parallelizza invece di serializzare.
01
Aggiungi repository, documenti e requisiti che una risposta utile deve considerare. La finestra da 1 milione di token esiste per questo.
02
Di' cosa deve essere vero perché il lavoro sia considerato finito. Il consiglio di Anthropic per le esecuzioni non presidiate è tenere le parti dell'attività in una checklist che il modello aggiorna.
03
Esegui la stessa attività su Opus 5.5, Opus 5 e Fable 5.1 in Felo. Confronta test, avvertenze e consumo di token, non solo la risposta.
Seleziona Claude Opus 5.5 quando compare nel selettore dei modelli del tuo account.
Prova Opus 5.5 su FeloClaude Opus 5.5 è il modello di Anthropic per la codifica agentica di lunga durata e il lavoro di conoscenza, pubblicato il 22 settembre 2026 come primo modello della famiglia Claude 5.5. Secondo Anthropic raggiunge il livello di Claude Fable 5.1 sulla maggior parte dei compiti e costa il 40% in meno da eseguire rispetto a Claude Opus 5.
Metti Claude Opus 5.5 accanto agli altri modelli di punta in Felo, poi provalo su quel lavoro che rimandi perché richiede ore.
Prova Opus 5.5 su FeloInizia dalla ricerca di Felo AI e seleziona il modello dove è disponibile.