01
맥락을 통째로 담기
100만 토큰 컨텍스트 창과 2026년 6월 지식 컷오프. 긴 스레드, 저장소 전체, 문서 묶음을 하나의 작업에 담을 수 있습니다.
Anthropic이 2026년 9월 22일 Opus 5.5를 공개했습니다
Anthropic Claude 5.5 패밀리의 첫 모델입니다. 대부분의 작업에서 Claude Fable 5.1 수준의 성능을 내면서 실행 비용은 Opus 5보다 40% 낮고, 출력 속도는 30% 이상 빠릅니다.
Felo 검색에서 사용 가능
Claude Opus 5.5가 Felo 검색에 들어왔습니다. 긴 입력을 다루는 작업에 맞습니다. 파일을 넘나들며 수치를 대조하고, 주장을 출처까지 추적하고, 그대로 다른 사람에게 넘길 수 있는 답을 만드는 일입니다.
01
100만 토큰 컨텍스트 창과 2026년 6월 지식 컷오프. 긴 스레드, 저장소 전체, 문서 묶음을 하나의 작업에 담을 수 있습니다.
02
Anthropic의 내부 테스트에서 18건 중 16건의 보고서가 품질 기준을 통과했습니다. 지어낸 수치나 인용이 하나라도 있으면 실패하는 작업이었습니다.
03
Anthropic은 모델의 소통 방식을 다시 설계했습니다. 가장 중요한 정보가 앞에 오고, 완료한 일과 발견한 것, 아직 열려 있는 항목을 그대로 적습니다.
빠른 안내
Claude Opus 5.5는 계정의 다른 주요 모델과 함께 모델 선택기에 표시됩니다.
Opus 5.5의 차이
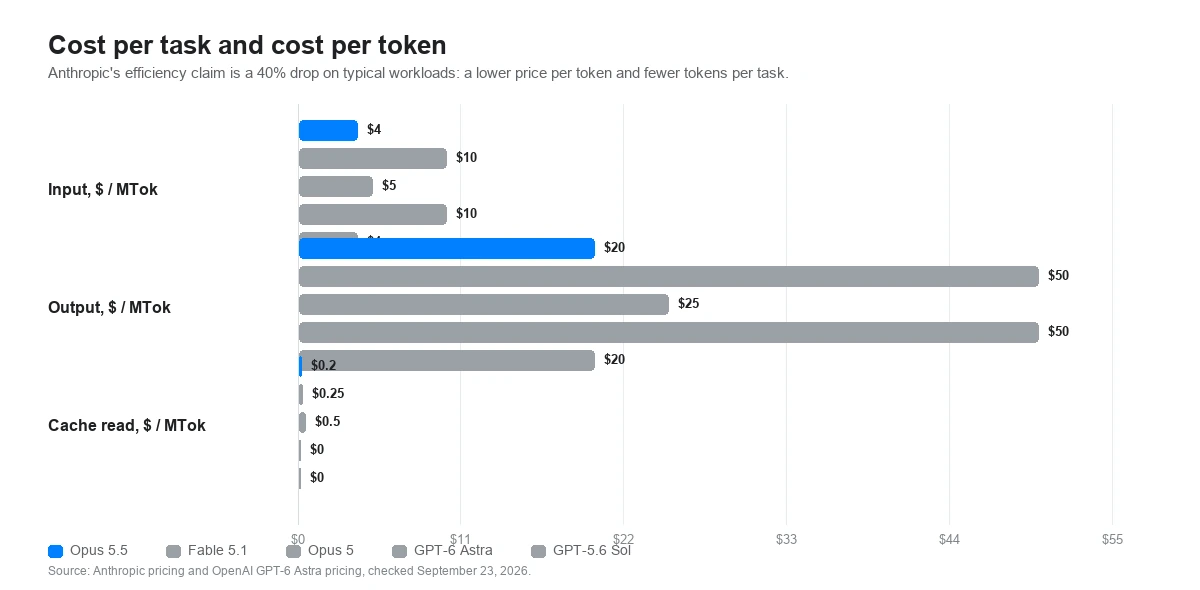
Anthropic이 내세우는 것은 벤치마크 점수가 아니라 효율입니다. 작업당 토큰 수가 줄고 토큰 단가도 내려가 일반적인 워크로드에서 비용이 40% 줄어듭니다. 오래 돌아가는 에이전트 작업을 감당할 수 있는 비용으로 만드는 것이 바로 이 지점입니다.
01
Anthropic에 따르면 초기 테스터는 20만 줄 코드베이스를 세 시간이 채 안 되어 감사하고 수정했습니다. Opus 5는 20시간 넘게 걸렸고 토큰도 2.5배 더 썼습니다.
02
Deloitte는 가장 낮은 effort 설정에서도 코드 리뷰로 알려진 버그의 72%를 찾아냈다고 보고했습니다. Opus 5는 high 설정에서 56%였고 오탐도 더 많았습니다.
03
문장이 더 짧고 구조가 분명합니다. Box는 정확도를 잃지 않고 답변이 40% 덜 장황해졌고 토큰은 Opus 5의 3분의 1만 썼다고 보고했습니다.
모델 선택
아래 가격은 백만 토큰당 공식 공개 API 요금이며 Felo 구독이나 사용량 요금이 아닙니다. effort 행은 가격 행만큼 중요합니다. 같은 프롬프트라도 각 모델의 출발점이 다르면 비용이 크게 달라집니다.
위 공개 API 요금과 기본값은 2026년 9월 23일 기준으로 Anthropic의 Claude Opus 5.5 발표, Claude Platform 모델 페이지, OpenAI의 GPT-6 Astra 페이지와 대조했습니다. 토큰 단가는 전체 작업 비용의 일부일 뿐입니다. Anthropic이 내세우는 효율은 일반적인 워크로드에서 40% 비용 절감이며, 여기에는 토큰 단가 인하와 작업당 토큰 감소가 함께 포함됩니다.
Anthropic이 공개한 결과
Anthropic은 자사 수치를 Fable 5.1, Opus 5, GPT-6 Astra, GPT-5.6 Sol과 나란히 공개했습니다. 아래 네 개의 차트 중 두 개는 정확도 자체가 아니라 정확도와 작업당 비용의 관계를 보여줍니다. Anthropic이 하려는 비교가 바로 그것이기 때문입니다.
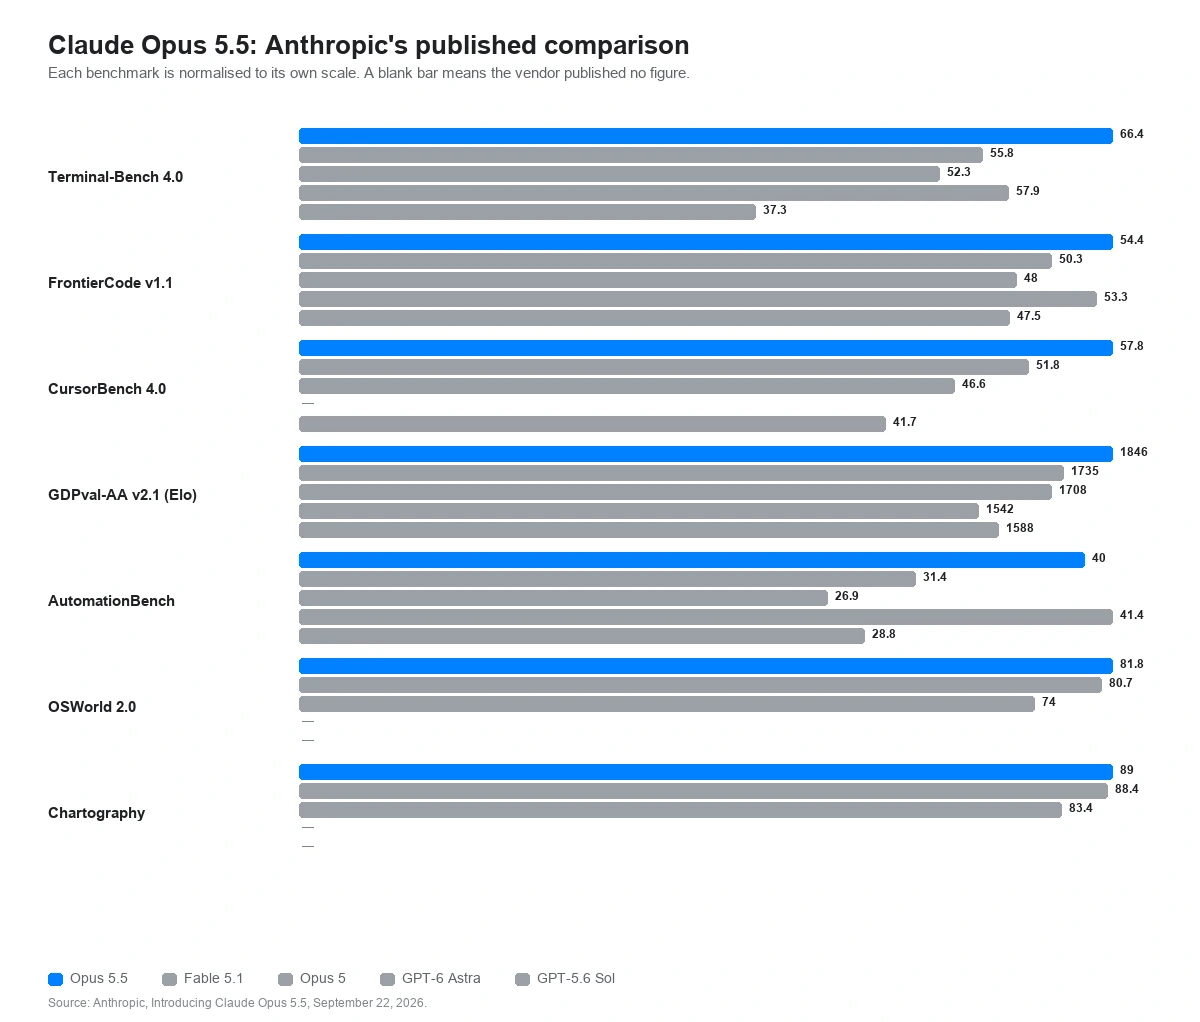
공개된 전체 비교
에이전트 코딩, 지식 작업, 비즈니스 워크플로, 학제 간 추론, 과학 연구, 컴퓨터 사용, 차트 인식을 Anthropic이 측정한 다섯 모델 모두에 대해 보여줍니다.
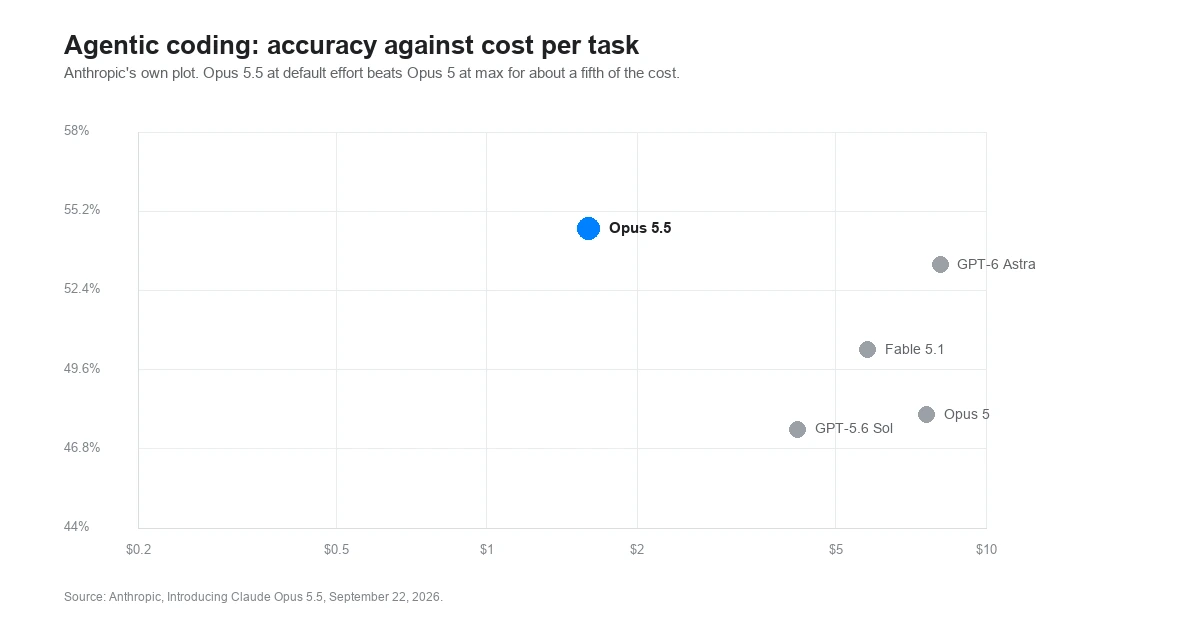
에이전트 코딩
Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0을 작업당 비용 대비 정확도로 나타냈습니다.
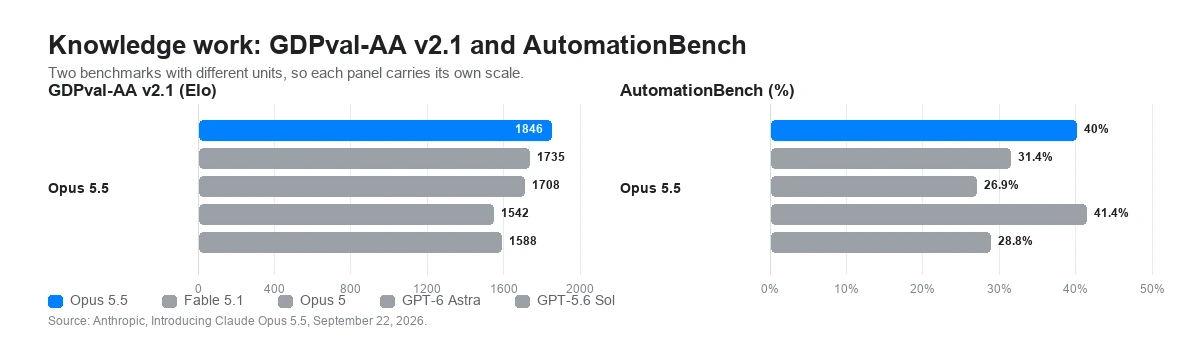
지식 작업
44개 직업을 아우르는 GDPval-AA v2.1, AutomationBench, Perplexity의 데이터 수집 벤치마크 WANDR.
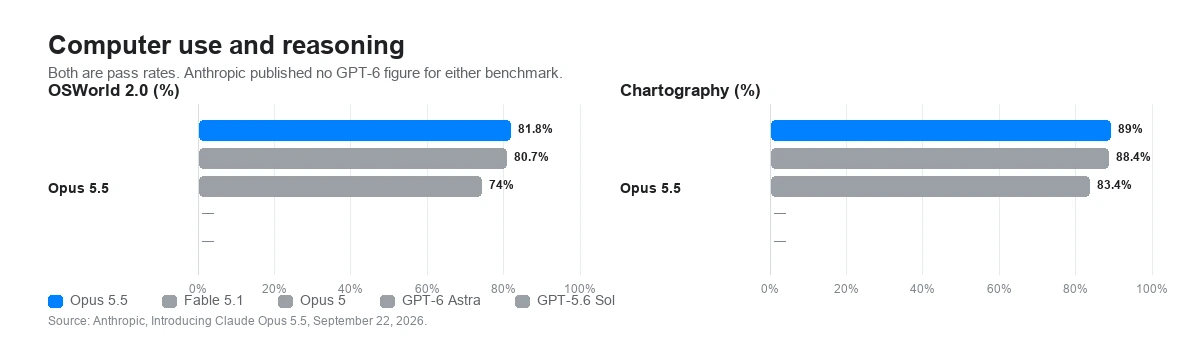
컴퓨터 사용과 추론
OSWorld 2.0, Humanity's Last Exam, Chartography. 마지막 항목은 차트에서 값을 읽어내는 정확도를 측정합니다.
정확도와 작업당 비용
Anthropic의 핵심 주장은 어떤 비용을 치르더라도 더 높은 점수를 받는 것이 아니라, 비용을 크게 낮추면서 같거나 더 나은 점수를 받는 것입니다.
벤더가 공개한 수치입니다. 별도 표기가 없으면 Anthropic은 max effort에서 적응형 사고를 켜고 Opus 5.5를 실행했으며 프로덕션 안전장치를 활성화한 상태로 평가했습니다. 안전장치가 개입한 경우 사이버보안 작업은 Opus 4.8이, 생물학 작업은 Opus 5가 완료했으며, 이는 해당 벤치마크에서 공개된 Opus 5.5 수치를 낮췄을 가능성이 큽니다. GPT-6 Astra와 GPT-5.6 Sol 수치는 OpenAI가 보고한 값입니다. 벤더 간 벤치마크 격차는 실제 차이를 보여주는 약한 지표일 뿐이라는 것이 Anthropic 자신의 설명입니다.
이미 Opus 5를 운영 중이라면
Anthropic은 이미 Claude Opus 5에서 돌아가는 통합을 위한 호환성 깨지는 변경 네 가지를 제시했습니다. 여기에 요청을 실패시키지 않으면서 응답 구조를 바꾸는 변경이 하나 더 있습니다. 모델 ID를 바꾸기 전에 읽어볼 만합니다. 네 가지 중 세 가지는 조용히 성능이 떨어지는 대신 400 오류를 반환하기 때문입니다.
01
Opus 5에서는 high 이하에서 사고를 끌 수 있었습니다. Opus 5.5에서는 항상 켜져 있고, 비활성화 지정과 수동 토큰 예산 모두 400 오류를 반환합니다. 이제 effort만이 제어 수단이며 기본값도 high에서 medium으로 바뀌었습니다.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice를 "any"로 두거나 도구 이름을 지정하면 400 오류가 납니다. 토큰 계산 엔드포인트도 마찬가지입니다. auto와 함께 엄격한 도구 사용이나 구조화 출력을 쓰고, 도구를 써야 하는 상황은 프롬프트에서 알려 주세요.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
각 사고 블록은 이를 생성한 모델을 기록합니다. Opus 5.5는 Opus 5와 그 이전 Opus, Sonnet, Haiku 모델의 블록은 읽지만 Fable과 Mythos의 블록은 읽지 못합니다. 라우터가 대화를 다른 모델로 옮기면 이후 턴은 이전 추론 없이 실행됩니다.
Opus 5.5 -> Fable 5.1 / Mythos 5.1은 사고를 유지, 다른 모델은 폐기
04
Claude API와 Google Cloud에서 computer_20251124 도구는 400 오류를 반환합니다. 대신 computer_toolset_20260801 도구셋을 선언하고 베타 헤더를 제거하며, 에이전트 루프를 멤버 tool_use 블록에 맞게 수정하세요. Amazon Bedrock에서는 구형 도구가 계속 동작합니다.
computer_20251124 -> computer_toolset_20260801
사고를 끌 수 없으니 조정할 것은 effort입니다. Opus 5.5는 다섯 단계를 모두 지원하고 기본값은 medium으로, Opus 5보다 한 단계 낮습니다. Anthropic의 권고는 이전 설정을 그대로 쓰지 말고 자체 평가에서 다시 훑어보라는 것, 그리고 높은 단계에서는 max_tokens를 넉넉히 잡으라는 것입니다. 사고 텍스트가 반환되지 않아도 사고 토큰은 이 한도에 포함되기 때문입니다.
effort는 엄격한 토큰 예산이 아니라 행동 신호입니다. 낮은 단계에서도 정말 어려운 문제에서는 사고하지만, 높은 단계보다는 적게 합니다. Anthropic은 또한 같은 단계에서 Opus 5.5가 Opus 5보다 턴당 더 많이 사고하는 경향이 있고 xhigh와 max에서 특히 두드러진다고 밝혔습니다. Opus 5 설정을 그대로 가져오면 턴이 더 길고 비싸집니다.
어울리는 작업
몇 시간씩 걸리거나, 한 사람이 감당할 수 없을 만큼 많은 파일을 다루거나, 결과물을 다른 사람이 확인해야 하는 작업에서 Opus 5.5가 값을 합니다. 아래는 Anthropic과 초기 테스터가 제시한 구체적인 작업이며 일반적인 채팅 프롬프트가 아닙니다.
그럴듯해 보이는 첫 패치에서 멈추지 않고 테스트가 통과할 때까지 변경을 큰 저장소 전체로 밀어붙입니다. Anthropic에 따르면 한 테스터는 68만 줄 마이그레이션을 하루가 안 되어 끝냈습니다.
Anthropic의 테스터인 Column은 여러 커밋 전에 잘못 모델링된 서드파티 연동에 대해 외부 문서를 확인해 버그를 찾아냈다고 보고했습니다.
모델을 만들고 한 장짜리 요약을 쓴 뒤 전제와 유보 사항을 그대로 남깁니다. Anthropic에 따르면 한 인수 분석은 63분에 끝났고 Opus 5의 93분보다 비용이 절반이었습니다.
하위 에이전트에 위임하고 시간 예산에 맞춰 진행 속도를 조절합니다. Anthropic은 다중 에이전트 구성에 경과 시간 신호를 주면 직렬화 대신 병렬화한다고 설명합니다.
01
저장소, 문서, 요구사항처럼 쓸모 있는 답이 반영해야 할 것들을 넣으세요. 100만 토큰 창이 바로 이를 위한 것입니다.
02
무엇이 충족되어야 끝난 것인지 분명히 하세요. 무인 실행에 대한 Anthropic의 권고는 작업 항목을 체크리스트로 두고 모델이 계속 갱신하게 하는 것입니다.
03
같은 작업을 Felo에서 Opus 5.5, Opus 5, Fable 5.1에 각각 맡기세요. 답변뿐 아니라 테스트, 유보 사항, 토큰 사용량까지 비교하세요.
계정의 모델 선택기에 Claude Opus 5.5가 표시되면 선택하세요.
Felo에서 Opus 5.5 사용해 보기Claude Opus 5.5는 오래 실행되는 에이전트 코딩과 지식 작업을 위한 Anthropic의 모델로, 2026년 9월 22일 Claude 5.5 패밀리의 첫 모델로 공개되었습니다. Anthropic에 따르면 대부분의 작업에서 Claude Fable 5.1 수준의 성능을 내면서 실행 비용은 Claude Opus 5보다 40% 낮습니다.
Felo에서 Claude Opus 5.5를 다른 주요 모델과 나란히 두고, 몇 시간이 걸린다는 이유로 미뤄 둔 작업에 시험해 보세요.
Felo에서 Opus 5.5 사용해 보기Felo AI 검색에서 시작하고 사용 가능한 경우 모델을 선택하세요.