2026년 9월 30일 발표 · 단계적 출시 중

Gemini 4 Argon긴 리서치를, 한 번에 끝까지

Google이 Gemini 3 이후 처음 선보이는 프론티어 모델입니다. 길고 여러 단계에 걸친 작업을 아우르는 깊은 추론을 위해 만들어졌습니다. 출력 상한은 64K 토큰에서 1M로 올라갔고, Google이 공개한 수치에서는 코딩보다 지식 작업에서 앞섭니다.

Felo API는 현재 클로즈드 베타로 운영 중이며, Gemini 4 Argon은 곧 지원될 예정입니다.
Gemini 4 Argon 키 비주얼: 파란 그라데이션 위에 모델 이름과 큼직한 숫자 4가 나란히 놓여 있는 이미지
Google의 발표 아트워크. Argon은 Gemini 4.0 라인의 업데이트가 아니라 새로운 작명 체계로 출시됩니다. 이름에 버전 번호가 붙지 않은 이유가 여기에 있습니다.
1M
최대 출력 토큰
64K에서 늘어난 값입니다. 한 번의 생성 흐름으로 보고서를 끝까지 쓸 수 있습니다.
$2 / $10
API 도입 가격
입력·출력 각각 백만 토큰당. 캐시 입력은 95% 할인됩니다.
77.9%
DeepSWE v1.1
Google이 보고한 점수로, Claude Opus 5.5와 GPT-6 Astra를 앞섭니다.
15%
환각률
Artificial Analysis가 측정한 프론티어 모델 가운데 가장 낮은 수치입니다.

이 페이지의 도판과 차트는 이를 공개한 기관인 Google, Arena.ai, Artificial Analysis에서 가져온 것이며, 원본 그대로 실었습니다.

출시 현황

Argon은 아직 일반 공개되지 않았습니다. 공개 순서는 다음과 같습니다.

Google은 Argon을 단계적으로 공개하고 있으며, 첫 단계는 일반 사용자를 위한 것이 아닙니다. Felo 내 접근도 이 일정에 맞춰 준비하고 있습니다.

현재 이용 가능

신뢰받는 사이버 방어 담당자

Google Fairwind 프로그램에서 선정된 파트너가 Argon을 가장 먼저 받습니다. 사이버 안전장치 없이 제공됩니다.

다음 발표 예정

유료 API 고객과 Google AI Ultra

Google은 더 넓은 접근이 여기서 시작된다고 밝혔습니다. 날짜는 나오지 않았고, 지금은 구독만으로는 이용할 수 없습니다.

일정 미정

개발자, 기업, 일반 사용자

유료 단계 뒤에 이어집니다. Google은 일반 공개 시점을 확정하지 않았습니다.

Felo 검색에서의 Argon 지원은 준비 중입니다. 열리는 대로 이 페이지를 업데이트하겠습니다.

잘하는 것

빠른 답변이 아니라 긴 작업을 끝내기 위해 만든 모델

Argon이 공개한 강점은 읽기, 추론, 장문 쓰기에 모여 있습니다. 코딩을 앞세운 프론티어 모델과는 결이 다릅니다.

긴 작업에서 흔들리지 않는 추론

Google은 Argon을 몇 시간씩 이어지는 다단계 작업에 맞춘 모델로 위치시킵니다. 이전 모델들은 이런 작업에서 방향을 잃거나 일찍 멈추곤 했습니다.

1M 토큰을 한 번에 출력

Google이 밝힌 상향 이유는, 생각할 여유가 있는 모델은 여러 번 주고받지 않고 한 번의 흐름으로 어려운 문제를 풀 수 있다는 것입니다.

코딩이 아니라 지식 작업에서 앞섭니다

가장 격차가 큰 항목은 Harvey's Legal Agent Benchmark와 Vals Finance Agent v2입니다. 합성 과제가 아니라 실제 법률·재무 분석입니다.

버티는 장문맥 검색

256K에서 1M에 이르는 컨텍스트를 실제로 쓸 수 있는지 측정하는 GraphWalks에서, Google은 다른 플래그십보다 10점 이상 앞선다고 보고했습니다.

긴 영상 이해

긴 영상 이해력을 측정하는 LVBench는 91.7%로, Google이 Argon에 대해 제시한 가장 높은 점수입니다.
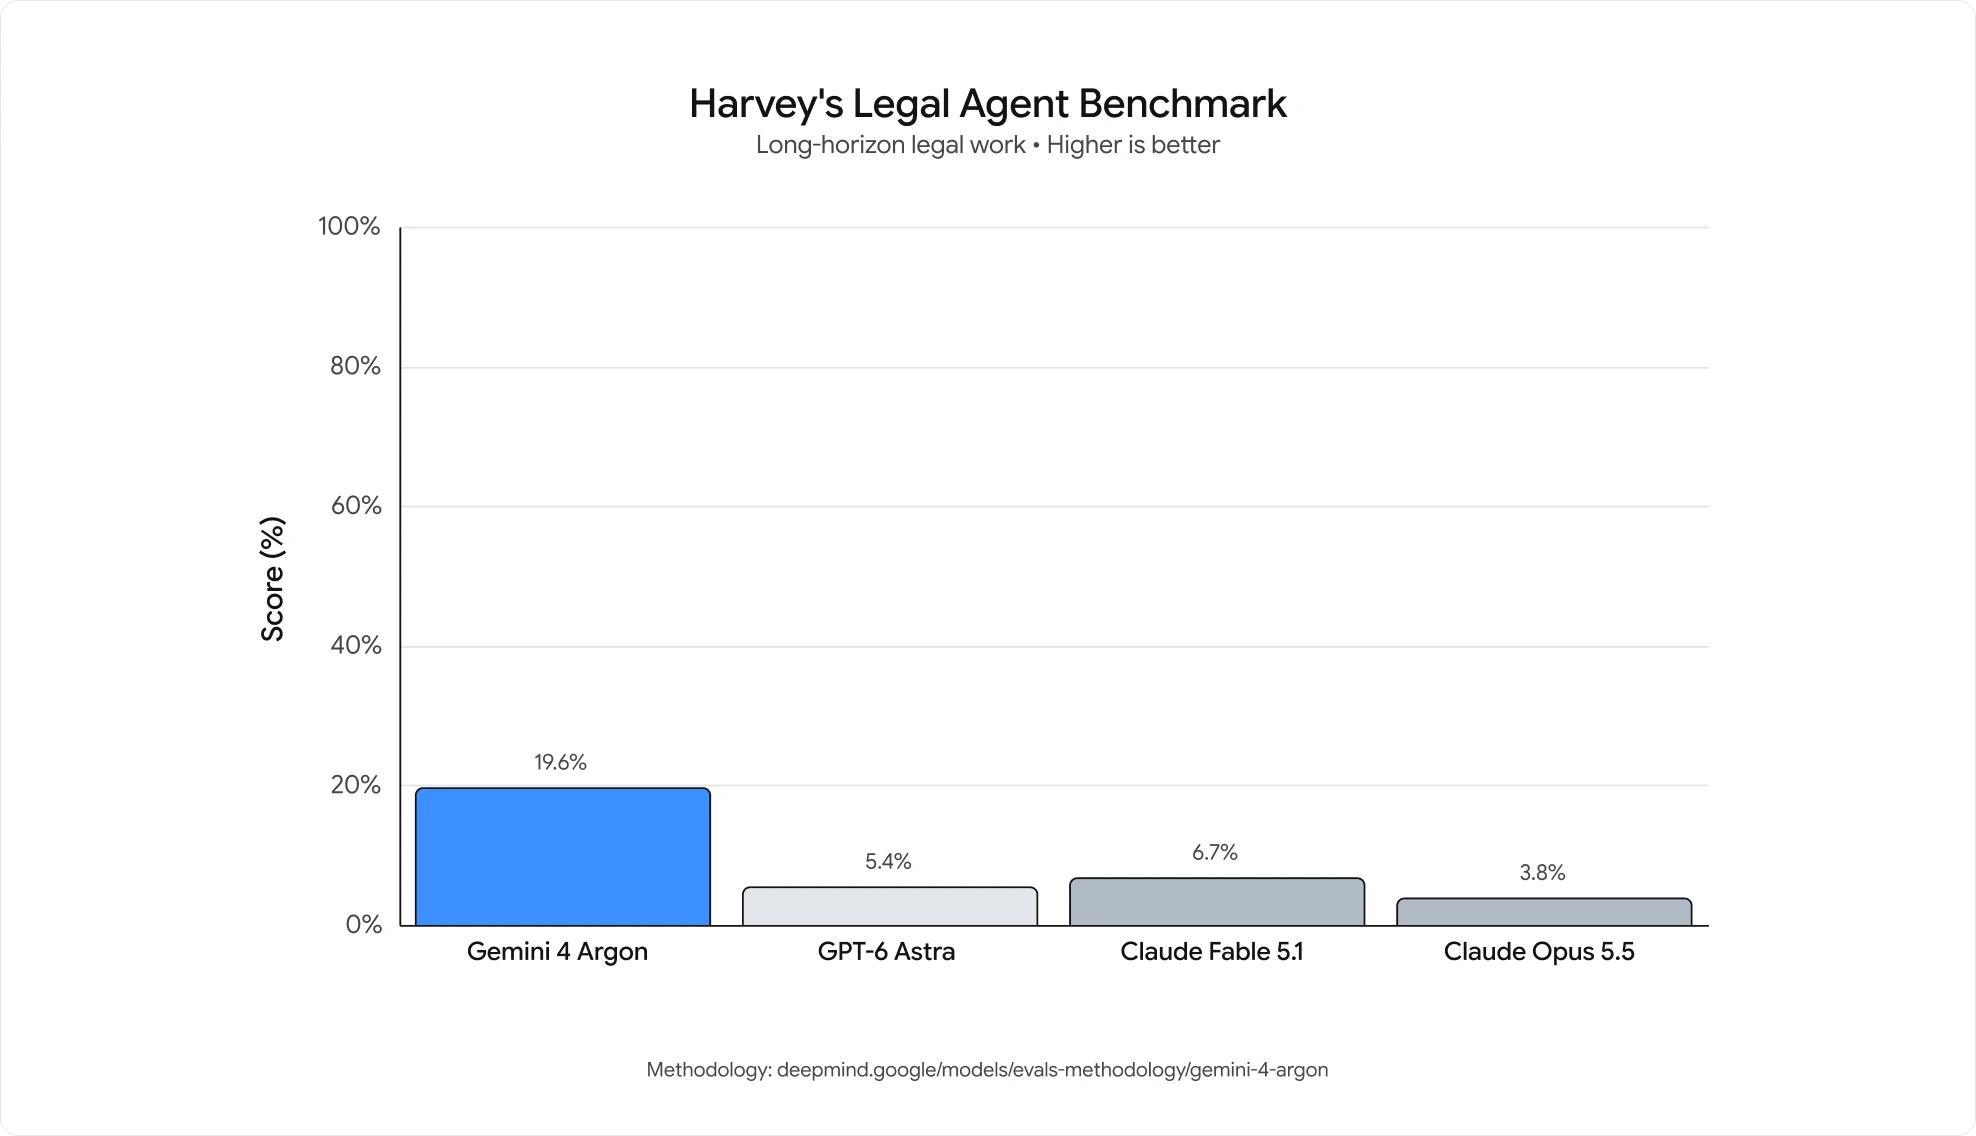
Harvey's Legal Agent Benchmark 막대 차트: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
장시간에 걸친 법률 업무. Argon의 19.6%는 두 번째 모델의 약 세 배이며, Google이 공개한 가운데 가장 큰 격차입니다.
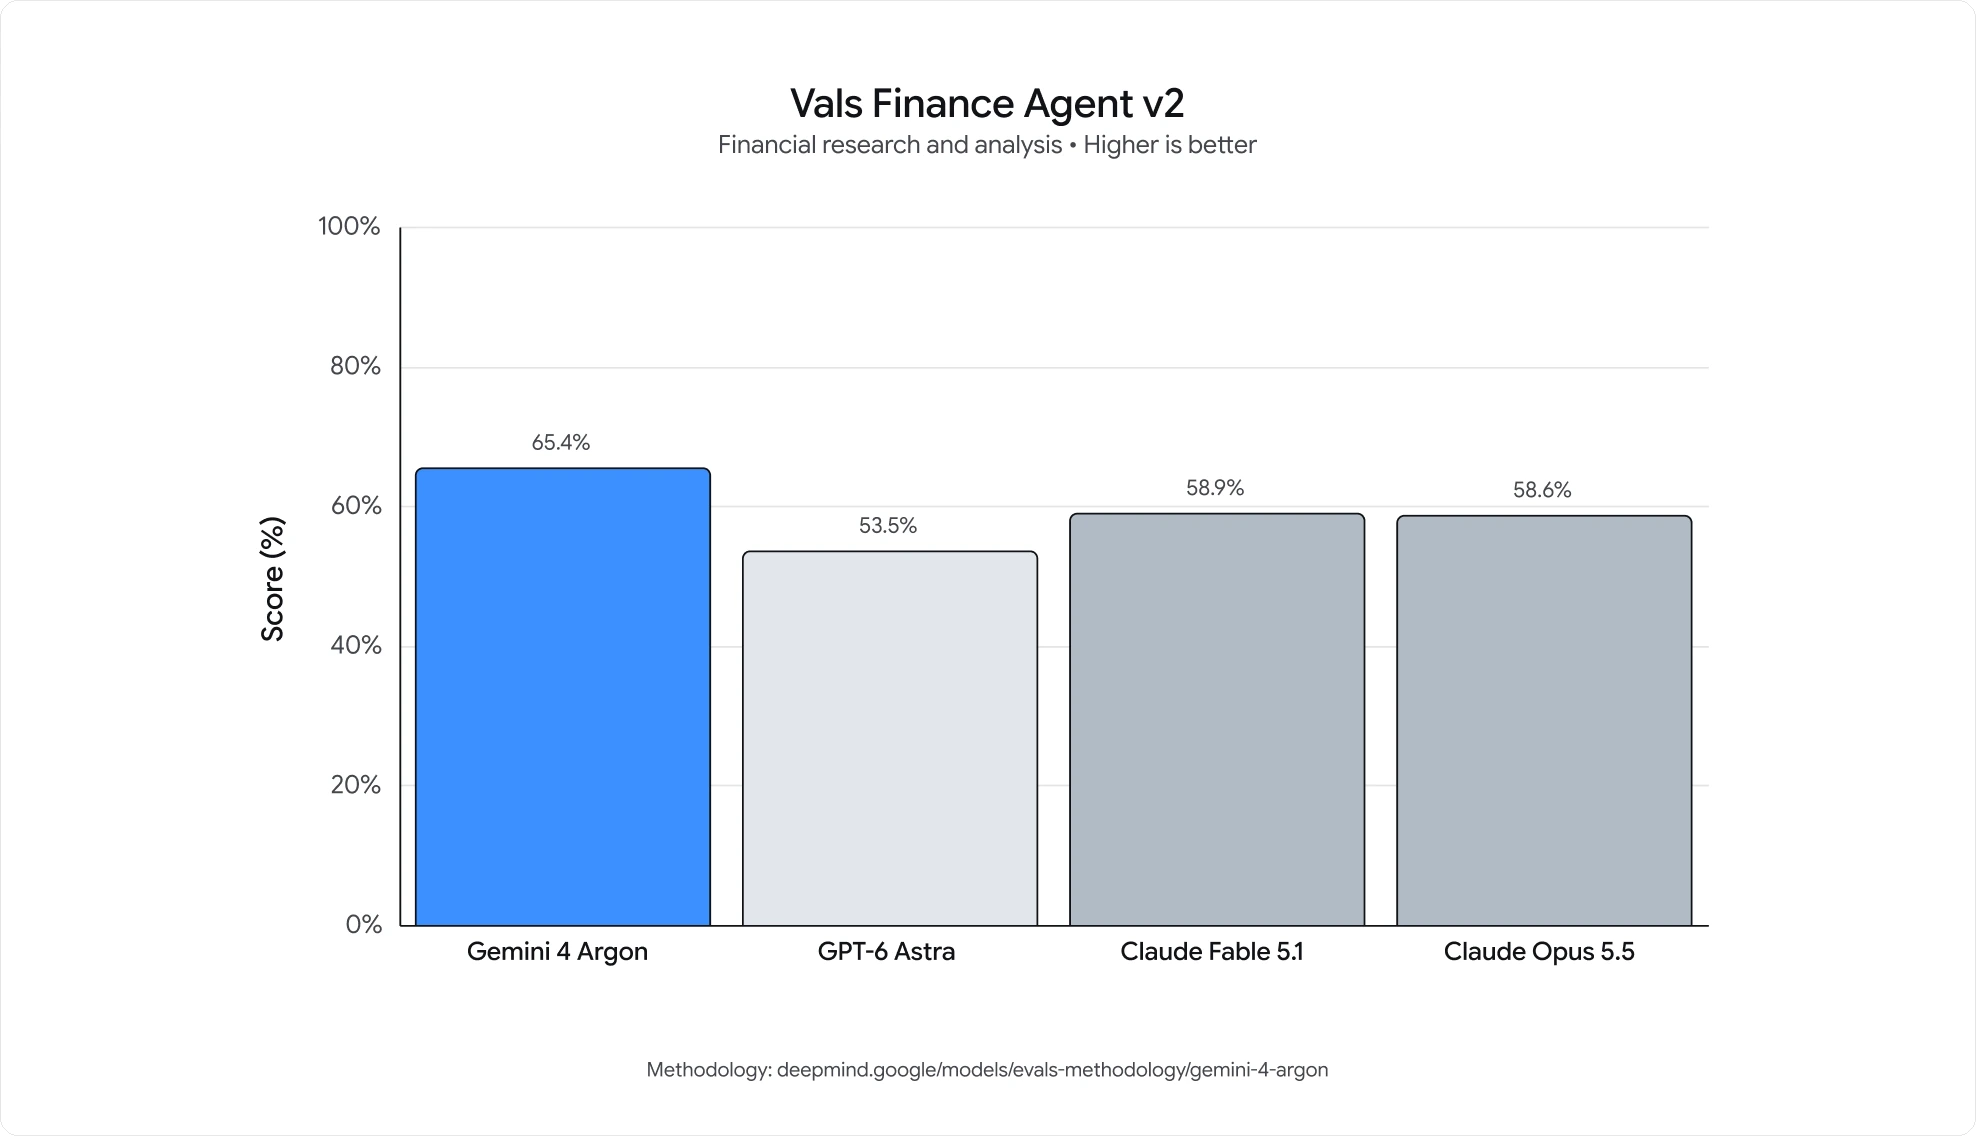
Vals Finance Agent v2 막대 차트: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
재무 리서치와 분석으로, 65.4% 대 53.5~58.9%의 구도입니다. 법률 업무보다 격차는 좁지만 순위는 같습니다.

공개된 수치

Google 자체 벤치마크에서 Argon의 위치

모두 벤더가 보고한 결과입니다. Google은 대표 점수에 적용한 사고 설정이나 effort 설정을 밝히지 않았고, 독립 연구소의 재현도 아직 없습니다.

벤치마크
측정 내용
Argon
가장 가까운 비교
DeepSWE v1.1
장기간에 걸친 소프트웨어 엔지니어링
77.9%
Opus 5.5 74.2%, GPT-6 Astra 74.1%
CWE-bench v1
취약점 발견과 패치
68%
공동 1위
AutomationBench
Zapier가 만든 엔드투엔드 업무 과제
51.3%
1위
LVBench
긴 영상 이해
91.7%
Google이 Argon에 대해 보고한 최고 점수

방향을 보여주는 수치로 받아들이세요. 벤더 벤치마크가 실제 운영 워크로드에서 그대로 유지되는 경우는 드물며, 벤치마크 우위가 실무로 이어지는지 Google 직원 일부도 회의적이라고 Bloomberg가 보도했습니다.
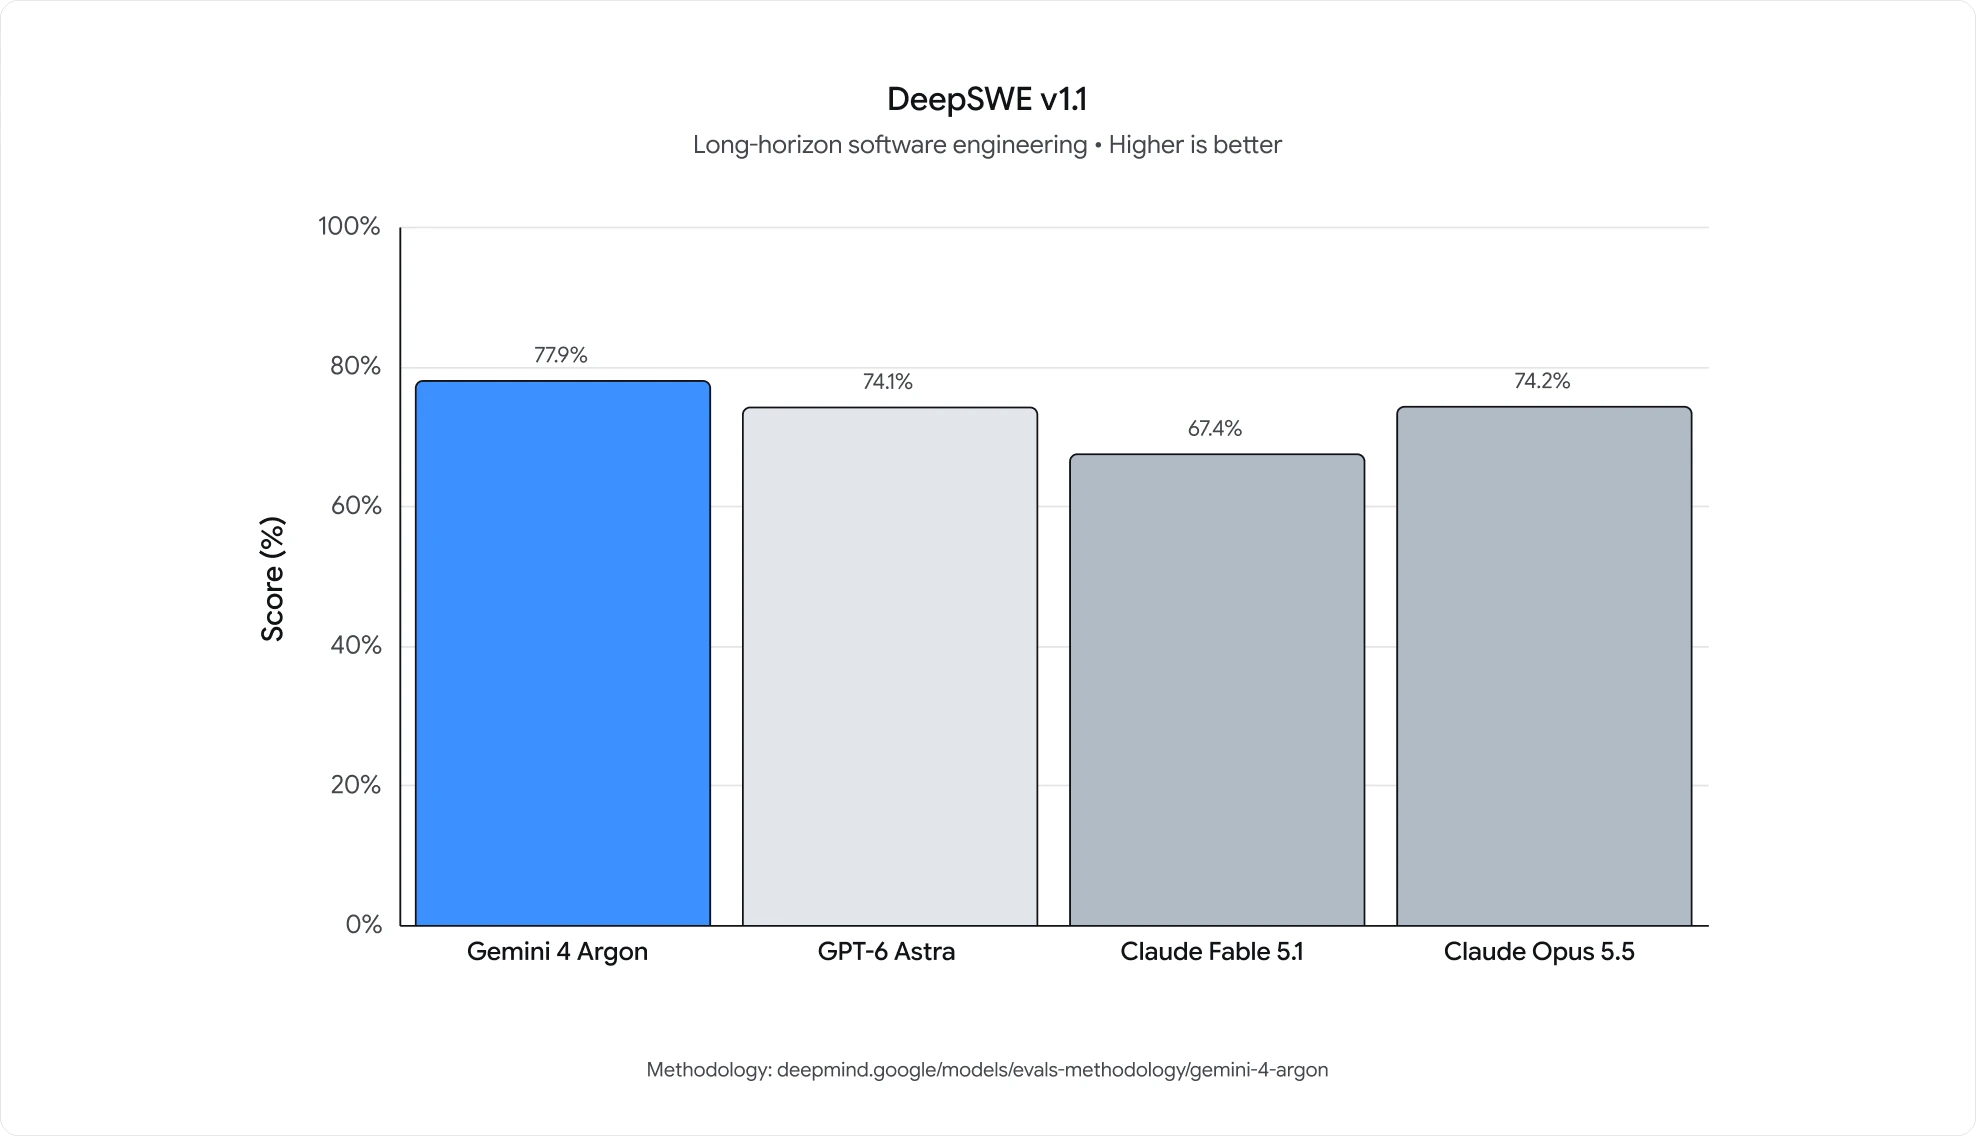
DeepSWE v1.1 막대 차트: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
장기간에 걸친 소프트웨어 엔지니어링. 대표 점수 77.9%에 가장 가까운 두 경쟁 모델이 모두 4점 이내로 따라붙었습니다.
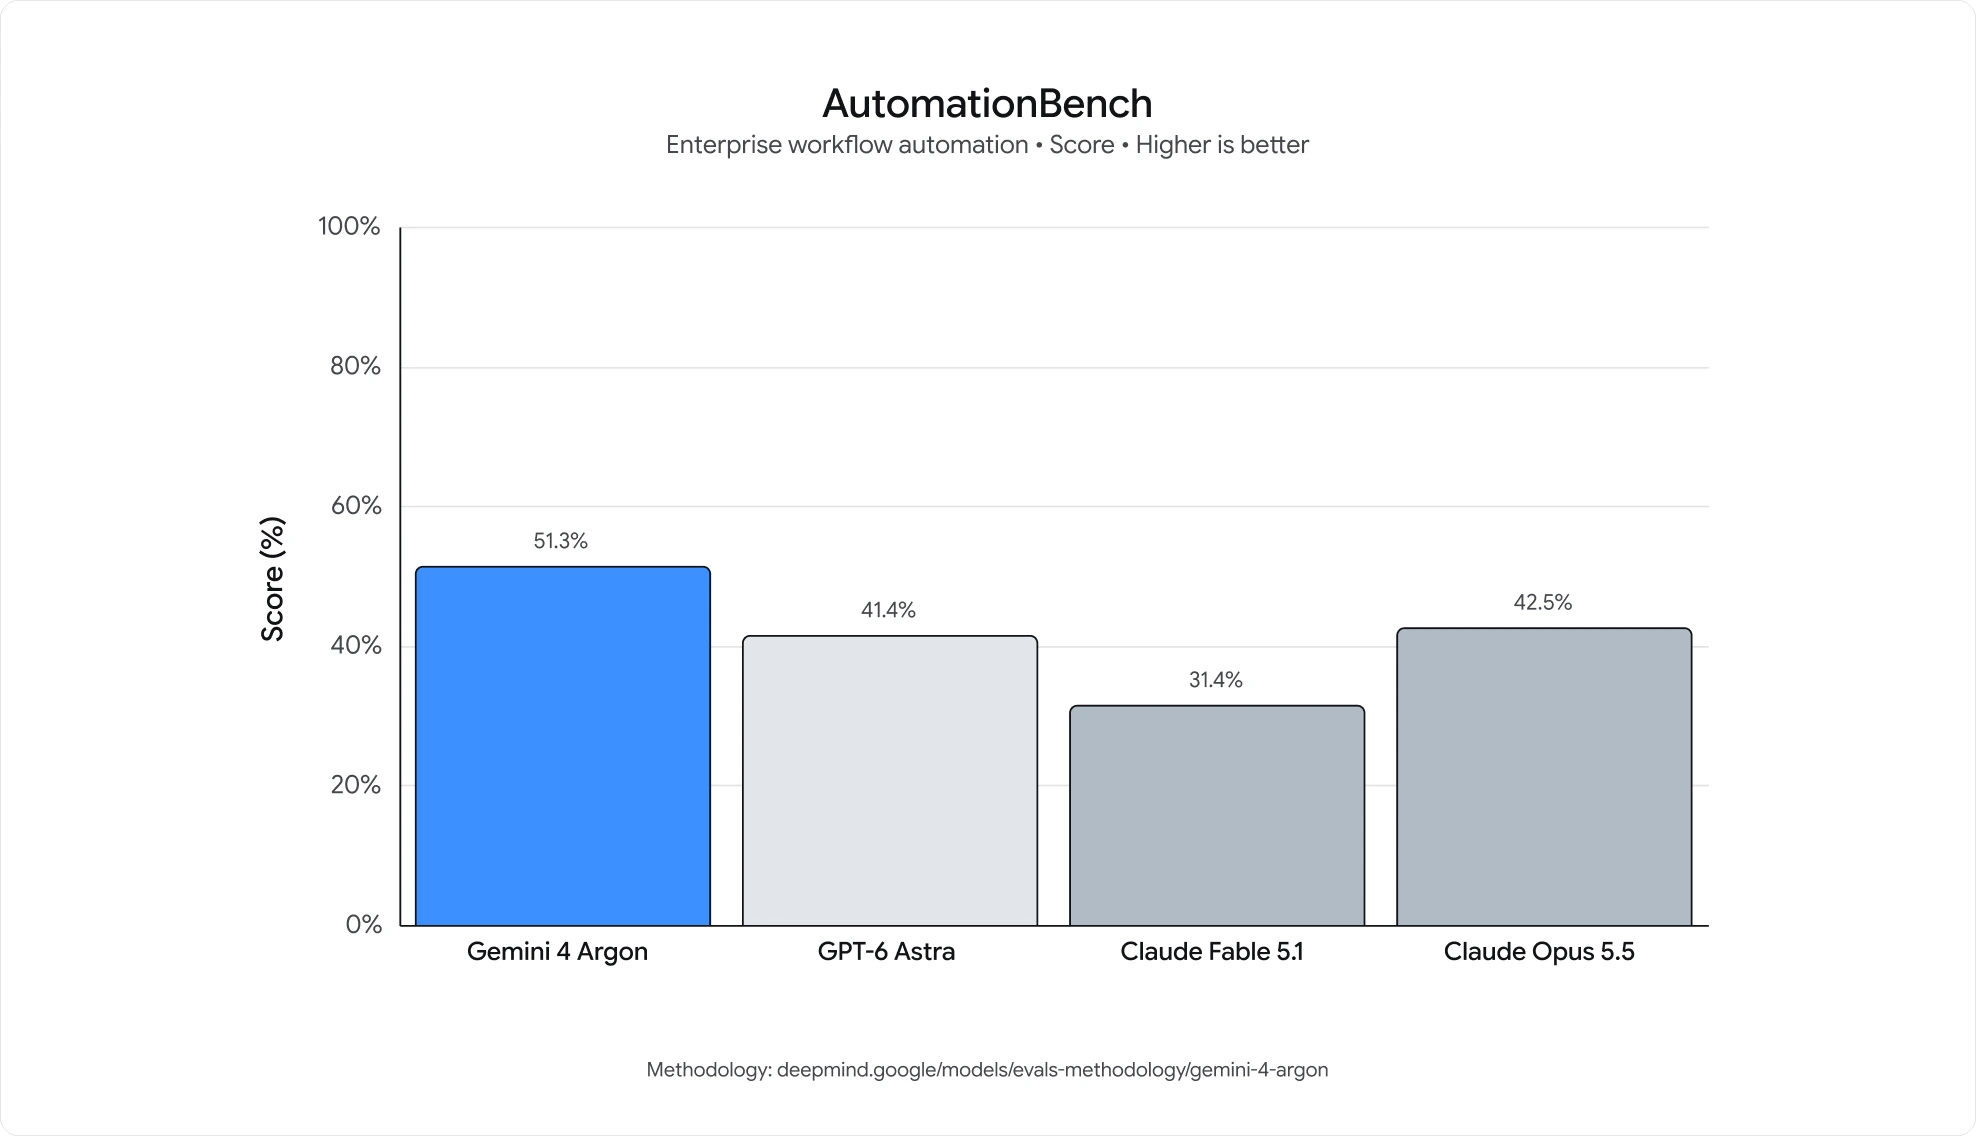
AutomationBench 막대 차트: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
Zapier가 만든 엔드투엔드 업무 과제. Argon만 50%를 넘었고, 비교에 들어간 나머지 모델은 모두 30%대이거나 40%대 초반입니다.
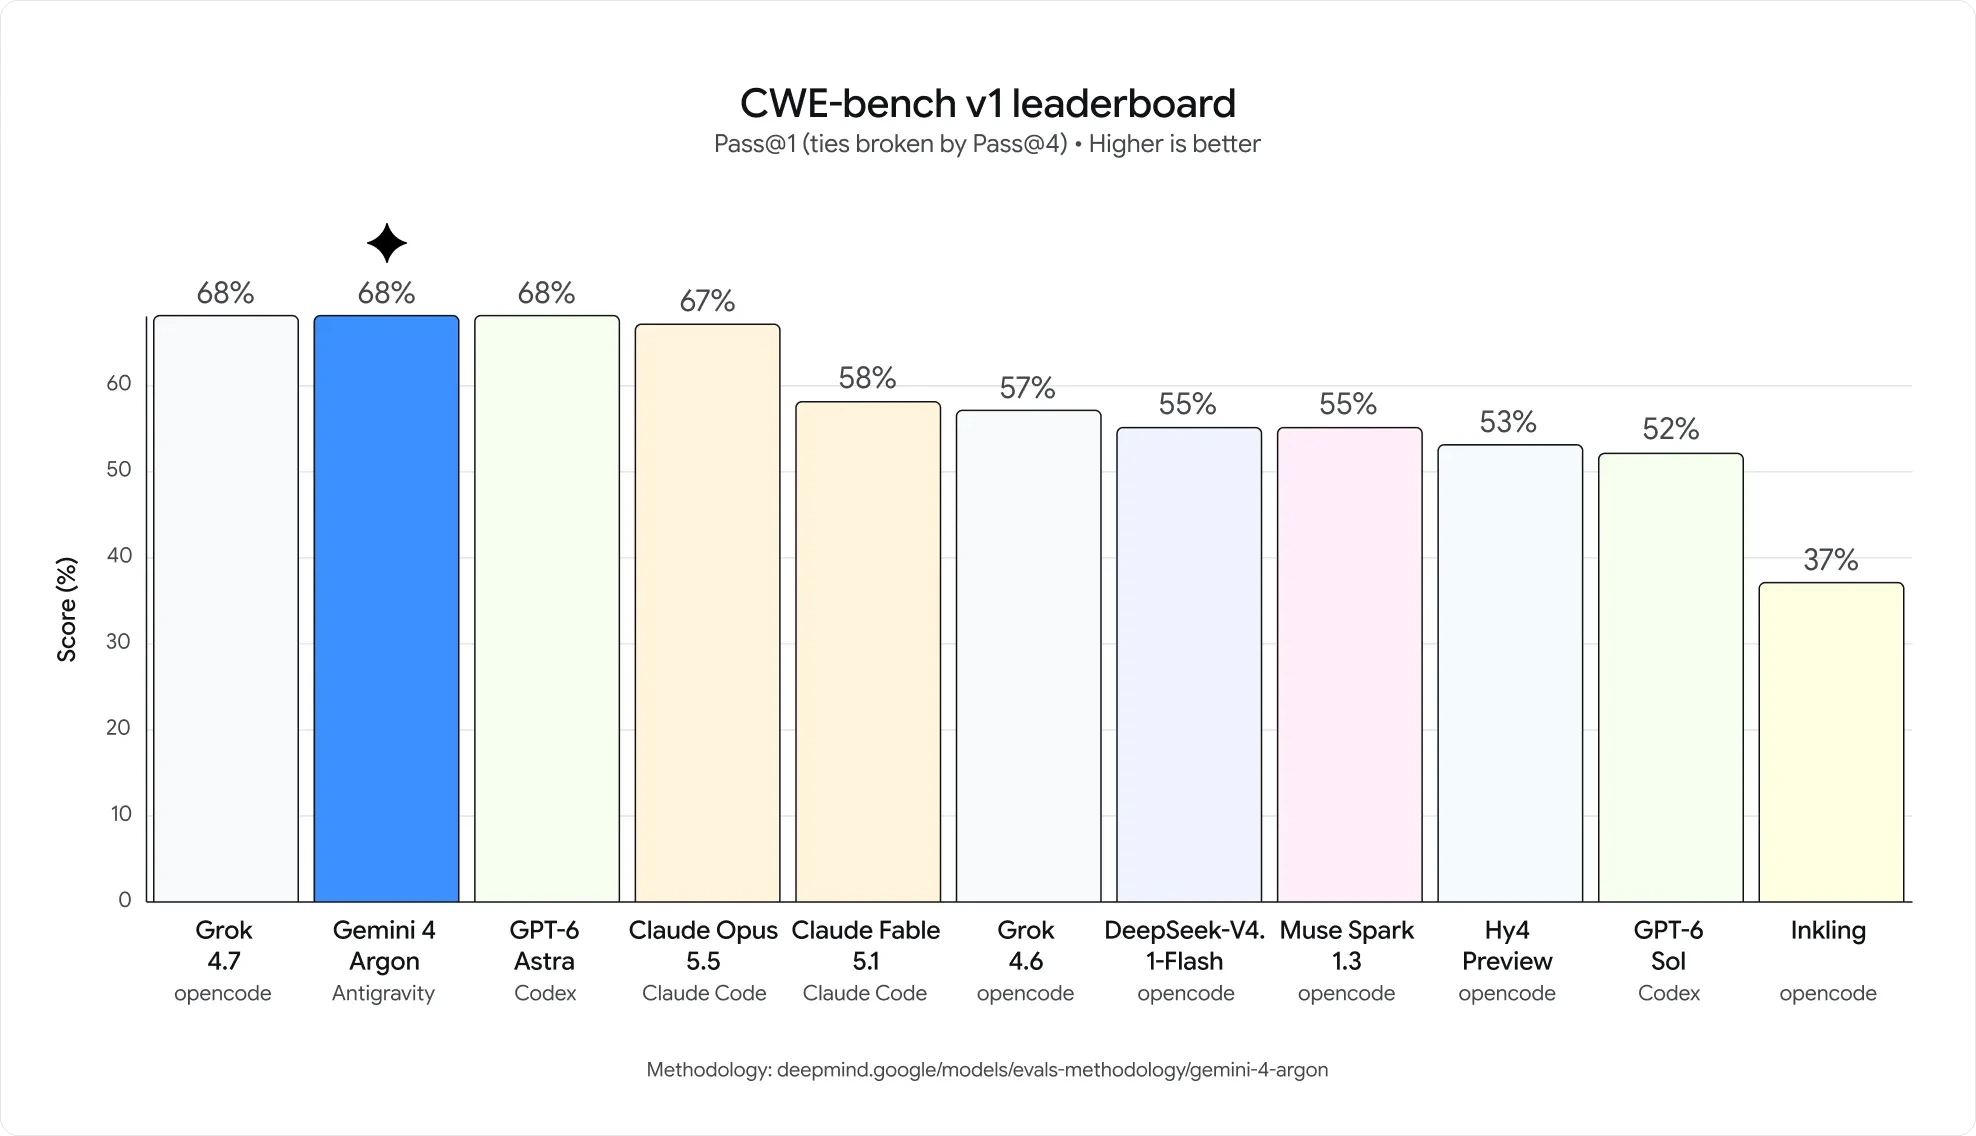
CWE-bench v1 리더보드: Gemini 4 Argon, Grok, GPT-6 Astra가 68%로 공동 선두, Claude Opus 5.5가 67%, 아래로 갈수록 낮아져 Inkling이 37%
Pass@1 기준 취약점 발견. Argon은 격차를 벌린 것이 아니라 빽빽한 상위권에서 공동 선두에 올랐습니다. 위 표에서 '공동 1위'로 적은 이유가 여기에 있습니다.
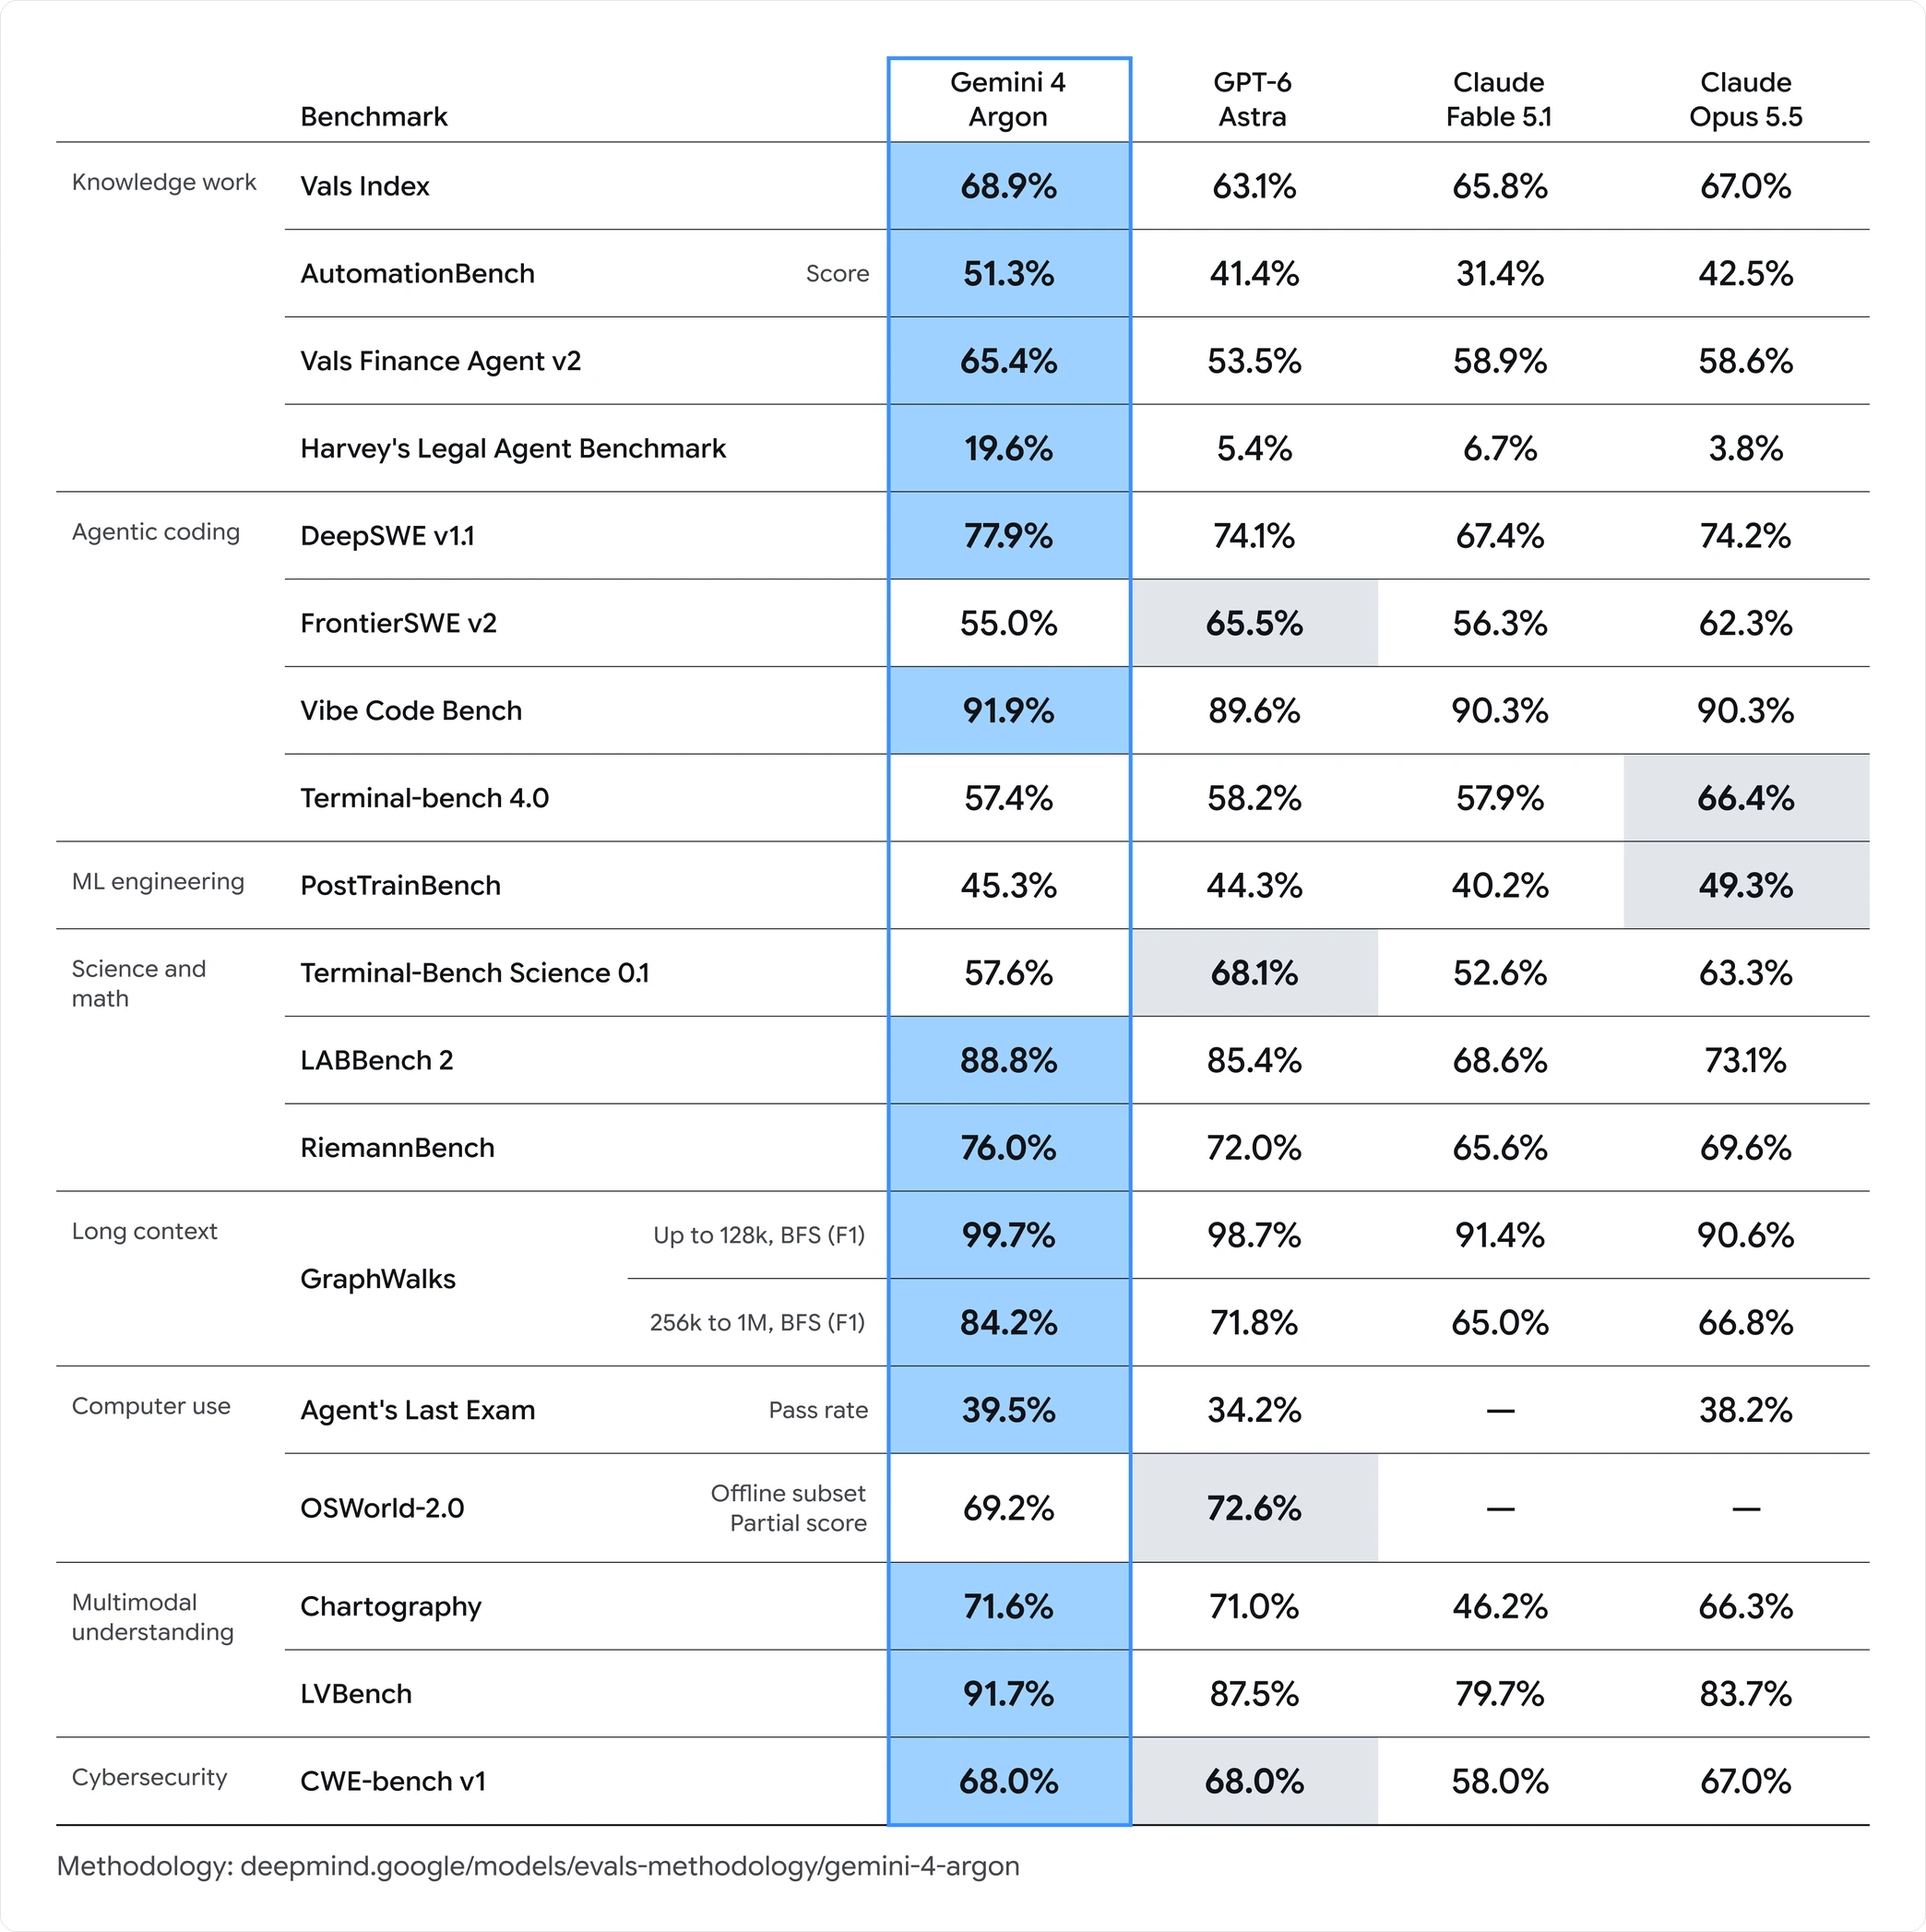
16개 벤치마크에 걸친 Gemini 4 Argon의 Google 전체 결과 표로, 지식 작업, 에이전트 코딩, ML 엔지니어링, 과학과 수학, 장문맥, 컴퓨터 사용, 멀티모달 이해, 사이버보안으로 묶여 있다
발표 자료에 실린 전체 표로, Argon이 앞선 칸은 파란색, 경쟁 모델이 앞선 칸은 회색입니다. Argon이 선두가 아닌 행은 FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1, OSWorld-2.0입니다.
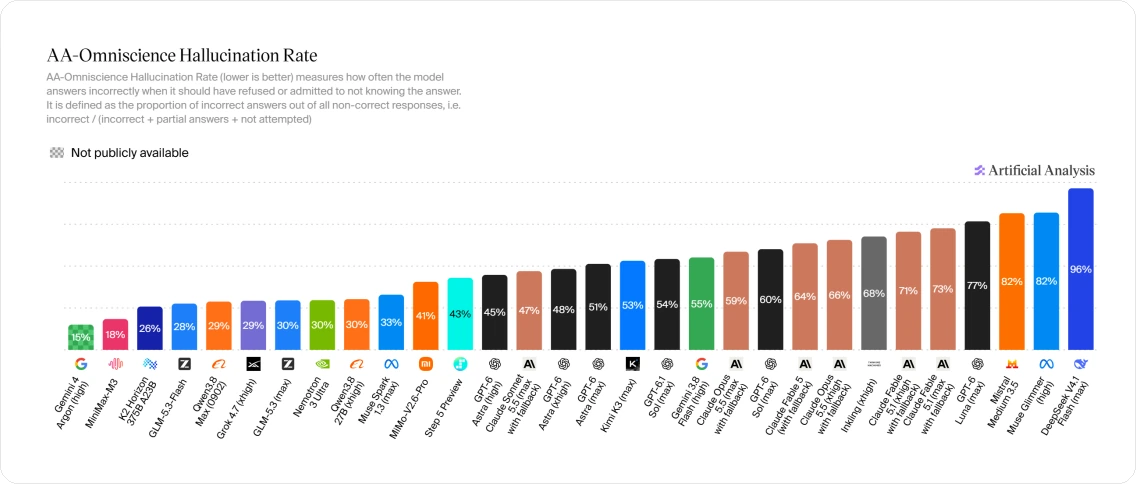
Artificial Analysis의 AA-Omniscience 환각률을 36개 모델에 대해 나타낸 막대 차트로, 낮은 순으로 정렬되어 있습니다: Gemini 4 Argon(High) 15%, MiniMax-M3 18%, Kimi K2.5 26%, 마지막으로 DeepSeek-V4 Flash 96%까지 올라갑니다
Artificial Analysis의 독립적인 측정치이자, 이 페이지에서 벤더가 제공하지 않은 유일한 수치입니다. 각 모델이 답변을 피하는 대신 얼마나 자주 틀린 답을 내놓는지를 보여주며, Argon의 15%는 그래프에 실린 36개 모델 가운데 가장 낮고 눈금은 96%까지 이어집니다.
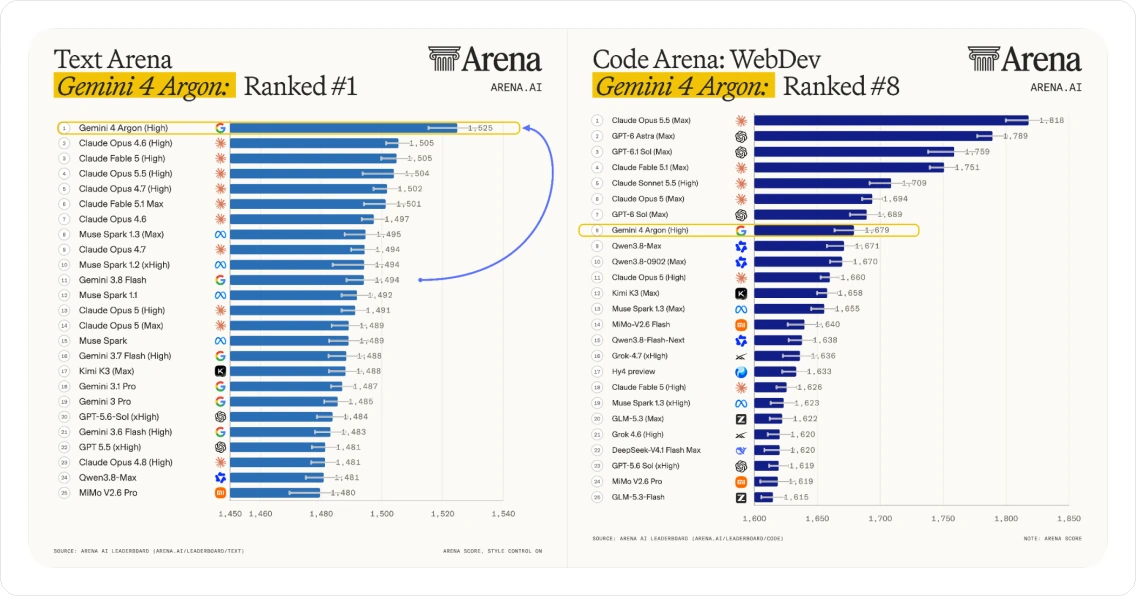
Arena.ai의 Text Arena와 Code Arena: WebDev 리더보드를 나란히 놓은 이미지: Gemini 4 Argon은 Text Arena에서 1,625로 1위, Code Arena: WebDev에서 1,679로 8위
위 문단이 근거로 삼은 두 순위로, Arena.ai의 투표 순위에서 나온 것입니다. Argon은 Text Arena에 오른 25개 모델 가운데 정상이고, Code Arena: WebDev에서는 8위로, Claude 모델 4개와 OpenAI GPT-6 계열 3개에 뒤처집니다.

Felo에서

1M 토큰을 쓰는 모델과 함께라면 리서치 흐름은 어떻게 달라질까

Felo는 검색과 문서 이해를 함께 다루기 때문에, 길게 출력하는 모델은 한 세션에서 만들 수 있는 결과물을 바꿉니다.

문서로 끝나는 리서치

자료를 모은 뒤, 여러 프롬프트로 나눠 조립하지 않고 모델이 한 번에 종합을 써 내려가게 합니다.

문서 묶음 전체를 한 작업으로

장문맥 검색은 Argon이 가장 강한 능력이며, 계약서 묶음과 공시 자료, 긴 보고서를 다룰 수 있게 하는 힘입니다.

어조가 중요한 초안 작성

텍스트는 강하고 코딩은 중간이라는 Argon의 공개된 특성은, 조립한 글이 아니라 쓴 글처럼 읽히는 문장이 필요한 팀에 맞습니다.

비용

Argon의 가격, 그리고 나중에 바뀌는 것

Google은 도입 가격과 더 높은 정가를 공개했지만 전환 시점은 밝히지 않았습니다. 예산은 높은 쪽 숫자로 잡으세요.

토큰 유형
도입 가격
이후
입력
$2.00 / 백만 토큰
$4.00 / 백만 토큰
캐시 입력
95% 할인
95% 할인
출력
$10.00 / 백만 토큰
$20.00 / 백만 토큰

비교하자면 도입 가격은 GPT-6.1 Sol, Sonnet 5.5와 거의 같은 수준이고 GPT-6 Astra의 약 5분의 1입니다. 모두 정가이며 작업당 실측 비용이 아닙니다. Argon은 더 어려운 질문을 다루므로 한 번 실행이 더 비쌀 수 있습니다.

Felo에서 Argon을 쓰는 방법

01

질문을 통째로 가져오기

요약본이 아니라 문서 묶음이나 긴 스레드를 그대로 Felo에 넣으세요. 프롬프트에 담기지 않기 시작하는 지점부터 Argon의 강점이 살아납니다.

02

완성된 결과물을 요청하기

1M 토큰 출력 상한이 있으면 전체 보고서나 완성된 초안을 섹션으로 나누지 않고 한 번의 지시로 요청할 수 있습니다.

03

출처와 대조해 확인하기

Felo는 답변 옆에 인용을 남겨 둡니다. 모델이 만든 긴 문서를 검토할 수 있는 이유입니다.

Felo 검색에서의 Argon 지원은 준비 중입니다. 열리기 전까지는 Felo 라인업의 다른 모든 모델을 지금 사용할 수 있습니다.

Felo AI 검색 열기

Gemini 4 Argon 자주 묻는 질문

일반적으로는 아직 쓸 수 없습니다. Google은 Argon을 Fairwind 프로그램에서 선정된 파트너에게 먼저 공개했고, 더 넓은 접근은 유료 API 고객과 Google AI Ultra 구독자부터 시작한다고 밝혔습니다. 그 단계의 날짜는 발표되지 않았고, 현재는 유료 구독만으로는 이용할 수 없습니다.

Felo에서 Google의 프론티어 모델을 사용해 보세요

작업에 맞는 모델로 검색하고 읽고 쓰세요. Argon도 출시가 Felo에 닿는 대로 라인업에 합류합니다.

Felo AI 검색 열기

Felo AI 검색은 신용카드 없이 사용할 수 있습니다.