01
Utrzymać cały kontekst
Okno kontekstu miliona tokenów i wiedza do czerwca 2026 roku. Długi wątek, całe repozytorium albo zestaw dokumentów mieszczą się w jednym zadaniu.
Anthropic opublikowała Opus 5.5 22 września 2026 roku
Pierwszy model z rodziny Claude 5.5. Osiąga poziom Claude Fable 5.1 w większości zadań, kosztuje o 40% mniej w eksploatacji niż Opus 5 i generuje odpowiedź ponad 30% szybciej.
Dostępny w wyszukiwaniu Felo
Claude Opus 5.5 jest dostępny w wyszukiwaniu Felo przy zadaniach z długim wejściem: uzgadnianie liczb między plikami, prześledzenie twierdzenia do źródła i zwrócenie odpowiedzi, którą można komuś przekazać.
01
Okno kontekstu miliona tokenów i wiedza do czerwca 2026 roku. Długi wątek, całe repozytorium albo zestaw dokumentów mieszczą się w jednym zadaniu.
02
W wewnętrznym teście Anthropic 16 z 18 raportów przeszło próg jakości. Jedna wymyślona liczba lub cytat wystarczyłyby, by całe zadanie przepadło.
03
Anthropic przeprojektowała sposób komunikacji modelu: najważniejsze informacje są na początku, a raport wprost mówi, co gotowe, co ustalono i co pozostaje otwarte.
Krótka instrukcja
Claude Opus 5.5 pojawia się w wyborze modelu obok innych wiodących modeli na twoim koncie.
Czym różni się Opus 5.5
Anthropic stawia na wydajność, a nie na wyższy wynik w benchmarku: mniej tokenów na zadanie, niższa cena za token i o 40% niższy koszt przy typowych obciążeniach. Właśnie to sprawia, że długotrwała praca agenta staje się opłacalna.
01
Anthropic podaje, że jeden z pierwszych testerów przeaudytował i naprawił bazę kodu o 200 000 linii w niecałe trzy godziny, podczas gdy Opus 5 potrzebował ponad 20 godzin i 2,5 raza więcej tokenów.
02
Deloitte podaje, że nawet na najniższym poziomie effort Opus 5.5 wykrył 72% znanych błędów w przeglądzie kodu, wobec 56% dla Opus 5 na high, przy mniejszej liczbie fałszywych alarmów.
03
Teksty są krótsze i lepiej ustrukturyzowane. Box podaje odpowiedzi o 40% mniej rozwlekłe bez utraty dokładności i przy jednej trzeciej tokenów Opus 5.
Wybór modelu
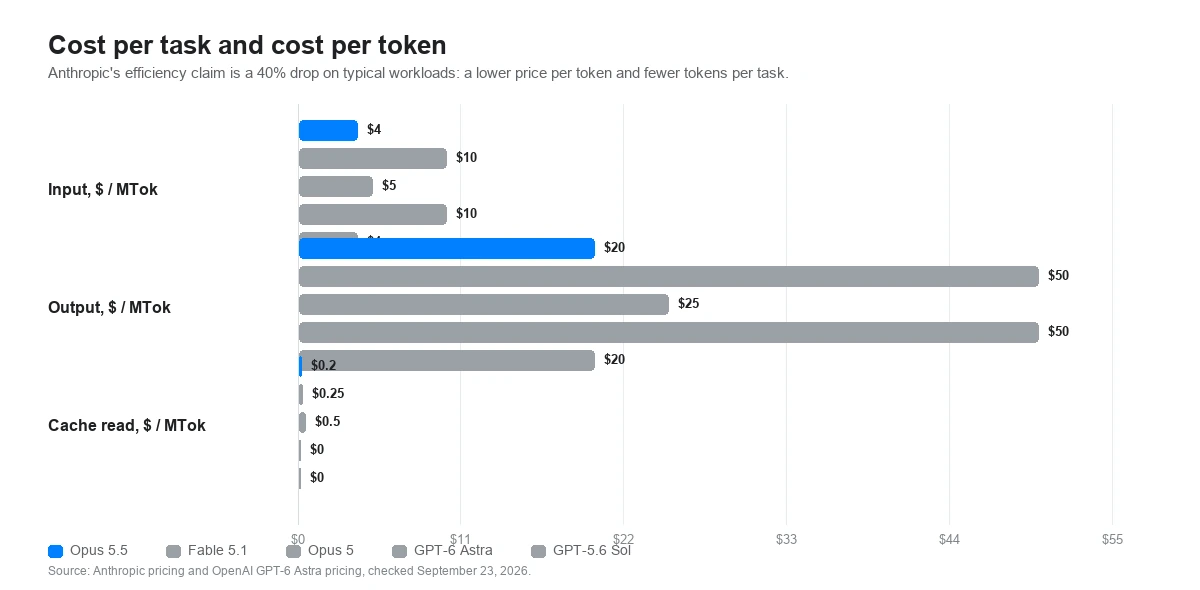
Poniższe ceny to oficjalne publiczne stawki API za milion tokenów, a nie ceny subskrypcji ani użycia w Felo. Wiersz effort jest tak samo ważny jak wiersz ceny: ten sam prompt może kosztować bardzo różnie w zależności od tego, z jakiego poziomu startuje model.
Publiczne stawki API i wartości domyślne sprawdzono 23 września 2026 roku w ogłoszeniu Claude Opus 5.5 od Anthropic, na stronach modeli Claude Platform i na stronie GPT-6 Astra od OpenAI. Cena za token to tylko część całkowitego kosztu zadania. Deklaracja wydajności Anthropic to spadek kosztów o 40% przy typowych obciążeniach, łączący niższą cenę za token z mniejszą liczbą tokenów na zadanie.
Wyniki opublikowane przez Anthropic
Anthropic opublikowała własne liczby obok Fable 5.1, Opus 5, GPT-6 Astra i GPT-5.6 Sol. Dwa z czterech wykresów poniżej pokazują dokładność względem kosztu zadania, a nie samą dokładność, bo właśnie takie porównanie robi Anthropic.
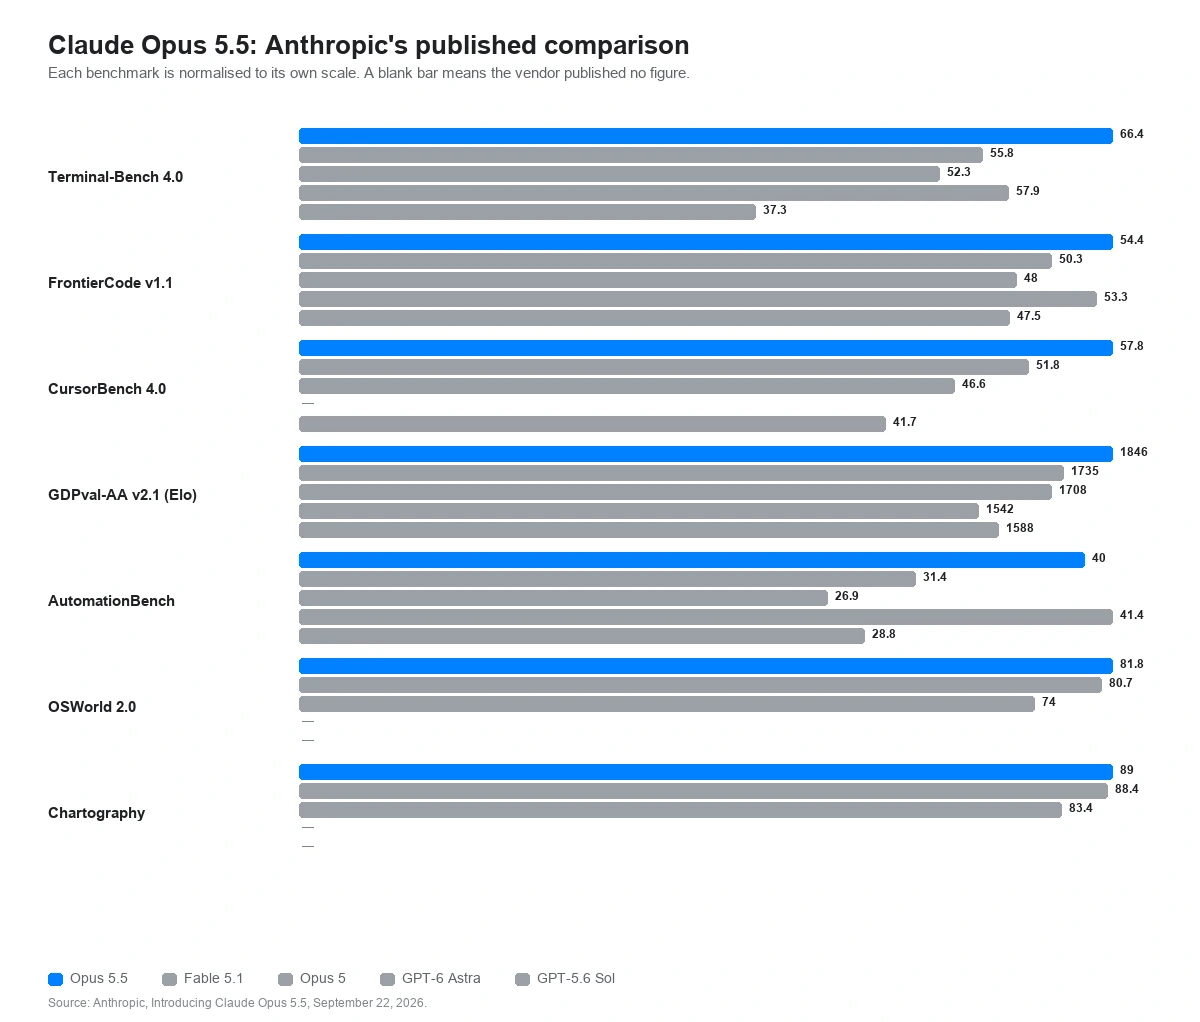
Pełne opublikowane porównanie
Kodowanie agentowe, praca z wiedzą, procesy biznesowe, rozumowanie interdyscyplinarne, badania naukowe, obsługa komputera i odczyt wykresów w pięciu zmierzonych modelach.
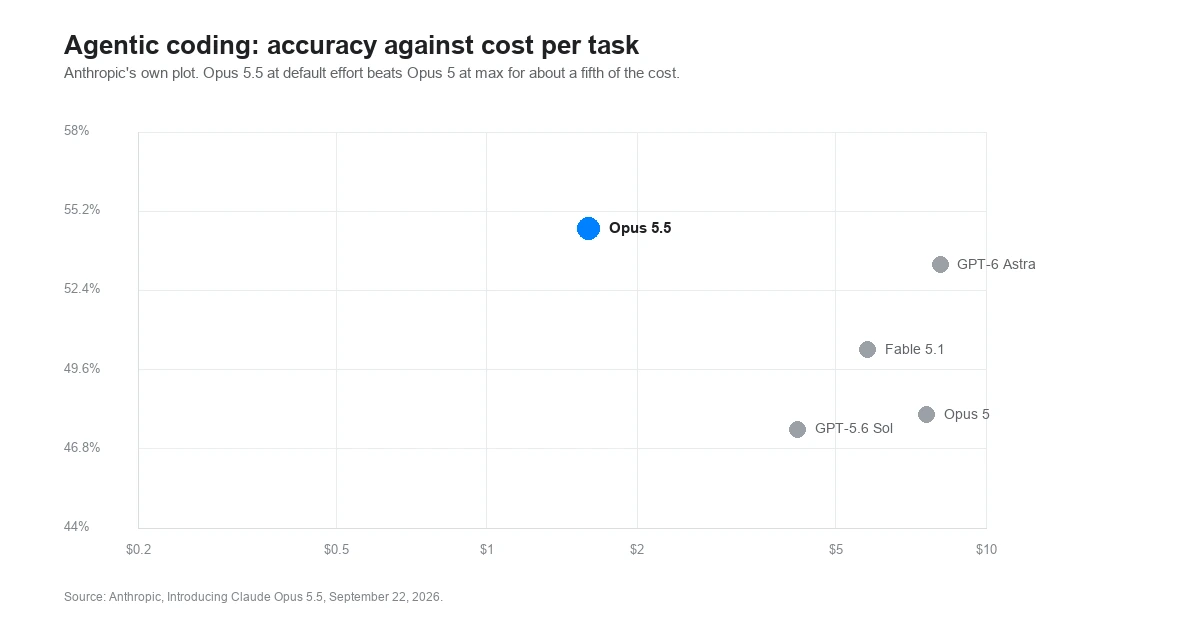
Kodowanie agentowe
Terminal-Bench 4.0, FrontierCode v1.1 i CursorBench 4.0 jako dokładność względem kosztu zadania.
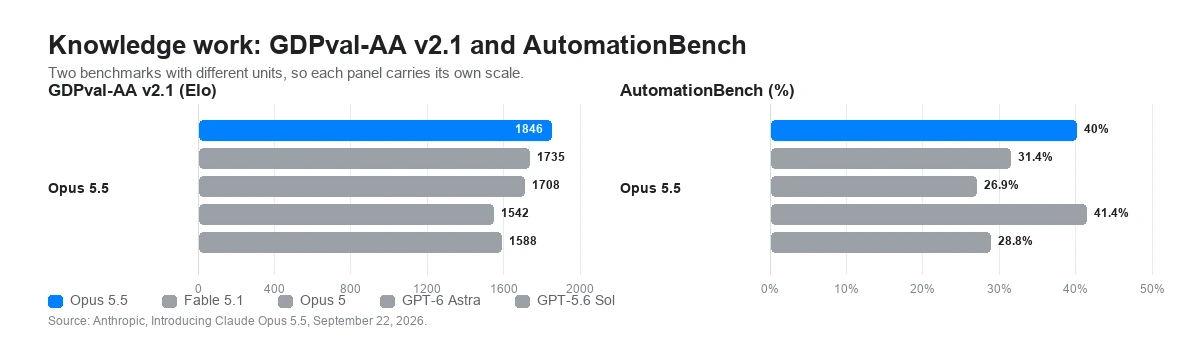
Praca z wiedzą
GDPval-AA v2.1 w 44 zawodach, AutomationBench i WANDR, benchmark zbierania danych od Perplexity.
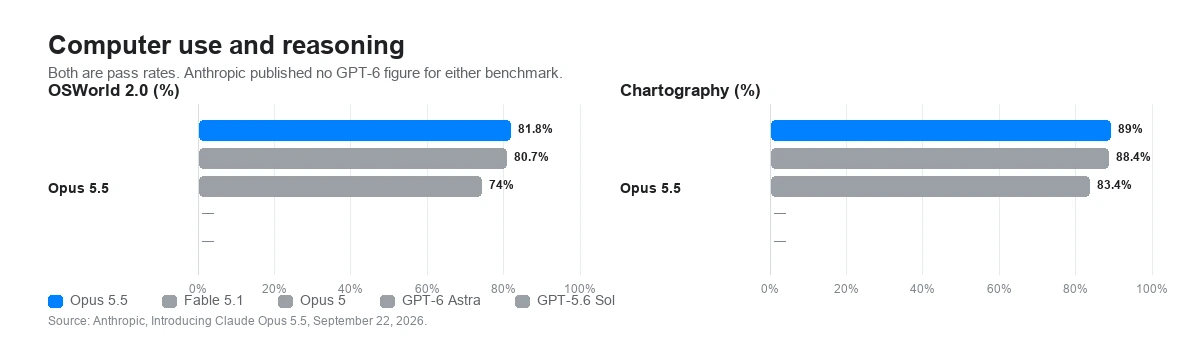
Obsługa komputera i rozumowanie
OSWorld 2.0, Humanity's Last Exam i Chartography, gdzie ostatni mierzy dokładność odczytu wartości z wykresu.
Dokładność względem kosztu zadania
Główna teza Anthropic to nie wyższy wynik za każdą cenę, lecz ten sam lub lepszy wynik za ułamek kosztu jednej próby.
Liczby opublikowane przez dostawcę. O ile nie zaznaczono inaczej, Anthropic uruchamiała Opus 5.5 z myśleniem adaptacyjnym na max effort i oceniała go z włączonymi zabezpieczeniami produkcyjnymi. Gdy zabezpieczenia interweniowały, zadania z cyberbezpieczeństwa kończył Opus 4.8, a z biologii Opus 5, co prawdopodobnie obniża opublikowane wyniki Opus 5.5 w tych benchmarkach. Liczby dla GPT-6 Astra i GPT-5.6 Sol pochodzą od OpenAI. Różnice w benchmarkach między dostawcami to słaba wskazówka co do rzeczywistych różnic, co sama Anthropic mówi o tych danych.
Jeśli już używasz Opus 5
Anthropic wymienia cztery zmiany niekompatybilne dla integracji działających już na Claude Opus 5, plus piątą, która zmienia kształt odpowiedzi, nie powodując błędu żądania. Warto je przeczytać przed podmianą identyfikatora modelu, bo trzy z nich zwracają błąd 400 zamiast cichej degradacji.
01
W Opus 5 myślenie można było wyłączyć na poziomie high i niżej. W Opus 5.5 jest zawsze włączone, a zarówno wyłączenie, jak i ręczny budżet tokenów zwracają błąd 400. Jedynym regulatorem staje się effort, a wartość domyślna zmienia się z high na medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice ustawione na "any" lub na konkretne narzędzie zwraca błąd 400, również w punkcie końcowym zliczania tokenów. Użyj auto razem ze ścisłym wywoływaniem narzędzi lub wyjściem strukturalnym i powiedz w prompcie, kiedy narzędzie ma zastosowanie.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Każdy blok myślenia zapisuje, który model go wytworzył. Opus 5.5 czyta bloki z Opus 5 oraz wcześniejszych modeli Opus, Sonnet i Haiku, ale nie z Fable ani Mythos. Jeśli router przeniesie rozmowę na inny model, kolejne tury przebiegną bez wcześniejszego rozumowania.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 zachowują myślenie; pozostałe modele je tracą
04
W Claude API i Google Cloud narzędzie computer_20251124 zwraca błąd 400. Zadeklaruj zamiast niego zestaw computer_toolset_20260801, usuń nagłówek beta i dostosuj pętlę agenta do bloków member tool_use. W Amazon Bedrock stare narzędzie nadal działa.
computer_20251124 -> computer_toolset_20260801
Skoro myślenia nie można wyłączyć, reguluje się effort. Opus 5.5 obsługuje wszystkie pięć poziomów i startuje z medium, o poziom niżej niż Opus 5. Anthropic zaleca ponowne przejście przez poziomy na własnych ewaluacjach zamiast przenoszenia ustawienia oraz ustawienie dużego max_tokens na wyższych poziomach, bo tokeny myślenia liczą się do tego limitu, nawet gdy tekst rozumowania nie jest zwracany.
Effort to sygnał behawioralny, a nie sztywny budżet tokenów: na niższym poziomie model nadal myśli nad naprawdę trudnymi problemami, tylko mniej niż na wyższym. Anthropic zauważa też, że na tym samym poziomie Opus 5.5 myśli więcej na turę niż Opus 5, zwłaszcza na xhigh i max, więc ustawienie przeniesione z Opus 5 da dłuższe i droższe tury.
Gdzie pasuje
Opus 5.5 się opłaca, gdy zadanie trwa godziny, obejmuje więcej plików, niż jedna osoba jest w stanie ogarnąć, albo daje wynik, który musi sprawdzić ktoś inny. To przypadki opisywane przez Anthropic i jej pierwszych testerów, a nie zwykłe prompty czatu.
Przeprowadzić zmianę przez duże repozytorium, aż przejdą testy, zamiast zatrzymywać się na pierwszej sensownej łatce. Anthropic podaje migrację 680 000 linii ukończoną przez jednego testera w niecały dzień.
Tester Anthropic o nazwie Column podał, że znalazł błąd, sprawdzając zewnętrzną dokumentację integracji zewnętrznej, którą kilka commitów wcześniej zamodelowano błędnie.
Zbudować model, a potem jednostronicowe podsumowanie, zachowując zastrzeżenia. Anthropic podaje analizę fuzji wykonaną w 63 minuty wobec 93 dla Opus 5, za połowę kosztu.
Model deleguje zadania subagentom i dopasowuje tempo do budżetu czasu. Anthropic zaleca przekazanie architekturze wieloagentowej sygnału upływu czasu, żeby równolegliła pracę zamiast ją szeregować.
01
Dodaj repozytorium, dokumenty i wymagania, które użyteczna odpowiedź musi uwzględnić. Okno miliona tokenów istnieje właśnie po to.
02
Powiedz, co musi być spełnione, żeby pracę uznać za skończoną. Rada Anthropic do pracy bez nadzoru to trzymanie części zadania na liście, którą model aktualizuje.
03
Uruchom to samo zadanie na Opus 5.5, Opus 5 i Fable 5.1 w Felo. Porównuj nie tylko odpowiedź, ale też testy, zastrzeżenia i zużycie tokenów.
Wybierz Claude Opus 5.5, gdy pojawi się w wyborze modeli na twoim koncie.
Wypróbuj Opus 5.5 w FeloClaude Opus 5.5 to model Anthropic do długotrwałego kodowania agentowego i pracy z wiedzą, opublikowany 22 września 2026 roku jako pierwszy model z rodziny Claude 5.5. Według Anthropic osiąga poziom Claude Fable 5.1 w większości zadań, a jego eksploatacja kosztuje o 40% mniej niż Claude Opus 5.
Postaw Claude Opus 5.5 obok innych wiodących modeli w Felo i sprawdź go na pracy, którą odkładasz, bo zajmuje godziny.
Wypróbuj Opus 5.5 w FeloZacznij od wyszukiwania Felo AI i wybierz model tam, gdzie jest dostępny.