01
Segurar todo o contexto
Janela de contexto de 1 milhão de tokens e conhecimento até junho de 2026. Uma conversa longa, um repositório inteiro ou um conjunto de documentos cabem em uma única tarefa.
A Anthropic lançou o Opus 5.5 em 22 de setembro de 2026
O primeiro modelo da família Claude 5.5. Alcança o nível do Claude Fable 5.1 na maior parte das tarefas, custa 40% menos para rodar que o Opus 5 e gera a saída mais de 30% mais rápido.
Agora na busca do Felo
O Claude Opus 5.5 está disponível na busca do Felo para tarefas com entradas longas: cruzar números entre arquivos, rastrear uma afirmação até a fonte e devolver uma resposta que você possa repassar.
01
Janela de contexto de 1 milhão de tokens e conhecimento até junho de 2026. Uma conversa longa, um repositório inteiro ou um conjunto de documentos cabem em uma única tarefa.
02
Em um teste interno da Anthropic, 16 de 18 relatórios passaram no critério de qualidade. Um único número ou citação inventados reprovariam o exercício.
03
A Anthropic refez a forma de o modelo se comunicar: o mais importante vem primeiro, e o relatório diz com clareza o que está pronto, o que foi encontrado e o que segue em aberto.
Passo a passo rápido
O Claude Opus 5.5 aparece no seletor de modelos ao lado dos outros modelos de ponta da sua conta.
A diferença do Opus 5.5
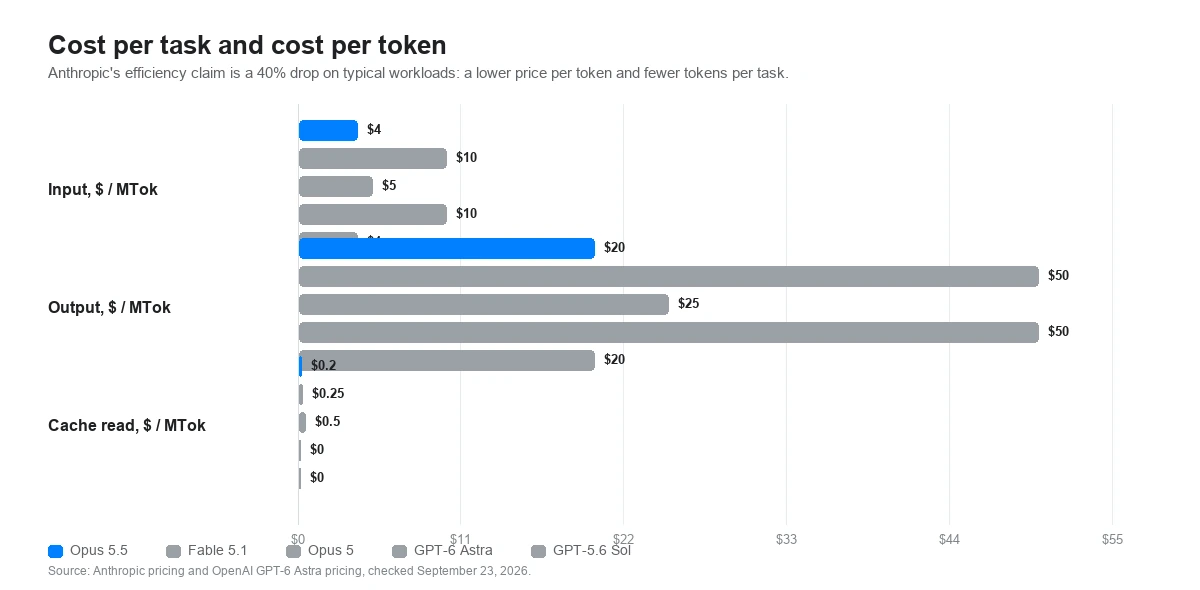
A Anthropic aposta em eficiência, não em uma pontuação maior de benchmark: menos tokens por tarefa, preço por token mais baixo e 40% menos custo em cargas de trabalho típicas. É isso que torna viável deixar um agente rodando por horas.
01
A Anthropic relata que um testador auditou e corrigiu uma base de 200 mil linhas em menos de três horas, enquanto o Opus 5 levava mais de 20 horas e consumia 2,5 vezes mais tokens.
02
A Deloitte relatou que, no nível de effort mais baixo, o Opus 5.5 encontrou 72% dos bugs conhecidos na revisão de código, contra 56% do Opus 5 em high, com menos falsos positivos.
03
Os textos são mais curtos e mais bem estruturados. A Box relatou respostas 40% menos prolixas sem perda de precisão e com um terço dos tokens do Opus 5.
Escolha do modelo
Os preços abaixo são tarifas públicas oficiais da API por milhão de tokens, não preços de assinatura ou de uso do Felo. A linha de effort importa tanto quanto a de preço: o mesmo prompt pode custar bem diferente dependendo de onde cada modelo começa.
As tarifas públicas da API e os valores padrão foram conferidos em 23 de setembro de 2026 no anúncio do Claude Opus 5.5 da Anthropic, nas páginas de modelos da Claude Platform e na página do GPT-6 Astra da OpenAI. O preço por token é só uma parte do custo total de uma tarefa. A afirmação de eficiência da Anthropic é uma queda de 40% em cargas típicas, que combina preço por token menor com menos tokens por tarefa.
Resultados publicados pela Anthropic
A Anthropic publicou seus próprios números ao lado de Fable 5.1, Opus 5, GPT-6 Astra e GPT-5.6 Sol. Dois dos quatro gráficos abaixo mostram precisão contra custo por tarefa, e não precisão isolada, porque é exatamente essa a comparação que a Anthropic faz.
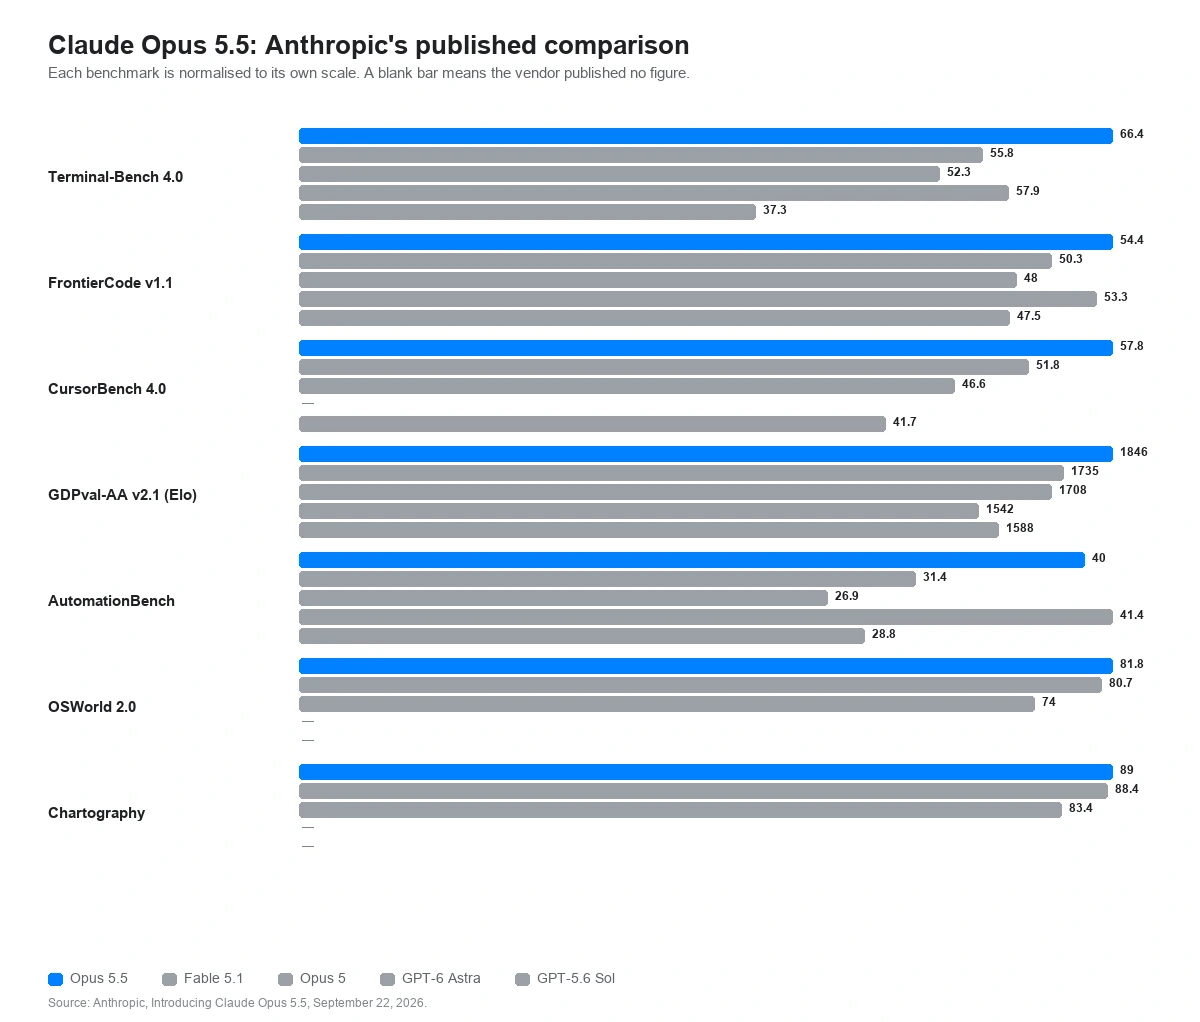
A comparação publicada por completo
Programação agêntica, trabalho de conhecimento, fluxos de negócio, raciocínio multidisciplinar, pesquisa científica, uso do computador e leitura de gráficos, nos cinco modelos medidos.
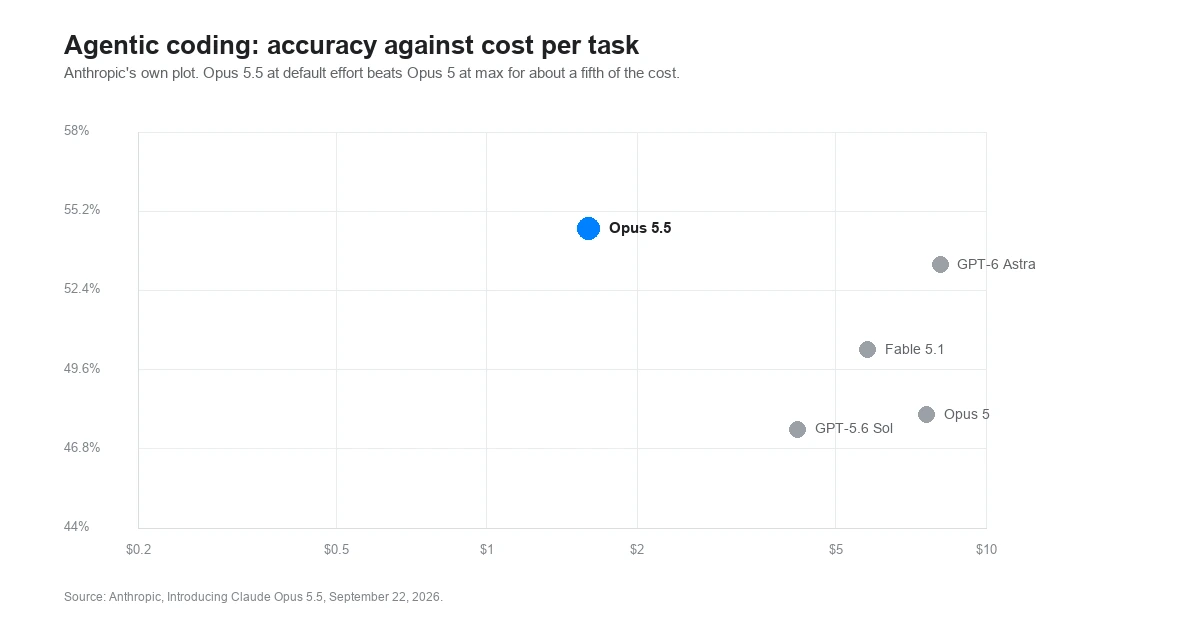
Programação agêntica
Terminal-Bench 4.0, FrontierCode v1.1 e CursorBench 4.0, traçados como precisão contra custo por tarefa.
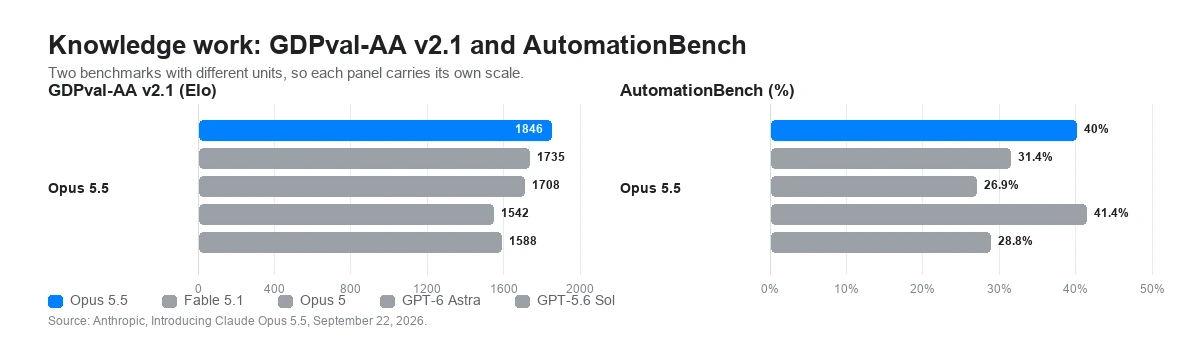
Trabalho de conhecimento
GDPval-AA v2.1 em 44 ocupações, AutomationBench e o WANDR, benchmark de coleta de dados da Perplexity.
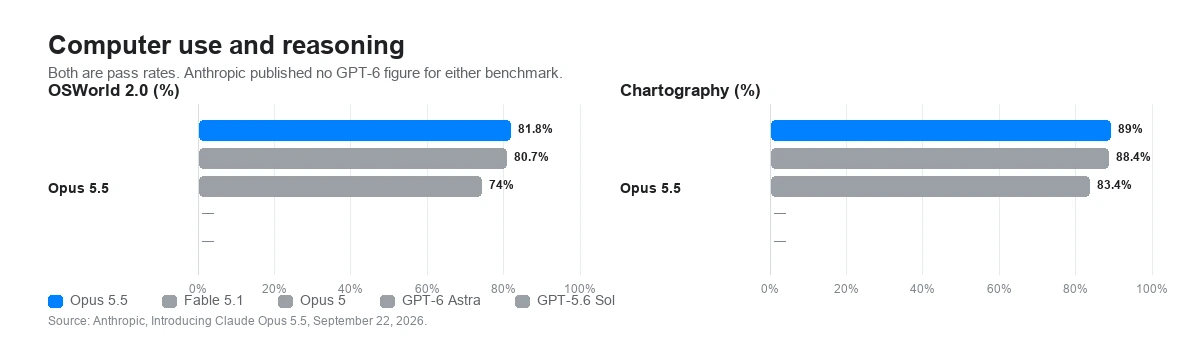
Uso do computador e raciocínio
OSWorld 2.0, Humanity's Last Exam e Chartography, sendo que o último mede a precisão ao ler valores de um gráfico.
Precisão contra custo por tarefa
A tese central da Anthropic não é uma pontuação maior a qualquer preço, e sim a mesma pontuação, ou melhor, por uma fração do custo por tentativa.
Números publicados pelo fabricante. Salvo indicação em contrário, a Anthropic executou o Opus 5.5 com raciocínio adaptativo em max effort e o avaliou com as proteções de produção ativadas. Quando essas proteções intervieram, as tarefas de cibersegurança foram concluídas pelo Opus 4.8 e as de biologia pelo Opus 5, o que provavelmente reduz os números publicados do Opus 5.5 nesses benchmarks. Os números do GPT-6 Astra e do GPT-5.6 Sol são os reportados pela OpenAI. Diferenças de benchmark entre fabricantes são um indício fraco das diferenças reais, o que a própria Anthropic diz sobre esses números.
Se você já roda o Opus 5
A Anthropic lista quatro mudanças incompatíveis para integrações que já rodam no Claude Opus 5, além de uma quinta que altera o formato da resposta sem fazer nenhuma requisição falhar. Vale ler antes de trocar o ID do modelo, porque três delas retornam erro 400 em vez de degradar em silêncio.
01
No Opus 5, o raciocínio podia ser desativado até high. No Opus 5.5 ele fica sempre ligado, e tanto a desativação quanto um orçamento manual de tokens retornam erro 400. O effort passa a ser o único controle, e o padrão muda de high para medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice definido como "any" ou como uma ferramenta nomeada retorna erro 400, inclusive no endpoint de contagem de tokens. Use auto com uso estrito de ferramentas ou saídas estruturadas, e diga no prompt quando a ferramenta se aplica.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Cada bloco de raciocínio registra qual modelo o produziu. O Opus 5.5 lê blocos do Opus 5 e de modelos Opus, Sonnet e Haiku anteriores, mas não do Fable nem do Mythos. Se um roteador mover a conversa para outro modelo, os turnos seguintes rodam sem o raciocínio anterior.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 mantêm o raciocínio; os outros modelos o descartam
04
Na API da Claude e no Google Cloud, a ferramenta computer_20251124 retorna erro 400. Declare o toolset computer_toolset_20260801, remova o cabeçalho beta e adapte o loop do agente para blocos member tool_use. No Amazon Bedrock a ferramenta antiga continua funcionando.
computer_20251124 -> computer_toolset_20260801
Como o raciocínio não pode ser desativado, o que se ajusta é o effort. O Opus 5.5 suporta os cinco níveis e começa em medium, um nível abaixo do Opus 5. A recomendação da Anthropic é refazer a varredura nas suas próprias avaliações em vez de reaproveitar uma configuração, e definir um max_tokens generoso nos níveis altos, já que os tokens de raciocínio contam nesse limite mesmo quando o texto do raciocínio não é devolvido.
O effort é um sinal de comportamento, não um orçamento rígido de tokens: em um nível baixo o modelo ainda raciocina diante de problemas realmente difíceis, só que menos do que em um nível alto. A Anthropic também observa que o Opus 5.5 tende a pensar mais por turno que o Opus 5 no mesmo nível, sobretudo em xhigh e max, então uma configuração herdada do Opus 5 vai gerar turnos mais longos e mais caros.
Onde ele encaixa
O Opus 5.5 se paga quando uma tarefa dura horas, cobre mais arquivos do que uma pessoa consegue segurar ou gera algo que outra pessoa precisa revisar. São os casos que a Anthropic e seus primeiros testadores descrevem, não prompts genéricos de conversa.
Levar uma mudança por um repositório grande até os testes passarem, em vez de parar no primeiro patch plausível. A Anthropic relata uma migração de 680 mil linhas concluída em menos de um dia por um testador.
A Column, testadora citada pela Anthropic, relatou ter encontrado um bug ao consultar documentação externa de uma integração de terceiros que havia sido modelada errado vários commits antes.
Montar o modelo e depois o resumo de uma página, mantendo as ressalvas. A Anthropic relata uma análise de fusão concluída em 63 minutos contra 93 do Opus 5, pela metade do custo.
Ele delega para subagentes e ajusta o ritmo a um orçamento de tempo. A recomendação da Anthropic é dar a uma arquitetura multiagente um sinal de tempo decorrido para que ela paralelize em vez de serializar.
01
Inclua o repositório, os documentos e os requisitos que uma resposta útil precisa considerar. A janela de 1 milhão de tokens existe para isso.
02
Deixe claro o que precisa ser verdade para o trabalho ser considerado pronto. A orientação da própria Anthropic para execuções sem supervisão é manter as partes da tarefa em uma lista que o modelo atualiza.
03
Rode a mesma tarefa no Opus 5.5, no Opus 5 e no Fable 5.1 dentro do Felo. Compare os testes, as ressalvas e o consumo de tokens, não só a resposta.
Selecione o Claude Opus 5.5 quando ele aparecer no seletor de modelos da sua conta.
Testar o Opus 5.5 no FeloO Claude Opus 5.5 é o modelo da Anthropic para programação agêntica de longa duração e trabalho de conhecimento, lançado em 22 de setembro de 2026 como primeiro modelo da família Claude 5.5. Segundo a Anthropic, ele alcança o nível do Claude Fable 5.1 na maior parte das tarefas e custa 40% menos para rodar que o Claude Opus 5.
Coloque o Claude Opus 5.5 ao lado dos outros modelos de ponta no Felo e teste naquele trabalho que você vem adiando porque leva horas.
Testar o Opus 5.5 no FeloComece pela busca do Felo AI e selecione o modelo onde ele estiver disponível.