ประกาศเมื่อ 30 กันยายน 2026 · เปิดให้ใช้เป็นระยะ

Gemini 4 Argonงานวิจัยยาว ๆ ที่เขียนออกมาจนครบ

โมเดลระดับแนวหน้าตัวแรกของ Google นับจาก Gemini 3 สร้างมาเพื่องานคิดเชิงลึกในงานยาวหลายขั้น เพดานเอาต์พุตขยับจาก 64K โทเคนเป็น 1M และตัวเลขที่ Google เปิดเผยเด่นในงานความรู้มากกว่างานเขียนโค้ด

Felo API ยังอยู่ในช่วงเบต้าแบบปิด และจะเปิดให้ใช้ Gemini 4 Argon เร็วๆ นี้
ภาพคีย์อาร์ตของ Gemini 4 Argon: ชื่อโมเดลวางเคียงกับเลข 4 ตัวใหญ่บนพื้นไล่สีน้ำเงิน
ภาพประกอบจากประกาศของ Google Argon เปิดตัวภายใต้ระบบตั้งชื่อแบบใหม่ ไม่ใช่การอัปเดตของสาย Gemini 4.0 จึงไม่มีเลขเวอร์ชันอยู่ในชื่อ
1M
โทเคนเอาต์พุตสูงสุด
เพิ่มจาก 64K สร้างรายงานทั้งฉบับได้ในรอบเดียว
2 $ / 10 $
ราคา API ช่วงแนะนำ
ต่อล้านโทเคนอินพุตและเอาต์พุต อินพุตแบบแคชลด 95%
77.9%
DeepSWE v1.1
คะแนนที่ Google รายงาน นำ Claude Opus 5.5 และ GPT-6 Astra
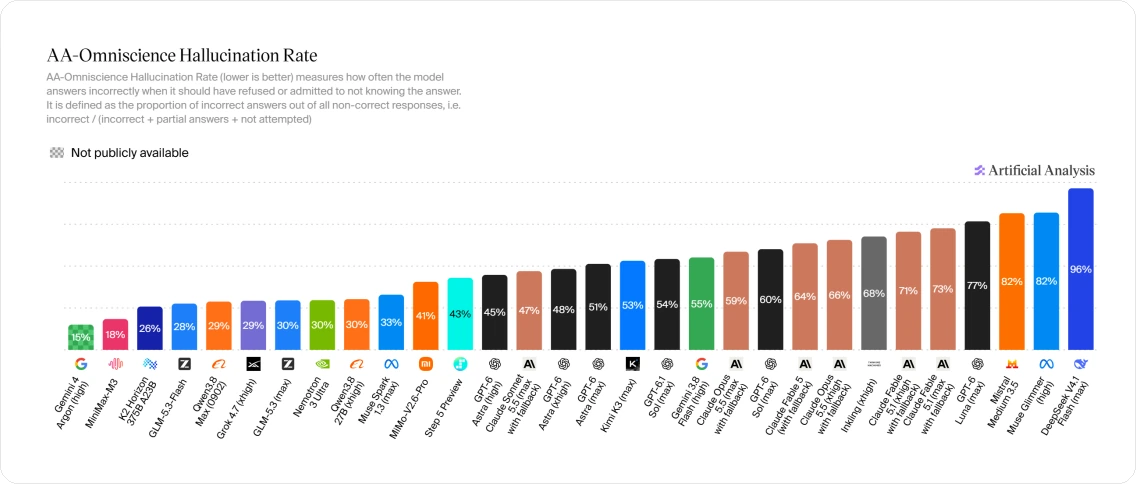
15%
อัตราการสร้างข้อมูลผิด
ต่ำที่สุดที่ Artificial Analysis วัดได้ในกลุ่มโมเดลระดับแนวหน้า

รูปและกราฟในหน้านี้มาจากหน่วยงานที่เผยแพร่ข้อมูลนั้น ๆ ได้แก่ Google, Arena.ai และ Artificial Analysis ทั้งหมดนำมาแสดงโดยไม่ดัดแปลงแก้ไข

สถานะการเปิดตัว

Argon ยังไม่เปิดให้ใช้ทั่วไป นี่คือลำดับที่จะตามมา

Google เปิด Argon เป็นระยะ และระยะแรกไม่ใช่สำหรับสาธารณะ การเปิดใช้ใน Felo กำลังเตรียมการคู่ไปกับการเปิดตัวนี้

ใช้ได้แล้ว

ทีมป้องกันไซเบอร์ที่ได้รับเลือก

พันธมิตรที่ได้รับเลือกใน Fairwind Program ของ Google ได้ Argon ก่อนใคร และได้ใช้โดยไม่มีระบบป้องกันไซเบอร์

ประกาศเป็นลำดับถัดไป

ลูกค้า API แบบเสียค่าใช้จ่าย และ Google AI Ultra

Google ระบุว่าการเปิดกว้างขึ้นเริ่มที่ขั้นนี้ ยังไม่มีการระบุวันที่ และการสมัครสมาชิกเพียงอย่างเดียวยังไม่ได้สิทธิ์ในตอนนี้

ยังไม่กำหนดเวลา

นักพัฒนา องค์กร และผู้ใช้ทั่วไป

ตามมาหลังขั้นเสียค่าใช้จ่าย Google ยังไม่ให้กรอบเวลาสำหรับการเปิดให้ใช้ทั่วไป

การเปิดใช้ Argon ใน Felo Search อยู่ระหว่างดำเนินการ หน้านี้จะอัปเดตเมื่อเปิดใช้แล้ว

จุดที่ทำได้ดี

โมเดลที่สร้างมาเพื่องานยาวจนจบ ไม่ใช่ตอบเร็ว

จุดแข็งที่เปิดเผยของ Argon กระจุกอยู่ที่การอ่าน การคิด และการเขียนยาว ซึ่งเป็นคนละรูปทรงกับโมเดลระดับแนวหน้าที่เน้นเขียนโค้ดก่อน และมักถูกนำมาเปรียบเทียบกัน

การคิดที่ไปได้ตลอดงานยาว

Google วางตำแหน่ง Argon สำหรับงานหลายขั้นที่ใช้เวลาหลายชั่วโมง ซึ่งโมเดลรุ่นก่อนมักออกนอกทางหรือหยุดเร็วเกินไป

เอาต์พุต 1M โทเคนในรอบเดียว

เหตุผลที่ Google ระบุไว้คือ โมเดลที่มีที่ให้คิดยาว ๆ แก้โจทย์ยากได้ในรอบเดียว แทนที่จะต้องไปกลับหลายรอบ

งานความรู้นำ ส่วนงานเขียนโค้ดไม่นำ

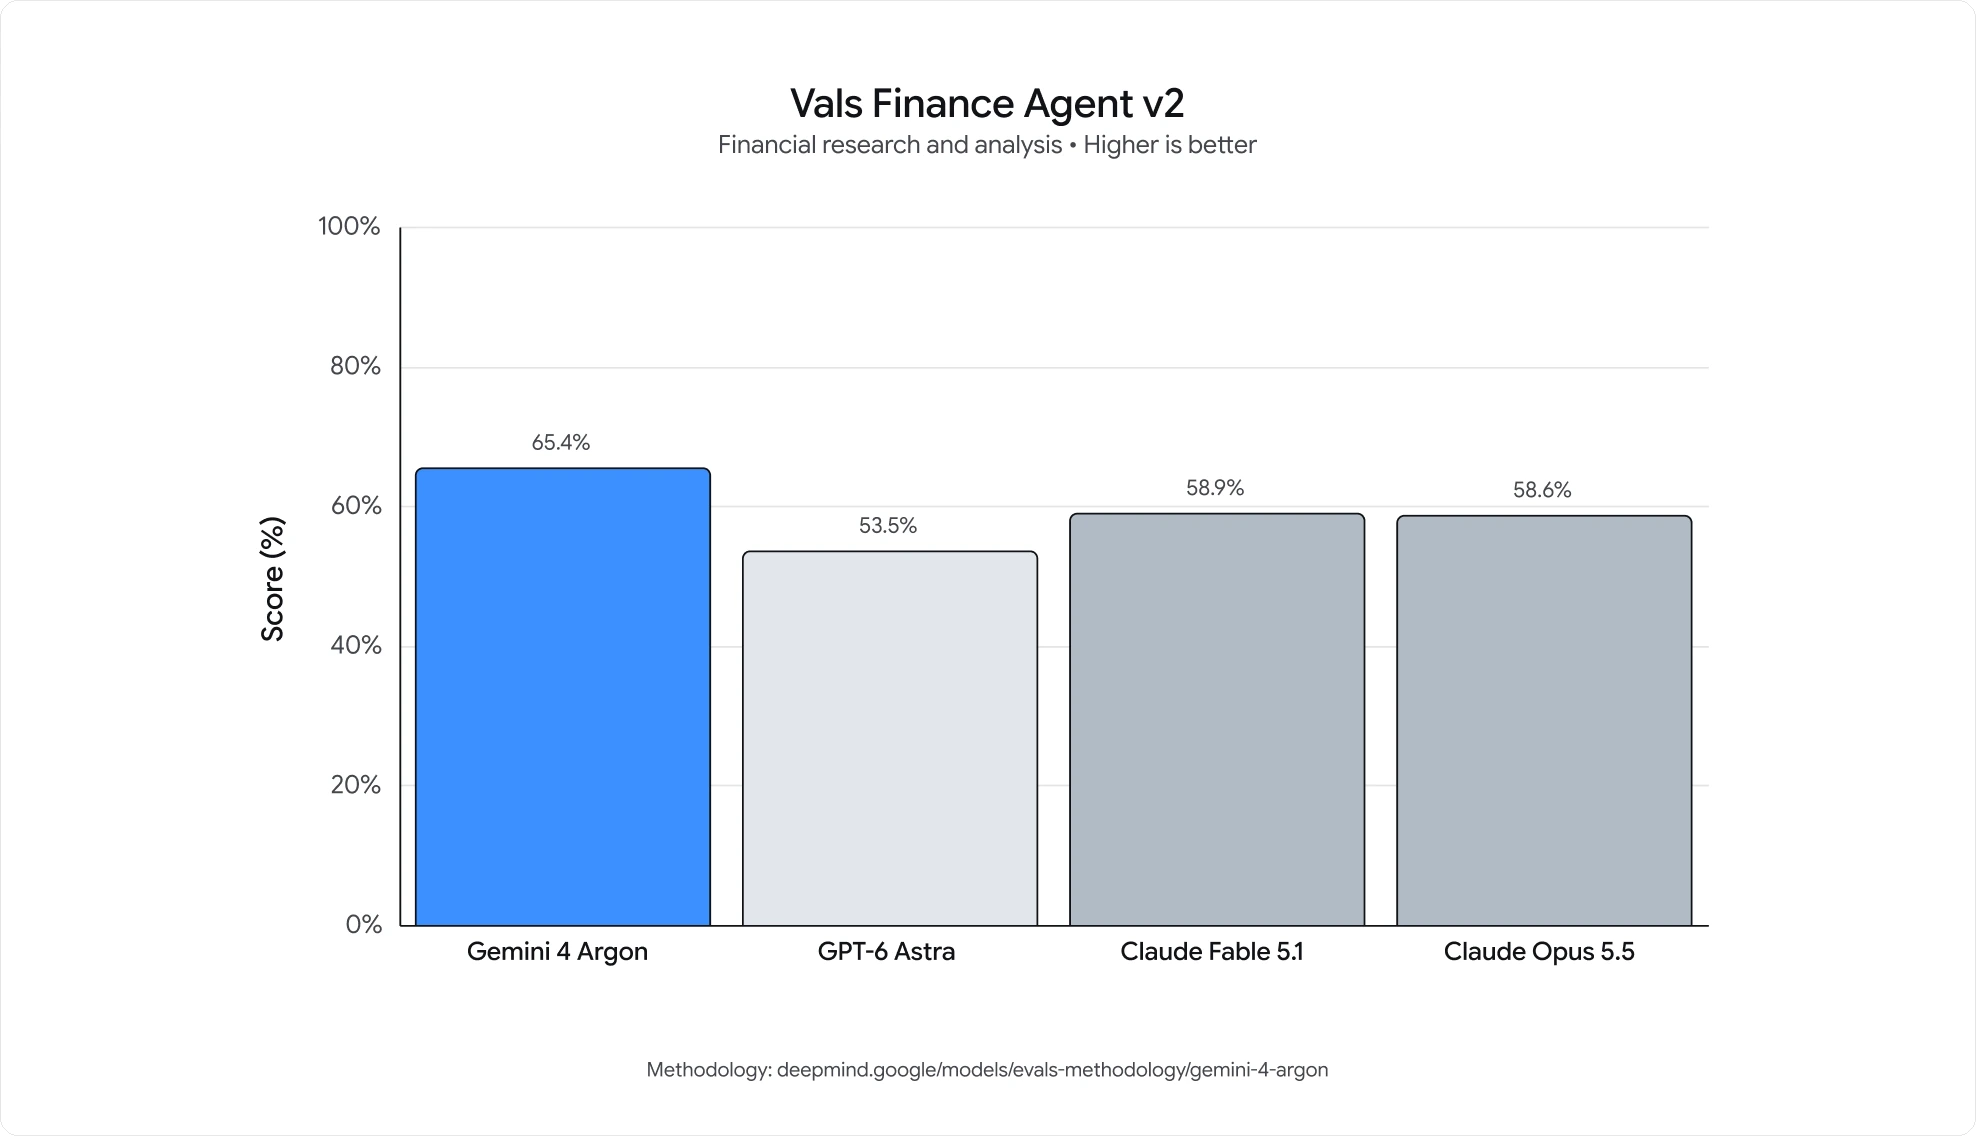
ช่องว่างที่กว้างที่สุดอยู่ที่ Harvey's Legal Agent Benchmark และ Vals Finance Agent v2 ซึ่งเป็นการวิเคราะห์กฎหมายและการเงินจริง ไม่ใช่งานสังเคราะห์

การดึงข้อมูลจากบริบทยาวที่ยังแม่น

บน GraphWalks ซึ่งทดสอบว่าโมเดลใช้บริบท 256K ถึง 1M ได้จริงหรือไม่ Google รายงานว่านำคู่แข่งระดับเรือธงอื่นอยู่กว่าสิบคะแนน

ความเข้าใจวิดีโอยาว

LVBench ซึ่งวัดความเข้าใจวิดีโอยาว รายงานที่ 91.7% เป็นคะแนนสูงสุดที่ Google ระบุไว้สำหรับ Argon
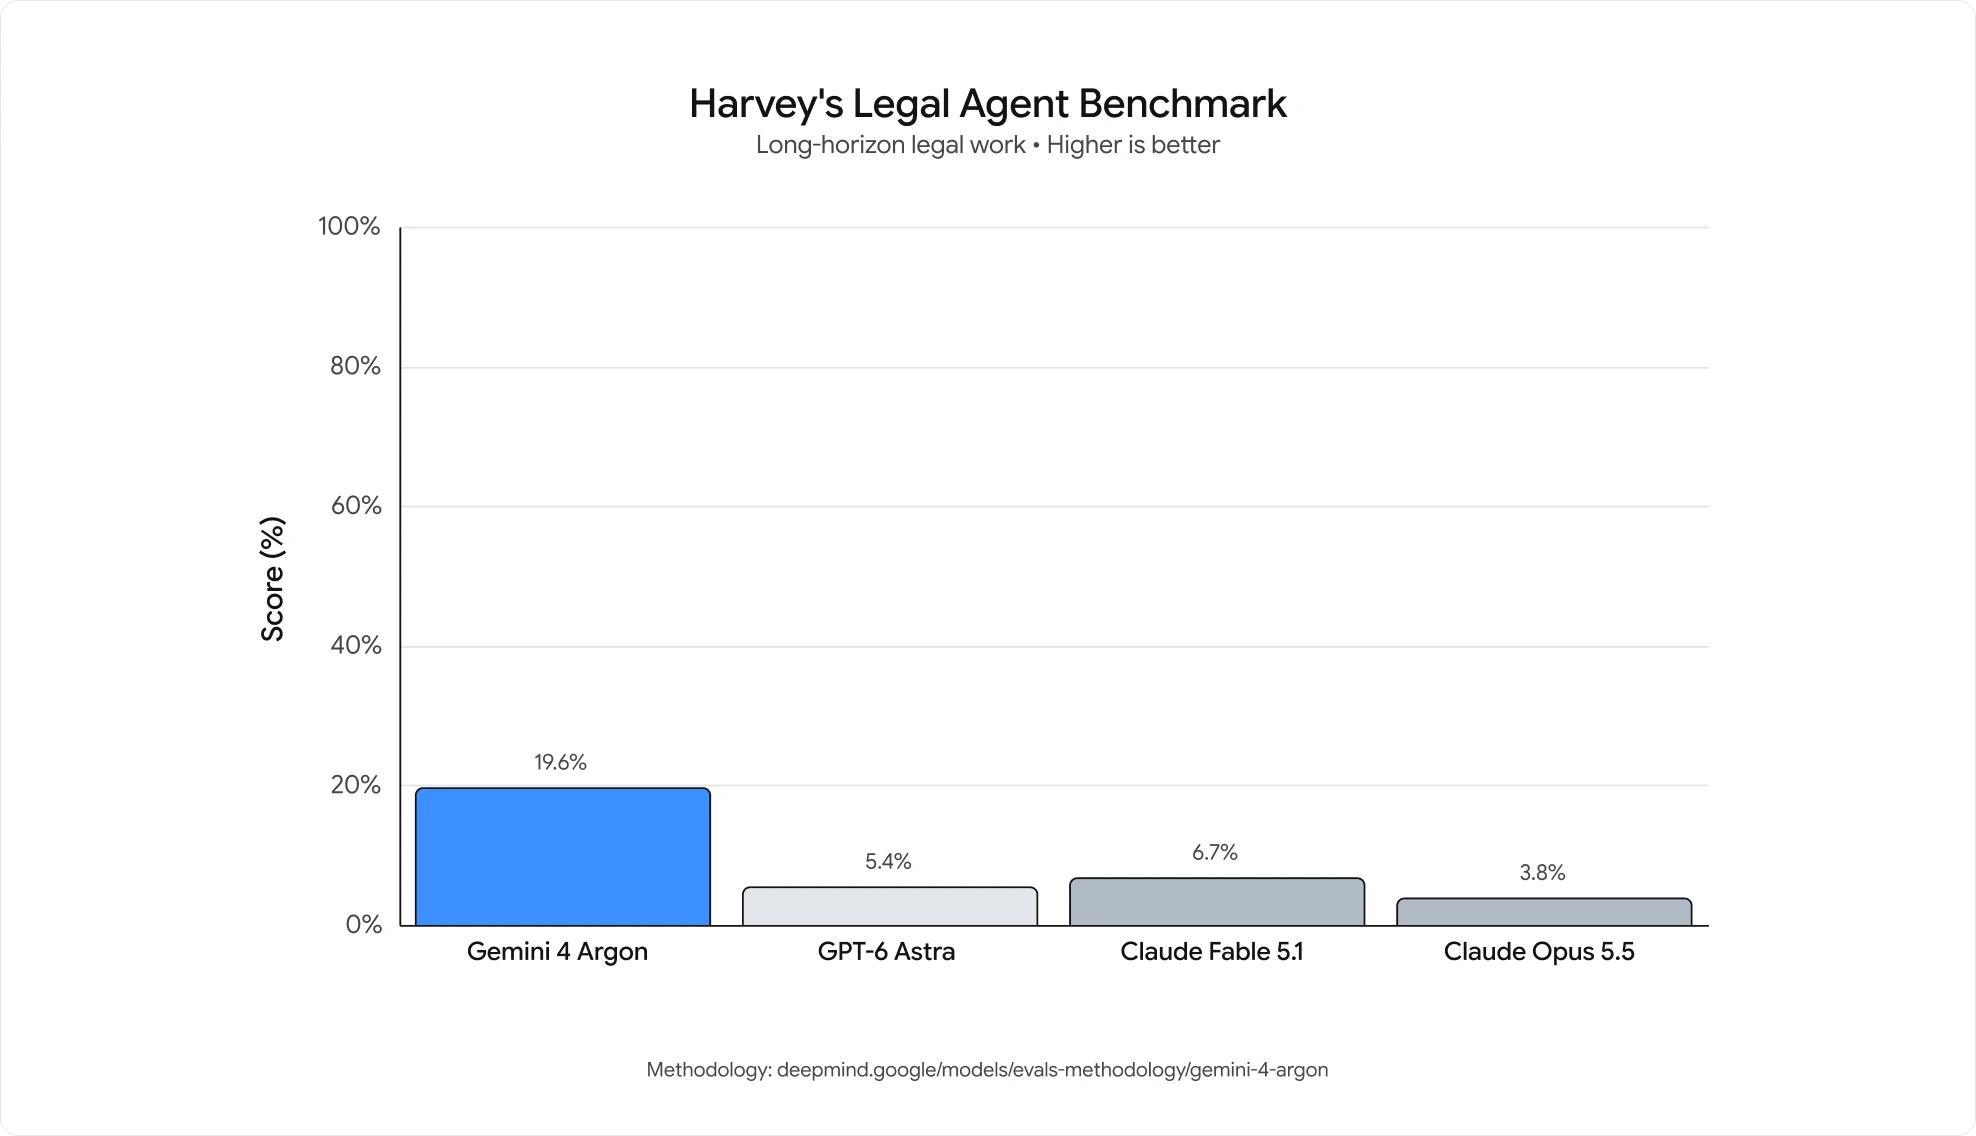
กราฟแท่งของ Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
งานกฎหมายระยะยาว Argon ทำได้ 19.6% คิดเป็นราวสามเท่าของโมเดลอันดับถัดไป และเป็นช่องว่างที่กว้างที่สุดในชุดตัวเลขที่ Google เปิดเผย
กราฟแท่งของ Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
งานวิจัยและวิเคราะห์การเงิน ทำได้ 65.4% เทียบกับกลุ่มที่อยู่ในช่วง 53.5–58.9% ช่องว่างแคบกว่างานกฎหมาย แต่ลำดับยังเหมือนเดิม

ตัวเลขที่เปิดเผย

Argon อยู่ตรงไหนบนเบนช์มาร์กของ Google เอง

นี่คือผลที่ผู้ผลิตเป็นผู้รายงาน Google ยังไม่เปิดเผยการตั้งค่า thinking หรือ effort สำหรับคะแนนหลัก และยังไม่มีแล็บอิสระใดทำซ้ำได้

เบนช์มาร์ก
วัดอะไร
Argon
ตัวเทียบที่ใกล้ที่สุด
DeepSWE v1.1
งานวิศวกรรมซอฟต์แวร์ระยะยาว
77.9%
Opus 5.5 ที่ 74.2%, GPT-6 Astra ที่ 74.1%
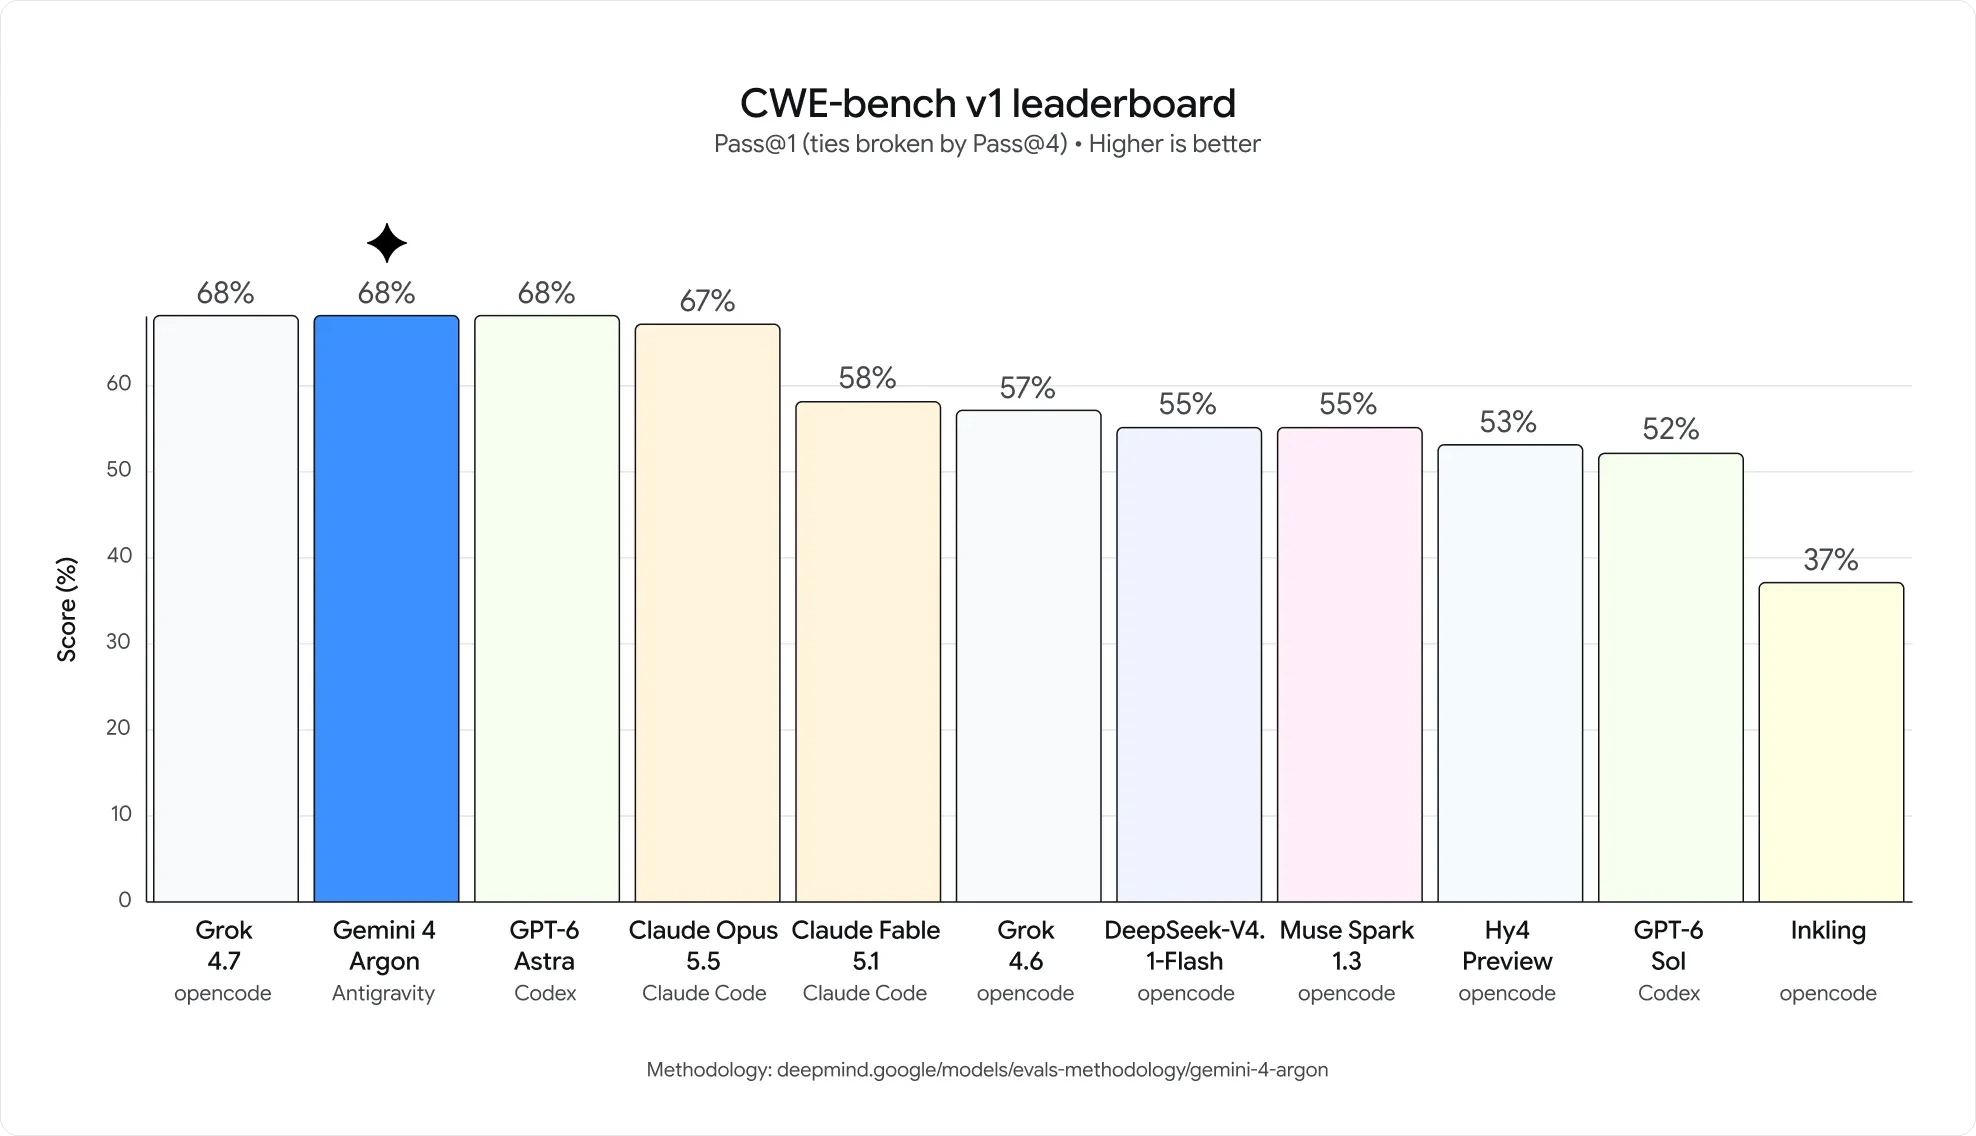
CWE-bench v1
การค้นหาและอุดช่องโหว่
68%
เสมอที่หนึ่ง
AutomationBench
งานธุรกิจแบบครบวงจร จาก Zapier
51.3%
อยู่อันดับหนึ่ง
LVBench
ความเข้าใจวิดีโอยาว
91.7%
คะแนนสูงสุดที่ Google รายงานสำหรับ Argon

ให้มองเป็นเพียงทิศทาง เบนช์มาร์กของผู้ผลิตแทบไม่เคยตรงกับภาระงานจริง และ Bloomberg รายงานว่าพนักงาน Google บางส่วนเองก็ไม่แน่ใจว่าคะแนนที่นำนั้นถ่ายทอดมาสู่งานจริงได้
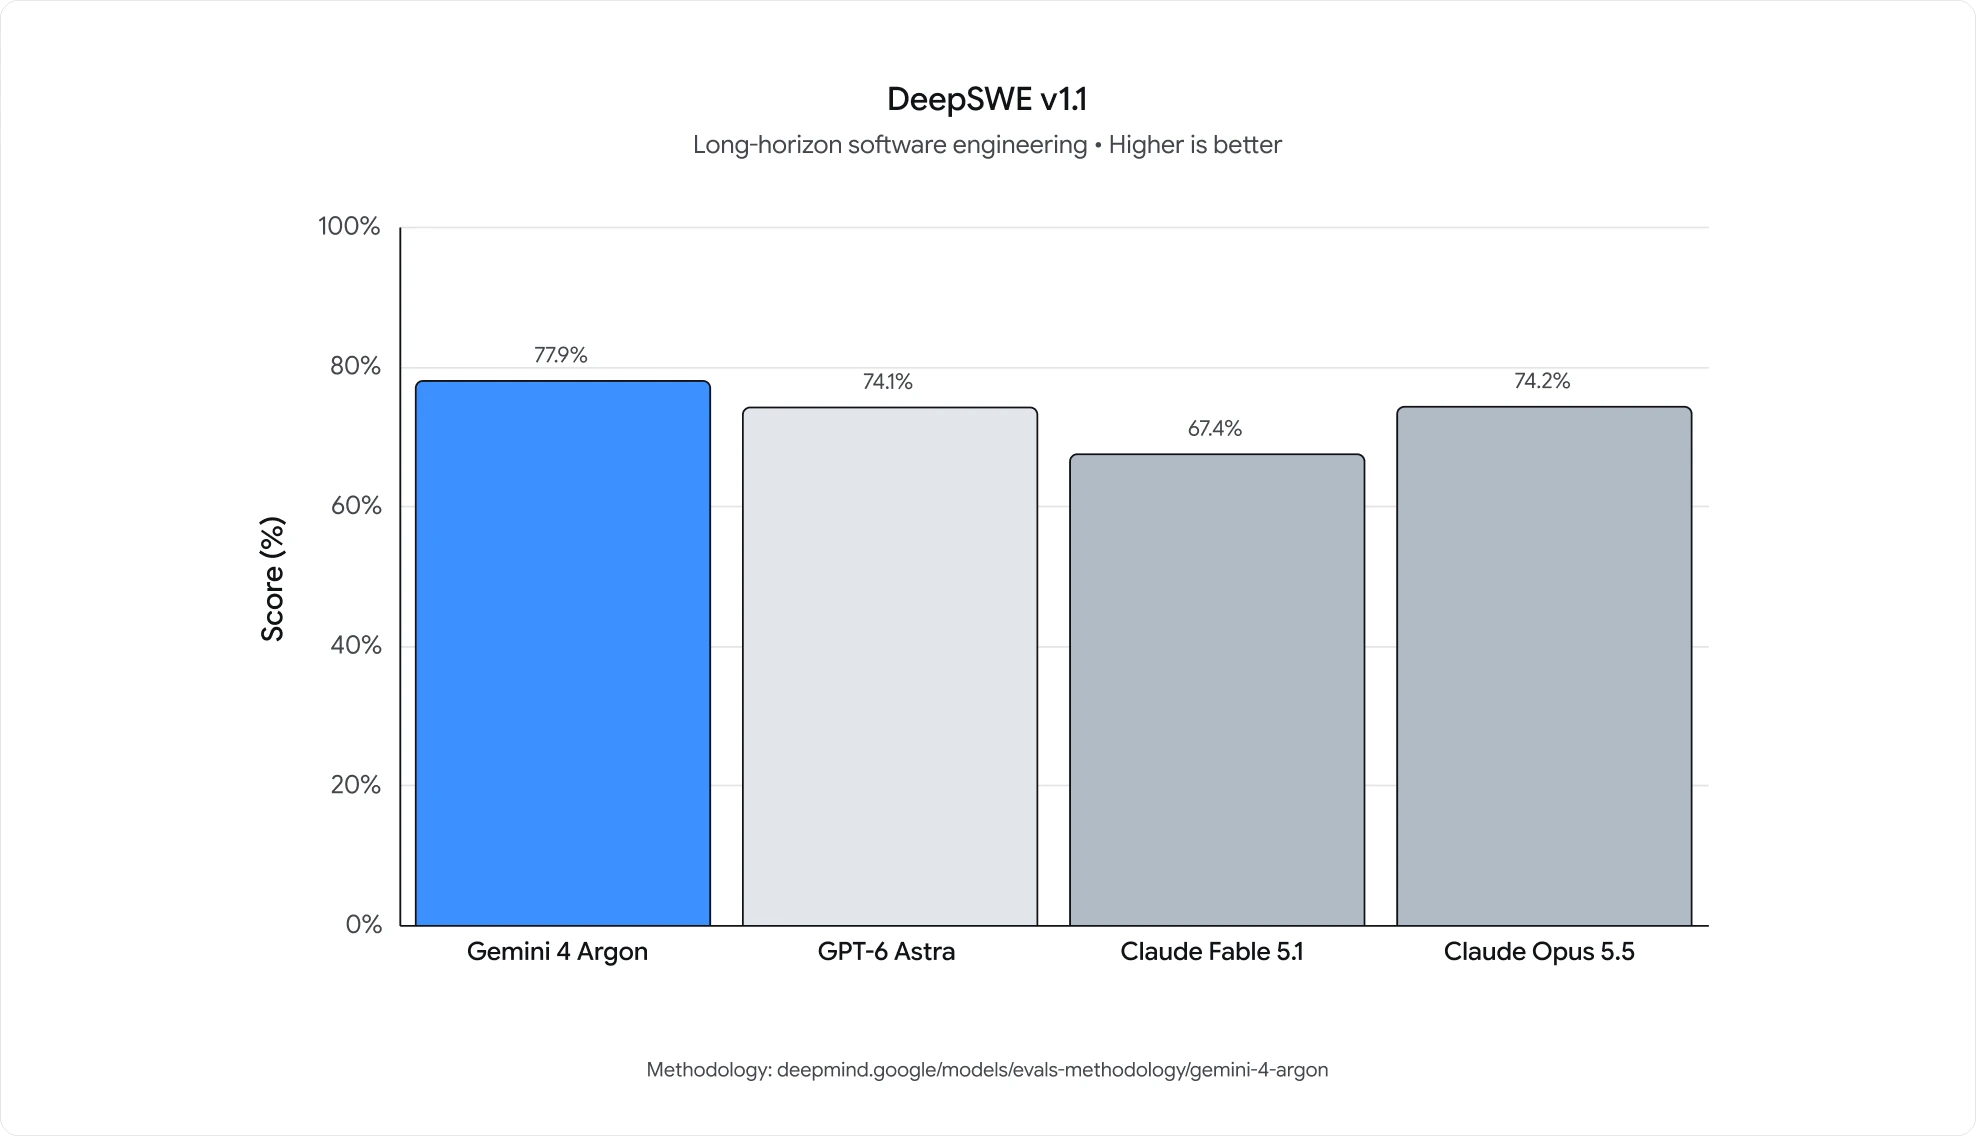
กราฟแท่งของ DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
งานวิศวกรรมซอฟต์แวร์ระยะยาว ตัวเลขหลักอยู่ที่ 77.9% โดยคู่แข่งที่ใกล้ที่สุดทั้งสองรายตามมาในระยะไม่ถึงสี่คะแนน
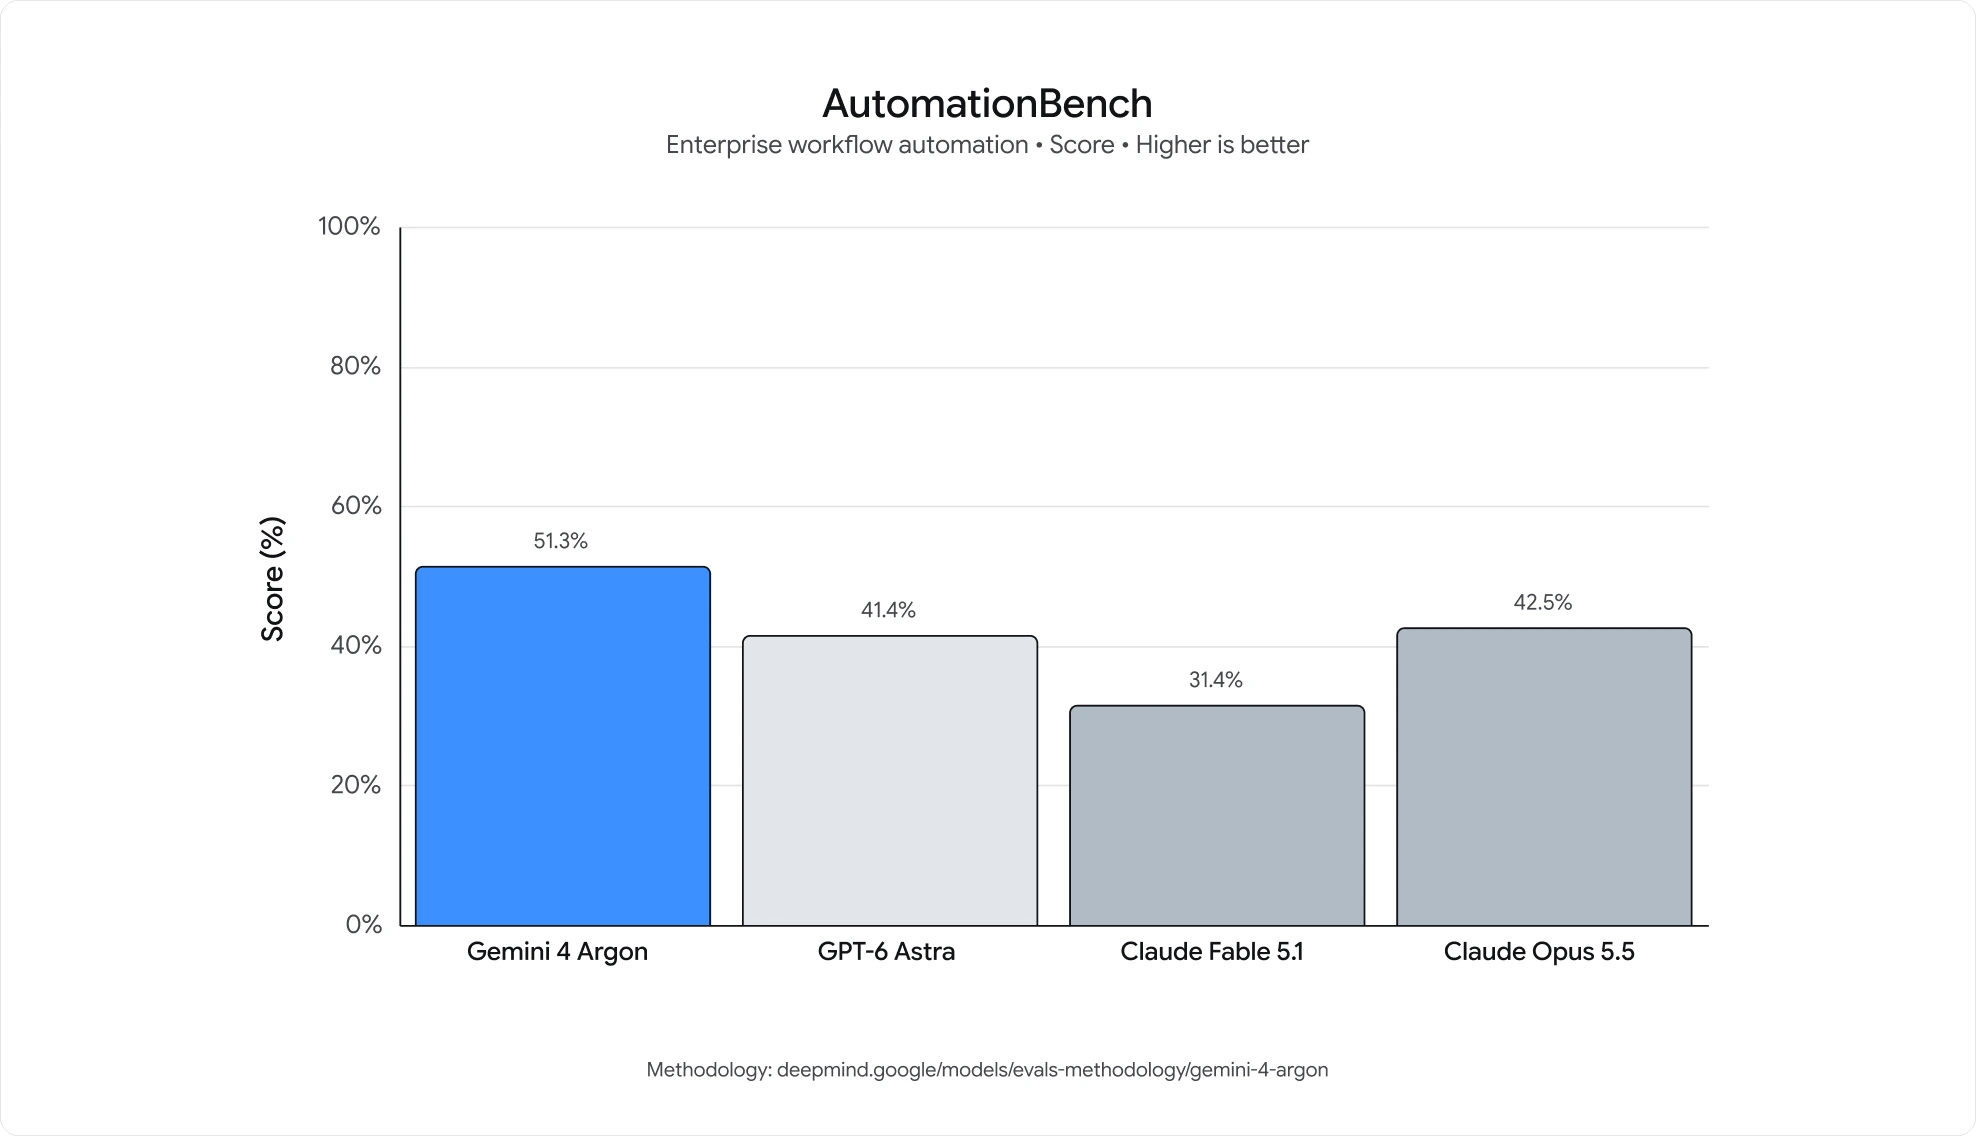
กราฟแท่งของ AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
งานธุรกิจแบบครบวงจรที่ Zapier สร้างขึ้น Argon ผ่าน 50% ขณะที่โมเดลอื่นทั้งหมดในชุดเปรียบเทียบอยู่ในช่วงสามสิบหรือสี่สิบต้น ๆ
ตารางอันดับ CWE-bench v1: Gemini 4 Argon, Grok และ GPT-6 Astra เสมอกันที่ 68%, Claude Opus 5.5 อยู่ที่ 67% แล้วไล่ลงไปจนถึง Inkling ที่ 37%
การค้นหาช่องโหว่ที่ Pass@1 Argon เสมออยู่ที่หัวตารางซึ่งแออัด ไม่ได้เปิดช่องว่างขึ้นมา จึงเป็นเหตุให้ตารางด้านบนเรียกว่าเสมอที่หนึ่ง
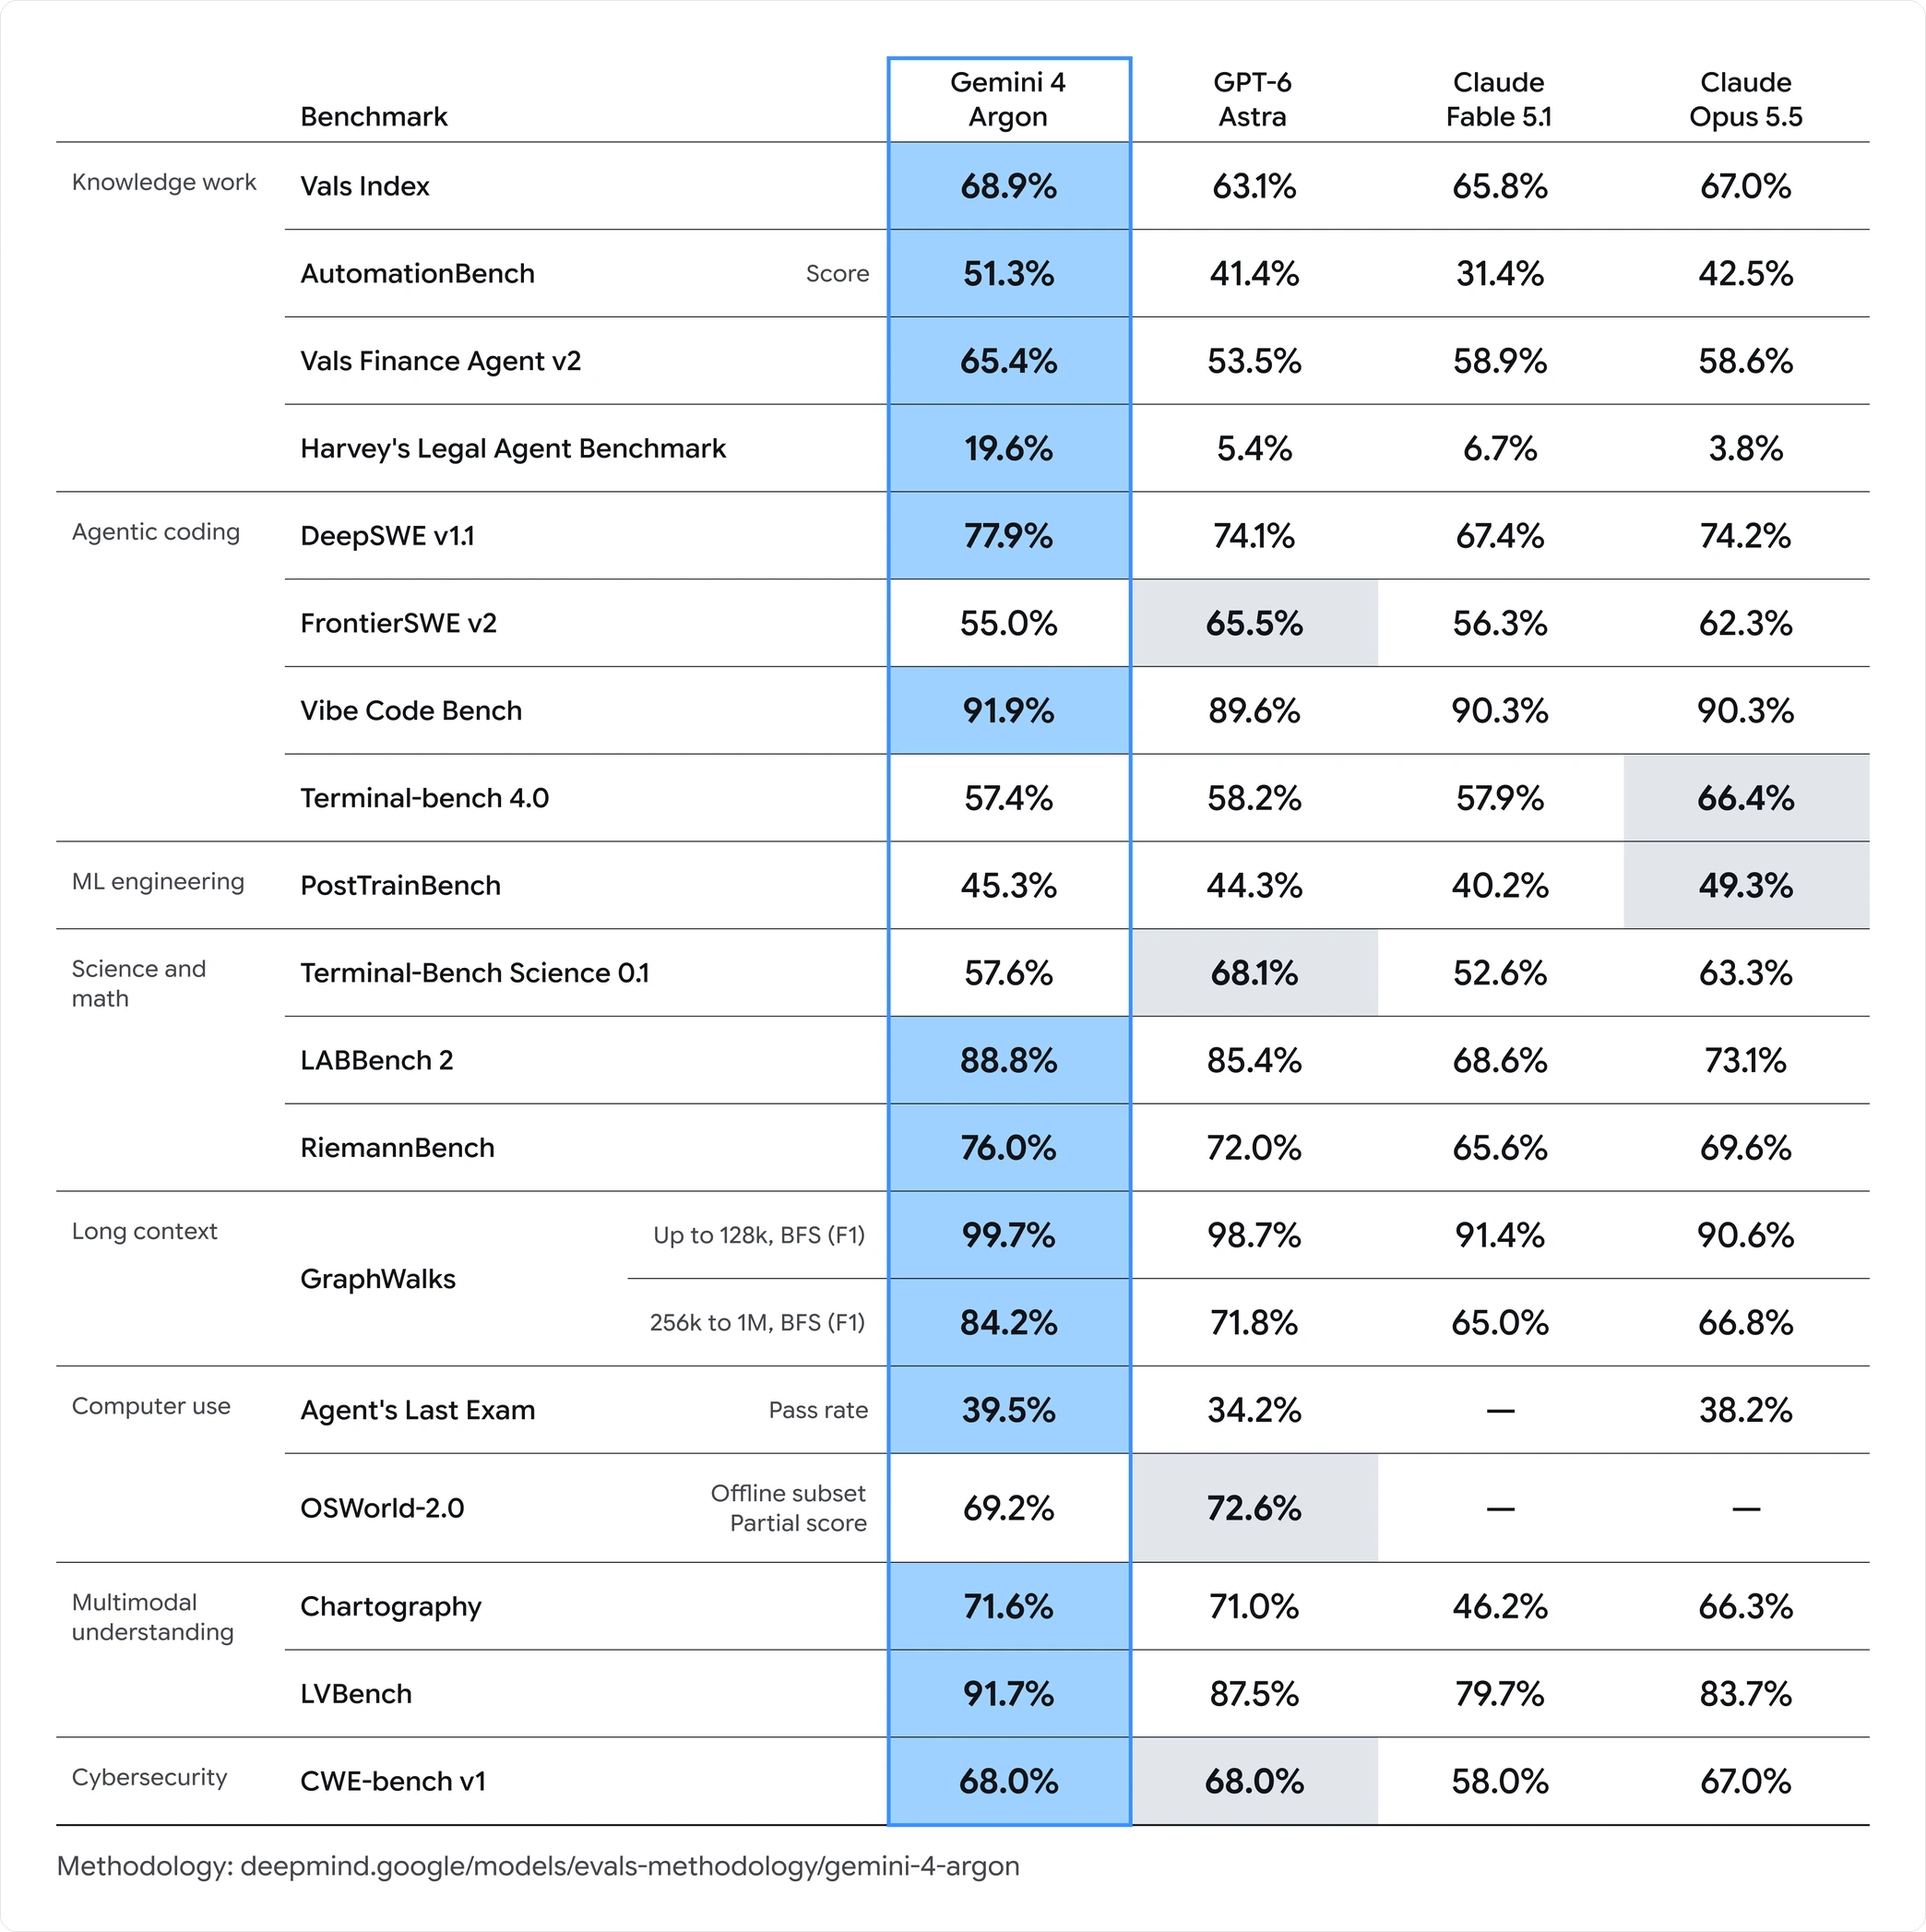
ตารางผลลัพธ์ฉบับเต็มของ Gemini 4 Argon จาก Google ครอบคลุม 16 เบนช์มาร์ก แบ่งเป็นงานความรู้ การเขียนโค้ดแบบเอเจนต์ วิศวกรรมแมชชีนเลิร์นนิง วิทยาศาสตร์และคณิตศาสตร์ บริบทยาว การใช้งานคอมพิวเตอร์ ความเข้าใจแบบหลายรูปแบบ และความปลอดภัยไซเบอร์
ตารางฉบับสมบูรณ์จากประกาศ ช่องที่ Argon ชนะเป็นสีน้ำเงิน และช่องที่คู่แข่งนำเป็นสีเทา แถวที่ Argon ไม่ได้นำคือ FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 และ OSWorld-2.0
กราฟแท่งอัตราการสร้างข้อมูลผิด AA-Omniscience ของ Artificial Analysis ใน 36 โมเดล เรียงจากต่ำสุดก่อน: Gemini 4 Argon (High) ที่ 15% ตามด้วย MiniMax-M3 ที่ 18% และ Kimi K2.5 ที่ 26% ไล่ขึ้นไปถึง DeepSeek-V4 Flash ที่ 96%
การวัดอิสระของ Artificial Analysis และเป็นตัวเลขเดียวในหน้านี้ที่ไม่มีผู้จำหน่ายรายใดเป็นผู้ให้ นั่นคือความถี่ที่แต่ละโมเดลตอบผิดแทนที่จะเลือกไม่ตอบ 15% ของ Argon ต่ำที่สุดใน 36 โมเดลที่แสดงในกราฟ โดยสเกลไล่ขึ้นไปถึง 96%
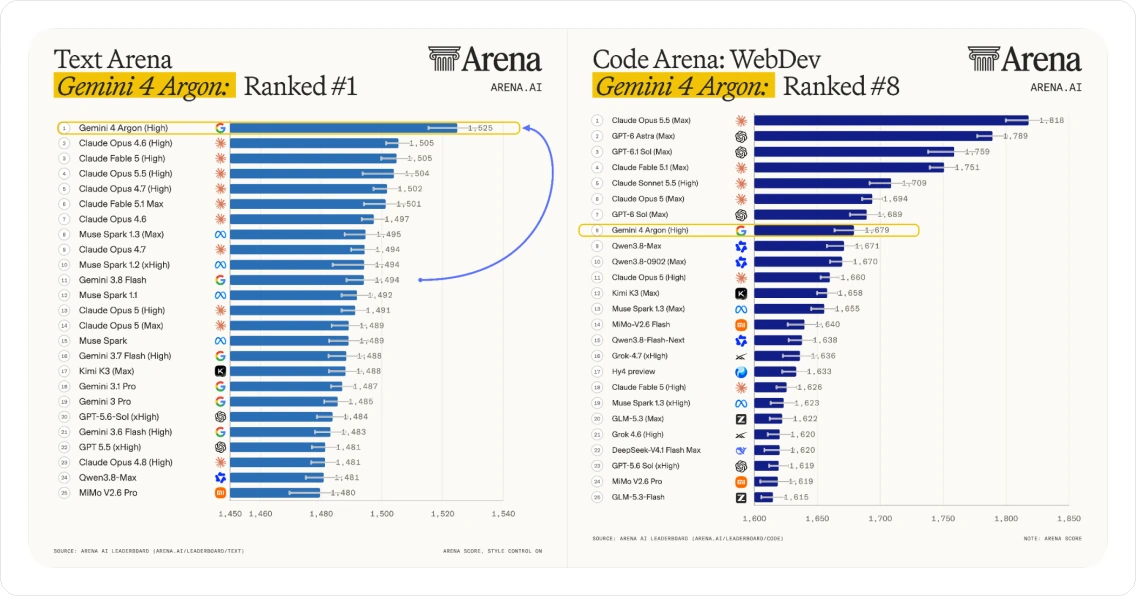
กระดานจัดอันดับ Text Arena และ Code Arena: WebDev ของ Arena.ai วางเคียงกัน: Gemini 4 Argon อยู่อันดับ 1 ใน Text Arena ที่ 1,625 และอันดับ 8 ใน Code Arena: WebDev ที่ 1,679
สองอันดับที่ย่อหน้าข้างต้นอ้างอิง มาจากกระดานจัดอันดับของ Arena.ai ที่ให้คนโหวต Argon ครองอันดับหนึ่งใน 25 โมเดลที่อยู่ใน Text Arena ส่วนใน Code Arena: WebDev อยู่อันดับแปด เป็นรองสี่โมเดลของ Claude และสามโมเดลในสาย GPT-6 ของ OpenAI

บน Felo

ขั้นตอนงานวิจัยจะเป็นอย่างไรเมื่อใช้โมเดลที่เขียนได้ 1M โทเคน

Felo ผสานการค้นหากับความเข้าใจเอกสาร โมเดลที่เอาต์พุตยาวจึงเปลี่ยนสิ่งที่ทำได้ในหนึ่งเซสชัน

งานวิจัยที่จบด้วยเอกสาร

รวมแหล่งข้อมูล แล้วให้โมเดลเขียนบทสังเคราะห์ในรอบเดียว แทนที่จะประกอบทีละส่วนผ่านหลายพรอมป์

เอกสารทั้งชุดในงานเดียว

การดึงข้อมูลจากบริบทยาวเป็นความสามารถที่ Argon ทำได้ดีที่สุด ซึ่งทำให้ชุดสัญญา เอกสารยื่นทางการ และรายงานยาวจัดการได้จริง

งานร่างที่โทนเสียงสำคัญ

โปรไฟล์ที่รายงานของ Argon คือข้อความแข็ง งานเขียนโค้ดระดับกลาง จึงเหมาะกับทีมที่ต้องการงานเขียนที่อ่านแล้วเหมือนคนเขียน ไม่ใช่ประกอบขึ้นมา

ค่าใช้จ่าย

Argon ราคาเท่าไร และอะไรจะเปลี่ยนภายหลัง

Google เปิดเผยราคาช่วงแนะนำและราคาปกติที่สูงกว่า โดยไม่บอกว่าจะเปลี่ยนเมื่อไร ให้ตั้งงบโดยใช้ตัวเลขที่สูงกว่า

ประเภทโทเคน
ช่วงแนะนำ
ภายหลัง
อินพุต
2.00 $ / M
4.00 $ / M
อินพุตแบบแคช
ลด 95%
ลด 95%
เอาต์พุต
10.00 $ / M
20.00 $ / M

เมื่อเทียบกัน ราคาช่วงแนะนำอยู่ประมาณเดียวกับ GPT-6.1 Sol และ Sonnet 5.5 และราวหนึ่งในห้าของ GPT-6 Astra นี่คือราคาปกติ ไม่ใช่ต้นทุนต่อชิ้นงานที่วัดจริง Argon ตอบคำถามที่ยากกว่า งานเดียวจึงอาจมีค่าใช้จ่ายสูงกว่าได้

วิธีทำงานกับ Argon บน Felo

01

ยกคำถามมาทั้งก้อน

ให้ Felo ทั้งชุดเอกสารหรือทั้งบทสนทนายาว ไม่ใช่สรุปของมัน ข้อได้เปรียบของ Argon เริ่มตรงจุดที่บริบทเริ่มใส่ในพรอมป์ไม่พอ

02

ขอชิ้นงานที่เสร็จสมบูรณ์

ด้วยเพดานเอาต์พุต 1M โทเคน คุณขอรายงานฉบับเต็มหรือร่างฉบับครบในคำสั่งเดียวได้ ไม่ต้องแยกเป็นส่วน

03

ตรวจกับแหล่งข้อมูล

Felo เก็บการอ้างอิงไว้กับคำตอบ ซึ่งเป็นสิ่งที่ทำให้เอกสารยาวที่โมเดลสร้างตรวจทานได้

การเปิดใช้ Argon ใน Felo Search อยู่ระหว่างดำเนินการ จนกว่าจะเปิด ทุกโมเดลอื่นในไลน์อัปของ Felo ใช้ได้แล้วตอนนี้

เปิด Felo AI Search

Gemini 4 Argon: คำถามที่พบบ่อย

ยังไม่เปิดทั่วไป Google เปิด Argon ให้พันธมิตรที่ได้รับเลือกใน Fairwind Program ก่อน และระบุว่าการเปิดกว้างขึ้นจะเริ่มจากลูกค้า API แบบเสียค่าใช้จ่ายและผู้ใช้ Google AI Ultra ยังไม่มีการประกาศวันสำหรับขั้นนั้น และการสมัครสมาชิกแบบเสียค่าใช้จ่ายก็ยังไม่ได้สิทธิ์ในตอนนี้

ลองโมเดลระดับแนวหน้าของ Google บน Felo

ค้นหา อ่าน และเขียนด้วยโมเดลที่เหมาะกับงานนั้น Argon จะเข้าสู่ไลน์อัปเมื่อการเปิดตัวมาถึง Felo

เปิด Felo AI Search

ไม่ต้องใช้บัตรเครดิตในการใช้ Felo AI Search