Angekündigt am 30. September 2026 · Start in Stufen

Gemini 4 ArgonLange Recherche, vollständig ausformuliert

Googles erstes Frontier-Modell seit Gemini 3, gebaut für tiefes Reasoning über lange, mehrstufige Arbeit. Es hebt die Ausgabegrenze von 64K auf 1M Token und führt in Googles veröffentlichten Zahlen zur Wissensarbeit, nicht beim Coden.

Die Felo API befindet sich in einer geschlossenen Beta — der Zugang zu Gemini 4 Argon kommt bald.
Key Visual zu Gemini 4 Argon: der Modellname neben einer großen Ziffer 4 auf einem blauen Farbverlauf
Das Ankündigungsbild von Google. Argon erscheint unter einem neuen Namensschema und nicht als Update der Gemini-4.0-Reihe — deshalb trägt der Name keine Versionsnummer.
1M
Max. Ausgabe-Token
Vorher 64K — ein vollständiger Bericht in einem einzigen Durchlauf.
2 $ / 10 $
Einführungspreis API
Pro Million Eingabe- und Ausgabe-Token. Zwischengespeicherte Eingabe ist 95% günstiger.
77.9%
DeepSWE v1.1
Googles gemeldeter Wert, vor Claude Opus 5.5 und GPT-6 Astra.
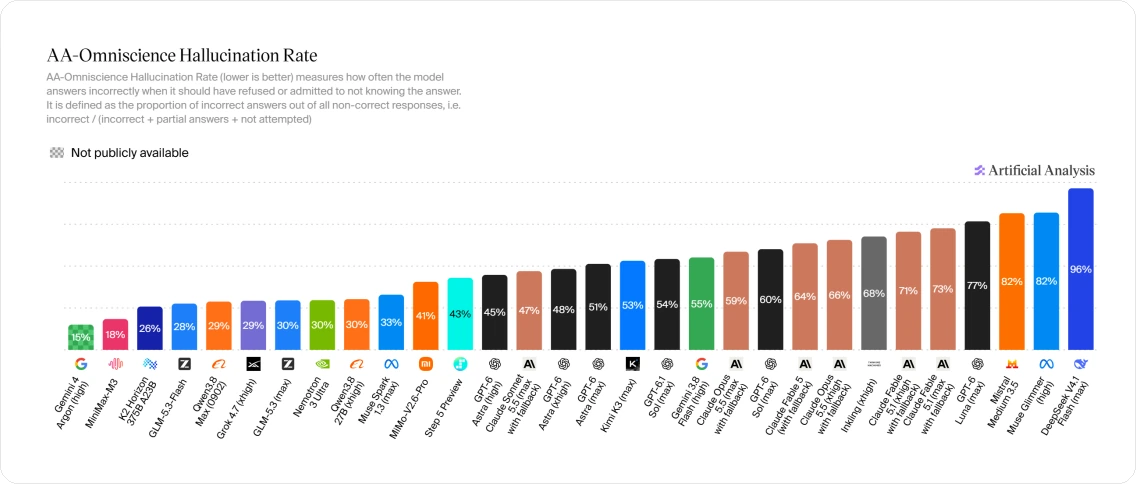
15%
Halluzinationsrate
Der niedrigste gemessene Wert unter Frontier-Modellen laut Artificial Analysis.

Die Abbildungen und Diagramme auf dieser Seite stammen von den Organisationen, die sie veröffentlicht haben — Google, Arena.ai und Artificial Analysis — und werden unverändert wiedergegeben.

Rollout-Status

Argon ist noch nicht allgemein verfügbar. So ist die Reihenfolge.

Google bringt Argon in Stufen heraus, und die erste Stufe ist nicht die öffentliche. Der Zugang in Felo wird parallel zu diesem Rollout aufgebaut.

Jetzt verfügbar

Vertrauenswürdige Cyber-Verteidiger

Ausgewählte Partner im Fairwind-Programm von Google erhalten Argon zuerst, und zwar ohne Cyber-Schutzmaßnahmen.

Als Nächstes angekündigt

Zahlende API-Kunden und Google AI Ultra

Laut Google beginnt hier der breitere Zugang. Ein Datum wurde nicht genannt, und ein Abo allein reicht heute nicht.

Noch nicht terminiert

Entwickler, Unternehmen und Endnutzer

Folgt auf die kostenpflichtigen Stufen. Google hat sich für die allgemeine Verfügbarkeit nicht auf einen Zeitplan festgelegt.

Der Argon-Zugang in der Felo-Suche ist in Arbeit. Diese Seite wird aktualisiert, sobald er öffnet.

Worin es stark ist

Ein Modell, das lange Arbeit zu Ende bringt, nicht schnell antwortet

Argons veröffentlichte Stärken liegen beim Lesen, Denken und Schreiben über lange Strecken. Das ist eine andere Form als die coding-orientierten Frontier-Modelle, mit denen es verglichen wird.

Reasoning, das eine lange Aufgabe durchhält

Google positioniert Argon für mehrstufige Arbeit über Stunden, bei der frühere Modelle abdriften oder zu früh aufhören.

1M Token Ausgabe in einem Durchgang

Googles Begründung für die Erhöhung: Ein Modell mit Raum zum langen Denken löst ein schweres Problem in einem Durchlauf statt in vielen Runden.

Wissensarbeit führt, nicht Coden

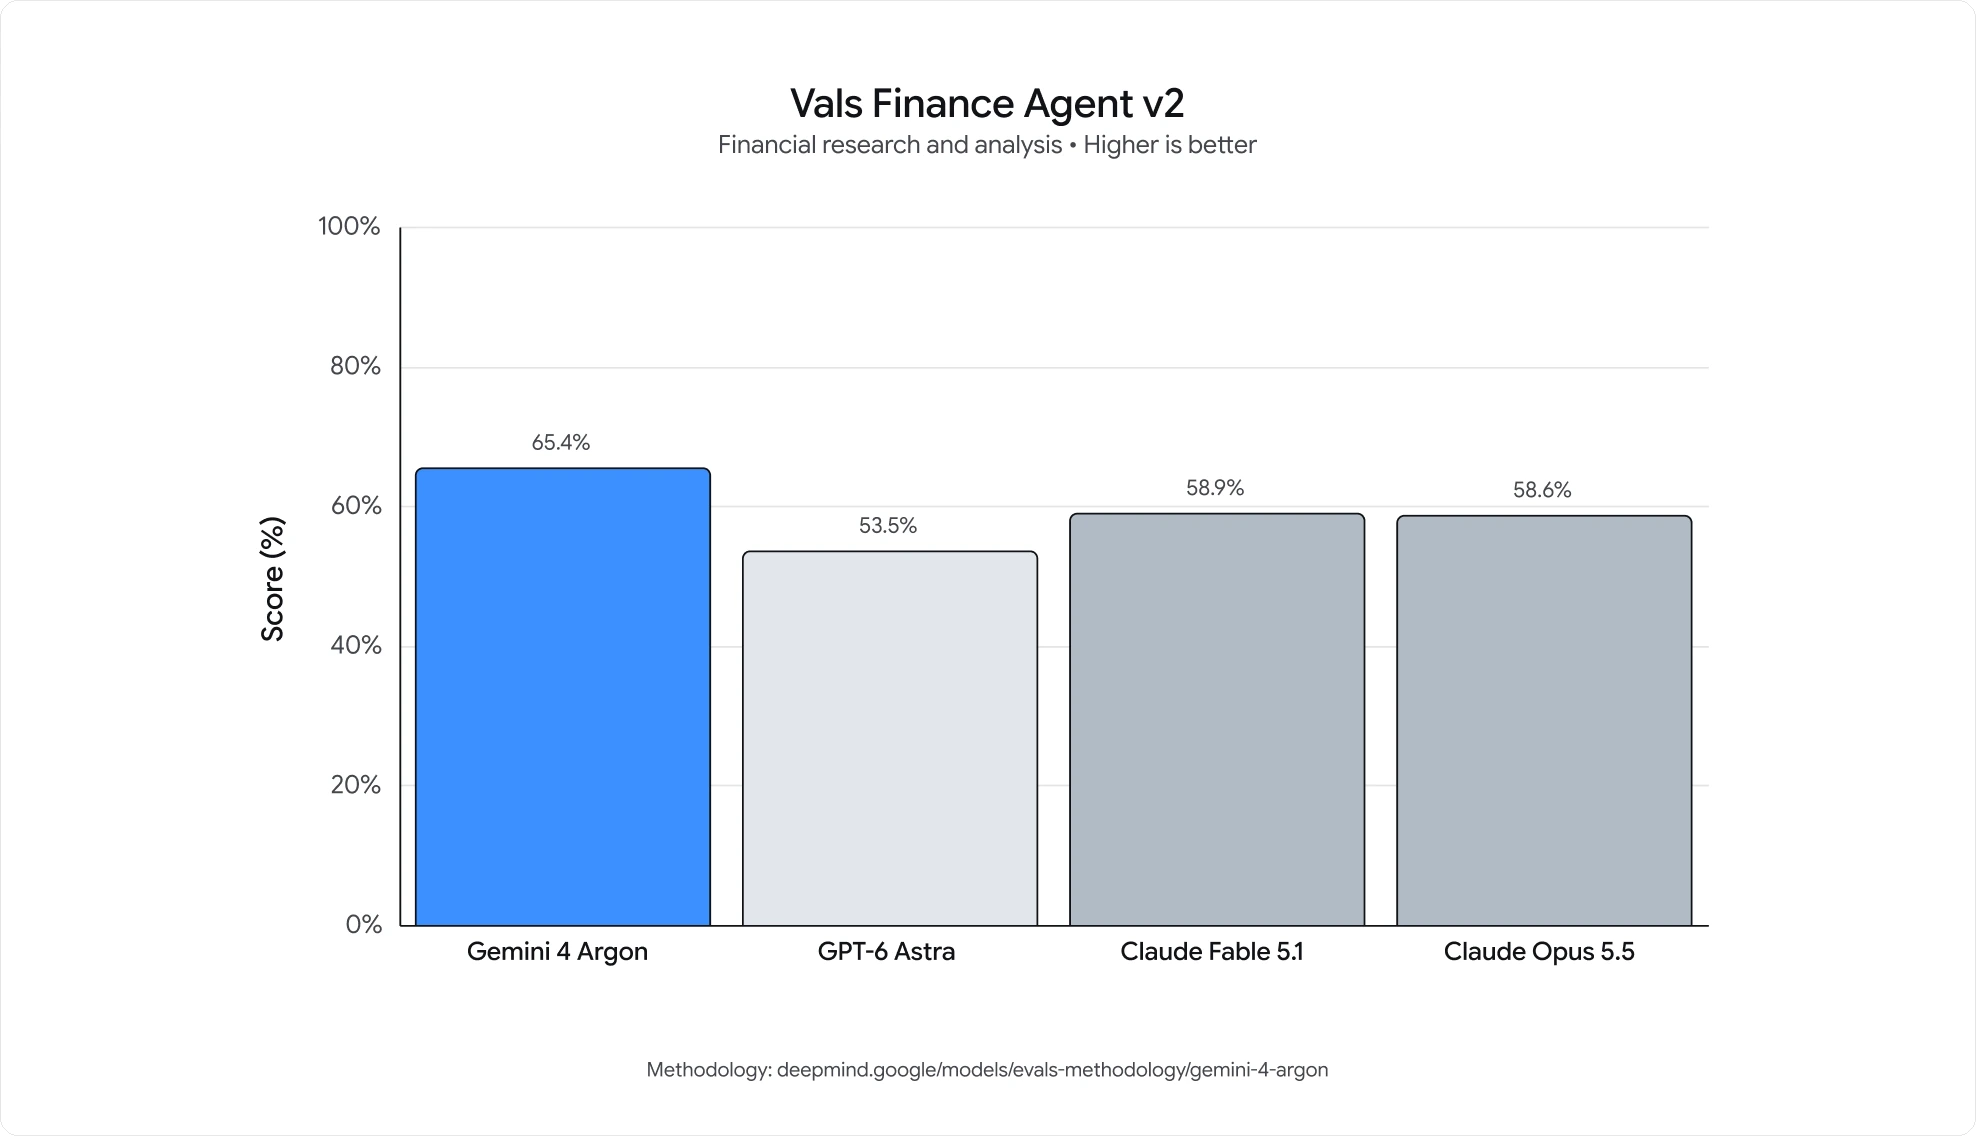
Die größten gemeldeten Abstände liegen bei Harvey's Legal Agent Benchmark und Vals Finance Agent v2 — echte juristische und finanzielle Analyse, keine synthetischen Aufgaben.

Langkontext-Retrieval, das trägt

Bei GraphWalks, das prüft, ob ein Modell einen Kontext von 256K bis 1M wirklich nutzen kann, meldet Google mehr als zehn Punkte Vorsprung vor anderen Flaggschiffen.

Langes Video verstehen

LVBench, das das Verständnis langer Videos misst, wird mit 91.7% angegeben — der höchste Wert, den Google für Argon nennt.
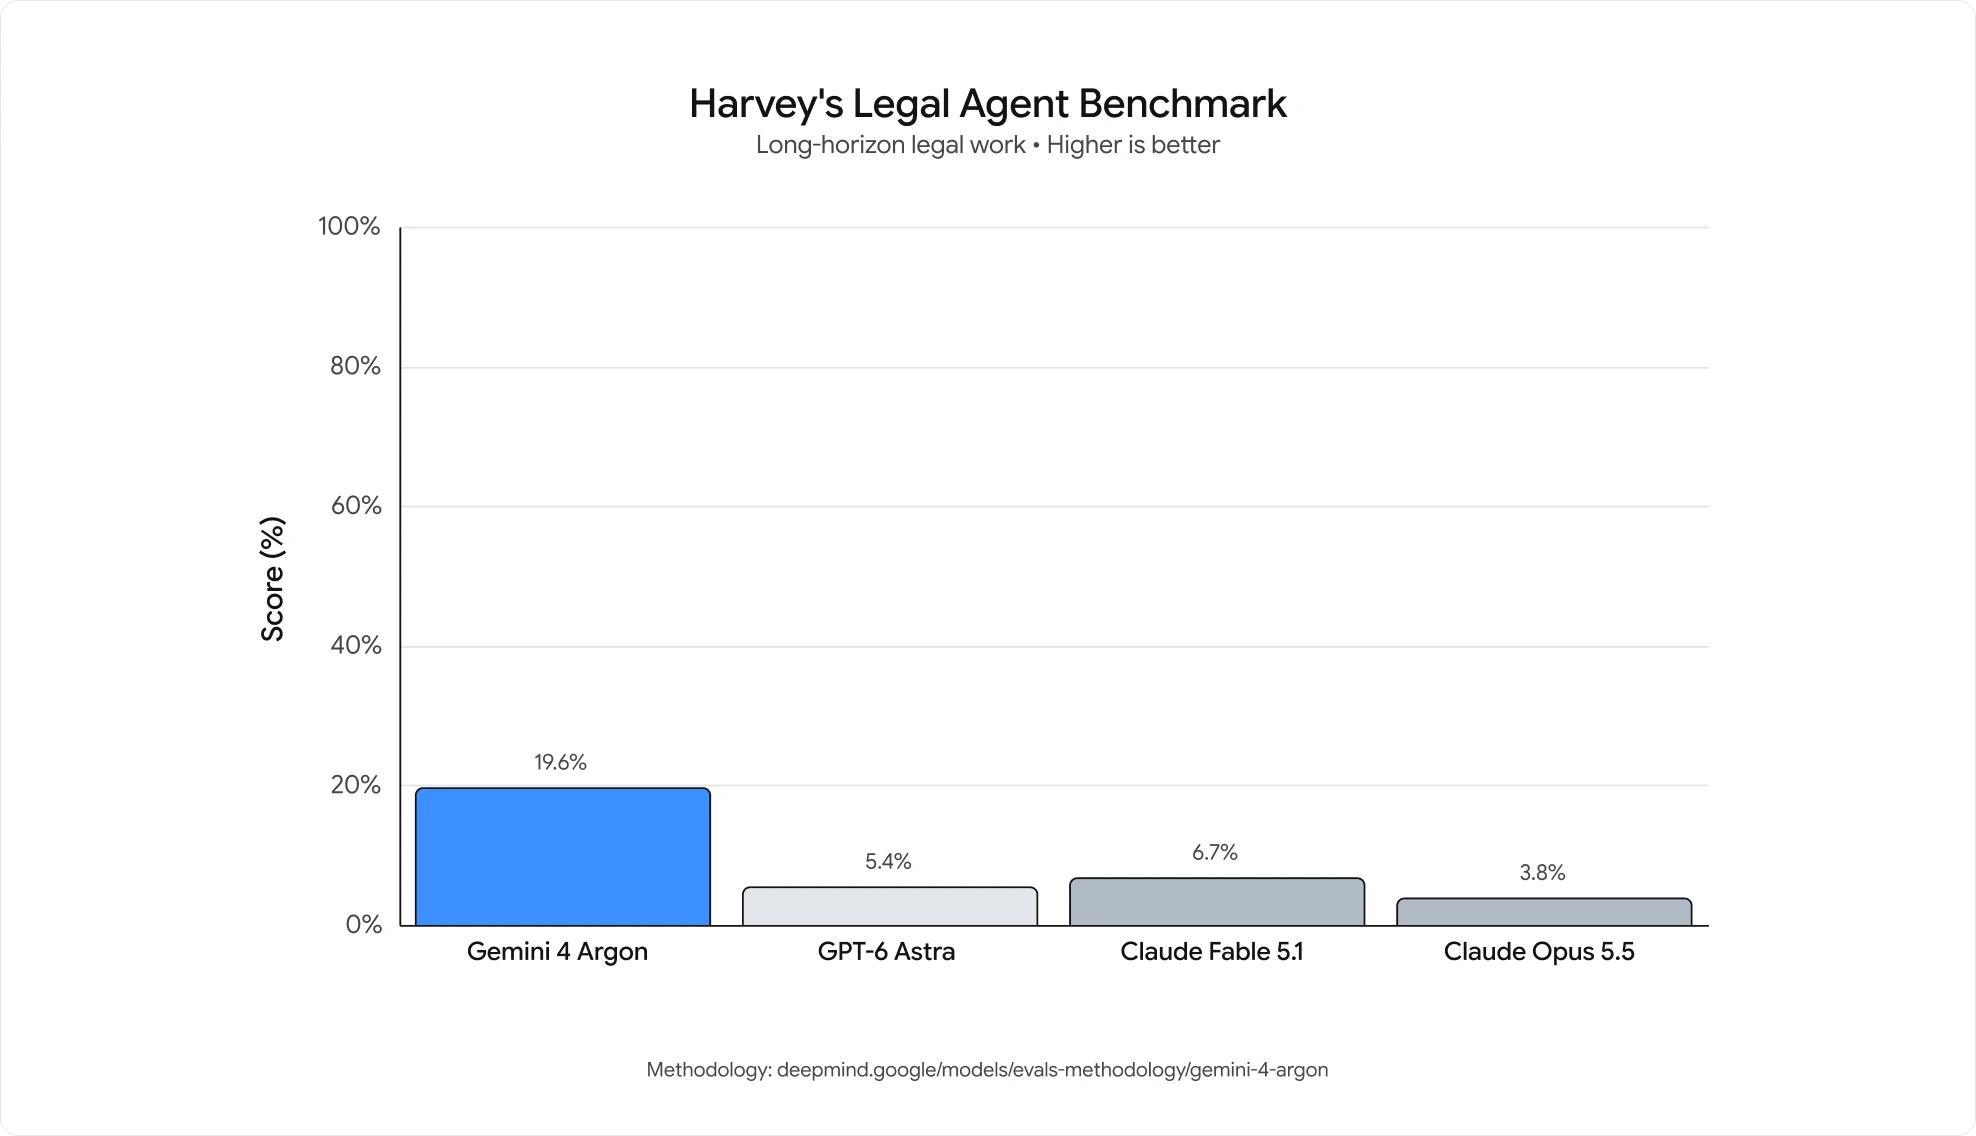
Balkendiagramm zu Harvey's Legal Agent Benchmark: Gemini 4 Argon 19.6%, Claude Fable 5.1 6.7%, GPT-6 Astra 5.4%, Claude Opus 5.5 3.8%
Langfristige juristische Arbeit. Mit 19.6% erreicht Argon rund das Dreifache des nächstbesten Modells — der größte Vorsprung in Googles veröffentlichter Auswahl.
Balkendiagramm zu Vals Finance Agent v2: Gemini 4 Argon 65.4%, Claude Fable 5.1 58.9%, Claude Opus 5.5 58.6%, GPT-6 Astra 53.5%
Finanzrecherche und -analyse: 65.4% gegenüber einem Feld von 53.5% bis 58.9%. Ein schmalerer Vorsprung als bei der juristischen Arbeit, aber dieselbe Reihenfolge.

Veröffentlichte Zahlen

Wo Argon in Googles eigenen Benchmarks steht

Das sind vom Anbieter gemeldete Ergebnisse. Google hat für die Spitzenwerte keine Thinking- oder Effort-Einstellung veröffentlicht, und kein unabhängiges Labor hat sie bisher nachgestellt.

Benchmark
Was gemessen wird
Argon
Nächster Vergleich
DeepSWE v1.1
Langfristige Software-Entwicklung
77.9%
Opus 5.5 mit 74.2%, GPT-6 Astra mit 74.1%
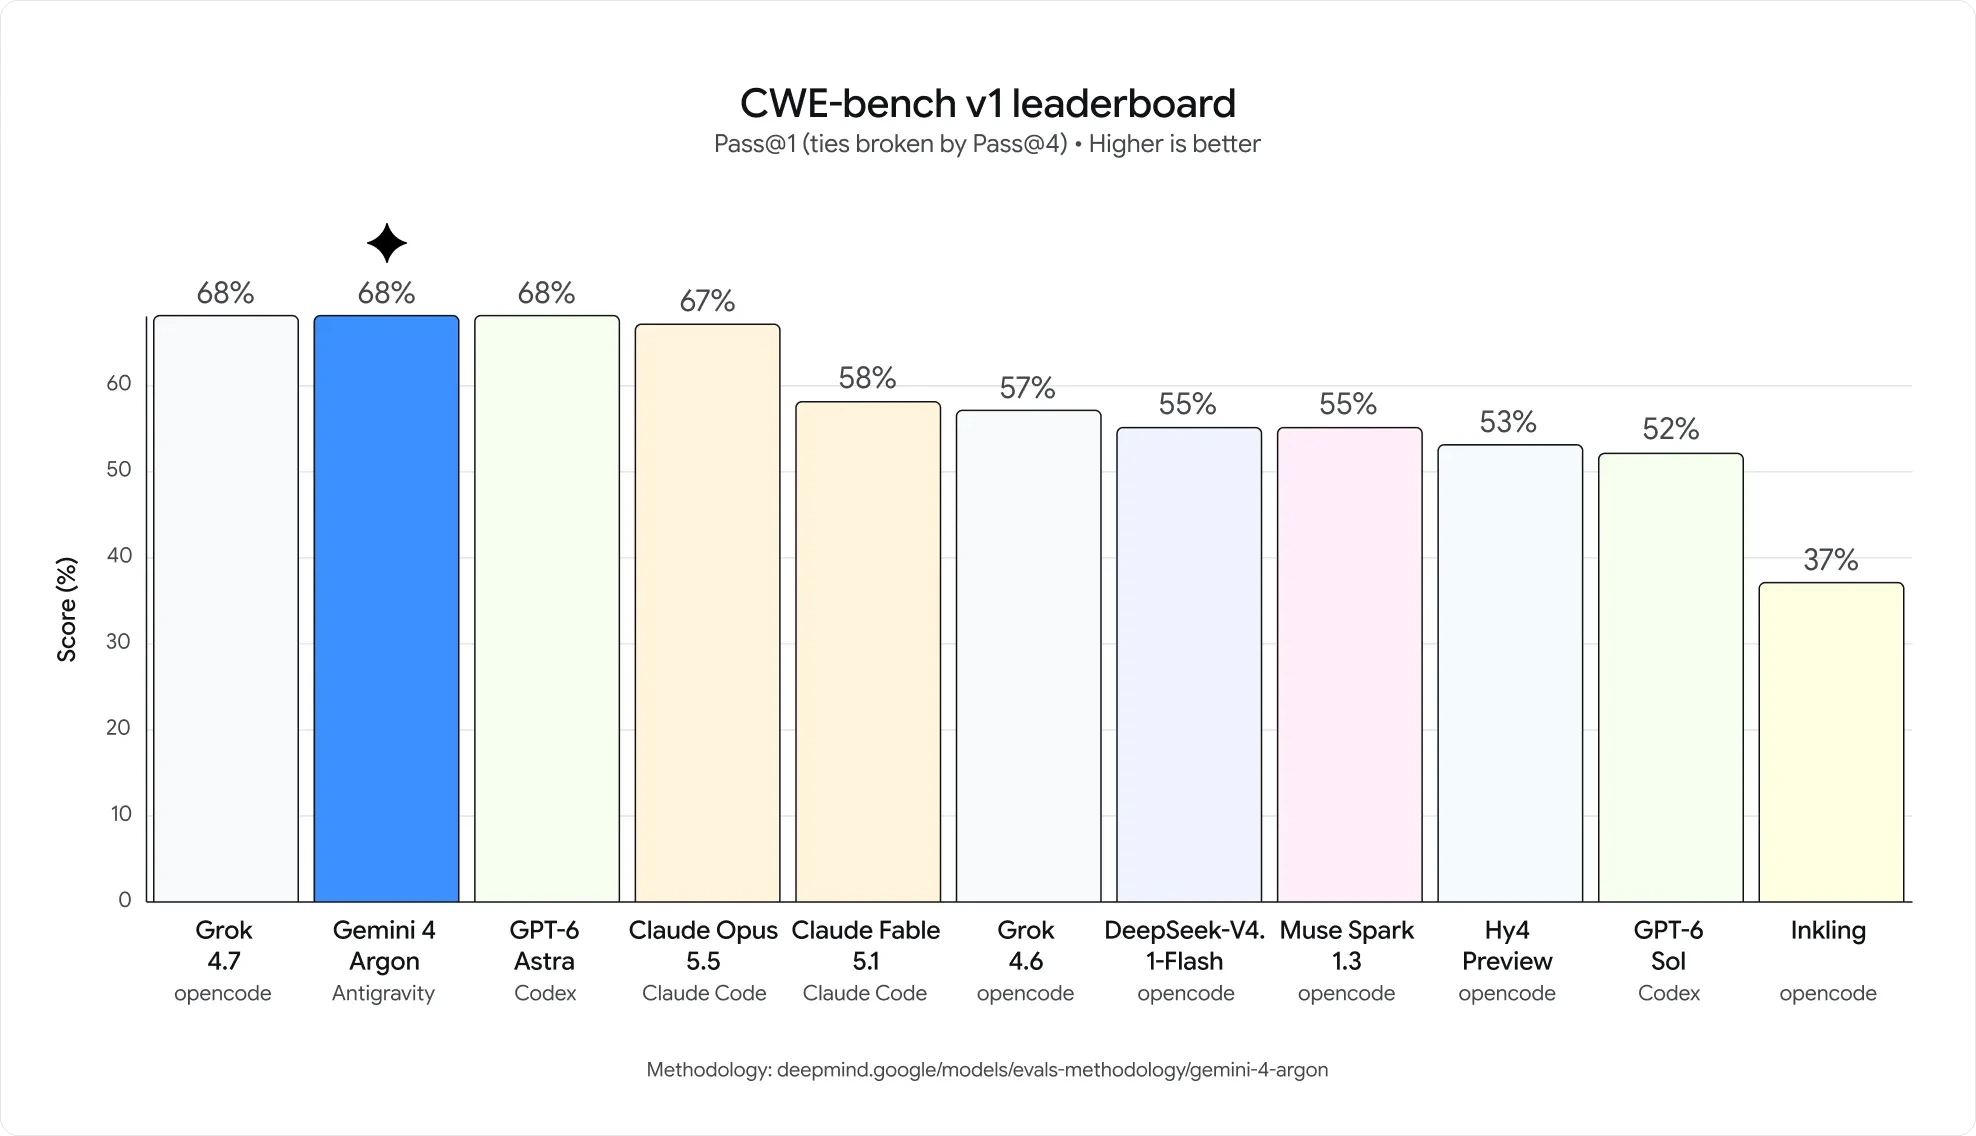
CWE-bench v1
Finden und Beheben von Sicherheitslücken
68%
Teilt sich den ersten Platz
AutomationBench
End-to-End-Geschäftsaufgaben, von Zapier
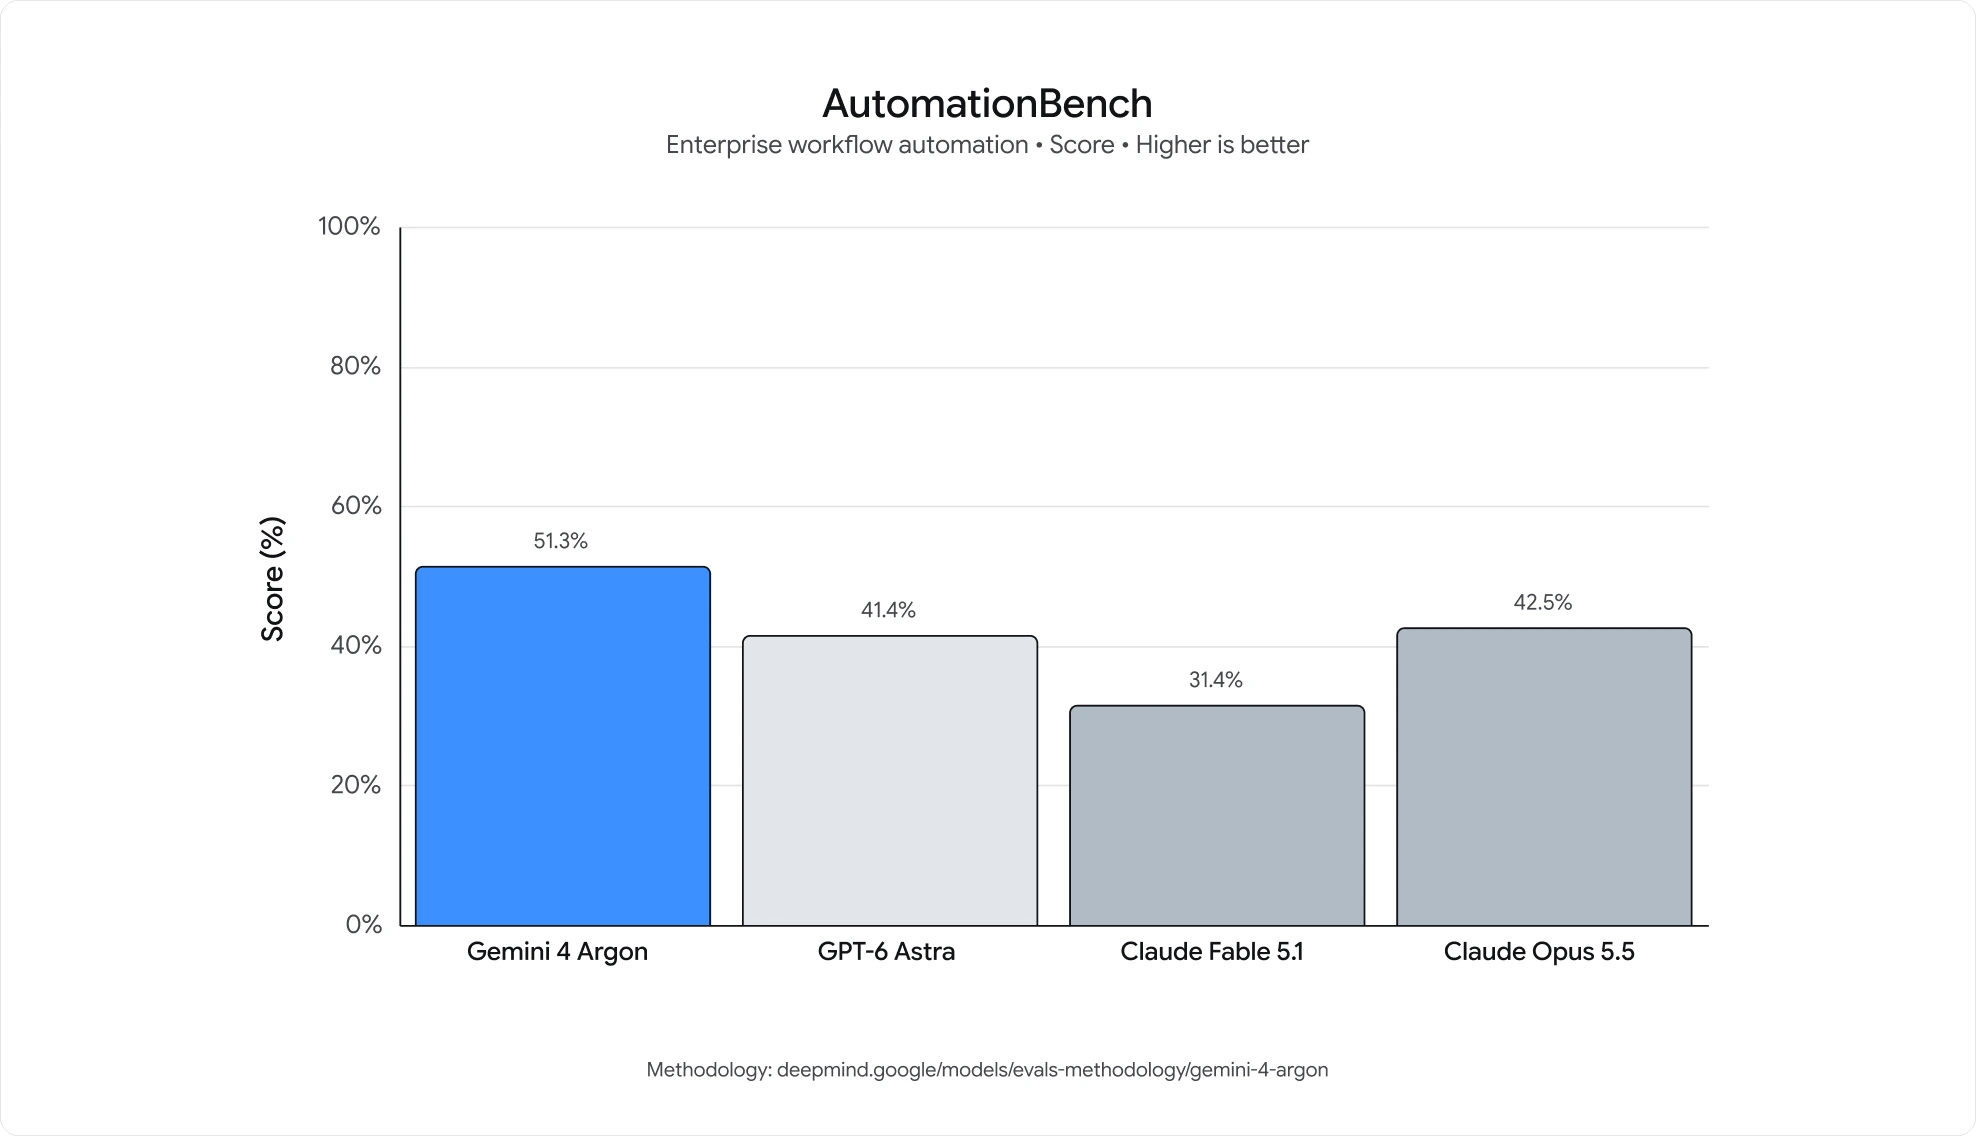
51.3%
Auf Platz eins
LVBench
Langes Video verstehen
91.7%
Höchster Wert, den Google für Argon nennt

Diese Werte sind eine Richtungsangabe. Anbieter-Benchmarks überstehen den Kontakt mit Produktionslast selten unverändert, und Bloomberg hat berichtet, dass selbst einige Google-Mitarbeiter bezweifeln, dass sich der Benchmark-Vorsprung auf echte Arbeit überträgt.
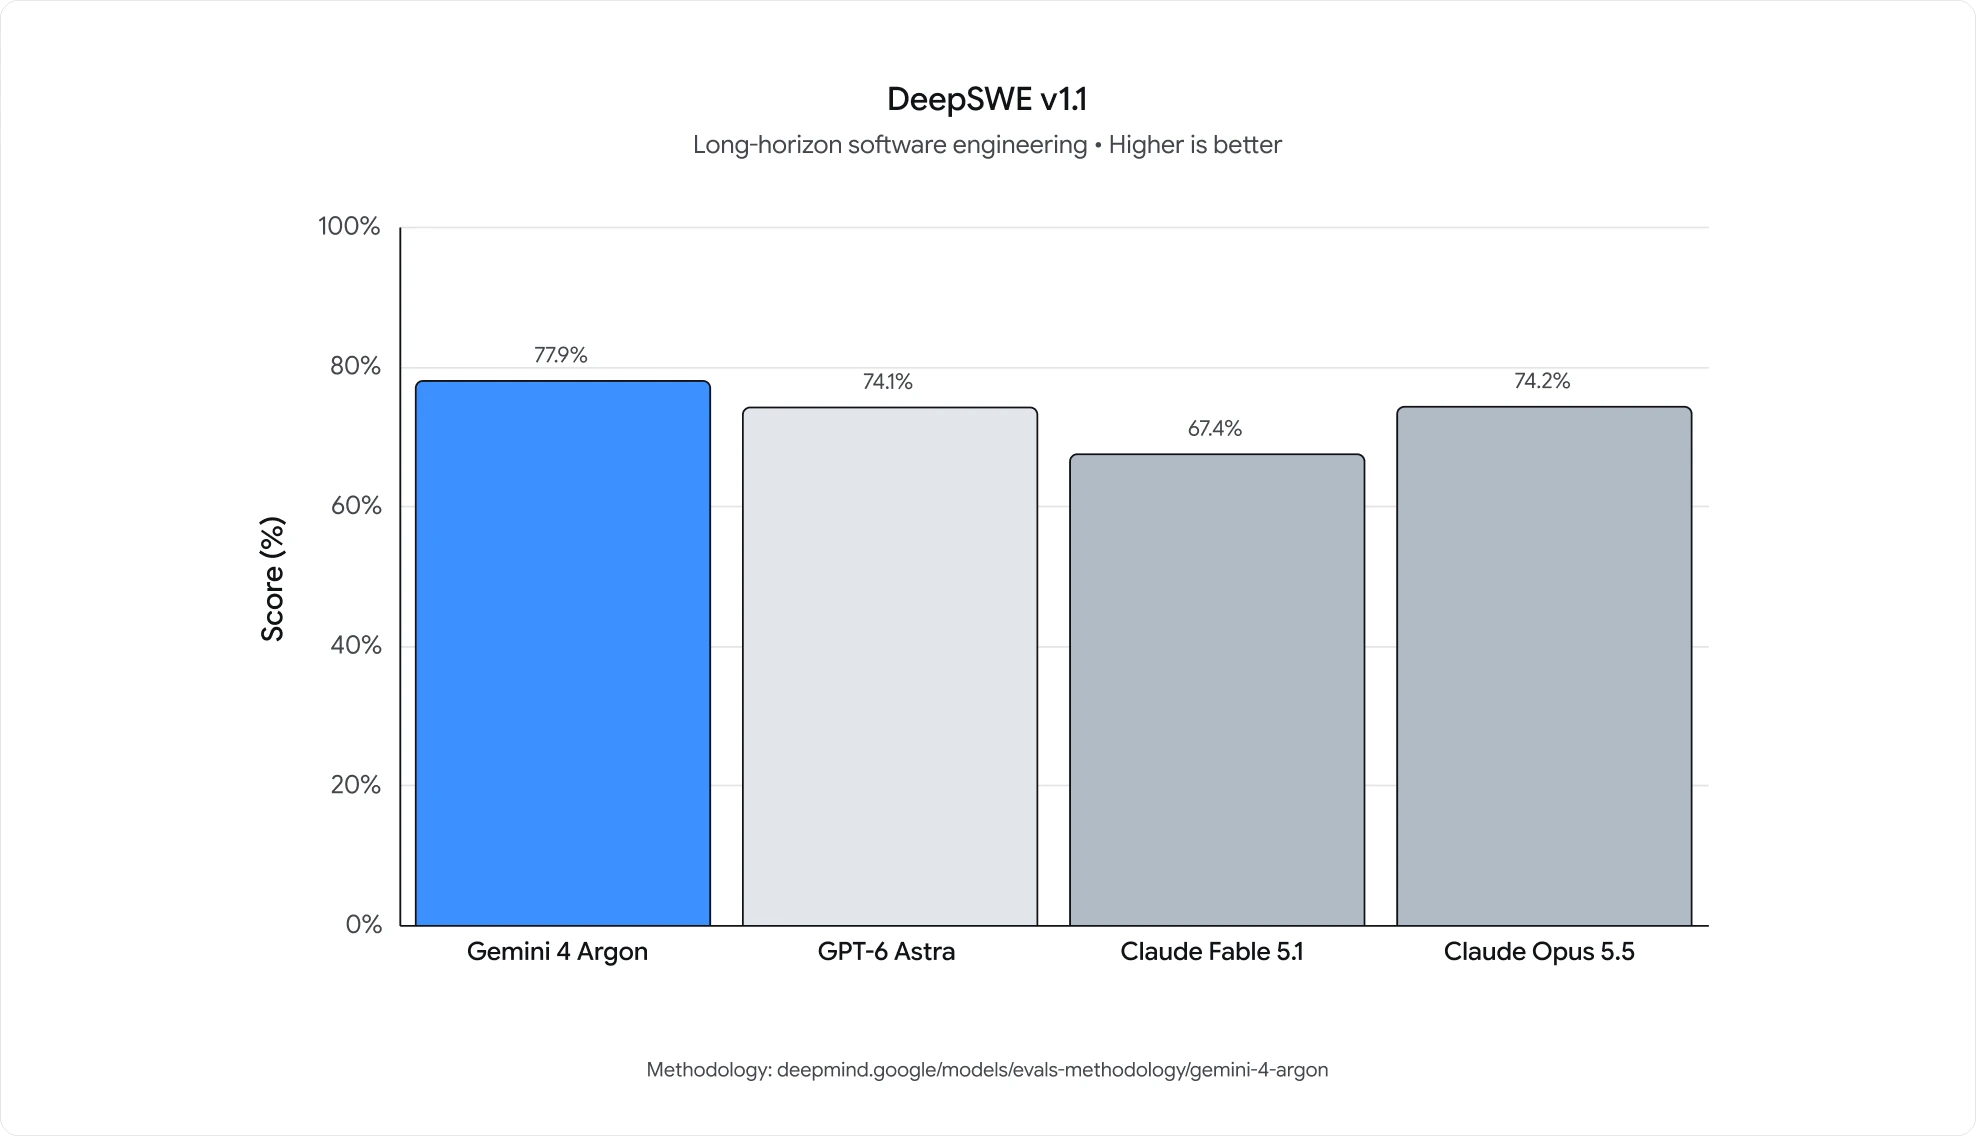
Balkendiagramm zu DeepSWE v1.1: Gemini 4 Argon 77.9%, Claude Opus 5.5 74.2%, GPT-6 Astra 74.1%, Claude Fable 5.1 67.4%
Langfristige Software-Entwicklung. Der Spitzenwert von 77.9%, mit beiden nächsten Wettbewerbern innerhalb von vier Punkten.
Balkendiagramm zu AutomationBench: Gemini 4 Argon 51.3%, Claude Opus 5.5 42.5%, GPT-6 Astra 41.4%, Claude Fable 5.1 31.4%
End-to-End-Geschäftsaufgaben, entwickelt von Zapier. Argon knackt die 50%-Marke, während jedes andere Vergleichsmodell im 30er- oder niedrigen 40er-Bereich liegt.
Rangliste zu CWE-bench v1: Gemini 4 Argon, Grok und GPT-6 Astra liegen mit 68% gleichauf, Claude Opus 5.5 bei 67%, abfallend bis Inkling bei 37%
Das Finden von Sicherheitslücken bei Pass@1. Argon teilt sich die Spitze eines dicht besetzten Feldes, statt eine Lücke aufzureißen — deshalb spricht die Tabelle oben von einem geteilten ersten Platz.
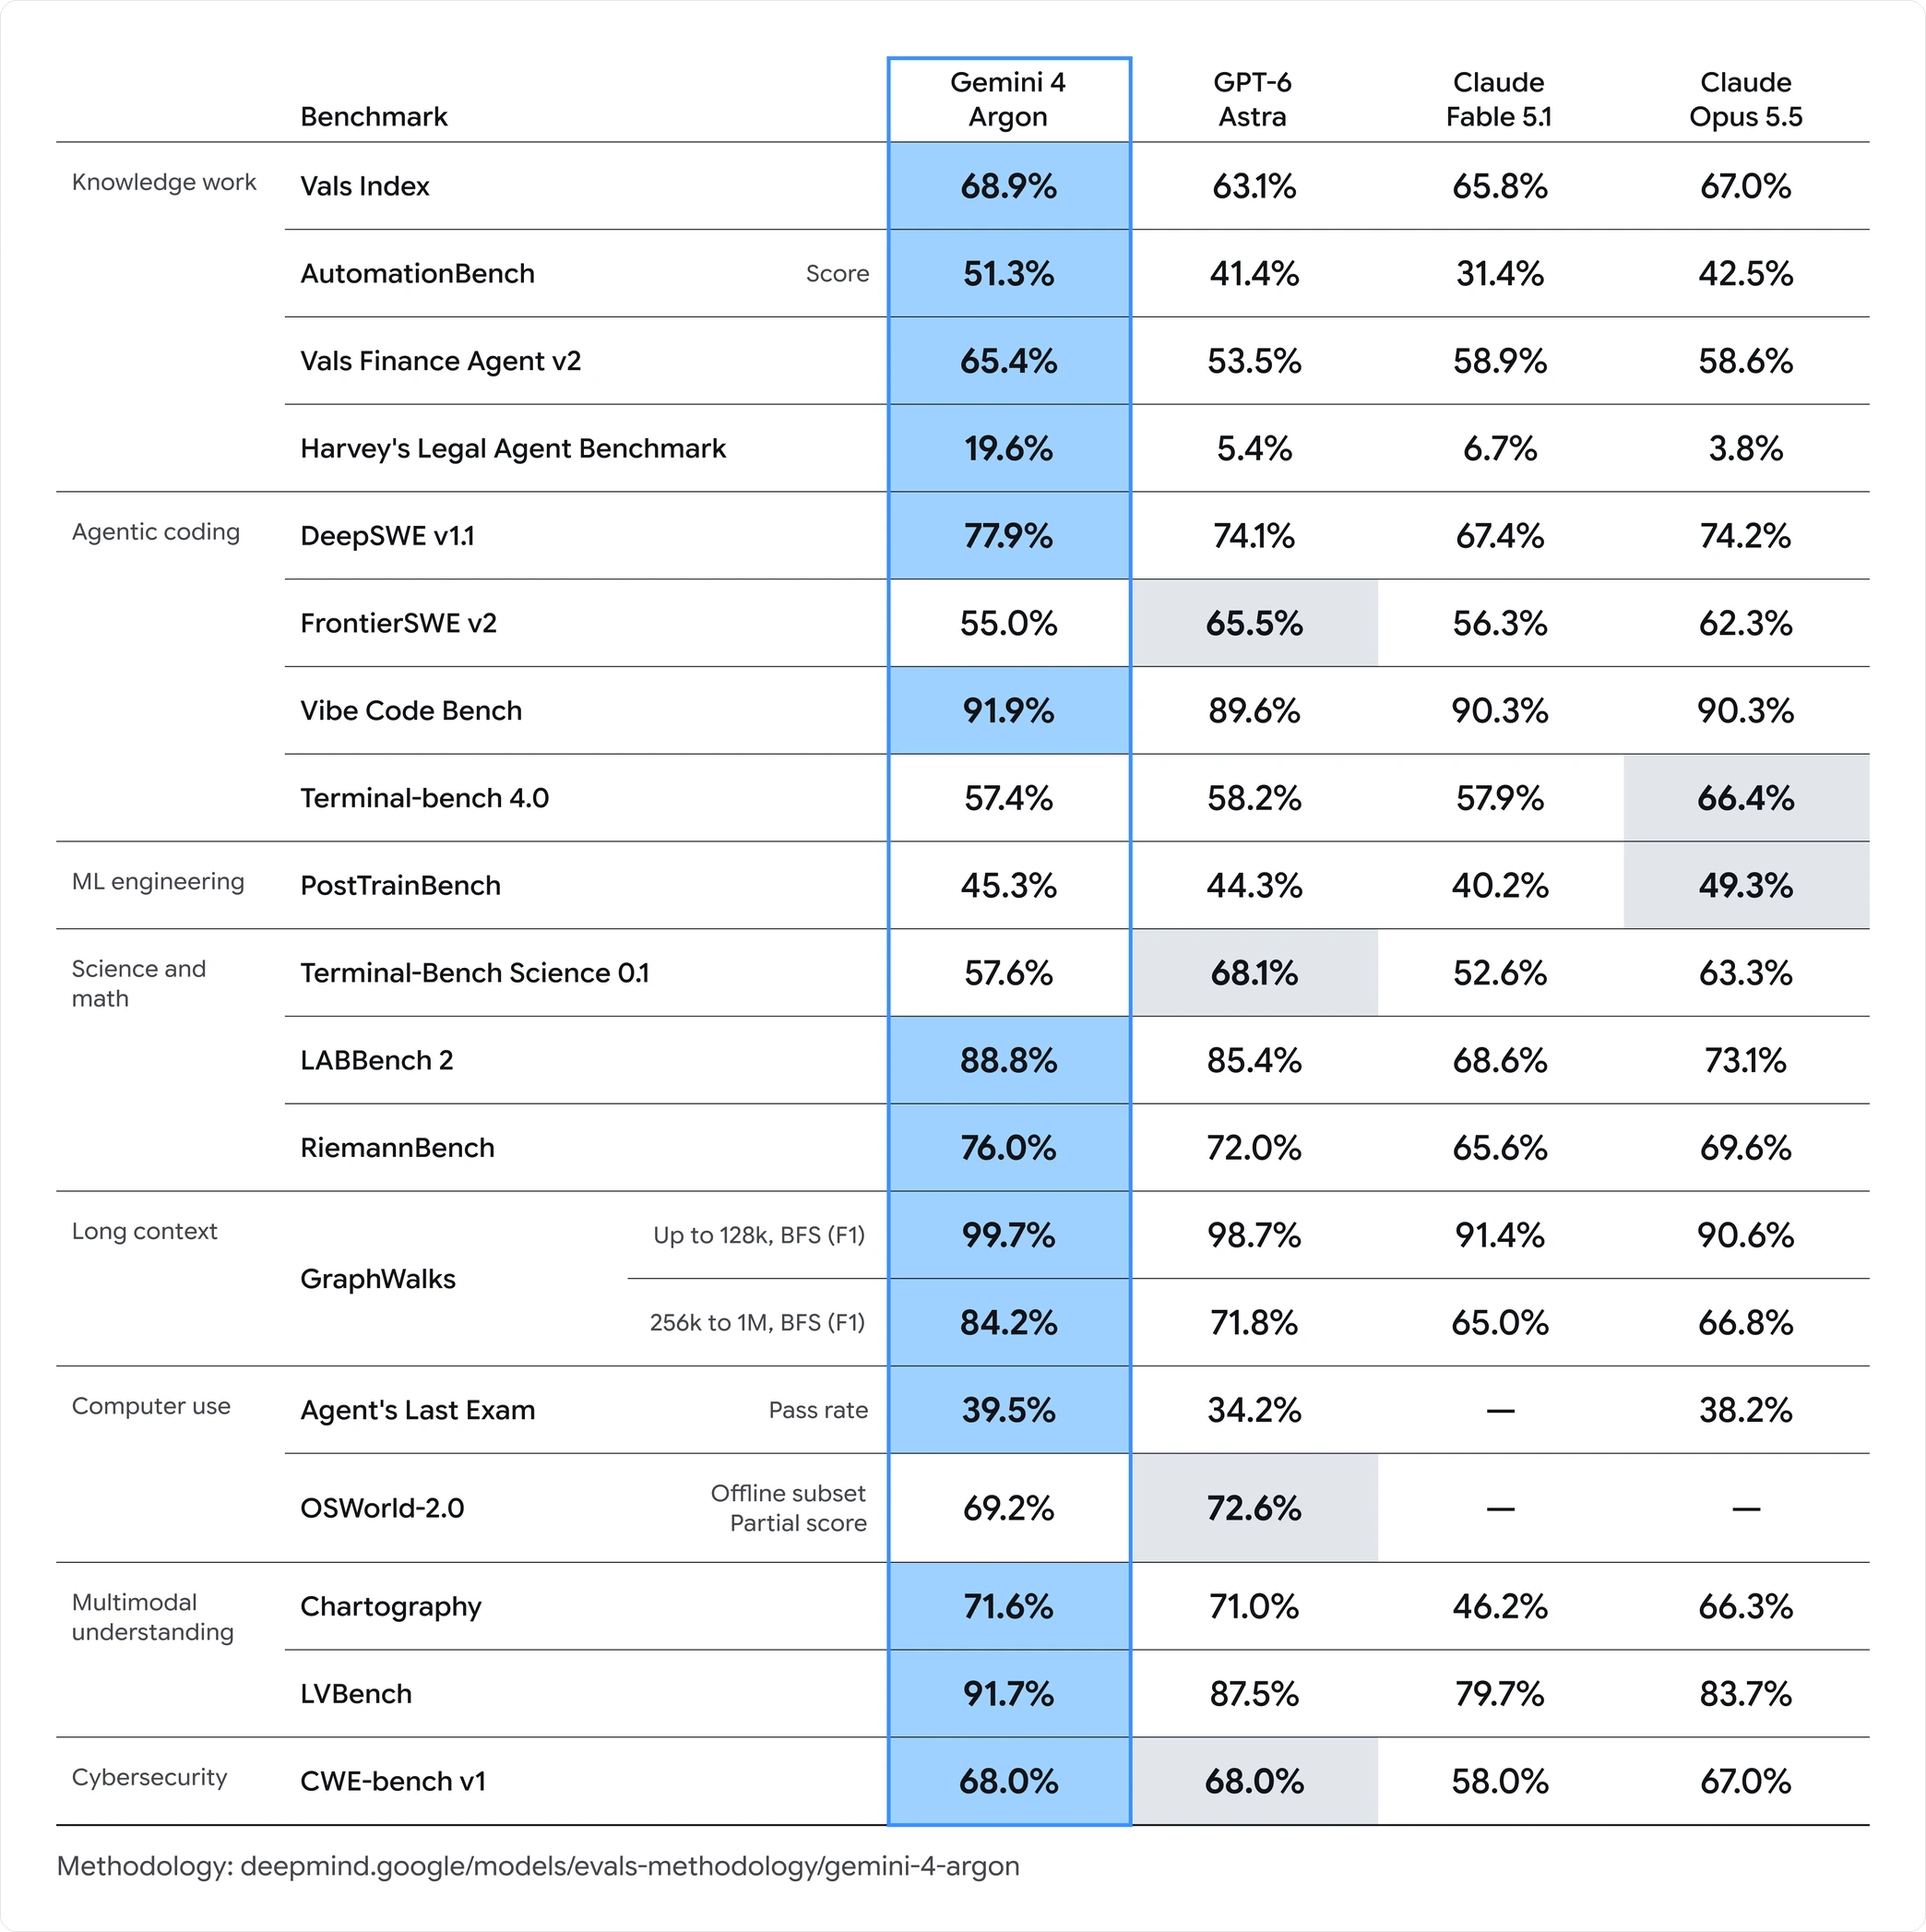
Googles vollständige Ergebnistabelle zu Gemini 4 Argon über 16 Benchmarks, gruppiert nach Wissensarbeit, agentischem Coden, ML-Engineering, Naturwissenschaft und Mathematik, langem Kontext, Computernutzung, multimodalem Verständnis und Cybersicherheit
Die vollständige Tabelle aus der Ankündigung: Argons Siege in Blau, die Zellen mit einem führenden Wettbewerber in Grau. FrontierSWE v2, Terminal-Bench 4.0, PostTrainBench, Terminal-Bench Science 0.1 und OSWorld-2.0 sind die Zeilen, in denen Argon nicht vorn liegt.
Balkendiagramm zur Halluzinationsrate von Artificial Analysis bei AA-Omniscience über 36 Modelle, sortiert vom niedrigsten Wert: Gemini 4 Argon (High) bei 15%, dann MiniMax-M3 bei 18%, Kimi K2.5 bei 26%, bis hin zu DeepSeek-V4 Flash bei 96%
Die unabhängige Messung von Artificial Analysis — und die einzige Zahl auf dieser Seite, die kein Anbieter geliefert hat: wie oft ein Modell falsch antwortet, statt die Antwort zu verweigern. Argons 15% sind der niedrigste Wert unter den 36 dargestellten Modellen; die Skala reicht bis 96%.
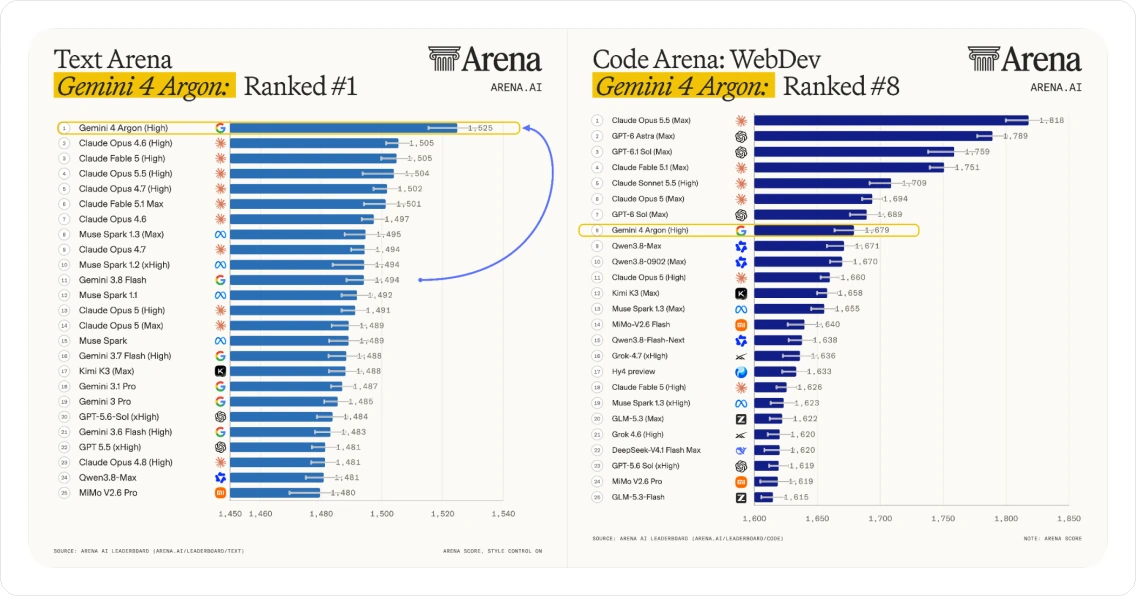
Die Ranglisten Text Arena und Code Arena: WebDev von Arena.ai nebeneinander: Gemini 4 Argon auf Platz 1 in der Text Arena mit 1625 und auf Platz 8 in Code Arena: WebDev mit 1679
Die beiden Ranglisten, auf denen der Absatz oben beruht, aus den von Nutzern abgestimmten Listen von Arena.ai. Argon führt die 25 gelisteten Modelle der Text Arena an; in Code Arena: WebDev liegt es auf Platz acht, hinter vier Claude-Modellen und drei aus der GPT-6-Reihe von OpenAI.

Auf Felo

Wie ein Recherche-Workflow mit einem 1M-Token-Schreiber aussieht

Felo verbindet Suche mit Dokumentenverständnis, deshalb verändert ein Modell mit langer Ausgabe, was eine einzelne Sitzung leisten kann.

Recherche, die in einem Dokument endet

Quellen sammeln und die Synthese dann in einem Durchgang schreiben lassen, statt sie über viele Prompts Abschnitt für Abschnitt zusammenzusetzen.

Ganze Dokumentensätze in einer Aufgabe

Langkontext-Retrieval ist die Fähigkeit, in der Argon am stärksten ist — genau das macht Vertragssätze, Einreichungen und lange Berichte handhabbar.

Entwürfe, bei denen der Ton zählt

Argons gemeldetes Profil — starker Text, mittelmäßiges Coden — passt zu Teams, die Prosa brauchen, die geschrieben und nicht zusammengesetzt wirkt.

Kosten

Was Argon kostet und was sich später ändert

Google hat einen Einführungspreis und einen höheren Listenpreis veröffentlicht, ohne zu sagen, wann der Wechsel kommt. Planen Sie mit der höheren Zahl.

Token-Art
Einführung
Später
Eingabe
2,00 $ / Mio.
4,00 $ / Mio.
Zwischengespeicherte Eingabe
95% günstiger
95% günstiger
Ausgabe
10,00 $ / Mio.
20,00 $ / Mio.

Zum Vergleich: Der Einführungspreis liegt etwa auf dem Niveau von GPT-6.1 Sol und Sonnet 5.5 und bei rund einem Fünftel von GPT-6 Astra. Das sind Listenpreise, keine gemessenen Kosten pro Aufgabe — Argon beantwortet schwierigere Fragen, ein einzelner Lauf kann also trotzdem mehr kosten.

So arbeiten Sie mit Argon auf Felo

01

Die ganze Frage mitbringen

Geben Sie Felo den Dokumentensatz oder den langen Thread, nicht eine Zusammenfassung davon. Argons Vorteil beginnt dort, wo der Kontext nicht mehr in einen Prompt passt.

02

Das fertige Ergebnis anfordern

Mit einer Ausgabegrenze von 1M Token können Sie den vollständigen Bericht oder den kompletten Entwurf in einer Anweisung verlangen statt in Abschnitten.

03

Gegen die Quellen prüfen

Felo behält die Belege an der Antwort, und genau das macht ein langes modellgeneriertes Dokument überprüfbar.

Der Argon-Zugang in der Felo-Suche ist in Arbeit. Bis er öffnet, ist jedes andere Modell im Felo-Angebot sofort verfügbar.

Felo-AI-Suche öffnen

Gemini 4 Argon: häufige Fragen

Nicht allgemein. Google hat Argon zuerst an ausgewählte Partner im Fairwind-Programm herausgegeben und sagt, dass der breitere Zugang mit zahlenden API-Kunden und Abonnenten von Google AI Ultra beginnt. Für diese Stufe wurde kein Datum genannt, und ein kostenpflichtiges Abo gewährt heute keinen Zugang.

Testen Sie Googles Frontier-Modelle auf Felo

Suchen, lesen und schreiben mit dem Modell, das zur Aufgabe passt. Argon kommt ins Angebot, sobald sein Rollout Felo erreicht.

Felo-AI-Suche öffnen

Für die Felo-AI-Suche ist keine Kreditkarte nötig.