01
Tenir tout le contexte
Une fenêtre de contexte d'un million de tokens et des connaissances arrêtées à juin 2026. Un long fil, un dépôt entier ou un dossier complet tiennent dans une seule tâche.
Anthropic a publié Opus 5.5 le 22 septembre 2026
Le premier modèle de la famille Claude 5.5. Il atteint le niveau de Claude Fable 5.1 sur la plupart des tâches, coûte 40 % moins cher à l'usage qu'Opus 5 et génère sa sortie plus de 30 % plus vite.
Désormais dans la recherche Felo
Claude Opus 5.5 est disponible dans la recherche Felo pour les tâches à entrée longue : recouper des chiffres entre plusieurs fichiers, remonter une affirmation jusqu'à sa source et produire une réponse que vous pouvez transmettre telle quelle.
01
Une fenêtre de contexte d'un million de tokens et des connaissances arrêtées à juin 2026. Un long fil, un dépôt entier ou un dossier complet tiennent dans une seule tâche.
02
Dans un test interne d'Anthropic, 16 rapports sur 18 ont passé le seuil de qualité. Un seul chiffre ou une seule citation inventés faisaient échouer l'exercice.
03
Anthropic a revu la façon dont le modèle communique : l'essentiel vient en premier, et le rapport indique clairement ce qui est terminé, ce qui a été trouvé et ce qui reste ouvert.
Prise en main rapide
Claude Opus 5.5 apparaît dans le sélecteur de modèle aux côtés des autres modèles de tête de votre compte.
Ce qui change avec Opus 5.5
Anthropic met en avant l'efficacité plutôt qu'un score de benchmark plus élevé : moins de tokens par tâche, un prix au token plus bas et 40 % de coût en moins sur les charges de travail typiques. C'est ce qui rend enfin abordable le travail d'agent qui tourne longtemps.
01
Anthropic rapporte qu'un testeur a audité et corrigé une base de 200 000 lignes en moins de trois heures, là où Opus 5 y passait plus de 20 heures avec 2,5 fois plus de tokens.
02
Deloitte rapporte qu'au niveau d'effort le plus bas, Opus 5.5 a détecté 72 % des bugs connus en revue de code, contre 56 % pour Opus 5 en high, avec moins de faux positifs.
03
Les textes sont plus courts et mieux structurés. Box rapporte des réponses 40 % moins verbeuses à précision égale, pour un tiers des tokens d'Opus 5.
Choix du modèle
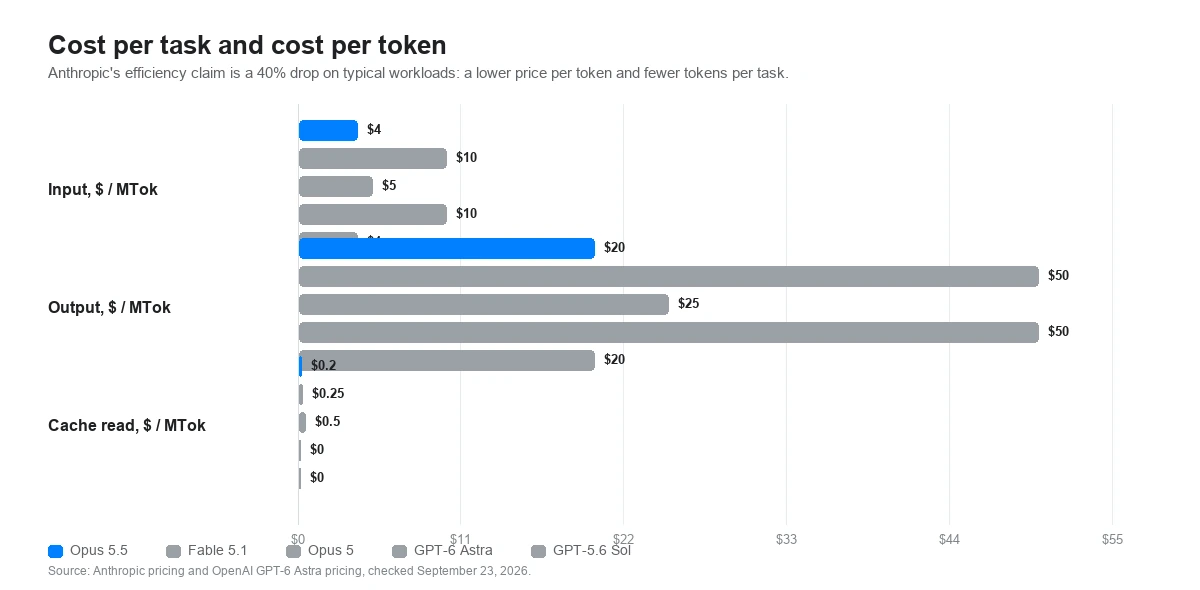
Les tarifs ci-dessous sont les tarifs publics officiels de l'API par million de tokens, pas les prix d'abonnement ou d'usage de Felo. La ligne effort compte autant que la ligne prix : un même prompt peut coûter très différemment selon le point de départ de chaque modèle.
Les tarifs publics de l'API et les valeurs par défaut ont été vérifiés le 23 septembre 2026 dans l'annonce de Claude Opus 5.5 par Anthropic, les pages de modèles de la Claude Platform et la page GPT-6 Astra d'OpenAI. Le prix au token ne représente qu'une partie du coût total d'une tâche. L'affirmation d'efficacité d'Anthropic est une baisse de 40 % sur des charges de travail typiques, qui combine un prix au token plus bas et moins de tokens par tâche.
Résultats publiés par Anthropic
Anthropic a publié ses propres chiffres aux côtés de Fable 5.1, Opus 5, GPT-6 Astra et GPT-5.6 Sol. Deux des quatre graphiques ci-dessous montrent la précision en fonction du coût par tâche plutôt que la précision seule, parce que c'est exactement la comparaison que fait Anthropic.
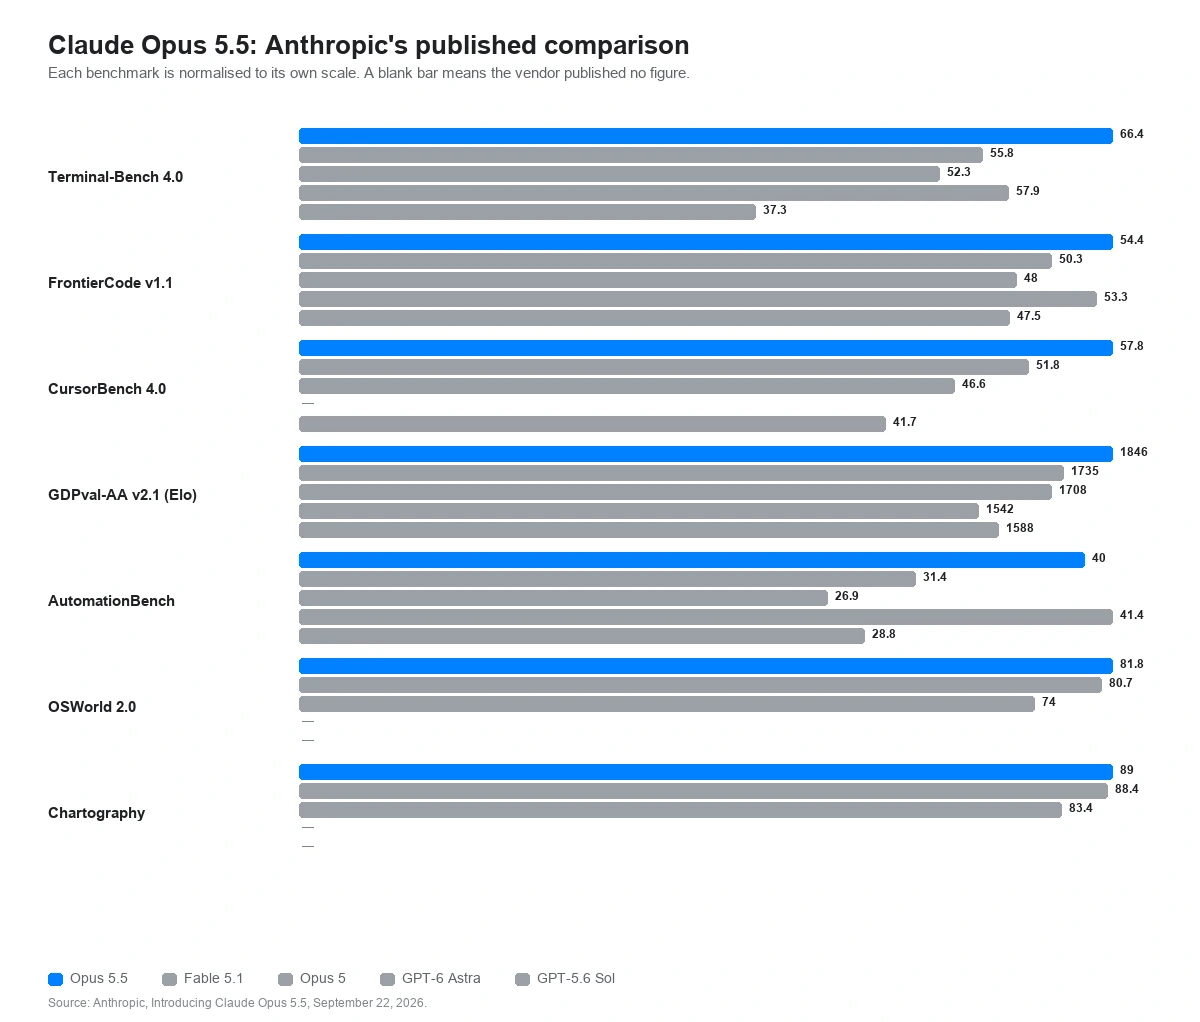
La comparaison publiée dans son intégralité
Codage agentique, travail de connaissance, processus métier, raisonnement pluridisciplinaire, recherche scientifique, usage de l'ordinateur et lecture de graphiques, sur les cinq modèles mesurés.
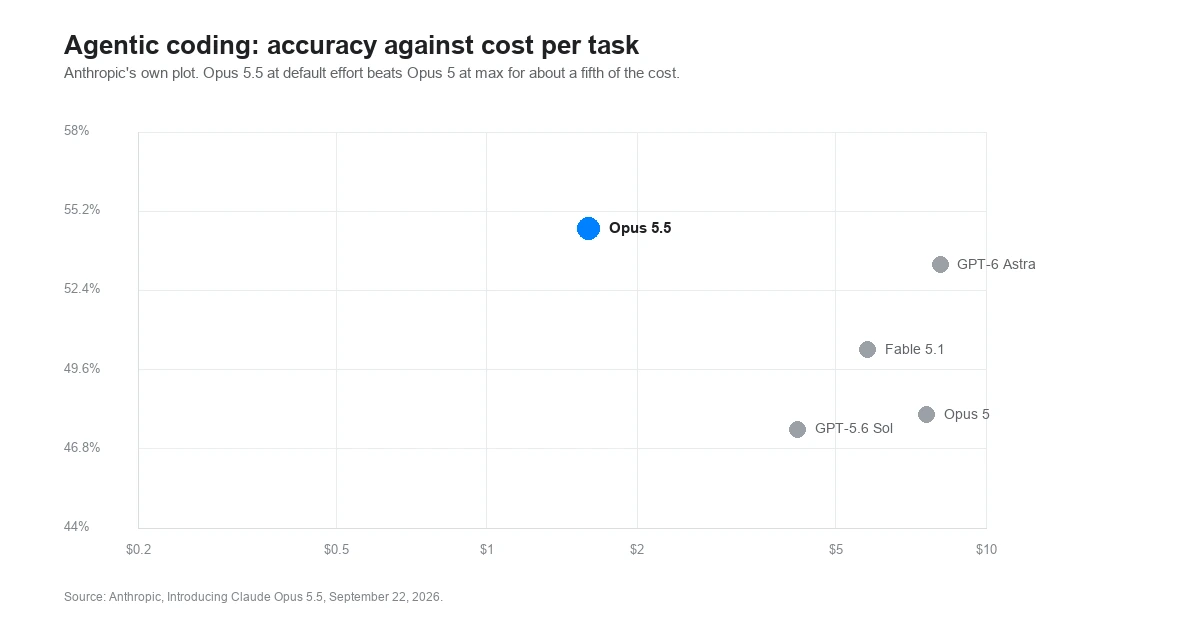
Codage agentique
Terminal-Bench 4.0, FrontierCode v1.1 et CursorBench 4.0, tracés en précision selon le coût par tâche.
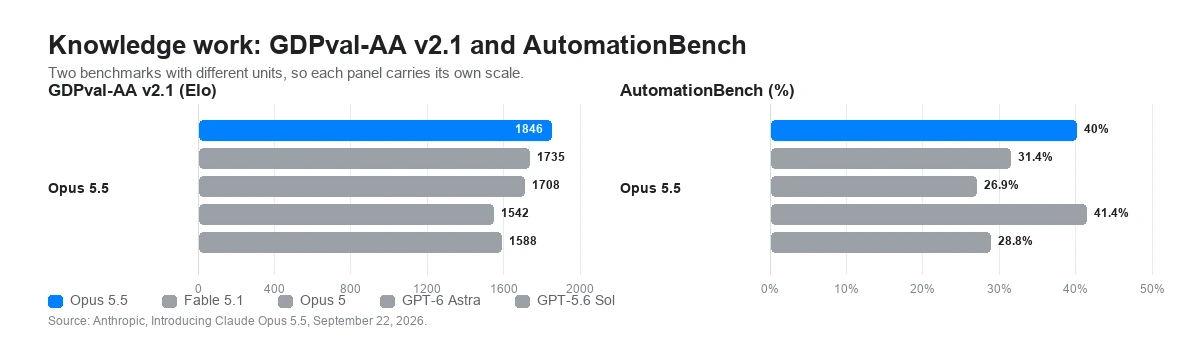
Travail de connaissance
GDPval-AA v2.1 sur 44 métiers, AutomationBench et WANDR, le benchmark de collecte de données de Perplexity.
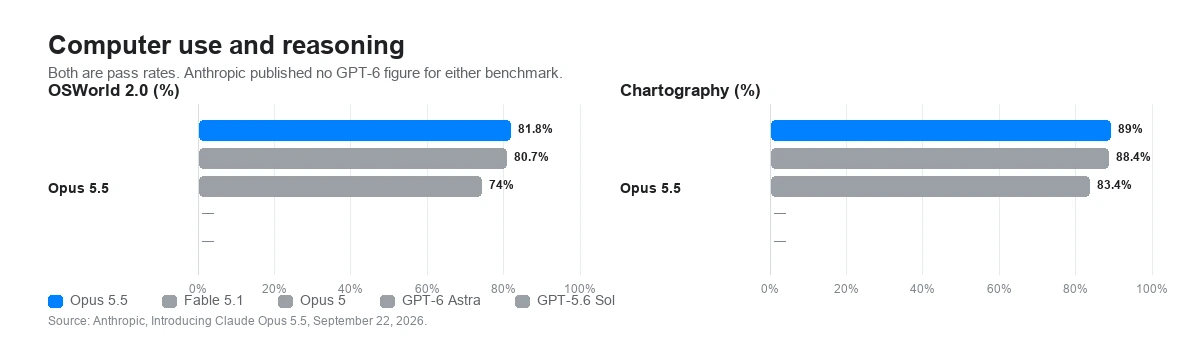
Usage de l'ordinateur et raisonnement
OSWorld 2.0, Humanity's Last Exam et Chartography, ce dernier mesurant la précision de lecture de valeurs sur un graphique.
Précision selon le coût par tâche
L'argument central d'Anthropic n'est pas un meilleur score à tout prix, mais le même score, ou un meilleur, pour une fraction du coût par tentative.
Chiffres publiés par l'éditeur. Sauf mention contraire, Anthropic a exécuté Opus 5.5 avec la réflexion adaptative en max effort et l'a évalué avec les protections de production activées. Lorsque ces protections sont intervenues, les tâches de cybersécurité ont été traitées par Opus 4.8 et les tâches de biologie par Opus 5, ce qui abaisse probablement les chiffres publiés d'Opus 5.5 sur ces benchmarks. Les chiffres de GPT-6 Astra et GPT-5.6 Sol sont ceux rapportés par OpenAI. Les écarts de benchmark entre éditeurs restent un faible indicateur des différences réelles, ce qu'Anthropic dit elle-même de ces chiffres.
Si vous faites déjà tourner Opus 5
Anthropic liste quatre changements majeurs pour les intégrations déjà en production sur Claude Opus 5, plus un cinquième qui modifie la forme de la réponse sans faire échouer la requête. À lire avant de remplacer l'identifiant du modèle, car trois d'entre eux renvoient une erreur 400 au lieu de se dégrader en silence.
01
Sur Opus 5, la réflexion pouvait être désactivée jusqu'à high inclus. Sur Opus 5.5, elle est toujours active, et la désactivation comme le budget de tokens manuel renvoient une erreur 400. L'effort devient le seul levier, et sa valeur par défaut passe de high à medium.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice défini sur "any" ou sur un outil nommé renvoie une erreur 400, y compris sur l'endpoint de comptage de tokens. Utilisez auto avec l'appel d'outil strict ou les sorties structurées, et précisez dans le prompt quand l'outil doit servir.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Chaque bloc de réflexion enregistre le modèle qui l'a produit. Opus 5.5 lit les blocs d'Opus 5 et des modèles Opus, Sonnet et Haiku antérieurs, mais pas ceux de Fable ni de Mythos. Si un routeur bascule la conversation vers un autre modèle, les tours suivants s'exécutent sans le raisonnement précédent.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 conservent la réflexion ; les autres modèles la perdent
04
Sur l'API Claude et Google Cloud, l'outil computer_20251124 renvoie une erreur 400. Déclarez plutôt le toolset computer_toolset_20260801, retirez l'en-tête bêta et adaptez la boucle d'agent aux blocs member tool_use. Sur Amazon Bedrock, l'ancien outil fonctionne toujours.
computer_20251124 -> computer_toolset_20260801
Puisque la réflexion ne peut plus être désactivée, c'est l'effort que l'on règle. Opus 5.5 prend en charge les cinq niveaux et démarre à medium, un cran sous Opus 5. Anthropic recommande de refaire une campagne de mesure sur vos propres évaluations plutôt que de reconduire un réglage, et de prévoir un max_tokens généreux aux niveaux élevés, car les tokens de réflexion y sont comptés même lorsque le texte de réflexion n'est pas renvoyé.
L'effort est un signal de comportement, pas un budget de tokens strict : à un niveau plus bas, le modèle réfléchit toujours sur les problèmes vraiment difficiles, simplement moins qu'à un niveau supérieur. Anthropic note aussi qu'Opus 5.5 réfléchit davantage par tour qu'Opus 5 à niveau égal, surtout en xhigh et max. Un réglage repris d'Opus 5 produira donc des tours plus longs et plus coûteux.
Là où il trouve sa place
Opus 5.5 vaut le coup quand une tâche dure des heures, couvre plus de fichiers qu'une personne ne peut en tenir, ou produit un livrable qu'un tiers doit vérifier. Ce sont les cas décrits par Anthropic et ses premiers testeurs, pas des prompts de conversation génériques.
Mener une modification à travers un grand dépôt jusqu'à ce que les tests passent, plutôt que de s'arrêter au premier correctif plausible. Anthropic rapporte une migration de 680 000 lignes terminée en moins d'une journée par un testeur.
Column, testeur cité par Anthropic, rapporte avoir trouvé un bug en consultant la documentation externe d'une intégration tierce mal modélisée plusieurs commits plus tôt.
Construire le modèle, puis la synthèse d'une page, en conservant les réserves. Anthropic rapporte une analyse de fusion terminée en 63 minutes contre 93 pour Opus 5, pour moitié moins cher.
Il délègue à des sous-agents et cale son rythme sur un budget de temps. Anthropic recommande de fournir à une architecture multi-agents un signal de temps écoulé pour qu'elle parallélise au lieu de sérialiser.
01
Ajoutez le dépôt, les documents et les exigences dont une réponse utile doit tenir compte. La fenêtre d'un million de tokens est faite pour cela.
02
Dites ce qui doit être vrai pour que le travail soit considéré comme terminé. Le conseil d'Anthropic pour les exécutions sans surveillance est de tenir les parties de la tâche dans une liste que le modèle met à jour.
03
Faites tourner la même tâche sur Opus 5.5, Opus 5 et Fable 5.1 dans Felo. Comparez les tests, les réserves et la consommation de tokens, pas seulement la réponse.
Sélectionnez Claude Opus 5.5 dès qu'il apparaît dans le sélecteur de modèle de votre compte.
Essayer Opus 5.5 sur FeloClaude Opus 5.5 est le modèle d'Anthropic pour le codage agentique de longue durée et le travail de connaissance, publié le 22 septembre 2026 comme premier modèle de la famille Claude 5.5. Selon Anthropic, il atteint le niveau de Claude Fable 5.1 sur la plupart des tâches tout en coûtant 40 % moins cher à l'usage que Claude Opus 5.
Placez Claude Opus 5.5 aux côtés des autres modèles de tête dans Felo, puis testez-le sur le travail que vous repoussez parce qu'il prend des heures.
Essayer Opus 5.5 sur FeloCommencez par la recherche Felo AI et sélectionnez le modèle là où il est disponible.