01
ถือบริบททั้งหมดไว้
หน้าต่างบริบท 1 ล้านโทเคน และความรู้ถึงเดือนมิถุนายน 2026 บทสนทนายาว ๆ ทั้งรีโพซิทอรี หรือชุดเอกสารทั้งชุด อยู่ในงานเดียวได้
Anthropic เปิดตัว Opus 5.5 เมื่อวันที่ 22 กันยายน 2026
โมเดลแรกในตระกูล Claude 5.5 ทำได้ถึงระดับ Claude Fable 5.1 ในงานส่วนใหญ่ ต้นทุนการใช้งานต่ำกว่า Opus 5 ราว 40% และสร้างเอาต์พุตเร็วขึ้นกว่า 30%
ใช้ได้แล้วใน Felo Search
Claude Opus 5.5 ใช้ได้ใน Felo Search สำหรับงานที่อินพุตยาว เช่น การกระทบยอดตัวเลขข้ามไฟล์ การไล่ที่มาของข้อกล่าวอ้าง และการคืนคำตอบที่ส่งต่อให้คนอื่นได้ทันที
01
หน้าต่างบริบท 1 ล้านโทเคน และความรู้ถึงเดือนมิถุนายน 2026 บทสนทนายาว ๆ ทั้งรีโพซิทอรี หรือชุดเอกสารทั้งชุด อยู่ในงานเดียวได้
02
ในการทดสอบภายในของ Anthropic มี 16 จาก 18 รายงานที่ผ่านเกณฑ์คุณภาพ โดยงานนี้จะถือว่าล้มเหลวทันทีหากมีตัวเลขหรือคำอ้างอิงที่กุขึ้นมาเพียงจุดเดียว
03
Anthropic ออกแบบวิธีสื่อสารของโมเดลใหม่ ข้อมูลสำคัญที่สุดอยู่ตอนต้น และรายงานระบุตรง ๆ ว่าอะไรเสร็จแล้ว พบอะไร และยังเหลืออะไรที่เปิดอยู่
คู่มือแบบเร็ว
Claude Opus 5.5 ปรากฏในตัวเลือกโมเดลข้างโมเดลชั้นนำอื่นในบัญชีของคุณ
ความต่างของ Opus 5.5
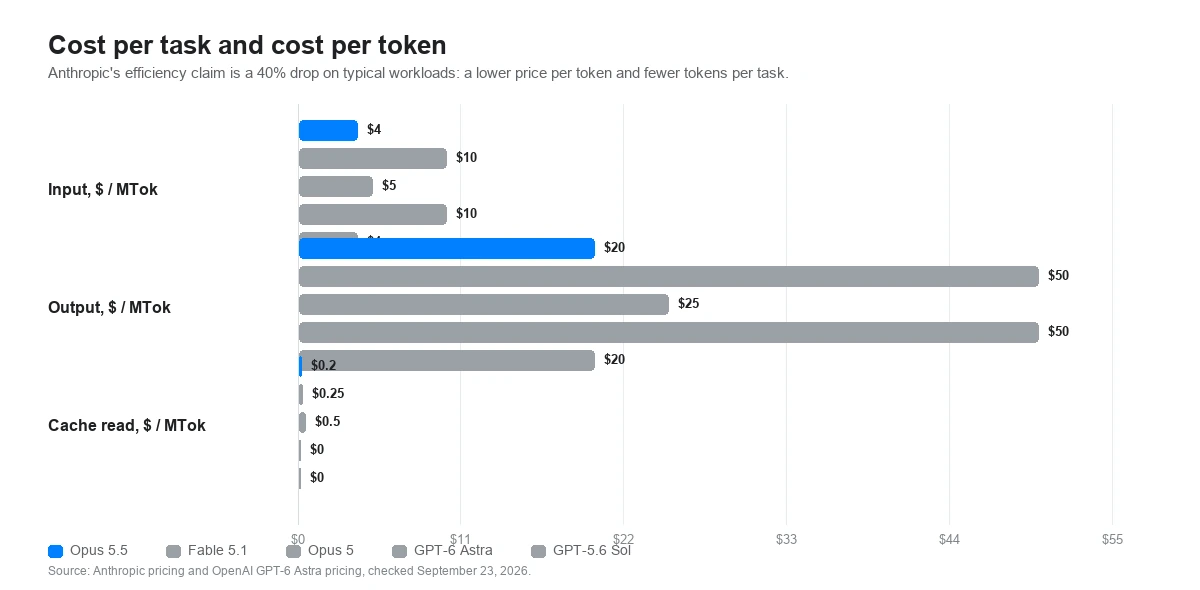
Anthropic ชูเรื่องประสิทธิภาพมากกว่าคะแนนเบนช์มาร์กที่สูงขึ้น ใช้โทเคนต่องานน้อยลง ราคาต่อโทเคนต่ำลง และต้นทุนลดลง 40% ในภาระงานทั่วไป นี่คือสิ่งที่ทำให้การปล่อยให้เอเจนต์ทำงานหลายชั่วโมงเป็นเรื่องที่จ่ายไหว
01
Anthropic เล่าว่าผู้ทดสอบรายหนึ่งตรวจสอบและแก้โค้ดเบส 200,000 บรรทัดเสร็จในไม่ถึงสามชั่วโมง ขณะที่ Opus 5 ใช้เวลากว่า 20 ชั่วโมงและใช้โทเคนมากกว่า 2.5 เท่า
02
Deloitte รายงานว่าแม้ที่ระดับ effort ต่ำสุด Opus 5.5 ก็ตรวจพบบั๊กที่รู้จักแล้ว 72% ในการรีวิวโค้ด เทียบกับ 56% ของ Opus 5 ที่ระดับ high และมีสัญญาณเตือนผิดพลาดน้อยกว่า
03
ข้อความสั้นลงและมีโครงสร้างชัดขึ้น Box รายงานว่าคำตอบยาวเยิ่นเย้อน้อยลง 40% โดยไม่เสียความแม่นยำ และใช้โทเคนเพียงหนึ่งในสามของ Opus 5
การเลือกโมเดล
ราคาด้านล่างเป็นอัตรา API สาธารณะอย่างเป็นทางการต่อล้านโทเคน ไม่ใช่ราคาสมาชิกหรือราคาการใช้งานของ Felo แถว effort สำคัญพอ ๆ กับแถวราคา เพราะพรอมป์เดียวกันอาจมีค่าใช้จ่ายต่างกันมาก ขึ้นอยู่กับว่าแต่ละโมเดลเริ่มจากระดับใด
อัตรา API สาธารณะและค่าเริ่มต้นตรวจสอบเมื่อวันที่ 23 กันยายน 2026 เทียบกับประกาศ Claude Opus 5.5 ของ Anthropic หน้าโมเดลบน Claude Platform และหน้า GPT-6 Astra ของ OpenAI ราคาต่อโทเคนเป็นเพียงส่วนหนึ่งของต้นทุนรวมของงาน ข้ออ้างเรื่องประสิทธิภาพของ Anthropic คือต้นทุนลดลง 40% ในภาระงานทั่วไป ซึ่งรวมราคาต่อโทเคนที่ต่ำลงเข้ากับจำนวนโทเคนต่อวันที่น้อยลง
ผลที่ Anthropic เปิดเผย
Anthropic เปิดเผยตัวเลขของตัวเองวางข้าง Fable 5.1, Opus 5, GPT-6 Astra และ GPT-5.6 Sol โดยสองในสี่กราฟด้านล่างแสดงความแม่นยำเทียบกับต้นทุนต่อชิ้นงาน ไม่ใช่ความแม่นยำอย่างเดียว เพราะนั่นคือการเปรียบเทียบที่ Anthropic ต้องการสื่อ
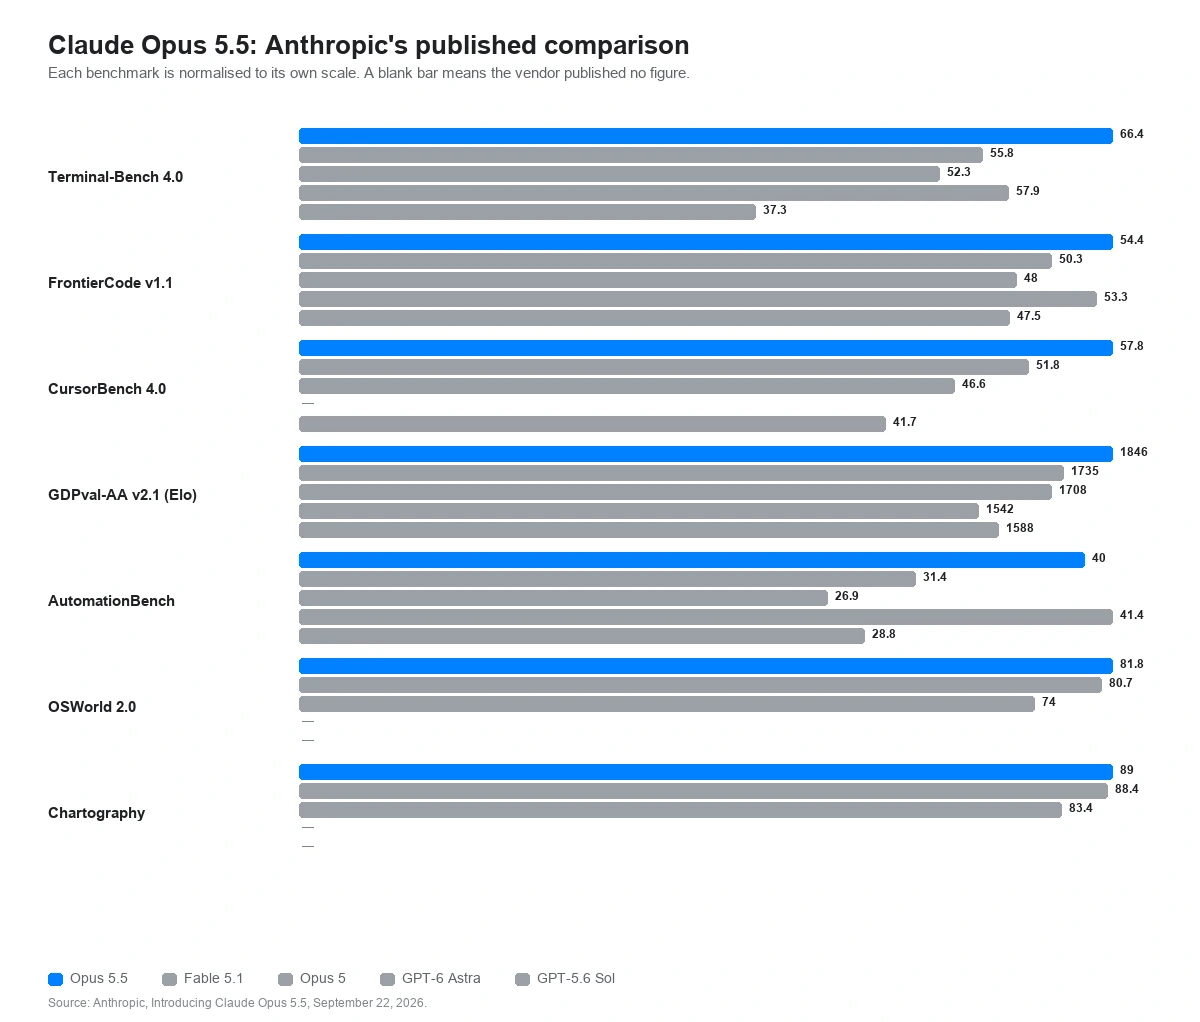
ตารางเปรียบเทียบฉบับเต็มที่เปิดเผย
งานเขียนโค้ดแบบเอเจนต์ งานความรู้ กระบวนการธุรกิจ การคิดข้ามสาขา งานวิจัยวิทยาศาสตร์ การใช้คอมพิวเตอร์ และการอ่านกราฟ ครอบคลุมทั้งห้าโมเดลที่วัด
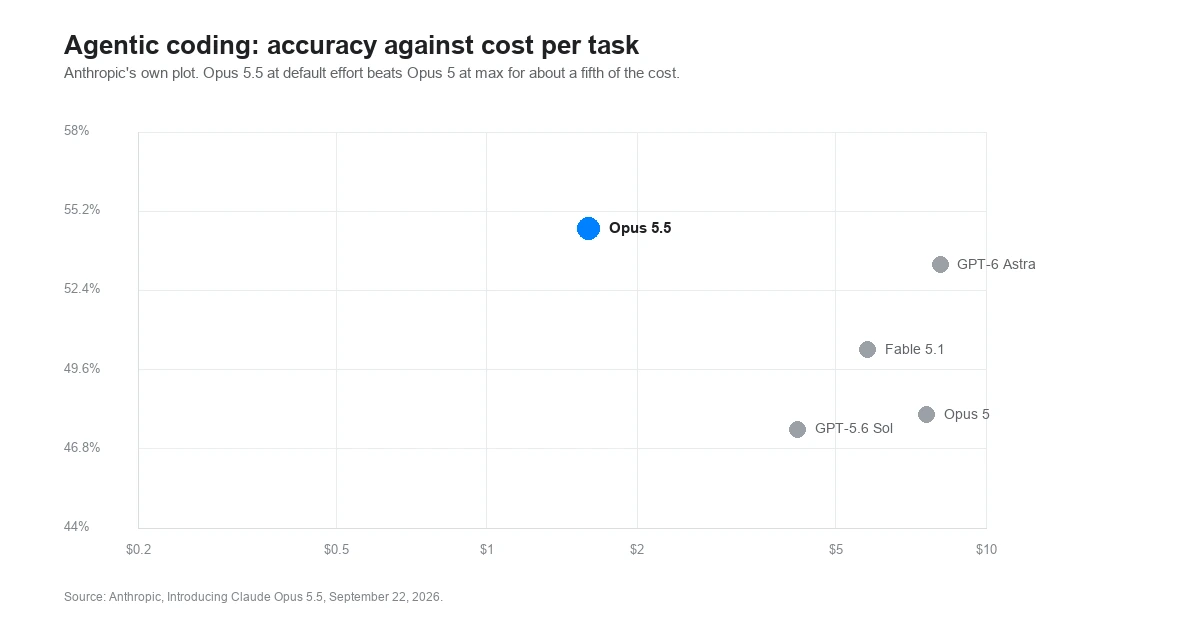
งานเขียนโค้ดแบบเอเจนต์
Terminal-Bench 4.0, FrontierCode v1.1 และ CursorBench 4.0 พล็อตเป็นความแม่นยำเทียบกับต้นทุนต่อชิ้นงาน
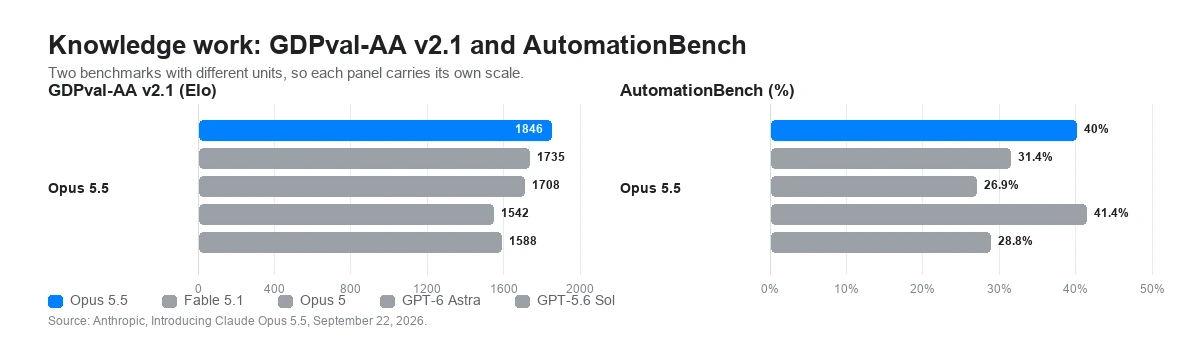
งานความรู้
GDPval-AA v2.1 ครอบคลุม 44 อาชีพ, AutomationBench และ WANDR เบนช์มาร์กเก็บข้อมูลของ Perplexity
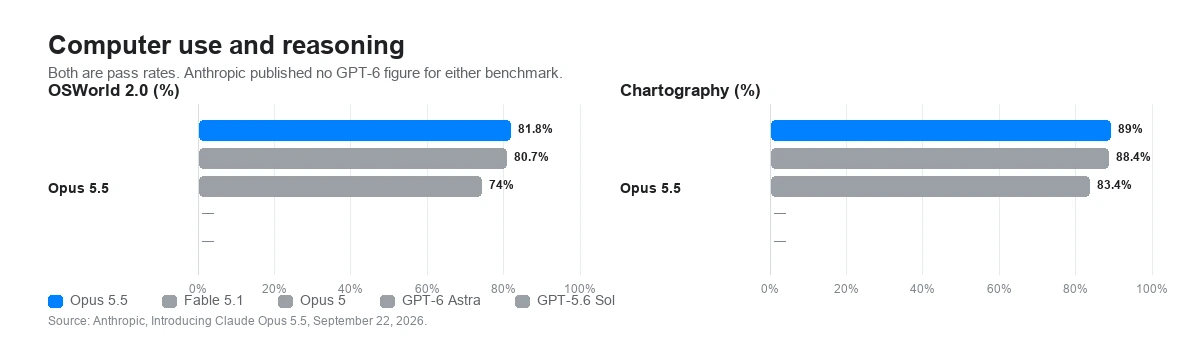
การใช้คอมพิวเตอร์และการคิด
OSWorld 2.0, Humanity's Last Exam และ Chartography โดยตัวสุดท้ายวัดความแม่นยำในการอ่านค่าจากกราฟ
ความแม่นยำเทียบกับต้นทุนต่อชิ้นงาน
ข้ออ้างหลักของ Anthropic ไม่ใช่คะแนนที่สูงขึ้นไม่ว่าจ่ายเท่าไร แต่เป็นคะแนนที่เท่าเดิมหรือดีกว่าในต้นทุนต่อครั้งที่ต่ำกว่ามาก
ตัวเลขที่ผู้ผลิตเปิดเผย เว้นแต่ระบุไว้เป็นอย่างอื่น Anthropic รัน Opus 5.5 ด้วยการคิดแบบปรับตัวที่ max effort และประเมินโดยเปิดระบบป้องกันสำหรับงานจริงไว้ เมื่อระบบเหล่านั้นเข้ามาแทรก งานด้านความมั่นคงไซเบอร์จะทำโดย Opus 4.8 และงานด้านชีววิทยาทำโดย Opus 5 ซึ่งน่าจะทำให้ตัวเลข Opus 5.5 ที่เปิดเผยในเบนช์มาร์กเหล่านั้นต่ำลง ตัวเลขของ GPT-6 Astra และ GPT-5.6 Sol เป็นค่าที่ OpenAI รายงาน ช่องว่างเบนช์มาร์กข้ามผู้ผลิตเป็นเพียงสัญญาณอ่อน ๆ ถึงความต่างในโลกจริง ซึ่งเป็นสิ่งที่ Anthropic เองก็กล่าวถึงตัวเลขชุดนี้
ถ้าคุณใช้งาน Opus 5 อยู่แล้ว
Anthropic ระบุการเปลี่ยนแปลงที่ทำให้โค้ดเดิมบน Claude Opus 5 ใช้ไม่ได้สี่ข้อ และอีกข้อที่เปลี่ยนรูปทรงของคำตอบโดยไม่ทำให้คำขอล้มเหลว ควรอ่านก่อนเปลี่ยน ID โมเดล เพราะสามข้อในนั้นคืนข้อผิดพลาด 400 แทนที่จะค่อย ๆ ด้อยลงอย่างเงียบ ๆ
01
บน Opus 5 ปิดการคิดได้ที่ระดับ high หรือต่ำกว่า บน Opus 5.5 เปิดอยู่เสมอ และทั้งการปิดและงบโทเคนที่กำหนดเองต่างคืนข้อผิดพลาด 400 ตอนนี้ effort เป็นตัวควบคุมเดียว และค่าเริ่มต้นเปลี่ยนจาก high เป็น medium
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice ที่ตั้งเป็น "any" หรือระบุชื่อเครื่องมือจะคืนข้อผิดพลาด 400 รวมถึงที่ปลายทางนับโทเคน ให้ใช้ auto ร่วมกับการเรียกเครื่องมือแบบเข้มงวดหรือเอาต์พุตแบบมีโครงสร้าง และระบุในพรอมป์ว่าเมื่อใดควรใช้เครื่องมือนั้น
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
บล็อกการคิดแต่ละก้อนบันทึกว่าโมเดลใดสร้างขึ้น Opus 5.5 อ่านบล็อกจาก Opus 5 และโมเดล Opus, Sonnet, Haiku รุ่นก่อนได้ แต่ไม่สามารถอ่านจาก Fable หรือ Mythos ได้ หากเราเตอร์ย้ายบทสนทนาไปโมเดลอื่น เทิร์นถัดไปจะทำงานโดยไม่มีการคิดก่อนหน้า
Opus 5.5 -> Fable 5.1 / Mythos 5.1 เก็บการคิดไว้ โมเดลอื่นทิ้งไป
04
บน Claude API และ Google Cloud เครื่องมือ computer_20251124 คืนข้อผิดพลาด 400 ให้ประกาศชุดเครื่องมือ computer_toolset_20260801 แทน ลบเฮดเดอร์ beta และปรับลูปเอเจนต์ให้รองรับบล็อก member tool_use บน Amazon Bedrock เครื่องมือเก่ายังใช้ได้
computer_20251124 -> computer_toolset_20260801
เมื่อปิดการคิดไม่ได้ สิ่งที่ปรับคือ effort โดย Opus 5.5 รองรับทั้งห้าระดับและเริ่มที่ medium ต่ำกว่า Opus 5 อยู่หนึ่งระดับ คำแนะนำของ Anthropic คือให้กวาดทดสอบใหม่บนชุดประเมินของคุณเอง แทนที่จะยกการตั้งค่าเดิมมาใช้ และตั้ง max_tokens ให้กว้างในระดับสูง เพราะโทเคนการคิดนับรวมในเพดานนั้นแม้จะไม่ได้รับข้อความการคิดกลับมา
effort เป็นสัญญาณเชิงพฤติกรรม ไม่ใช่เพดานโทเคนแบบตายตัว ที่ระดับต่ำโมเดลยังคิดกับปัญหาที่ยากจริง เพียงแต่น้อยกว่าระดับสูง Anthropic ยังระบุว่าที่ระดับเดียวกัน Opus 5.5 มีแนวโน้มคิดต่อเทิร์นมากกว่า Opus 5 โดยชัดที่สุดที่ xhigh และ max ดังนั้นการตั้งค่าที่ยกมาจาก Opus 5 จะทำให้เทิร์นยาวขึ้นและแพงขึ้น
จุดที่เหมาะ
Opus 5.5 คุ้มค่าเมื่องานใช้เวลาหลายชั่วโมง ครอบคลุมไฟล์มากกว่าที่คนคนหนึ่งจะจำไหว หรือได้ผลลัพธ์ที่ต้องมีคนอื่นมาตรวจอีกชั้น นี่คือลักษณะงานที่ Anthropic และผู้ทดสอบรุ่นแรกเล่าไว้ ไม่ใช่พรอมป์แชตทั่วไป
พาการเปลี่ยนแปลงให้ทะลุทั้งรีโพซิทอรีใหญ่จนเทสต์ผ่าน แทนที่จะหยุดที่แพตช์แรกที่ดูเข้าท่า Anthropic รายงานการย้ายโค้ด 680,000 บรรทัดเสร็จในไม่ถึงหนึ่งวันโดยผู้ทดสอบรายเดียว
Column หนึ่งในผู้ทดสอบที่ Anthropic อ้างถึง รายงานว่าพบบั๊กจากการไปเปิดเอกสารภายนอกของการเชื่อมต่อบุคคลที่สามที่ถูกโมเดลผิดไว้หลายคอมมิตก่อนหน้า
สร้างโมเดลก่อน แล้วค่อยเขียนสรุปหนึ่งหน้า โดยเก็บข้อควรระวังไว้ครบ Anthropic รายงานว่าการวิเคราะห์การควบรวมเสร็จใน 63 นาที เทียบกับ 93 นาทีของ Opus 5 และต้นทุนเพียงครึ่งเดียว
โมเดลมอบงานต่อให้ซับเอเจนต์และปรับจังหวะตามงบเวลา คำแนะนำของ Anthropic คือให้ระบบหลายเอเจนต์มีสัญญาณเวลาที่ผ่านไป เพื่อให้ทำงานขนานกันแทนที่จะต่อคิว
01
ใส่รีโพซิทอรี เอกสาร และข้อกำหนดที่คำตอบที่มีประโยชน์ต้องคำนึงถึง หน้าต่าง 1 ล้านโทเคนมีไว้เพื่อสิ่งนี้
02
บอกว่าอะไรต้องเป็นจริงก่อนจึงจะถือว่างานเสร็จ คำแนะนำของ Anthropic สำหรับการรันแบบไม่มีคนเฝ้าคือให้เก็บส่วนต่าง ๆ ของงานไว้ในเช็กลิสต์ที่โมเดลอัปเดตเอง
03
รันงานเดียวกันบน Opus 5.5, Opus 5 และ Fable 5.1 ใน Felo เทียบทั้งเทสต์ ข้อควรระวัง และปริมาณโทเคน ไม่ใช่แค่คำตอบ
เลือก Claude Opus 5.5 เมื่อปรากฏในตัวเลือกโมเดลของบัญชีคุณ
ลอง Opus 5.5 บน FeloClaude Opus 5.5 คือโมเดลของ Anthropic สำหรับงานเขียนโค้ดแบบเอเจนต์ระยะยาวและงานความรู้ เปิดตัวเมื่อวันที่ 22 กันยายน 2026 เป็นโมเดลแรกในตระกูล Claude 5.5 Anthropic ระบุว่าทำได้ถึงระดับ Claude Fable 5.1 ในงานส่วนใหญ่ โดยต้นทุนการใช้งานต่ำกว่า Claude Opus 5 ราว 40%
วาง Claude Opus 5.5 ไว้ข้างโมเดลชั้นนำอื่นใน Felo แล้วลองกับงานที่คุณเลื่อนออกไปเพราะใช้เวลาหลายชั่วโมง
ลอง Opus 5.5 บน Feloเริ่มจาก Felo AI Search แล้วเลือกโมเดลเมื่อมีให้ใช้