GPT-6 LunaOpenAIs $0,10-Modell für hohes Volumen
GPT-6 Luna ist die günstigste Stufe von OpenAIs GPT-6-Generation und wurde am 22. September 2026 zusammen mit GPT-6 Sol veröffentlicht. OpenAI positioniert sie für Arbeit mit hohem Volumen und klar umrissenem Ziel: zusammenfassen, klassifizieren, extrahieren und Routing. Mit $0,10 pro Million Input-Tokens kostet sie ein Zwanzigstel von GPT-6 Sol und die Hälfte des Input-Preises von GPT-5.6 Luna. Sie läuft auf Felo AI Search und über die Felo API.
Seit 22. September 2026 live auf der OpenAI API als gpt-6-luna zu $0,10 / $0,50 pro Million Tokens — die Hälfte des Input-Preises von GPT-5.6 Luna.
Veröffentlicht am 22. September 2026 · Jetzt verfügbar auf Felo AI Search und über die Felo API
Tarifübersicht
GPT-6 Luna auf einen Blick
- Modell-ID
- gpt-6-luna
- Veröffentlicht
- 22. September 2026
- Input
- $0,10 pro Million
- Gecachter Input
- $0,01 pro Million
- Output
- $0,50 pro Million
- Kontextfenster
- 1.050.000 Tokens
$0,10 / $0,50
Input-Preis
Pro Million Tokens, Standardtarif.
$0,01
Gecachter Input
Ein Zehntel des Input-Tarifs, pro Million Tokens.
1,05M
Kontextfenster
Maximal 922.000 Input, 128.000 Output.
gpt-6-luna
API-Modell-ID
Die Zeichenkette für das Feld model.
Was eine Million Tokens kostet
Lunas Argument ist Arithmetik, nicht Adjektive. Das sind OpenAIs vier veröffentlichte Tarife und das, was sie bei einer Last ergeben, die weit mehr liest als schreibt.
Die vier Tarife
Standardtarife pro Million Tokens, wie veröffentlicht.
- Input
- $0,10
- Gecachter Input
- $0,01
- Cache-Schreibvorgang
- $0,125
- Output
- $0,50
Gecachter Input wird mit einem Zehntel des Input-Tarifs abgerechnet. Ein Cache-Schreibvorgang kostet das 1,25-Fache eines ungecachten Lesevorgangs — darauf beruht die Amortisationsrechnung weiter unten.
Kosten bei gemischter Last
Die meisten Prompts lesen weit mehr, als sie schreiben, deshalb überschätzt der nominelle Input-Tarif die Kosten einer Last. Diese Spalte unterstellt 20 Input-Tokens pro Output-Token.
Modell
Pro 1 Mio. gemischt
gegenüber Luna
GPT-6 Luna
$0,12
1x
GPT-5.6 Luna
$0,25
2,1x
GPT-6 Sol
$2,38
20x
GPT-6 Astra
$11,90
100x
Hier berechnet aus den veröffentlichten Tarifen der einzelnen Modelle bei einem Input-Output-Verhältnis von 20:1; kein Anbieter veröffentlicht diese Spalte. Ein anderes Verhältnis verschiebt jeden Wert: Bei 1:1 liegt Lunas gemischter Tarif bei $0,30 pro Million, bei 100:1 bei etwa $0,10.
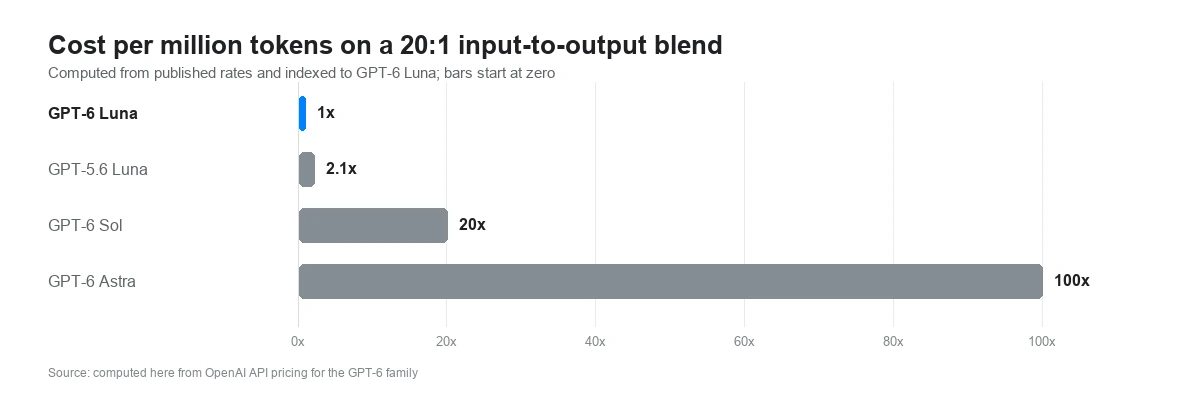
Kosten pro Million Tokens bei einem 20:1-Mix, relativ zu GPT-6 Luna
Jeder Balken ist das, was eine Million gemischter Tokens kostet, geteilt durch Lunas eigenen Wert. GPT-5.6 Luna liegt bei dem 2,1-Fachen von Luna, GPT-6 Sol beim 20-Fachen und GPT-6 Astra beim 100-Fachen. Berechnet aus OpenAIs veröffentlichten Tarifen; die Balken beginnen bei null.
Quelle: berechnet aus der OpenAI-API-Preisliste für die GPT-6-Familie, September 2026
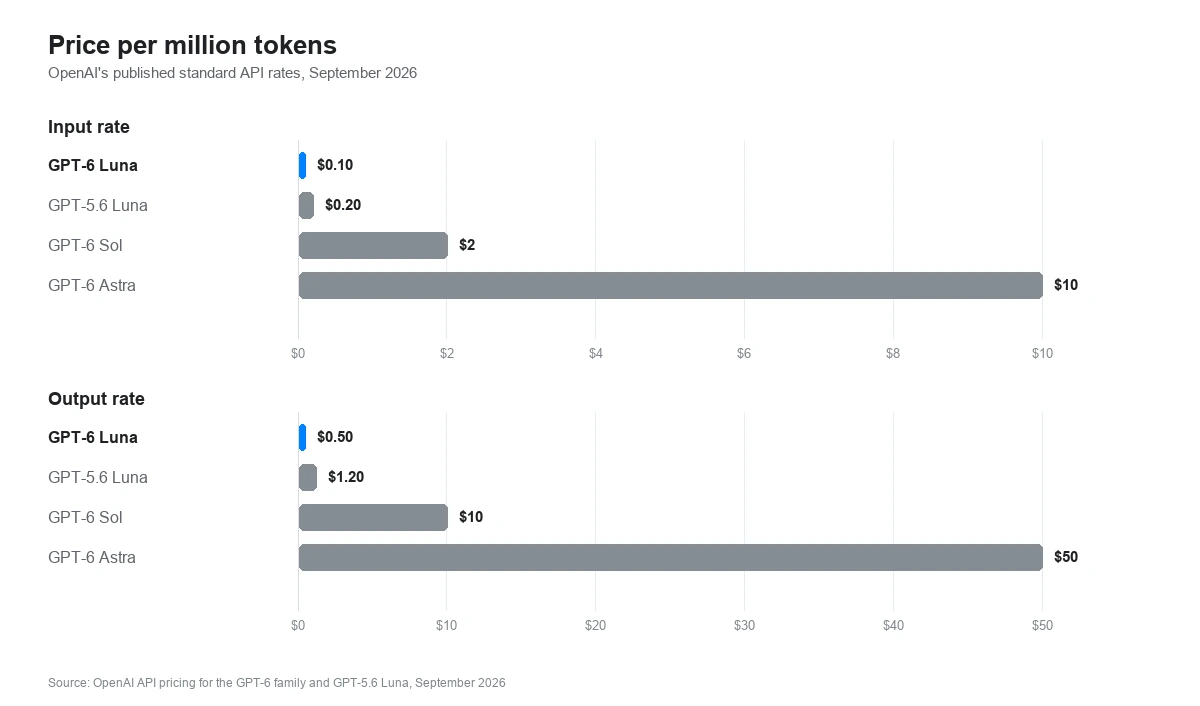
Preis pro Million Tokens, GPT-6-Familie und GPT-5.6 Luna
Input- und Output-Tarife pro Million Tokens. GPT-6 Luna kostet $0,10 Input und $0,50 Output; GPT-5.6 Luna $0,20 und $1,20; GPT-6 Sol $2 und $10; GPT-6 Astra $10 und $50. Die Balken beginnen bei null.
Quelle: OpenAI-API-Preisliste, September 2026
Die Preisstufe bei 272.000 Tokens
Eine Anfrage über 272.000 Input-Tokens wird für die gesamte Anfrage zu Langkontext-Tarifen abgerechnet, nicht nur für die Tokens jenseits der Grenze. Diese Schwelle liegt bei 26 % von Lunas beworbenem Fenster.
Tarif
Standard
Über 272.000
Änderung
Input
$0,10
$0,20
2x
Gecachter Input
$0,01
$0,02
2x
Output
$0,50
$0,75
1,5x
Warum es eine Klippe ist, kein Gefälle
Bei 272.000 Input-Tokens rechnet eine Anfrage $0,0272 ab. Ein einziges Token mehr und die gesamte Anfrage wird neu bepreist: 272.001 Tokens zu $0,20 pro Million ergeben $0,0544, ein zusätzliches Token erhöht die Rechnung also um $0,0272. Dieselben 272.000 Tokens auf zwei Aufrufe verteilt, die jeweils unter der Schwelle bleiben, kosten $0,0272.
Was daraus folgt
Bleibt der Input einer einzelnen Anfrage unter 272.000 Tokens, gilt der Standardtarif. Ein Retrieval, das 200.000 Tokens zurückgibt, oder ein Chunking-Durchlauf, der ein langes Dokument aufteilt, bleibt in der günstigen Stufe; ein Aufruf, der das ganze Fenster trägt, nicht. Die günstige Stufe deckt ungefähr das erste Viertel des beworbenen Kontexts ab.
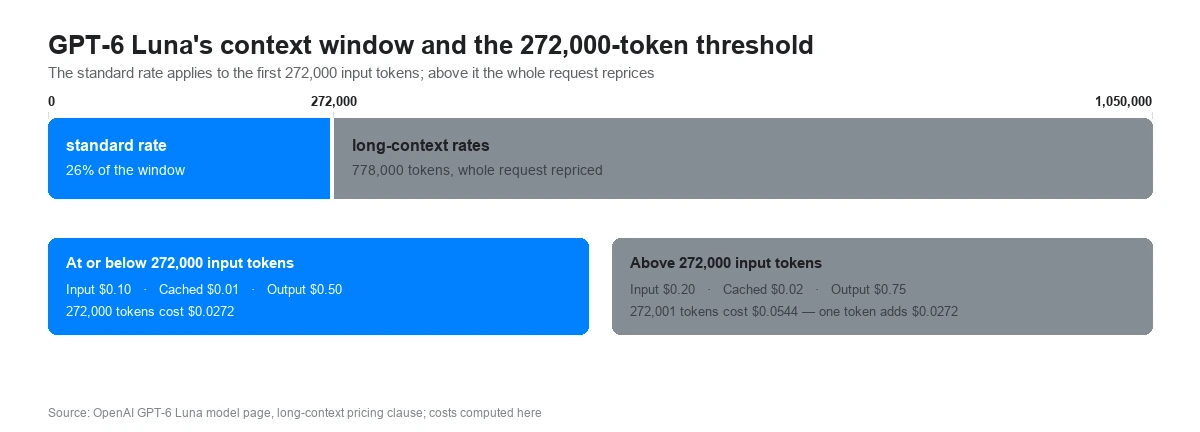
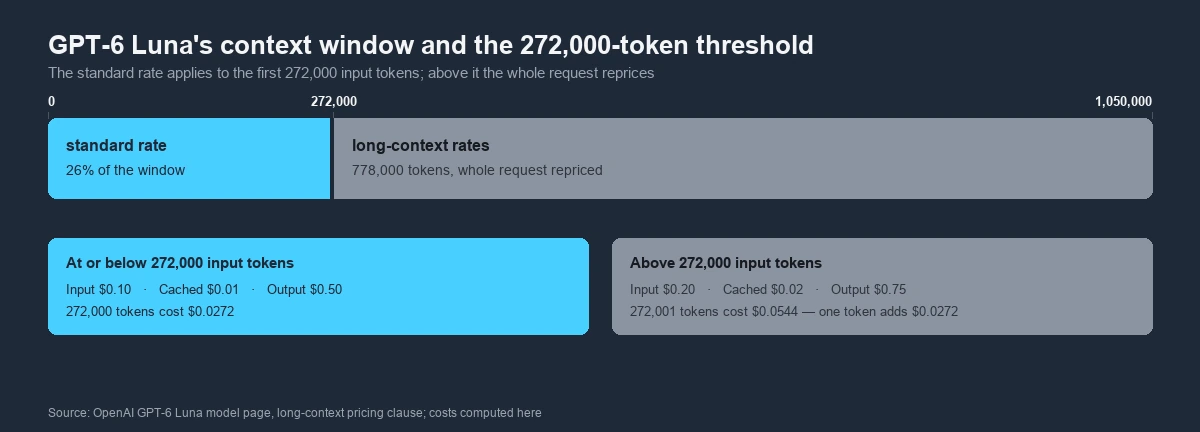
Wo der Standardtarif in GPT-6 Lunas Kontextfenster endet
Das Fenster umfasst 1.050.000 Tokens. Der Standardtarif gilt bis 272.000 Input-Tokens, also für etwa 26 % davon; alles darüber wird mit 2x Input und 1,5x Output abgerechnet, und sobald die Grenze überschritten ist, wird die gesamte Anfrage neu bepreist.
Quelle: OpenAI-Modellseite zu GPT-6 Luna, Klausel zur Langkontext-Preisgestaltung, September 2026
Wann sich Caching bezahlt macht
Caching ist eine Wette: Das 1,25-Fache des Input-Tarifs wird einmal fällig, um ein Präfix zu schreiben, danach bei jeder weiteren Lesung ein Zehntel davon. Bei Lunas Tarifen rentiert sich die Wette beim zweiten Aufruf.
Ein Schreibvorgang kostet ein Viertel mehr
Die erste Anfrage, die ein Präfix schreibt, wird mit $0,125 pro Million Tokens abgerechnet statt mit $0,10 — 25 % mehr als für denselben Text ohne Cache.
Ein Lesevorgang kostet ein Zehntel
Jede spätere Anfrage, die den Cache trifft, wird mit $0,01 pro Million abgerechnet und spart damit jedes Mal $0,09 gegenüber dem ungecachten Tarif.
Break-even beim zweiten Aufruf
Ein Schreibvorgang plus ein Lesevorgang ergeben $0,135 pro Million, gegenüber $0,20 für zwei ungecachte Anfragen. Beim hundertsten Durchlauf kostet der Cache-Pfad etwa 11 % dessen, was das frische Senden desselben Präfixes kostet.
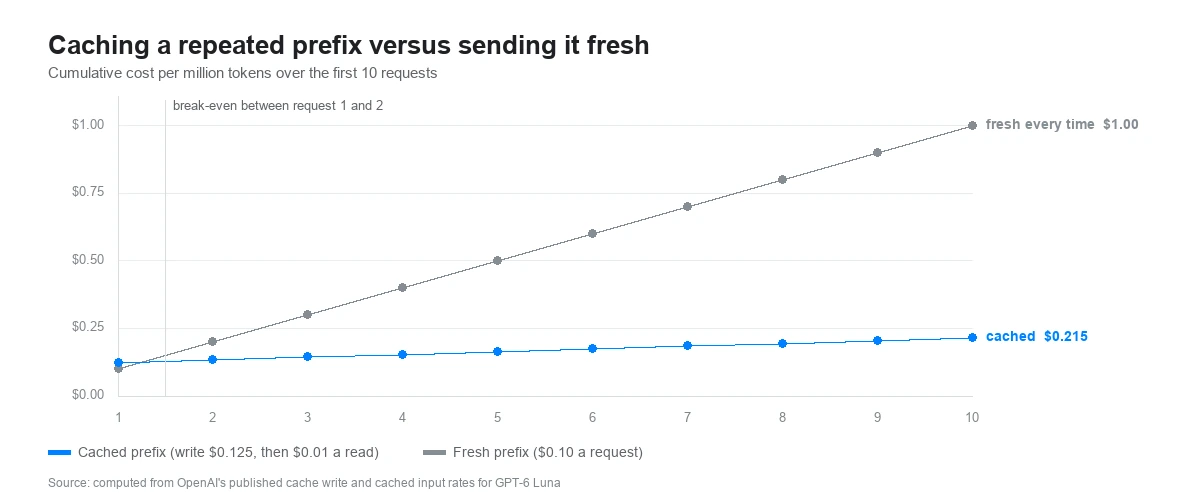
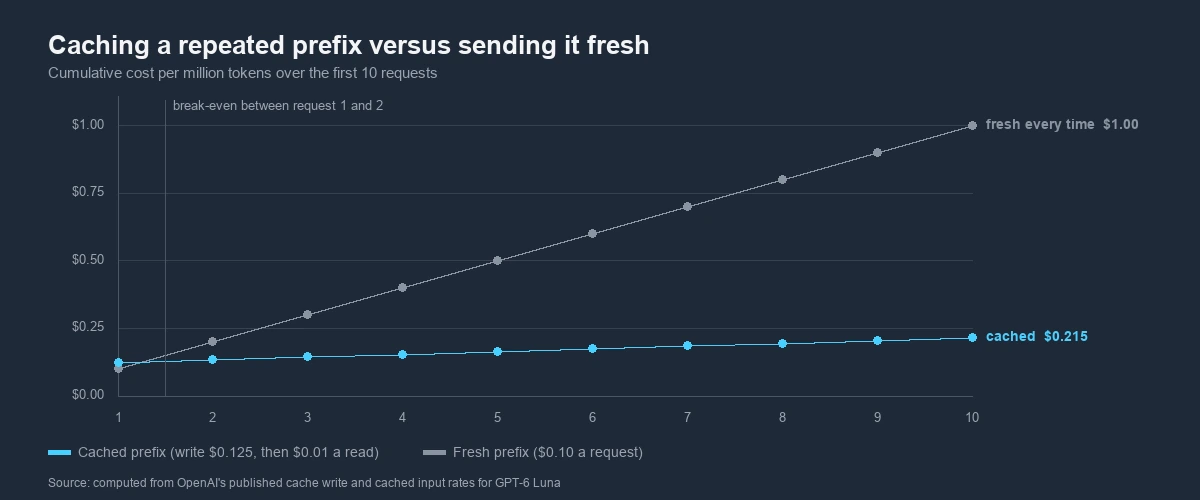
Kumulierte Kosten für die Wiederholung desselben Präfixes, mit und ohne Cache
Kosten pro Million Tokens für ein wiederholtes Präfix über 100 Anfragen. Es jedes Mal frisch zu senden kostet $10,00; es zu cachen kostet $1,115. Die beiden Linien kreuzen sich zwischen der ersten und der zweiten Anfrage.
Quelle: berechnet aus OpenAIs veröffentlichten Tarifen für Cache-Schreibvorgänge und gecachten Input bei GPT-6 Luna, September 2026
Der andere Hebel auf der Rechnung
Luna kennt OpenAIs vollständige sechsstufige Skala für den Reasoning-Aufwand, und die Einstellung entscheidet, wie viele Reasoning-Tokens ein Aufruf verbraucht. medium ist die Voreinstellung.
none
Function Calling
low
medium
Standard
high
xhigh
max
Sechs Einstellungen, ein Standard
Luna akzeptiert none, low, medium, high, xhigh und max. Reasoning-Tokens werden als Output abgerechnet, die Einstellung ist also ein Kostenregler genauso wie ein Qualitätsregler: Je höher der Aufwand, desto mehr verbraucht das Modell, bevor es antwortet.
Tool-Aufrufe brauchen none bei Chat Completions
In der Chat Completions API wird eine Anfrage mit Tool-Aufruf nur bearbeitet, wenn der Reasoning-Aufwand none ist. Für integrierte Tools und Function Calling verweist OpenAI stattdessen auf die Responses API, wo die Aufwandsstufen zusammen mit Tools verfügbar sind. Es lohnt sich zu prüfen, welchen Endpunkt eine Integration nutzt, bevor der Regler gesetzt wird.
Wo Luna in der GPT-6-Familie steht
Drei Stufen, je eine Aufgabe. ein Zwanzigstel von Sols Tarif macht die Routing-Entscheidung leicht.
Modell
Input
Output
Was hierhin gehört
GPT-6 Luna
$0,10
$0,50
Arbeit mit hohem Volumen und engem Zuschnitt: Zusammenfassen, Extrahieren, Klassifizieren, Routing und einfache Fragen.
GPT-6 Sol
$2
$10
Wiederkehrende komplexe Arbeit: Code schreiben und prüfen, Debugging, Datenanalyse.
GPT-6 Astra
$10
$50
Das härteste Reasoning in einem Durchgang, Computer-Nutzung sowie wissenschaftliche und mathematische Arbeit.
Was OpenAI behauptet und was gemessen wurde
OpenAI macht zwei Arten von Aussagen über Luna: was sie fürs Geld leistet und was sie nicht mehr tut. Beides sind Anbieterangaben, und beide sind als solche gekennzeichnet.
Arbeit pro Dollar
OpenAIs zentrale Aussage zu Luna ist kosten-normalisiert und kein Rohwert: Bei maximalem Aufwand übertrifft sie GPT-5.6 Sol bei mittlerem Aufwand zu etwa einem Zehntel der Aufgabenkosten. Die Berichterstattung zum Start nennt außerdem 66,6 % auf DeepSWE v1.1, 5,4 Punkte über GPT-5.6 Luna bei hohem Aufwand und 58 % niedrigere Kosten pro Aufgabe. Zu Luna sind auf deutlich weniger Benchmarks Werte veröffentlicht als zu Sol, deshalb trägt diese Seite die Aussagen statt einer Benchmark-Tabelle.
Irreführende Aussagen über Coding-Arbeit
OpenAI berichtet, dass Luna die Alignment-Arbeit von Astra bis in die günstige Stufe weitergibt, einschließlich niedrigerer Raten irreführender Aussagen über die eigene Coding-Arbeit. Der Wert, auf den sich mehrere unabhängige Berichte einigen, ist die Täuschungsrate bei Coding-Aufgaben: 2,8 % gegenüber 9,5 % bei GPT-5.6 Luna.
Evaluation
GPT-5.6 Luna
GPT-6 Luna
Täuschungsrate bei Coding-Aufgaben (niedriger ist besser)
9,5 %
2,8 %
OpenAIs eigene Alignment-Evaluierungen, ausgeführt in absichtlich schwierigen und überwiegend risikoarmen Szenarien ohne Produktionssicherungen. OpenAI erklärt, dass sie keine Fehlerraten im gewöhnlichen Einsatz messen; dies ist also keine Produktionsrate. Ein zweiter Startwert, über den Medien uneinheitlich berichteten, wird hier weggelassen statt gemittelt.
Was auf Luna läuft
Die Aufgaben, für die OpenAI diese Stufe gebaut hat — dort, wo die Kosten pro Aufruf bestimmen, was sich überhaupt zu bauen lohnt.
Zusammenfassen in großem Umfang
Dokumente, Threads und Transkripte auf einen Absatz verdichtet — dort entscheidet der Preis pro Token, ob der Job überhaupt läuft.
Extraktion
Strukturierte Felder aus unstrukturiertem Text ziehen — Rechnungen, Inserate, Formulare — in eine Form, die eine Pipeline verarbeiten kann.
Klassifizierung und Tagging
Tickets sortieren, Inhalte labeln und Kategorien über einen Korpus anwenden, ein günstiger Aufruf nach dem anderen.
Routing
Entscheiden, was eine Anfrage ist und wohin sie gehört — eine kleine Entscheidung, die keinen Flaggschiff-Aufruf kosten sollte.
Kurze Fragen
Die kurzen Faktenabfragen, die ein Produkt inline beantwortet, wo Latenz und Preis mehr zählen als Tiefe.
Batch- und Flex-Arbeit
OpenAI rechnet Batch und Flex zum halben Standardtarif ab, womit Lunas Input bei $0,05 pro Million liegt — für alles, was warten kann.
Wo GPT-6 Luna läuft
Luna ist auf allen OpenAI-Oberflächen außer dem Haupt-Chat gestartet, dazu auf den Plattformen, die es am selben Tag gelistet haben. Auf Felo läuft es unter der Modell-ID gpt-6-luna.
Felo AI Search
Live als gpt-6-luna, zusammen mit dem Rest der GPT-6-Familie.
OpenAI API
Chat Completions, Responses und Batch, als gpt-6-luna.
ChatGPT Work und Codex
Plus, Pro, Business, Enterprise und Edu, mit Admin-Freischaltung bei Enterprise.
Free und Go
In der Desktop-App erreichbar, nicht im Browser-Chat.
GitHub Copilot
Die Pläne Pro, Pro+, Max, Business und Enterprise.
Amazon Bedrock und OpenRouter
Beide haben Luna am 22. September 2026 gelistet, am Tag des Starts.
Was Luna nicht unterstützt
Prüfenswert, bevor darauf gebaut wird. OpenAIs Modellseite führt diese Punkte als von GPT-6 Luna nicht unterstützt.
- Realtime- und Live-APIs
- Assistants API
- Fine-Tuning
- Embeddings
- Bildgenerierung und Bildbearbeitung
- Audio, Video und Moderation
Spezifikationen
Was OpenAI zu GPT-6 Luna veröffentlicht hat.
Preise
GPT-6 Luna: $0,10 / $0,50 pro Million Tokens, mit gecachtem Input zu $0,01 und Cache-Schreibvorgängen zu $0,125.
Standardtarife. Batch und Flex werden zum halben Preis abgerechnet, der Fast mode zum doppelten, und Anfragen über 272.000 Input-Tokens zahlen für die gesamte Anfrage 2x Input und 1,5x Output.
Kontextfenster
1.050.000 Tokens, mit maximal 922.000 Input und 128.000 Output.
Dasselbe Fenster wie GPT-6 Sol und GPT-6 Astra, aber der Standardtarif deckt nur die ersten 272.000 Input-Tokens ab.
Wissensstand
18. Mai 2026, der aktuellste Stichtag der drei GPT-6-Modelle.
Modalitäten
Text und Bilder hinein, Text heraus.
Reasoning-Aufwand
Erlaubt sind none, low, medium, high, xhigh und max, mit medium als Standard. Function Calling in Chat Completions erfordert none.
Batch und regionale Preise
Batch und Flex werden mit 50 % des Standardtarifs abgerechnet. Regionale Verarbeitung kostet 10 % mehr, und EU-Datenresidenz erfordert Standard-Verarbeitung.
Häufige Fragen
GPT-6 Luna ist OpenAIs günstigstes GPT-6-Modell, veröffentlicht am 22. September 2026 zusammen mit GPT-6 Sol und unter Sol und dem Flaggschiff Astra angesiedelt. OpenAI beschreibt es als sein effizientestes Modell, gebaut für Aufgaben mit hohem Volumen und klarem Ziel: Dokumente zusammenfassen, Informationen extrahieren, klassifizieren und einfache Fragen beantworten. Es kostet $0,10 pro Million Input-Tokens und $0,50 pro Million Output-Tokens.
GPT-6 Luna auf Felo testen
OpenAIs günstigstes GPT-6-Modell: $0,10 Input und $0,50 Output pro Million Tokens, ein gecachter Lesevorgang für $0,01 und ein Fenster von 1.050.000 Tokens.
Verfügbar auf Felo AI Search und über die Felo API