01
Den ganzen Kontext halten
Ein Kontextfenster von 1 Mio. Token und ein Wissensstand von Juni 2026. Ein langer Thread, ein ganzes Repository oder ein Dokumentstapel bleiben in einer Aufgabe.
Anthropic hat Opus 5.5 am 22. September 2026 veröffentlicht
Das erste Modell der Claude-5.5-Familie. Es erreicht bei den meisten Aufgaben das Niveau von Claude Fable 5.1, kostet im Betrieb 40 % weniger als Opus 5 und erzeugt Ausgaben über 30 % schneller.
Jetzt in der Felo-Suche
Claude Opus 5.5 ist in der Felo-Suche verfügbar, für Aufgaben mit langen Eingaben: Zahlen über Dateien hinweg abgleichen, eine Aussage bis zur Quelle zurückverfolgen und eine Antwort liefern, die Sie weitergeben können.
01
Ein Kontextfenster von 1 Mio. Token und ein Wissensstand von Juni 2026. Ein langer Thread, ein ganzes Repository oder ein Dokumentstapel bleiben in einer Aufgabe.
02
In einem internen Test von Anthropic erfüllten 16 von 18 Berichten die Qualitätslatte. Eine einzige erfundene Zahl oder ein erfundenes Zitat hätte den Durchlauf scheitern lassen.
03
Anthropic hat die Kommunikation des Modells überarbeitet: Das Wichtigste steht vorn, und der Bericht nennt klar, was erledigt ist, was gefunden wurde und was offen bleibt.
Kurze Anleitung
Claude Opus 5.5 erscheint in der Modellauswahl neben den anderen führenden Modellen Ihres Kontos.
Der Unterschied von Opus 5.5
Anthropic argumentiert mit Effizienz statt mit einer höheren Benchmark-Zahl: weniger Token pro Aufgabe, ein niedrigerer Preis pro Token und 40 % geringere Kosten bei typischen Workloads. Erst das macht lang laufende Agentenarbeit bezahlbar.
01
Anthropic berichtet von einem frühen Tester, der eine Codebasis mit 200.000 Zeilen in unter drei Stunden prüfte und reparierte. Opus 5 brauchte über 20 Stunden und 2,5-mal so viele Token.
02
Deloitte berichtet, dass Opus 5.5 selbst auf der niedrigsten Effort-Stufe 72 % der bekannten Fehler im Code-Review fand, gegenüber 56 % bei Opus 5 auf high, mit weniger Fehlalarmen.
03
Die Texte sind kürzer und besser gegliedert. Box berichtet von 40 % weniger Weitschweifigkeit ohne Genauigkeitsverlust und einem Drittel der Token von Opus 5.
Modellwahl
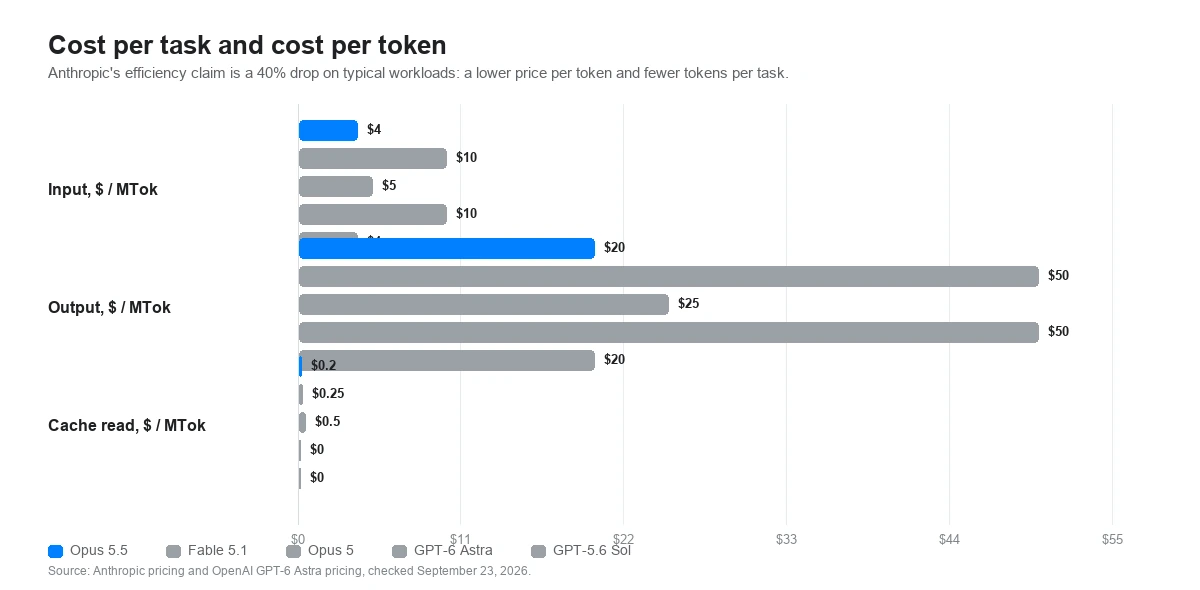
Die Preise unten sind offizielle öffentliche API-Sätze pro Million Token, keine Abo- oder Nutzungspreise von Felo. Die Effort-Zeile ist so wichtig wie die Preiszeile: Derselbe Prompt kann sehr unterschiedlich teuer sein, je nachdem, wo ein Modell startet.
Öffentliche API-Sätze und Standardwerte wurden am 23. September 2026 gegen Anthropics Claude-Opus-5.5-Ankündigung, die Modellseiten der Claude Platform und OpenAIs GPT-6-Astra-Seite geprüft. Der Token-Preis ist nur ein Teil der Gesamtkosten. Anthropics eigene Effizienzaussage sind 40 % geringere Kosten bei typischen Workloads, was niedrigeren Preis pro Token und weniger Token pro Aufgabe zusammenfasst.
Von Anthropic veröffentlichte Ergebnisse
Anthropic hat die eigenen Zahlen neben Fable 5.1, Opus 5, GPT-6 Astra und GPT-5.6 Sol veröffentlicht. Zwei der vier Diagramme unten zeigen Genauigkeit gegen Kosten pro Aufgabe statt Genauigkeit allein, weil genau das der Vergleich ist, den Anthropic anstellt.
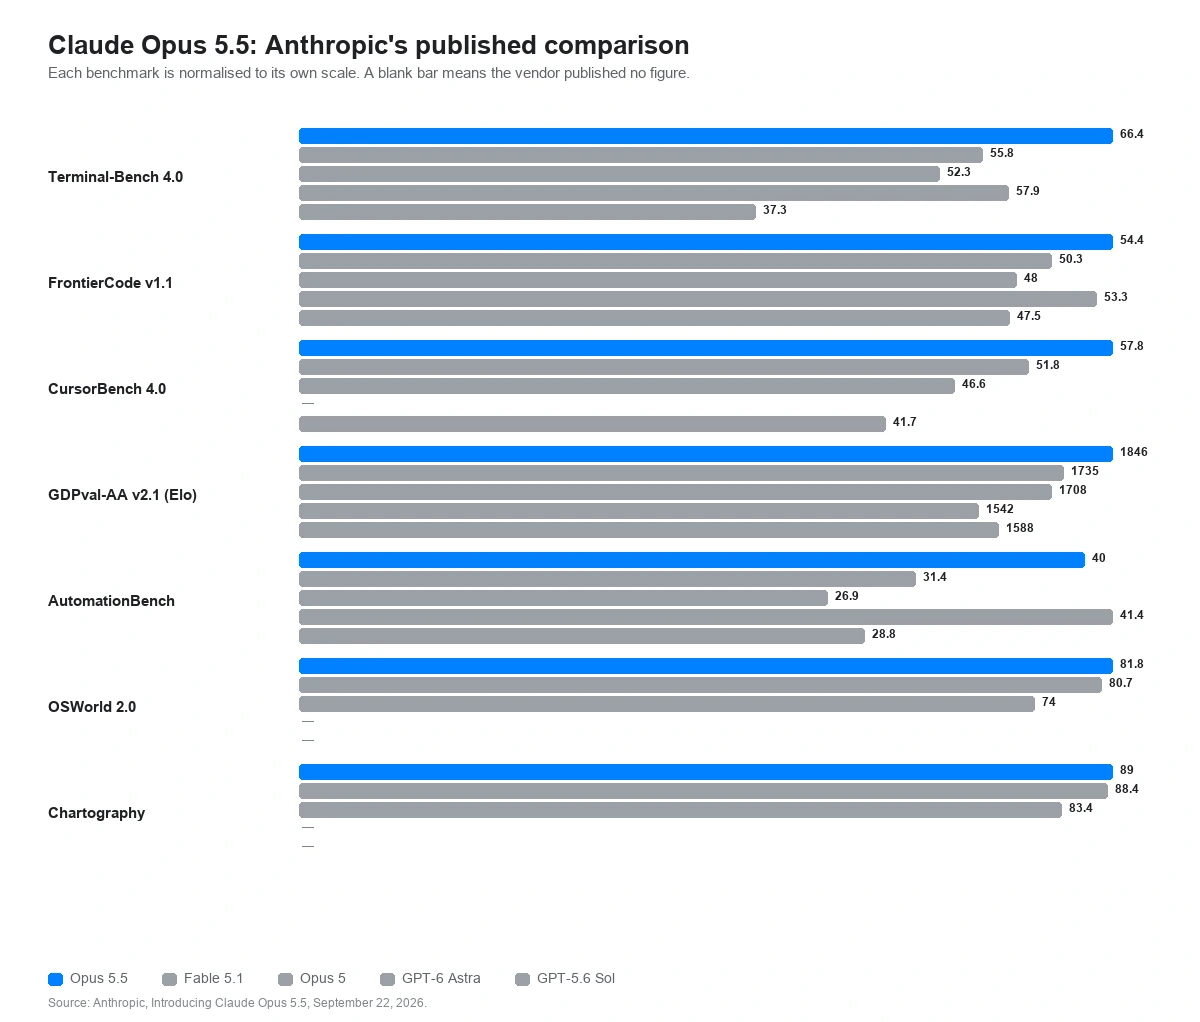
Der vollständige veröffentlichte Vergleich
Agentisches Coden, Wissensarbeit, Geschäftsprozesse, interdisziplinäres Denken, wissenschaftliche Forschung, Computer-Nutzung und Diagrammerkennung über alle fünf gemessenen Modelle.
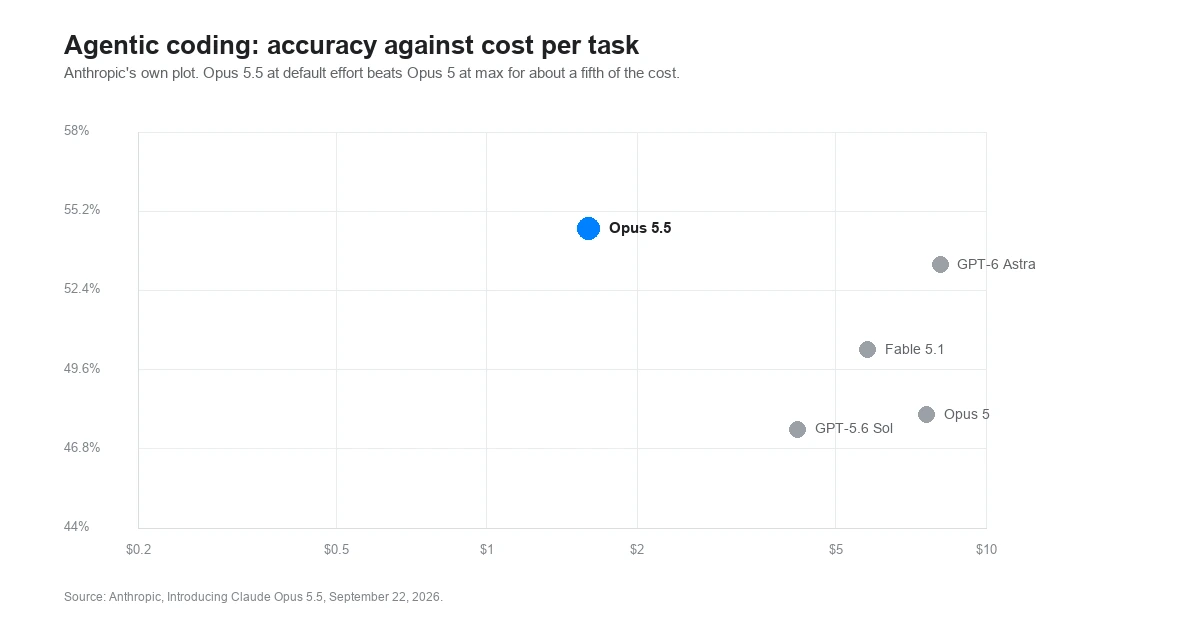
Agentisches Coden
Terminal-Bench 4.0, FrontierCode v1.1 und CursorBench 4.0, aufgetragen als Genauigkeit gegen Kosten pro Aufgabe.
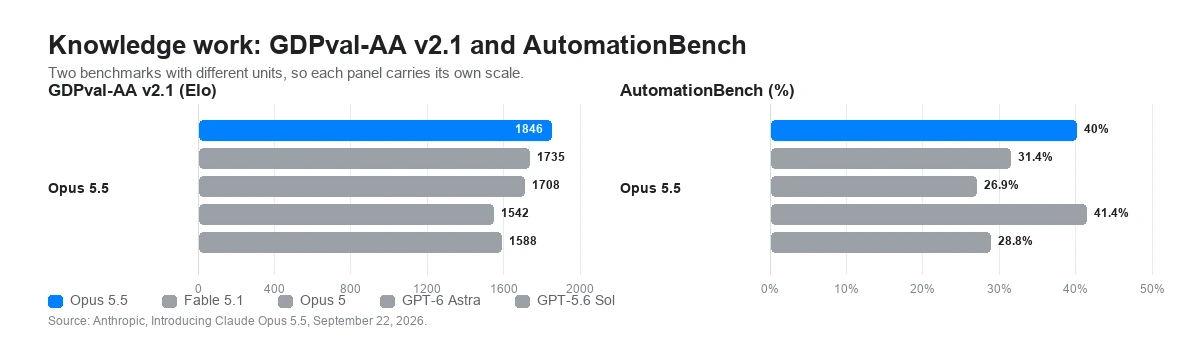
Wissensarbeit
GDPval-AA v2.1 über 44 Berufe, AutomationBench und Perplexitys Datenerhebungs-Benchmark WANDR.
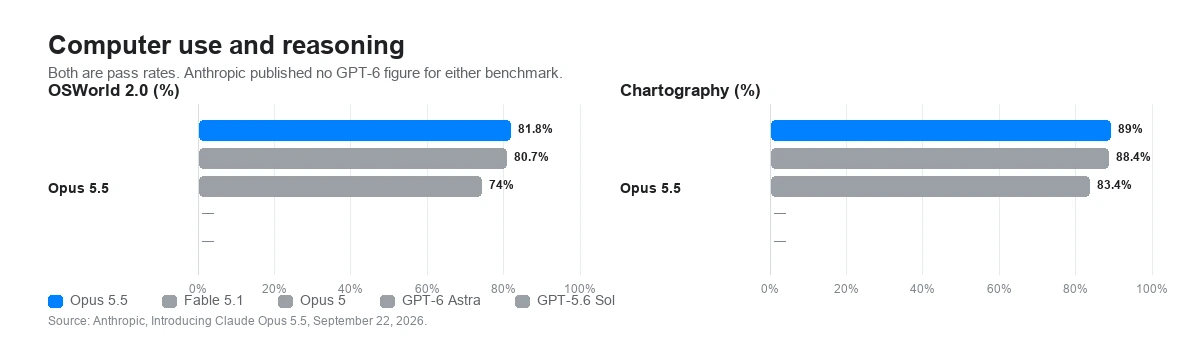
Computer-Nutzung und Denken
OSWorld 2.0, Humanity's Last Exam und Chartography, wobei letzteres misst, wie genau Werte aus einem Diagramm abgelesen werden.
Genauigkeit gegen Kosten pro Aufgabe
Anthropics Kernaussage ist nicht ein höherer Wert zu jedem Preis, sondern derselbe oder ein besserer Wert zu einem Bruchteil der Kosten pro Versuch.
Vom Anbieter veröffentlichte Werte. Sofern nicht anders vermerkt, führte Anthropic Opus 5.5 mit adaptivem Denken auf max effort aus und bewertete es mit aktivierten Produktionsschutzmaßnahmen. Griffen diese ein, wurden Cybersicherheitsaufgaben von Opus 4.8 und Biologieaufgaben von Opus 5 abgeschlossen, was die veröffentlichten Opus-5.5-Werte in diesen Benchmarks wahrscheinlich senkt. Die Werte für GPT-6 Astra und GPT-5.6 Sol stammen von OpenAI. Anbieterübergreifende Benchmark-Abstände sind ein schwacher Hinweis auf reale Unterschiede, was Anthropic selbst über diese Zahlen sagt.
Wenn Sie Opus 5 bereits einsetzen
Anthropic nennt vier breaking changes für Integrationen, die bereits auf Claude Opus 5 laufen, plus eine fünfte Änderung, die die Antwortstruktur verändert, ohne eine Anfrage scheitern zu lassen. Lesen Sie sie, bevor Sie die Modell-ID tauschen, denn drei davon liefern einen 400-Fehler statt still schlechter zu werden.
01
Bei Opus 5 ließ sich Denken bis einschließlich high deaktivieren. Bei Opus 5.5 ist es immer aktiv, und sowohl die Deaktivierung als auch ein manuelles Token-Budget liefern einen 400-Fehler. Effort ist nun die einzige Steuerung, und der Standardwert ist medium statt high.
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice auf "any" oder auf ein benanntes Tool liefert einen 400-Fehler, auch beim Token-Counting-Endpunkt. Nutzen Sie auto zusammen mit strikter Tool-Nutzung oder strukturierten Ausgaben und sagen Sie im Prompt, wann das Tool greift.
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
Jeder Denkblock hält fest, welches Modell ihn erzeugt hat. Opus 5.5 liest Blöcke von Opus 5 und früheren Opus-, Sonnet- und Haiku-Modellen, aber nicht von Fable oder Mythos. Verschiebt ein Router die Konversation auf ein anderes Modell, laufen die späteren Runden ohne die frühere Schlussfolgerung.
Opus 5.5 -> Fable 5.1 / Mythos 5.1 behalten Denken; andere Modelle verwerfen es
04
In der Claude API und auf Google Cloud liefert das Tool computer_20251124 einen 400-Fehler. Deklarieren Sie stattdessen das Toolset computer_toolset_20260801, entfernen Sie den Beta-Header und passen Sie die Agentenschleife an member tool_use-Blöcke an. Auf Amazon Bedrock funktioniert das ältere Tool weiterhin.
computer_20251124 -> computer_toolset_20260801
Da Denken nicht abgeschaltet werden kann, ist Effort die Stellschraube. Opus 5.5 unterstützt alle fünf Stufen und startet auf medium, eine Stufe unter Opus 5. Anthropics Empfehlung lautet, mit den eigenen Evals einen frischen Durchlauf zu machen statt eine Einstellung zu übernehmen, und auf den höheren Stufen ein großzügiges max_tokens zu setzen, da Denk-Token darauf angerechnet werden, auch wenn der Denktext nicht zurückgegeben wird.
Effort ist ein Verhaltenssignal, kein hartes Token-Budget: Auf einer niedrigeren Stufe denkt das Modell bei wirklich schwierigen Problemen weiterhin nach, nur weniger als auf einer höheren. Anthropic merkt außerdem an, dass Opus 5.5 auf derselben Stufe pro Runde mehr denkt als Opus 5, besonders bei xhigh und max. Eine von Opus 5 übernommene Einstellung führt daher zu längeren und teureren Runden.
Wo es passt
Opus 5.5 lohnt sich, wenn eine Aufgabe Stunden dauert, mehr Dateien umfasst, als eine Person überblicken kann, oder ein Ergebnis liefert, das eine zweite Person prüfen muss. Das sind die Aufgaben, die Anthropic und seine frühen Tester beschreiben, keine allgemeinen Chat-Prompts.
Eine Änderung durch ein großes Repository tragen, bis die Tests laufen, statt beim ersten plausiblen Patch zu stoppen. Anthropic berichtet von einer Migration mit 680.000 Zeilen, die ein Tester an einem Tag abschloss.
Anthropics Tester Column berichtet, es habe einen Fehler gefunden, indem es externe Dokumentation zu einer Drittanbieter-Integration prüfte, die mehrere Commits zuvor falsch modelliert worden war.
Erst das Modell bauen, dann die einseitige Zusammenfassung, und die Vorbehalte erhalten. Anthropic berichtet von einer Fusionsanalyse in 63 Minuten gegenüber 93 bei Opus 5, bei halben Kosten.
Es delegiert an Subagenten und richtet sein Tempo an einem Zeitbudget aus. Anthropics Empfehlung ist, einer Multi-Agenten-Umgebung ein Signal für die verstrichene Zeit zu geben, damit sie parallelisiert statt zu serialisieren.
01
Legen Sie Repository, Dokumente und Anforderungen dazu, die eine brauchbare Antwort berücksichtigen muss. Dafür ist das Fenster von 1 Mio. Token da.
02
Sagen Sie, was erfüllt sein muss, damit die Arbeit als erledigt gilt. Anthropics eigener Rat für unbeaufsichtigte Läufe ist, die Teile der Aufgabe in einer Checkliste zu führen, die das Modell aktualisiert.
03
Lassen Sie dieselbe Aufgabe in Felo von Opus 5.5, Opus 5 und Fable 5.1 laufen. Vergleichen Sie nicht nur die Antwort, sondern auch Tests, Vorbehalte und Token-Verbrauch.
Wählen Sie Claude Opus 5.5, sobald es in der Modellauswahl Ihres Kontos erscheint.
Opus 5.5 in Felo testenClaude Opus 5.5 ist Anthropics Modell für lang laufendes agentisches Coden und Wissensarbeit, veröffentlicht am 22. September 2026 als erstes Modell der Claude-5.5-Familie. Laut Anthropic erreicht es bei den meisten Aufgaben das Niveau von Claude Fable 5.1 und kostet im Betrieb 40 % weniger als Claude Opus 5.
Stellen Sie Claude Opus 5.5 in Felo neben die anderen führenden Modelle und testen Sie es mit der Aufgabe, die Sie aufgeschoben haben, weil sie Stunden dauert.
Opus 5.5 in Felo testenStarten Sie in der Felo-AI-Suche und wählen Sie das Modell, wo es verfügbar ist.