01
पूरा संदर्भ थामे रखें
10 लाख टोकन की संदर्भ विंडो और जून 2026 तक का ज्ञान। लंबी बातचीत, पूरा रिपॉज़िटरी या दस्तावेज़ों का एक सेट एक ही काम में रह सकता है।
Anthropic ने 22 सितंबर 2026 को Opus 5.5 जारी किया
Claude 5.5 परिवार का पहला मॉडल। ज़्यादातर काम में यह Claude Fable 5.1 के स्तर तक पहुँचता है, चलाने का खर्च Opus 5 से 40% कम है, और आउटपुट 30% से ज़्यादा तेज़ बनाता है।
अब Felo Search में
Claude Opus 5.5 लंबे इनपुट वाले काम के लिए Felo Search में उपलब्ध है: फ़ाइलों के बीच आँकड़े मिलाना, किसी दावे को उसके स्रोत तक पीछे ले जाना, और ऐसा जवाब देना जिसे आप सीधे किसी और को सौंप सकें।
01
10 लाख टोकन की संदर्भ विंडो और जून 2026 तक का ज्ञान। लंबी बातचीत, पूरा रिपॉज़िटरी या दस्तावेज़ों का एक सेट एक ही काम में रह सकता है।
02
Anthropic के आंतरिक परीक्षण में 18 में से 16 रिपोर्ट गुणवत्ता की कसौटी पर खरी उतरीं। उस काम में एक भी गढ़ा हुआ आँकड़ा या हवाला पूरे प्रयास को विफल कर देता।
03
Anthropic ने मॉडल के संवाद का तरीका नए सिरे से बनाया: सबसे ज़रूरी जानकारी शुरू में आती है, और रिपोर्ट साफ़ बताती है कि क्या पूरा हुआ, क्या पता चला और क्या अब भी खुला है।
छोटी गाइड
Claude Opus 5.5 आपके खाते के दूसरे अग्रणी मॉडलों के साथ मॉडल चयन में दिखता है।
Opus 5.5 की ख़ास बात
Anthropic ऊँचे बेंचमार्क स्कोर की जगह दक्षता पर ज़ोर दे रहा है: हर काम में कम टोकन, हर टोकन की कम क़ीमत, और आम कार्यभार पर 40% कम लागत। यही वजह है कि घंटों चलने वाले एजेंट का काम अब वहनीय बनता है।
01
Anthropic के मुताबिक़ एक शुरुआती परीक्षक ने 2 लाख पंक्तियों का कोडबेस ढाई घंटे से कम में जाँचा और ठीक किया, जबकि Opus 5 को 20 घंटे से ज़्यादा लगे और 2.5 गुना टोकन खर्च हुए।
02
Deloitte ने बताया कि सबसे निचले effort स्तर पर भी Opus 5.5 ने कोड समीक्षा में ज्ञात बग का 72% पकड़ा, जबकि Opus 5 ने high पर 56%, और झूठे अलर्ट भी कम थे।
03
लिखावट छोटी और बेहतर ढाँचे वाली है। Box ने बताया कि सटीकता बनी रही और जवाब 40% कम लंबे हुए, टोकन Opus 5 के एक-तिहाई रहे।
मॉडल चुनाव
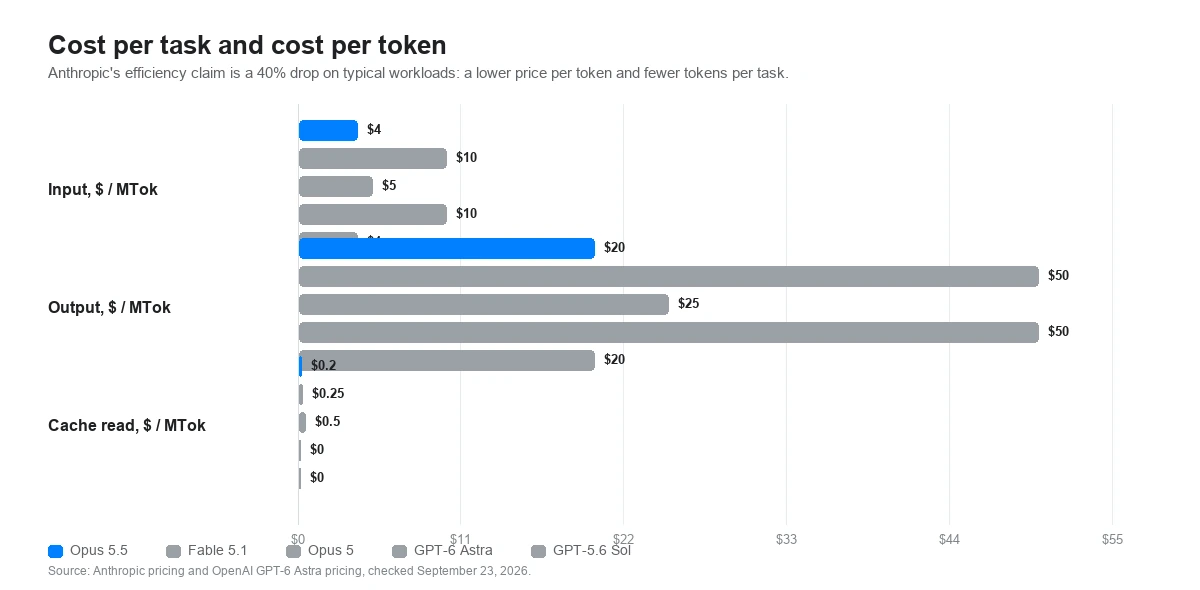
नीचे दी क़ीमतें प्रति 10 लाख टोकन की आधिकारिक सार्वजनिक API दरें हैं, Felo की सदस्यता या उपयोग क़ीमतें नहीं। effort वाली पंक्ति क़ीमत वाली पंक्ति जितनी ही ज़रूरी है: एक ही प्रॉम्प्ट की लागत बहुत बदल सकती है, यह इस पर निर्भर है कि हर मॉडल कहाँ से शुरू होता है।
ऊपर दी सार्वजनिक API दरें और डिफ़ॉल्ट 23 सितंबर 2026 को Anthropic की Claude Opus 5.5 घोषणा, Claude Platform के मॉडल पृष्ठों और OpenAI के GPT-6 Astra पृष्ठ से मिलाकर देखे गए। टोकन की क़ीमत किसी काम की कुल लागत का एक हिस्सा भर है। Anthropic का दक्षता दावा आम कार्यभार पर 40% कम लागत है, जिसमें हर टोकन की कम क़ीमत और हर काम में कम टोकन, दोनों शामिल हैं।
Anthropic के प्रकाशित नतीजे
Anthropic ने अपने आँकड़े Fable 5.1, Opus 5, GPT-6 Astra और GPT-5.6 Sol के साथ प्रकाशित किए हैं। नीचे के चार में से दो चार्ट शुद्ध सटीकता की जगह सटीकता बनाम प्रति-कार्य लागत दिखाते हैं, क्योंकि Anthropic की तुलना ठीक यही है।
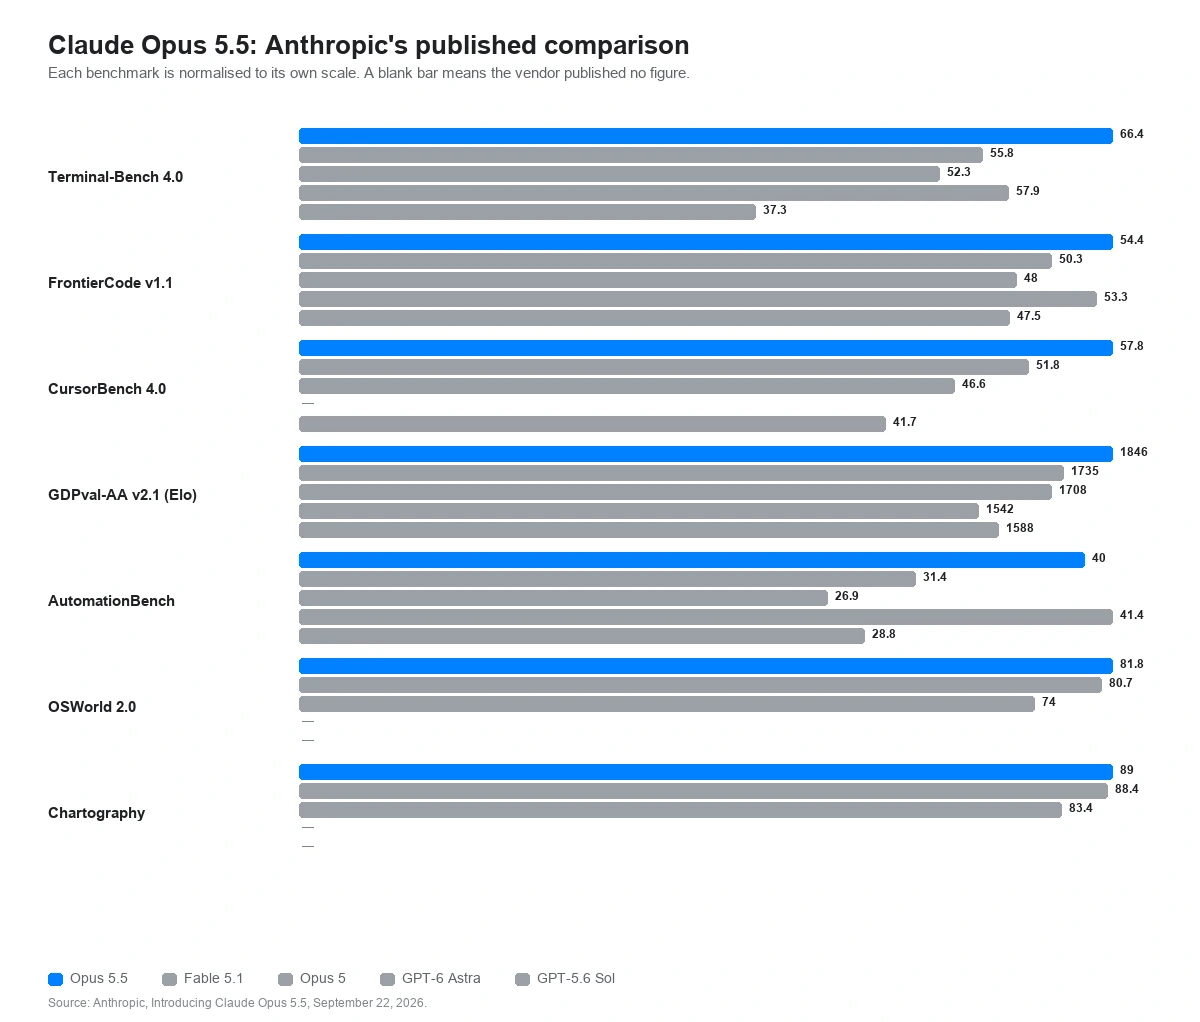
पूरी प्रकाशित तुलना
एजेंट कोडिंग, ज्ञान-कार्य, कारोबारी प्रक्रियाएँ, बहुविषयक तर्क, वैज्ञानिक शोध, कंप्यूटर उपयोग और चार्ट पढ़ना, सभी पाँच मापे गए मॉडलों पर।
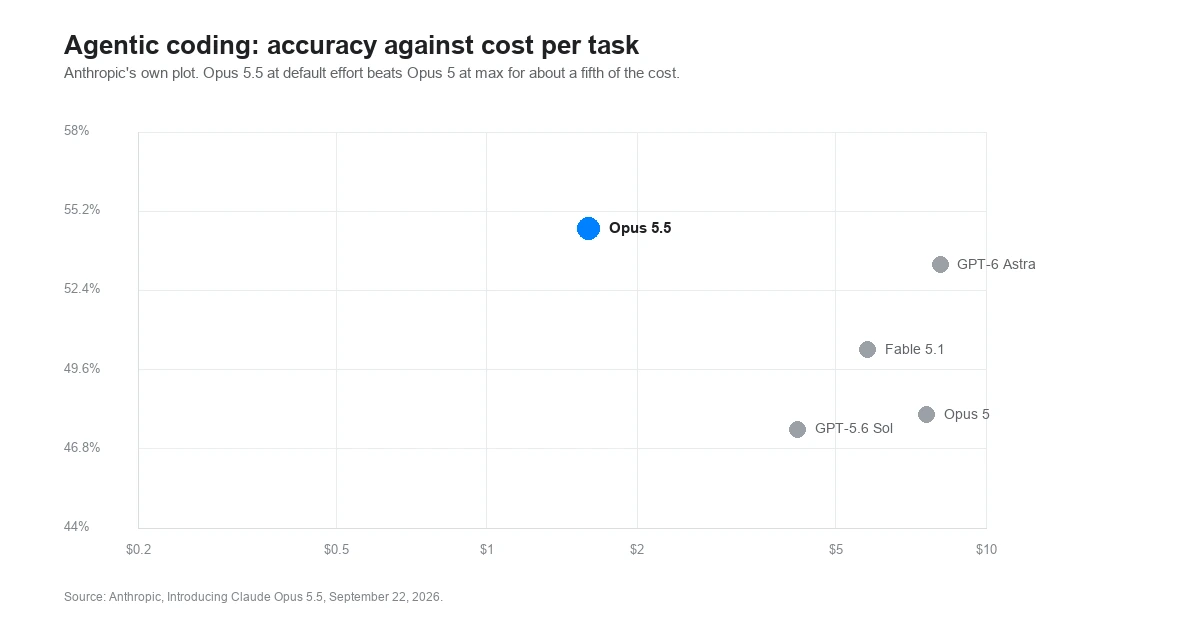
एजेंट कोडिंग
Terminal-Bench 4.0, FrontierCode v1.1 और CursorBench 4.0, प्रति-कार्य लागत के मुक़ाबले सटीकता के रूप में।
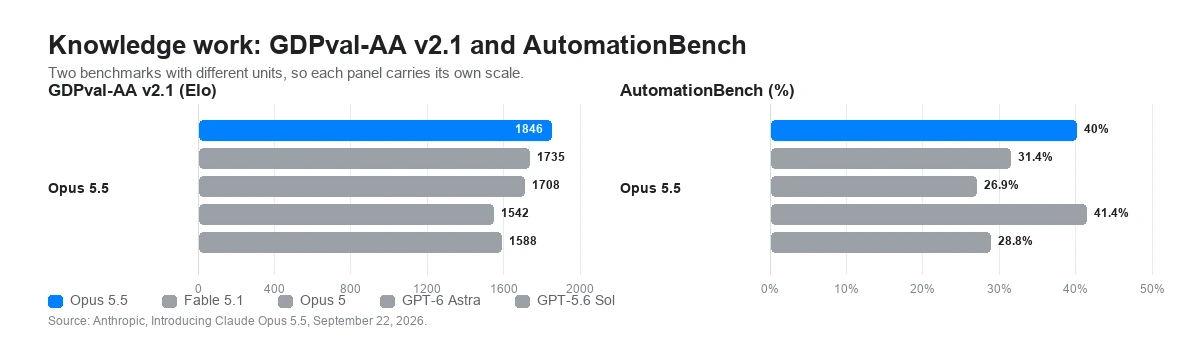
ज्ञान-कार्य
44 व्यवसायों पर GDPval-AA v2.1, AutomationBench, और Perplexity का डेटा-संग्रह बेंचमार्क WANDR।
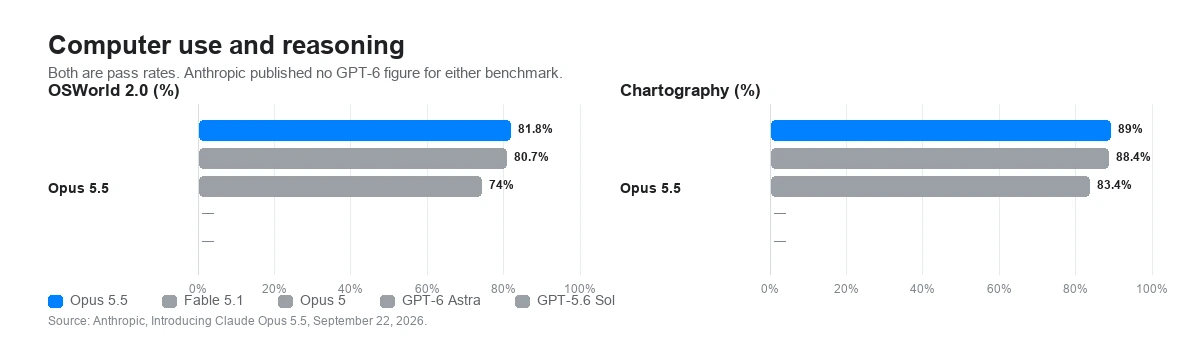
कंप्यूटर उपयोग और तर्क
OSWorld 2.0, Humanity's Last Exam और Chartography, जिनमें अंतिम चार्ट से मान पढ़ने की सटीकता मापता है।
प्रति-कार्य लागत के मुक़ाबले सटीकता
Anthropic का मुख्य दावा किसी भी क़ीमत पर ऊँचा स्कोर नहीं, बल्कि प्रति-प्रयास लागत के एक छोटे हिस्से में बराबर या बेहतर स्कोर है।
निर्माता द्वारा प्रकाशित आँकड़े। जहाँ अलग से न कहा गया हो, Anthropic ने Opus 5.5 को max effort पर अनुकूली तर्क के साथ चलाया और उत्पादन सुरक्षा उपाय चालू रखते हुए मूल्यांकन किया। जब वे उपाय बीच में आए, तो साइबर सुरक्षा के काम Opus 4.8 ने और जीव विज्ञान के काम Opus 5 ने पूरे किए, जिससे उन बेंचमार्क पर Opus 5.5 के प्रकाशित आँकड़े कम आने की संभावना है। GPT-6 Astra और GPT-5.6 Sol के आँकड़े OpenAI के बताए हुए हैं। निर्माताओं के बीच बेंचमार्क का अंतर असल फ़र्क़ का कमज़ोर संकेत है, जो Anthropic ख़ुद इन आँकड़ों के बारे में कहता है।
अगर आप पहले से Opus 5 चला रहे हैं
Anthropic ने Claude Opus 5 पर पहले से चल रहे इंटीग्रेशन के लिए चार असंगत बदलाव गिनाए हैं, और एक पाँचवाँ बदलाव जो किसी अनुरोध को विफल किए बिना जवाब का ढाँचा बदल देता है। मॉडल ID बदलने से पहले इन्हें पढ़ लेना ठीक है, क्योंकि इनमें से तीन चुपचाप कमज़ोर पड़ने की जगह 400 त्रुटि लौटाते हैं।
01
Opus 5 पर तर्क high और उससे नीचे बंद किया जा सकता था। Opus 5.5 पर यह हमेशा चालू है, और बंद करने का तरीक़ा तथा हाथ से तय टोकन बजट, दोनों 400 त्रुटि लौटाते हैं। अब effort ही एकमात्र नियंत्रण है, और डिफ़ॉल्ट high से medium हो गया है।
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice को "any" या किसी नामित टूल पर सेट करने पर 400 त्रुटि आती है, टोकन गिनती एंडपॉइंट पर भी। auto के साथ सख़्त टूल इस्तेमाल या संरचित आउटपुट इस्तेमाल करें, और प्रॉम्प्ट में बताएँ कि टूल कब लागू होता है।
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
हर तर्क ब्लॉक दर्ज करता है कि उसे किस मॉडल ने बनाया। Opus 5.5, Opus 5 और उससे पहले के Opus, Sonnet, Haiku मॉडलों के ब्लॉक पढ़ सकता है, पर Fable या Mythos के नहीं। अगर कोई राउटर बातचीत किसी और मॉडल पर ले जाए, तो आगे के दौर पिछले तर्क के बिना चलेंगे।
Opus 5.5 -> Fable 5.1 / Mythos 5.1 तर्क रखते हैं; बाक़ी मॉडल उसे छोड़ देते हैं
04
Claude API और Google Cloud पर computer_20251124 टूल 400 त्रुटि लौटाता है। इसकी जगह computer_toolset_20260801 टूलसेट घोषित करें, beta हेडर हटाएँ, और एजेंट लूप को member tool_use ब्लॉकों के लिए ढालें। Amazon Bedrock पर पुराना टूल अब भी चलता है।
computer_20251124 -> computer_toolset_20260801
चूँकि तर्क बंद नहीं किया जा सकता, इसलिए effort ही घुमाने वाली चीज़ है। Opus 5.5 पाँचों स्तर समर्थित करता है और medium से शुरू होता है, यानी Opus 5 से एक स्तर नीचे। Anthropic की सलाह है कि पुरानी सेटिंग उठाने की जगह अपने ही मूल्यांकनों पर नया स्वीप चलाएँ, और ऊँचे स्तरों पर max_tokens खुला रखें, क्योंकि तर्क के टोकन उस सीमा में गिने जाते हैं, भले ही तर्क का पाठ वापस न मिले।
effort एक व्यवहारिक संकेत है, सख़्त टोकन बजट नहीं: निचले स्तर पर भी मॉडल सचमुच कठिन समस्याओं पर सोचता है, बस ऊँचे स्तर से कम। Anthropic यह भी बताता है कि एक ही स्तर पर Opus 5.5 हर दौर में Opus 5 से ज़्यादा सोचता है, ख़ासकर xhigh और max पर, इसलिए Opus 5 से उठाई गई सेटिंग लंबे और महँगे दौर बनाएगी।
कहाँ फिट बैठता है
Opus 5.5 तब काम आता है जब कोई काम घंटों चले, उतनी फ़ाइलों में फैले जितनी एक व्यक्ति थाम न सके, या ऐसा नतीजा दे जिसे किसी दूसरे को जाँचना पड़े। ये वही स्थितियाँ हैं जो Anthropic और उसके शुरुआती परीक्षक बताते हैं, कोई आम चैट प्रॉम्प्ट नहीं।
पहले कामचलाऊ पैच पर रुकने की जगह बदलाव को बड़े रिपॉज़िटरी में तब तक ले जाएँ जब तक टेस्ट पास न हों। Anthropic के मुताबिक़ एक परीक्षक ने 6.8 लाख पंक्तियों का माइग्रेशन एक दिन से कम में पूरा किया।
Anthropic के बताए परीक्षक Column ने बताया कि उसने कई कमिट पहले ग़लत तरीक़े से बनाई गई एक थर्ड-पार्टी इंटीग्रेशन की बाहरी डॉक्युमेंटेशन देखकर बग पकड़ा।
पहले मॉडल बनाएँ, फिर एक पन्ने का सार, और चेतावनियाँ बरकरार रखें। Anthropic के मुताबिक़ एक विलय विश्लेषण 63 मिनट में पूरा हुआ, जबकि Opus 5 को 93 मिनट लगे, और लागत आधी रही।
यह सब-एजेंट को काम सौंपता है और समय-बजट के हिसाब से गति तय करता है। Anthropic की सलाह है कि मल्टी-एजेंट ढाँचे को बीते समय का संकेत दें, ताकि वह क़तार लगाने की जगह समानांतर चले।
01
रिपॉज़िटरी, दस्तावेज़ और ज़रूरतें डालें जिन्हें काम का जवाब ध्यान में रखे। 10 लाख टोकन की विंडो इसी के लिए है।
02
बताएँ कि काम पूरा मानने से पहले क्या सही होना चाहिए। बिना निगरानी चलने वाले सत्रों के लिए Anthropic की सलाह है कि काम के हिस्से ऐसी सूची में रखें जिसे मॉडल अपडेट करता रहे।
03
एक ही काम Felo में Opus 5.5, Opus 5 और Fable 5.1 पर चलाएँ। सिर्फ़ जवाब नहीं, टेस्ट, चेतावनियाँ और टोकन खर्च भी तौलिए।
जब Claude Opus 5.5 आपके खाते के मॉडल चयन में दिखे तो उसे चुनें।
Felo पर Opus 5.5 आज़माएँClaude Opus 5.5, Anthropic का लंबे समय तक चलने वाली एजेंट कोडिंग और ज्ञान-कार्य के लिए बनाया मॉडल है, जो 22 सितंबर 2026 को Claude 5.5 परिवार के पहले मॉडल के रूप में जारी हुआ। Anthropic के मुताबिक़ यह ज़्यादातर काम में Claude Fable 5.1 के स्तर तक पहुँचता है, जबकि चलाने का खर्च Claude Opus 5 से 40% कम है।
Felo में Claude Opus 5.5 को दूसरे अग्रणी मॉडलों के साथ रखिए, फिर उस काम पर आज़माइए जिसे घंटों लगने की वजह से आप टालते आ रहे हैं।
Felo पर Opus 5.5 आज़माएँFelo AI Search से शुरू करें और जहाँ उपलब्ध हो वहाँ मॉडल चुनें।