2026 年 9 月 30 日發布 · 分階段開放中

Gemini 4 Argon長篇研究,一次寫完

Google 自 Gemini 3 以來首款前沿模型,為跨越長流程的深度推理而打造。輸出上限從 64K token 拉高到 1M,而 Google 公布的數字裡,它領先的是知識工作,不是程式開發。

Felo API 目前處於內測階段,Gemini 4 Argon 的接入即將開放。
Gemini 4 Argon 主視覺:藍色漸層背景上,模型名稱與巨大的數字 4 並列
Google 的發布主視覺。Argon 以全新的命名體系推出,並不是 Gemini 4.0 系列的更新,因此名稱不帶版本號。
1M
最大輸出 token
從 64K 提升而來,一條生成軌跡就能寫完一份完整報告。
2 / 10 美元
API 首發價格
每百萬輸入 / 輸出 token。快取輸入可享 95% 折扣。
77.9%
DeepSWE v1.1
Google 公布的成績,領先 Claude Opus 5.5 與 GPT-6 Astra。
15%
幻覺率
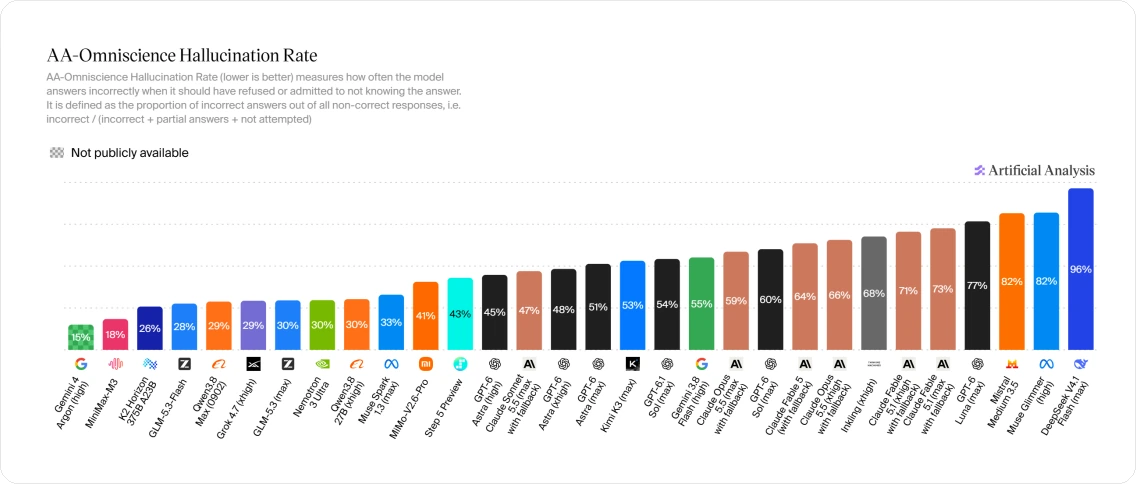
Artificial Analysis 測得的前沿模型中最低值。

本頁的圖片與圖表均來自各自的發布單位——Google、Arena.ai 與 Artificial Analysis,並原樣呈現,未經任何修改。

開放進度

Argon 尚未全面開放,以下是它的開放順序。

Google 正分階段釋出 Argon,而第一階段並不對外公開。Felo 內的接入也在同步準備中。

現已開放

受信任的網路防禦人員

Google Fairwind 計畫中的獲選合作夥伴可優先取得 Argon,且不套用網路安全防護限制。

接下來公布

付費 API 客戶與 Google AI Ultra

Google 表示更廣泛的開放由此開始。日期尚未公布,目前單憑訂閱也還無法使用。

尚未排定

開發者、企業與一般使用者

排在付費層級之後。Google 尚未承諾全面開放的時程。

Argon 在 Felo 搜尋中的接入正在進行,開放後本頁會同步更新。

擅長什麼

為了寫完長工作而生,不是為了快速回答

Argon 公布的強項集中在閱讀、推理與長文寫作。這跟它常被拿來比較的程式優先前沿模型,是兩條不同的路線。

長任務裡不會走樣的推理

Google 把 Argon 定位在動輒數小時的多步驟工作上;先前的模型在這類任務裡容易偏離目標或提早收手。

一次輸出 1M token

Google 對這次提升的說法是:有空間慢慢想的模型,能用一條軌跡解掉一個難題,不必來回多輪。

強在知識工作,不是程式開發

公布差距最大的項目是 Harvey's Legal Agent Benchmark 與 Vals Finance Agent v2,屬於真實的法務與財務分析,而不是合成任務。

撐得住的長上下文檢索

GraphWalks 測試的是模型能否真正用上 256K 到 1M 的上下文,Google 回報領先其他旗艦模型超過 10 個百分點。

長影片理解

衡量長影片理解力的 LVBench 回報為 91.7%,是 Google 為 Argon 列出的最高分。
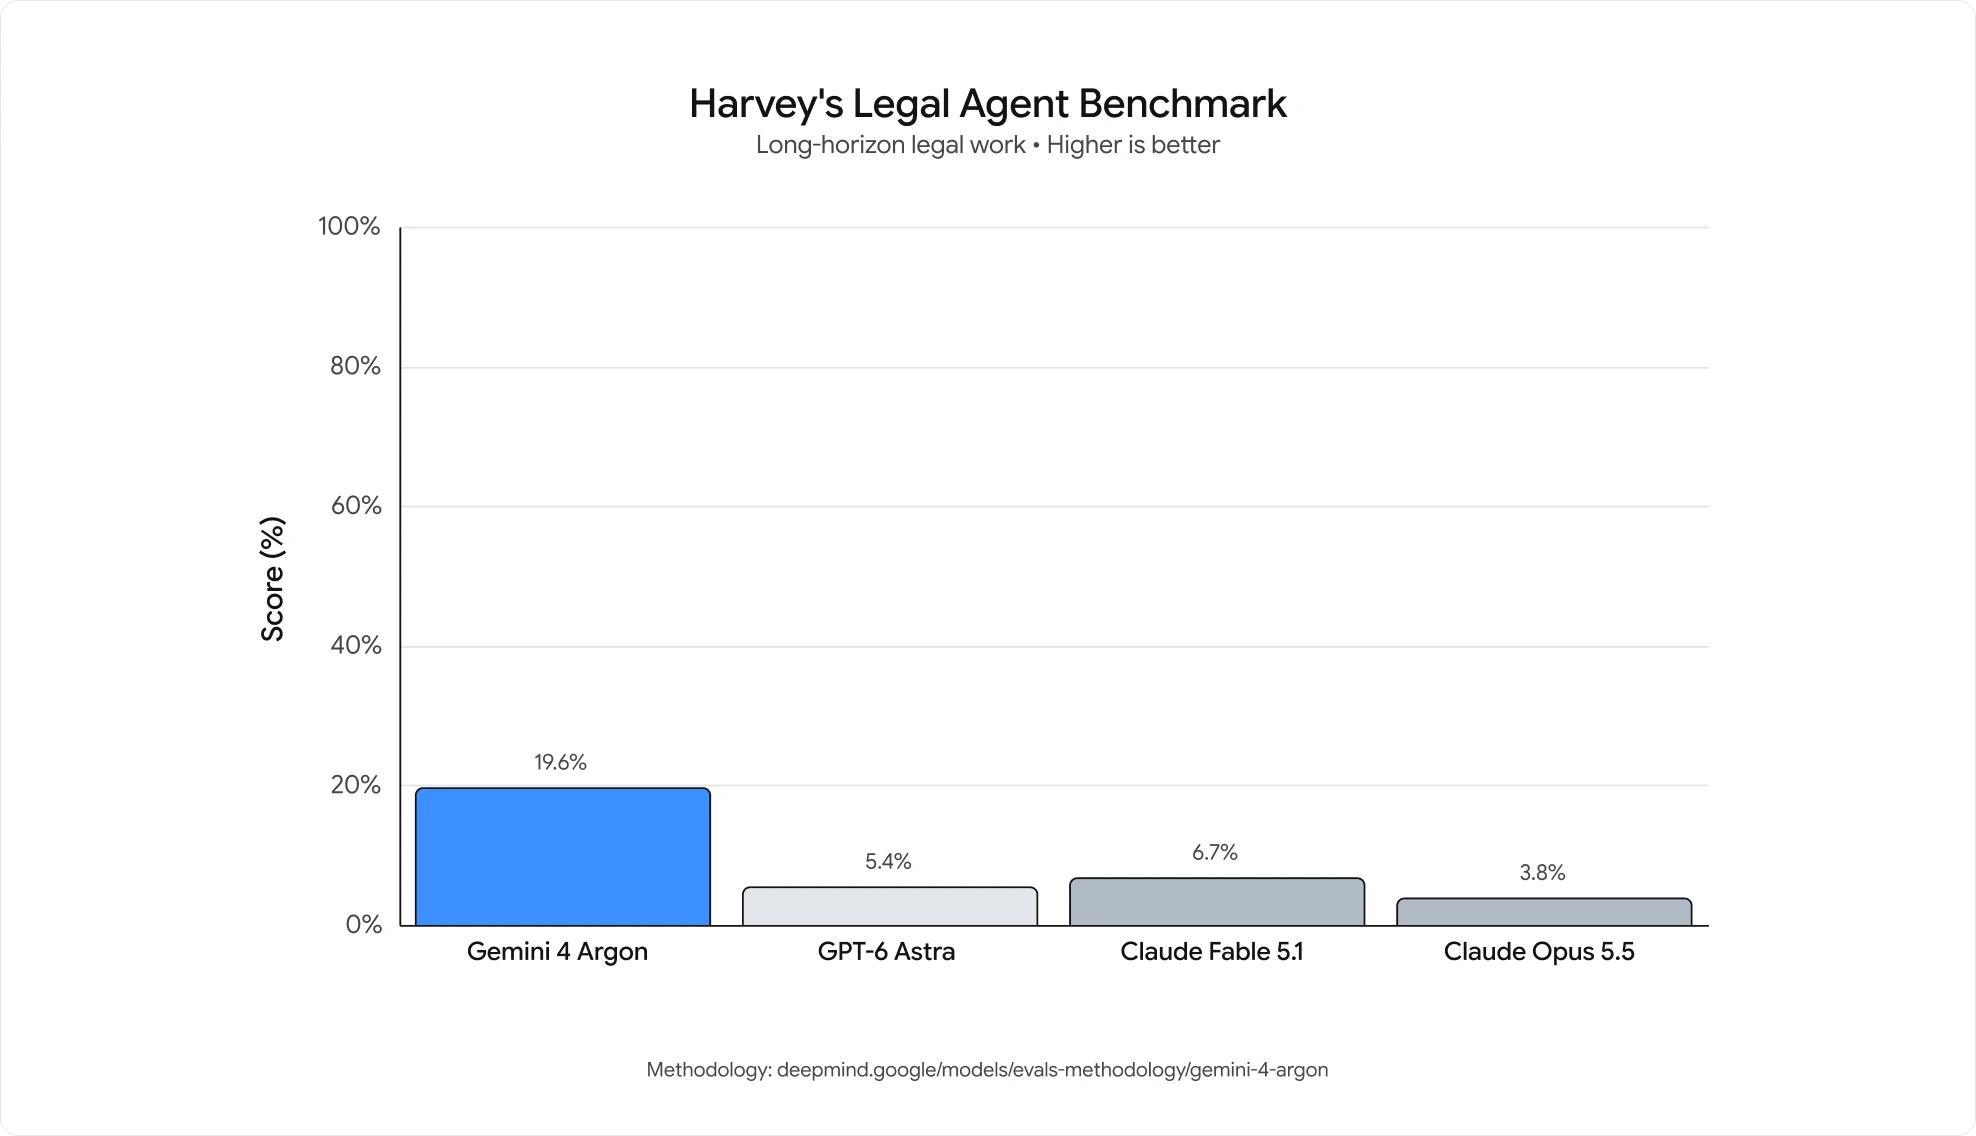
Harvey's Legal Agent Benchmark 長條圖:Gemini 4 Argon 19.6%,Claude Fable 5.1 6.7%,GPT-6 Astra 5.4%,Claude Opus 5.5 3.8%
長時程法律工作。Argon 的 19.6% 約為第二名模型的三倍,是 Google 公布資料中差距最大的一項。
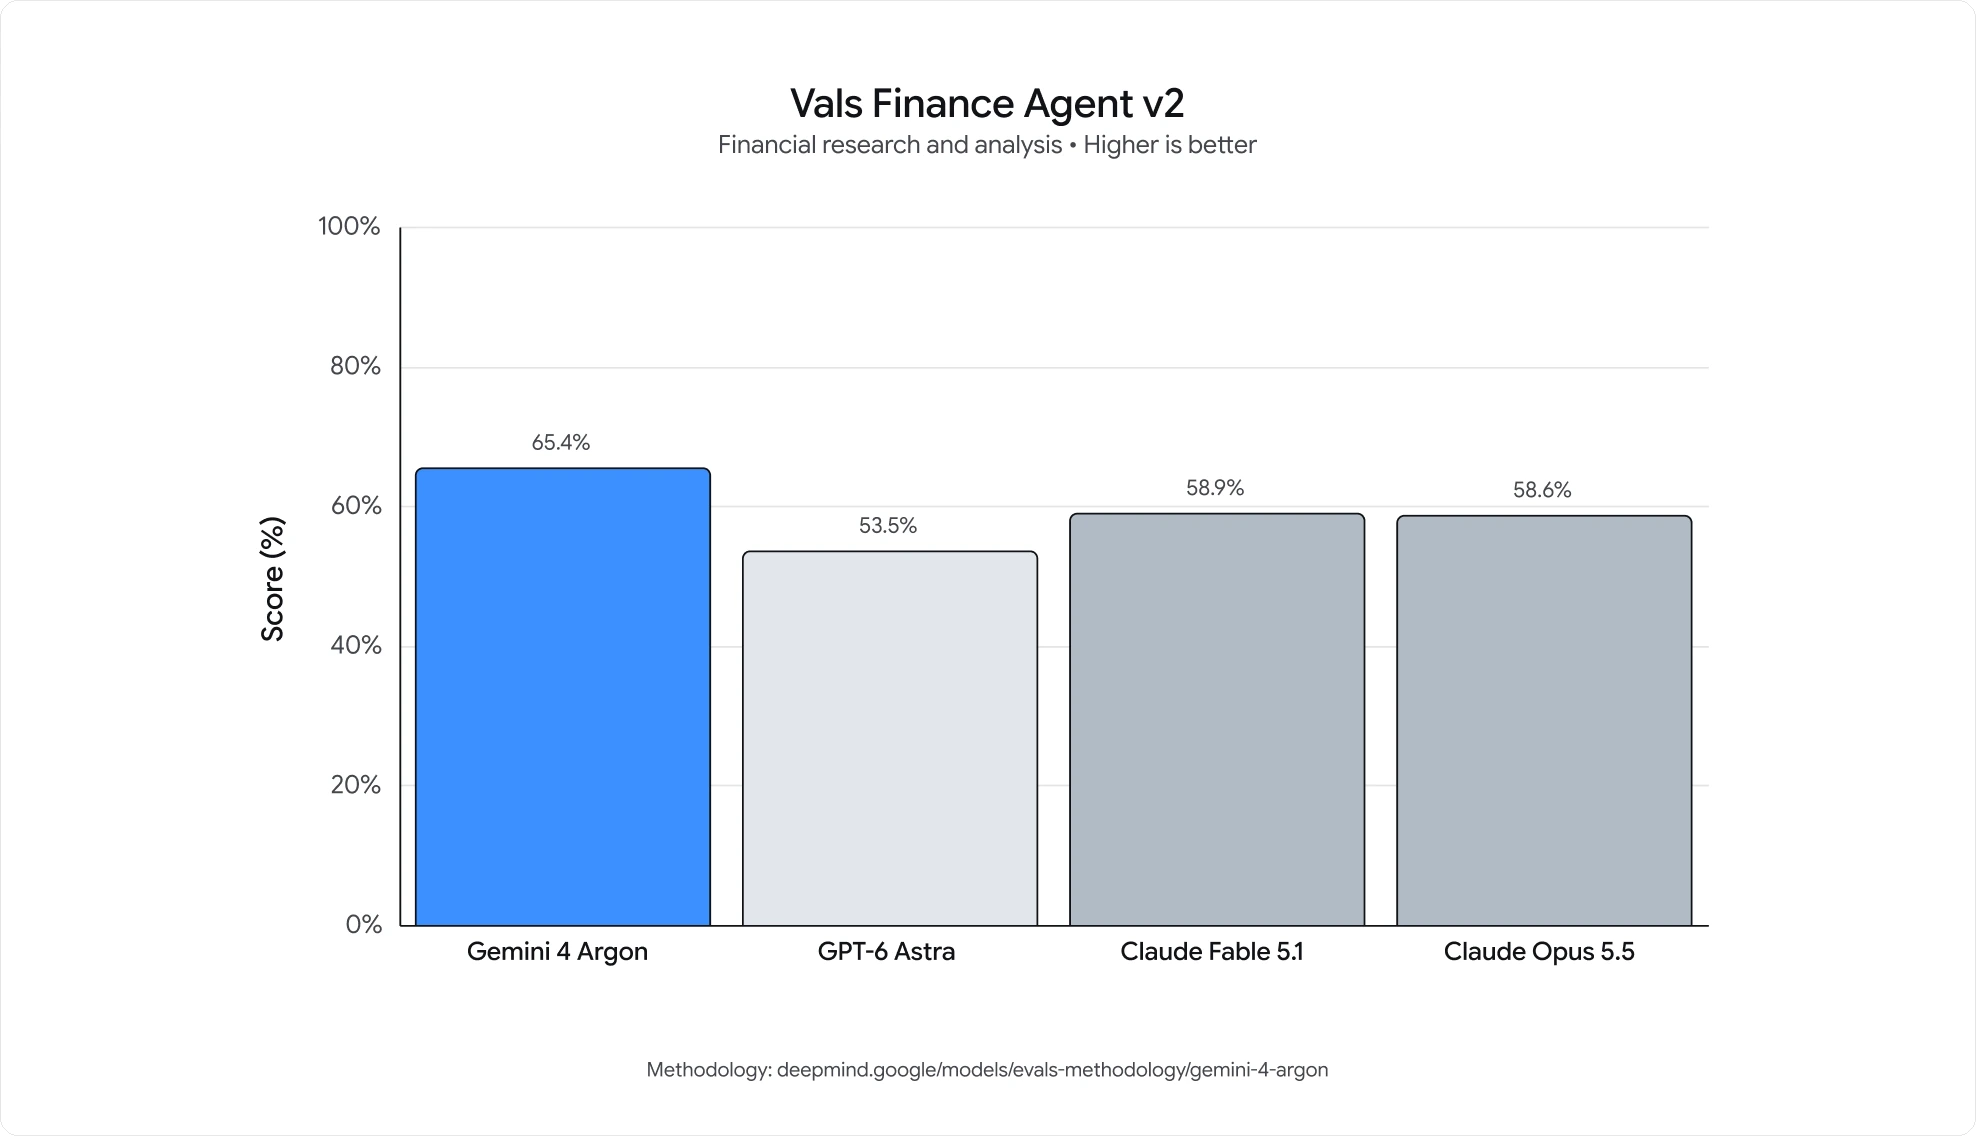
Vals Finance Agent v2 長條圖:Gemini 4 Argon 65.4%,Claude Fable 5.1 58.9%,Claude Opus 5.5 58.6%,GPT-6 Astra 53.5%
財務研究與分析,65.4% 對上 53.5%–58.9% 的群體。領先幅度不如法律工作,但排序一致。

公布數據

在 Google 自家基準上,Argon 站在哪裡

以下皆為廠商自行公布的結果。Google 沒有說明這些頭條分數對應的思考或 effort 設定,目前也還沒有獨立實驗室重現。

基準
衡量內容
Argon
最接近的對照
DeepSWE v1.1
長週期軟體工程
77.9%
Opus 5.5 為 74.2%,GPT-6 Astra 為 74.1%
CWE-bench v1
找出並修補漏洞
68%
並列第一
AutomationBench
端到端業務任務,來自 Zapier
51.3%
排名第一
LVBench
長影片理解
91.7%
Google 為 Argon 公布的最高分

這些數字只能當成方向參考。廠商基準很少能在生產負載中原樣成立,Bloomberg 也報導,部分 Google 員工自己就懷疑這種跑分領先能否轉移到真實工作。
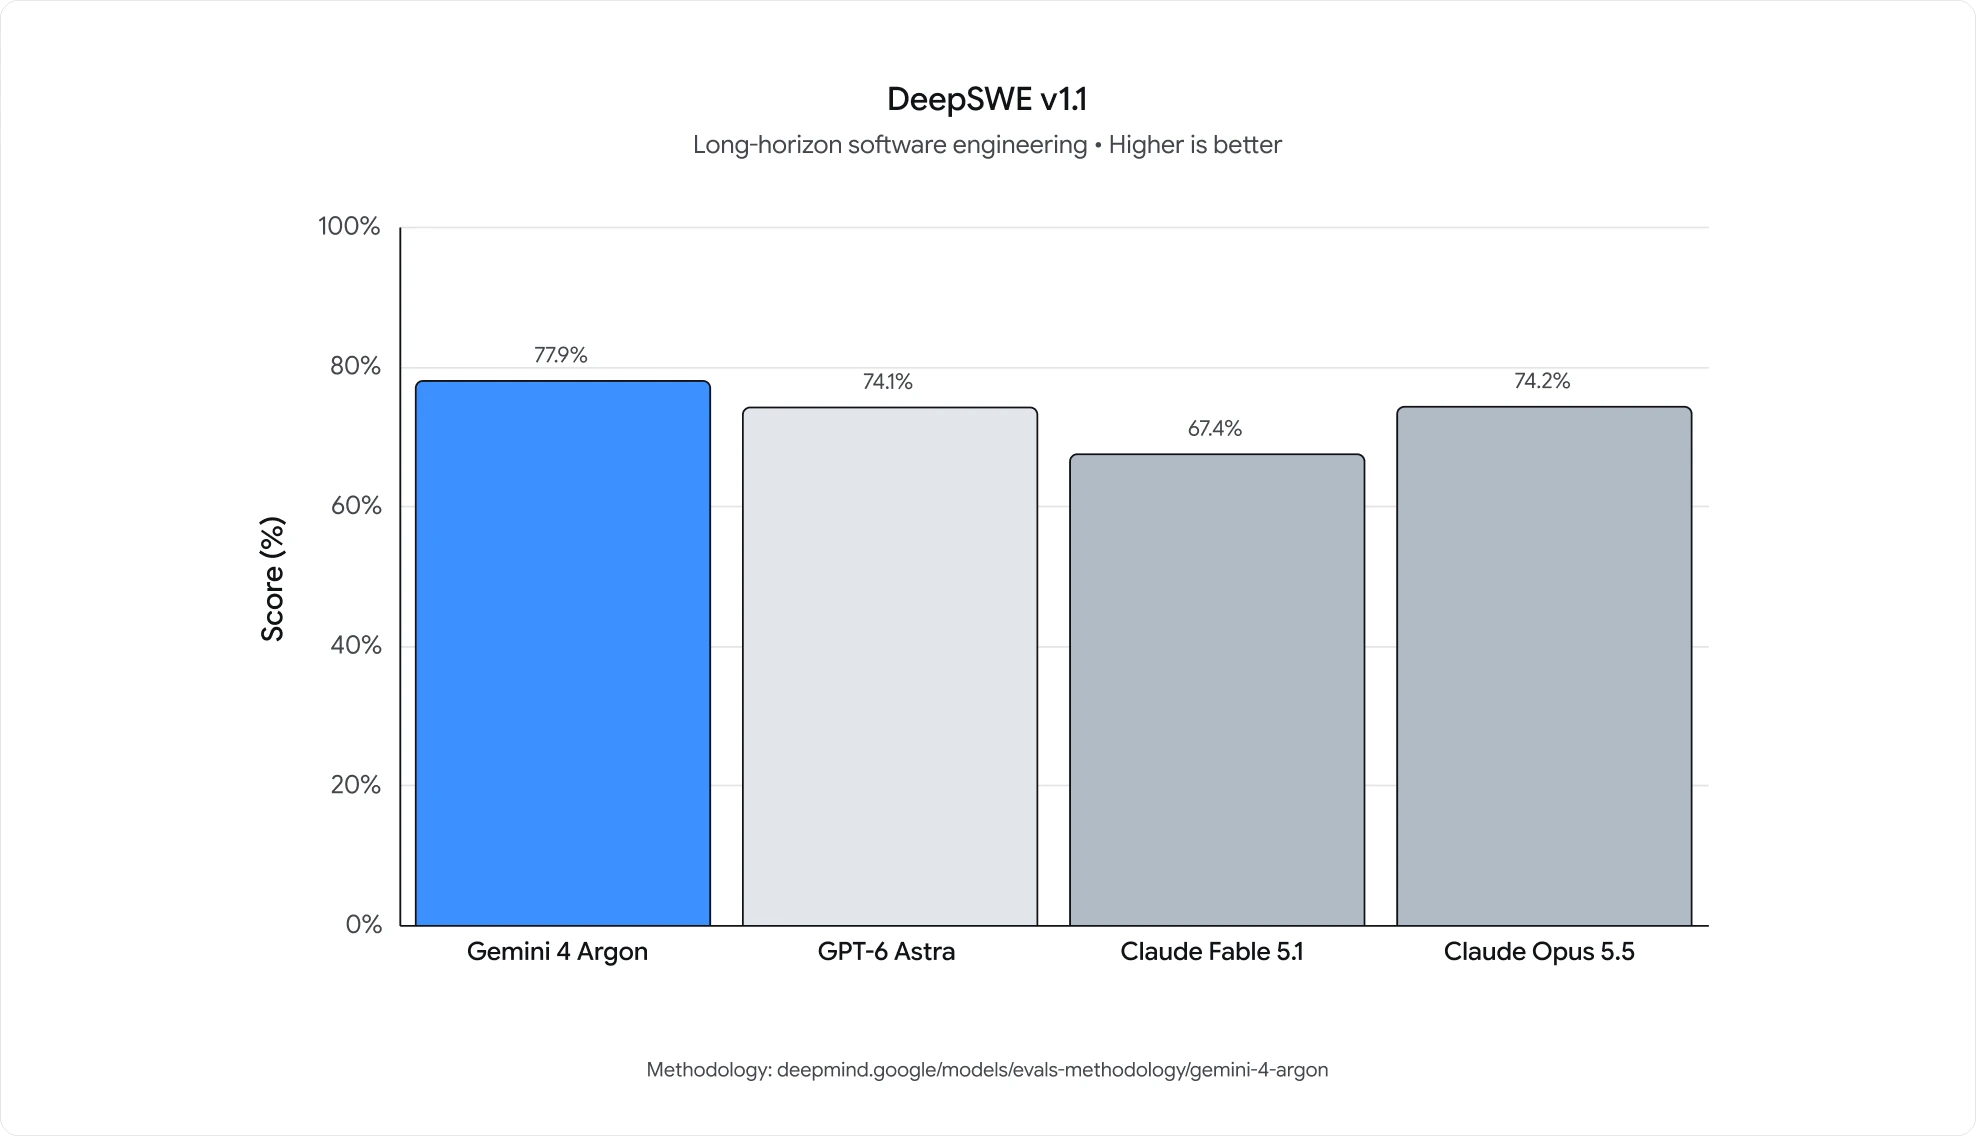
DeepSWE v1.1 長條圖:Gemini 4 Argon 77.9%,Claude Opus 5.5 74.2%,GPT-6 Astra 74.1%,Claude Fable 5.1 67.4%
長時程軟體工程。頭條成績 77.9%,兩個最接近的對手都在 4 個百分點以內。
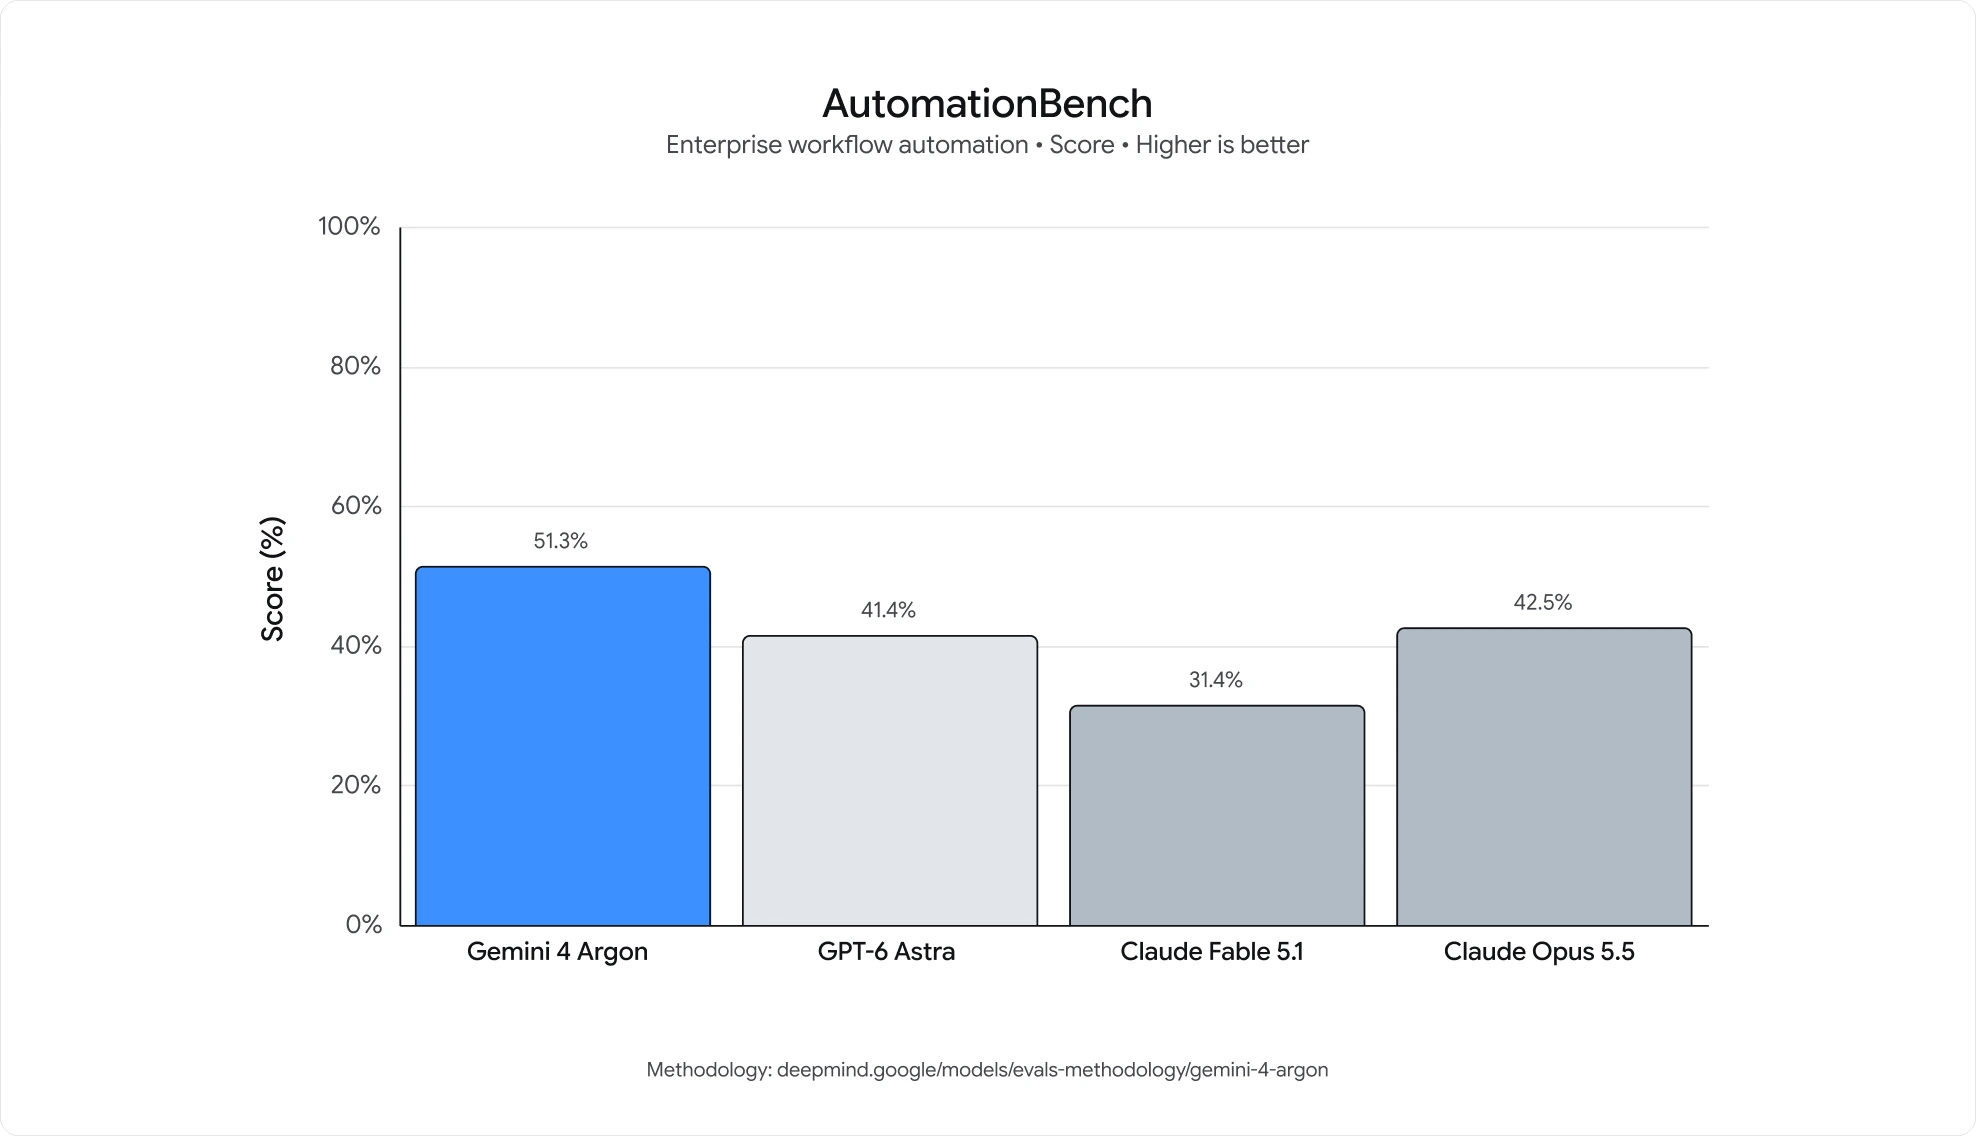
AutomationBench 長條圖:Gemini 4 Argon 51.3%,Claude Opus 5.5 42.5%,GPT-6 Astra 41.4%,Claude Fable 5.1 31.4%
由 Zapier 打造的端到端業務任務。Argon 跨過 50%,對照中的其他模型則全落在三十幾或四十初。
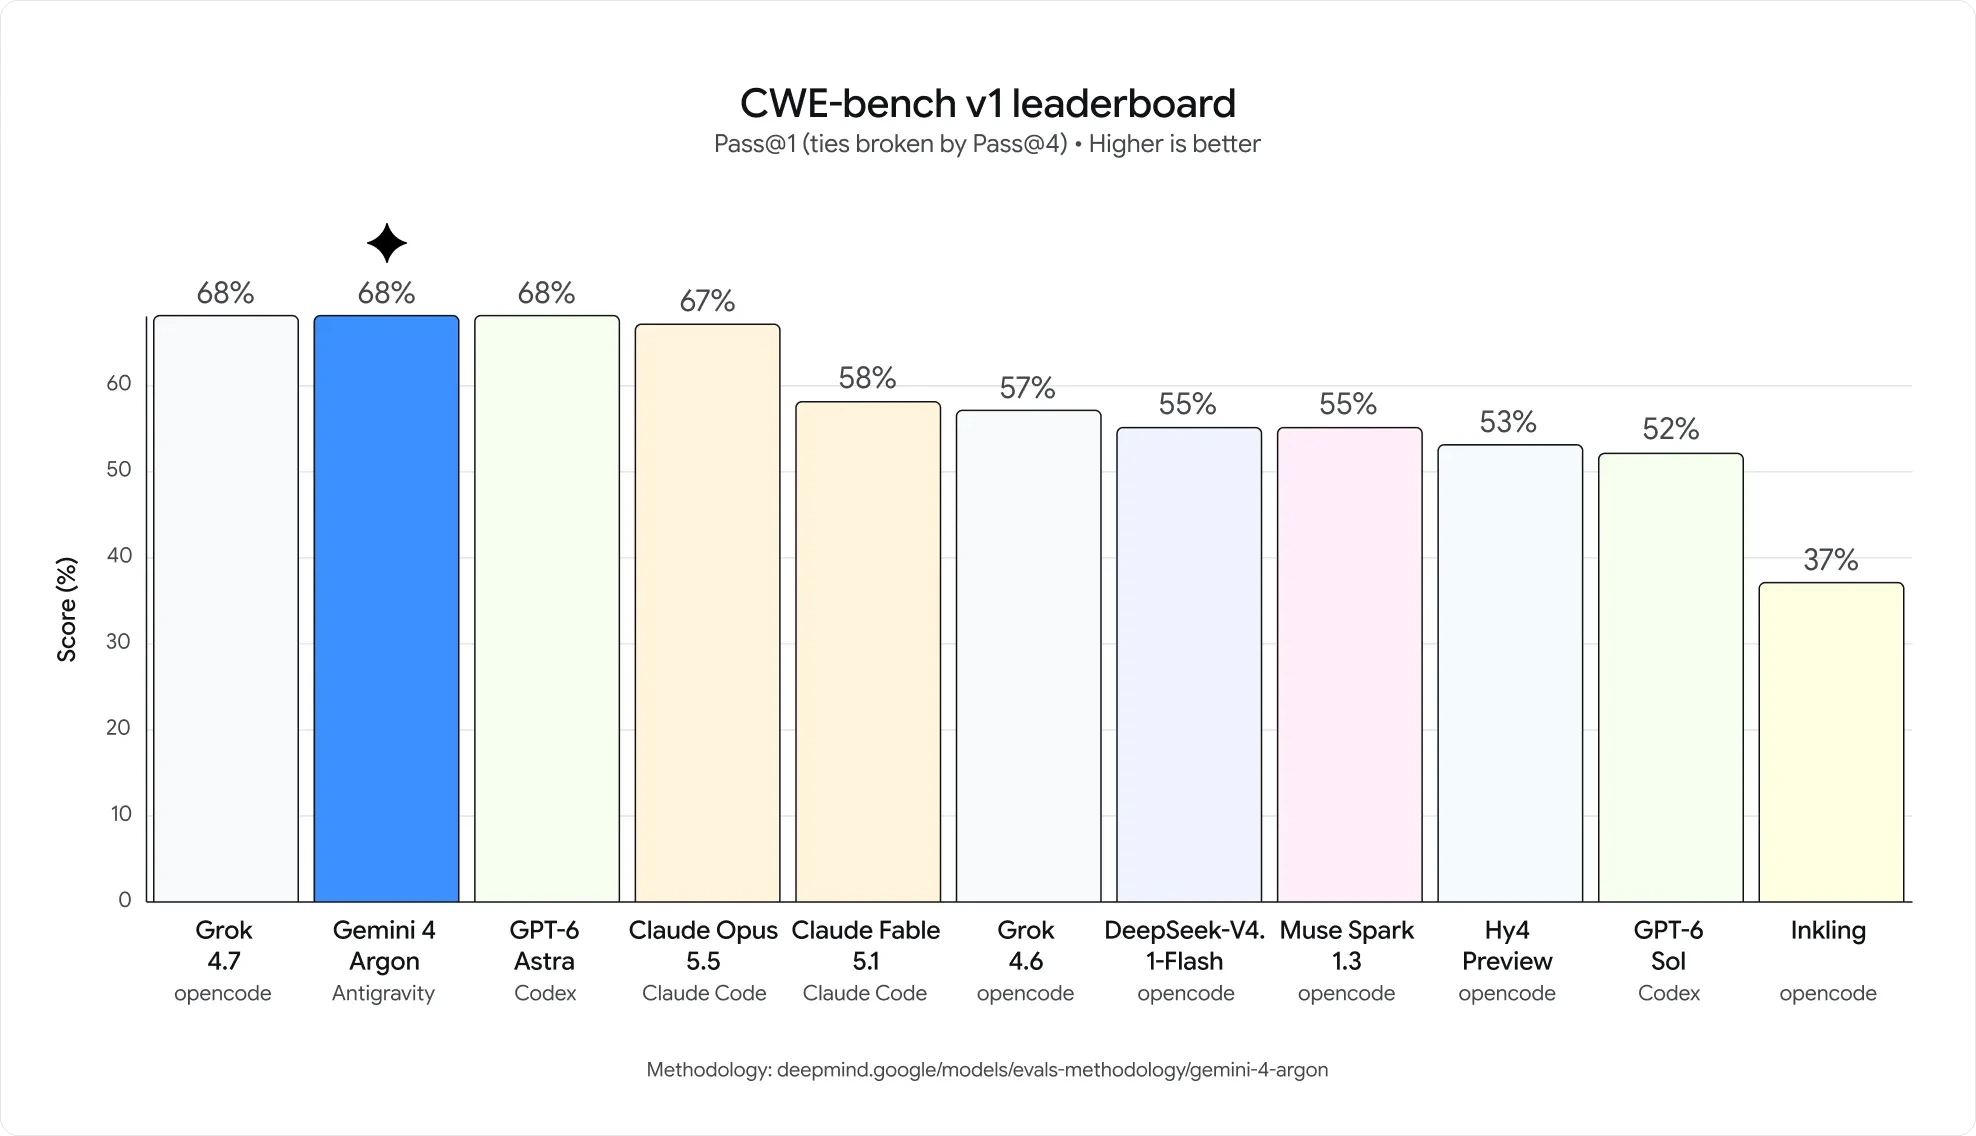
CWE-bench v1 排行榜:Gemini 4 Argon、Grok 與 GPT-6 Astra 以 68% 並列,Claude Opus 5.5 為 67%,一路遞減至 Inkling 的 37%
Pass@1 的漏洞發現。Argon 是在擁擠的榜首並列,而不是拉開差距,這也是上表稱其並列第一的原因。
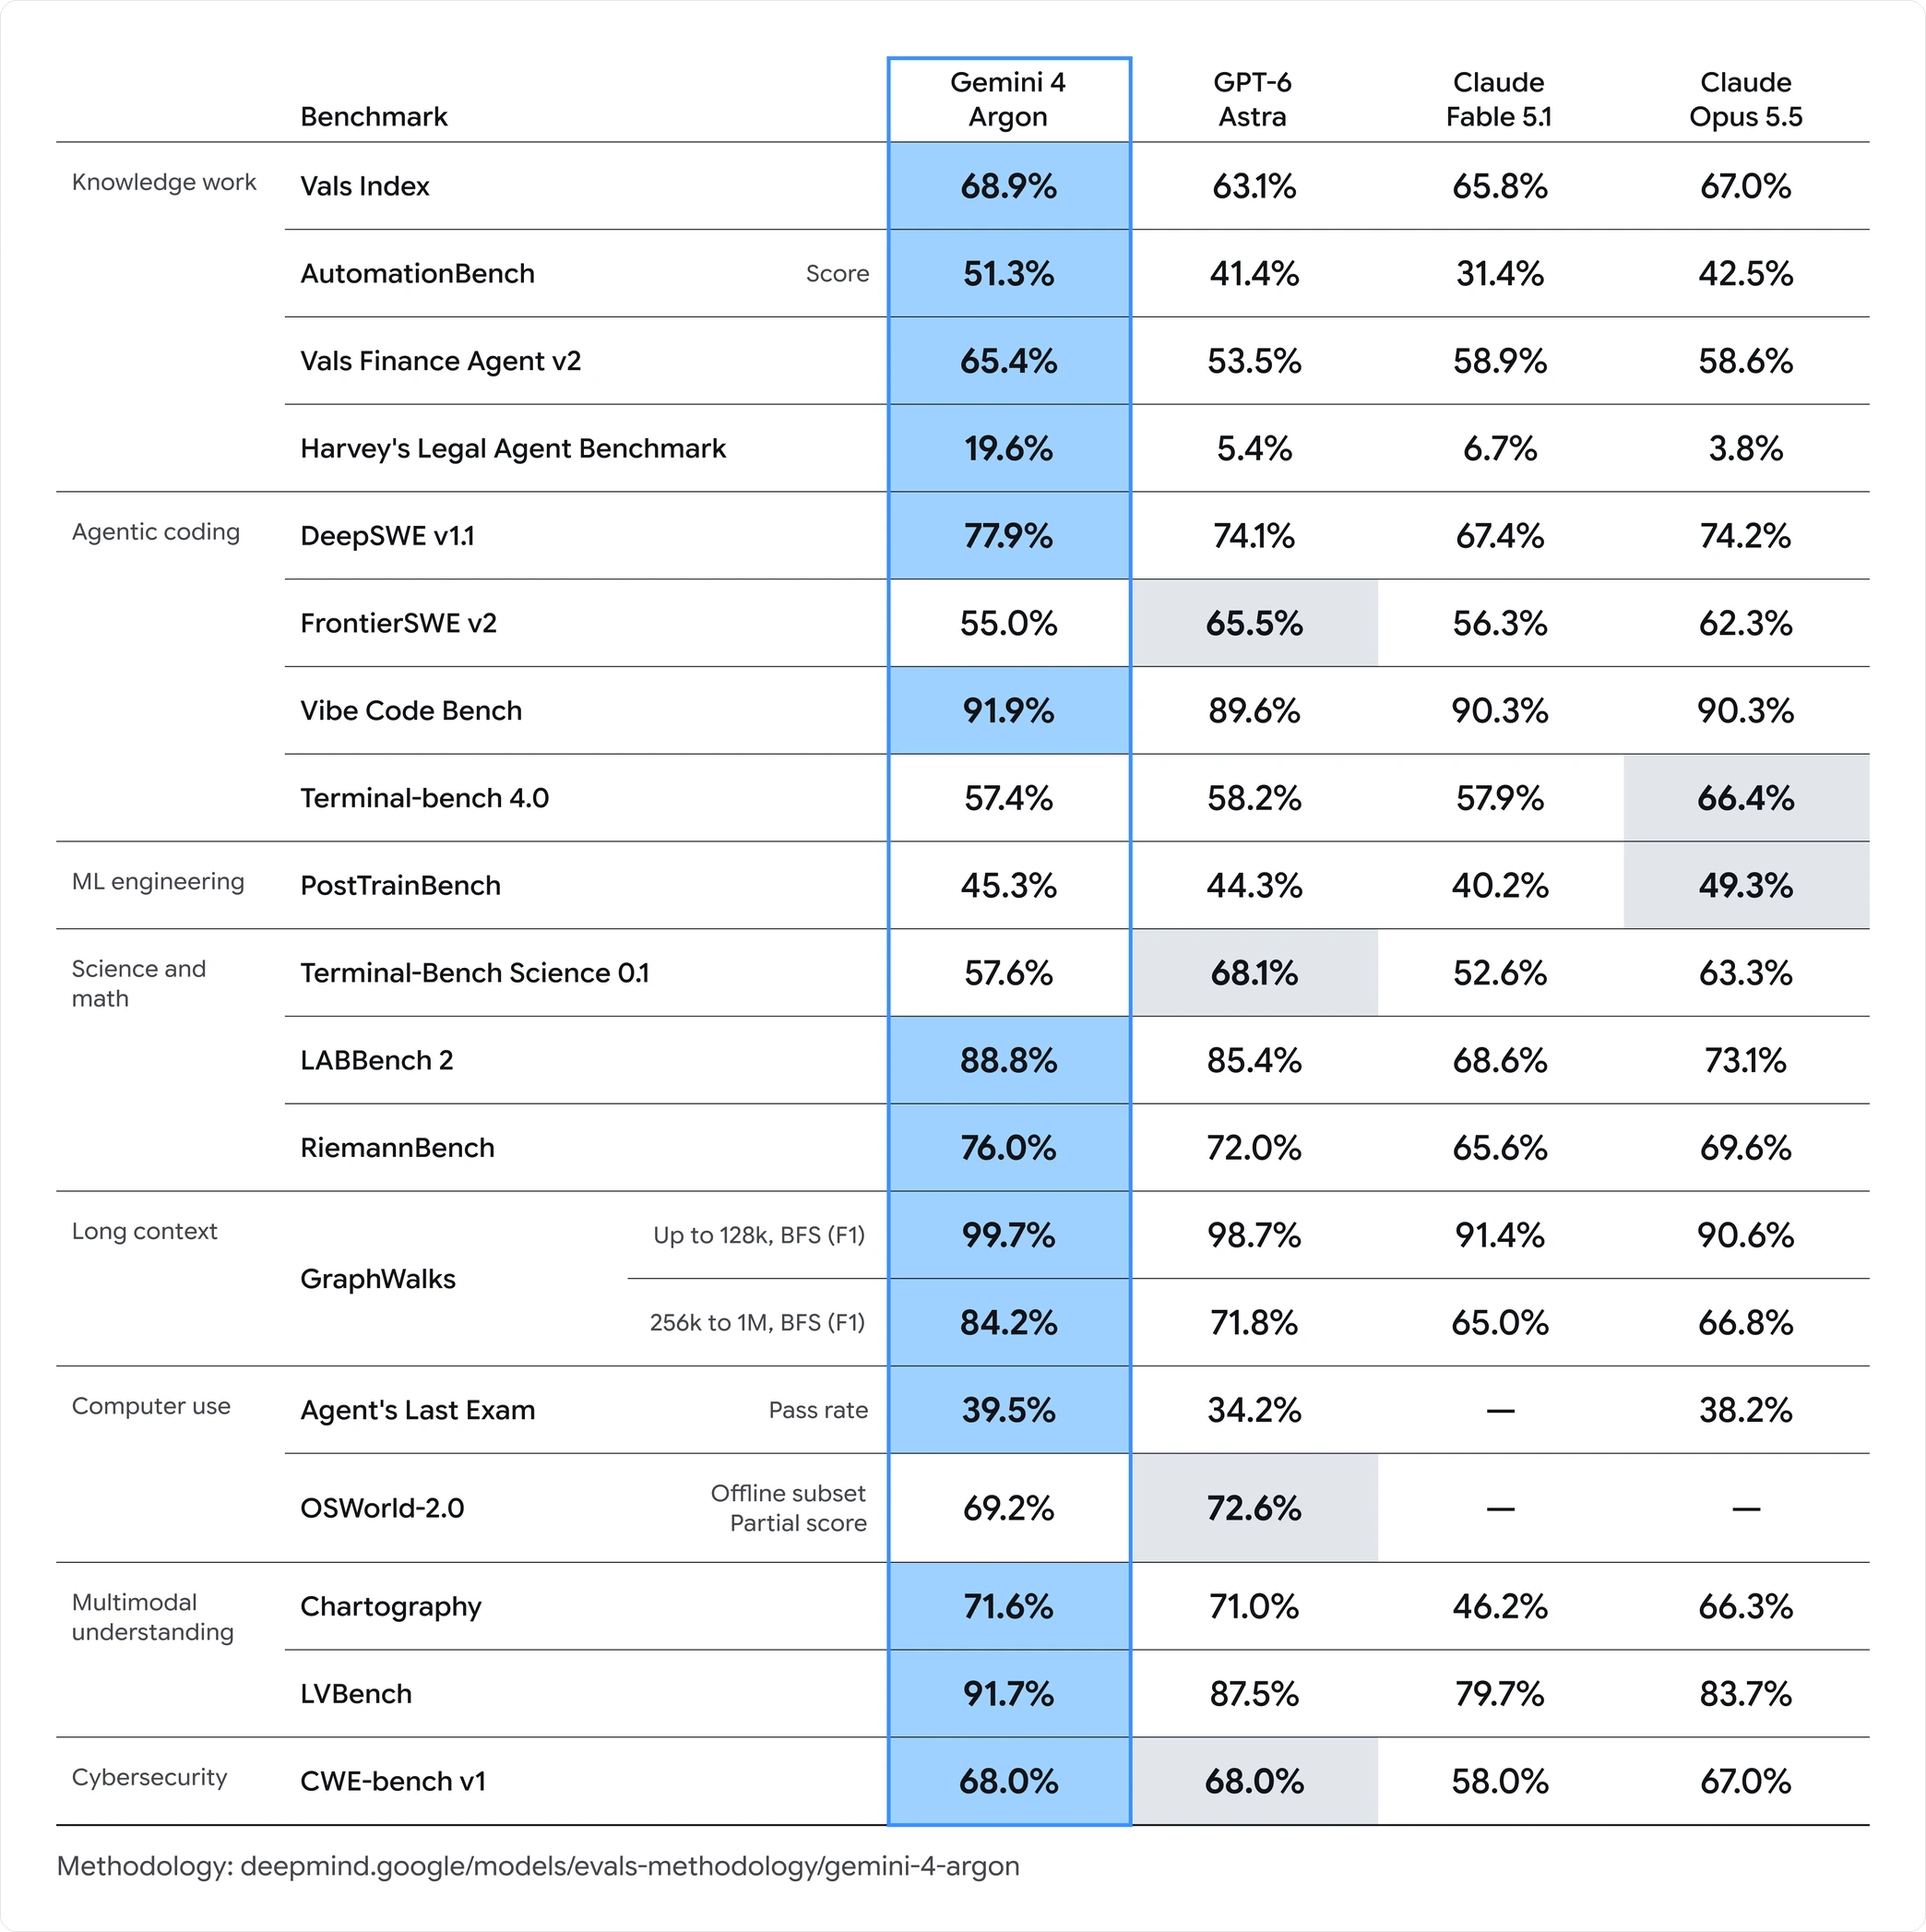
Google 公布的 Gemini 4 Argon 完整結果表,涵蓋 16 項基準,分為知識工作、代理式程式開發、機器學習工程、科學與數學、長上下文、電腦操作、多模態理解、網路安全八組
發布資料中的完整表格,Argon 領先的格子為藍色,競爭對手領先的格子為灰色。Argon 未領先的列是 FrontierSWE v2、Terminal-Bench 4.0、PostTrainBench、Terminal-Bench Science 0.1 與 OSWorld-2.0。
Artificial Analysis 的 AA-Omniscience 幻覺率長條圖,涵蓋 36 個模型,由低至高排列:Gemini 4 Argon(High)為 15%,接著是 MiniMax-M3 的 18%、Kimi K2.5 的 26%,一路升到 DeepSeek-V4 Flash 的 96%
這是 Artificial Analysis 的獨立測量結果,也是本頁唯一沒有廠商提供的數字:它衡量每個模型多常給出錯誤答案,而非選擇不作答。Argon 的 15% 是圖中 36 個模型裡最低的,量表上限為 96%。
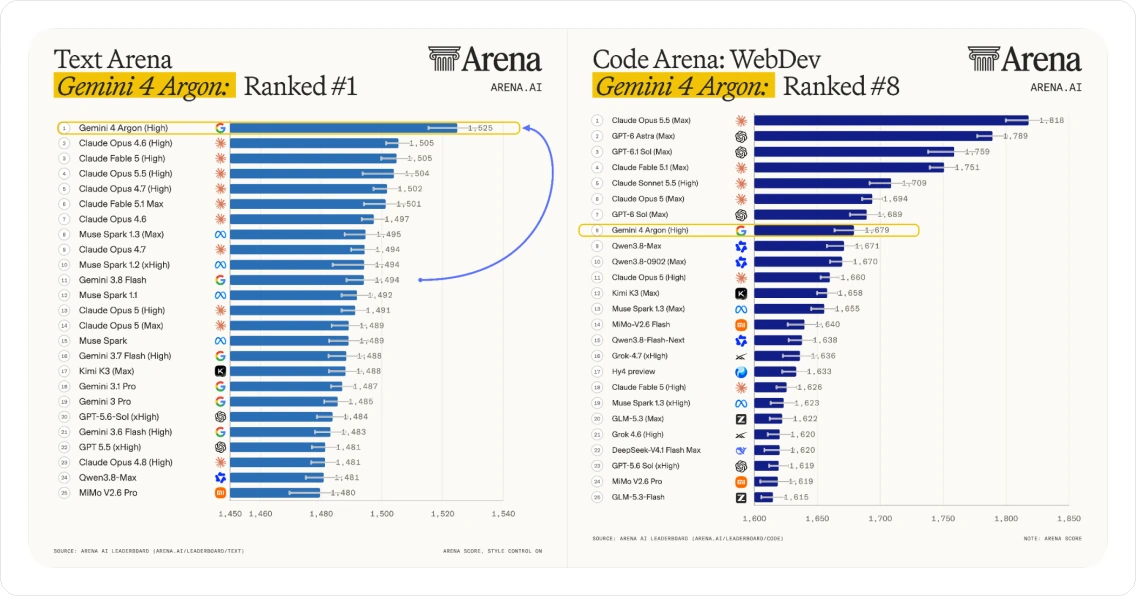
Arena.ai 的 Text Arena 與 Code Arena: WebDev 排行榜並列呈現:Gemini 4 Argon 在 Text Arena 以 1,625 排名第一,在 Code Arena: WebDev 以 1,679 排名第八
上面那段話所依據的兩個排名,出自 Arena.ai 的群眾投票排行榜。Argon 在 Text Arena 上榜的 25 個模型中居首;在 Code Arena: WebDev 中排第八,落後四個 Claude 模型與 OpenAI GPT-6 系列的三款模型。

在 Felo 上

有了能寫 1M token 的模型,研究工作流會變成什麼樣子

Felo 把搜尋與文件理解放在一起,所以一個長輸出模型會改變單次工作階段能產出多少東西。

以一份文件收尾的調研

先蒐集資料,再讓模型一次寫出綜整,而不是拆成許多提示詞、一段段拼起來。

整批文件,一個任務

長上下文檢索是 Argon 最強的一項能力,也正是它讓合約組合、申報文件與長篇報告變得可處理。

講究語感的撰稿

Argon 公布的畫像是文字強、程式中等,適合需要讀起來像人寫的、而不是拼裝出來的文字團隊。

成本

Argon 的價格,以及之後會怎麼變

Google 公布了首發價與較高的牌價,卻沒有說明何時切換。編預算時請以較高的數字為準。

Token 類型
首發價
之後
輸入
2.00 美元 / 百萬 token
4.00 美元 / 百萬 token
快取輸入
95% 折扣
95% 折扣
輸出
10.00 美元 / 百萬 token
20.00 美元 / 百萬 token

作為對照,首發價大致與 GPT-6.1 Sol 和 Sonnet 5.5 相當,約為 GPT-6 Astra 的五分之一。這些都是牌價,不是實測的單一任務成本——Argon 回答的問題更難,單次執行仍可能更貴。

在 Felo 上用 Argon 做事的方法

01

把完整的問題帶進來

把整批文件或整串長討論交給 Felo,而不是它的摘要。當上下文開始塞不進提示詞,Argon 的優勢才會浮現。

02

直接要最終成品

有了 1M token 的輸出上限,你可以用一句指令要一份完整報告或完整初稿,而不必分章索取。

03

對照來源檢查一遍

Felo 會把引用留在答案旁邊,模型產出的長文件因此才檢查得下去。

Argon 在 Felo 搜尋中的接入正在進行。在開放之前,Felo 模型陣容裡的其他模型現在都能使用。

開啟 Felo AI 搜尋

Gemini 4 Argon 常見問題

還無法普遍使用。Google 先將 Argon 開放給 Fairwind 計畫中的獲選合作夥伴,並表示更廣泛的開放會從付費 API 客戶與 Google AI Ultra 訂戶開始。該階段尚未公布日期,目前光有付費訂閱也拿不到使用權。

在 Felo 上試用 Google 的前沿模型

依任務挑模型來搜尋、閱讀與寫作。當 Argon 的開放推進到 Felo,它也會加入陣容。

開啟 Felo AI 搜尋

使用 Felo AI 搜尋不需要信用卡。