01
一次裝下全部脈絡
100 萬 token 上下文視窗,知識截止到 2026 年 6 月。長對話、整個程式碼倉庫或一整套文件都能留在同一個任務裡。
Anthropic 於 2026 年 9 月 22 日發布 Opus 5.5
Anthropic Claude 5.5 家族的首款模型。它在多數任務上達到 Claude Fable 5.1 的水準,執行成本比 Opus 5 低 40%,輸出速度提升超過 30%。
現已接入 Felo 搜尋
Claude Opus 5.5 已在 Felo 搜尋中上線,適合處理長輸入的任務:跨檔案核對數字、把結論追溯回出處,最後交出一份可以直接轉給別人的答案。
01
100 萬 token 上下文視窗,知識截止到 2026 年 6 月。長對話、整個程式碼倉庫或一整套文件都能留在同一個任務裡。
02
在 Anthropic 的內部測試中,18 份報告有 16 份通過品質門檻;該任務只要出現一個捏造的數字或引文就會判定失敗。
03
Anthropic 重寫了模型的表達方式:最重要的資訊放在最前面,報告會直接說明已完成什麼、發現了什麼、還有什麼沒解決。
快速上手
Claude Opus 5.5 會與其他領先模型一起出現在你帳號的模型選擇器中。
Opus 5.5 的不同之處
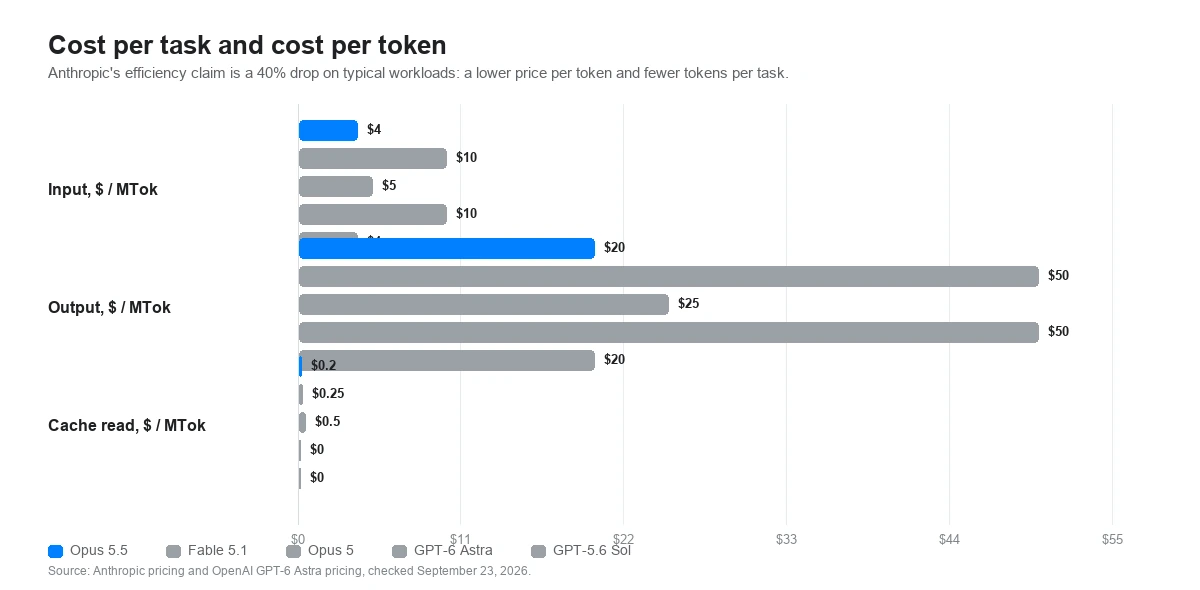
Anthropic 這次強調的是效率,而不是更高的跑分:每個任務消耗的 token 更少,單價更低,典型工作負載的成本下降 40%。正是這一點讓長時間執行的代理任務變得負擔得起。
01
Anthropic 提到一位早期測試者用不到三小時稽核並修復了 20 萬行程式碼庫,而 Opus 5 花了 20 多個小時,token 用量還是它的 2.5 倍。
02
Deloitte 報告指出,Opus 5.5 在最低 effort 等級下於程式碼審查中發現了 72% 的已知 bug,而 Opus 5 在 high 等級下為 56%,且誤報更少。
03
它的文字更短、結構更清楚。Box 報告指出答案冗長程度降低 40% 而準確率不變,token 用量只有 Opus 5 的三分之一。
模型選擇
下表是官方公開 API 價格,按每百萬 token 計,不是 Felo 的訂閱或用量價格。effort 那一列和價格一樣重要:同一個提示詞,各模型起點不同,花費可能相差很大。
以上公開 API 價格與預設等級於 2026 年 9 月 23 日核對自 Anthropic 的 Claude Opus 5.5 發布公告、Claude Platform 模型頁以及 OpenAI 的 GPT-6 Astra 頁面。token 單價只是任務總成本的一部分;Anthropic 自己的效率說法是典型工作負載成本下降 40%,這個數字同時包含單價下降與單一任務 token 用量減少。
Anthropic 公布的成績
Anthropic 把自己的成績與 Fable 5.1、Opus 5、GPT-6 Astra 和 GPT-5.6 Sol 並列公布。下面四張圖中有兩張畫的是準確率與單一任務成本的關係,而不是單純的準確率,因為這才是 Anthropic 想做的對比。
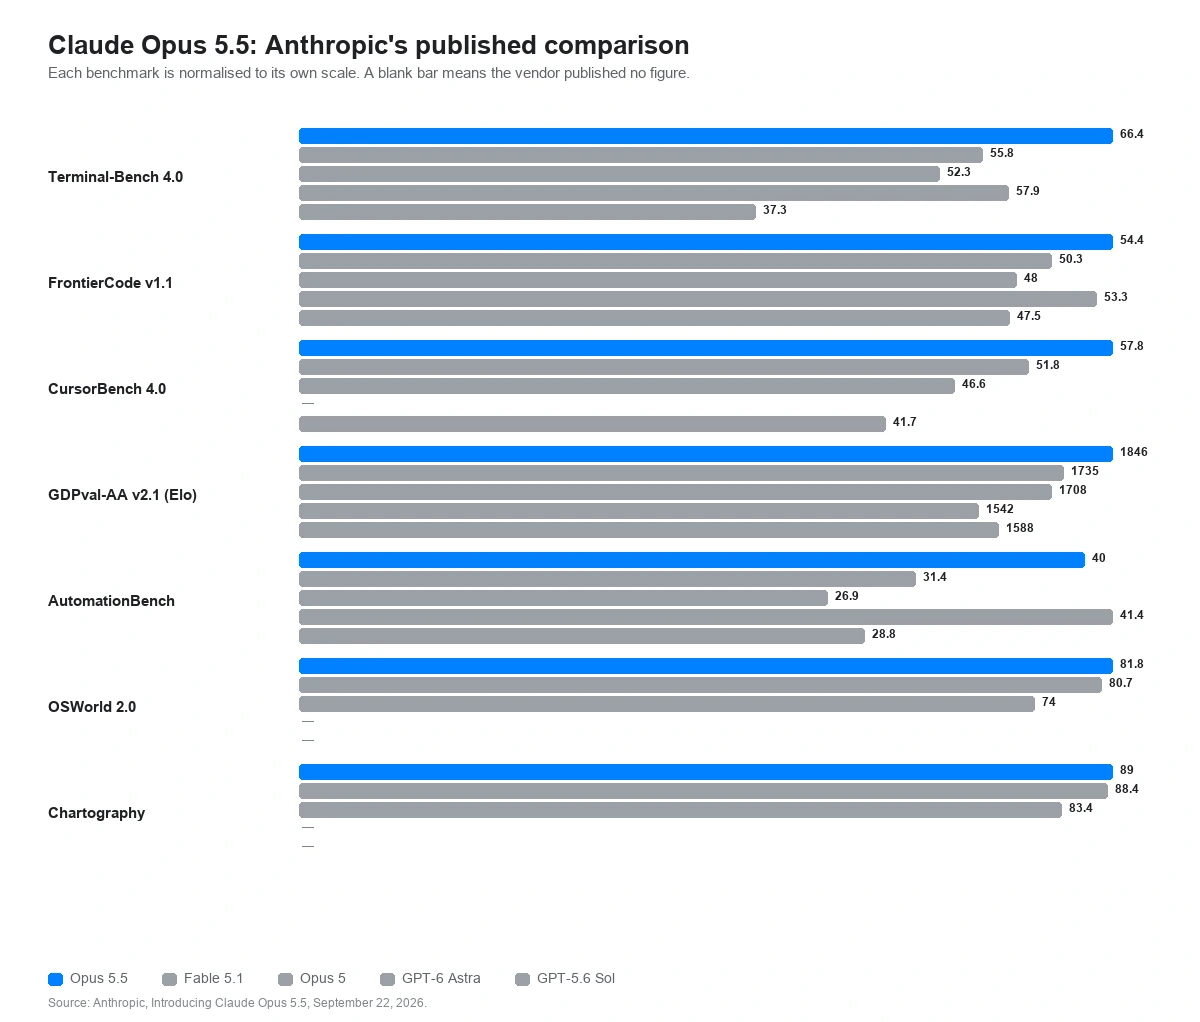
完整的官方對比
涵蓋代理程式開發、知識工作、業務流程、跨領域推理、科研、電腦操作與圖表辨識,涵蓋 Anthropic 測量的全部五款模型。
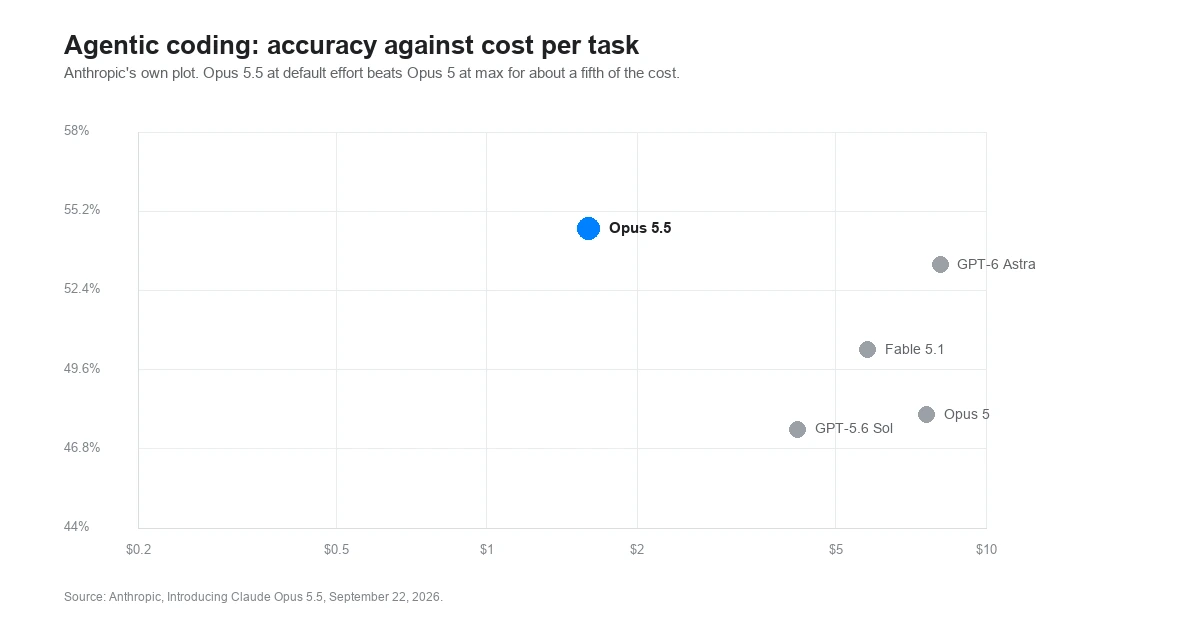
代理程式開發
Terminal-Bench 4.0、FrontierCode v1.1 與 CursorBench 4.0,橫軸為單一任務成本,縱軸為準確率。
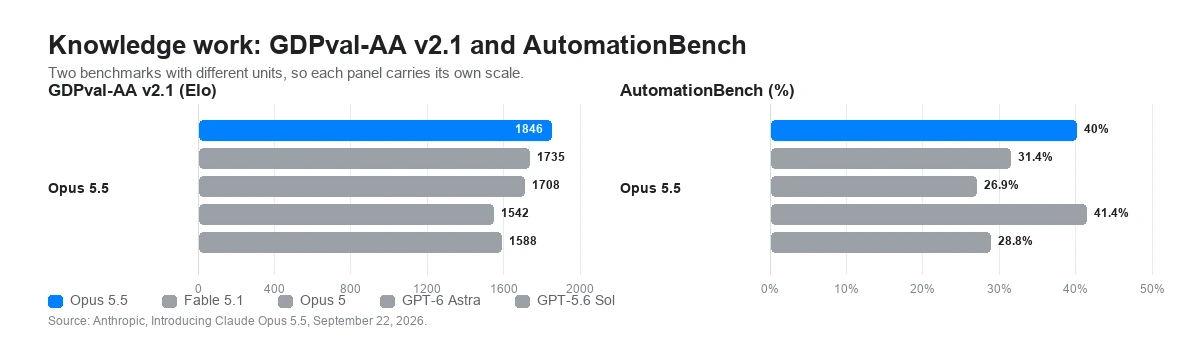
知識工作
涵蓋 44 種職業的 GDPval-AA v2.1、AutomationBench,以及 Perplexity 的資料蒐集基準 WANDR。
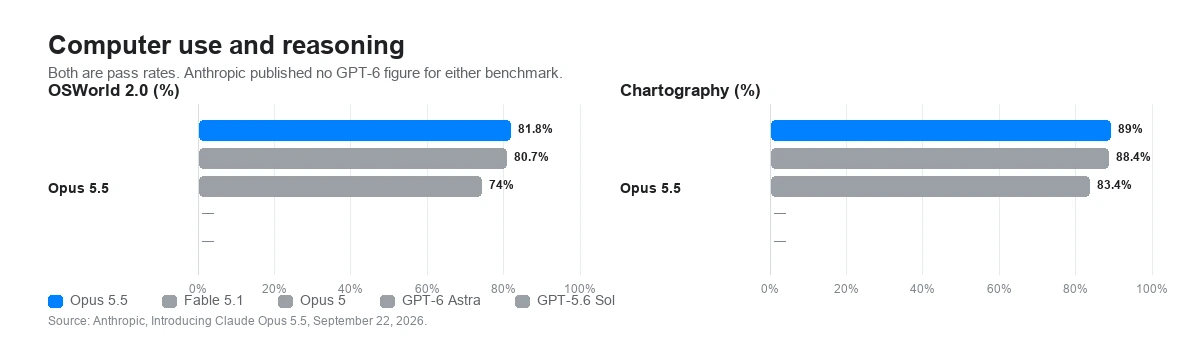
電腦操作與推理
OSWorld 2.0、Humanity's Last Exam 與 Chartography,其中最後一項衡量的是從圖表中讀取數值的準確度。
準確率與單一任務成本
Anthropic 的核心主張不是在任何成本下都拿到更高分,而是在成本降到零頭的同時拿到持平或更好的成績。
廠商公布資料。除另有說明外,Anthropic 在 max effort 下啟用自適應思考執行 Opus 5.5,並在生產防護開啟的情況下評測;當防護介入時,網路安全任務由 Opus 4.8 完成,生物學任務由 Opus 5 完成,這很可能壓低了 Opus 5.5 在這些基準上的公布成績。GPT-6 Astra 與 GPT-5.6 Sol 的資料來自 OpenAI 公布值。跨廠商的跑分差距只能作為現實差異的弱參考,這也是 Anthropic 自己對這組數字的說明。
如果你已經在跑 Opus 5
Anthropic 列出了四項針對已在 Claude Opus 5 上執行的整合的破壞性變更,另外還有一項會改變回應結構但不會讓請求失敗。換模型 ID 之前值得先讀一遍,因為其中三項會直接回傳 400 錯誤,而不是悄悄降級。
01
在 Opus 5 上,high 及以下等級可以關閉思考。Opus 5.5 始終開啟,關閉寫法與手動 token 預算都會回傳 400 錯誤。effort 成了唯一的控制手段,預設等級也從 high 變成 medium。
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice 設為 "any" 或指定某個工具名稱都會回傳 400 錯誤,token 計數端點同樣如此。改用 auto 搭配嚴格工具呼叫或結構化輸出,並在提示詞裡說明何時該用該工具。
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
每個思考區塊都會記錄產出它的模型。Opus 5.5 可以讀取 Opus 5 及更早的 Opus、Sonnet、Haiku 模型的思考區塊,但讀不了 Fable 與 Mythos 的。如果路由把對話切到其他模型,後續輪次將不再帶上先前的推理。
Opus 5.5 -> Fable 5.1 / Mythos 5.1 保留思考;其他模型會丟棄
04
在 Claude API 與 Google Cloud 上,computer_20251124 工具會回傳 400 錯誤。請改用 computer_toolset_20260801 工具集,移除 beta 標頭,並讓代理迴圈適合成員 tool_use 區塊。在 Amazon Bedrock 上舊工具仍可使用。
computer_20251124 -> computer_toolset_20260801
既然思考無法關閉,可調的就是 effort。Opus 5.5 支援全部五個等級,預設 medium,比 Opus 5 低一級。Anthropic 的建議是在自己的評測集上重新跑一輪等級掃描,而不是沿用舊設定;同時在高等級下把 max_tokens 設得足夠大,因為即使不回傳思考文字,思考 token 也計入其中。
effort 是行為訊號,而不是硬性 token 預算:在較低等級下,模型面對真正困難的問題仍會思考,只是比高等級少。Anthropic 還指出,在同一等級下 Opus 5.5 每輪思考量普遍多於 Opus 5,在 xhigh 與 max 下尤其明顯,因此沿用 Opus 5 的設定會讓每輪更長、更貴。
適用場景
當任務要跑幾個小時、涉及的檔案多到一個人裝不下,或者產出需要第二個人複核時,Opus 5.5 才真正體現出價值。以下場景來自 Anthropic 及其早期測試者的描述,不是泛泛的聊天提示詞。
把一處改動貫穿整個大型倉庫直到測試通過,而不是停在第一個看起來可行的補丁上。Anthropic 提到一位測試者用不到一天完成了 68 萬行的遷移。
Anthropic 的測試方 Column 報告指出,它透過查閱外部文件,發現了一個在好幾個提交之前就被建模錯誤的第三方整合 bug。
先建模型,再寫一頁紙的結論,並把前提與保留意見保留下來。Anthropic 報告指出一起併購分析用時 63 分鐘,Opus 5 為 93 分鐘,成本只有一半。
它會把任務分派給子代理,並依時間預算安排節奏。Anthropic 的建議是給多代理框架提供已耗時訊號,讓它並行推進而不是串行等待。
01
把程式碼倉庫、文件和需求都放進去,這些是答案必須考慮到的內容。100 萬 token 視窗正是為此存在。
02
講清楚什麼條件滿足才算做完。Anthropic 對無人值守執行的建議是:把任務的各個部分放進一份清單,讓模型持續更新。
03
在 Felo 裡把同一個任務分別交給 Opus 5.5、Opus 5 和 Fable 5.1。比的不只是答案,還有測試、保留意見和 token 消耗。
當你的帳號模型選擇器中出現 Claude Opus 5.5 時選中它即可。
在 Felo 試用 Opus 5.5Claude Opus 5.5 是 Anthropic 針對長時間執行的代理程式開發與知識工作推出的模型,於 2026 年 9 月 22 日發布,是 Claude 5.5 家族的首款模型。Anthropic 稱它在多數任務上達到 Claude Fable 5.1 的水準,而執行成本比 Claude Opus 5 低 40%。
在 Felo 裡把 Claude Opus 5.5 和其他領先模型放在一起,然後拿那個因為要跑幾個小時而一直拖著沒做的任務來試。
在 Felo 試用 Opus 5.5從 Felo AI 搜尋開始,在可用時選中該模型。