GPT-6 LunaOpenAI 的 $0.10 高用量模型
GPT-6 Luna 是 OpenAI GPT-6 世代中最便宜的档位,2026 年 9 月 22 日与 GPT-6 Sol 一同发布。OpenAI 把它定位在任务边界明确的高用量工作上:摘要、分类、抽取与路由。每百万输入 token $0.10,是 GPT-6 Sol 的二十分之一,也是 GPT-5.6 Luna 输入价格的一半。它已在 Felo AI Search 和 Felo API 上线。
自 2026年9月22日 起以 gpt-6-luna 在 OpenAI API 上线,每百万 token $0.10 / $0.50,即 GPT-5.6 Luna 输入价格的一半。
2026 年 9 月 22 日发布 · 现已在 Felo AI Search 和 Felo API 上线
价目表
GPT-6 Luna 一览
- 模型 ID
- gpt-6-luna
- 发布日期
- 2026年9月22日
- 输入
- 每百万 $0.10
- 缓存输入
- 每百万 $0.01
- 输出
- 每百万 $0.50
- 上下文窗口
- 1,050,000 token
$0.10 / $0.50
输入价格
每百万 token 的标准费率。
$0.01
缓存输入
按每百万 token 计,为输入费率的十分之一。
1.05M
上下文窗口
最大输入 922,000,最大输出 128,000。
gpt-6-luna
API 模型 ID
在 model 字段中发送的字符串。
一百万 token 的成本
Luna 的说服力来自算术,而不是形容词。以下是 OpenAI 公布的四项费率,以及它们在一个读取远多于写入的工作负载上会算出什么结果。
费率表
官方公布的标准费率,按每百万 token 计。
- 输入
- $0.10
- 缓存输入
- $0.01
- 缓存写入
- $0.125
- 输出
- $0.50
缓存输入按输入费率的十分之一计费。缓存写入的成本是未缓存读取的 1.25 倍,下文回本周期的计算正是围绕这一点展开。
混合工作负载下的成本
多数提示词的读取量远大于写入量,所以只看输入费率会高估实际成本。本列按每 1 个输出 token 对应 20 个输入 token 计算。
模型
每百万 token 混合成本
相对 Luna
GPT-6 Luna
$0.12
1x
GPT-5.6 Luna
$0.25
2.1x
GPT-6 Sol
$2.38
20x
GPT-6 Astra
$11.90
100x
本列由本文按各模型公布的费率、以 20:1 的输入输出比算出,没有厂商公布这一列。换一个比例,每个数字都会变:按 1:1 计算,Luna 的混合费率为每百万 $0.30;按 100:1 计算,约为 $0.10。
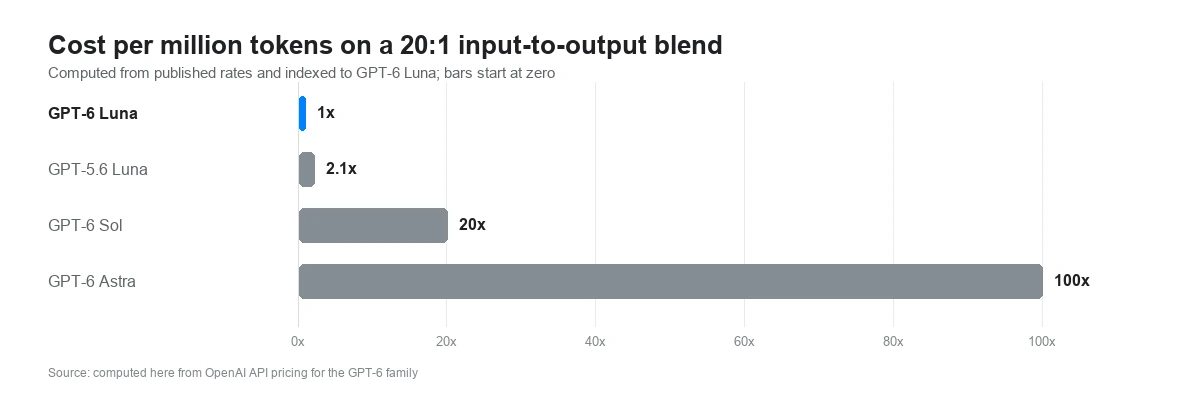
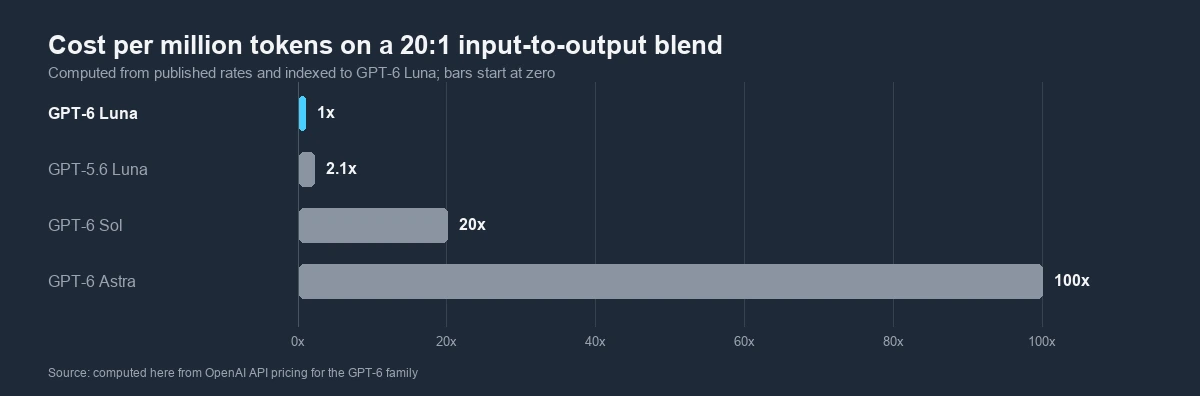
按 20:1 混合比例计算的每百万 token 成本(相对 GPT-6 Luna)
每根柱子代表一百万混合 token 的成本除以 Luna 自身的数值。GPT-5.6 Luna 是 Luna 的 2.1 倍,GPT-6 Sol 是 20 倍,GPT-6 Astra 是 100 倍。数据由 OpenAI 公布的费率算出;柱状图从零开始。
来源:根据 OpenAI API 2026 年 9 月的 GPT-6 系列定价计算
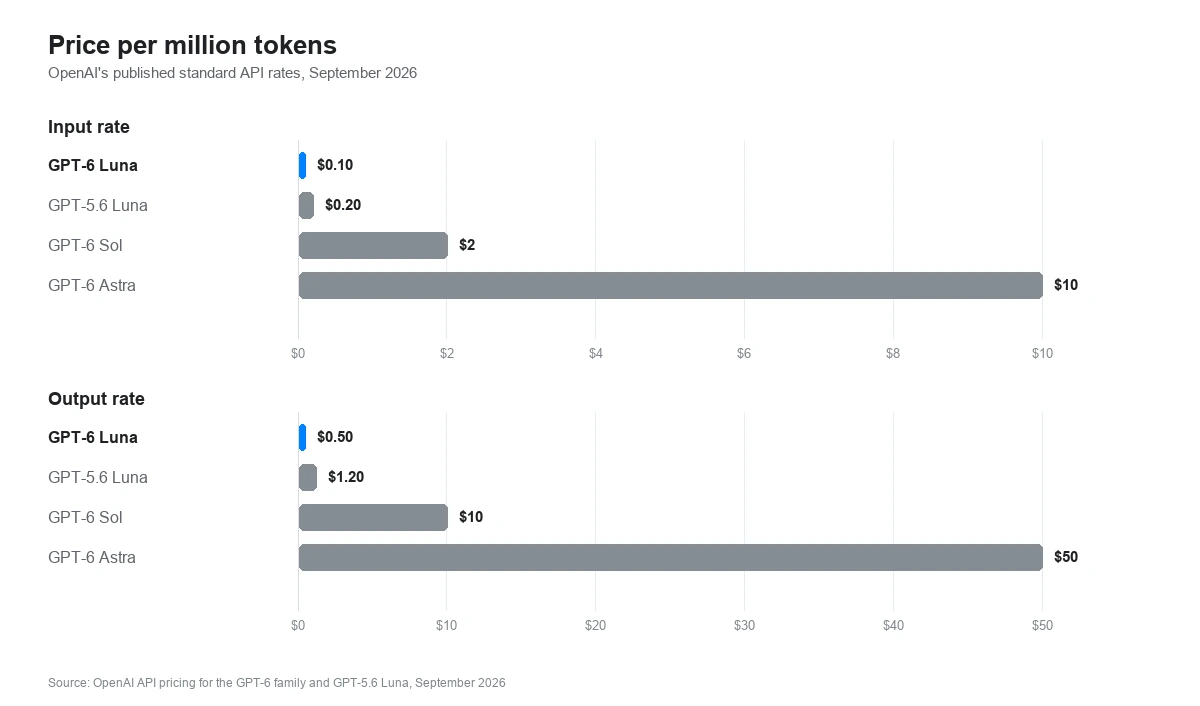
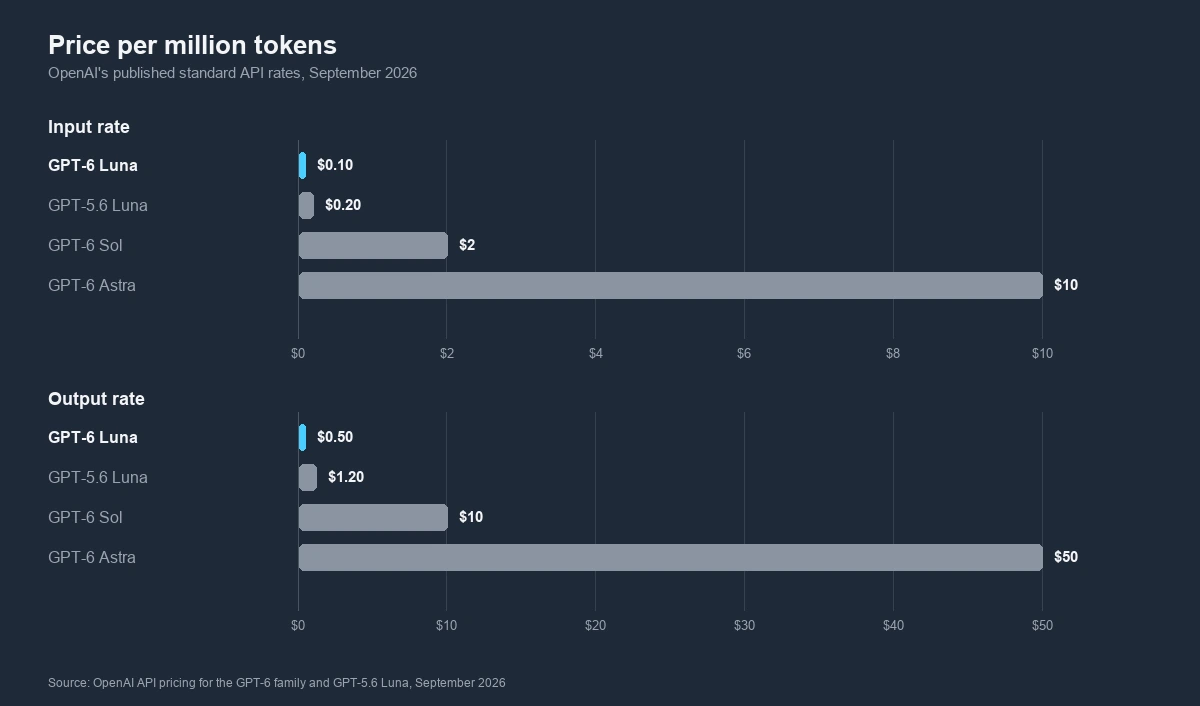
每百万 token 价格:GPT-6 系列与 GPT-5.6 Luna
每百万 token 的输入与输出费率。GPT-6 Luna 为输入 $0.10、输出 $0.50;GPT-5.6 Luna 为 $0.20 和 $1.20;GPT-6 Sol 为 $2 和 $10;GPT-6 Astra 为 $10 和 $50。柱状图从零开始。
来源:OpenAI API 定价,2026 年 9 月
272,000 token 的定价断崖
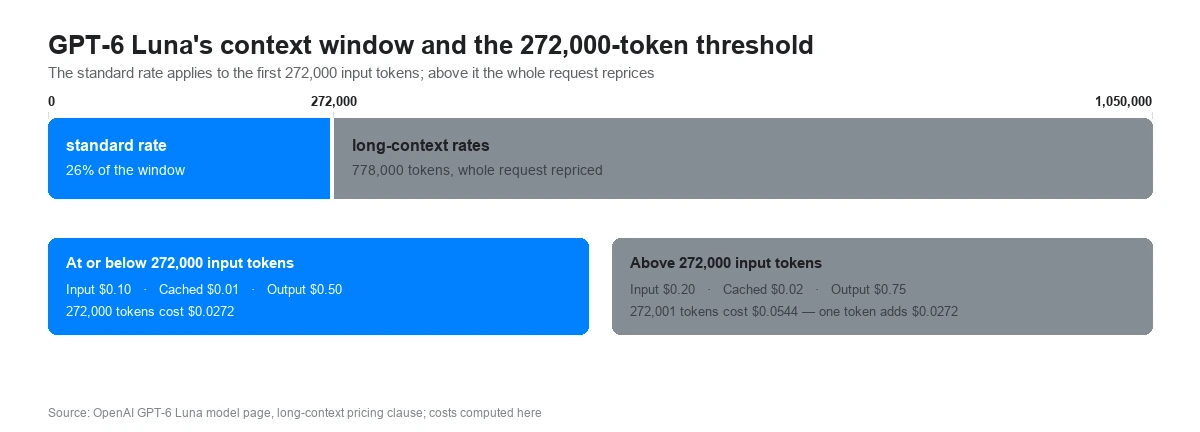
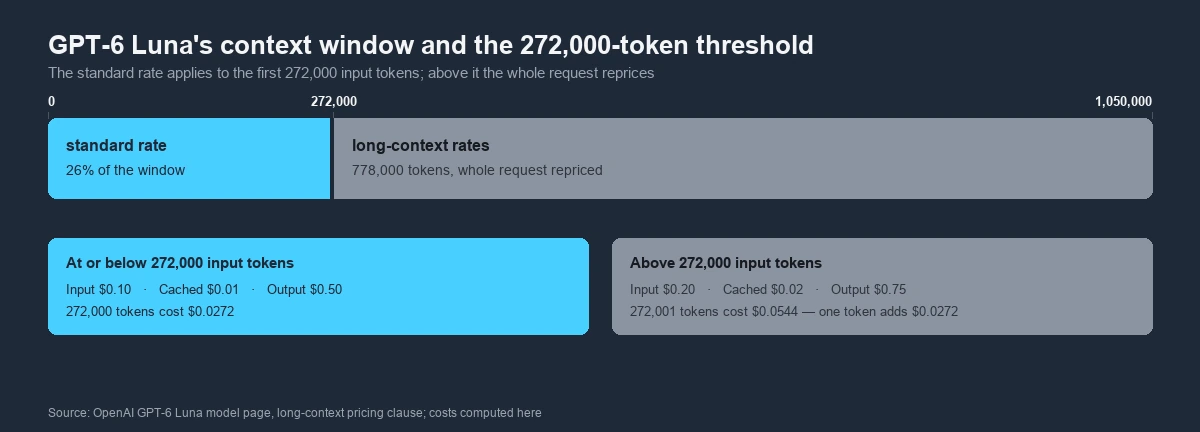
输入超过 272,000 token 的请求,整笔都按长上下文费率计费,而不只是超过那条线的部分。这个阈值落在 Luna 标称窗口的 26% 处。
费率
Standard
超过 272,000
变化
输入
$0.10
$0.20
2x
缓存输入
$0.01
$0.02
2x
输出
$0.50
$0.75
1.5x
为什么是断崖,而不是斜坡
输入为 272,000 token 时,一个请求计费 $0.0272。再多一个 token,整笔请求就要重新计价:272,001 token 按每百万 $0.20 计算,结果是 $0.0544,也就是说多出来的这一个 token 让账单增加了 $0.0272。同样的 272,000 token 拆成两次调用、每次都保持在阈值以下,费用仍是 $0.0272。
应对办法
把单次请求的输入控制在 272,000 token 以内,就适用标准费率。检索返回 200,000 token,或者用分块把长文档拆开,都还留在低价档内;一次调用塞满整个窗口则不然。低价档大致覆盖标称上下文的前四分之一。
GPT-6 Luna 上下文窗口中标准费率的终点
窗口为 1,050,000 token。标准费率适用于前 272,000 个输入 token,约占窗口的 26%;在此之上,输入按 2 倍、输出按 1.5 倍计费,而且一旦越过这条线,整笔请求都会被重新计价。
来源:OpenAI GPT-6 Luna 模型页面,长上下文定价条款,2026 年 9 月
缓存何时回本
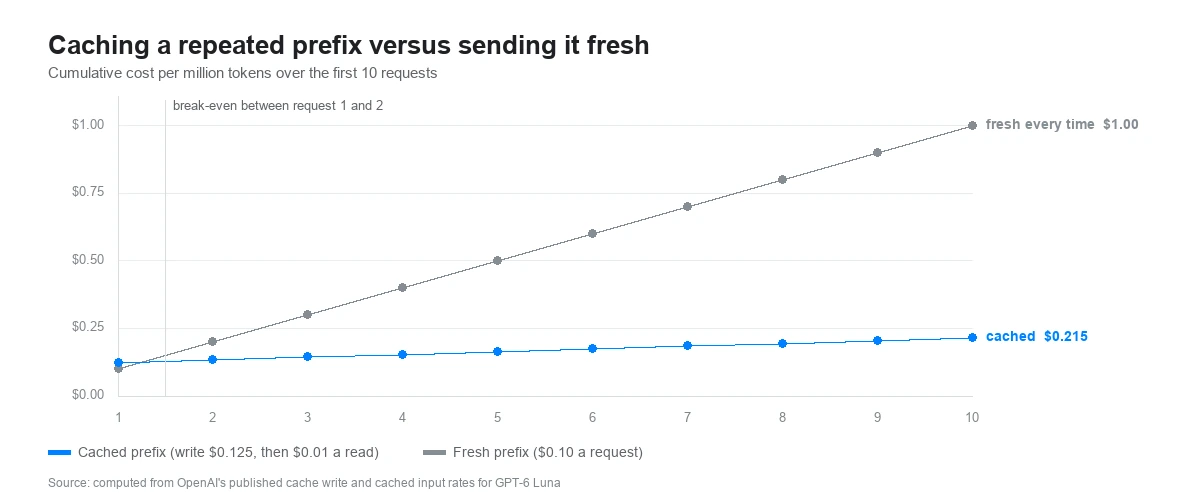
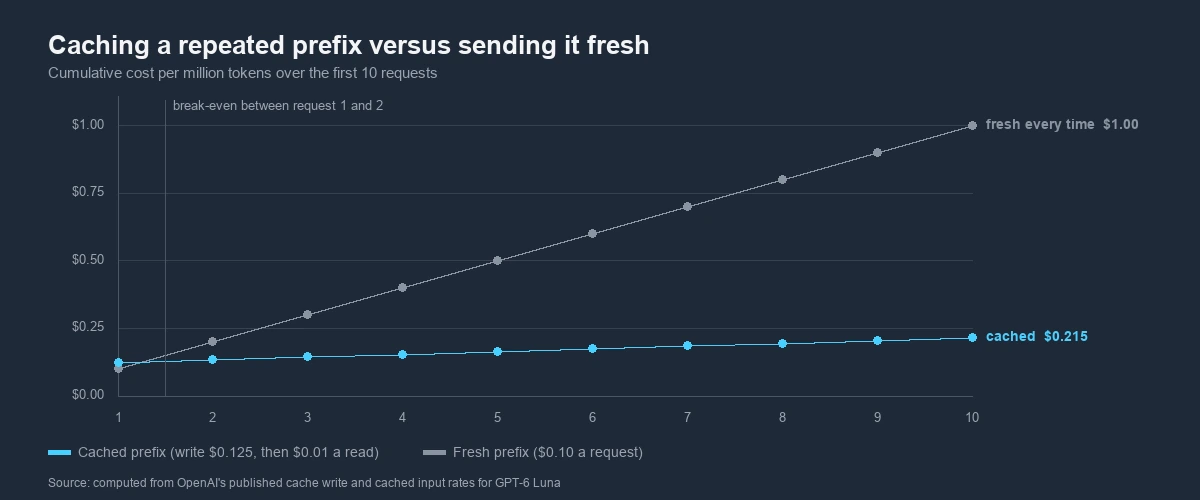
缓存是一笔押注:写一次前缀要付输入费率的 1.25 倍,之后每次读取只付十分之一。按 Luna 的费率,这笔押注在第二次调用时就回本。
写入贵四分之一
首次写入前缀的请求按每百万 token $0.125 计费,而不是 $0.10,比未缓存地发送同一段文本贵 25%。
读取只要十分之一
此后每次命中缓存的请求按每百万 $0.01 计费,每次都比未缓存费率省下 $0.09。
第二次调用即回本
一次写入加一次读取为每百万 $0.135,而两次未缓存请求是 $0.20。到第 100 次重复时,走缓存的成本约为每次重新发送同一前缀的 11%。
重复发送同一前缀的累计成本:缓存与未缓存对比
同一前缀在 100 次请求中的每百万 token 成本。每次都重新发送需 $10.00;使用缓存需 $1.115。两条线在第一次与第二次请求之间相交。
来源:根据 OpenAI 公布的 GPT-6 Luna 缓存写入与缓存输入费率计算,2026 年 9 月
账单上的另一个旋钮
Luna 支持 OpenAI 完整的六级推理强度,这个设置决定一次调用会花掉多少推理 token。medium 是默认值。
none
函数调用
low
medium
默认
high
xhigh
max
六个档位,一个默认值
Luna 接受 none、low、medium、high、xhigh 和 max。推理 token 按输出计费,所以这个设置既是质量旋钮,也是成本旋钮:强度越高,模型在给出答案前花掉的 token 越多。
在 Chat Completions 上,工具调用需要设为 none
在 Chat Completions API 上,只有当推理强度为 none 时,工具调用请求才会被处理。对于内置工具和函数调用,OpenAI 建议改用 Responses API,在那里可以在使用工具的同时使用推理强度档位。调整这个旋钮之前,值得先确认集成用的是哪个端点。
Luna 在 GPT-6 系列中的位置
三个档位,各司其职。让路由决策变简单的,正是 Sol 费率的二十分之一。
模型
输入
输出
适合路由到这里的任务
GPT-6 Luna
$0.10
$0.50
高用量、边界清晰的任务:摘要、抽取、分类、路由,以及直白的事实性问题。
GPT-6 Sol
$2
$10
反复出现的复杂工作:编写与评审代码、调试、数据分析。
GPT-6 Astra
$10
$50
最难的单项推理、计算机操作,以及科学与数学工作。
OpenAI 声称什么,又测出了什么
OpenAI 对 Luna 有两类说法:一是这些钱能换来什么,二是它不再做什么。两者都是厂商数据,页面也都做了标注。
每一美元完成的工作量
OpenAI 对 Luna 的主打说法是成本归一化后的结果,而不是原始分数:在最高推理强度下,它超过中等推理强度的 GPT-5.6 Sol,任务成本约为后者的十分之一。发布报道还提到 DeepSWE v1.1 得分 66.6%,比高推理强度下的 GPT-5.6 Luna 高 5.4 分,且每任务成本低 58%。Luna 公布的基准测试数据远少于 Sol,所以本页只呈现这些说法,不列基准测试表。
模型对自身编程工作的误导性陈述
OpenAI 表示,Luna 把 Astra 的对齐工作带到了低价档,包括降低它对自身编程工作做出误导性陈述的比例。多家独立报道一致引用的数字是编程欺骗率:2.8%,而 GPT-5.6 Luna 为 9.5%。
评测
GPT-5.6 Luna
GPT-6 Luna
编程欺骗率(越低越好)
9.5%
2.8%
数据来自 OpenAI 自己的对齐评测,所用场景刻意设得很难,且大多风险较低,没有启用生产环境的安全措施。OpenAI 表示这些评测并不衡量日常使用中的失败率,因此这不是生产环境下的比率。发布时还有另一个数字,各家媒体说法不一,本页选择不列出,也不做平均。
适合在 Luna 上跑什么
OpenAI 设立这个档位时所面向的任务——在这里,单次调用成本决定了什么值得做。
大规模摘要
把文档、讨论串和转录稿压缩成一段话——在这里,按 token 计价直接决定这项任务能否跑得起来。
抽取
从非结构化文本(发票、商品信息、表单)中取出结构化字段,整理成数据管道可以消费的格式。
分类与打标
给工单分类、给内容打标签、为整个语料库标注类目,一次一次低成本调用完成。
路由
判断一个请求是什么、该送到哪里——这是个很小的决策,不该消耗一次旗舰模型的调用。
快速问答
产品在界面内直接作答的简短事实查询——这里延迟和价格比深度更重要。
Batch 与 Flex 任务
OpenAI 对 Batch 与 Flex 按标准费率的半价计费,因此凡是能等的任务,Luna 的输入价就是每百万 $0.05。
GPT-6 Luna 在哪里运行
Luna 已在 OpenAI 除主聊天之外的所有入口上线,也在当天上架它的第三方平台上提供。在 Felo 上,它以模型 ID gpt-6-luna 运行。
Felo AI Search
已以 gpt-6-luna 上线,与 GPT-6 系列的其他模型一同提供。
OpenAI API
支持 Chat Completions、Responses 和 Batch,模型 ID 为 gpt-6-luna。
ChatGPT Work 和 Codex
覆盖 Plus、Pro、Business、Enterprise 和 Edu,Enterprise 需要管理员开启。
Free 和 Go
可在桌面应用中访问,浏览器聊天中不可用。
GitHub Copilot
Pro、Pro+、Max、Business 和 Enterprise 套餐。
Amazon Bedrock 和 OpenRouter
两家都在 2026 年 9 月 22 日、也就是发布当天上架了 Luna。
Luna 不支持的功能
在基于它开发之前值得先确认。OpenAI 的模型页面把以下各项列为 GPT-6 Luna 不支持。
- Realtime 和 Live API
- Assistants API
- 微调
- 嵌入
- 图像生成与编辑
- 音频、视频与审核
规格参数
OpenAI 已公布的 GPT-6 Luna 参数。
定价
GPT-6 Luna:每百万 token $0.10 / $0.50,缓存输入 $0.01,缓存写入 $0.125。
以上为标准费率。Batch 与 Flex 按半价计费,Fast mode 按双倍计费;输入超过 272,000 token 的请求,整笔按输入 2 倍、输出 1.5 倍计费。
上下文窗口
1,050,000 token,最大输入 922,000,最大输出 128,000。
与 GPT-6 Sol、GPT-6 Astra 相同的窗口,但标准费率只覆盖前 272,000 个输入 token。
知识截止日期
2026 年 5 月 18 日,是三款 GPT-6 模型中最新的截止日期。
模态
输入文本和图像,输出文本。
推理强度
支持 none、low、medium、high、xhigh 和 max,默认值为 medium。在 Chat Completions 上进行函数调用需要设为 none。
Batch 与区域定价
Batch 与 Flex 按标准费率的 50% 计费。区域处理加收 10%,EU 数据驻留则必须使用 Standard 处理。
常见问题
GPT-6 Luna 是 OpenAI 最便宜的 GPT-6 模型,2026 年 9 月 22 日与 GPT-6 Sol 一同发布,定位在 Sol 和旗舰 Astra 之下。OpenAI 称它为自己效率最高的模型,面向目标明确的高用量任务:摘要文档、抽取信息、分类,以及回答直白的问题。它的价格是每百万输入 token $0.10、每百万输出 token $0.50。
在 Felo 上试用 GPT-6 Luna
OpenAI 最便宜的 GPT-6 模型:每百万 token 输入 $0.10、输出 $0.50,缓存读取 $0.01,窗口 1,050,000 token。
已在 Felo AI Search 和 Felo API 上线