01
文脈をまるごと保持する
100 万トークンのコンテキストウィンドウと 2026 年 6 月の知識カットオフ。長いスレッド、リポジトリ全体、資料一式をひとつのタスクに収められます。
Anthropic は 2026 年 9 月 22 日に Opus 5.5 を公開
Anthropic の Claude 5.5 ファミリー最初のモデルです。多くの作業で Claude Fable 5.1 と同等の性能を持ち、実行コストは Opus 5 より 40% 低く、出力速度は 30% 以上向上しています。
Felo 検索で利用可能
Claude Opus 5.5 が Felo 検索で使えるようになりました。長い入力を扱う作業に向いています。ファイルをまたいだ数値の突き合わせ、主張の出典までの追跡、そのまま他の人に渡せる回答の作成などです。
01
100 万トークンのコンテキストウィンドウと 2026 年 6 月の知識カットオフ。長いスレッド、リポジトリ全体、資料一式をひとつのタスクに収められます。
02
Anthropic の社内テストでは、18 件のレポートのうち 16 件が品質基準を通過しました。捏造した数値や引用がひとつでもあれば失敗するタスクです。
03
Anthropic はモデルの伝え方を作り直しました。重要な情報が先頭に来て、完了したこと、判明したこと、未解決のことがそのまま書かれます。
クイックガイド
Claude Opus 5.5 は、アカウントの他の主要モデルと並んでモデル選択に表示されます。
Opus 5.5 の違い
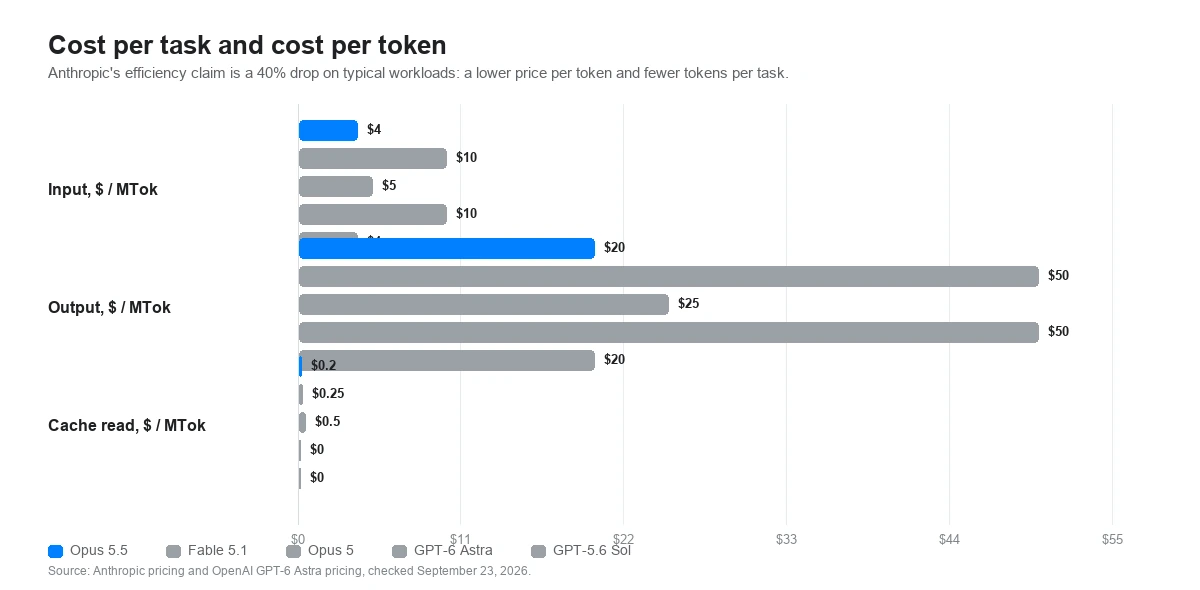
Anthropic が打ち出しているのは、ベンチマークの点数を上げることではなく効率です。タスクあたりのトークン数が減り、トークン単価も下がり、典型的なワークロードでコストが 40% 下がります。長時間動かし続けるエージェント作業を現実的な費用で回せるのは、この点によります。
01
Anthropic によると、初期テスターは 20 万行のコードベースを 3 時間足らずで監査・修正しました。Opus 5 では 20 時間以上かかり、トークン消費も 2.5 倍でした。
02
Deloitte の報告では、最低の effort 設定でもコードレビューで既知のバグの 72% を検出しました。Opus 5 の high 設定では 56% で、誤検知もより多く出ていました。
03
文章は短く、構成も明快です。Box の報告では、精度を落とさずに冗長さが 40% 減り、トークン消費は Opus 5 の 3 分の 1 でした。
モデル選定
以下の価格は 100 万トークンあたりの公式な公開 API 料金で、Felo のサブスクリプションや利用料金ではありません。effort の行は価格の行と同じくらい重要です。同じプロンプトでも、各モデルの出発点が違えば費用は大きく変わります。
上記の公開 API 料金と既定値は、2026 年 9 月 23 日時点で Anthropic の Claude Opus 5.5 発表、Claude Platform のモデルページ、OpenAI の GPT-6 Astra ページと照合しました。トークン単価はタスク総コストの一部にすぎません。Anthropic 自身の効率の主張は典型的なワークロードで 40% のコスト削減で、これはトークン単価の低下とタスクあたりのトークン数削減の両方を含みます。
Anthropic の公開結果
Anthropic は自社の数値を Fable 5.1、Opus 5、GPT-6 Astra、GPT-5.6 Sol と並べて公開しました。以下の 4 つのグラフのうち 2 つは、精度そのものではなく精度とタスクあたりコストの関係を示しています。Anthropic が行っている比較がまさにそれだからです。
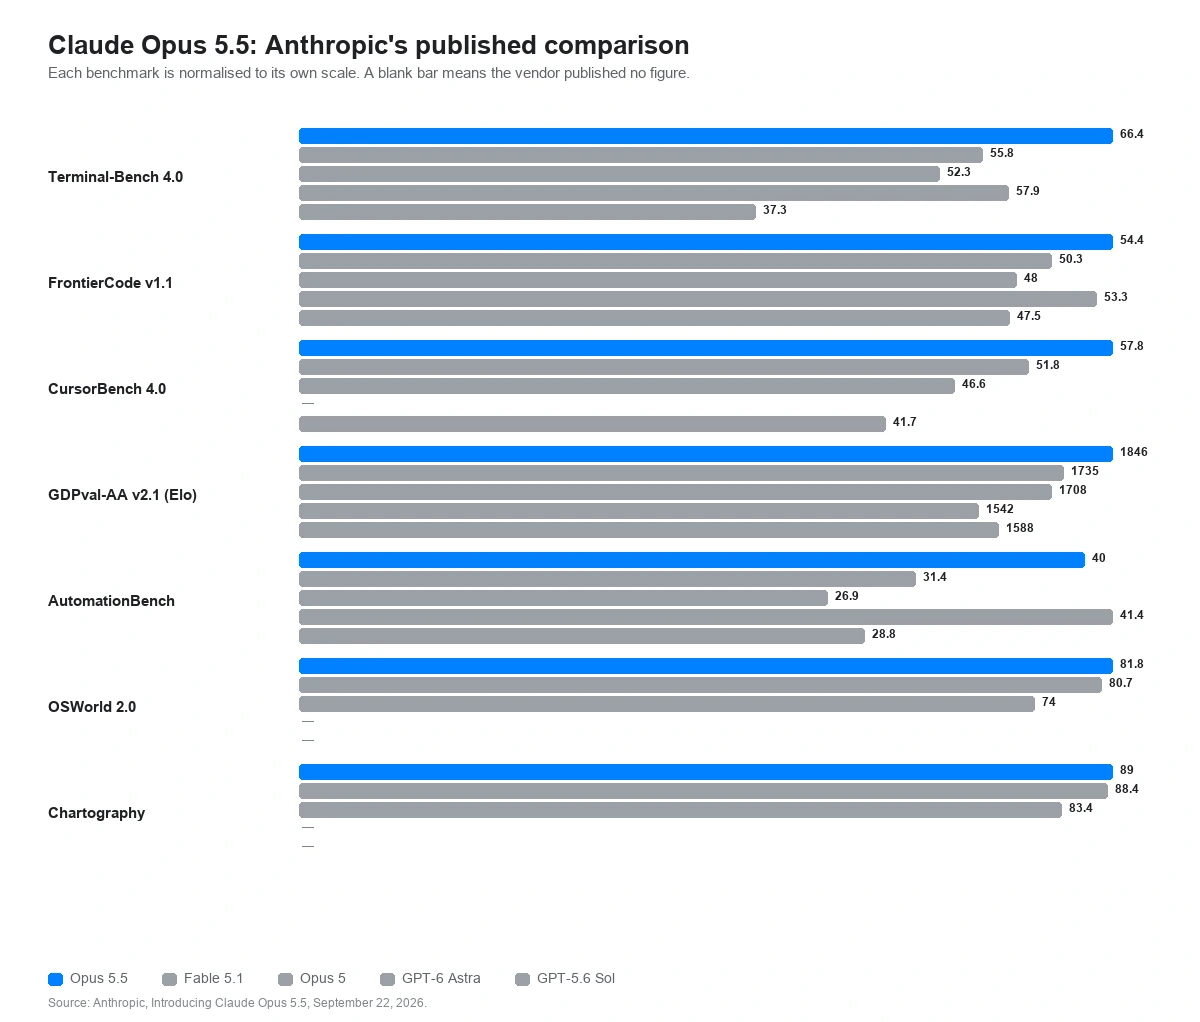
公開された比較の全体
エージェント型コーディング、ナレッジワーク、業務ワークフロー、学際的推論、科学研究、コンピュータ操作、図表認識を、Anthropic が測定した 5 モデルすべてについて示しています。
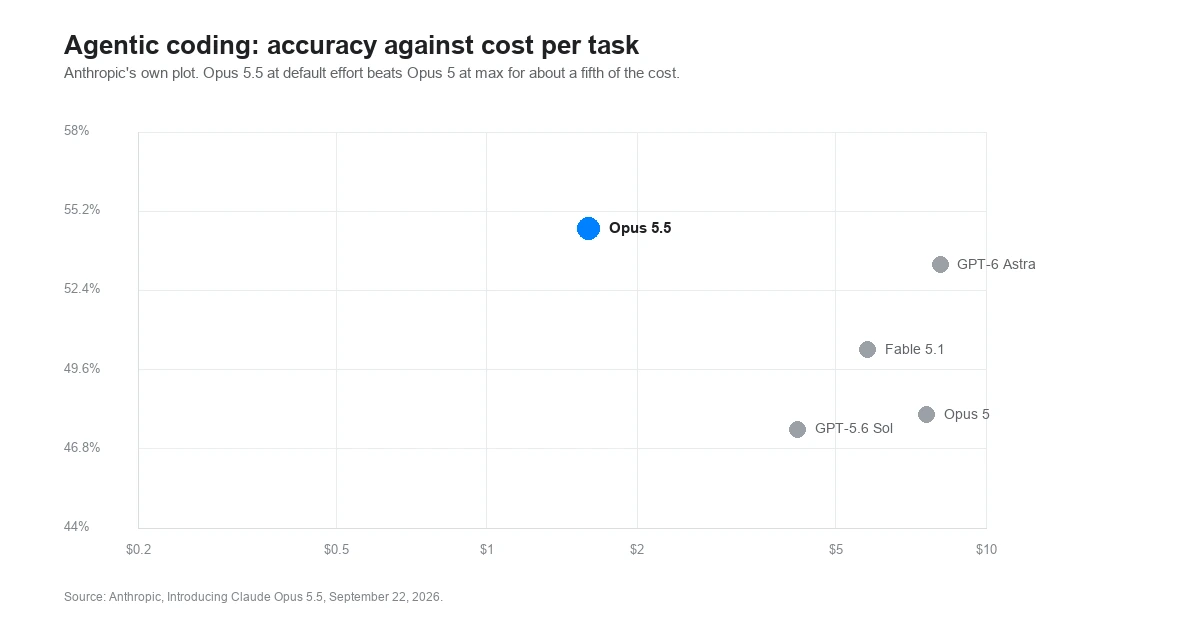
エージェント型コーディング
Terminal-Bench 4.0、FrontierCode v1.1、CursorBench 4.0 を、タスクあたりコストに対する精度として示しています。
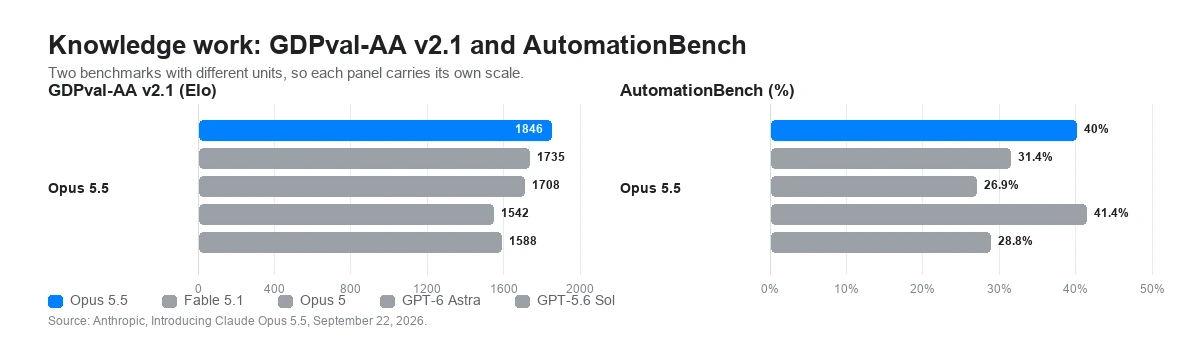
ナレッジワーク
44 職種を対象とする GDPval-AA v2.1、AutomationBench、Perplexity のデータ収集ベンチマーク WANDR。
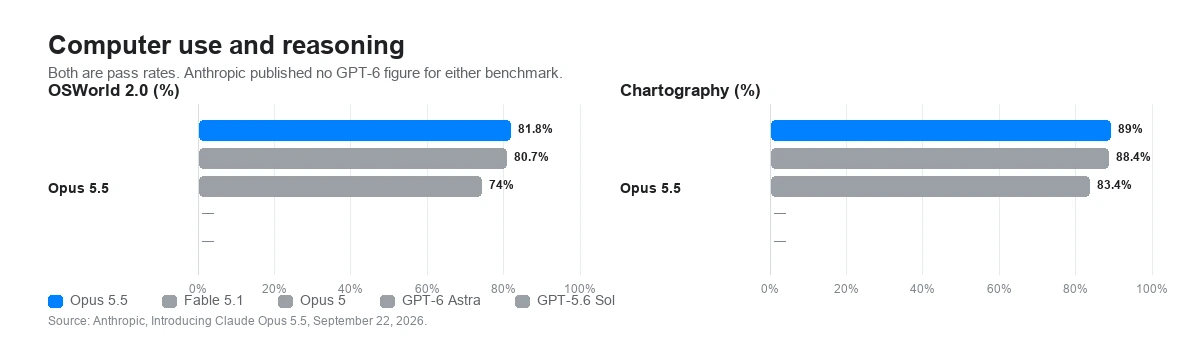
コンピュータ操作と推論
OSWorld 2.0、Humanity's Last Exam、Chartography。最後のものはグラフから数値を読み取る精度を測ります。
精度とタスクあたりコスト
Anthropic の主張の中心は、どんな費用を払っても高い点数を取ることではなく、費用を桁違いに下げても同等以上の点数を取ることです。
ベンダー公開の数値です。特に断りのない限り、Anthropic は max effort で適応型思考を有効にして Opus 5.5 を実行し、本番用のセーフガードを有効にして評価しています。セーフガードが介入した場合、サイバーセキュリティのタスクは Opus 4.8 が、生物学のタスクは Opus 5 が完了しており、これらのベンチマークで公開された Opus 5.5 の数値は低く出ている可能性があります。GPT-6 Astra と GPT-5.6 Sol の数値は OpenAI の公表値です。ベンダーをまたいだスコア差は実世界の差の弱い手がかりにすぎない、というのが Anthropic 自身の説明です。
すでに Opus 5 を動かしている場合
Anthropic は、すでに Claude Opus 5 で動いている統合向けの破壊的変更を 4 つ挙げています。加えて、リクエストは失敗させないままレスポンスの形を変える変更が 1 つあります。モデル ID を差し替える前に読む価値があります。4 つのうち 3 つは静かに劣化するのではなく、400 エラーを返すからです。
01
Opus 5 では high 以下で思考を無効化できました。Opus 5.5 では常時有効で、無効化の指定も手動のトークン予算も 400 エラーを返します。制御できるのは effort だけで、既定値も high から medium に変わりました。
thinking: {"type": "disabled"} -> 400 invalid_request_error
02
tool_choice を "any" にするか、ツール名を指定すると 400 エラーを返します。トークン計数エンドポイントも同様です。auto と strict なツール使用または構造化出力を組み合わせ、ツールを使うべき場面はプロンプトで伝えてください。
tool_choice: {"type": "tool", "name": "..."} -> 400 invalid_request_error
03
各思考ブロックは、それを生成したモデルを記録します。Opus 5.5 は Opus 5 およびそれ以前の Opus、Sonnet、Haiku のブロックは読めますが、Fable と Mythos のものは読めません。ルーターが会話を他のモデルへ移すと、以降のターンは以前の推論なしで実行されます。
Opus 5.5 -> Fable 5.1 / Mythos 5.1 は思考を保持、他のモデルは破棄
04
Claude API と Google Cloud では computer_20251124 ツールが 400 エラーを返します。代わりに computer_toolset_20260801 ツールセットを宣言し、ベータヘッダーを外し、エージェントループをメンバーの tool_use ブロックに対応させてください。Amazon Bedrock では旧ツールも引き続き動作します。
computer_20251124 -> computer_toolset_20260801
思考を無効化できない以上、調整するのは effort です。Opus 5.5 は 5 段階すべてに対応し、既定は medium で Opus 5 より一段低くなっています。Anthropic の指針は、以前の設定を持ち越さず自社の評価で改めてスイープすること、そして高めの設定では max_tokens を大きく取ることです。思考テキストが返らない場合でも思考トークンは上限に計上されるためです。
effort は厳密なトークン予算ではなく行動のシグナルです。低い設定でも、本当に難しい問題では思考します。ただし高い設定よりは少なくなります。Anthropic はまた、同じ設定でも Opus 5.5 は Opus 5 より 1 ターンあたりの思考量が多く、xhigh と max で特に顕著だと述べています。Opus 5 の設定を持ち越すと、ターンが長く高くつきます。
向いている作業
数時間かかる、扱うファイルが一人では把握しきれない、あるいは成果物を別の人が確認する必要がある。そんなときに Opus 5.5 は力を発揮します。以下は Anthropic と初期テスターが挙げた具体的な作業で、一般的なチャットのプロンプトではありません。
最初に見つかった動きそうなパッチで止めず、テストが通るまで変更を大きなリポジトリ全体に通します。Anthropic によれば、あるテスターは 68 万行の移行を 1 日足らずで終えました。
Anthropic のテスターである Column は、数コミット前に誤ってモデル化されていたサードパーティ連携について、外部ドキュメントを確認してバグを発見したと報告しています。
モデルを組み、次に 1 枚の要約を書き、前提と留保を保ったまま仕上げます。Anthropic によれば、ある買収分析は 63 分で完了し、Opus 5 の 93 分に対してコストは半分でした。
サブエージェントに委任し、時間予算に合わせて進め方を調整します。Anthropic は、マルチエージェント構成に経過時間のシグナルを与えると、直列化せず並列化すると説明しています。
01
リポジトリ、文書、要件など、役に立つ回答が考慮すべきものを入れます。100 万トークンのウィンドウはそのためにあります。
02
何が満たされれば完了と言えるかを明示します。Anthropic の無人実行向けの指針は、タスクの各項目をチェックリストにしてモデルに更新させることです。
03
同じタスクを Felo で Opus 5.5、Opus 5、Fable 5.1 に実行させます。答えだけでなく、テスト、留保、トークン数まで比べてください。
アカウントのモデル選択に Claude Opus 5.5 が表示されたら選択してください。
Felo で Opus 5.5 を試すClaude Opus 5.5 は、長時間動くエージェント型コーディングとナレッジワーク向けの Anthropic のモデルで、2026 年 9 月 22 日に Claude 5.5 ファミリーの最初のモデルとして公開されました。Anthropic によれば、多くの作業で Claude Fable 5.1 と同等の性能を持ちながら、実行コストは Claude Opus 5 より 40% 低くなっています。
Felo で Claude Opus 5.5 を他の主要モデルと並べ、何時間もかかるからと後回しにしてきた仕事で試してみてください。
Felo で Opus 5.5 を試すFelo AI 検索から始め、利用可能な場合はモデルを選択してください。