2026 年 9 月 30 日発表 · 段階的に提供開始

Gemini 4 Argon長い調査を、一気に書き切る

Google が Gemini 3 以来となるフロンティアモデルです。長時間・多段階の作業をまたぐ深い推論のために作られました。出力上限は 64K トークンから 1M に上がり、Google が公表した数字では、コーディングよりもナレッジワークで先行しています。

Felo API は現在クローズドベータ中で、Gemini 4 Argon への対応は近日公開予定です。
Gemini 4 Argon のキービジュアル。青いグラデーションを背景に、モデル名と大きな数字の 4 が並んでいる
Google の発表用アートワーク。Argon は Gemini 4.0 系の更新ではなく、新しい命名体系のもとで登場します。名前にバージョン番号が付いていないのはそのためです。
1M
最大出力トークン
64K からの引き上げです。1 回の生成で報告書を最後まで書き切れます。
$2 / $10
API の導入価格
入力・出力それぞれ 100 万トークンあたり。キャッシュ入力は 95% 割引です。
77.9%
DeepSWE v1.1
Google の公表値で、Claude Opus 5.5 と GPT-6 Astra を上回ります。
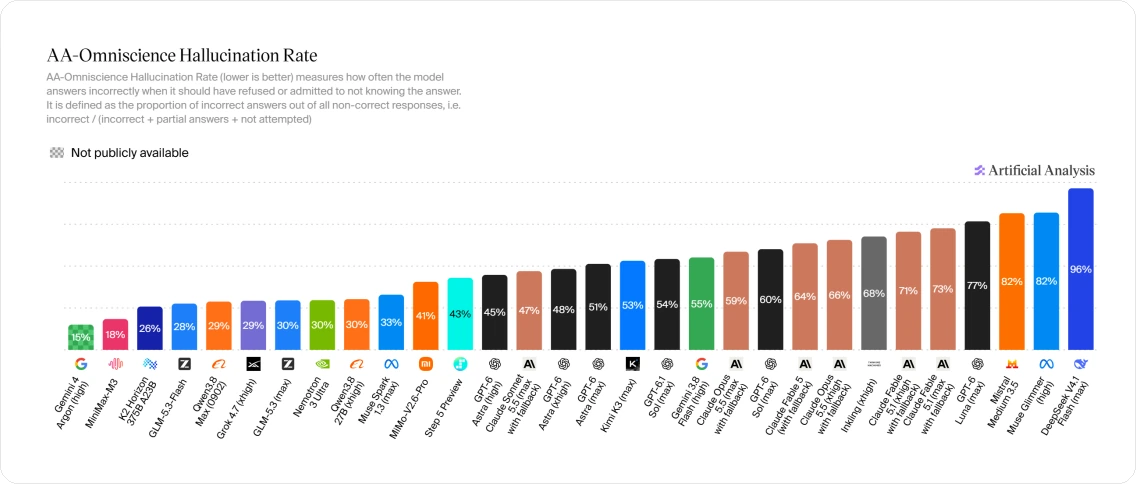
15%
ハルシネーション率
Artificial Analysis が計測したフロンティアモデル中の最低値です。

本ページの図版とグラフは、それぞれを公表した Google、Arena.ai、Artificial Analysis によるもので、改変せずに掲載しています。

提供状況

Argon はまだ一般提供されていません。提供はこの順で始まります。

Google は Argon を段階的に公開しており、最初の段階は一般向けではありません。Felo 内での利用も、この動きに合わせて準備を進めています。

提供中

信頼されたサイバー防御担当者

Google の Fairwind プログラムで選ばれたパートナーが最初に Argon を受け取ります。サイバーガードレールなしで提供されます。

次に公表

有料 API のお客様と Google AI Ultra

Google によれば、より広い提供はここから始まります。日付は示されておらず、現時点では購読だけでは利用できません。

時期未定

開発者、企業、一般利用者

有料プランの後に続きます。Google は一般提供の時期を明言していません。

Felo 検索内での Argon の提供は準備中です。開放され次第、本ページを更新します。

得意なこと

速く答えるためではなく、長い仕事を終えるために作られたモデル

Argon の公表された強みは、読む・考える・長く書くという領域に集まっています。コーディングを優先するフロンティアモデルとは、性格が異なります。

長いタスクでも崩れない推論

Google は Argon を、数時間におよぶ多段階の作業向けと位置づけています。従来のモデルはこうした作業で脱線したり、途中で止まったりしていました。

1M トークンを 1 回で出力

Google が増加の理由として挙げるのは、考える余地のあるモデルは、何度も往復せずに 1 回の流れで難問を解けるという点です。

コーディングではなくナレッジワークで先行

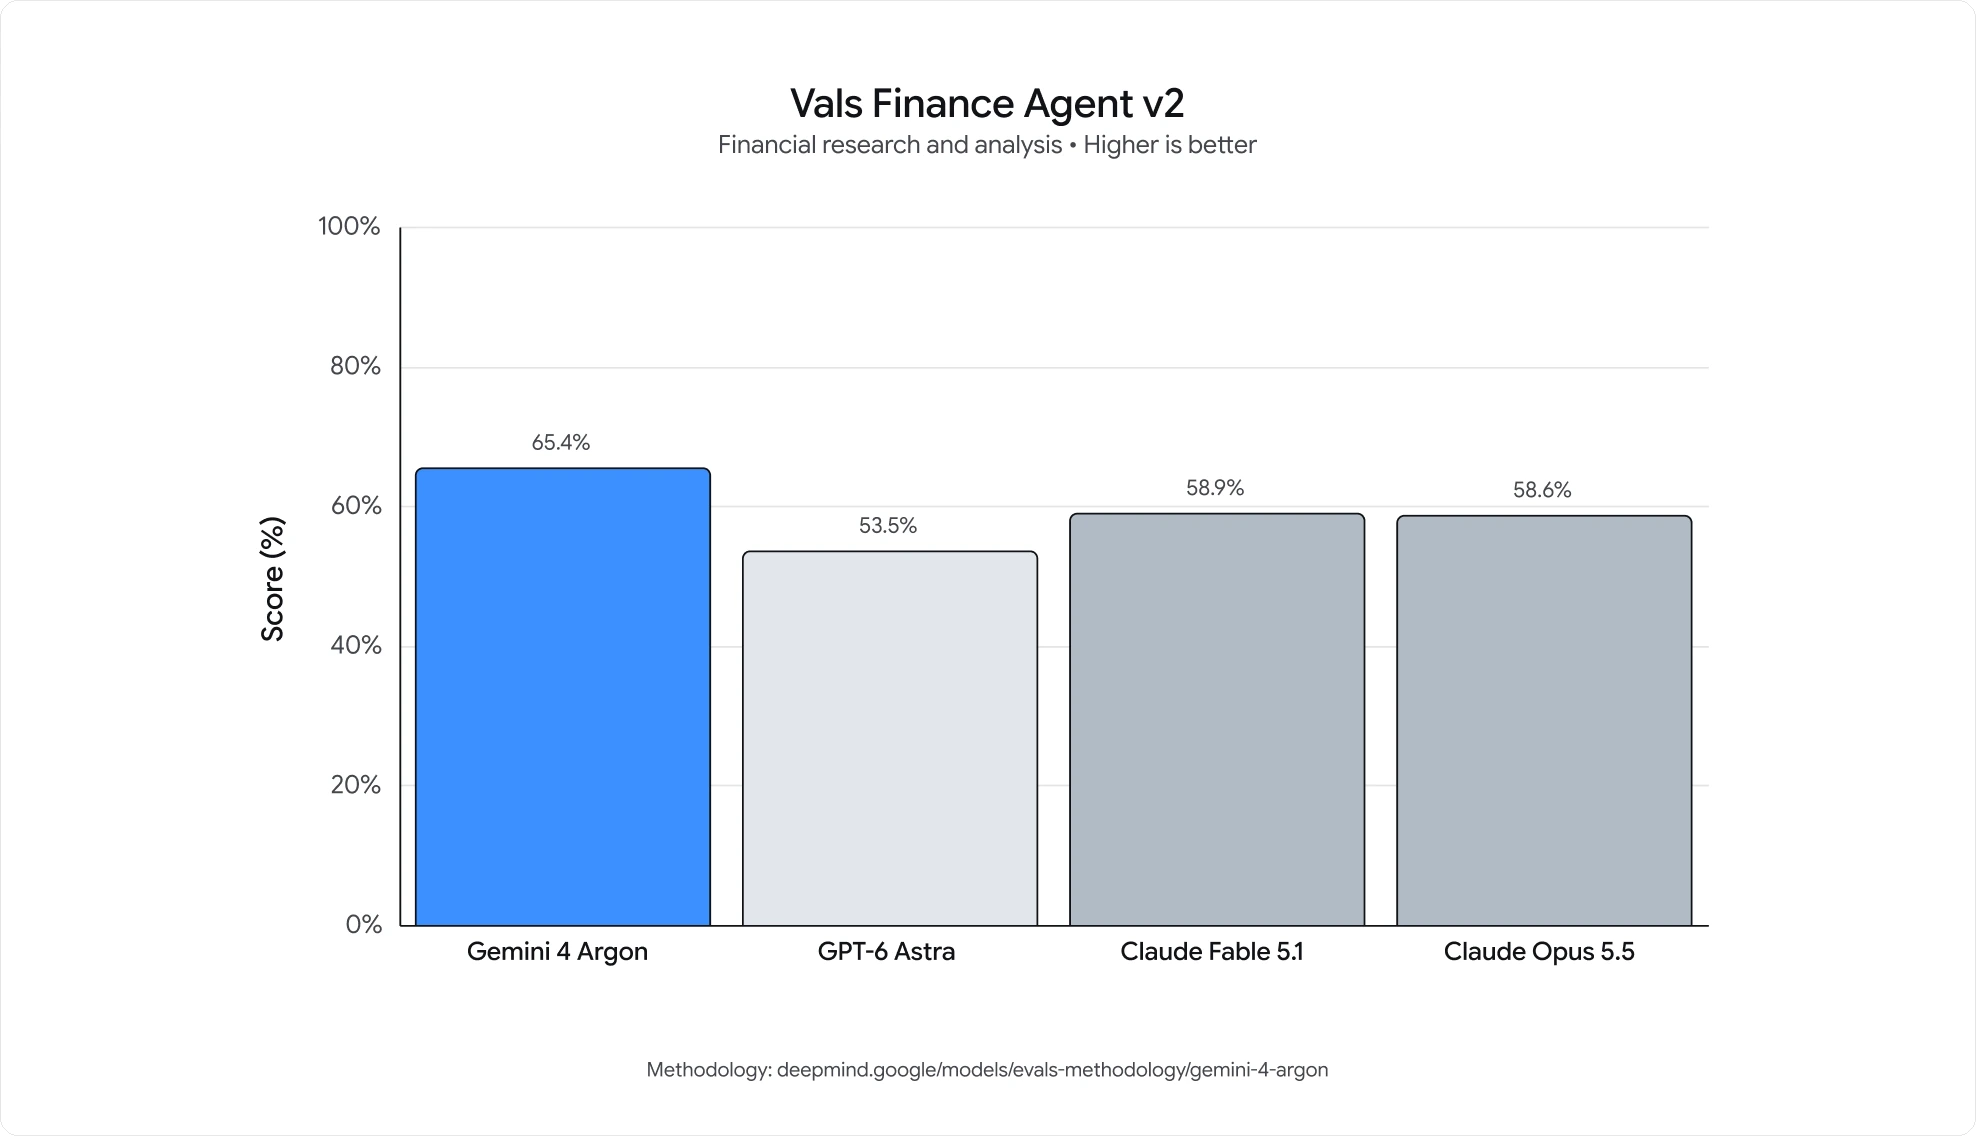
差が最も大きいのは Harvey's Legal Agent Benchmark と Vals Finance Agent v2 です。合成タスクではなく、実際の法務・財務分析が対象です。

耐える長文脈の検索

256K から 1M のコンテキストを実際に使いこなせるかを測る GraphWalks で、Google は他のフラッグシップに 10 ポイント以上の差をつけたと報告しています。

長い動画の理解

長い動画の理解度を測る LVBench は 91.7%。Google が Argon について示した中で最も高いスコアです。
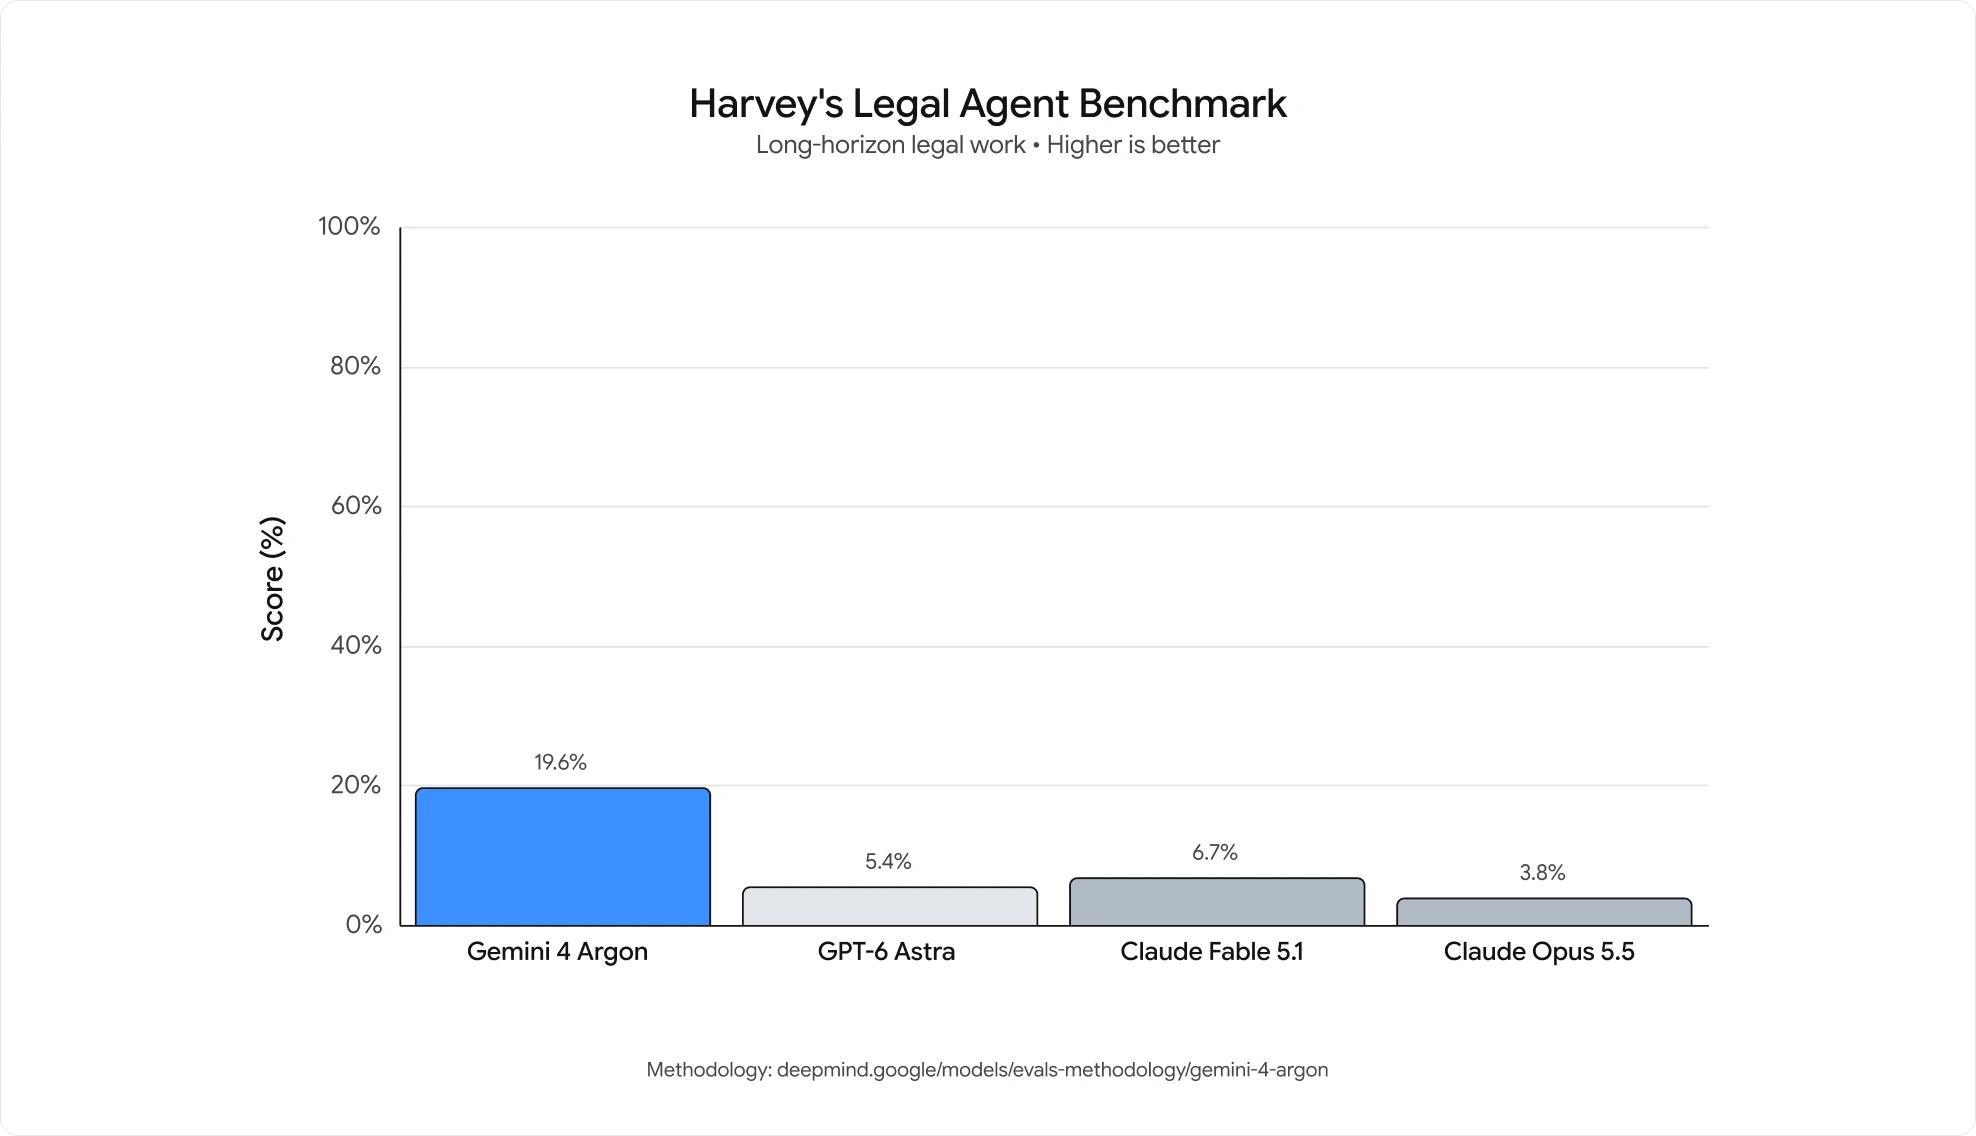
Harvey's Legal Agent Benchmark の棒グラフ。Gemini 4 Argon が 19.6%、Claude Fable 5.1 が 6.7%、GPT-6 Astra が 5.4%、Claude Opus 5.5 が 3.8%
長時間にわたる法務業務。Argon の 19.6% は 2 番手のモデルの約 3 倍で、Google が公表した中で最も大きな差です。
Vals Finance Agent v2 の棒グラフ。Gemini 4 Argon が 65.4%、Claude Fable 5.1 が 58.9%、Claude Opus 5.5 が 58.6%、GPT-6 Astra が 53.5%
財務の調査と分析で、65.4% 対 53.5〜58.9% の集団。法務業務ほどの差はありませんが、順位は同じです。

公表された数値

Google 自身のベンチマークで Argon はどこにいるか

いずれもベンダー公表の結果です。Google は主要スコアの思考設定や effort 設定を明らかにしておらず、独立した検証もまだありません。

ベンチマーク
測定内容
Argon
最も近い比較
DeepSWE v1.1
長時間におよぶソフトウェアエンジニアリング
77.9%
Opus 5.5 が 74.2%、GPT-6 Astra が 74.1%
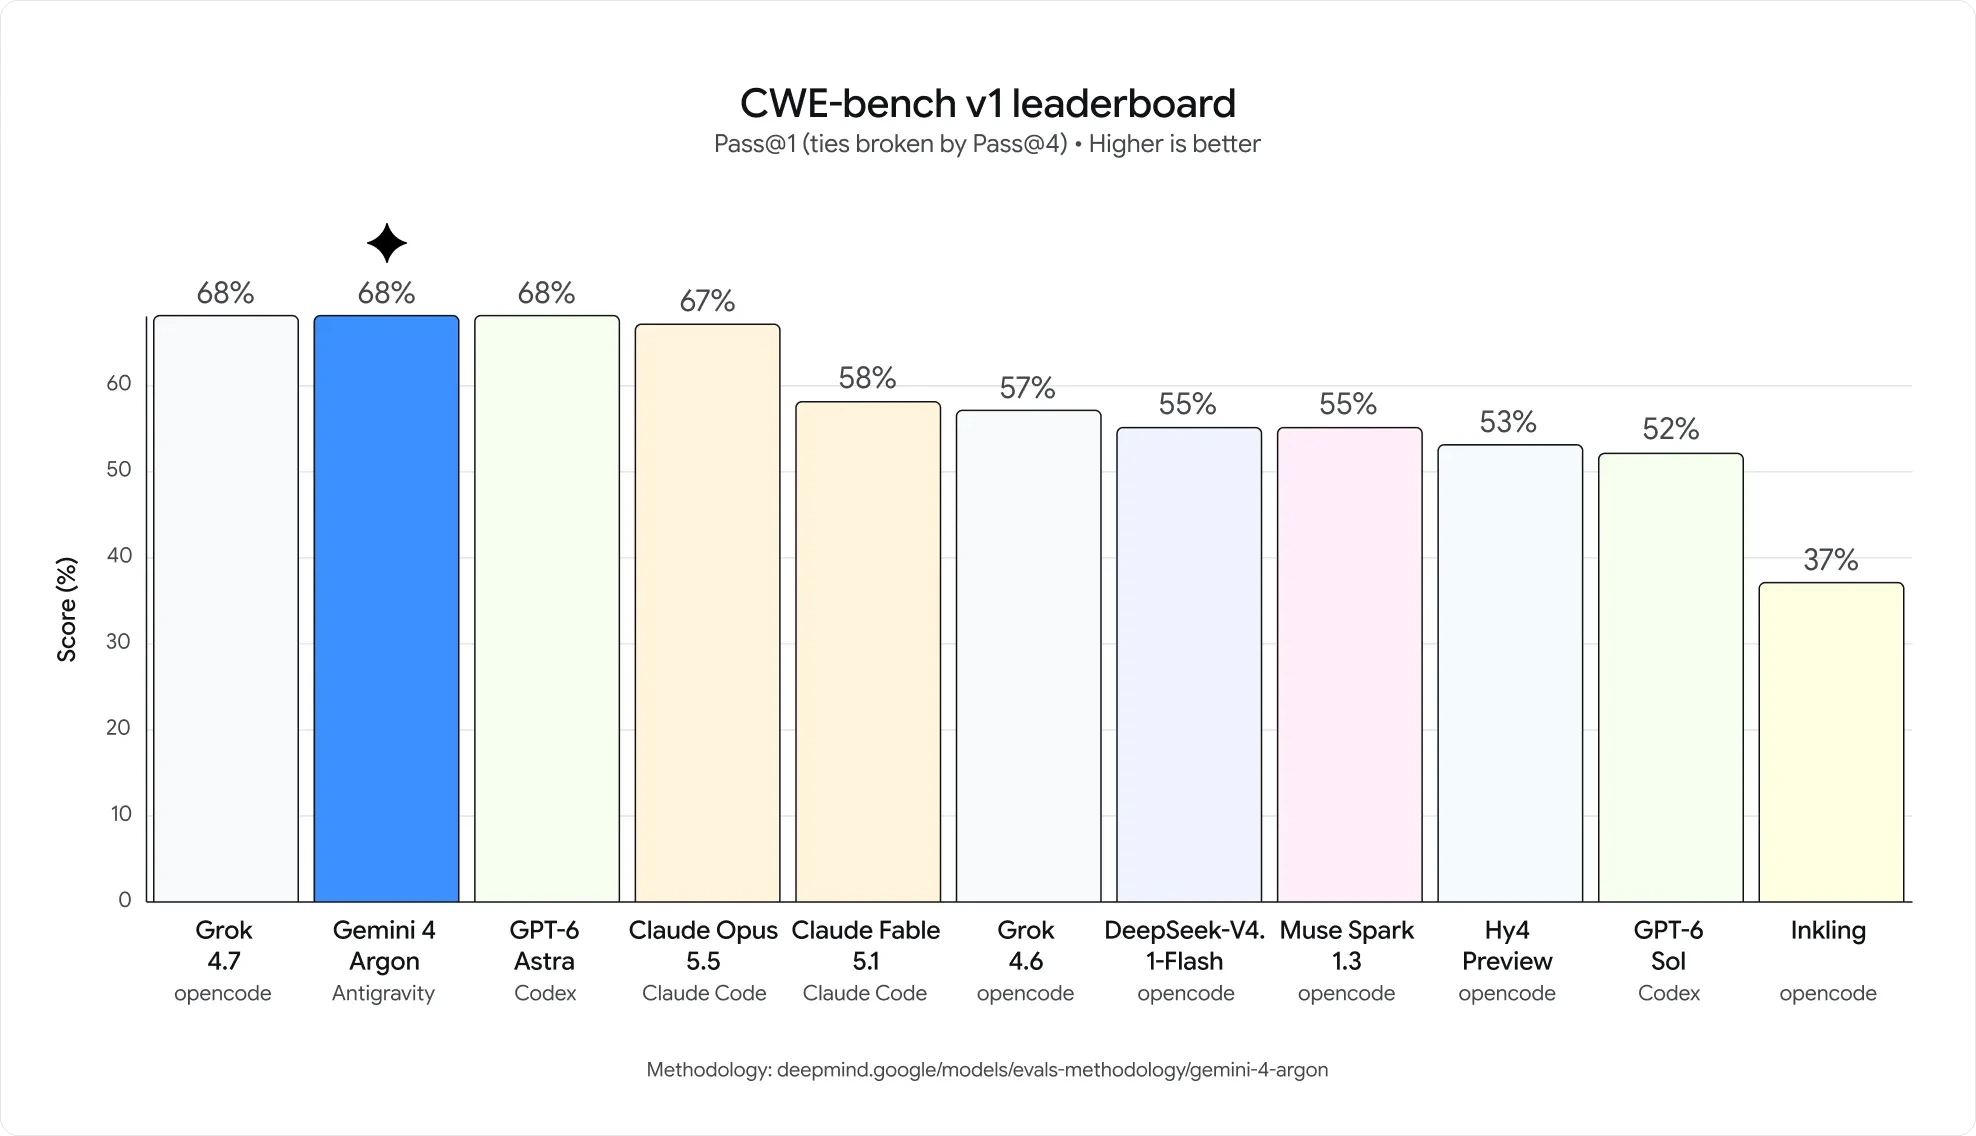
CWE-bench v1
脆弱性の発見と修正
68%
同率 1 位
AutomationBench
Zapier によるエンドツーエンドの業務タスク
51.3%
1 位
LVBench
長い動画の理解
91.7%
Google が Argon について示した最高スコア

方向性を示す数字として扱ってください。ベンダーのベンチマークが本番のワークロードでそのまま通用することはほとんどなく、ベンチマークの優位が実務に移るかを Google 社内でも疑う声があると Bloomberg は報じています。
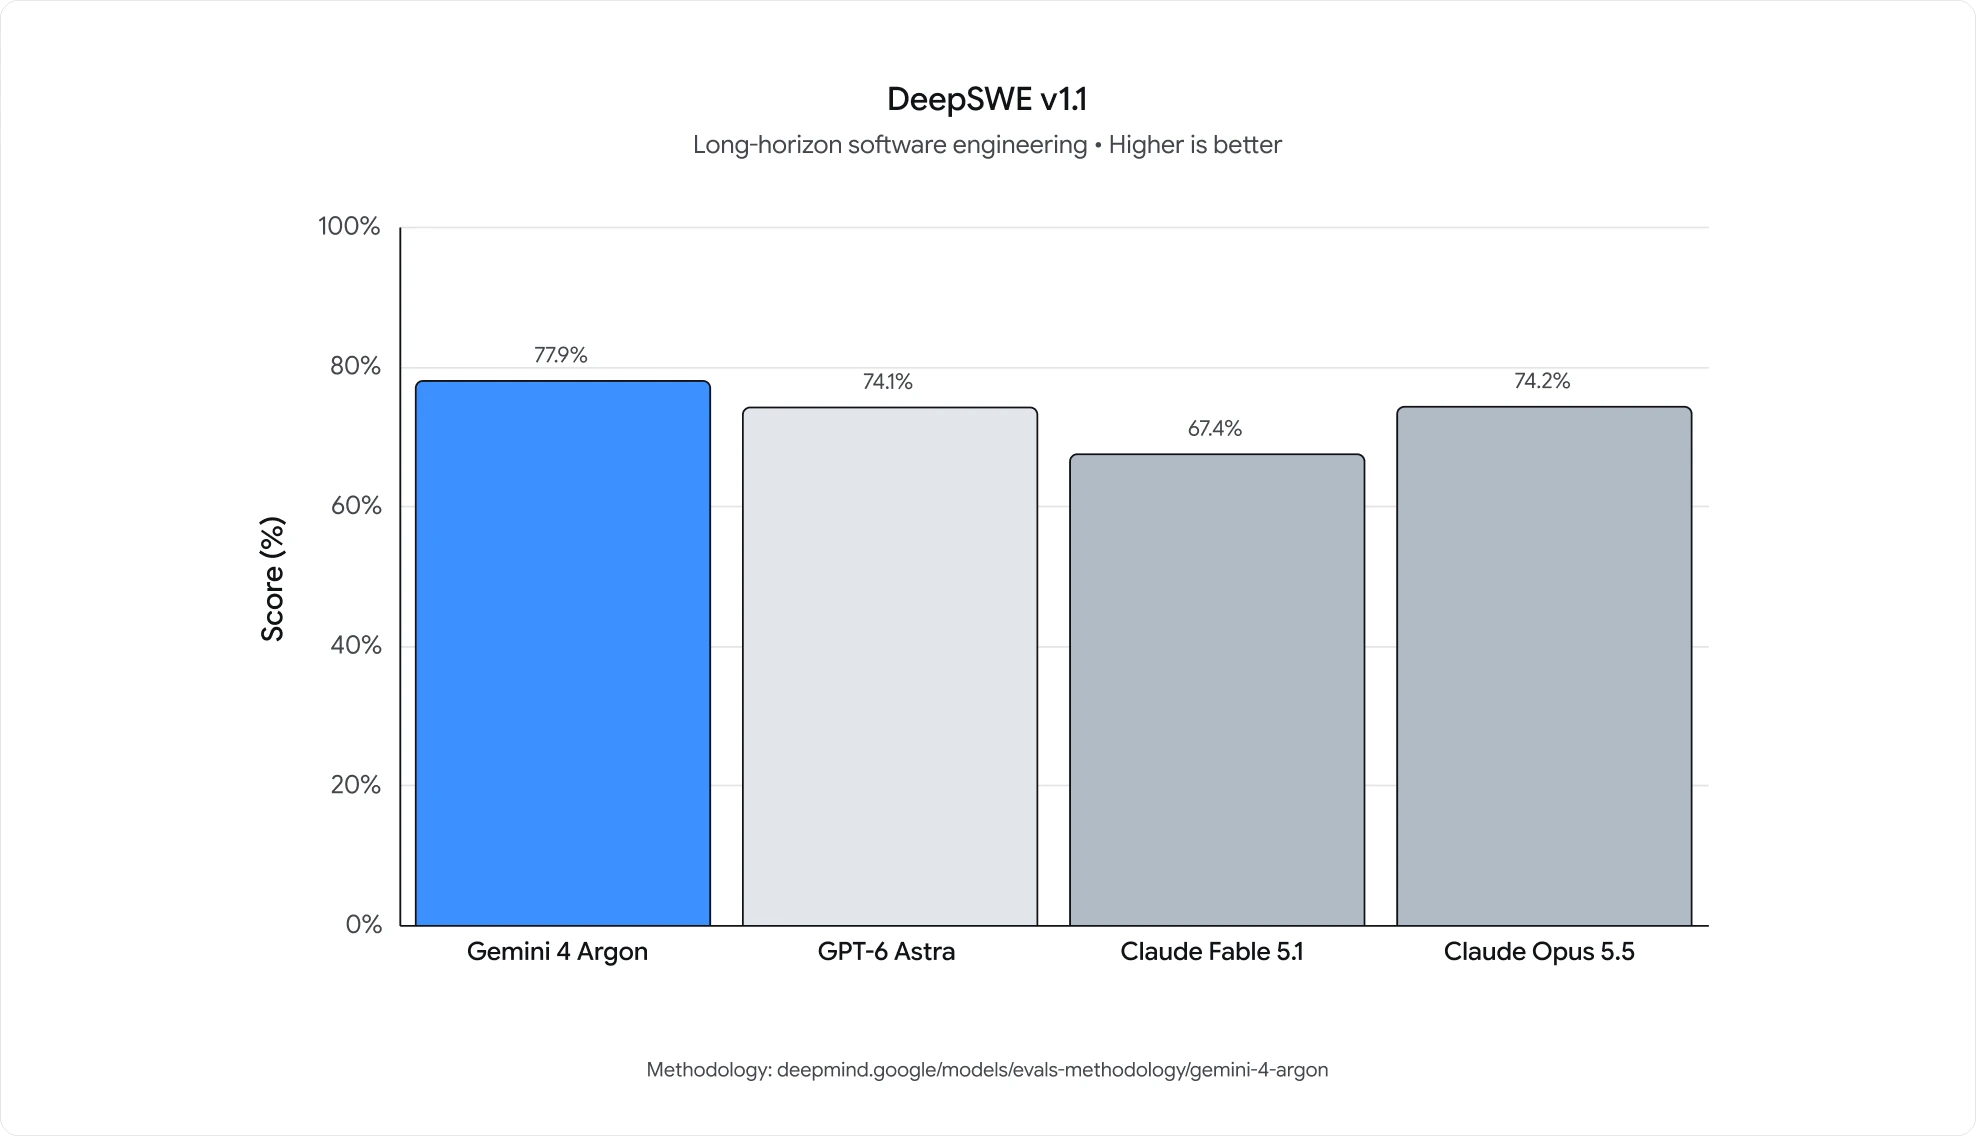
DeepSWE v1.1 の棒グラフ。Gemini 4 Argon が 77.9%、Claude Opus 5.5 が 74.2%、GPT-6 Astra が 74.1%、Claude Fable 5.1 が 67.4%
長時間におよぶソフトウェアエンジニアリング。主要スコアの 77.9% に対し、最も近い 2 モデルはいずれも 4 ポイント以内に収まっています。
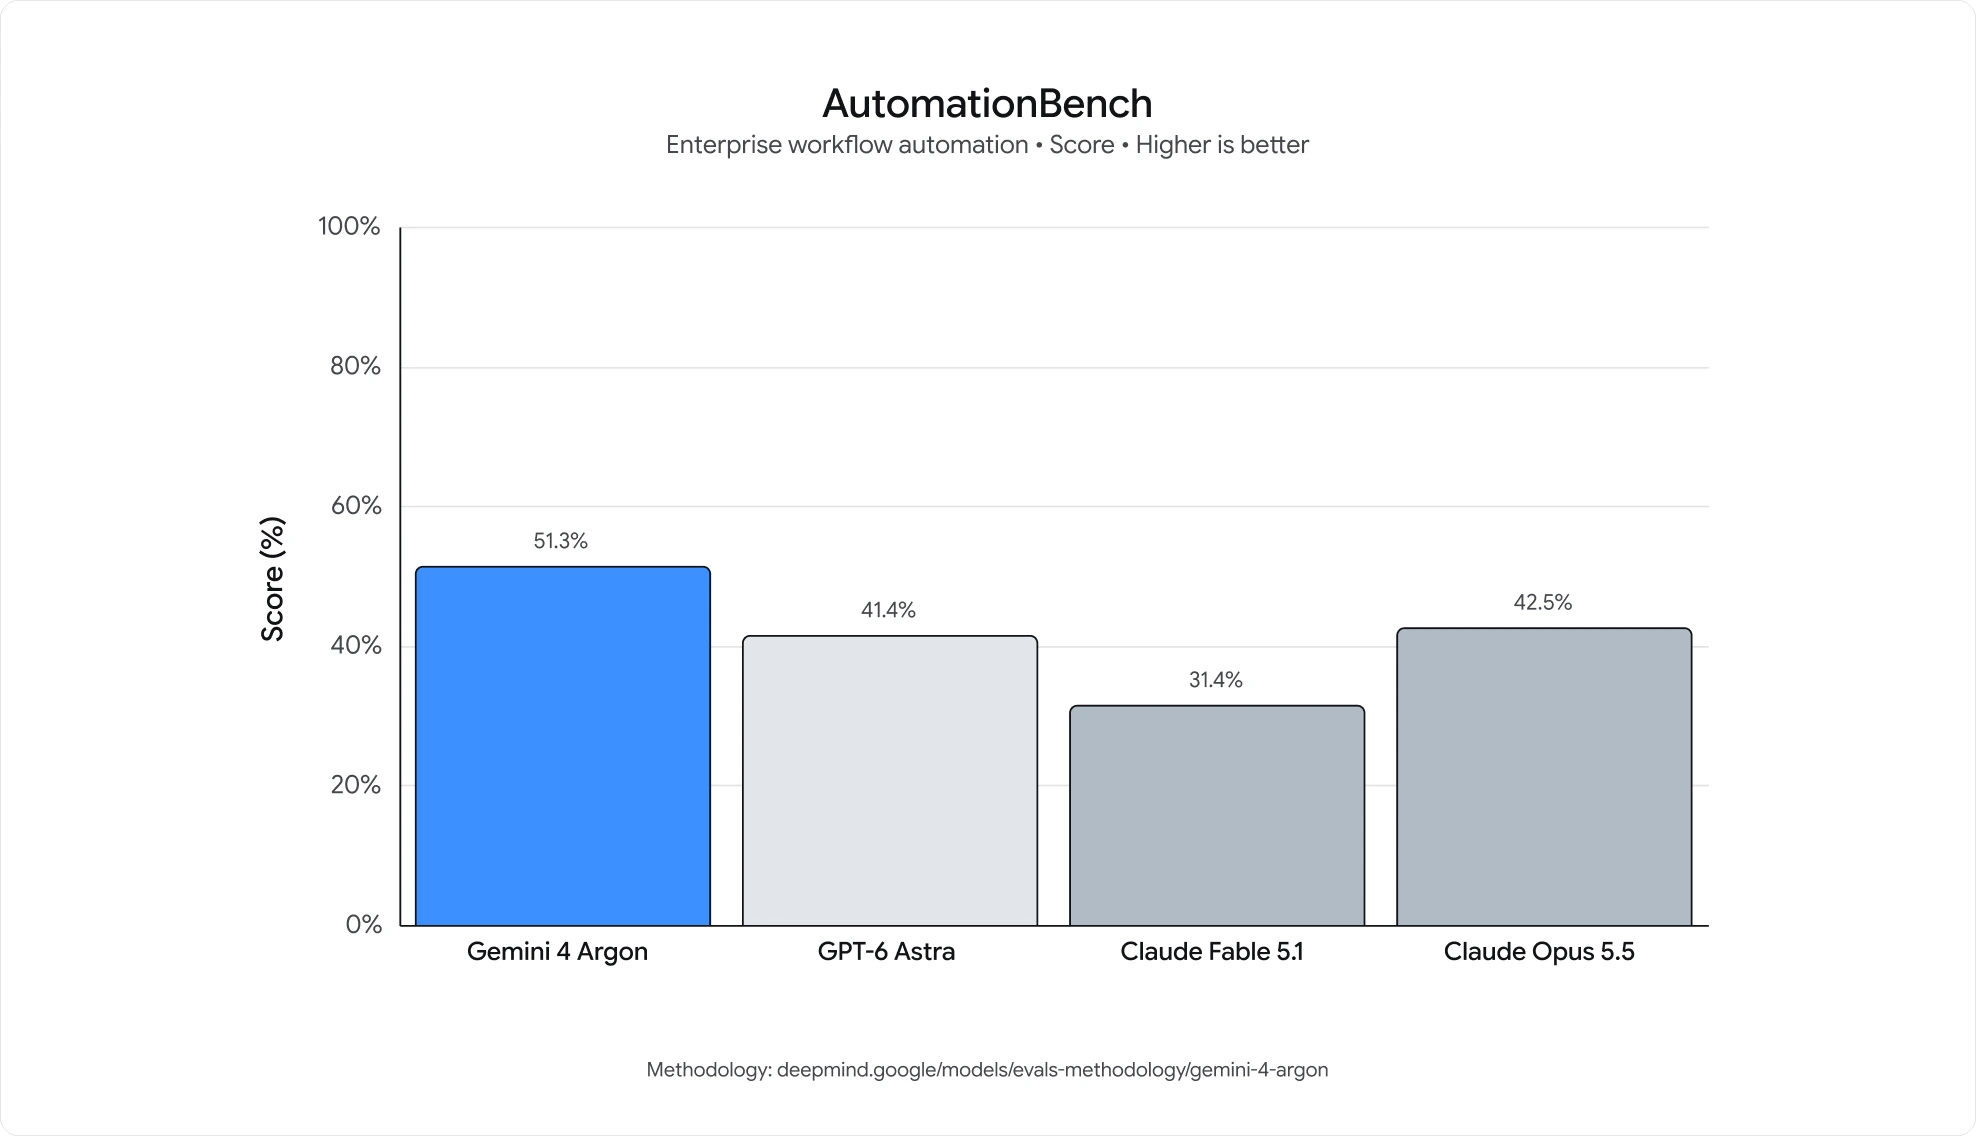
AutomationBench の棒グラフ。Gemini 4 Argon が 51.3%、Claude Opus 5.5 が 42.5%、GPT-6 Astra が 41.4%、Claude Fable 5.1 が 31.4%
Zapier が作ったエンドツーエンドの業務タスク。Argon は 50% を超え、比較対象の他のモデルはすべて 30% 台か 40% 台前半にとどまっています。
CWE-bench v1 のリーダーボード。Gemini 4 Argon、Grok、GPT-6 Astra が 68% で並び、Claude Opus 5.5 が 67%、そこから Inkling の 37% まで下がっていく
Pass@1 での脆弱性の発見。Argon は差を広げたのではなく、ひしめく上位集団で首位に並んだだけです。上の表で「同率 1 位」としているのはそのためです。
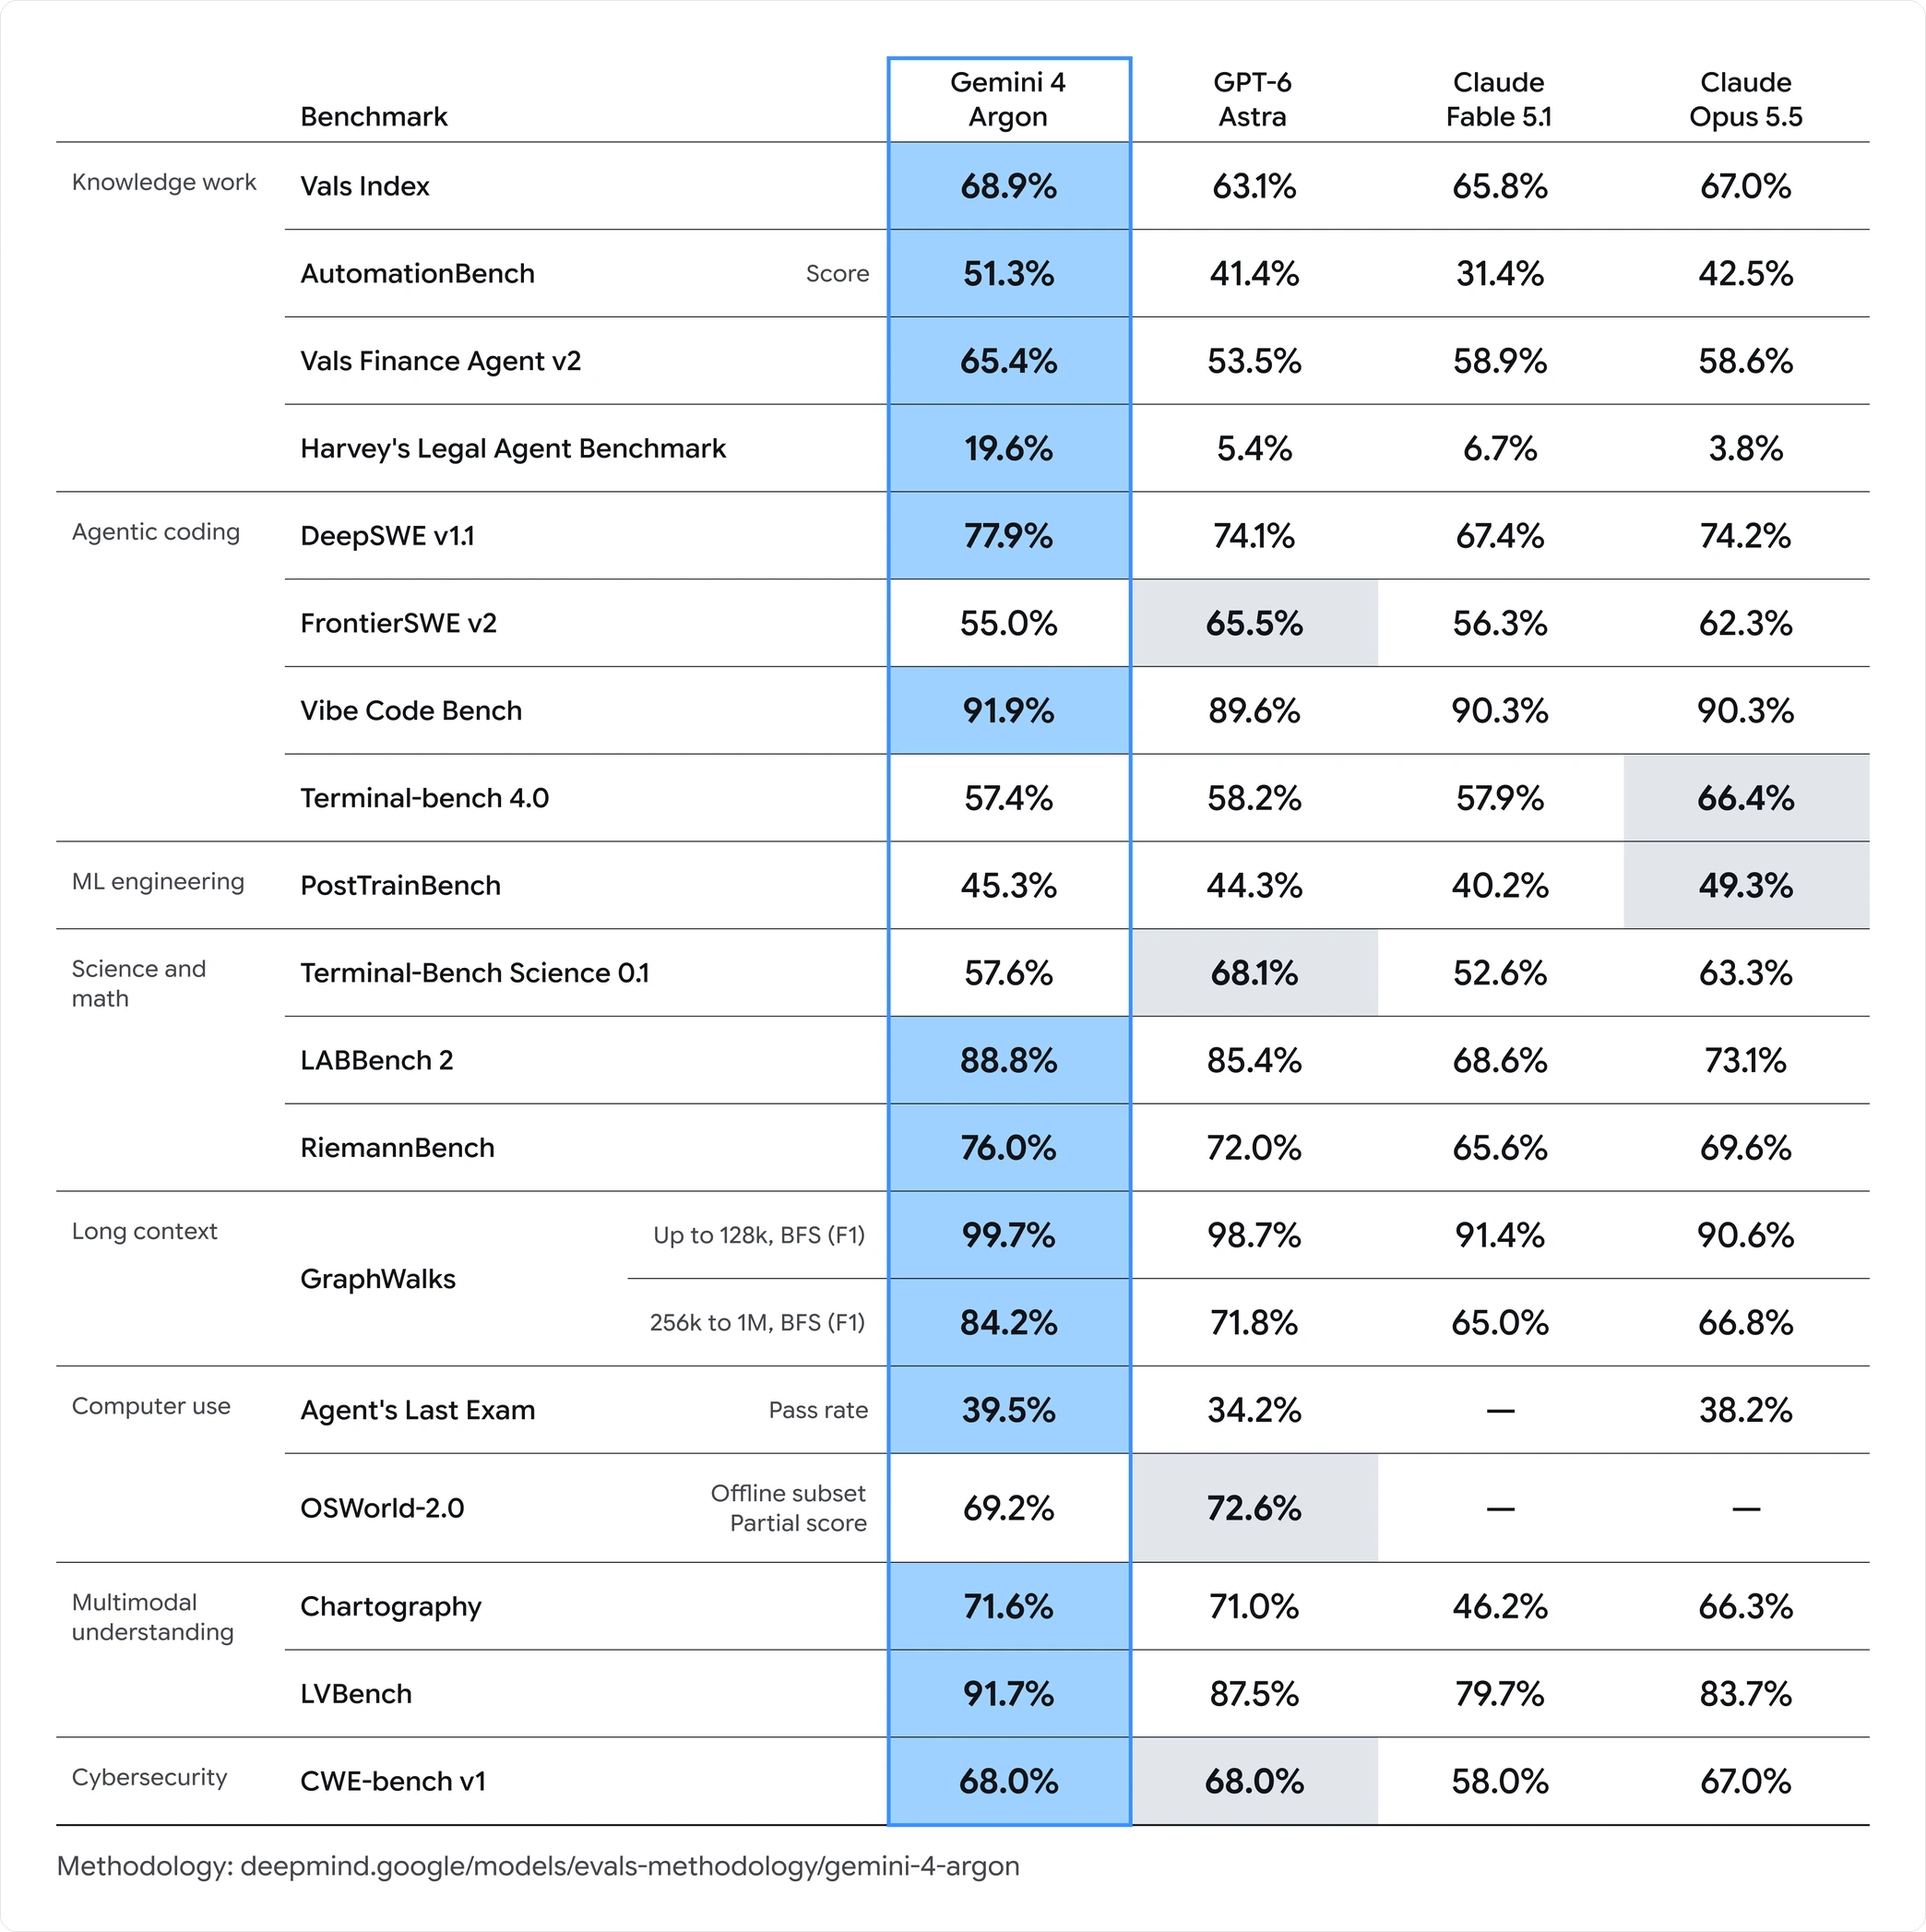
16 のベンチマークにわたる Gemini 4 Argon の Google の全結果表。ナレッジワーク、エージェント型コーディング、ML エンジニアリング、科学と数学、長いコンテキスト、コンピュータ操作、マルチモーダル理解、サイバーセキュリティのグループに分かれている
発表資料に載っている完全版の表で、Argon が勝っている箇所は青、競合がリードしているセルは灰色です。Argon が首位でない行は FrontierSWE v2、Terminal-Bench 4.0、PostTrainBench、Terminal-Bench Science 0.1、OSWorld-2.0 です。
Artificial Analysis の AA-Omniscience ハルシネーション率を 36 モデルについて示した棒グラフ。低い順に、Gemini 4 Argon(High)が 15%、次に MiniMax-M3 が 18%、Kimi K2.5 が 26%、そして DeepSeek-V4 Flash の 96% まで上がっていく
Artificial Analysis による独立した計測で、本ページで唯一ベンダーが提供していない数値です。各モデルが回答を控える代わりに誤って答えてしまう頻度を示し、Argon の 15% は掲載した 36 モデルの中で最低、目盛りは 96% まであります。
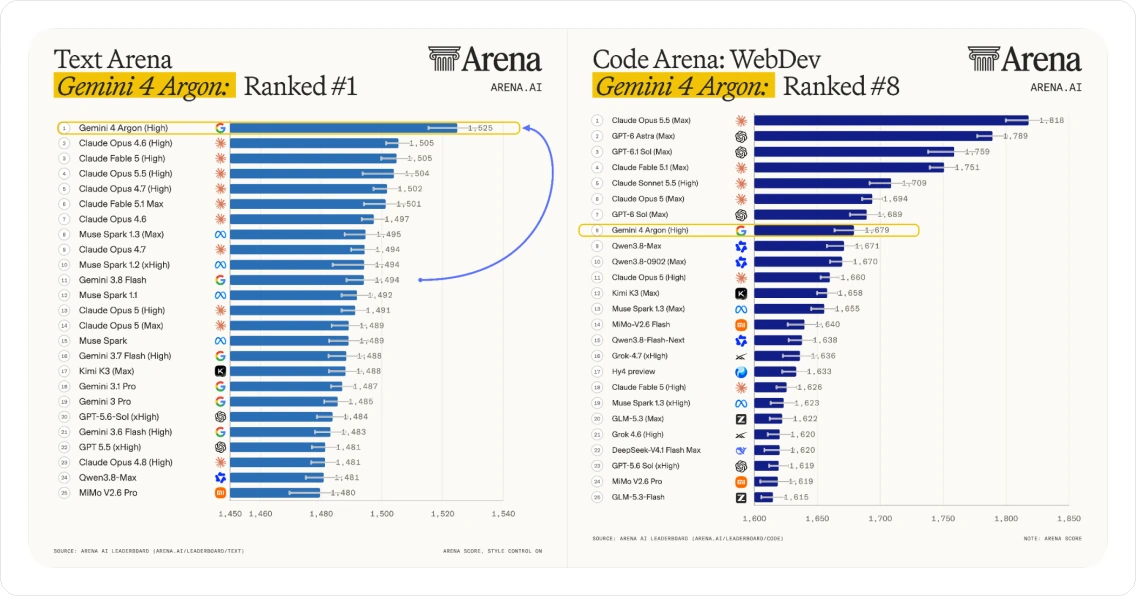
Arena.ai の Text Arena と Code Arena: WebDev のリーダーボードを並べて表示。Gemini 4 Argon は Text Arena で 1,625 を記録して 1 位、Code Arena: WebDev では 1,679 で 8 位
上の段落が根拠としている 2 つの順位で、Arena.ai の投票ランキングによるものです。Argon は Text Arena に掲載された 25 モデルの首位に立ち、Code Arena: WebDev では 8 位で、4 つの Claude モデルと OpenAI の GPT-6 系 3 モデルに先行を許しています。

Felo で

1M トークンを書けるモデルで、調査の流れはどう変わるか

Felo は検索と文書理解を組み合わせているため、長く出力できるモデルは 1 セッションで作れるものを変えます。

文書で終わる調査

資料を集め、要約と統合を 1 回で書かせます。多くのプロンプトに分けて少しずつ組み立てる必要はありません。

文書一式を 1 つのタスクで

長い文脈の検索は Argon が最も得意とする能力です。契約書の束、申請書類、長い報告書を扱いやすくするのもこの点です。

語感が問われる執筆

文章が強くコーディングは中程度という Argon の公表された特性は、組み立てたのではなく書かれた文章が必要なチームに向いています。

コスト

Argon の料金と、後から変わる点

Google は導入価格と、それより高い通常価格を公表していますが、切り替えの時期は示していません。予算は高いほうの数字で立ててください。

トークンの種類
導入価格
以降
入力
$2.00 / 100 万トークン
$4.00 / 100 万トークン
キャッシュ入力
95% 割引
95% 割引
出力
$10.00 / 100 万トークン
$20.00 / 100 万トークン

参考までに、導入価格は GPT-6.1 Sol と Sonnet 5.5 とほぼ同水準、GPT-6 Astra のおよそ 5 分の 1 です。いずれも表示価格であり、タスクあたりの実測コストではありません。Argon は難しい問いを扱うため、1 回の実行が高くつくことはあります。

Felo で Argon を使いこなすには

01

問いをまるごと持ち込む

要約ではなく、文書一式や長いスレッドをそのまま Felo に渡してください。プロンプトに収まらなくなったところから、Argon の強みが効いてきます。

02

完成品をそのまま頼む

1M トークンの出力上限があれば、章ごとに分けずに、完全な報告書や初稿を 1 つの指示で求められます。

03

出典と突き合わせる

Felo は回答のそばに引用を残します。モデルが書いた長い文書を点検できるのは、このためです。

Felo 検索内での Argon の提供は準備中です。開放までは、Felo のラインアップにある他のモデルがすべて利用できます。

Felo AI 検索を開く

Gemini 4 Argon よくある質問

一般にはまだ使えません。Google は Argon をまず Fairwind プログラムで選ばれたパートナーに公開し、より広い提供は有料 API のお客様と Google AI Ultra の加入者から始まるとしています。その段階の日付は公表されておらず、現在は有料の購読だけでは利用できません。

Felo で Google のフロンティアモデルを試す

タスクに合うモデルで検索し、読み、書いてください。Argon も、提供が Felo に届き次第ラインアップに加わります。

Felo AI 検索を開く

Felo AI 検索の利用にクレジットカードは不要です。